跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI硬件
  4. Strata 在我这台 5060ti 16G 显存 32g内存 电脑上成功跑通:一次本地大模型实战心得 暂时不用升级ddr5内存了,真心贵啊!!!

Strata 在我这台 5060ti 16G 显存 32g内存 电脑上成功跑通:一次本地大模型实战心得 暂时不用升级ddr5内存了,真心贵啊!!!

已定时 已固定 已锁定 已移动 AI硬件
rtx5060strata本地模型
8 帖子 5 发布者 285 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • focuser liF
    focuser liF
    focuser li
    编写于 最后由 编辑
    #1

    image.jpeg
    image.jpeg
    image.jpeg

    这段时间,我一直在测试本地大模型的不同方案。相比很多人动不动就上大显存、大内存服务器,我更关心的是:普通一点的个人电脑,到底能不能把高质量本地模型真正跑起来,并且投入实际工作。

    这次,我重点测试的是 Strata / Basalt 这一套方案。最终结果是:在我这台 RTX 5060 Ti 16GB 显存、32GB 内存的机器上,Strata 已经成功稳定运行,而且确实能完成实际开发任务。

    更重要的是,它不是“勉强点亮”,而是已经能进入“可用、可验证、可交付”的阶段。
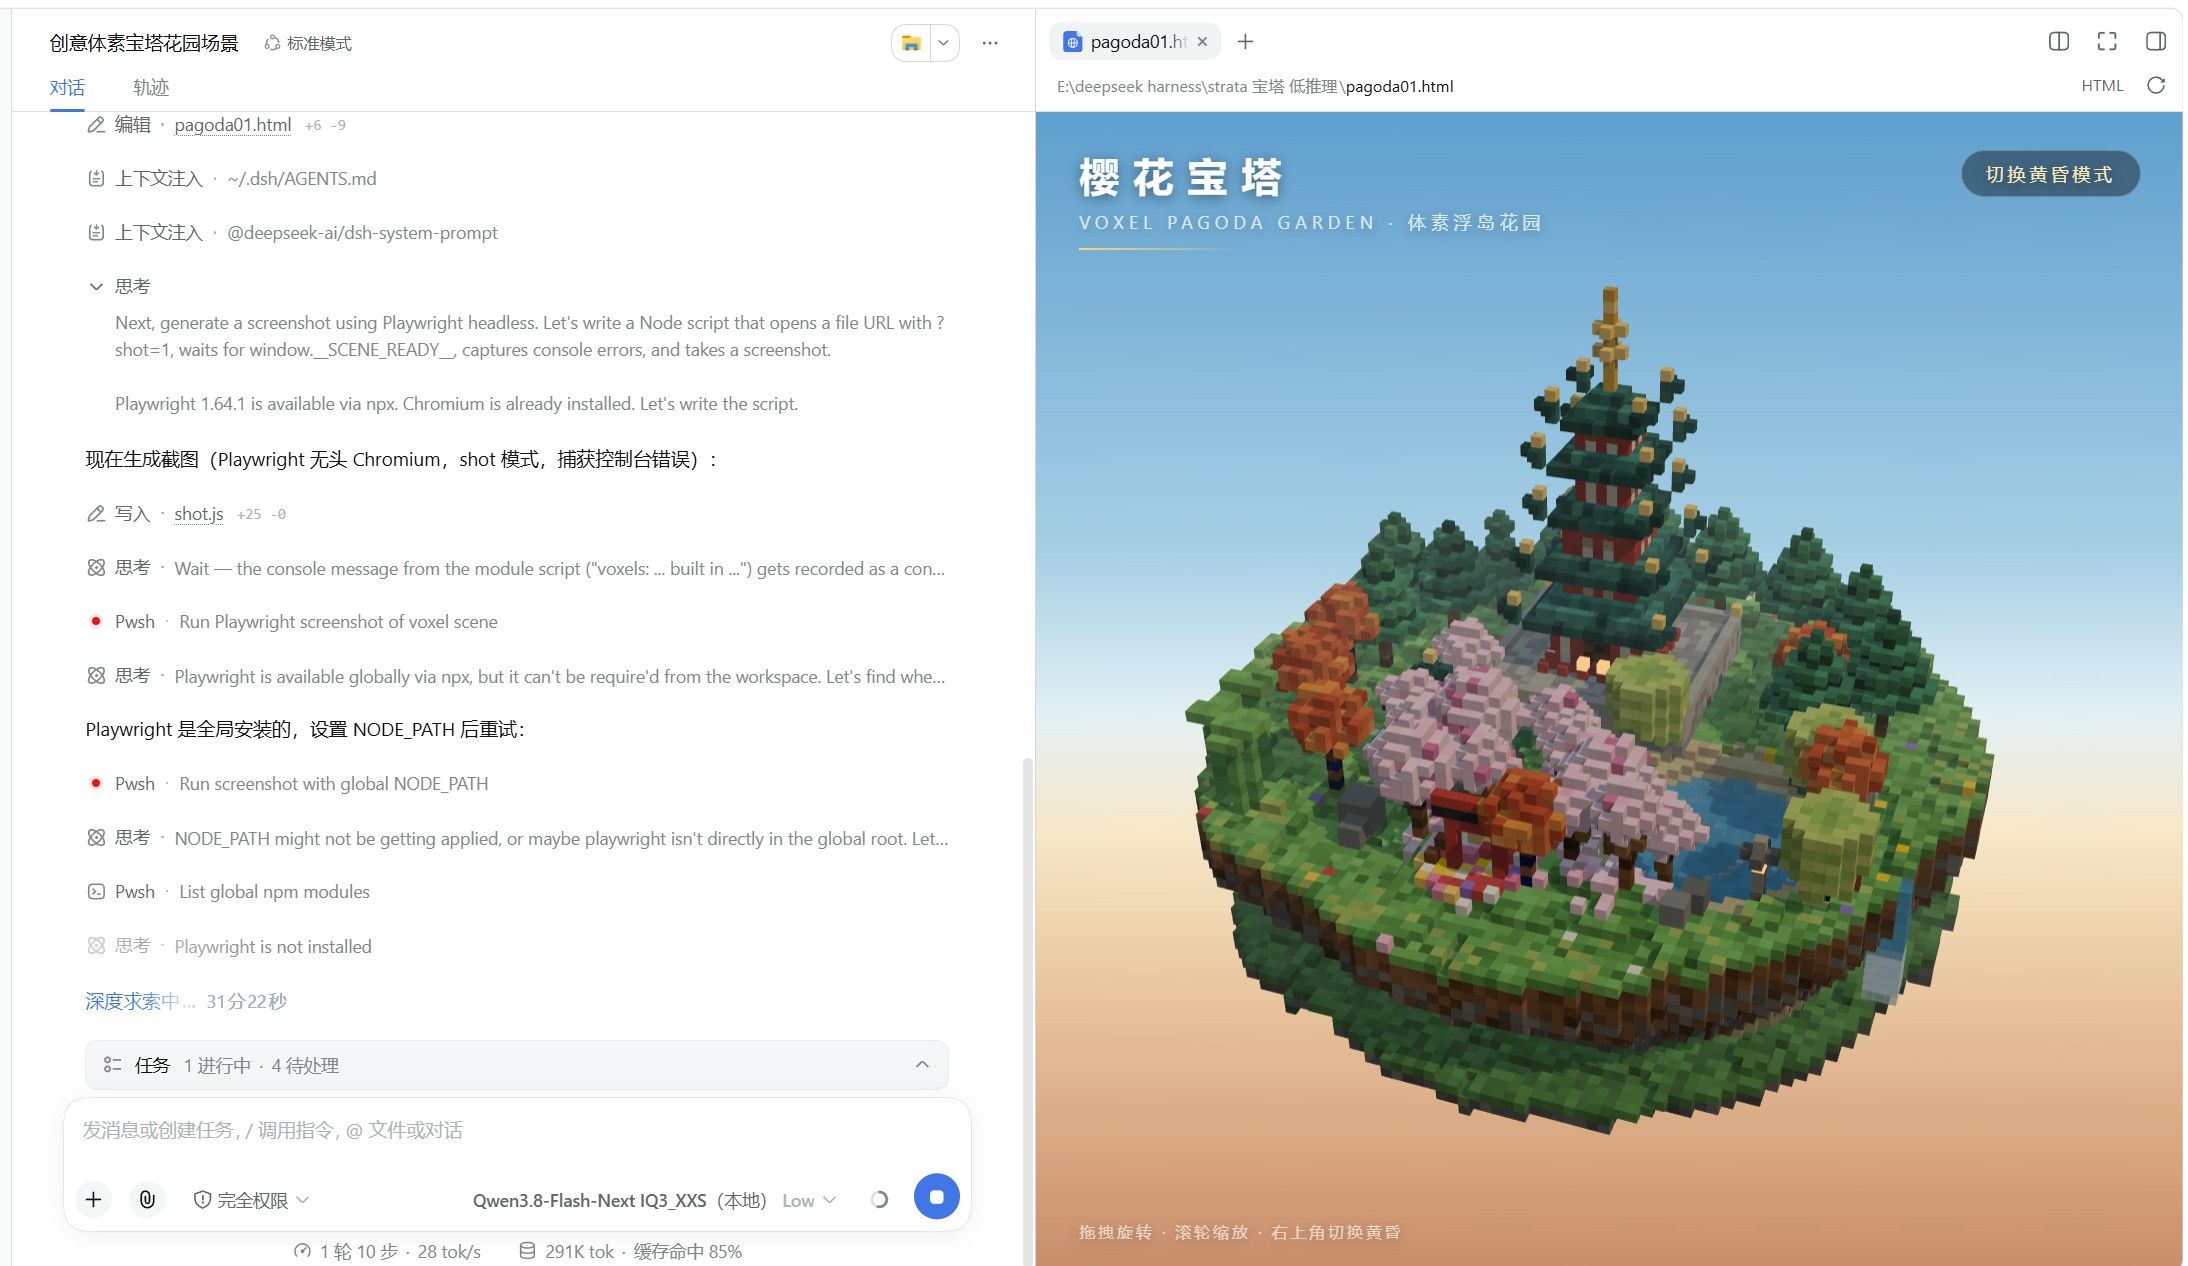
    我还用它做出了一个 3D 体素花园 / 宝塔场景的 HTML 项目,效果相当不错,这也说明它不仅能聊天,还能真正干活。
    一、我的机器配置
    先说一下我的硬件环境,这也是很多人最关心的部分。
    本机配置

    • 显卡:RTX 5060 Ti 16GB
    • 显存:16GB
    • 系统内存:32GB
    • 系统环境:Windows
    • 使用目标:本地大模型推理、长上下文测试、代码生成、前端项目开发、HTML/Three.js/SVG 类任务
      这套配置并不算豪华,尤其在当前“大家都在卷大内存、大显存”的环境下,16G 显存 + 32G 内存其实属于一个比较有代表性的普通玩家/个人开发者配置。

    也正因为如此,这次测试的意义更大:
    如果这套方案能在我的机器上跑通并稳定工作,那么它对大多数本地 AI 爱好者来说,就具备很强的参考价值。
    二、我测试的 Strata / Basalt 方案
    这次跑通的核心方案,是:
    模型

    • Qwen3.8-Flash-Next
    • 量化格式:GSQ-RCO IQ3_XXS
      推理框架
    • Basalt / Strata
      关键运行参数
      Basalt 侧实际稳定运行的核心参数大致如下:
    • max-context = 65536
    • kv = int8
    • expert-cache = auto
    • prefill = auto
    • mmap-experts = true
    • prompt-cache = 4
    • ple-row-cache = 0
    • spec = 0
      DSH 侧关键设置
    • contextWindow = 65536
    • maxTokens = 16384
    • reasoningEffort 默认按需要切换
    • thinkingBudgets.low = 2048
      其中有两个点我觉得特别重要:
      1)64K 上下文成功跑通
      这说明它不是只能做短对话,而是已经具备更长上下文的实际使用能力。
      对于代码任务、复杂项目排障、长流程开发来说,这个提升非常关键。
      2)Low 推理预算调到 2048
      这是一个非常实用的平衡点。
      之前如果推理预算太高,会出现“思考太多,输出被截断”的问题;调到 2048 后,既保留了一定的推理能力,又不会把输出额度吃光,更适合实际开发任务。
      三、跑通过程里最关键的经验:问题不一定在模型,而可能在运行方式
      这次测试里,最让我印象深刻的一点是:
      很多看上去像“模型不行”的问题,最后发现其实不是模型能力问题,而是运行链路、进程优先级、工具调用链等工程问题。

    例如我中间遇到过一个很典型的问题:

    • 同样的模型、同样的参数
    • 一段时间能跑到 20–30 tok/s
    • 后来却掉到了 2–3 tok/s
      最后定位下来,根因并不是模型变差了,也不是 64K 上下文拖慢了速度,而是:
      真正的问题根源
      启动方式改变后,Basalt 进程被 Windows 计划任务以 BelowNormal 优先级启动了。

    这会导致:

    • CPU 侧线程被系统其他普通进程抢占
    • 专家计算 / 缺页线程效率下降
    • GPU 看起来在忙,但功耗很低,实际在等数据
    • decode 速度大幅下降
      后来我把启动方式改回 WMI 启动 + Normal 优先级 后,性能马上恢复了。
      恢复后的实测表现
      在 64K 上下文、Normal 优先级下,重新实测得到:
    • 冷启动短请求:约 14.8 tok/s
    • 热身后:约 33.8 tok/s
    • 再进一步热起来:约 39.8 tok/s
      而在真实 DSH 开发会话里,
      9k+ prompt 的请求也能回到大约 23.8–27.4 tok/s,已经非常可用了。

    这个过程让我更加确定一点:
    本地大模型方案要跑好,模型只是第一层;真正决定能不能“用起来”的,是工程链路是否打通。

    四、为什么我觉得 Strata 值得重视
    很多人现在一提本地大模型,就默认必须大显存、大内存,不然很难玩。
    但我这次测试后的一个很深体会是:
    Strata 的价值,不只是“能跑”
    而是它在我的配置上,已经体现出三个很强的优势:
    1)低门槛
    在 16GB 显存 + 32GB 内存 这类更常见的电脑配置上,Strata 不是完全没机会,反而已经能跑出实际效果。
    2)长上下文能力有现实意义
    64K 上下文对开发任务帮助明显。
    尤其是前端工程、HTML 动画、Three.js 场景、SVG 页面这类任务,提示词、历史记录、错误日志都比较长,没有长上下文就很容易断链。
    3)更像“工作工具”,不是纯演示
    这次我不是只拿它做聊天测试,而是让它真正去做项目,包括:

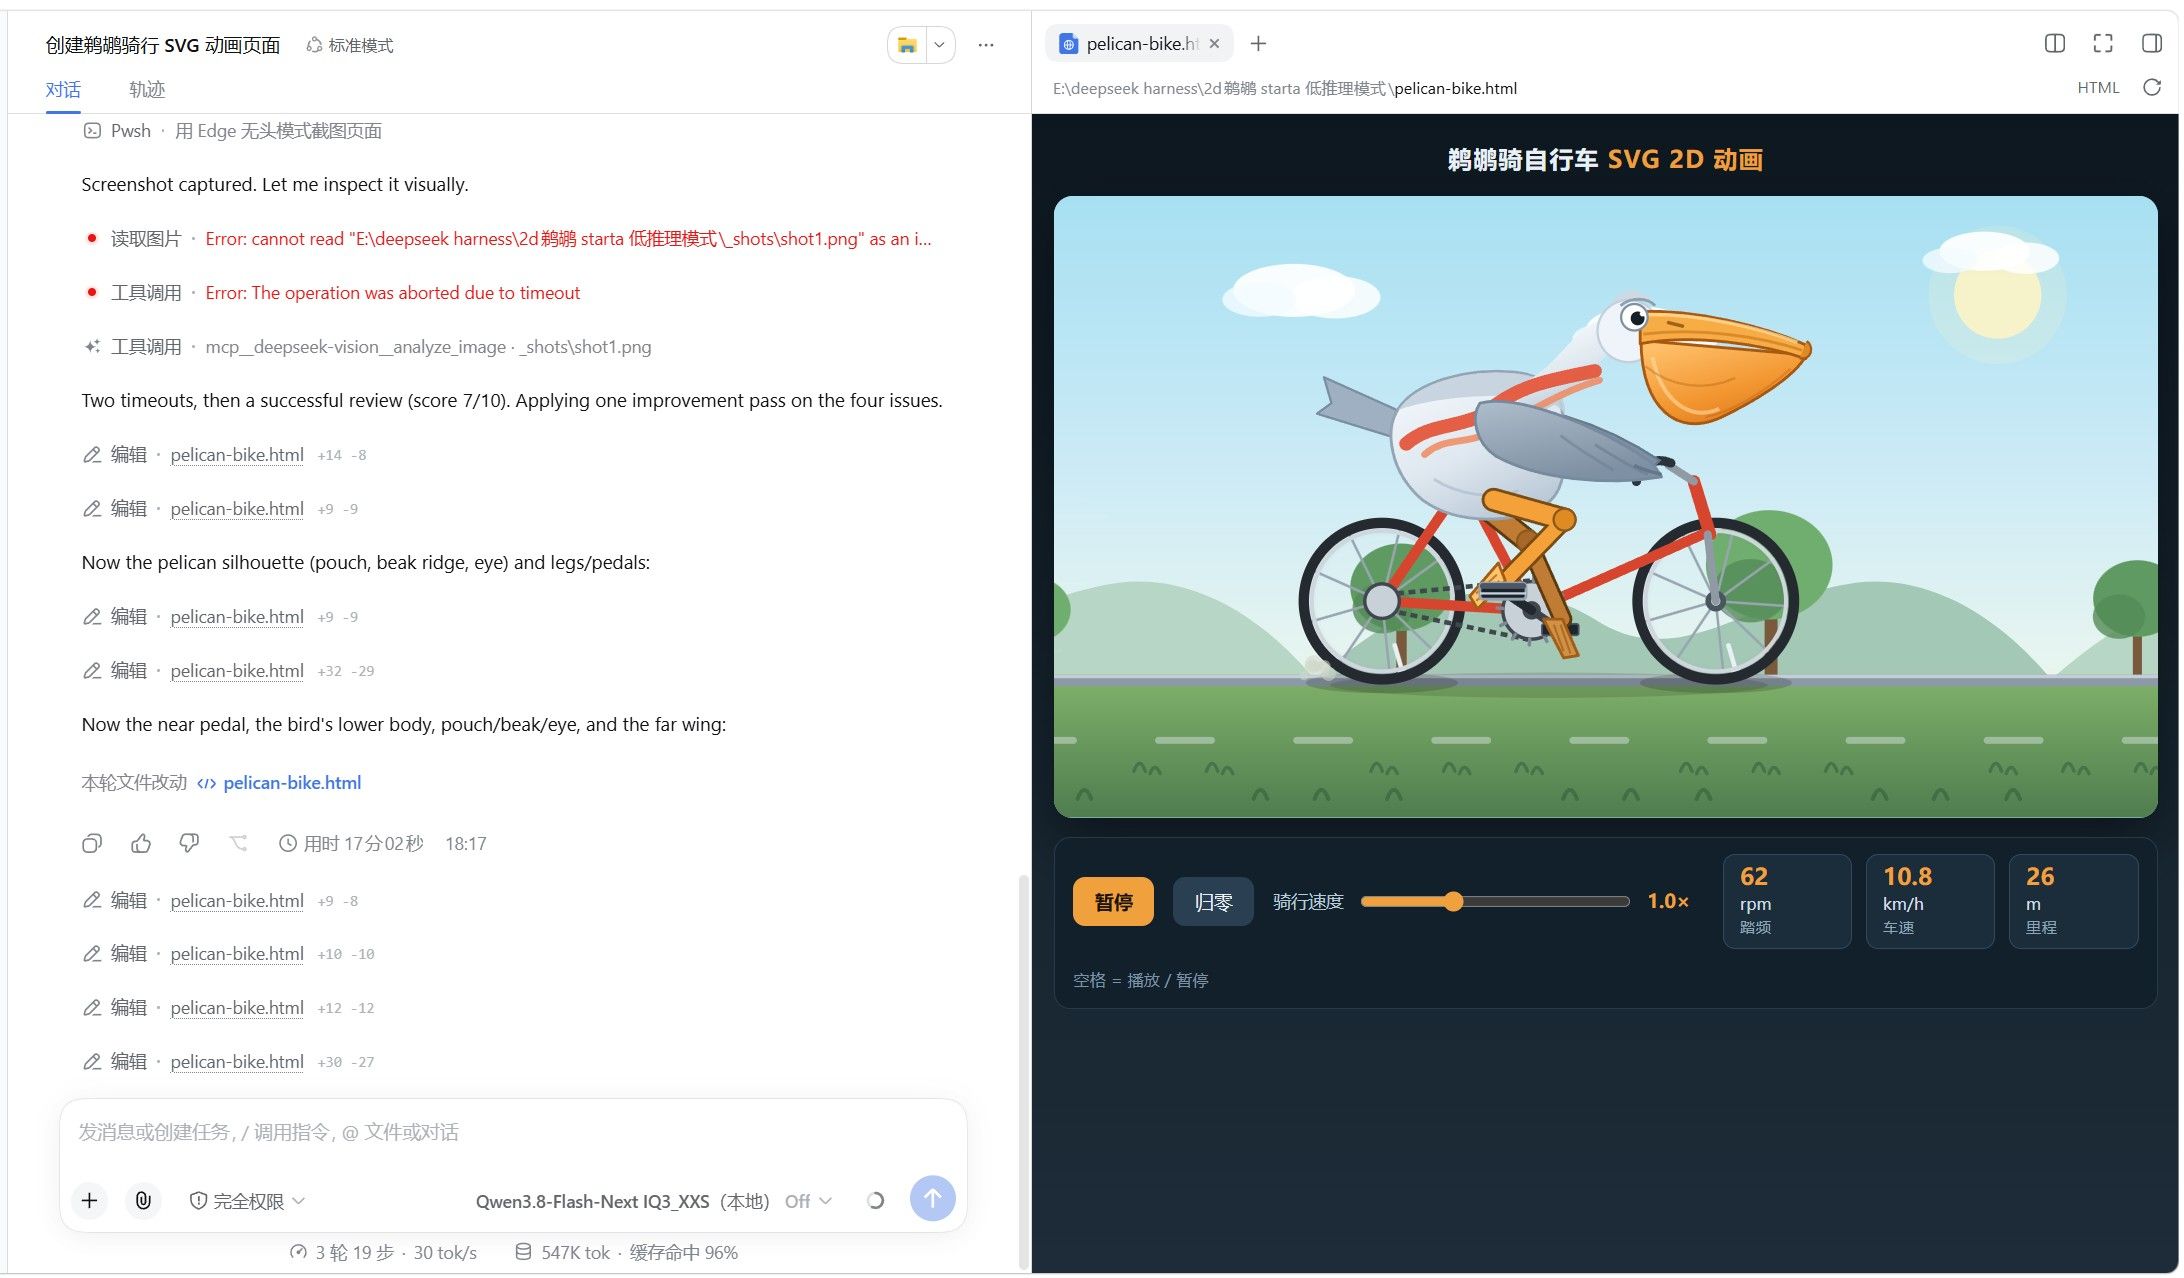
    • 生成单文件 HTML
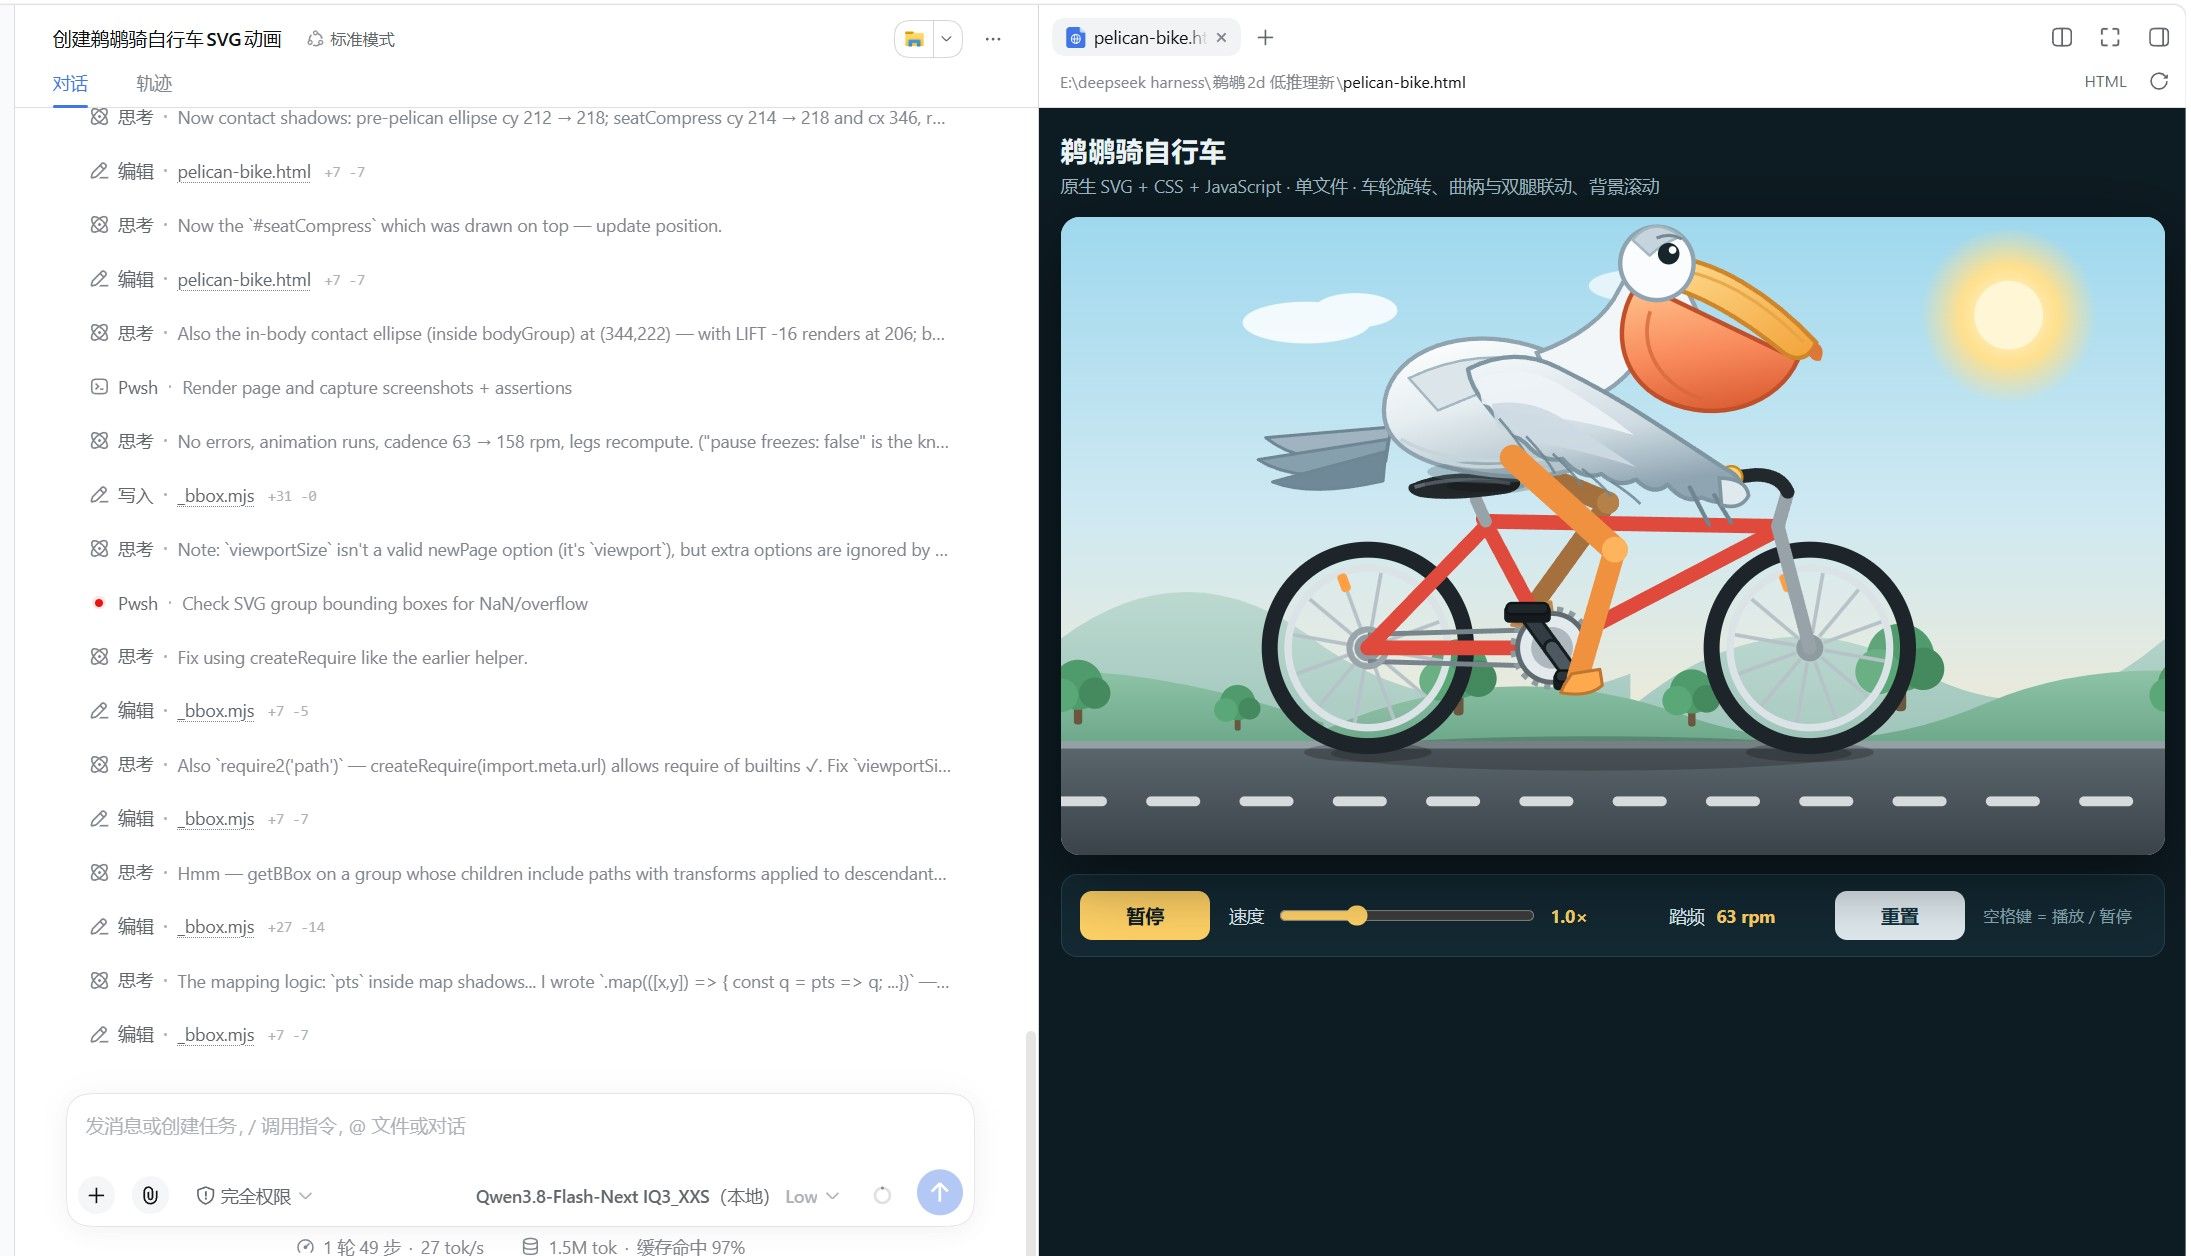
    • 完成 SVG 动画
    • 生成 Three.js 体素场景
    • 调试代码错误
    • 配合截图和视觉链路进行验收
      这就和单纯跑一个 benchmark 完全不是一回事了。
      五、成功运行后的实际效果
      这次让我最满意的一个成果,就是让它生成并完成了一个 3D 体素花园 / 宝塔场景 项目。

    这个项目最终做到了:

    • 单文件 HTML 交付
    • 页面可直接打开
    • 展示完整的体素艺术场景
    • 包含宝塔、树木、樱花、花园地形、池塘等元素
    • 构图完整,整体观感已经具备“作品展示”的感觉
      你可以在这里插入成果图:
      配图:Strata 在本机配置上生成的 3D 体素花园 / 宝塔场景成果图

    我觉得这一点非常重要,因为它说明:
    Strata 在我这台机器上,不只是“推理成功”,而是已经“产出成功”。

    这和只看 token 速度、只看上下文长度,是两个层面的意义。
    六、Low 推理模式给我的感受
    这次测试还有一个很有价值的体验:
    推理模式对成品质量是有帮助的,但前提是预算要合理。

    我的实际感受大致是:
    无推理模式(Off)
    优点:

    • 响应快
    • 输出直接
    • 适合简单任务
      缺点:
    • 更容易“一把写完就交”
    • 对长代码任务的自检能力弱一些
      Low 推理模式(2048)
      优点:
    • 会更愿意自查
    • 更适合中等复杂度任务
    • 对 HTML / 动画 / Three.js 这种长代码任务帮助明显
      缺点:
    • 比 Off 慢一点
    • 如果预算设置过高,容易挤占输出额度
      但在我把 thinkingBudgets.low 调到 2048 后,Low 模式明显变得更平衡了。
      它不再像以前那样“想太多把输出挤爆”,而是能在适度思考 + 完整输出之间找到一个比较好的平衡。

    所以如果是我的结论,我会说:
    在我这台机器上,Low 推理模式已经是 Strata 做实际开发任务的一个很适合的档位。

    七、这次测试给我的最大启发
    如果只看表面,很多人会觉得:
    “本地大模型嘛,差不多能回答问题就行了。”

    但这次我真正跑下来,感受完全不是这样。
    我觉得本地模型真正有价值的地方,在于它开始具备下面这些能力:

    • 可控
    • 可长期运行
    • 可调参
    • 可做工程化测试
    • 可为实际项目服务
      而 Strata 在我这台机器上的成功,恰恰说明了一点:
      本地 AI 不一定必须建立在高昂硬件门槛上。只要方案合适、配置合理、链路打通,中等配置机器同样可以跑出有生产力的结果。

    这也是我最想分享的地方。
    八、我的最终结论
    如果让我用一句话总结这次体验,那就是:
    Strata 在 RTX 5060 Ti 16GB + 32GB 内存这类普通但不低端的个人电脑上,已经具备了“真实可用”的价值。

    它的成功不只是点亮模型,而是体现在:

    • 64K 上下文成功运行
    • 实际速度恢复并稳定在可用区间
    • 推理模式可调且有效
    • 能完成 HTML / SVG / Three.js 这类真实项目
    • 已经产出了可展示的 3D 花园成果图
      当然,它不是没有门槛。
      你仍然需要处理不少工程问题,比如:
    • 进程优先级
    • 启动方式
    • 输出预算
    • 推理预算
    • 视觉链路
    • 浏览器验证链路
      但恰恰因为这些问题被解决了,这套方案才更有说服力。

    对我来说,这次 Strata 的成功,不只是一次技术折腾,
    更像是一种确认:
    本地 AI 真正开始从“能跑”走向“能用”了。

    1 条回复 最后回复
    1
    • J Z 0J
      J Z 0J
      J Z 0
      体面乡绅
      编写于 最后由 编辑
      #2

      这是怎么做到的,strata真是弹性很大。
      我之前5070+ 48g ram,感觉用q2模型都要爆了,速度倒是飞起,记得decode有100多来着。看来资源有限时,它能自动优化分配

      1 条回复 最后回复
      0
      • focuser liF
        focuser liF
        focuser li
        编写于 最后由 编辑
        #3

        我的帖子里面都写了,你让codex 参考我帖子部署就能避坑

        perterP 1 条回复 最后回复
        0
        • imbiplaza ASUSI
          imbiplaza ASUSI
          imbiplaza ASUS
          谪仙人
          编写于 最后由 编辑
          #4

          谢谢你,我可以抄功课了,

          1 条回复 最后回复
          0
          • focuser liF
            focuser liF
            focuser li
            编写于 最后由 编辑
            #5

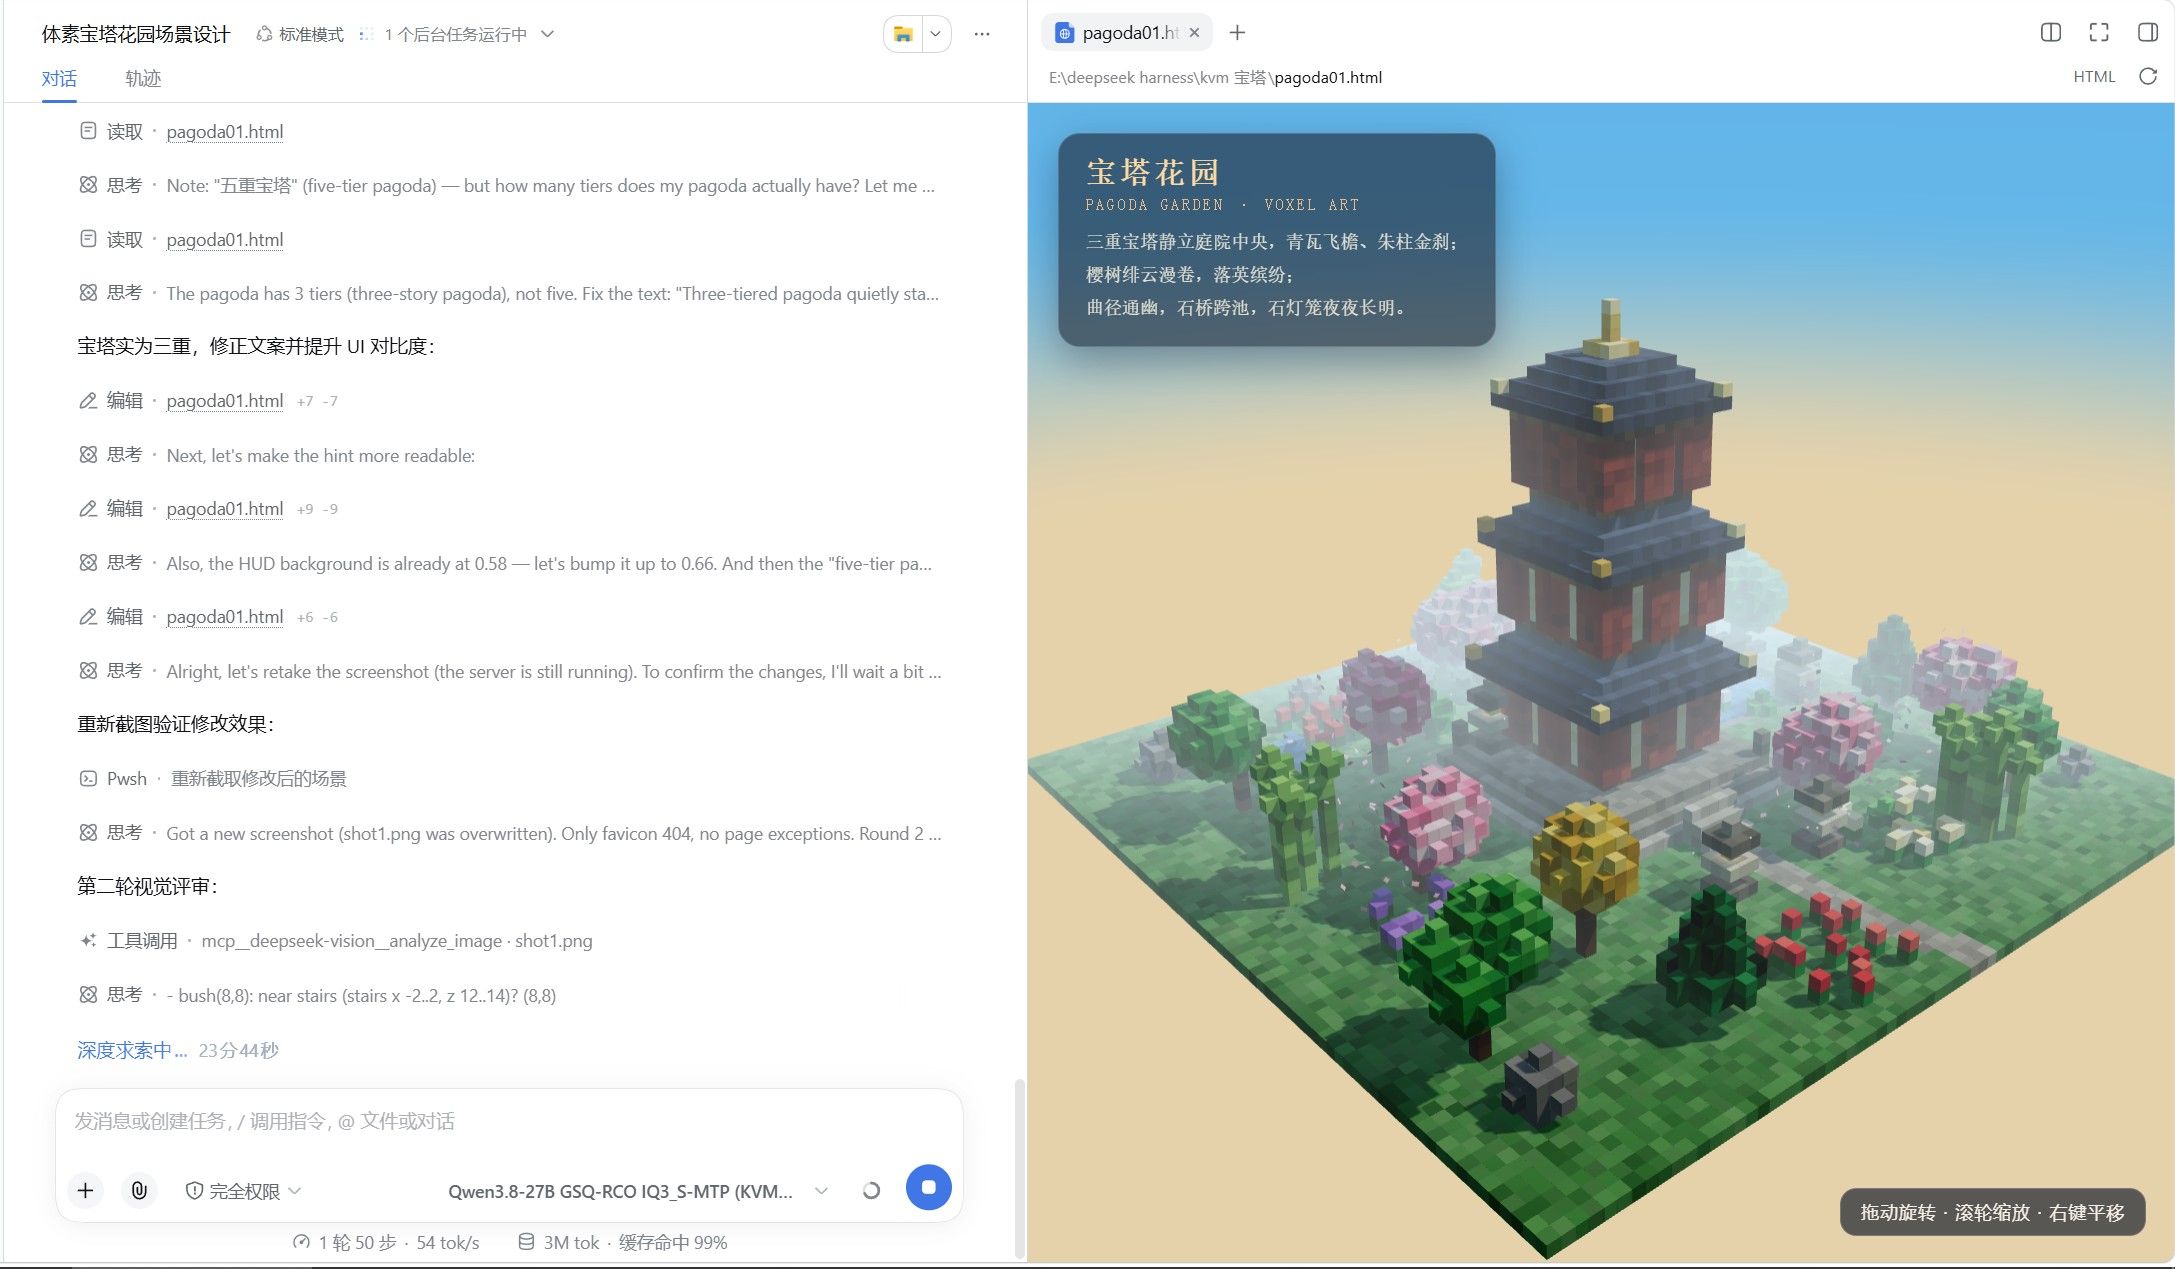
            image.jpeg
            同样的提示词 qwen27b kvmem inifer方案做的效果 还是有差距的。。。

            dardeaw fengD 1 条回复 最后回复
            1
            • focuser liF focuser li

              image.jpeg
              同样的提示词 qwen27b kvmem inifer方案做的效果 还是有差距的。。。

              dardeaw fengD
              dardeaw fengD
              dardeaw feng
              硕果累累 贵族大夫
              编写于 最后由 编辑
              #6

              @focuser-li 真的用了qfn後再回頭用27B,有點回不去了,qfn上到4bit量化後除了廢話多了點,全面輾壓27B
              但為了不久後Qwen 4 27B要發布了,我還是得準備好27B環境恭候大駕

              1 条回复 最后回复
              1
              • focuser liF focuser li

                我的帖子里面都写了,你让codex 参考我帖子部署就能避坑

                perterP
                perterP
                perter
                贵族大夫 硕果累累
                编写于 最后由 编辑
                #7

                @focuser-li 说:

                我的帖子里面都写了,你让codex 参考我帖子部署就能避坑

                Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS主模型就43G,难道一部分放到虚拟内存了。

                1 条回复 最后回复
                0
                • ,gao GaoG gao Gao 引用了 此主题
                • focuser liF
                  focuser liF
                  focuser li
                  编写于 最后由 编辑
                  #8

                  应该是用ssd硬盘给消化了

                  1 条回复 最后回复
                  0

                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                  有了你的建议,这篇帖子会更精彩哦 💗

                  注册 登录
                  回复
                  • 在新帖中回复
                  登录后回复
                  • 从旧到新
                  • 从新到旧
                  • 最多赞同


                  • 登录

                  • 登录或注册以进行搜索。
                  • 第一个帖子
                    最后一个帖子
                  0
                  • 版块
                  • 最新
                  • 标签
                  • 热门
                  • 用户
                  • 群组