双7900 XTX 对战单卡 5090:Strata 从 4K 跑到 262K,长上下文成绩有点意外!
-
我这台主机用的是 Ryzen 5 7500F+双 RX 7900 XTX。这次想弄明白:用 Strata 跑 IQ3_S,这套机器和公开的 9700X+RTX 5090 主机相比,实际处在什么位置?
之前看过不少“几千 token/s”的成绩,但提示长度、缓存和测试方法不一样,直接摆在一起容易误判。这次我找到了 Strata 仓库里一份 RTX 5090 + Ryzen 7 9700X 的 IQ3_S 社区报告,照着它附带的脚本,在双 7900 XTX 上重新跑了一遍四档速度测试。
结果先放前面:128,000 token 输入时,我这台双 7900 XTX 的 prefill 中位数为 4,880 token/s,约为那份 5090 报告的 84.1%。 32K 的比例为 60.9%,4K 为 53.2%;接近 262K 时为 78.5%,但波动明显增大。吐字速度的差距也比长上下文 prefill 大得多。
标题里的“84%”,限定的是7500F+双 7900 XTX 这套主机,在 128K prefill 测试中的成绩,占公开的 9700X+5090 主机成绩的比例。两边 CPU、GPU 数量、软件版本和参数都有差异,下面先把这些条件摆在一起。
对照来源:Strata 社区 RTX 5090 / 9700X / IQ3_S 测试报告。5090 数据来自这份公开记录,双 7900 XTX 数据为本机 2026 年 10 月 24 日实测。
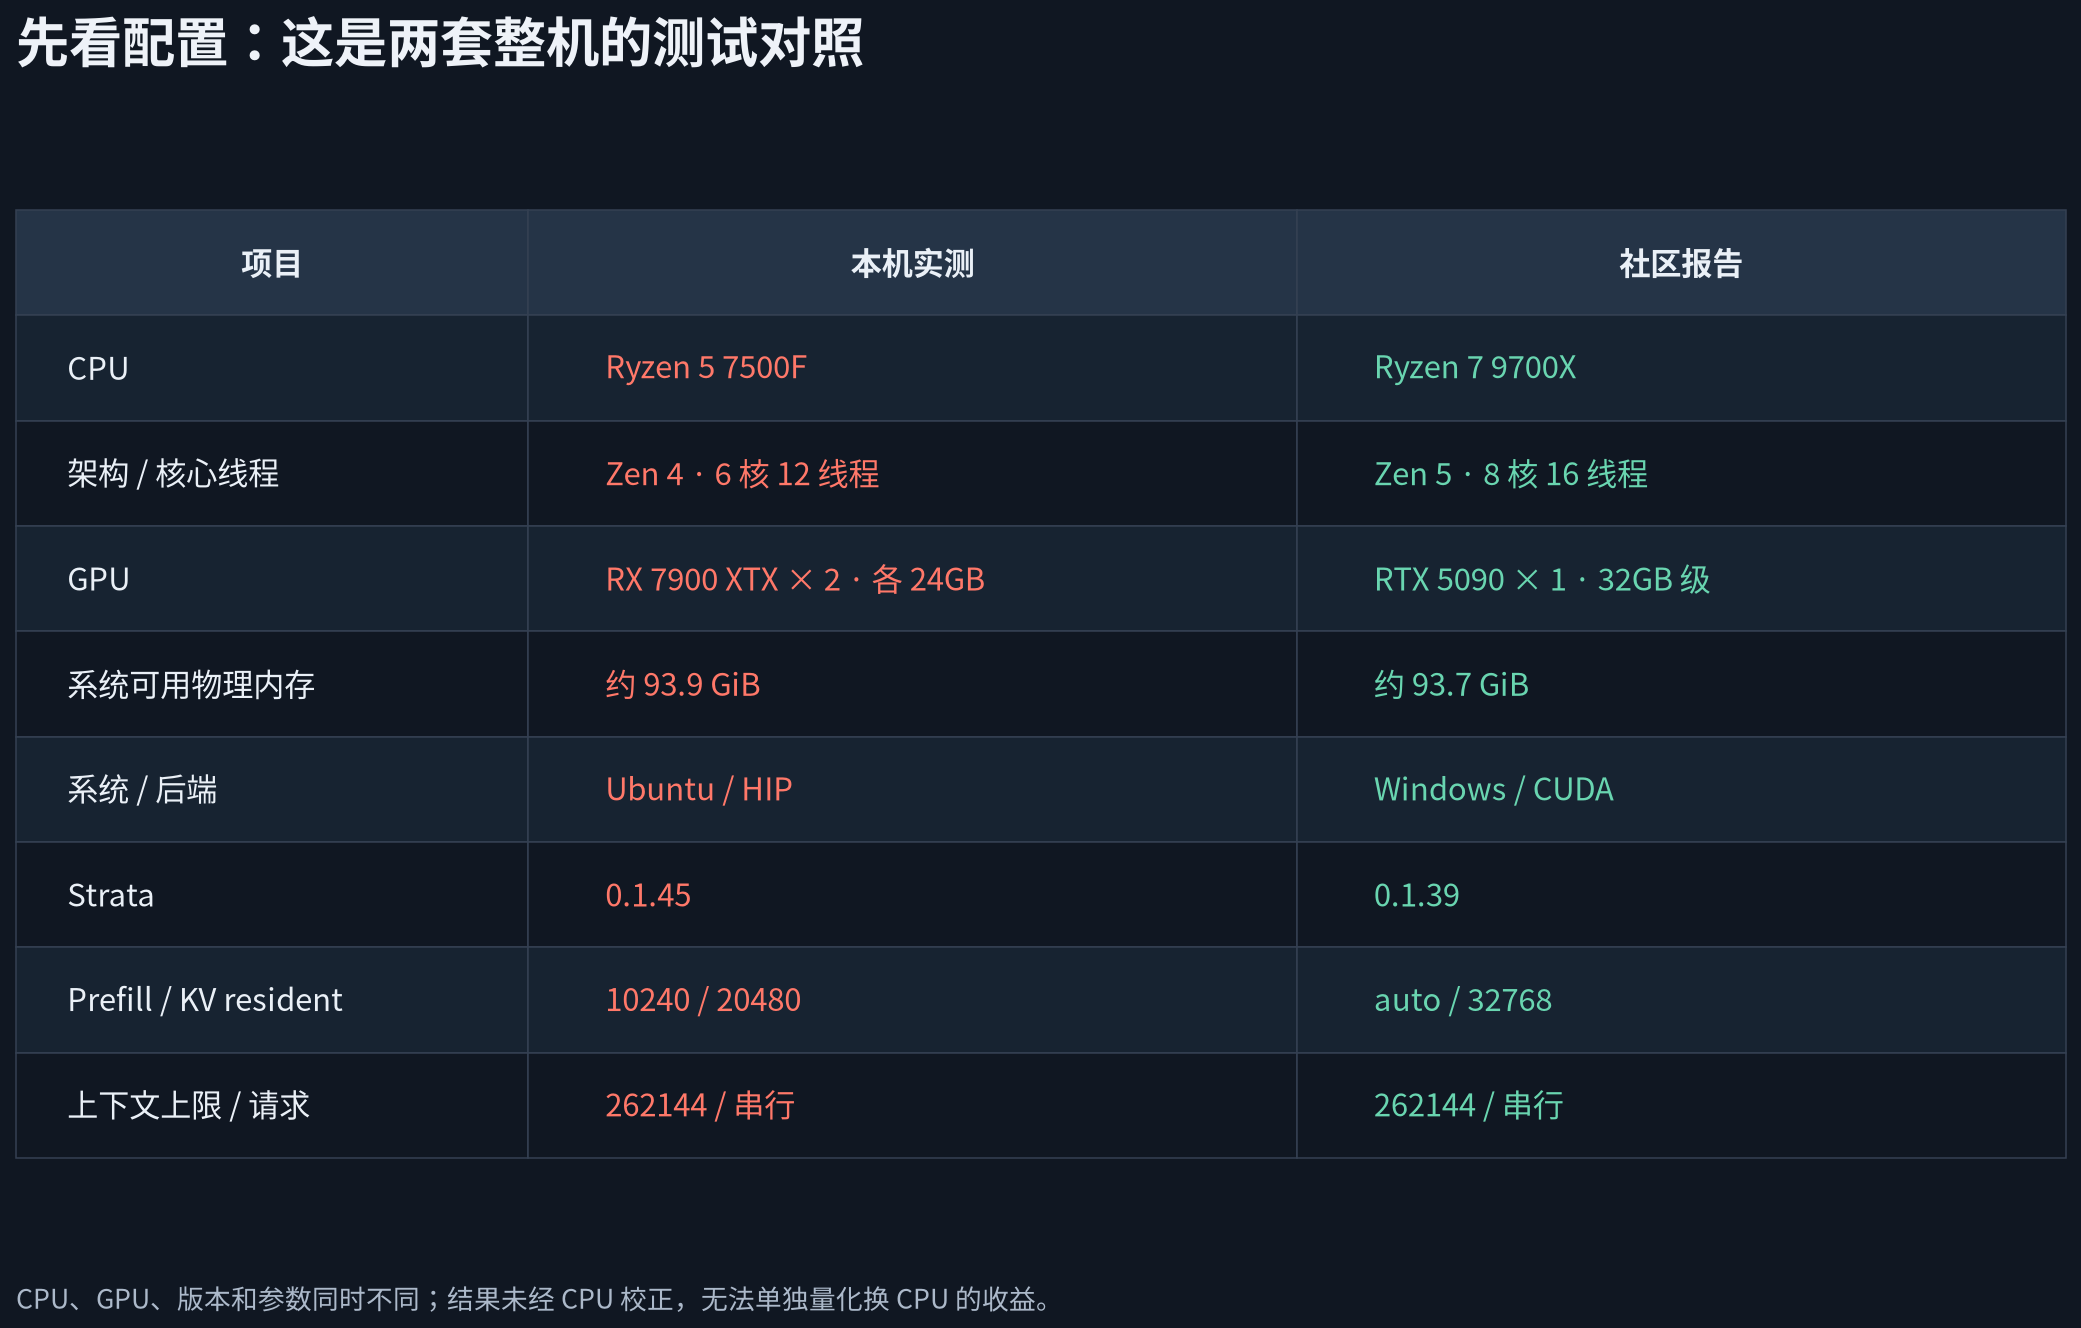
两边机器的基本情况如下:
项目 我的双 7900 XTX 主机 5090 社区报告 GPU RX 7900 XTX × 2,每张 24GB RTX 5090 × 1,32GB 级显存 CPU Ryzen 5 7500F,6 核 12 线程 Ryzen 7 9700X,8 核 16 线程 CPU 架构 Zen 4 Zen 5 系统可用物理内存 约 93.9 GiB 约 93.7 GiB 系统 / 后端 Ubuntu 24.04 / HIP Windows / CUDA Strata 0.1.45,本次保持原版本 0.1.39 模型 Qwen3.8-Flash-Next-GSQ-RCO IQ3_S 同型号 IQ3_S 本次上下文上限 262,144 262,144 运行方式 单个请求顺序执行 单个请求顺序执行 Prefill 参数 10240,使用本机调优表 auto KV / 常驻 token 数 int8 / 20480 int8 / 32768 推测解码 spec=3,加载 MTP,suffix-draft=4 请求 spec=4,报告启动时有效 spec=6,启用 MTP 和 prompt lookup 服务槽位 1 2(本次对照请求仍串行) CPU 的差别需要单独说明。按 AMD 官方规格,7500F 是 Zen 4、6 核 12 线程,9700X 是 Zen 5、8 核 16 线程。规格来源:7500F 官方页面、AMD Ryzen 9000 发布资料。
在 Strata 这类涉及主机端调度、系统内存和 GPU 数据传输的负载里,CPU 与平台条件可能影响整机成绩。9700X 的核心数更多、架构更新,CPU 侧处理可能更有余量;但本次没有记录足够的 CPU 阶段耗时,也没有做同机换 CPU 的测试,所以尚不能确认 7500F 是否构成本次瓶颈,更不能算出换成 9700X 会快多少。核心数多约三分之一,也不能换算成 Strata 快约三分之一。
双卡是每张各有 24GB 显存,通过 layer split 分配工作。这个模型还涉及专家缓存、系统内存和数据传输。因此,本帖比较的是“7500F+双 7900 XTX+Strata 0.1.45”和“9700X+5090+Strata 0.1.39”两套实际系统。84.1% 这个比例没有做 CPU 性能校正,也没有足够依据进行这种校正。
这次具体怎么测?
我使用了对照报告提供的
benchmark.py。本机副本仅为 localhost 请求绕过代理,提示词生成逻辑和统计口径保持原样:模型加载完成后做一次短请求预热,然后依次测试 4,096、32,768、128,000、261,880 tokens,每档三次,不在各轮之间额外冷却。提示词是一大段合成 Python 函数,再要求模型解释代码。每次提示开头有不同 nonce;提交前用本机 tokenizer 和聊天模板计数,再核对引擎记录。12 次正式请求的输入长度都与目标相符,
reused = 0,并且全部生成到 256 tokens 上限,结束原因为length。请求参数为
temperature=0、reasoning_effort=none、max_tokens=256,使用流式输出。统计方式也与对照报告一致:Prefill = 本次新读取的输入 token 数 ÷ prompt_ms × 1000 Decode = engine_generated ÷ decode_ms × 1000 TTFT = 客户端提交请求到收到首个流式内容 token 的时间表格统一使用三次中位数,括号保留最小值和最大值。模型装载时间不计入吞吐量。这里没有进行针测召回或答案质量测试,因此速度结果不代表长文本理解或编程质量。
先看最关心的 prefill。
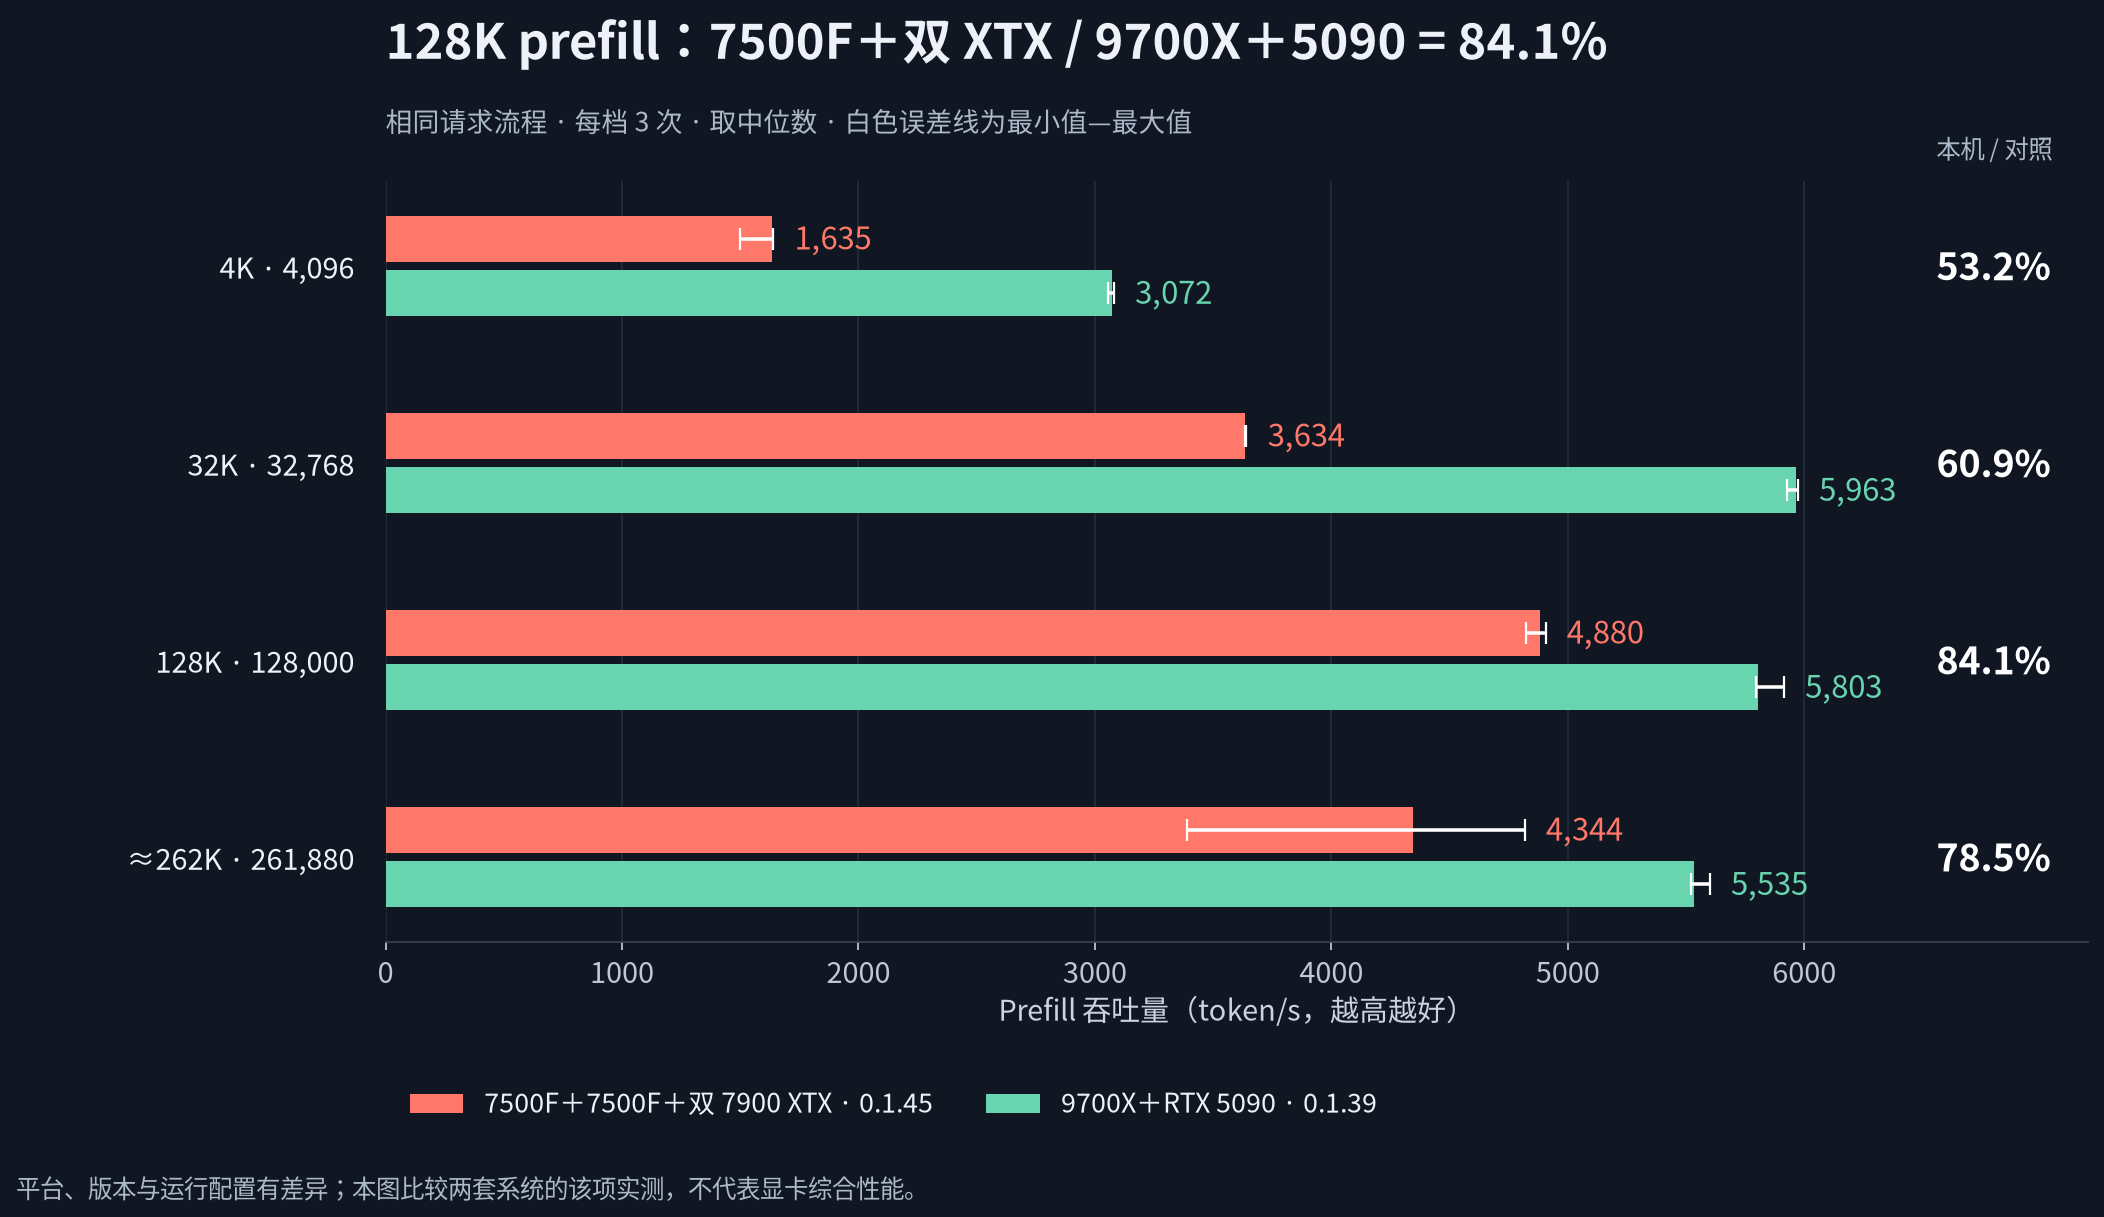
实际输入 tokens 7500F+双 7900 XTX,token/s 9700X+5090,token/s 本机 / 对照主机 4,096 1,635(1,500–1,639) 3,072(3,056–3,080) 53.2% 32,768 3,634(3,633–3,641) 5,963(5,925–5,973) 60.9% 128,000 4,880(4,822–4,906) 5,803(5,794–5,914) 84.1% 261,880 4,344(3,389–4,817) 5,535(5,522–5,600) 78.5% 图中的柱子是中位数,白色误差线表示三次的完整范围。比例用未取整的本机中位数计算。
最符合我预期用途的是 128K 这一档:三轮都在 4,822–4,906 token/s,结果比较集中。相比短提示,这套双卡配置在长输入下与那份 5090 报告的相对差距明显缩小。
但它并没有稳定突破 5,000 token/s。这次最高的一轮约为 4,906,不能把标题写成“128K 稳定 5000+”。而且从 4K 到 128K 的成绩变化,也不能直接推导为“上下文开得越大,速度就越快”;这里每一档改变的是实际输入长度,完整四档测试都在同一个 262,144 上限下完成。
读完输入有多快,和随后吐字有多快,是两件都要看的事。
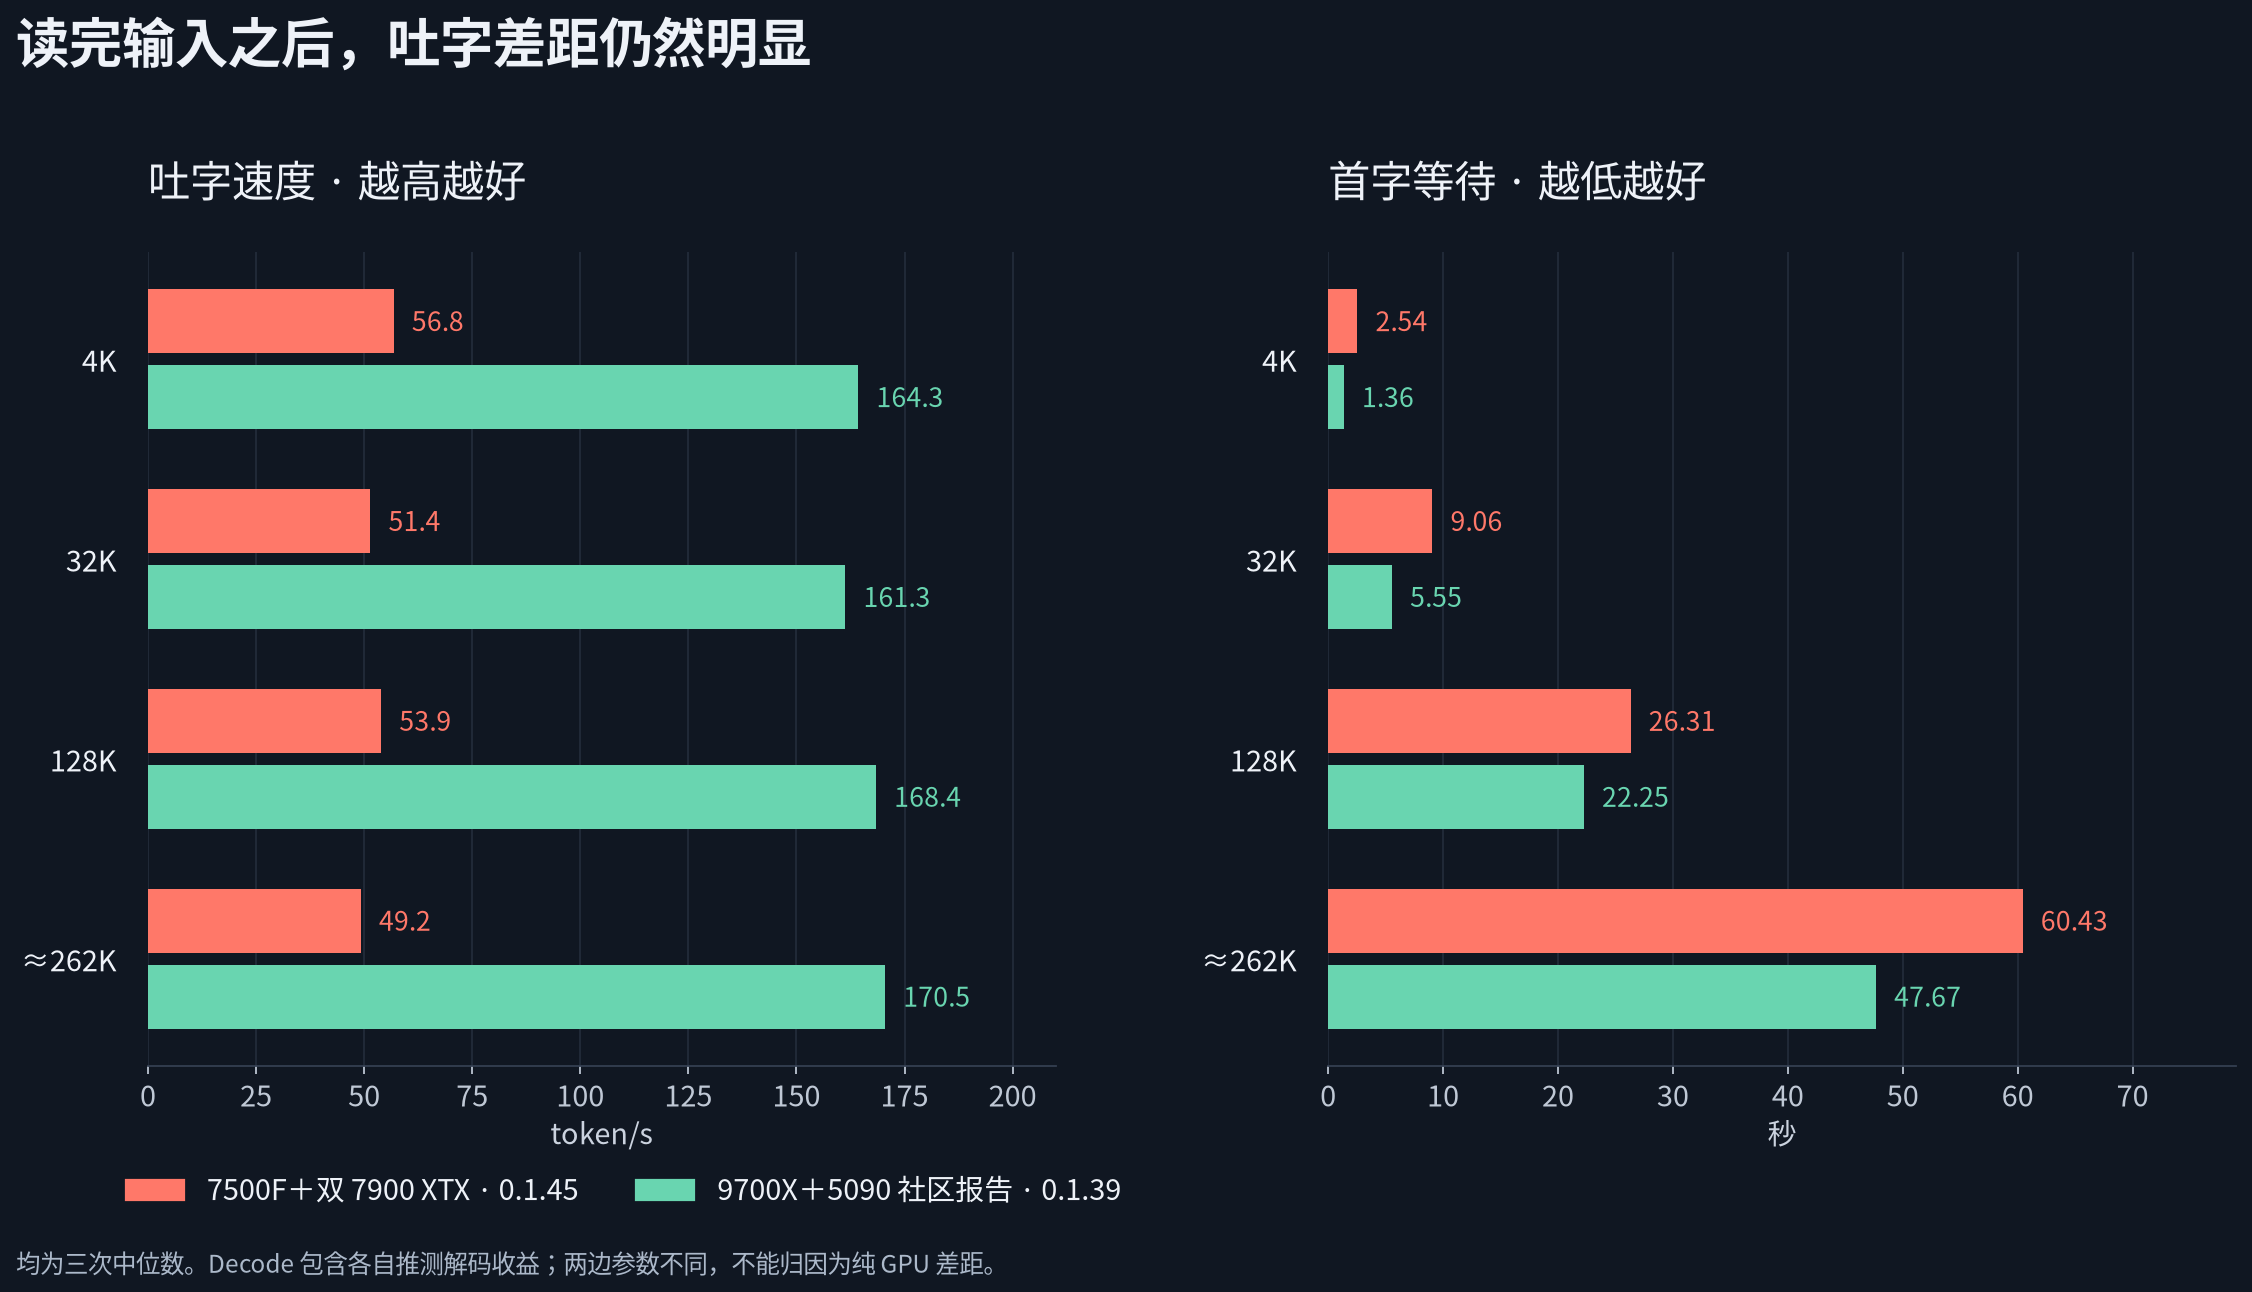
输入 tokens 双卡 Decode,token/s 5090 Decode,token/s 双卡 TTFT,秒 5090 TTFT,秒 4,096 56.8 164.3 2.54 1.36 32,768 51.4 161.3 9.06 5.55 128,000 53.9 168.4 26.31 22.25 261,880 49.2 170.5 60.43 47.67 都是三次中位数。比如 128K 时,我这台机器的首字等待约 26.31 秒,对照报告为 22.25 秒,相差约 4.06 秒;但开始输出后,双卡约 53.9 token/s,对方约 168.4 token/s,差距仍然很大。
所以,如果我主要关心把一大段代码或资料读进去的速度,128K prefill 的成绩对我有参考价值。如果经常需要生成很长的回答,就要把 Decode 一起看。两边还启用了不同的推测解码配置,因此这组吐字差距包含软件参数带来的影响。
接近满窗口的三轮,不能只挑最好看的一次。
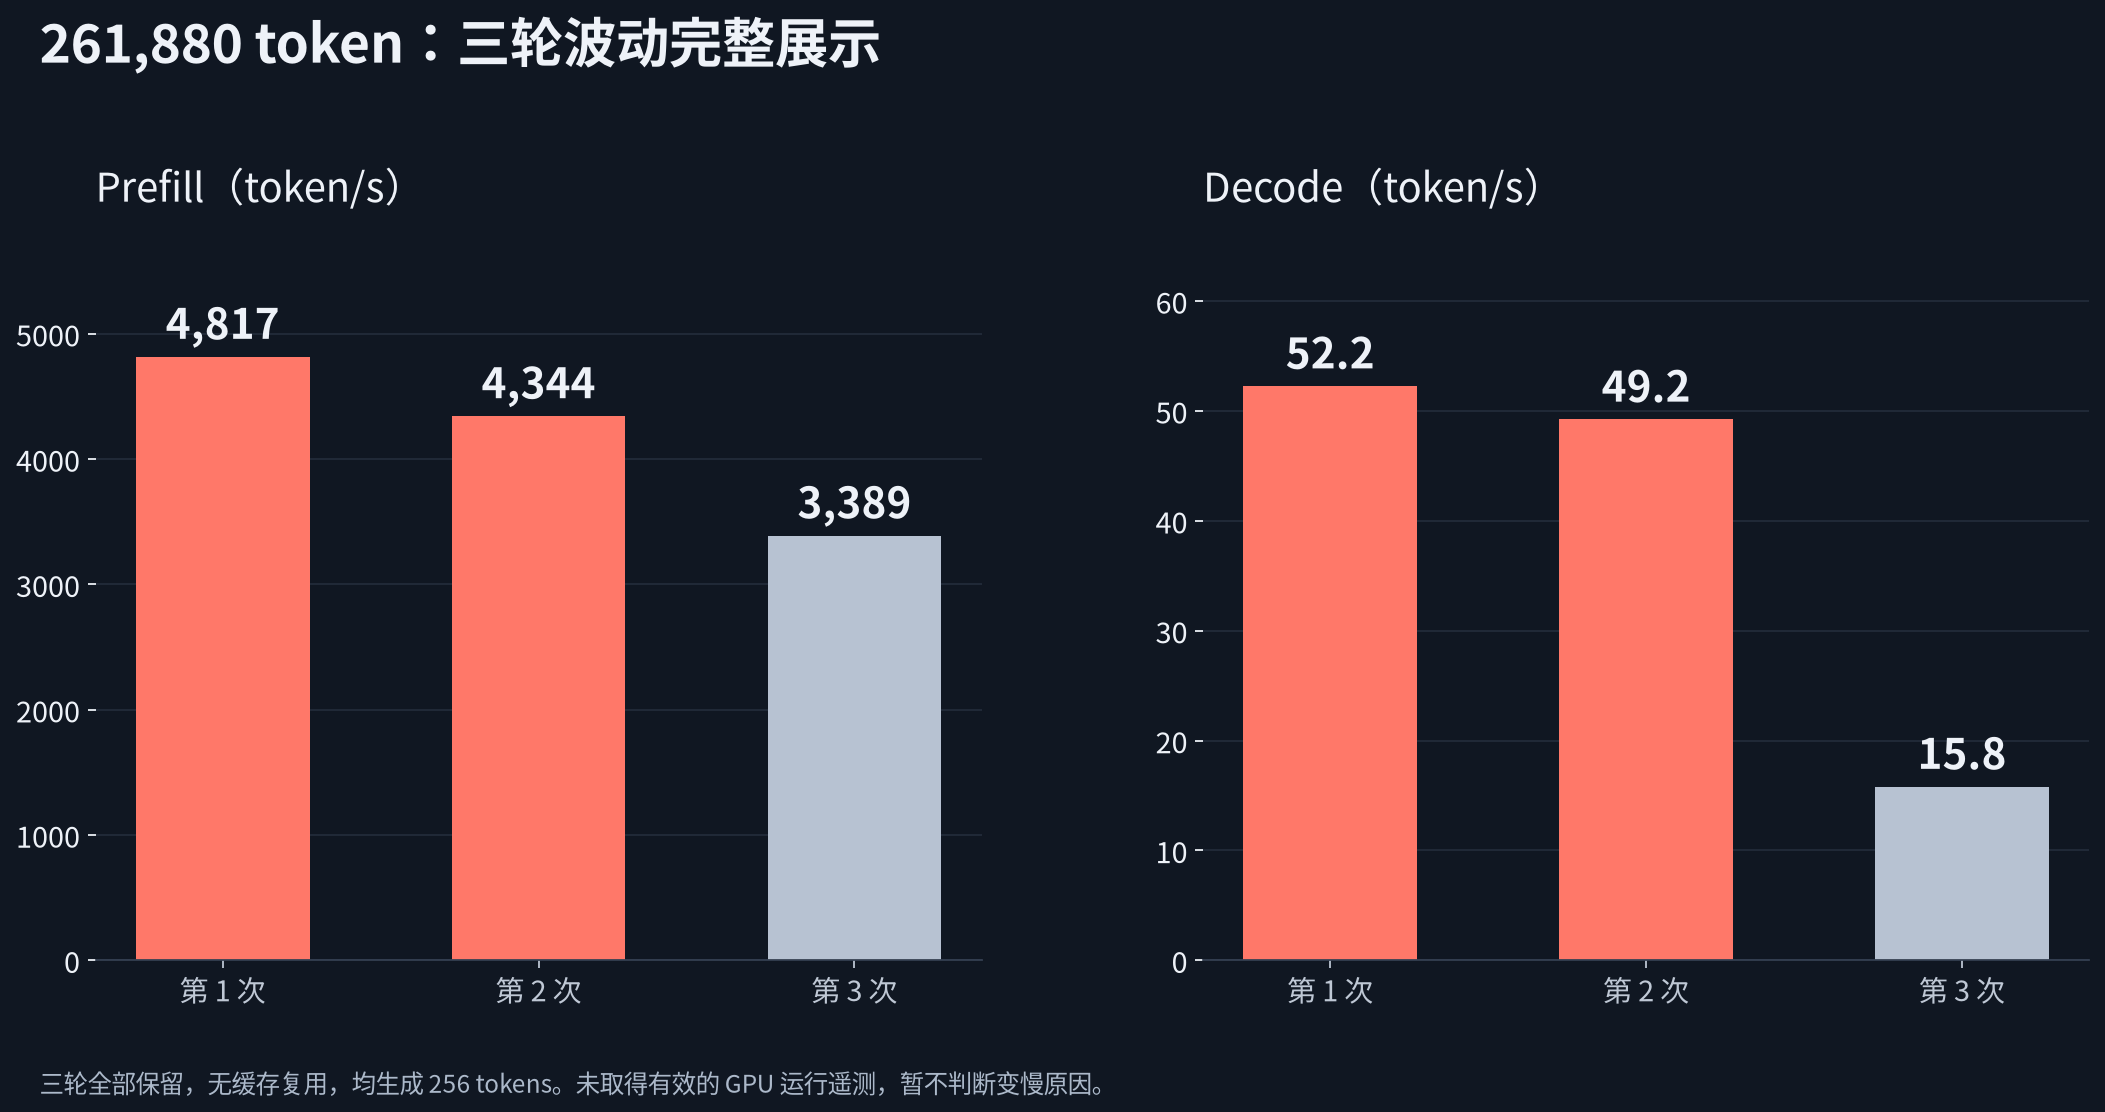
261,880 tokens Prefill,token/s Decode,token/s TTFT,秒 第 1 次 4,817 52.2 54.51 第 2 次 4,344 49.2 60.43 第 3 次 3,389 15.8 77.42 第三次连吐字也明显下降了。我保留这轮,没有删掉后用最好成绩去比。按约定的中位数是 4,344 token/s;但从这三次结果看,接近满窗口时的稳定性确实没有 128K 那么好。
这次基准脚本原带的监控只采集 NVIDIA 遥测,在 AMD 主机上没有留下有效的 GPU 功耗、频率记录。所以我目前不能把第三轮变慢归因于温度、显存迁移、系统内存压力或某个内核路径,需要进一步监控才能确定原因。
想复现的朋友,可以先参考本机这套配置。
双卡 layer split 为
24,使用两张卡,线程设置为8。模型、PLE 和 MTP 路径按本机实际文件填写,主要参数如下:--expert-cache auto --prefill 10240 --spec 3 --spec-min-p 0.5 --max-context 262144 --kv int8 --kv-resident 20480 --suffix-draft 4 --vram-reserve-mib 704 --pipeline-windows 2 --layer-split 24同时加载本机的 expert profile 和 MTP 文件。环境变量如下:
STRATA_STAGE_TRIM=1
STRATA_PCIE_AUTO_SPLIT=1
STRATA_PF_FUSED=1
STRATA_PF_GEMM=1
STRATA_GDN_CHUNKED=1
STRATA_HIP_WMMA=1
STRATA_SCORES_THREAD=1
STRATA_SELECT_SIMT=1
此外还设置了
STRATA_HIPBLASLT_TUNING,指向本机为 gfx1100 / prefill 10240 保存的调优表。这意味着,上面的命令参数还不足以保证在另一台机器上复现完全相同的数字;配套文件、双卡连接与硬件条件都要记录。测试后我已经恢复日常使用的 131,072 上下文配置。最后再说明比较范围:这次对齐的是基准请求流程。我的 Strata 是 0.1.45,5090 报告是 0.1.39;平台、CPU、GPU 数量和参数也有差异,例如本机
prefill=10240 / kv-resident=20480 / spec=3,对照报告为prefill=auto / kv-resident=32768,推测解码设置亦不同。模型文件同属 IQ3_S 且两片文件大小相符,但没有进一步核对 revision 与文件哈希。因此我愿意用这次结果回答:“我的 7500F+双 7900 XTX 主机在这个 Strata IQ3_S 长输入测试里处在什么位置?”——128K prefill 约为那台 9700X+5090 主机公开成绩的 84%,短输入与吐字仍有明显差距,满窗口还存在值得继续排查的波动。至于购买性价比、功耗效率和所有任务的综合性能,这次数据还回答不了。
如果论坛里还有 同模型 IQ3_S、同一脚本的其他显卡结果,欢迎贴上版本、配置和三轮原始数据,尤其想看看更多双 7900 XTX 或新版 Strata 下的 5090 成绩。
-
-
-
我这台主机用的是 Ryzen 5 7500F+双 RX 7900 XTX。这次想弄明白:用 Strata 跑 IQ3_S,这套机器和公开的 9700X+RTX 5090 主机相比,实际处在什么位置?
之前看过不少“几千 token/s”的成绩,但提示长度、缓存和测试方法不一样,直接摆在一起容易误判。这次我找到了 Strata 仓库里一份 RTX 5090 + Ryzen 7 9700X 的 IQ3_S 社区报告,照着它附带的脚本,在双 7900 XTX 上重新跑了一遍四档速度测试。
结果先放前面:128,000 token 输入时,我这台双 7900 XTX 的 prefill 中位数为 4,880 token/s,约为那份 5090 报告的 84.1%。 32K 的比例为 60.9%,4K 为 53.2%;接近 262K 时为 78.5%,但波动明显增大。吐字速度的差距也比长上下文 prefill 大得多。
标题里的“84%”,限定的是7500F+双 7900 XTX 这套主机,在 128K prefill 测试中的成绩,占公开的 9700X+5090 主机成绩的比例。两边 CPU、GPU 数量、软件版本和参数都有差异,下面先把这些条件摆在一起。
对照来源:Strata 社区 RTX 5090 / 9700X / IQ3_S 测试报告。5090 数据来自这份公开记录,双 7900 XTX 数据为本机 2026 年 10 月 24 日实测。
两边机器的基本情况如下:
项目 我的双 7900 XTX 主机 5090 社区报告 GPU RX 7900 XTX × 2,每张 24GB RTX 5090 × 1,32GB 级显存 CPU Ryzen 5 7500F,6 核 12 线程 Ryzen 7 9700X,8 核 16 线程 CPU 架构 Zen 4 Zen 5 系统可用物理内存 约 93.9 GiB 约 93.7 GiB 系统 / 后端 Ubuntu 24.04 / HIP Windows / CUDA Strata 0.1.45,本次保持原版本 0.1.39 模型 Qwen3.8-Flash-Next-GSQ-RCO IQ3_S 同型号 IQ3_S 本次上下文上限 262,144 262,144 运行方式 单个请求顺序执行 单个请求顺序执行 Prefill 参数 10240,使用本机调优表 auto KV / 常驻 token 数 int8 / 20480 int8 / 32768 推测解码 spec=3,加载 MTP,suffix-draft=4 请求 spec=4,报告启动时有效 spec=6,启用 MTP 和 prompt lookup 服务槽位 1 2(本次对照请求仍串行) CPU 的差别需要单独说明。按 AMD 官方规格,7500F 是 Zen 4、6 核 12 线程,9700X 是 Zen 5、8 核 16 线程。规格来源:7500F 官方页面、AMD Ryzen 9000 发布资料。
在 Strata 这类涉及主机端调度、系统内存和 GPU 数据传输的负载里,CPU 与平台条件可能影响整机成绩。9700X 的核心数更多、架构更新,CPU 侧处理可能更有余量;但本次没有记录足够的 CPU 阶段耗时,也没有做同机换 CPU 的测试,所以尚不能确认 7500F 是否构成本次瓶颈,更不能算出换成 9700X 会快多少。核心数多约三分之一,也不能换算成 Strata 快约三分之一。
双卡是每张各有 24GB 显存,通过 layer split 分配工作。这个模型还涉及专家缓存、系统内存和数据传输。因此,本帖比较的是“7500F+双 7900 XTX+Strata 0.1.45”和“9700X+5090+Strata 0.1.39”两套实际系统。84.1% 这个比例没有做 CPU 性能校正,也没有足够依据进行这种校正。
这次具体怎么测?
我使用了对照报告提供的
benchmark.py。本机副本仅为 localhost 请求绕过代理,提示词生成逻辑和统计口径保持原样:模型加载完成后做一次短请求预热,然后依次测试 4,096、32,768、128,000、261,880 tokens,每档三次,不在各轮之间额外冷却。提示词是一大段合成 Python 函数,再要求模型解释代码。每次提示开头有不同 nonce;提交前用本机 tokenizer 和聊天模板计数,再核对引擎记录。12 次正式请求的输入长度都与目标相符,
reused = 0,并且全部生成到 256 tokens 上限,结束原因为length。请求参数为
temperature=0、reasoning_effort=none、max_tokens=256,使用流式输出。统计方式也与对照报告一致:Prefill = 本次新读取的输入 token 数 ÷ prompt_ms × 1000 Decode = engine_generated ÷ decode_ms × 1000 TTFT = 客户端提交请求到收到首个流式内容 token 的时间表格统一使用三次中位数,括号保留最小值和最大值。模型装载时间不计入吞吐量。这里没有进行针测召回或答案质量测试,因此速度结果不代表长文本理解或编程质量。
先看最关心的 prefill。
实际输入 tokens 7500F+双 7900 XTX,token/s 9700X+5090,token/s 本机 / 对照主机 4,096 1,635(1,500–1,639) 3,072(3,056–3,080) 53.2% 32,768 3,634(3,633–3,641) 5,963(5,925–5,973) 60.9% 128,000 4,880(4,822–4,906) 5,803(5,794–5,914) 84.1% 261,880 4,344(3,389–4,817) 5,535(5,522–5,600) 78.5% 图中的柱子是中位数,白色误差线表示三次的完整范围。比例用未取整的本机中位数计算。
最符合我预期用途的是 128K 这一档:三轮都在 4,822–4,906 token/s,结果比较集中。相比短提示,这套双卡配置在长输入下与那份 5090 报告的相对差距明显缩小。
但它并没有稳定突破 5,000 token/s。这次最高的一轮约为 4,906,不能把标题写成“128K 稳定 5000+”。而且从 4K 到 128K 的成绩变化,也不能直接推导为“上下文开得越大,速度就越快”;这里每一档改变的是实际输入长度,完整四档测试都在同一个 262,144 上限下完成。
读完输入有多快,和随后吐字有多快,是两件都要看的事。
输入 tokens 双卡 Decode,token/s 5090 Decode,token/s 双卡 TTFT,秒 5090 TTFT,秒 4,096 56.8 164.3 2.54 1.36 32,768 51.4 161.3 9.06 5.55 128,000 53.9 168.4 26.31 22.25 261,880 49.2 170.5 60.43 47.67 都是三次中位数。比如 128K 时,我这台机器的首字等待约 26.31 秒,对照报告为 22.25 秒,相差约 4.06 秒;但开始输出后,双卡约 53.9 token/s,对方约 168.4 token/s,差距仍然很大。
所以,如果我主要关心把一大段代码或资料读进去的速度,128K prefill 的成绩对我有参考价值。如果经常需要生成很长的回答,就要把 Decode 一起看。两边还启用了不同的推测解码配置,因此这组吐字差距包含软件参数带来的影响。
接近满窗口的三轮,不能只挑最好看的一次。
261,880 tokens Prefill,token/s Decode,token/s TTFT,秒 第 1 次 4,817 52.2 54.51 第 2 次 4,344 49.2 60.43 第 3 次 3,389 15.8 77.42 第三次连吐字也明显下降了。我保留这轮,没有删掉后用最好成绩去比。按约定的中位数是 4,344 token/s;但从这三次结果看,接近满窗口时的稳定性确实没有 128K 那么好。
这次基准脚本原带的监控只采集 NVIDIA 遥测,在 AMD 主机上没有留下有效的 GPU 功耗、频率记录。所以我目前不能把第三轮变慢归因于温度、显存迁移、系统内存压力或某个内核路径,需要进一步监控才能确定原因。
想复现的朋友,可以先参考本机这套配置。
双卡 layer split 为
24,使用两张卡,线程设置为8。模型、PLE 和 MTP 路径按本机实际文件填写,主要参数如下:--expert-cache auto --prefill 10240 --spec 3 --spec-min-p 0.5 --max-context 262144 --kv int8 --kv-resident 20480 --suffix-draft 4 --vram-reserve-mib 704 --pipeline-windows 2 --layer-split 24同时加载本机的 expert profile 和 MTP 文件。环境变量如下:
STRATA_STAGE_TRIM=1
STRATA_PCIE_AUTO_SPLIT=1
STRATA_PF_FUSED=1
STRATA_PF_GEMM=1
STRATA_GDN_CHUNKED=1
STRATA_HIP_WMMA=1
STRATA_SCORES_THREAD=1
STRATA_SELECT_SIMT=1
此外还设置了
STRATA_HIPBLASLT_TUNING,指向本机为 gfx1100 / prefill 10240 保存的调优表。这意味着,上面的命令参数还不足以保证在另一台机器上复现完全相同的数字;配套文件、双卡连接与硬件条件都要记录。测试后我已经恢复日常使用的 131,072 上下文配置。最后再说明比较范围:这次对齐的是基准请求流程。我的 Strata 是 0.1.45,5090 报告是 0.1.39;平台、CPU、GPU 数量和参数也有差异,例如本机
prefill=10240 / kv-resident=20480 / spec=3,对照报告为prefill=auto / kv-resident=32768,推测解码设置亦不同。模型文件同属 IQ3_S 且两片文件大小相符,但没有进一步核对 revision 与文件哈希。因此我愿意用这次结果回答:“我的 7500F+双 7900 XTX 主机在这个 Strata IQ3_S 长输入测试里处在什么位置?”——128K prefill 约为那台 9700X+5090 主机公开成绩的 84%,短输入与吐字仍有明显差距,满窗口还存在值得继续排查的波动。至于购买性价比、功耗效率和所有任务的综合性能,这次数据还回答不了。
如果论坛里还有 同模型 IQ3_S、同一脚本的其他显卡结果,欢迎贴上版本、配置和三轮原始数据,尤其想看看更多双 7900 XTX 或新版 Strata 下的 5090 成绩。
-
-
@懒人烘培 话说 , strata每个版本之间差很多, 0.1.39 太落后了, 另外我的实测是, windows跟 linux也差出好多, 我IQ4 的在windows下平均 80tok/s, 但是到了 ubuntu下面平均能到95tok/s . 双 7900xtx 吐字才50多不太对劲, 看着是不是mtp都没有命中
-
prefill这么猛,decode又这么弱,感觉不太正常
-
6核心的确喂不饱 7900xtx...
长时间几乎满载