
64G 内存硬跑 IQ3_S:245K 上下文实测 155 t/s,专家全驻零分页
-
国庆那篇 4500 单卡跑 125B 的帖子里,我写过一句"60G 机器上的安全档是 IQ2_XS,想上 IQ3_S 得上 96G"。这半个多月我就照这个思路在用,IQ2 也确实够用。
前几天 Strata 更到 0.2.6,我跑了一下它自带的 fit 探测,IQ3_S 给的是 tight——不是不能跑,是"关掉别的程序"。这就勾起了我的好奇心,昨晚干脆把它拉起来跑了一晚上。
先说结果:能跑,而且比我预期好。
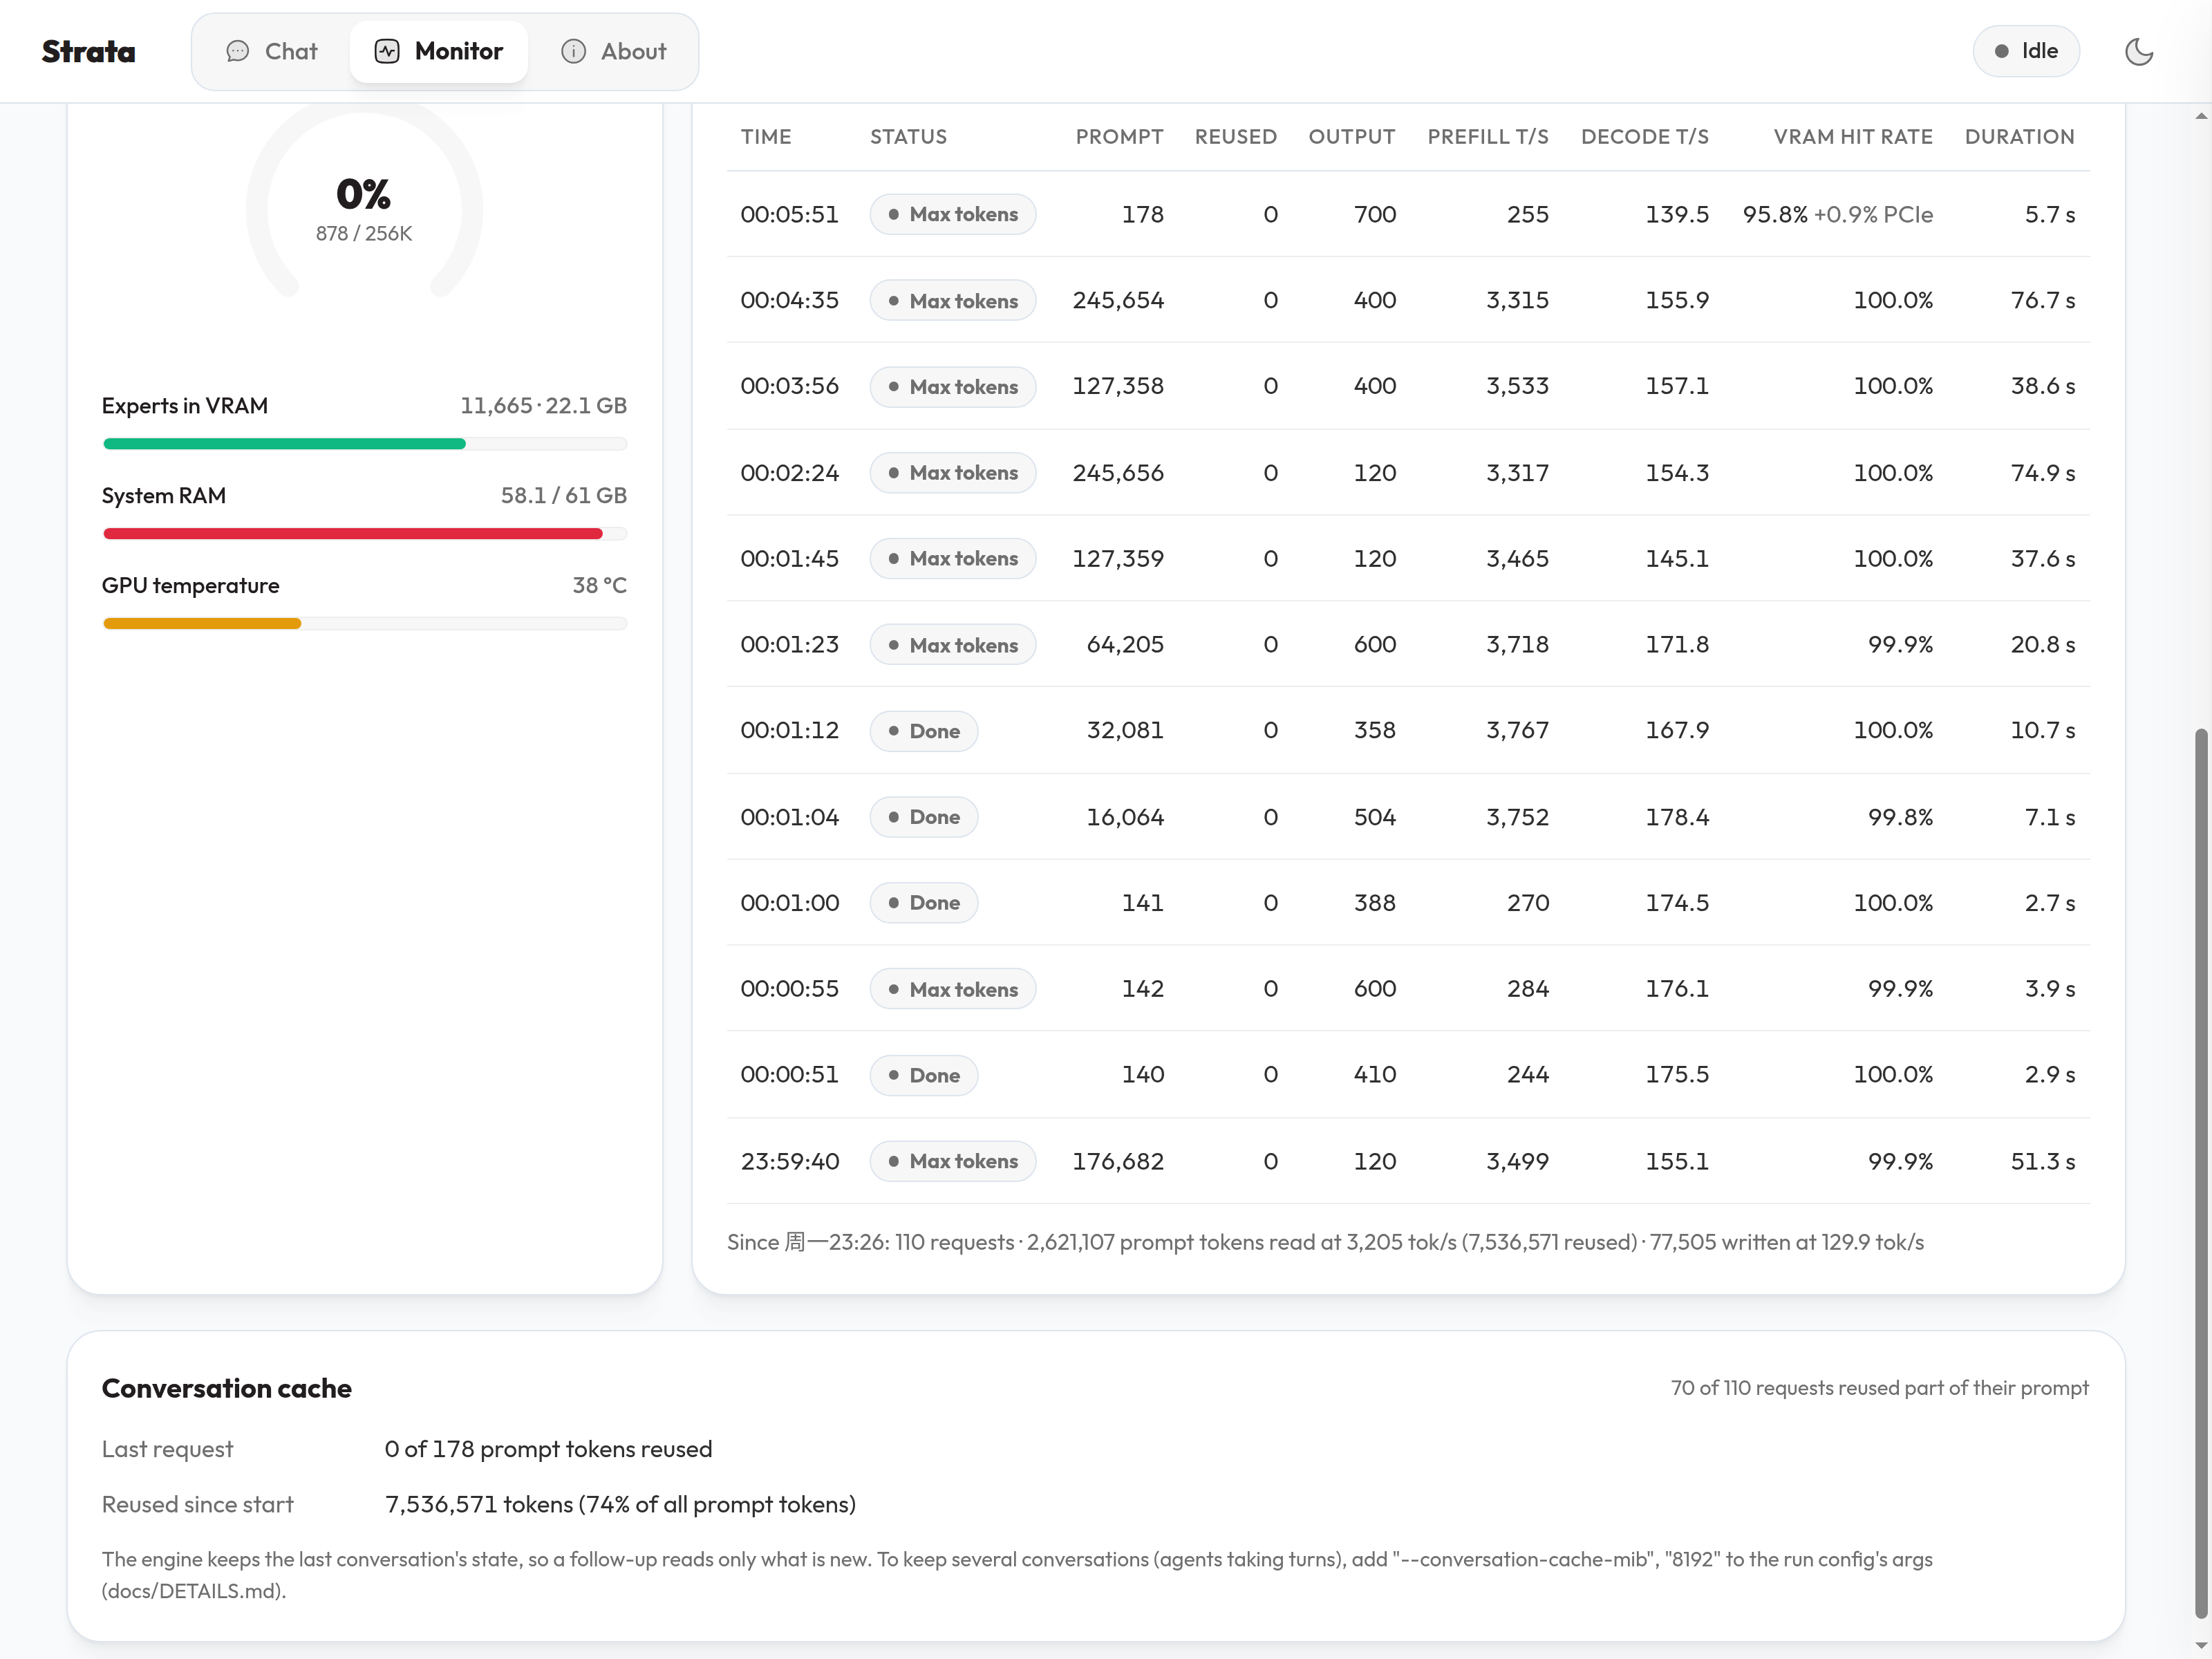
46.8G 的专家全部驻在内存里,没有掉进那种从 SSD 一点点读专家的低内存模式。显存吃到 33.4/34.2G(98%),内存 61.4/65.2G(94%)。数字看着吓人,但这套引擎本来就是拿显存换命中率的;桌面还能正常用,只是余量只剩两个 G 出头。
回头看那句「得上 96G」,是我把模型文件的大小当成内存占用了。IQ3_S 两个文件一共 83.6G,但其中 28.8G 是 n-gram 查表,mmap 在硬盘上按需读,不进内存;真正要驻的是 46.8G 专家,再加一点 KV。按这个账算,60G 的机器刚好够。
速度上我还闹了个笑话。第一版测试是客户端自己数流式分片,中文一个分片里经常塞着两个词,算出来 245K 才 85 t/s,我纳闷了半天怎么比 IQ2 掉这么狠。后来翻引擎的请求记录,同一个请求 155.9 t/s——是我数错了。所以下面都是引擎口径:短提示一百多 token 的时候 175 左右,16K 是 178,64K 171,127K 157,245K 155.9。长上下文基本不掉,这点比我原来估计的强。三万多 token 的提示读进去 3.3K t/s 左右,245K 那个光 prefill 要 74 秒,我觉得能接受。
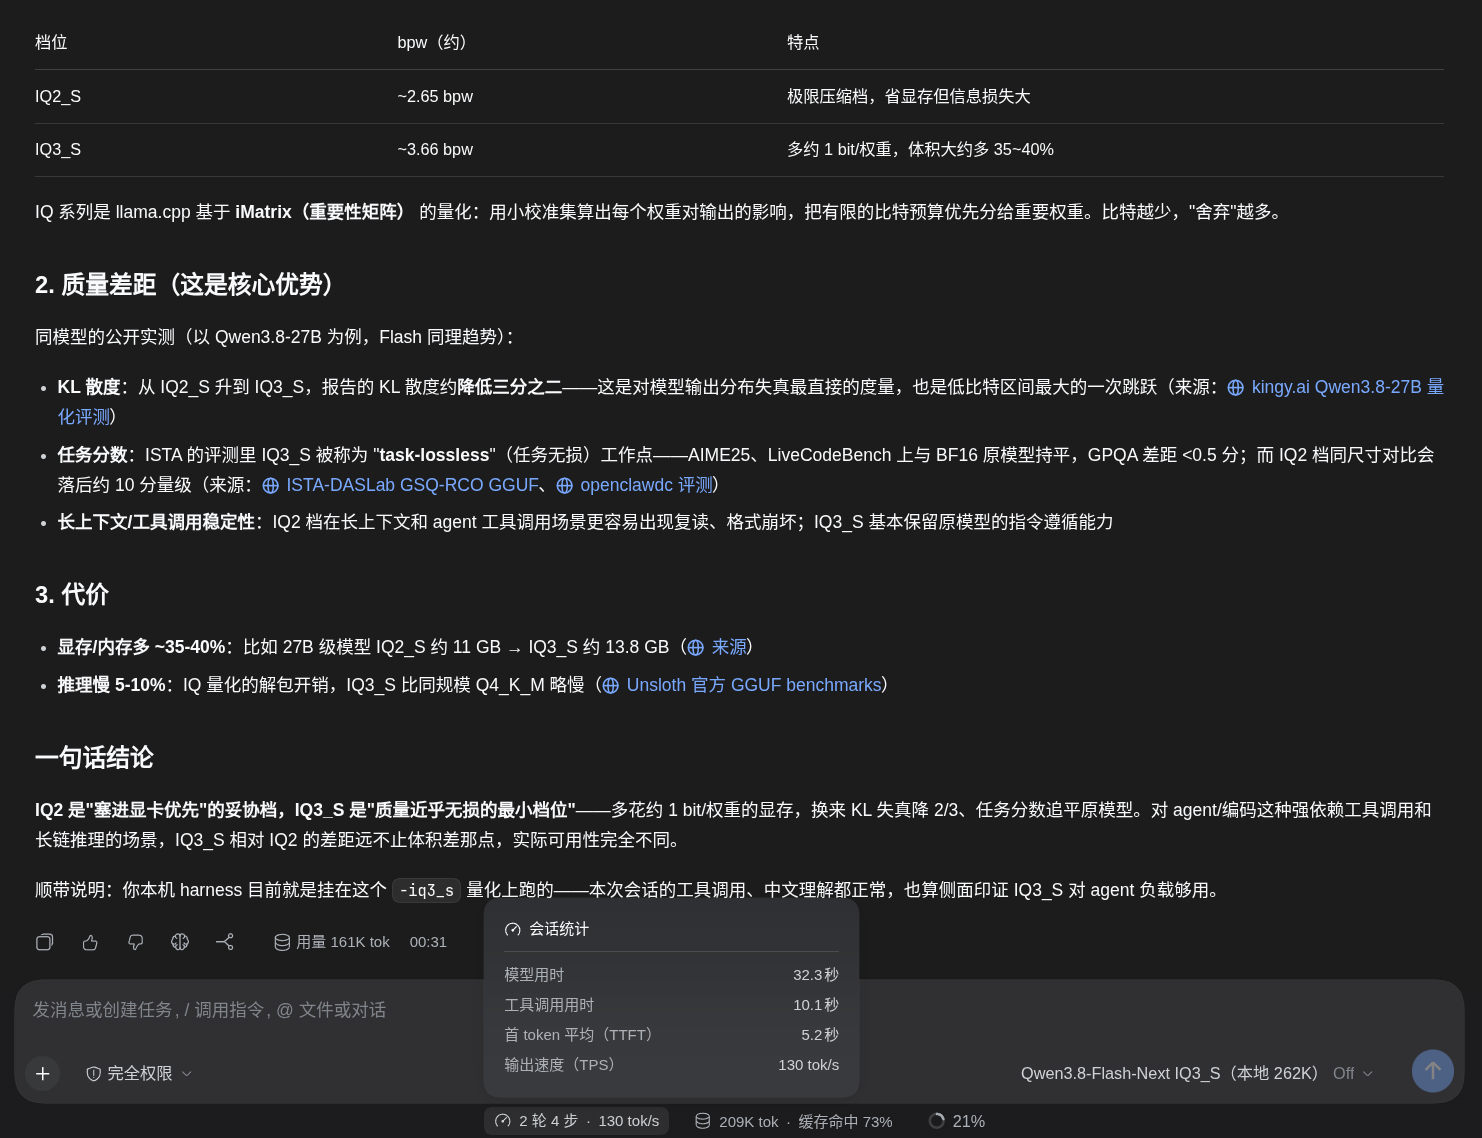
质量这档官方给的是 89 分到 93 分(IQ2 到 IQ3_S,基本贴着满血)。日常能感觉到的,一是推理链长一点不容易中途跑偏,二是写小脚本的时候瞎编 API 的情况少了很多。这四分我认为值。
顺手拿 needle 试了下:32K 上下文、九成深处埋了个密码,问它,捞出来了。
坑也有几个。第一次起服务直接被拦,日志说专家要 46.84G,但这个进程的 cgroup 限额只有 4G,装不下它自己就退了——不是 OOM,是提前拒载,报错写得挺清楚,换个正常终端起就没事。二是我一开始按 2.4 字符一个 token 估长度,凑了个三十三万 token 的提示,直接 HTTP 400,才知道中文大概 1.73 字符一个 token,而且超了 262144 是直接拒不是截断。三是冷启动头几百个 token 专家缓存命中只有八成多,速度会慢一下,别拿那一段下结论,正常聊两轮再看数。
还有个不太好听的现实:内存顶到 94% 以后,引擎把多轮对话的缓存关掉了,日志写着 not enough free RAM to park conversations。每轮都得把前面整段重新读一遍,我那种三万 token 的对话,一问要等十秒左右。IQ2 余量有 13G,能驻四路会话,下一轮只读增量。所以真拿来聊天干活,IQ2 的体感反而顺;IQ3_S 更适合一次问清楚、要质量的事。
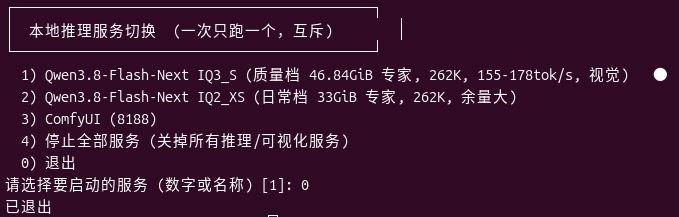
现在两个档我都留着,切换脚本一敲的事:平时 IQ2,要动脑子写东西的时候换 IQ3_S。原来那句"60G 只能将就 IQ2"算是打自己的脸,不过打得挺乐意。
图在下面:面板读数、请求记录表,还有接进 dsh 之后的实际对话(首 token 五秒多,输出 130 t/s,第二轮缓存命中 73%)。
配置没怎么动,还是 262K、kv int8、MTP spec 4,只是把 pack 和两个 gguf 换成 IQ3_S 的。
-
4500+64G RAM
可以用 infernix 引擎跑 QFN nvfp4
====下面參數借你參考(可以視妳情況調整 CTX KV等 )============[b]start_infernix_tp1_qfn.sh[/b]
[code]```
code_text#!/usr/bin/env bash set -euo pipefail DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" UNIT=infernix-qfn-12435-prd UNIT_FILE="$DIR/$UNIT.service" USER_UNIT_DIR="$HOME/.config/systemd/user" PORT=12435 install() { mkdir -p "$USER_UNIT_DIR" ln -sfn "$UNIT_FILE" "$USER_UNIT_DIR/$UNIT.service" systemctl --user daemon-reload echo "installed: $USER_UNIT_DIR/$UNIT.service -> $UNIT_FILE" } ensure_installed() { [[ -e "$USER_UNIT_DIR/$UNIT.service" ]] || install } start() { ensure_installed # 撞車檢查: port 與 GPU0 if ss -tln 2>/dev/null | grep -q ":$PORT "; then echo "FATAL: port $PORT 已被佔用 (strata 或其他腦在跑)。先停對方再啟動本腦。" >&2 exit 1 fi local gpu0_free gpu0_free=$(nvidia-smi --query-gpu=memory.free --format=csv,noheader,nounits -i 0 2>/dev/null || echo 0) if (( gpu0_free < 20000 )); then echo "FATAL: GPU0 剩餘 ${gpu0_free}MiB < 20G,載不進來 (推測有腦已佔卡)。" >&2 exit 1 fi systemctl --user start "$UNIT.service" echo "starting... (warmup 約 2 分鐘) 觀察: $0 logs" } status() { systemctl --user status "$UNIT.service" --no-pager 2>&1 | head -12 curl -s -m 4 "http://127.0.0.1:$PORT/health" && echo || echo "(health 未 responding — 可能仍在 warmup)" } case "${1:-}" in install) install ;; start) start ;; stop) systemctl --user stop "$UNIT.service" ;; status) status ;; logs) tail -n "${2:-40}" "$DIR/logs/serve-12435.log" 2>/dev/null || echo "(尚無 log)" ;; *) echo "用法: $0 [install|start|stop|status|logs]"; exit 1 ;; esac [/code] [b]infernix-qfn-12435-prd.service[/b] [code] [Service] Environment=CUDA_VISIBLE_DEVICES=0 Environment=PATH=/usr/local/bin:/usr/bin:/bin WorkingDirectory=/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn ExecStart=/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIEngine/infernix-serve /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-NVIDIA-NVFP4-Dense8-Infernix-00001-of-00003.infernix --ngram-volume /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-NVIDIA-NVFP4-Infernix.ngram --host 0.0.0.0 --port 12435 --device 0 --expert-ram-mib 40960 --rope-yarn-factor 1 --max-context 131072 --prefill-chunk 4096 --kv-dtype nvfp4 --max-concurrency 4 --vision --spec mtp --draft-tokens auto --spec-min-p 0.5 --lm-head-draft --model-id qwen38-nvfp4-mtp --pending-timeout-ms 180000 --request-log-jsonl /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/requests.jsonl --log-level info # --draft-model /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-DFlash2-Infernix.infernix (dflash2 用;需 --spec dflash2) StandardOutput=append:/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/serve-12435.log StandardError=append:/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/serve-12435.log Restart=on-failure RestartSec=5 TimeoutStartSec=900 [/code] -
4500+64G RAM
可以用 infernix 引擎跑 QFN nvfp4
====下面參數借你參考(可以視妳情況調整 CTX KV等 )============[b]start_infernix_tp1_qfn.sh[/b]
[code]```
code_text#!/usr/bin/env bash set -euo pipefail DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" UNIT=infernix-qfn-12435-prd UNIT_FILE="$DIR/$UNIT.service" USER_UNIT_DIR="$HOME/.config/systemd/user" PORT=12435 install() { mkdir -p "$USER_UNIT_DIR" ln -sfn "$UNIT_FILE" "$USER_UNIT_DIR/$UNIT.service" systemctl --user daemon-reload echo "installed: $USER_UNIT_DIR/$UNIT.service -> $UNIT_FILE" } ensure_installed() { [[ -e "$USER_UNIT_DIR/$UNIT.service" ]] || install } start() { ensure_installed # 撞車檢查: port 與 GPU0 if ss -tln 2>/dev/null | grep -q ":$PORT "; then echo "FATAL: port $PORT 已被佔用 (strata 或其他腦在跑)。先停對方再啟動本腦。" >&2 exit 1 fi local gpu0_free gpu0_free=$(nvidia-smi --query-gpu=memory.free --format=csv,noheader,nounits -i 0 2>/dev/null || echo 0) if (( gpu0_free < 20000 )); then echo "FATAL: GPU0 剩餘 ${gpu0_free}MiB < 20G,載不進來 (推測有腦已佔卡)。" >&2 exit 1 fi systemctl --user start "$UNIT.service" echo "starting... (warmup 約 2 分鐘) 觀察: $0 logs" } status() { systemctl --user status "$UNIT.service" --no-pager 2>&1 | head -12 curl -s -m 4 "http://127.0.0.1:$PORT/health" && echo || echo "(health 未 responding — 可能仍在 warmup)" } case "${1:-}" in install) install ;; start) start ;; stop) systemctl --user stop "$UNIT.service" ;; status) status ;; logs) tail -n "${2:-40}" "$DIR/logs/serve-12435.log" 2>/dev/null || echo "(尚無 log)" ;; *) echo "用法: $0 [install|start|stop|status|logs]"; exit 1 ;; esac [/code] [b]infernix-qfn-12435-prd.service[/b] [code] [Service] Environment=CUDA_VISIBLE_DEVICES=0 Environment=PATH=/usr/local/bin:/usr/bin:/bin WorkingDirectory=/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn ExecStart=/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIEngine/infernix-serve /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-NVIDIA-NVFP4-Dense8-Infernix-00001-of-00003.infernix --ngram-volume /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-NVIDIA-NVFP4-Infernix.ngram --host 0.0.0.0 --port 12435 --device 0 --expert-ram-mib 40960 --rope-yarn-factor 1 --max-context 131072 --prefill-chunk 4096 --kv-dtype nvfp4 --max-concurrency 4 --vision --spec mtp --draft-tokens auto --spec-min-p 0.5 --lm-head-draft --model-id qwen38-nvfp4-mtp --pending-timeout-ms 180000 --request-log-jsonl /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/requests.jsonl --log-level info # --draft-model /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-DFlash2-Infernix.infernix (dflash2 用;需 --spec dflash2) StandardOutput=append:/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/serve-12435.log StandardError=append:/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/serve-12435.log Restart=on-failure RestartSec=5 TimeoutStartSec=900 [/code] -
-
4500+64G RAM
可以用 infernix 引擎跑 QFN nvfp4
====下面參數借你參考(可以視妳情況調整 CTX KV等 )============[b]start_infernix_tp1_qfn.sh[/b]
[code]```
code_text#!/usr/bin/env bash set -euo pipefail DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" UNIT=infernix-qfn-12435-prd UNIT_FILE="$DIR/$UNIT.service" USER_UNIT_DIR="$HOME/.config/systemd/user" PORT=12435 install() { mkdir -p "$USER_UNIT_DIR" ln -sfn "$UNIT_FILE" "$USER_UNIT_DIR/$UNIT.service" systemctl --user daemon-reload echo "installed: $USER_UNIT_DIR/$UNIT.service -> $UNIT_FILE" } ensure_installed() { [[ -e "$USER_UNIT_DIR/$UNIT.service" ]] || install } start() { ensure_installed # 撞車檢查: port 與 GPU0 if ss -tln 2>/dev/null | grep -q ":$PORT "; then echo "FATAL: port $PORT 已被佔用 (strata 或其他腦在跑)。先停對方再啟動本腦。" >&2 exit 1 fi local gpu0_free gpu0_free=$(nvidia-smi --query-gpu=memory.free --format=csv,noheader,nounits -i 0 2>/dev/null || echo 0) if (( gpu0_free < 20000 )); then echo "FATAL: GPU0 剩餘 ${gpu0_free}MiB < 20G,載不進來 (推測有腦已佔卡)。" >&2 exit 1 fi systemctl --user start "$UNIT.service" echo "starting... (warmup 約 2 分鐘) 觀察: $0 logs" } status() { systemctl --user status "$UNIT.service" --no-pager 2>&1 | head -12 curl -s -m 4 "http://127.0.0.1:$PORT/health" && echo || echo "(health 未 responding — 可能仍在 warmup)" } case "${1:-}" in install) install ;; start) start ;; stop) systemctl --user stop "$UNIT.service" ;; status) status ;; logs) tail -n "${2:-40}" "$DIR/logs/serve-12435.log" 2>/dev/null || echo "(尚無 log)" ;; *) echo "用法: $0 [install|start|stop|status|logs]"; exit 1 ;; esac [/code] [b]infernix-qfn-12435-prd.service[/b] [code] [Service] Environment=CUDA_VISIBLE_DEVICES=0 Environment=PATH=/usr/local/bin:/usr/bin:/bin WorkingDirectory=/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn ExecStart=/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIEngine/infernix-serve /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-NVIDIA-NVFP4-Dense8-Infernix-00001-of-00003.infernix --ngram-volume /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-NVIDIA-NVFP4-Infernix.ngram --host 0.0.0.0 --port 12435 --device 0 --expert-ram-mib 40960 --rope-yarn-factor 1 --max-context 131072 --prefill-chunk 4096 --kv-dtype nvfp4 --max-concurrency 4 --vision --spec mtp --draft-tokens auto --spec-min-p 0.5 --lm-head-draft --model-id qwen38-nvfp4-mtp --pending-timeout-ms 180000 --request-log-jsonl /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/requests.jsonl --log-level info # --draft-model /home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/AIModel/Qwen3.8-Flash-Next-DFlash2-Infernix.infernix (dflash2 用;需 --spec dflash2) StandardOutput=append:/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/serve-12435.log StandardError=append:/home/alpha/Applications/AISystem/PRD/infernix_tp1_nvfp4/start_infernix_tp1_qfn/logs/serve-12435.log Restart=on-failure RestartSec=5 TimeoutStartSec=900 [/code] -



