
双7900 XTX MiniMax-H3 Turbo:TP2 优化思路,八档分辨率实测与复现方法
-
双 RX 7900 XTX 跑 MiniMax-H3 Turbo:TP2 优化思路、八档分辨率实测与复现方法
本机测试记录整理,本文聚焦 124 帧 / 24 fps / 8 步的单卡与双卡 TP2 对照,附工作流、首帧、代码快照、逐次 all_reduce 记录及重算脚本。硬件/软件、计时口径和当前限制一并公开,方便大家复现、讨论。
这轮主要想回答两个问题:双张 24 GiB 的 RX 7900 XTX 在 MiniMax-H3 上,张量并行能把采样加速到什么程度?分辨率提高以后,跨卡通信会不会成为瓶颈?
本机八档实测的采样加速比为 1.88~1.96×。其中 1920×1088、124 帧的单卡为 149.10 秒/步,TP2 为 77.24 秒/步,对应 1.93×,这次完整工作流成功结束。这里的“没有 OOM”严格限定在这个帧数和配置下;也不能把采样加速比理解成整段视频生成时间缩短到原来的约一半。
1. 测试范围与复现边界
思路来自 2665 主帖,TP 代码基于其关联的 2643 第 17 楼 公开代码,加入本地适配。参考帖的原始代码和本机差异可以通过附件里的版本记录及 diff 追踪。
需要先说明几个会影响对照的差异:
- 本机用 INT8 ConvRot DiT,原生
UNETLoader/ comfy-kitchen 路径;不能把它标成作者的 W4A8 实现。 - 本机 TP 是公开代码的适配版,并未取得主帖私有
comfyui-tp2插件及run_case.sh等完整工具链。 - Turbo LoRA 用 v4 step600 EMA 的 416 张量 pruned ComfyUI 转换候选;本地文件有完整哈希,但无法确认与楼主逐文件相同。
- 提示词和首帧是本地统一素材,不是楼主原素材。单卡、TP2 之间保持相同。
- 没有把 PDD 与 Turbo 叠加。虽然环境中安装过 PDD/Turbo 自定义节点,这次实际工作流使用普通
LoraLoaderModelOnly加载 Turbo。 - 速度表是单次完成运行的记录,不是多轮预热后的统计平均;没有置信区间。832×480 单卡沿用之前同设置的有效运行,其余单卡来自分辨率扫描;TP2 采用后来完整完成的通信 profile 重跑。
因此,本文是这台机器上的可检查实验记录,能够复现流程和指标定义。
2. 平台与固定参数
项目 本机配置 CPU AMD Ryzen 5 7500F,6 核 12 线程 GPU RX 7900 XTX ×2,每卡 sysfs 报告约 23.98 GiB 系统内存 系统报告可用物理容量约 93.90 GiB;具体基线空闲量会变化 PCIe 原测试记录为两卡 PCIe 4.0 ×8;没有用物理链路计数器代替 collective payload 系统 Ubuntu 24.04.5 LTS;整理时内核 7.0.0-38-generic Python / PyTorch Python 3.12.3;PyTorch 2.11.0+rocm7.2,torchvision 0.26.0+rocm7.2 ComfyUI v0.43.0,commit 426f5eea52a7ece1dd599fff4cb6cd1f352ddd24comfy-kitchen / comfy-aimdo 0.2.40 / 0.6.0 文本编码器 CPU;两个 TP rank 各自进行条件准备 视频 / 音频 VAE FP16 视频 VAE、FP32 音频 VAE,GPU 执行,受内存管理影响 Attention 两种模式都启用 --use-ck-attention采样 Euler + simple,BasicGuider,8 步,denoise=1.0,seed=145 Turbo 强度 1.0;不混用 PDD 的采样配方 视频 所有性能表项目为 124 帧、24 fps,即约 5.17 秒 TP2 两个 ComfyUI 进程,每个进程只暴露一张卡,RCCL world_size=2 通信 原始 profile 的真实张量 dtype 为 torch.bfloat16,SUM all_reduce,没有跳过归约软件快照见 environment/repositories.json、Python 包版本。这些文件记录整理时仍在使用的环境;没有把未留存的 BIOS、功耗墙、风扇、CPU/GPU 时钟等信息补写成固定实验参数。
共同启动参数:
--use-ck-attention
--disable-smart-memory
--disable-pinned-memory
--disable-async-offload
--reserve-vram 2
环境变量与历史启动脚本见 environment/historical-start_tp2.sh。原帖的
COMFY_TP_AR_DTYPE、COMFY_TP_AR_SKIP、COMFY_TP_ROW_BF16不是这份适配代码的开关,直接设置这些名字不能认为生效。本机设置
TP_SHARED_ACT_SCALE=0,关闭公开旧实现额外的激活 scale MAX 归约,保留正常计算所必需的 SUM 归约;TP_WIRE=bf16也保留在启动环境中。不过这次共享 scale 路径已关闭,通信 dtype 以逐调用记录中的torch.bfloat16为准,不靠环境变量名推断。3. 模型文件:同名不代表同文件
下面列的是本轮工作流真正引用的文件。SHA-256 在整理本文时重新读取完整文件计算,LoRA 哈希也与原测试 manifest 一致;附件不包含大模型权重。
相对模型目录的路径 文件字节数 SHA-256 diffusion_models/minimax_h3_fl2va_pruned_int8_convrot.safetensors20,970,379,616 e889202c41dafb67b10d67b97f0d8541508036a6090af23425a5c2615d03c47atext_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors27,141,342,152 bc2ced0fbea64757fa9acddccfc0b3f4819d1dcf1da6c124d690d368be283923vae/minimax_h3_video_vae_fp16.safetensors5,207,808,496 7c1f131492e7eddacaac9069a61b81bdd39de5cc96561e677c5eab1cdce5e522vae/minimax_h3_audio_vae_fp32.safetensors605,254,808 8e505d95dd1561d47abd43d4238fd40d9bb1ae9e147ed0a4cba778d76ae4db48loras/minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors620,285,592 7098acf3ee75028fd9fcd948f50fcc8d995057fabb76f86bd3ca2c0ffc58e409模型可放在独立共享目录,子目录为
diffusion_models/、text_encoders/、vae/、loras/。已有同哈希文件即可复用,避免重复下载。Turbo 转换候选的已记录来源为 drbaph/MiniMax-H3-Turbo-Lora-ComfyUI。本次有效的是 620,285,592 字节、416 个 A/B 张量的 pruned 文件,不是 779,849,816 字节、518 张量的原版文件;不能因为都叫 step600 EMA 就混用。
本轮没有重新确认其他大权重的公开下载源,复现时先按完整文件哈希核对已有权重。若更换量化文件、LoRA 或 VAE,应另开实验记录,不能沿用本表的结果标签。
4. 优化的设计思路
4.1 TP2 切的是同一层计算,不是同时生成两段视频
两个 rank 处理同一视频、相同的条件和噪声。主要把 attention 和 FFN 的大矩阵分成两半:
相同输入 → rank0 本地半幅矩阵计算 ─┐
                                  ├─ SUM all_reduce → 完整层输出 → 下一层
相同输入 → rank1 本地半幅矩阵计算 ─┘
Attention 的 56 个 head 分成每卡 28 个。QKV 在 Q、K、V 各段分别取对应 head,不能把整个拼接矩阵粗暴切成上下两半。输出投影按输入通道切,各卡算出部分和,随后 SUM all_reduce。
FFN 的
fc1包含 gate/up 两段,两段都按相同区间取一半;fc2按输入维切分,再对结果 SUM。对这套固定结构,每卡 QKV 输出维为 10752,attention out_proj 输入维为 3584,fc1 输出维为 14336,fc2 输入维为 7168。4.2 在构造模型前切 state_dict,减少“先装全量再切”的峰值
只在模型搬到 GPU 后才切权重,会先经历全模型加载峰值。本地加载钩子先对 state_dict 切片,使 ComfyUI 按半宽结构构造模型,再安装必要的归约逻辑。
这只分摊了被切分的部分,并不意味着每卡峰值显存严格减半。激活、attention 工作区、VAE、LoRA、临时缓冲和部分未切分模块仍要占用空间。
4.3 LoRA 必须与底模一起切,不能只看到加载成功就认为生效
本轮最重要的适配之一,是让 LoRA 的 A/B 形状与各 rank 的权重一致:
- QKV / fc1:切影响输出维度的 B/up;拼接层按 QKV 或 gate/up 的分段规则取行。
- out_proj / fc2:切影响输入维度的 A/down。
- 未涉及的维度不随意裁剪,兼容 A/B 和 up/down 两种命名。
日志中的预期检查项包括:
LoRA input_tensors=416 mapped_patches=208、LoRA sharded tensors=208。这能检查映射数量,不足以单独证明与单卡数值等价;还必须结合正确性验证。4.4 修补 token_refiner 的行并行归约
公开代码的 state_dict 切分也会匹配
token_refiner.blocks,但原来的前向 patch 只覆盖主 DiT。切过的 refiner 行并行输出同样需要先 SUM,再加残差。本机在两个 token_refiner block 的 attention/MLP 输出处补了归约,日志确认
refiner row reductions installed: 4。修正前的初次 TP2 结果已标为无效,性能表使用修正后的运行。这里不能把“修了正确性问题”直接宣传成某个百分比的提速;本轮没有做只改变该补丁的控制变量速度对照。
4.5 先固定配方,再扫分辨率,最后单独量通信
流程是:
- 固定模型、Turbo、首帧、提示词、seed、CPU 文本编码、attention、采样器和步数。
- 先跑通单卡,再用相同配方同时给两个 TP 实例提交工作流。
- 检查 LoRA 映射、半宽形状、refiner 归约和输出完整性,排除错误/中断的试跑。
- 固定 124 帧,仅改变八档分辨率,记录单卡及 TP2 的完整运行状态。
- 打开 all_reduce profile,重新完成 TP2,保存每次调用的 shape、dtype、payload 和耗时。
- 从原始事件重算表格,再输出两张 PNG。速度、payload、通信耗时来自本机记录;S、加速比、占比是据记录或形状计算的派生指标。
5. 计时口径:哪些算,哪些不算
5.1 表中的 s/步
采样节点为
SamplerCustomAdvanced(节点 10)。记录其 1/8~8/8 进度事件,取相邻进度差:s/步 = mean(t₂−t₁, t₃−t₂, …, t₇−t₆)即第 2~7 步的六个间隔,排除第一步和最后一步。TP2 表里的值为两个 rank 各自稳定步时的均值;加速比为本机单卡步时÷本机 TP2 步时。
该口径排除采样前的 CPU 文本/图像条件编码、首帧 VAE、初次模型加载,以及采样后的音视频解码/封装。发生在这些排除阶段的权重转换或 LoRA 加载开销,不属于这项稳定步时;采样步内部实际执行的量化、反量化、矩阵计算、attention、归约以及内存管理等待并没有另行扣掉。本轮是 INT8,不适合笼统回答成“W4A8 编码时间都刨掉了”。
如果关心用户等待多久,应另看
elapsed_seconds或引擎完整执行时间。两者也有区别:前者是提交到 history 可见,含轮询延迟;后者取执行事件,不能混成同一计时。5.2 all_reduce payload
payload/步(GB) = Σ(单个 rank 每次输入张量 numel × element_size) ÷ 8 ÷ 10⁹统计真实调用,不把两个 rank 的相同 payload 再相加;GB 用十进制,显存 GiB 用二进制。这个数不是常驻显存,也不是 PCIe 实际 TX/RX 双向流量。
每次完整采样,单 rank 原始记录有 804 次 SUM:800 次主干调用,另有 4 次 refiner 调用。对 1920×1088,主干张量 shape 为
[80012, 5376]、BF16,共 800 次;refiner 张量[2078, 5376],共 4 次。于是可直接复核:[(800 × 80012 × 5376 × 2) + (4 × 2078 × 5376 × 2)] ÷ 8 ÷ 10⁹ = 86.040073728 GB/步86.04 GB 是累计参与归约的张量量,不代表要分配 86 GB 的显存或系统内存。 这些调用按执行顺序复用内存。
5.3 通信耗时与占比
每次真实 all_reduce 前做设备同步,调用后再次同步,用
perf_counter()记录这段墙钟时间,逐调用写 JSONL。历史制图按 rank0 的 sampler 起止窗口过滤两边记录;八档均检查两边调用数和 payload。通信秒/步 = max(Σrank0调用耗时, Σrank1调用耗时) ÷ 8 归一化通信占比 = 通信秒/步 ÷ 同次profile的TP2稳定步时 × 100%计时包含 collective 调用开销、执行和等待另一 rank 的时间。前置同步不放进单次计时起点,但同步插桩本身仍可能改变整个执行时序,故带 profile 的速度与不带 profile 不是同一实验条件。
还需说明:通信分子覆盖完整采样后÷8,步时分母只取第2~7步,因此这是本轮统一定义的归一化占比,不是精确的某一步 GPU 时间分解。不能用
1−该占比当成纯计算占比,也不能从中直接证明计算与通信重叠效率。5.4 S 是视频 token,通信实际序列还包括条件和音频
124 帧在 H3 的时间网格上合法,对应视频 latent 时间长度 37;图中的横轴按以下公式计算:
S_video = 37 × (W/32) × (H/32)它是视频 token 数的计算值,不是完整 packed 序列长度。 模型还拼入文本、首帧条件和音频等 token。比如 1920×1088 表中 S_video=75480,但真实主干 all_reduce 记录的行数是 80012;640×352 分别是 8140 和 9032。原图的“S(token)”均按这里的 S_video 理解,不用它倒推全部通信量。
6. 八档本机结果
所有行均为 124 帧、24 fps、8 步。单卡与完整 TP2 profile 的原始结果保存在附件;没有把主帖或 #22 的数字填进表,也没有用模型外推补缺失格。
分辨率 S_video(计算值) 单卡 s/步 TP2 s/步 加速比 all_reduce payload/步 归约耗时/步 归一化通信占比 640×352 8,140 6.70 3.44 1.95× 9.71 GB 1.62 s 47.0% 832×480 14,430 12.88 6.84 1.88× 16.84 GB 2.53 s 37.0% 1024×576 21,312 21.50 11.33 1.90× 24.64 GB 2.83 s 24.9% 1280×704 32,560 39.65 20.47 1.94× 37.39 GB 3.67 s 17.9% 1344×768 37,296 48.64 25.08 1.94× 42.76 GB 4.20 s 16.8% 1536×864 47,952 71.99 36.87 1.95× 54.84 GB 5.32 s 14.4% 1600×896 51,800 81.58 41.66 1.96× 59.20 GB 5.73 s 13.8% 1920×1088 75,480 149.10 77.24 1.93× 86.04 GB 9.00 s 11.7% 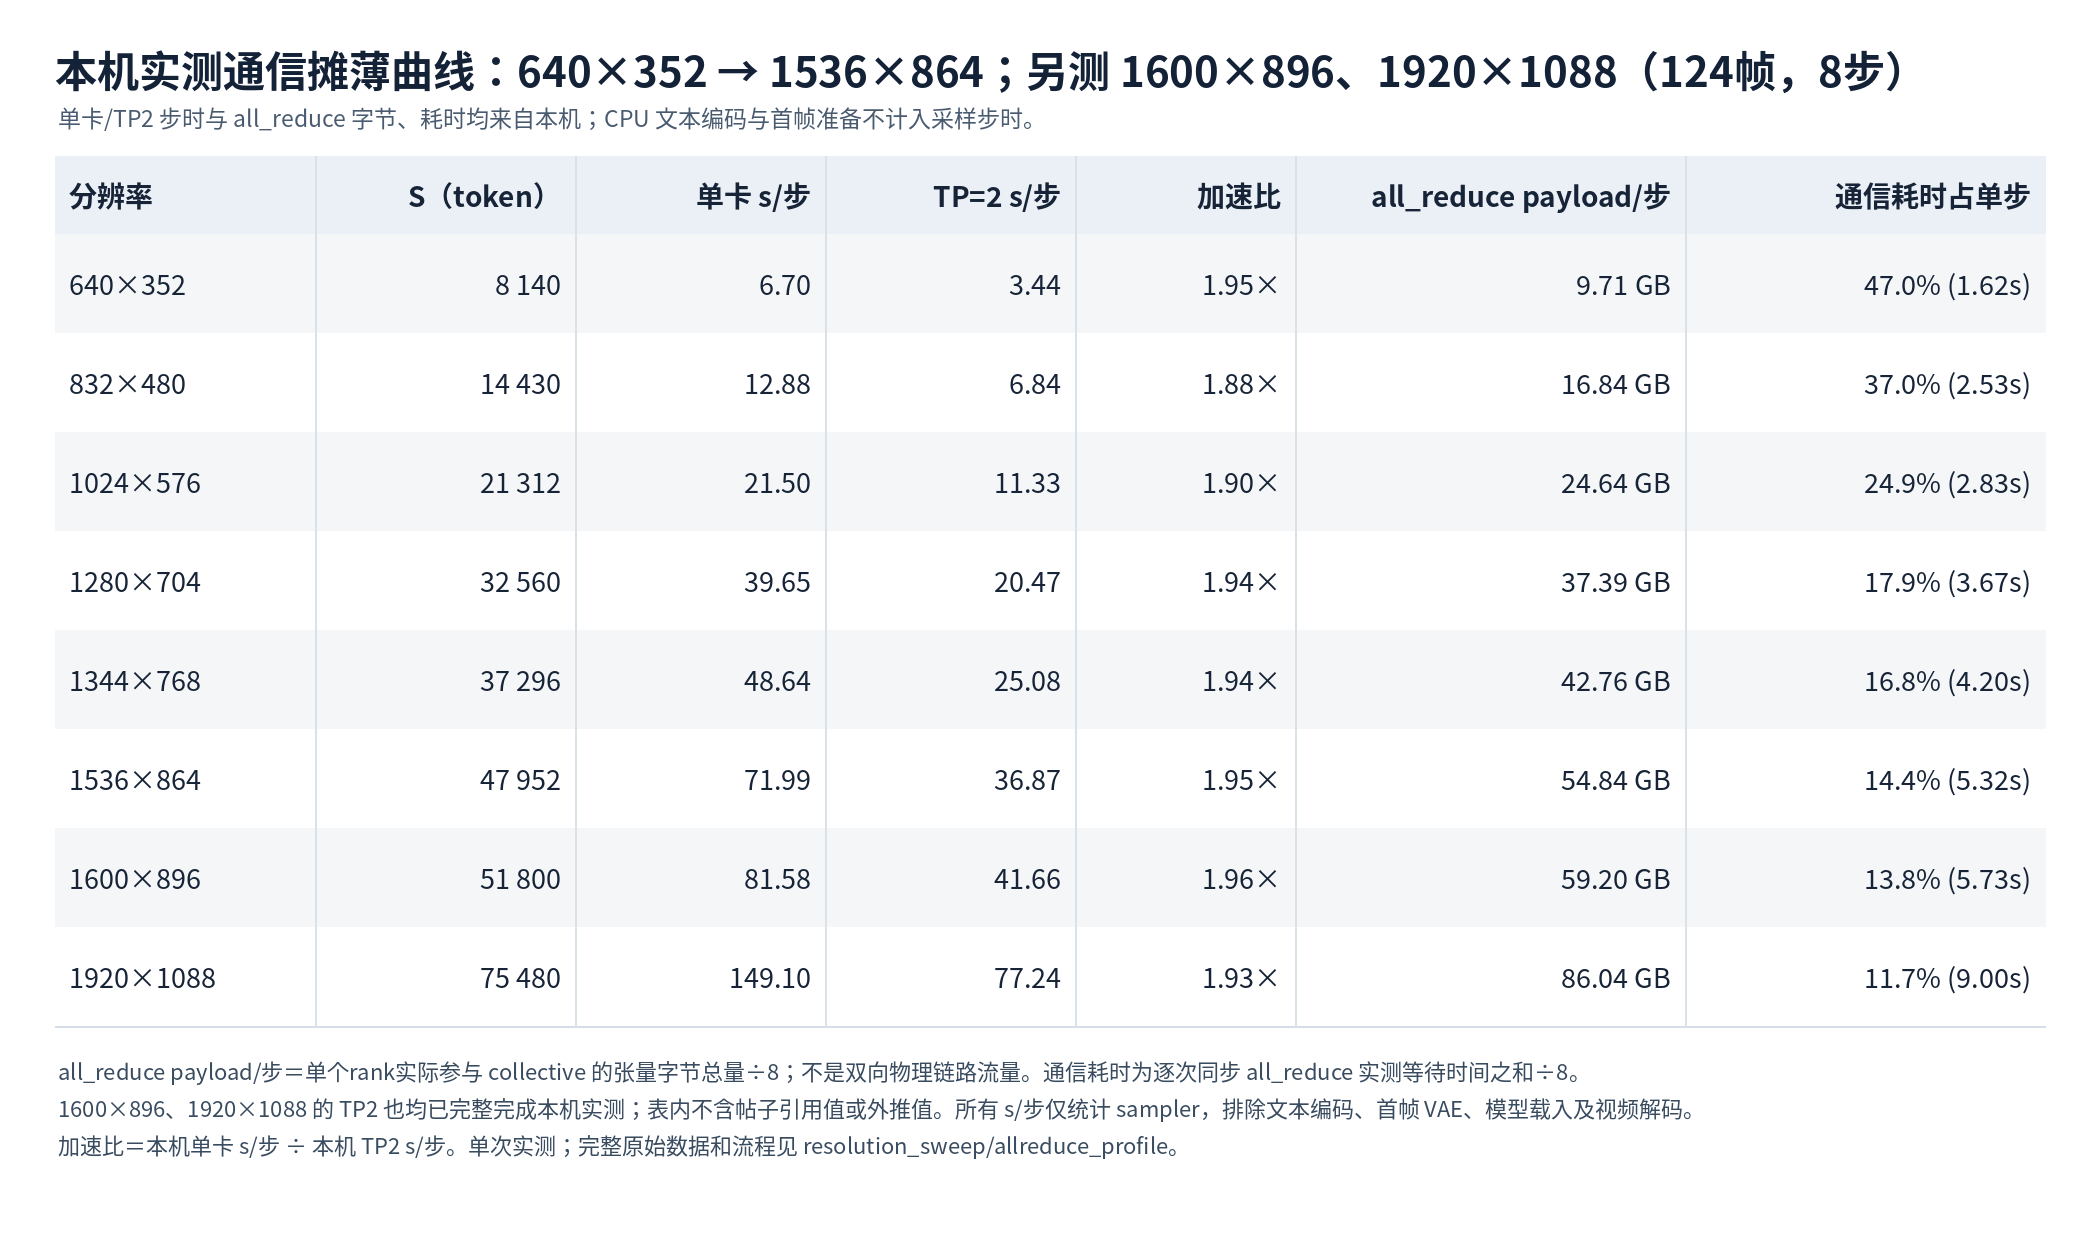
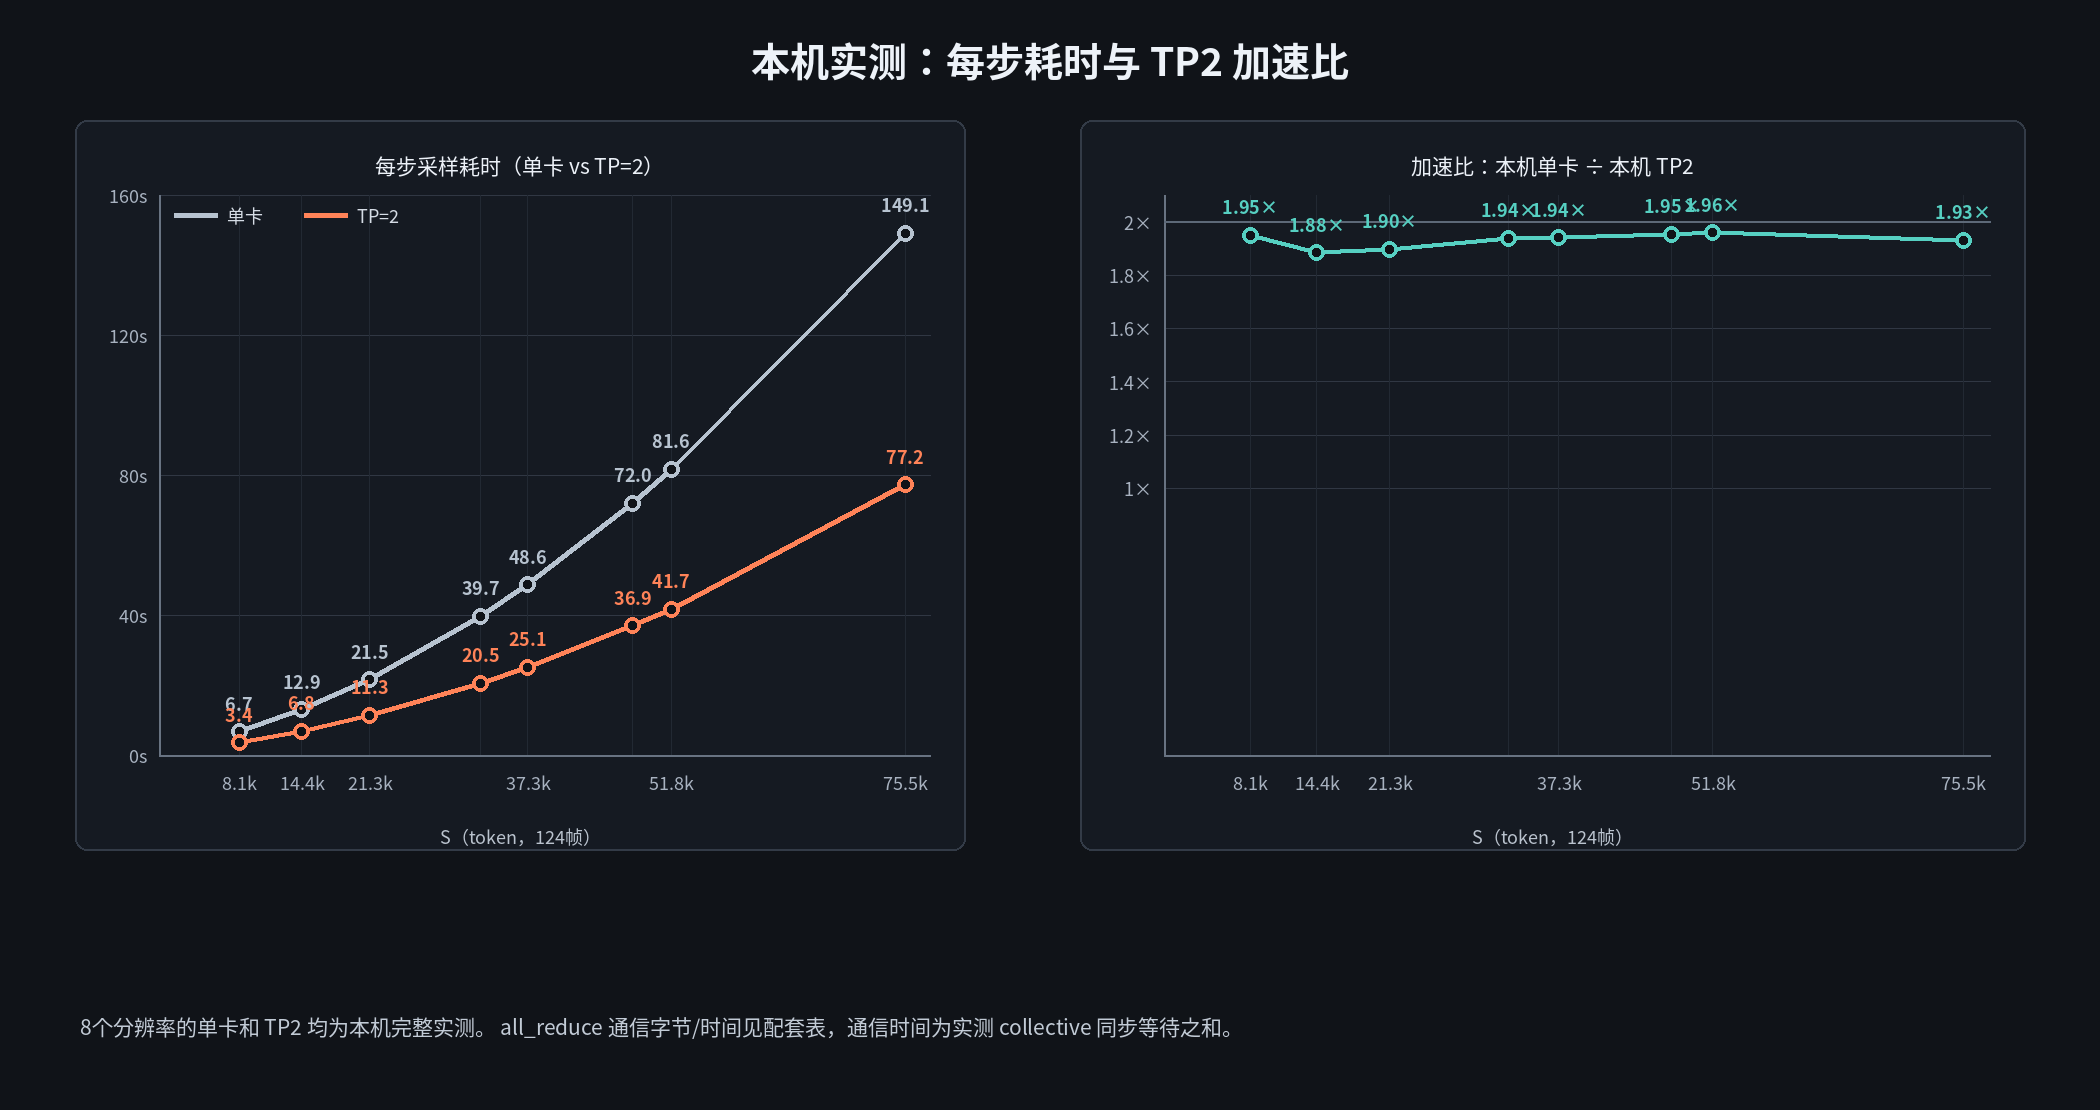
分辨率增大,绝对 payload 从约 9.71 GB/步增加到 86.04 GB/步,通信秒数也从约 1.62 秒增加到 9.00 秒;但归一化占比从约 47.0% 降到 11.7%。所以“摊薄”是通信占比下降,并不是通信字节或通信时间减少。
本机测得的 TP2 采样加速始终接近 2×。这和更大的矩阵/attention 工作量能够覆盖通信成本的解释相符,但本轮只有分辨率扫描,没有把各计算内核单独剖析,不能把因果归到唯一一个内核优化上。
1920×1088 的单卡完整提交到结果约 1574 秒,TP2 profile 较慢 rank 约 1205 秒;按这组提交到结果口径,整段加速约 1.31×,明显低于采样步时的 1.93×。832×480 的先前有效运行中,引擎完整执行约 266.1 秒对 280.4 秒,TP2 的完整流程反而略慢。这些差别主要提醒我们:采样速度和端到端延迟必须分开公布,尤其本机两个 rank 都要在同一 CPU 上准备条件。
早一轮普通扫描的 1600×896、1920×1088 TP2 有失败记录;上表采用后来完整成功的 profile 重跑,未采用失败试跑中的部分步时。附件保留原扫描状态,不把成功重跑写成“所有尝试都一次通过”。失败原因与环境状态不在本轮设计中构成单一变量对照,不能据此归因于某个参数。
7. 复现步骤与命令
附件目录结构:
h3-tp2-repro/
├── README.md                         本文
├── assets/                           统一首帧、两张原图
├── workflows/template-124f-api.json   实际使用的 API 工作流
├── tp/                               本机 TP 运行代码快照
├── tools/bench_h3_run.py              原始事件与显存采样器
├── tools/run_case.py                  整理新增的可移植单档启动脚本
├── tools/summarize_case.py            从事件/profile重算指标
├── environment/                      仓库提交、依赖、模型哈希、diff
└── evidence/                         原始结果与逐调用记录
附件中的
manifest.json/final-results.json是早先832×480验证的记录;八档表以evidence/local-measured-chart-data.json、evidence/single/、evidence/profiles/为重算入口,原扫描失败状态另见evidence/sweep-status.jsonl。不要把早期 manifest 的单分辨率范围误当成后来扫描的全部范围。7.1 准备相同代码与模型
在具备匹配 ROCm 驱动和 PyTorch 的环境中,使用锁定的仓库提交。不要直接以未来的最新版本替换后还宣称是同一软件配置。已有目录可直接核对提交,以下命令供新目录部署参考:
# 当前目录自行选择;这些命令只下载代码,不包含模型。
git clone https://github.com/Comfy-Org/ComfyUI.git ComfyUI-H3
cd ComfyUI-H3
git checkout 426f5eea52a7ece1dd599fff4cb6cd1f352ddd24

git clone https://github.com/patientx/ComfyUI-INT8-Fast-ROCM.git custom_nodes/ComfyUI-INT8-Fast-ROCM
git -C custom_nodes/ComfyUI-INT8-Fast-ROCM checkout 6b28bf637782d25225a88e316d864a8f551be000
原生工作流不直接调用 INT8 Fast 自定义加载节点,但环境中装有该插件;为避免无意变化,代码版本与 Linux 更新逻辑的小补丁一并放在
environment/。其他已安装节点的提交见repositories.json,本轮不调用 PDD Apply 节点。PyTorch/ROCm 二进制应按实际驱动和架构准备好,先确认是
torch==2.11.0+rocm7.2、torchvision==0.26.0+rocm7.2。下面是在已有匹配 Torch 的虚拟环境中安装 ComfyUI 依赖的约束写法;附件的完整包版本快照用于比对,不保证每个 ROCm wheel 在其他时间、其他镜像都能取到:PY=/绝对路径/venv/bin/python REPRO=/绝对路径/h3-tp2-repro "$PY" -m pip install -r requirements.txt -c "$REPRO/environment/constraints.txt" # Linux 下匹配本机已记录的插件更新适配;先确认仓库提交相同。 git -C custom_nodes/ComfyUI-INT8-Fast-ROCM apply \ "$REPRO/environment/ComfyUI-INT8-Fast-ROCM.patch"按模型哈希核对五个文件,放到
MODELS下对应子目录。首帧由附件提供,提示词来自模板。新增启动脚本会把共享模型目录写成单独的 extra_model_paths 配置,并为每个 rank 建独立 input/output/temp/user;不会覆盖原 ComfyUI 配置。7.2 先检查计划,再选择要跑的一档
run_case.py是整理时从历史启动逻辑抽出的便携脚本,原始测速器和 TP 代码保持快照;新增启动器仅验证了语法、dry-run 和已有数据重算,本次没有重新跑 GPU 验证它的完整执行路径。真实实验环境仍以已留存的工作流、源码、版本和日志为准。REPRO=/绝对路径/h3-tp2-repro COMFY=/绝对路径/ComfyUI-H3 MODELS=/绝对路径/comfy-models PY=/绝对路径/venv/bin/python # 默认只打印计划,不启动服务、不生成视频。 "$PY" "$REPRO/tools/run_case.py" \ --comfy "$COMFY" --models "$MODELS" --python "$PY" \ --mode tp2-profile --size 832x480 \ --output "$REPRO/runs/tp2-profile-832x480"若要实际执行,在同一命令后加
--run。每次使用全新的输出目录;脚本遇到端口占用会退出,不擅自终止已有服务。单卡端口 8194,TP2 端口 8192/8193,RCCL 默认 29670。# 单卡;同一首帧/提示词/权重/采样参数。 "$PY" "$REPRO/tools/run_case.py" \ --comfy "$COMFY" --models "$MODELS" --python "$PY" \ --mode single --size 832x480 --output "$REPRO/runs/single-832x480" --run # TP2 纯运行,可与下一项区分插桩影响。 "$PY" "$REPRO/tools/run_case.py" \ --comfy "$COMFY" --models "$MODELS" --python "$PY" \ --mode tp2 --size 832x480 --output "$REPRO/runs/tp2-832x480" --run # TP2 逐次同步通信计时;原图用的就是 profile 重跑步时。 "$PY" "$REPRO/tools/run_case.py" \ --comfy "$COMFY" --models "$MODELS" --python "$PY" \ --mode tp2-profile --size 832x480 --output "$REPRO/runs/profile-832x480" --runTP2 必须给两个实例提交相同工作流并同时运行;不能只给一边排队。脚本已同时提交,两个进程分别设置
TP_RANK=0/1、ROCR_VISIBLE_DEVICES=0/1;每个进程内本地 GPU 索引都是 0,日志里的“GPU 0”不一定指整机同一张物理卡。要复现整张表,按需把
--size换成:640x352 832x480 1024x576 1280x704 1344x768 1536x864 1600x896 1920x1088一次只跑一个实验,不并发跑不同分辨率或单卡/TP2;保存后台 GPU 占用、系统内存基线及端到端时间。高分辨率耗时长,先跑一档检查 LoRA/shape/输出,再决定是否扫全表。
7.3 重算已有数据,不需要启动 GPU
# 直接重算附件中 1920×1088 的原始 profile:
python3 "$REPRO/tools/summarize_case.py" \
  "$REPRO/evidence/profiles/1920x1088"

# 重算自己新跑的 profile:
python3 "$REPRO/tools/summarize_case.py" \
  "$REPRO/runs/profile-832x480"
脚本要求完整 success 且有8个采样进度,再按历史制图定义取两个 rank 的平均稳定步时;用 rank0 sampler 窗口过滤 profile,逐 rank 汇总 payload/时间,检查两边 payload 一致。重算结果写入
recomputed-summary.json。原附件的两张 PNG 及图表数据来自历史记录,不由新增启动器“模拟生成”。7.4 什么才算一次通过
- 单卡或两个 rank 的
result.json均为success,采样完整 8/8,不能拿前一两步当整段成功。 - 检查半宽形状、LoRA 映射数与 refiner 归约日志,无形状错配或 LoRA 静默漏加载。
- 通过
ffprobe或视频解码检查输出分辨率、帧率和实际帧数;原始124帧应得到约5.17秒视频。 - 保存 events、profile、显存、系统内存/Swap、完整错误日志。中断和 OOM 单独标记,不补写成功步时。
示例:
ffprobe -v error -select_streams v:0 -count_frames \
  -show_entries stream=width,height,r_frame_rate,nb_read_frames \
  -of json /实际输出/video.mp4
8. 正确性验证与目前不能下的结论
832×480 的修正后验证中,两个 TP rank 输出的 124 帧解码像素完全一致;单卡与 TP2 没有逐像素一致,留存的逐帧比较 PSNR 约 13.99 dB。编码 MP4 的文件 SHA 不同不一定代表解码像素不同,因此应对解码数据比较。
这只能支持“本机 TP2 两 rank 输出一致、工作流跑通”的结论。当前没有高分辨率全覆盖的 latent 逐元素等价验证,没有质量基准或人工质量评分;不能宣传为单卡无损等价、同质量翻倍,低精度、分片量化与归约顺序可能影响结果。
附件的共享 scale 开关保持为0,未额外研究打开全局激活 scale 的误差/速度权衡。后续若讨论质量,应固定相同 noise/conditioning,单独保存 sampler latent、计算误差并比较视频,而不是从速度接近2×反推正确性。
9. 帧数对齐与后续时长测试的关系
这版 ComfyUI H3 的时间长度会向上对齐到 17k+5 帧。不能把工作流里请求的 length 直接当成最终视频帧数:
请求 length 内部对齐帧数 内部帧数÷24 120 124 5.17 秒 124 124 5.17 秒 160 175 7.29 秒 240 243 10.125 秒 360 362 15.083 秒 这里的“内部时长”来自代码的帧网格计算;最终成片仍以解码帧数确认。原分辨率表全部用124,已对齐,因此主表的帧数没有这个歧义。
后续1080档时长探测中,请求240和360的运行报过OOM;请求120的复测被人为暂停,均不能作为“10秒/15秒完成”的证据。它们不是上述八档124帧速度表的样本,本文也不把它们混进通信摊薄曲线。早先把请求160直接写成6.67秒等说法,在讨论实际成片时应按这里的帧对齐规则和视频 metadata 重新核对。
10. 希望和大家讨论的问题
- 相同首帧/提示词、模型哈希、帧数和计时定义下,其他双卡平台能否复现类似的采样加速与通信占比趋势?
- 逐次同步 all_reduce 的观测偏差有多大?若统一第2~7步的分子分母,再用GPU event/profile工具,会得到怎样的通信分解?
- 在不遗漏 LoRA 和 refiner 归约的前提下,如何改善单卡与 TP2 的数值一致性?是否值得为共享量化 scale 增加通信?
- CPU 文本/图像条件准备在双实例中重复,怎样复用条件而又不影响精度、缓存语义与计时公平性?
欢迎附硬件、模型哈希、实际解码帧数、后台占用及原始日志对照。表中的1.93×是本机这组配置的采样结果.
- 本机用 INT8 ConvRot DiT,原生
-
-
-


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!
