3090 双卡 三卡的又 一选择QEngine.
-
https://github.com/bpx03/QEngine
模型: https://huggingface.co/bpx03/Qwen3.8-Flash-Next-QEngine/tree/main 128G的多个safetensor 文件。
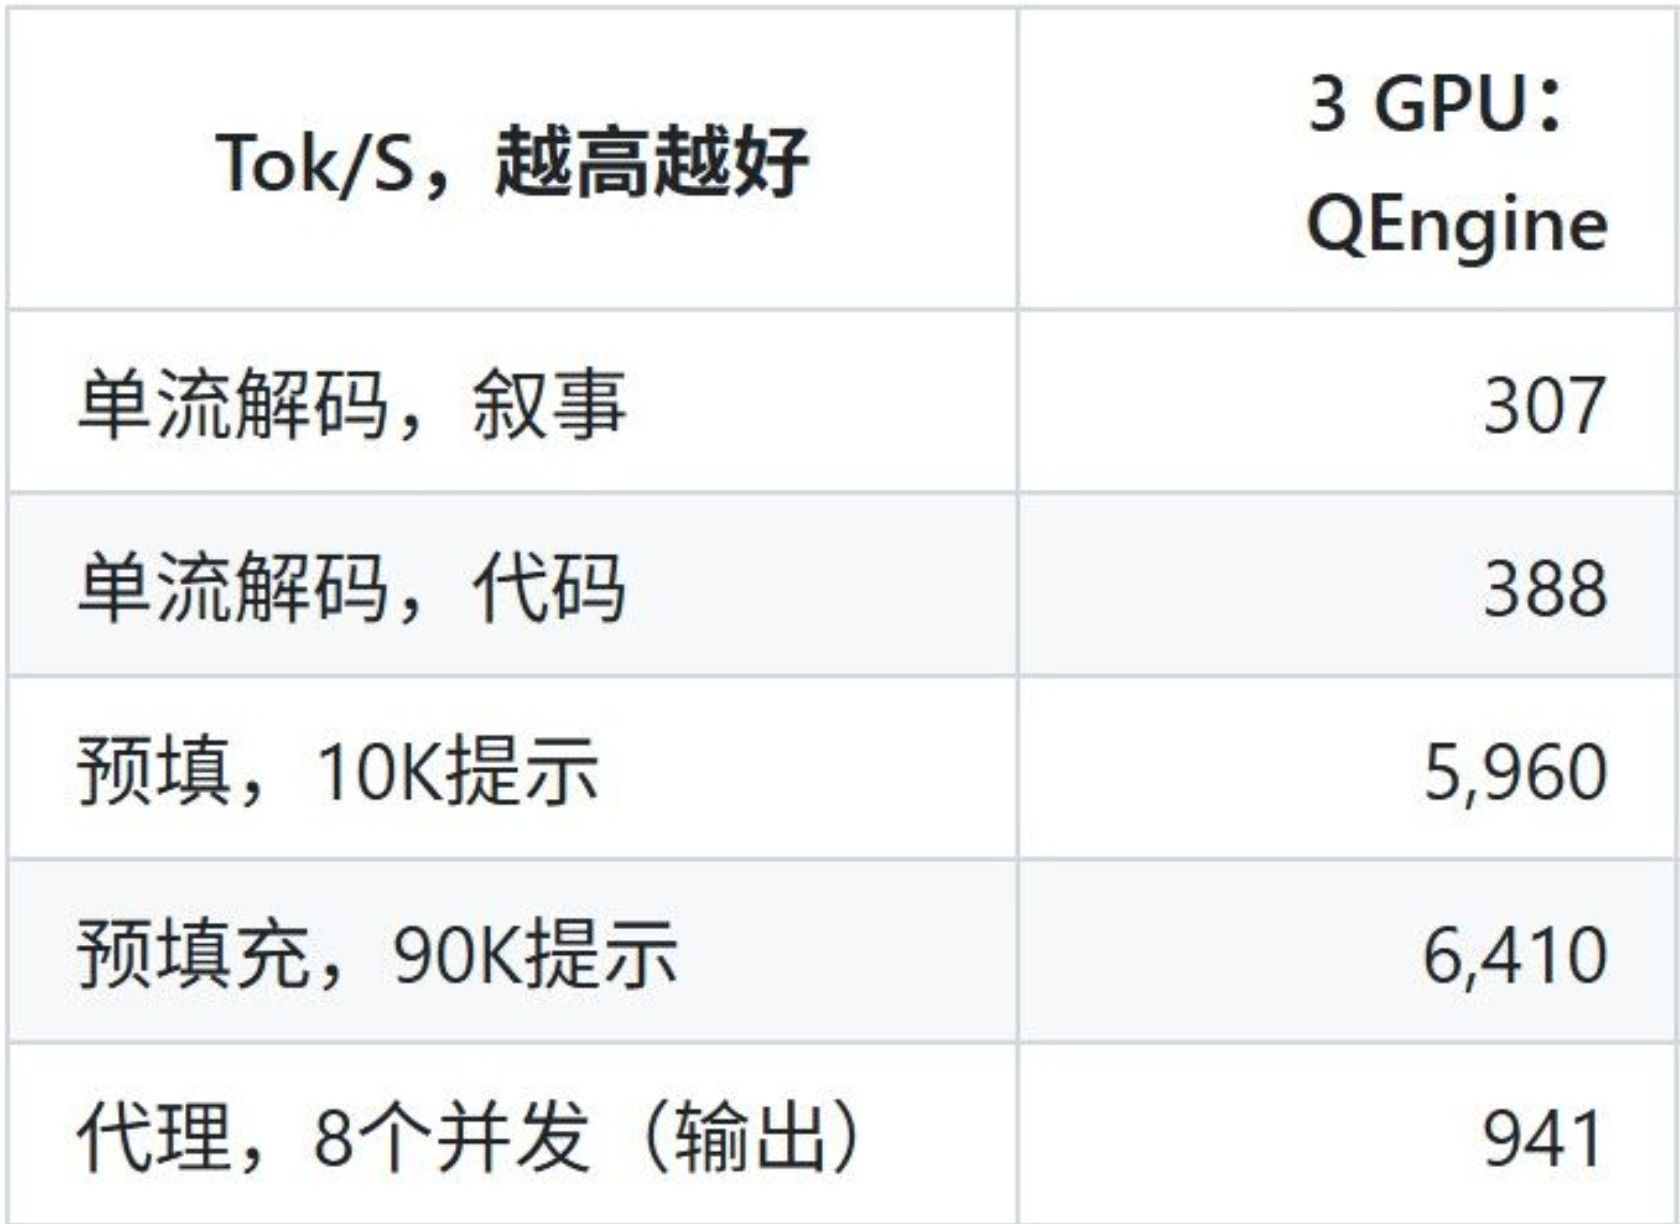
此项目是专为三卡3090用户而生的,并号称要踢馆Strata,先看作者github的数据
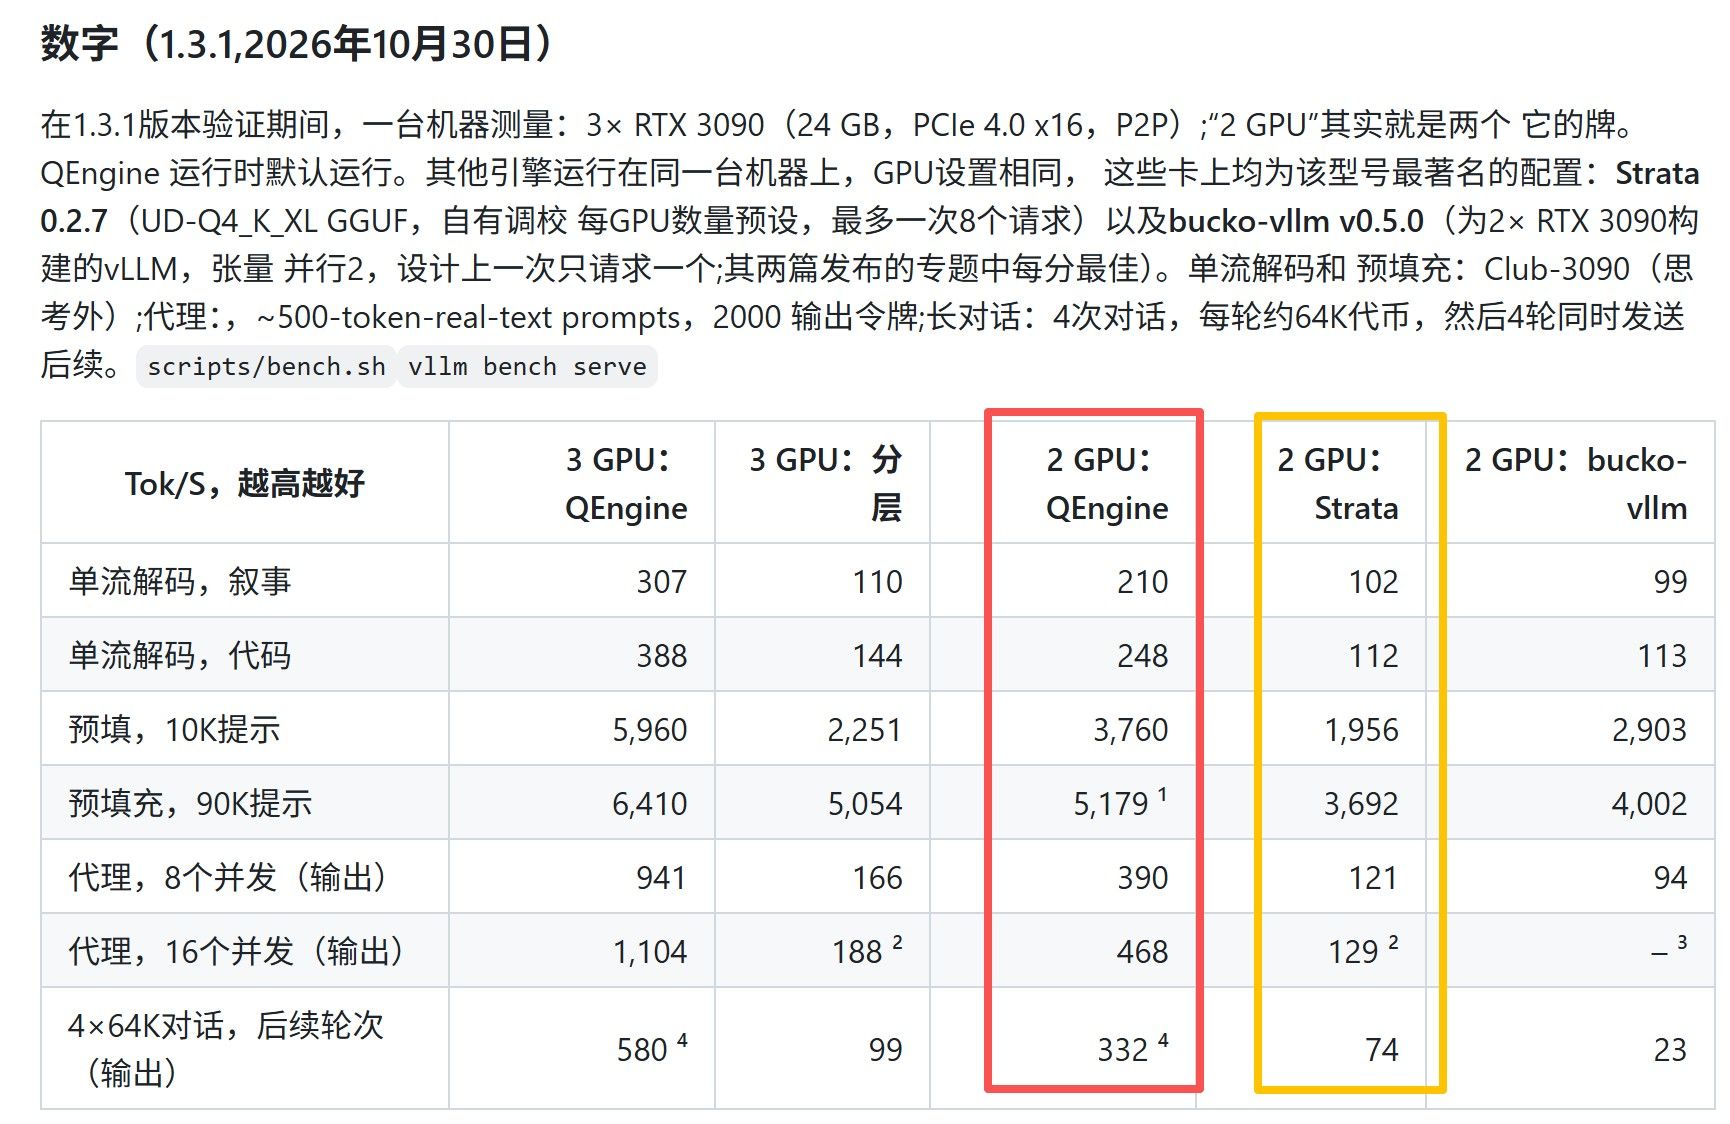
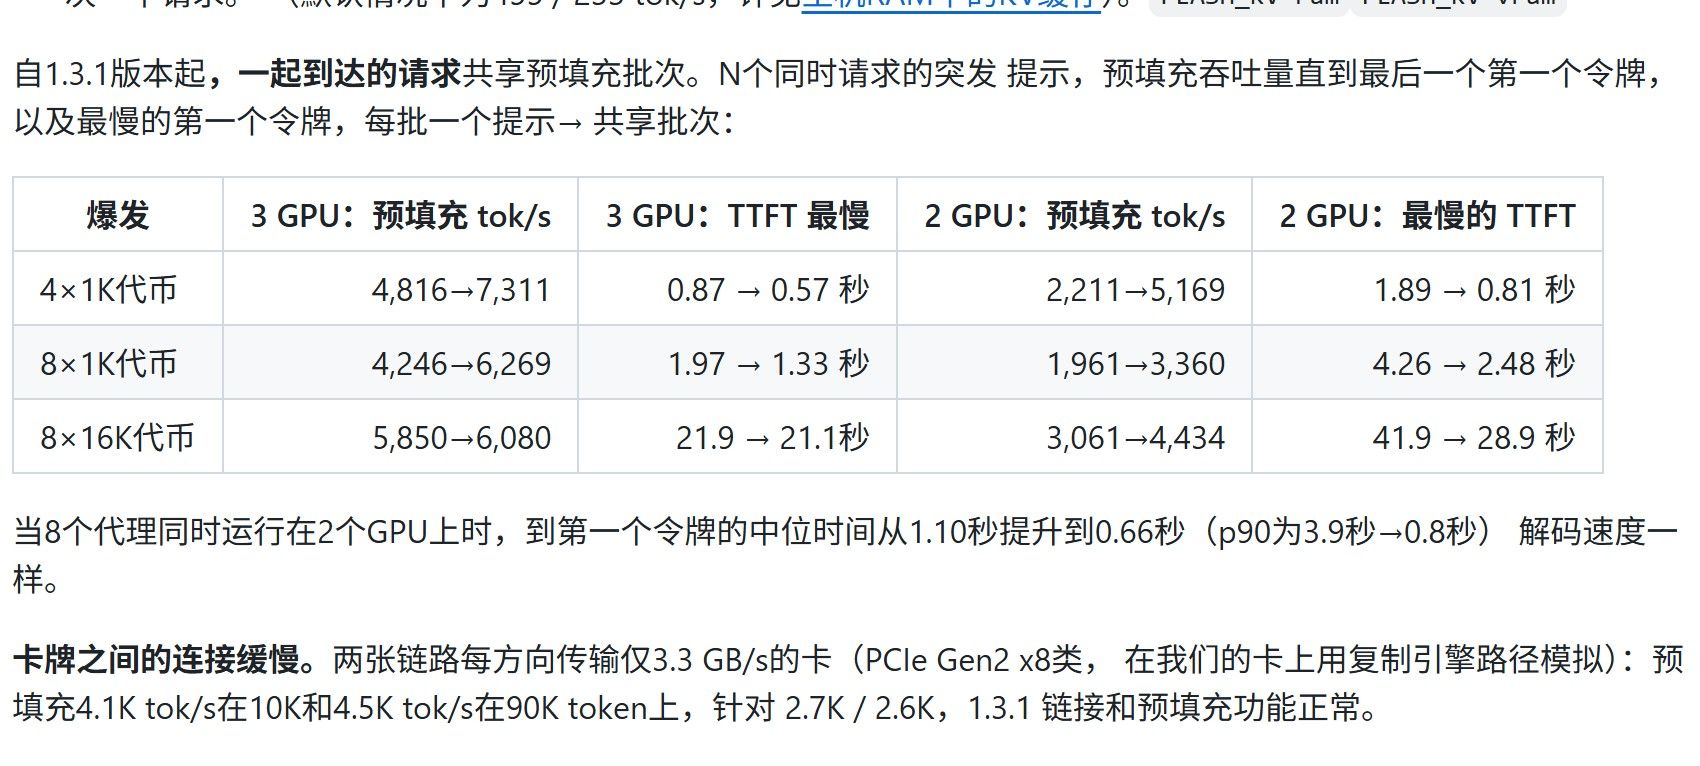
看起来要吊打strata啊。
我的是双卡。Strata IQ3S 平时250W稳跑120t (代码140左右)。 已经这样用了20多天了,感觉挺稳定,就没再折腾了。
那用上它不是得单流 稳跑200t?
-
-
我试了 也比strata 慢,达不到官方的5000 prefill
最多渠道3000 prefill 多
strata 已经4300 prefill
只是可以同时跑8个 但是我没有这个需求 -
-
-
架得起來,核心是那個多併發引起我的興趣
昨晚讓opus幫我架,還沒很花時間優化
QEngine 能同時處理 16 路,核心是它把 16 條對話合成同一次計算一起跑;Strata 的做法是 4 張卡接力分段處理,所以上限只到 8 路。一、數字比對
Column 1: 單人生成速度
舊 Strata 0.1.45 正式(4 卡,同時 4 路): 93~100 tok/s
Strata 最新 0.2.9(官方或社群,非 3090): 有人回報 3090 單卡從 80 掉到 60
QEngine 1.3.2 正式(3 卡運算,1 卡讀圖): 123~148
────────────────────────────────────────
Column 1: 同時 4 路合計
舊 Strata 0.1.45 正式(4 卡,同時 4 路): 166~299
Strata 最新 0.2.9(官方或社群,非 3090): 4 張 4090:366→510
QEngine 1.3.2 正式(3 卡運算,1 卡讀圖): 251~259
────────────────────────────────────────
Column 1: 同時 8 路合計
舊 Strata 0.1.45 正式(4 卡,同時 4 路): 最多 8 路,正式沒開到
Strata 最新 0.2.9(官方或社群,非 3090): 4 張 16GB 卡:360
QEngine 1.3.2 正式(3 卡運算,1 卡讀圖): 309
────────────────────────────────────────
Column 1: 同時 16 路合計
舊 Strata 0.1.45 正式(4 卡,同時 4 路): 不支援
Strata 最新 0.2.9(官方或社群,非 3090): 不支援,最多 8 路
QEngine 1.3.2 正式(3 卡運算,1 卡讀圖): 348~367(工具呼叫)/579~597(短題)
────────────────────────────────────────
Column 1: 16K 長文首字
舊 Strata 0.1.45 正式(4 卡,同時 4 路): 7.1 秒
Strata 最新 0.2.9(官方或社群,非 3090): —
QEngine 1.3.2 正式(3 卡運算,1 卡讀圖): 5.2 秒同時 4 路時兩者差不多,真正的差距在 8 路以上。還有一點:QEngine 只用 3 張卡運算,Strata 是 4 張全用。
二、QEngine 為什麼做得到 16 路
- 16 條對話合成一次計算。 每一步把所有進行中的對話一起送進去算一次。它預先建好的計算流程只看「幾條對話、幾個草稿」,不管是哪幾條,所以換人進出不用重建,多加一條幾乎沒有額外成本。
- 專家權重讀一次,大家共用。 這是混合專家模型,每一步只會用到一部分專家。QEngine 每個專家只讀一次,再分給所有選到它的對話一起算。實測每步只缺約 31 組專家,命中率 99%,所以人越多,搬資料的成本攤得越薄。
- 3 張卡同時算同一層。 每一層都是三張卡一起分工,所以每一步三張卡都在忙。
- 人多時犧牲「先猜後驗」的加速。 每次計算最多處理 32 列:只有 1 個人時,每條對話可以一次猜 3 個字再驗證;16 個人時,每條只剩猜 1 個字。這就是為什麼人多時總吞吐變成約 2.4 倍,但每個人自己變慢。
- 16 這個上限是寫死的。 程式裡直接限定 1~16 條,剛好 16 條 × 每條 2 列 = 32 列,填滿一次計算。
- KV 放主記憶體。 這樣 16 條長對話都放得下。代價是有人讀長文時,其他人的生成會被擠慢,1.3.2 和 1.3.3 都一樣。
這裡其實很有趣的地方是因為作者只三張,源碼就寫死勒。
另外還注意到上下文最長可以到 1M。 -
-
確認可用,速度還很不錯。
這樣的併發設計思路,應該可以是未來所有MOE模型的參考。
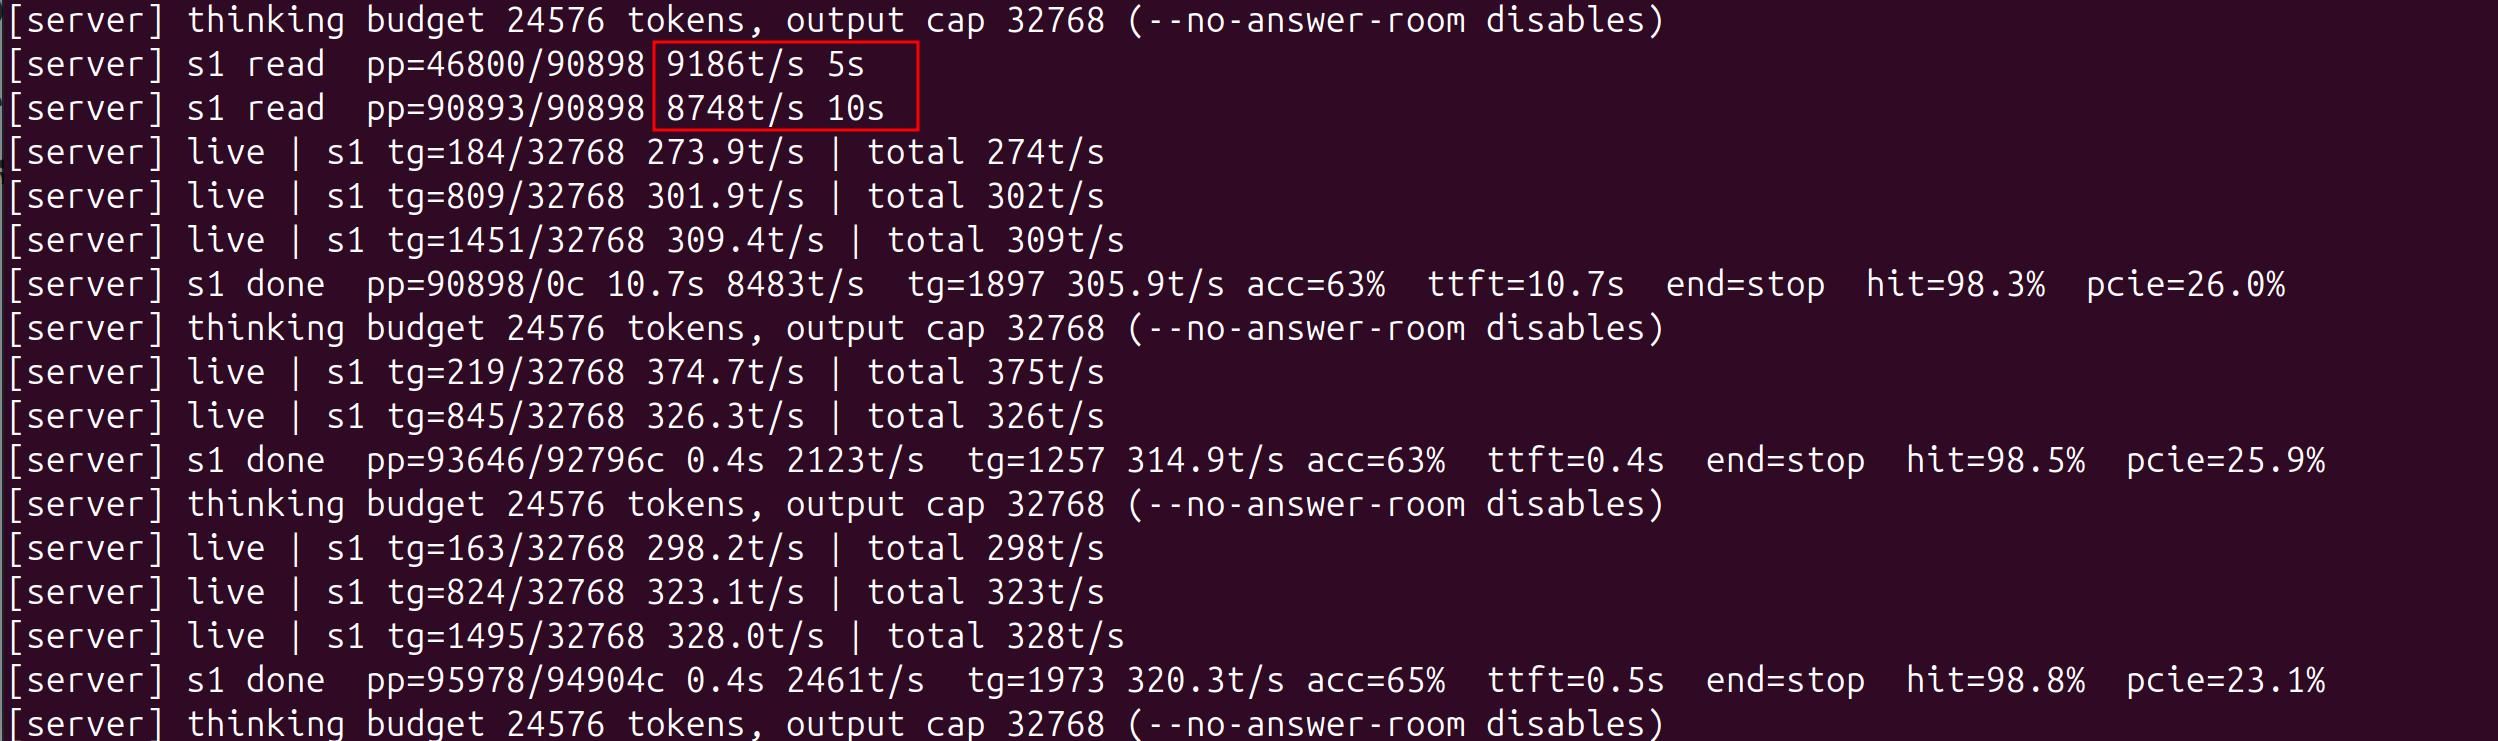
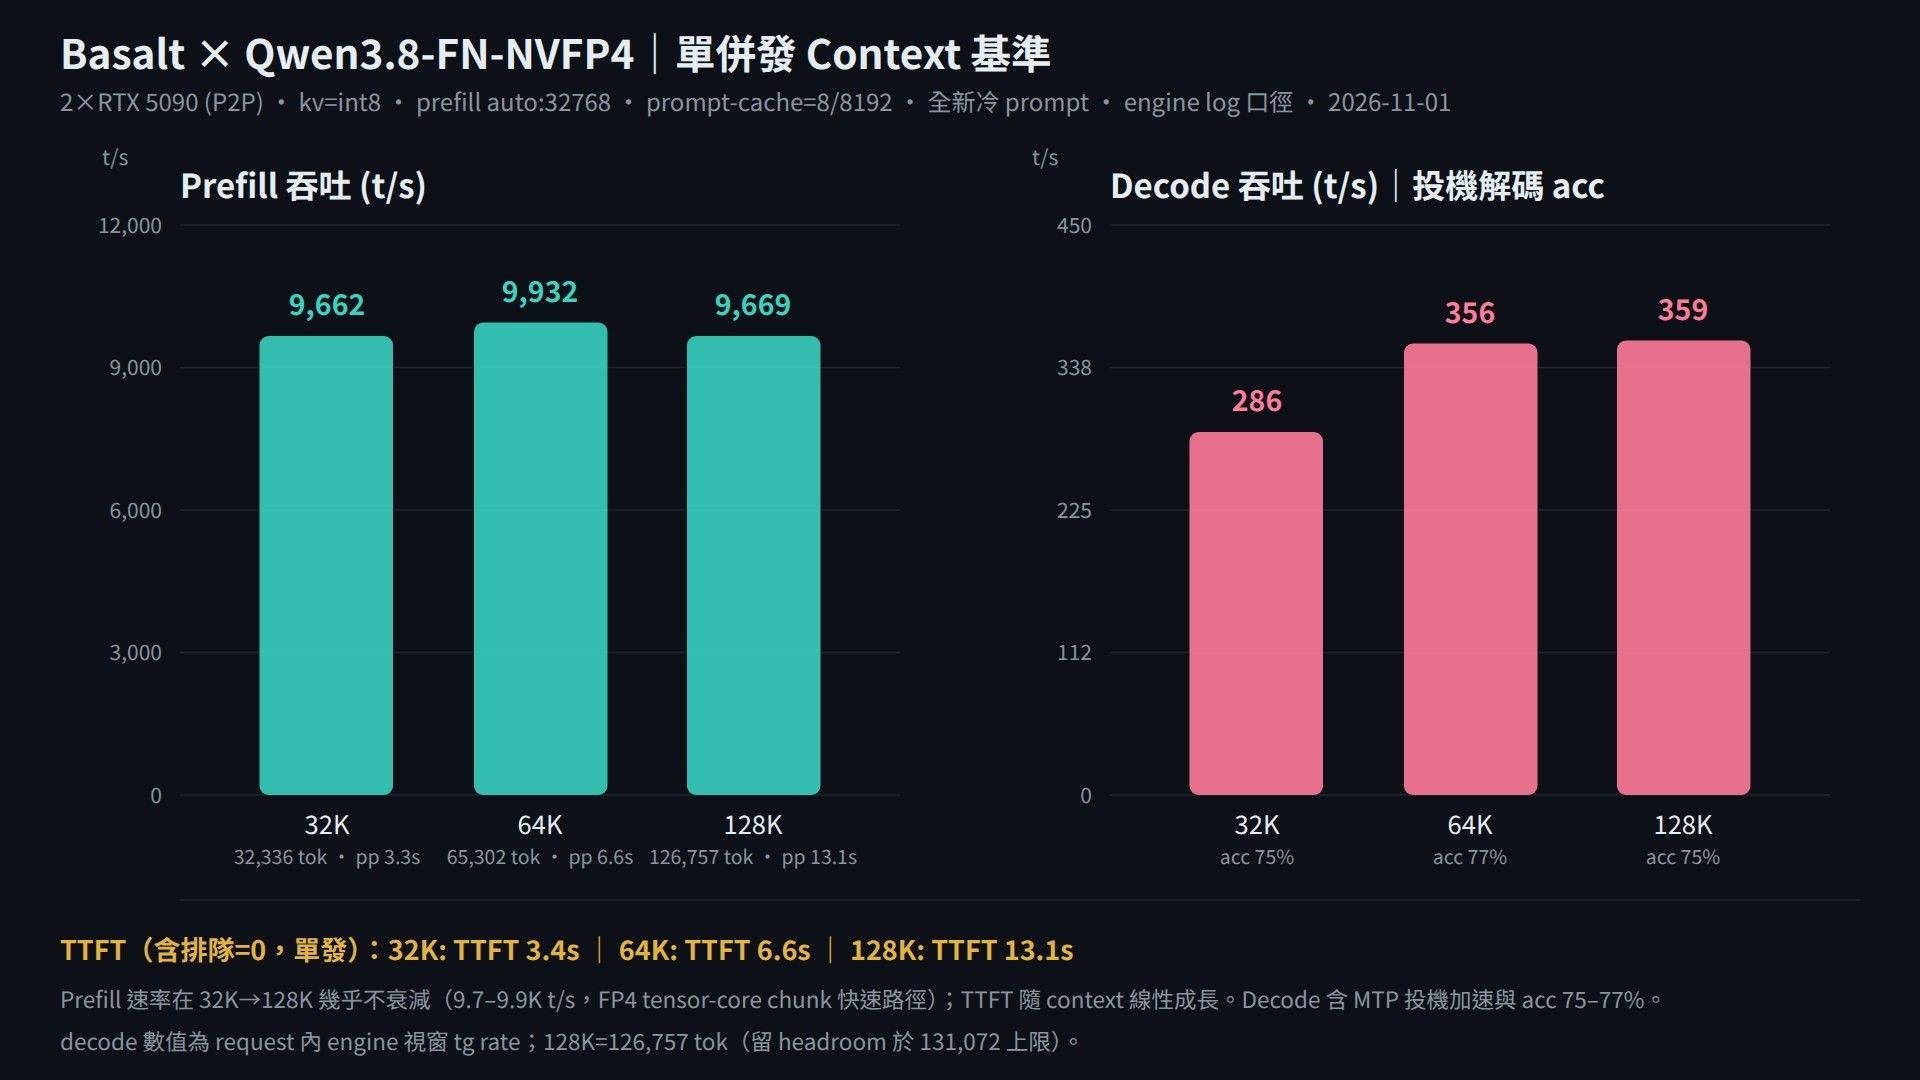
PS.這引擎禁止商用。負載 每秒產出字數(全部人加總) 第一個字出來的時間(一般 / 最慢 5%) 單人短題 143.6 0.06 / 0.07 秒 同時 16 路短題 634.4 0.12 / 0.62 秒 同時 4 路工具呼叫 238.3 0.31 / 0.53 秒 同時 8 路工具呼叫 380.3 0.41 / 0.73 秒 同時 16 路工具呼叫,第 1 輪 424.7 0.80 / 1.69 秒 同時 16 路工具呼叫,第 2 輪 435.8 0.76 / 1.80 秒 同時 16 路工具呼叫,第 3 輪 480.0 0.63 / 1.48 秒 長文 1.6 萬字,單路 讀題每秒 5,098 字 3.22 秒 - 穩定性: 每一格都零錯誤。卡間同步逾時、顯卡錯誤、顯存不足、系統層的顯卡錯誤、自動重啟,全部都是 0。
- 讀圖: 單獨測 5 次全對;壓測時背景同時讀 20 次也全對,每次約 0.2 秒。
- 上下文: 1M,對話快取放在主記憶體。
跟之前 Strata(同一台、4 卡)比較
Strata 的數字取自 10/31 停機前的測試(一題一格),以及 10/19 定案的 4 卡版本。
指標 Strata QEngine 現在 差距 單人短題,第一個字 1.89 秒 0.06 秒 約快 30 倍 單人短題,每秒字數 56.3 143.6 2.5 倍 單人工具呼叫,每秒字數 56.1(最佳設定 90~102) 這輪沒測(3 卡時 147.9) 約 1.5~2.6 倍 長文 1.6 萬字,第一個字 7.06 秒 3.22 秒 快 2.2 倍 長文 1.6 萬字,讀題每秒字數 2,331 5,098 2.2 倍 同時 4 路,加總每秒字數 166~174 238.3(背景同時在讀圖) 1.4 倍 同時 8 路、16 路 最多只能同時 8 人,16 路沒測過 8 路 380.3;16 路 425~480 至少約 2.5 倍以上 6.4 萬字長文,第一個字 14.7 秒 這輪沒測(3 卡時 13.96 秒) 待補 -
我目前的確是三卡 但我第二個NVLINK 在路上了 打算弄四卡的說 我月中有空來試試看
@starryskyknight 有推薦的NVLINK嗎 ?
-
@starryskyknight 有推薦的NVLINK嗎 ?
我兩台四張 兩個nvlink都是用四槽的 品牌沒差 都是官方貼牌的 不要買服務器版本的 不然沒空間散熱
-
@starryskyknight 有推薦的NVLINK嗎 ?
我兩台四張 兩個nvlink都是用四槽的 品牌沒差 都是官方貼牌的 不要買服務器版本的 不然沒空間散熱
@starryskyknight 感謝大大 因為掏寶價差很大 看得眼花撩亂 你買的價格大約是?
-
@starryskyknight 感謝大大 因為掏寶價差很大 看得眼花撩亂 你買的價格大約是?
記得 兩槽跟三槽的都不是 還有就是一定要買30系列用的 其他的都不能用