7900 XTX单卡:prefill 2086→3205,decode 64.7→96.3
-
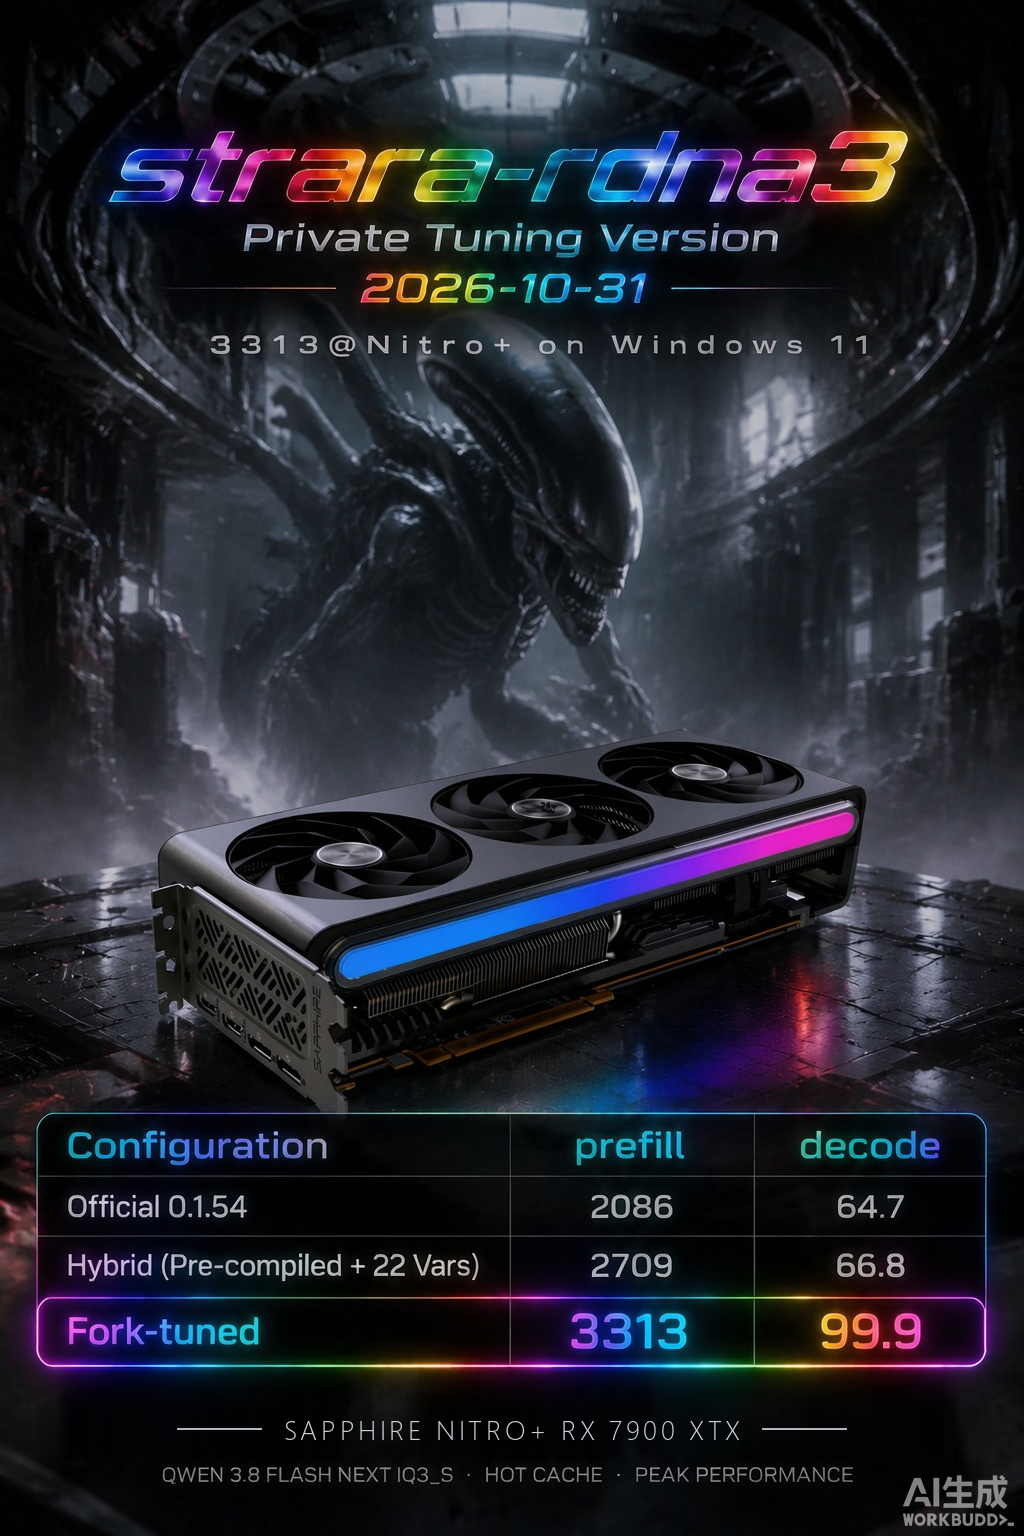
7900 XTX 跑 125B MoE:prefill 2086→3205,decode 64.7→96.3
一张 Radeon RX 7900 XTX(24 GB),跑 Qwen3.8-Flash-Next 125B MoE,128K 上下文。
官方预编译引擎 prefill 2086 / decode 64.7,调优后 prefill 3205 / decode 96.3。
+54% 和 +49%。
———————人话分界线其他都是AI写的————————
说明一下这个2086/64.7是我昨天第一次调过后的成绩,strata开箱直接用的prefill肯定没有2086,我记得好像是不到1000还是1000多。总之就是人在一边看,AI自己干,调优全过程都是deepseek flash免费模型给我做的,我就在一边抽鞭子来着。
———————人话分界线其他都是AI写的————————环境
GPU Radeon RX 7900 XTX,24 GB,gfx1100(RDNA3) CPU Intel i7-13700KF 内存 64 GB 系统 Windows 11 模型 Qwen3.8-Flash-Next(abliterated),125B MoE,IQ3_S 上下文 131072 服务 strata,OpenAI / Anthropic 兼容 API 测试协议:27549 token prompt / 400 token 输出 / 各 3 轮。
本来是
官方组合:strata 预编译引擎
0.1.54+ hipBLASLt100500+ 32 行社区调优表 +--lookup-chain 3+--host-core sibling。prefill(三轮) 中位 decode(三轮) 中位 2095.3 / 2069.1 / 2086.2 2086 65.5 / 64.2 / 64.7 64.7 27.5K 上下文要 13.2 秒才出第一个字。
调优措施
换引擎
自编译 RDNA3 fork
0.1.43(比官方的 0.1.54 更老,但更快),hipBLASLt 调优表从100500换成100100,和 fork 的 ROCm 对齐。38 个环境变量
矩阵乘
STRATA_HIP_WMMA=1              STRATA_SELECT_WMMA=1
STRATA_RDNA_MMVQ_WAVE=3        STRATA_PF_F16=2
Prefill 路径
STRATA_PF_GEMM=1               STRATA_PF_FUSED=1
STRATA_PF_PAD=1                STRATA_PF_GROUP_RES=1
STRATA_PF_HCDOWN=1             STRATA_PREFILL_AUTO_MAX=32768
STRATA_PREFILL_CPU_SHARE=auto  STRATA_PREFILL_CPU_SHARE_MAX=6144
STRATA_PREFILL_RING=192        STRATA_PREFILL_MMQ_TILE_ROWS=32
GDN(线性注意力)融合
STRATA_GDN_HEAD=1        STRATA_GDN_CHUNKED=1
STRATA_GDN_CHUNK_GDV=0   STRATA_GDN_PP=1
STRATA_GDN_CONVL2=1      STRATA_GDN_NOY=1
STRATA_FUSE_CONVAB=1
Attention 与 KV
STRATA_QSA_SPLIT_ATTN=1  STRATA_PA_KLDS=1
STRATA_PA_FAST=1         STRATA_KV_HOST_DMA=1
调度与流水
STRATA_QFUSE=1           STRATA_COMBINE_CPU=1
STRATA_WAIT_FUSE=1       STRATA_ROUTE_PUBLISH=1
STRATA_GR_INJ_UP=1       STRATA_GR_FUSED=1
STRATA_STAGER_RING=64    STRATA_HC_UPMIX=1
STRATA_HEAD_MIX_MULTI=1  STRATA_VERIFY_QDEDUP=1
STRATA_SH_STREAM=0       GPU_MAX_HW_QUEUES=6
引擎参数
--lookup-chain 3         --adapt-async 1
--kv-resident 32768      --ple-io direct
--ple-row-cache 1048576  --pcie-frac 0
--mtp-window 4096        --pool-workers 12
--vram-reserve-mib 1728  --host-core first
--kv int8                --spec 4
--spec-min-p 0.5         --max-context 131072
三个关键点
STRATA_PREFILL_AUTO_MAX从默认 12288 提到 32768(官方日志里能看到它自动选了 12288,13K 以上上下文要分两次处理)。32768 是安全上限,65536 会崩。STRATA_RDNA_MMVQ_WAVE=3—— decode 收益的主要来源。预编译引擎不认这个变量,必须自编译。--host-core first—— fork 不认sibling,照搬官方配置的写法会启动失败。
现在是
prefill decode 相对本来 3205 96.3 +54% / +49% 三轮明细:prefill 3317 / 3205 / 3167,峰值 3313(背靠背第 2 轮)。
更长上下文(54.8K):prefill 3308.8、decode 99.9 —— 上下文翻倍,速度不掉。
对比
本来 现在 提升 prefill @27.5K 2086 3205 +54% prefill 峰值 2046 3313 +62% decode @27.5K 64.7 96.3 +49% prefill @54.8K — 3308.8 — decode @54.8K — 99.9 — 27.5K 首字延迟 13.2 s 8.6 s -4.6 s 参考:一台 128 GB 内存的 Linux 机器同模型跑 3432 / 100.4,我们这台 64 GB 的 Windows 消费机到 93% / 96%。
Radeon RX 7900 XTX (gfx1100) / i7-13700KF / 64 GB / Windows 11 / Qwen3.8-Flash-Next abliterated IQ3_S / strata 0.1.43(自编译 RDNA3 fork)
-
-
-
-
-
-
以下全部来自实测日志(非估算),中位数取自每臂 2–3 次重复:
指标 0.1.45 原版 0.1.45 + RDNA3 env 0.1.45 + RDNA3 + 全套调优 升级至0.1.54 升级至0.1.55 4K prefill tok/s 1179 1997 2094 2041 2017 16K prefill tok/s 1766 2761 2805 2697 2710 32K prefill tok/s 1779 3029 3194 3074 3108 chat decode 中位 tok/s 78.2 79.2 80.5 77.1 82.7 agent decode tok/s 88.2 92.0 87.6 95.0 97.1 agent cache hit % — — 68.65 69.25 69.42 供参考。
X99洋垃圾+7900XTX
-
以下全部来自实测日志(非估算),中位数取自每臂 2–3 次重复:
指标 0.1.45 原版 0.1.45 + RDNA3 env 0.1.45 + RDNA3 + 全套调优 升级至0.1.54 升级至0.1.55 4K prefill tok/s 1179 1997 2094 2041 2017 16K prefill tok/s 1766 2761 2805 2697 2710 32K prefill tok/s 1779 3029 3194 3074 3108 chat decode 中位 tok/s 78.2 79.2 80.5 77.1 82.7 agent decode tok/s 88.2 92.0 87.6 95.0 97.1 agent cache hit % — — 68.65 69.25 69.42 供参考。
-
-
@空语 楼主你好,我把你这个贴子丢给dsh跑一遍,它给我这样回复了:
剩下那 24% 的 decode 缺口,只能拿到作者的 fork,或者自己改写 src/kernels/cuda/native_mmvq.cu 的 MMVQ 波前布局——那属于原创内核开发,不是复现了。
我的配置是7900xtx,cpu9700x,64g内存。感谢你的回复哈 -
-
-
-
其实不必非得编译 RDNA3 fork 0.1.43,用strata的0.1.45和0.1.54都行,只要让agent去借鉴一下strata rdna3的参数配置,一样能达到差不多的这个速度,也不影响引擎的升级。
@Y-G-0 这个是可以的, 我的agent也真的干了, 成功了。rdna3 的作者这几天也有基于新引擎的更新, 我也都测试了。 不过我的问题是,我用128g内存跑Q4_K_XL. 0.1.43引擎可以把PLE io 设成ram (差不多还剩10g的ram余量), 是最快的。 引擎从某个版本开始, 对内存占用提高了,结果就是只能选direct或mmap,否则就是OOM,把东西挤回硬盘, 都没有原版rdna3设成ram快。 我估计很长一段时间内, 我都没法更新了, 不过这样也比原版strata快不少, 7900xtx单卡, 干长活60tps, 写一段简单代码80+tps
-
@Y-G-0 这个是可以的, 我的agent也真的干了, 成功了。rdna3 的作者这几天也有基于新引擎的更新, 我也都测试了。 不过我的问题是,我用128g内存跑Q4_K_XL. 0.1.43引擎可以把PLE io 设成ram (差不多还剩10g的ram余量), 是最快的。 引擎从某个版本开始, 对内存占用提高了,结果就是只能选direct或mmap,否则就是OOM,把东西挤回硬盘, 都没有原版rdna3设成ram快。 我估计很长一段时间内, 我都没法更新了, 不过这样也比原版strata快不少, 7900xtx单卡, 干长活60tps, 写一段简单代码80+tps
-
-