
# 64G 内存刀尖上的 IQ3_S:「少想一会」的 Swift 1.5 双档重测,245K 还有 170 t/s
-
64G 内存刀尖上的 IQ3_S:「少想一会」的 Swift 1.5 双档重测,245K 还有 170 t/s
前几天那篇 IQ3_S 的帖子之后,我把它删了。原因在 512K 那篇里也写过:内存贴着上限,跑 agent 长任务心里没底,留 IQ2_XS 一档反而踏实。
这两天翻 Strata 的模型文档,看到一个 Swift 1.5——UkisAI 的微调版,跟原版同一个架构、同样的速度和内存,卖点是「思考的 token 更少、质量差不多」,作者自己推荐 IQ2_XS。我拿本地模型主要是跑 agent,一轮对话里思考占掉的时间不少,看到「少想」这两个字就有点兴趣。
于是把两档都重新下了一遍,IQ2_XS 68G、IQ3_S 84G,做成互斥双档,一条命令切换。顺手把 IQ3_S 重新量了一次:上次那组数是十月下旬的,模型和引擎都换过代了,再拿来当基线不合适。
先说结果:七档跑下来 154 到 179 t/s,245K 深度还有 170,全程没崩,口令召回七档全中,质量题四次采样全对。数字全附测法,欢迎拿你的卡来复现打脸。
环境
项 值 GPU NVIDIA RTX PRO 4500 Blackwell 32 GB(驱动 595.99.02,PCIe 4.0 x16) CPU AMD Ryzen 7 3700X,8 核 16 线程 主板 Gigabyte X570 GAMING X 内存 64 GB 物理(MemTotal 60.7 GiB,面板取整显示 61 GB) 磁盘 模型放 Samsung 970 PRO 1TB NVMe 系统 Ubuntu 26.04.1 引擎 Strata 0.2.6 / engine 0.1.55 模型 Swift 1.5 Qwen3.8-Flash-Next IQ3_S(125B MoE) 上下文 262,144 专家缓存 10,612 个 / 20.1 GiB(整卡 32 GB) 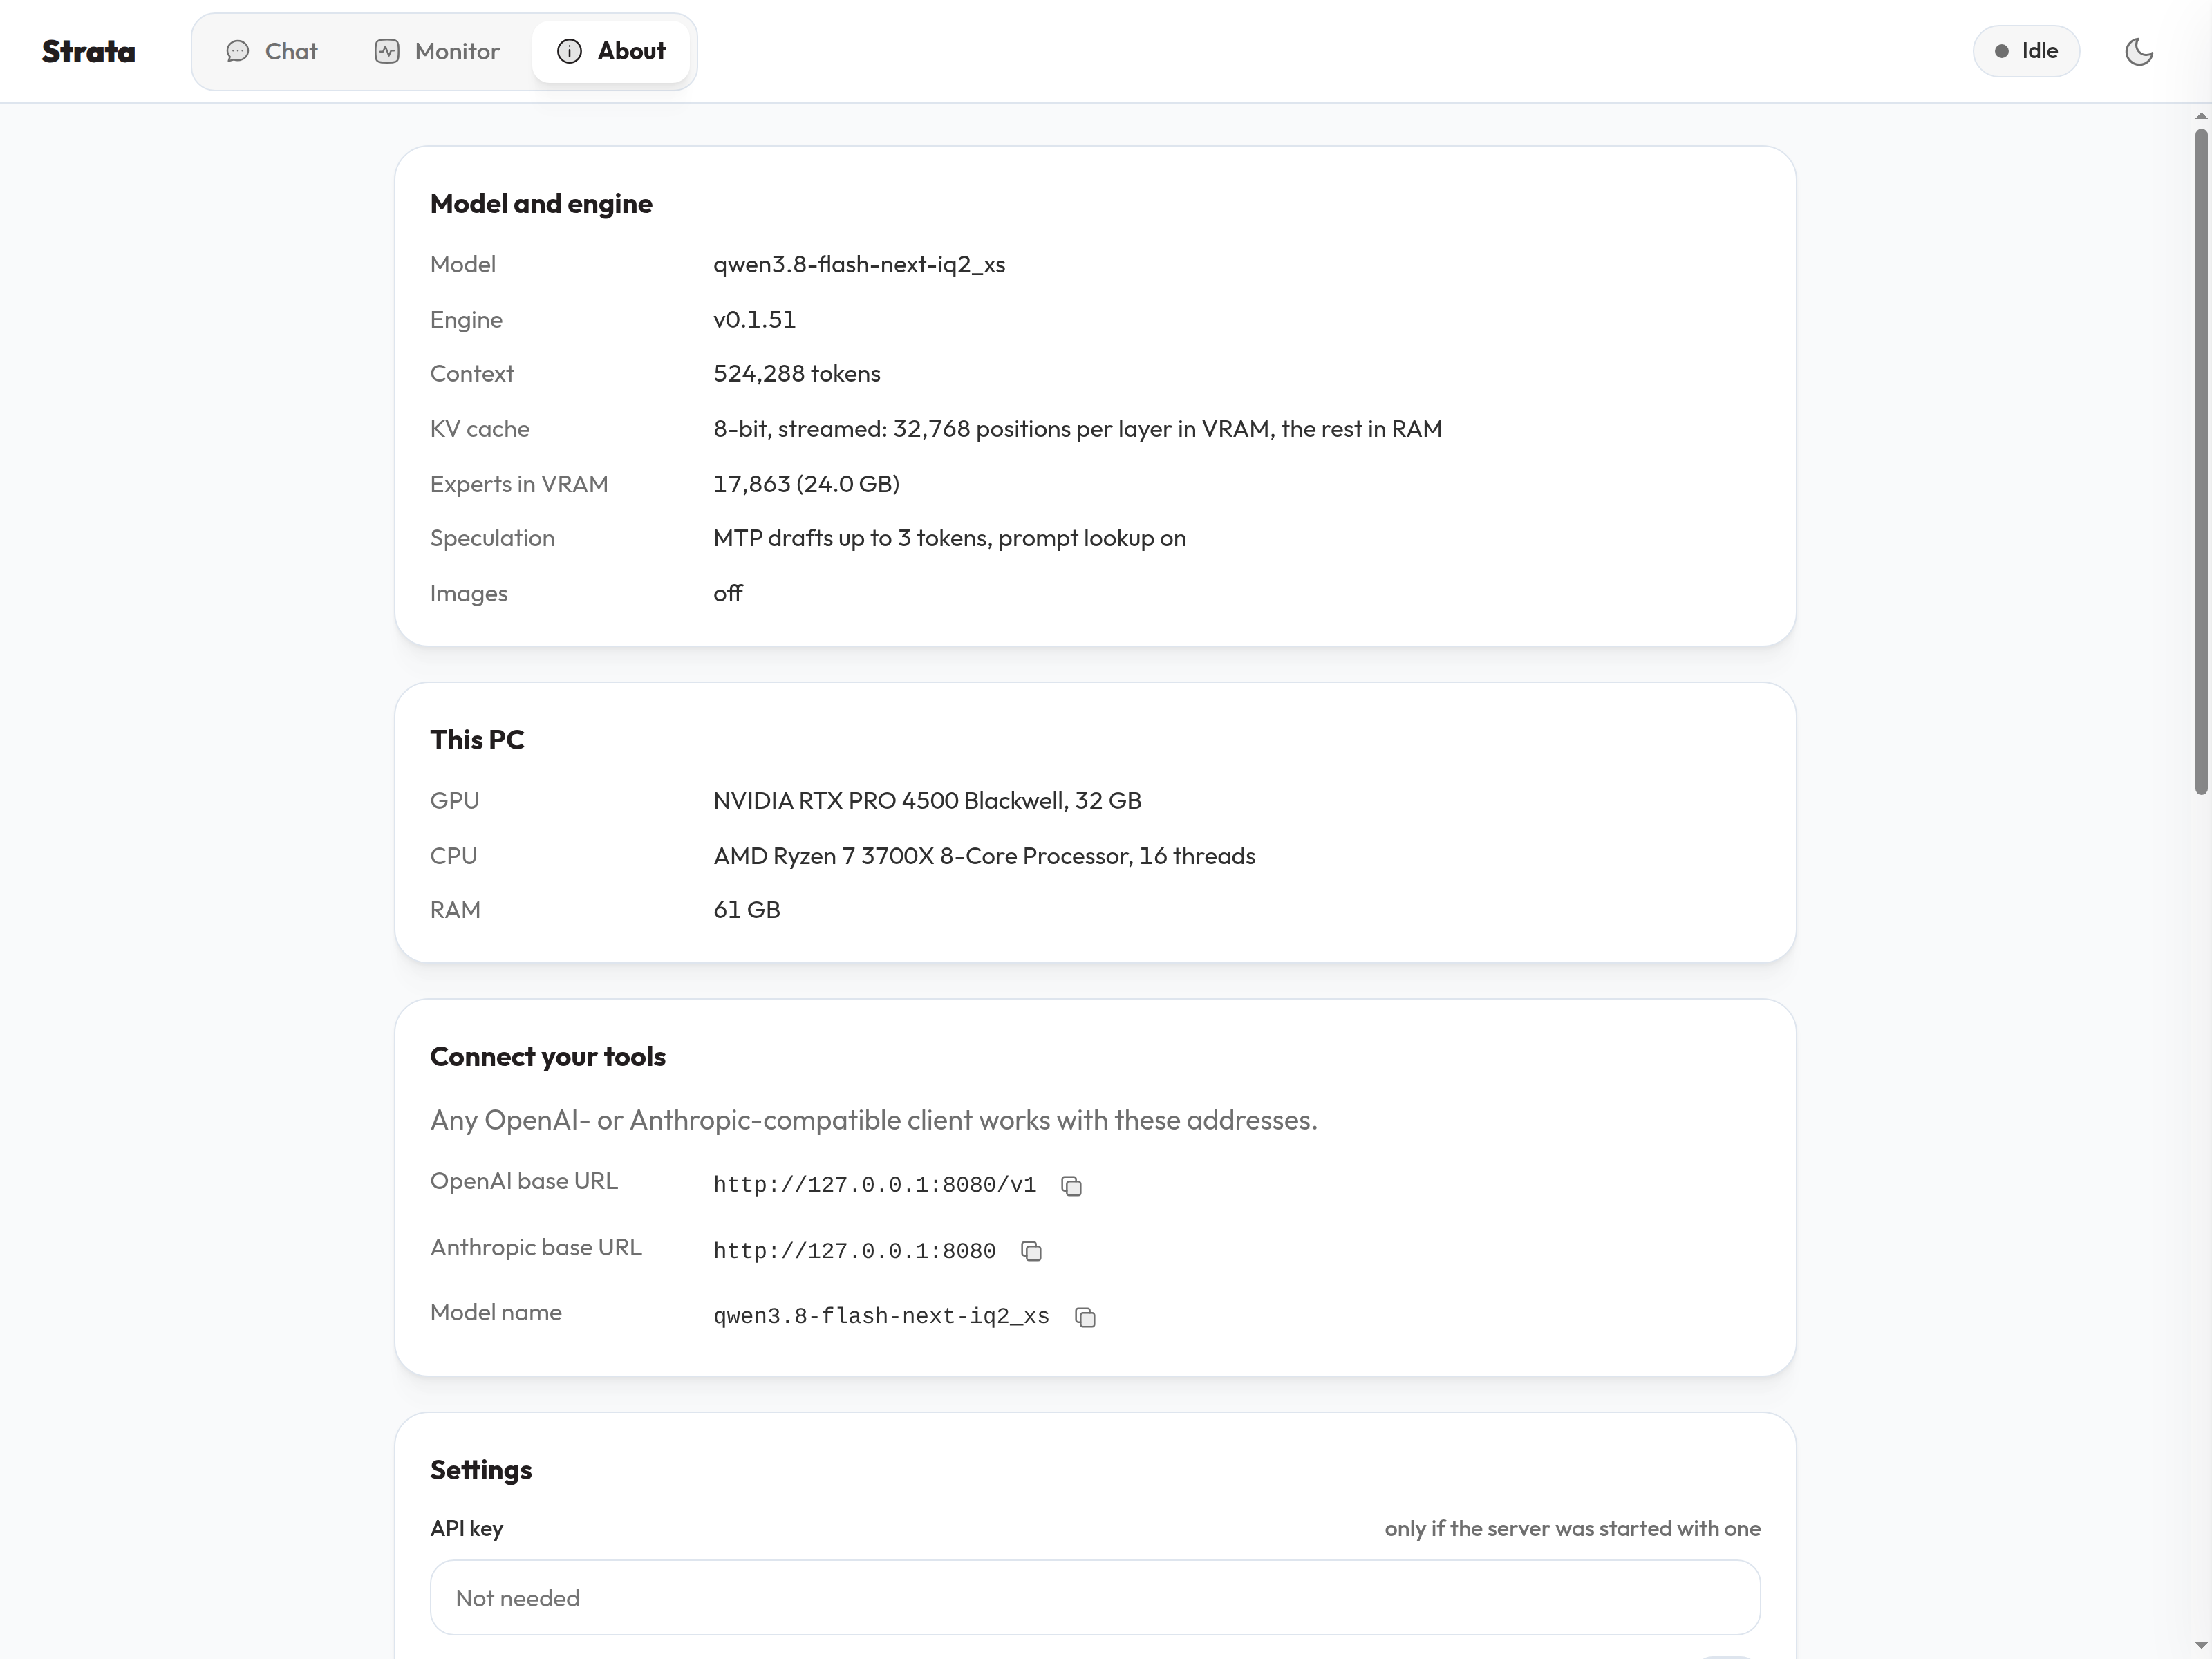
专家槽比上次估计的 IQ3_S 数字少了一千多个。不是我记错,是包换了:Swift 版专家包最大的一个 2.66MB,同样 20 GB 显存装得下的槽数自然少些。槽少不等于命中率差,下面各档命中去到 99% 往上。
配置
IQ3_S 这档按原生的 262K 开,没上 yarn。内存本来就不宽裕,先把稳的跑住。
--max-context 262144
--kv int8
--vram-reserve-mib 700     # 上次日志里报过 VRAM 只剩 510 MiB,这次留出余量
--spec 4 --spec-min-p 0.5
--mtp ~/.models/strata-data/mtp/rt
两档共用 8080,互斥启动:1 是 IQ2_XS(512K 加 yarn、68G 模型、冷启三十来秒),2 是 IQ3_S(256K、84G、四十来秒)。切换脚本一敲,停一个起一个,agent 那边换个模型名就行。
IQ3_S 的内存账:模型两个文件一共 83.7G,其中专家那块 46.84G 是启动时整个读进内存的(日志里写的是 read through the file cache),查表那部分按需从硬盘走,不进内存。显存这边,专家缓存 10,612 个槽吃掉 20.1 GiB,KV 是 int8 全在显存,最后只剩 649 MiB 的余量。
实测
每档一个请求:先在九成深度埋一条口令,让它原样复述,再列 200 个城市名。一次 prefill 同时测召回和吐字,速度只认引擎自己的 timings,不数客户端的分片。
深度(prompt) prefill t/s decode t/s 召回 草稿接受 4,134 2,838 153.9 ✓ 85.7% 8,155 3,565 162.6 ✓ 79.8% 32,342 3,921 173.0 ✓ 82.1% 64,573 3,865 178.8 ✓ 83.6% 129,095 3,757 161.3 ✓ 84.9% 201,655 3,689 173.0 ✓ 83.1% 247,014 3,559 170.3 ✓ 83.3% 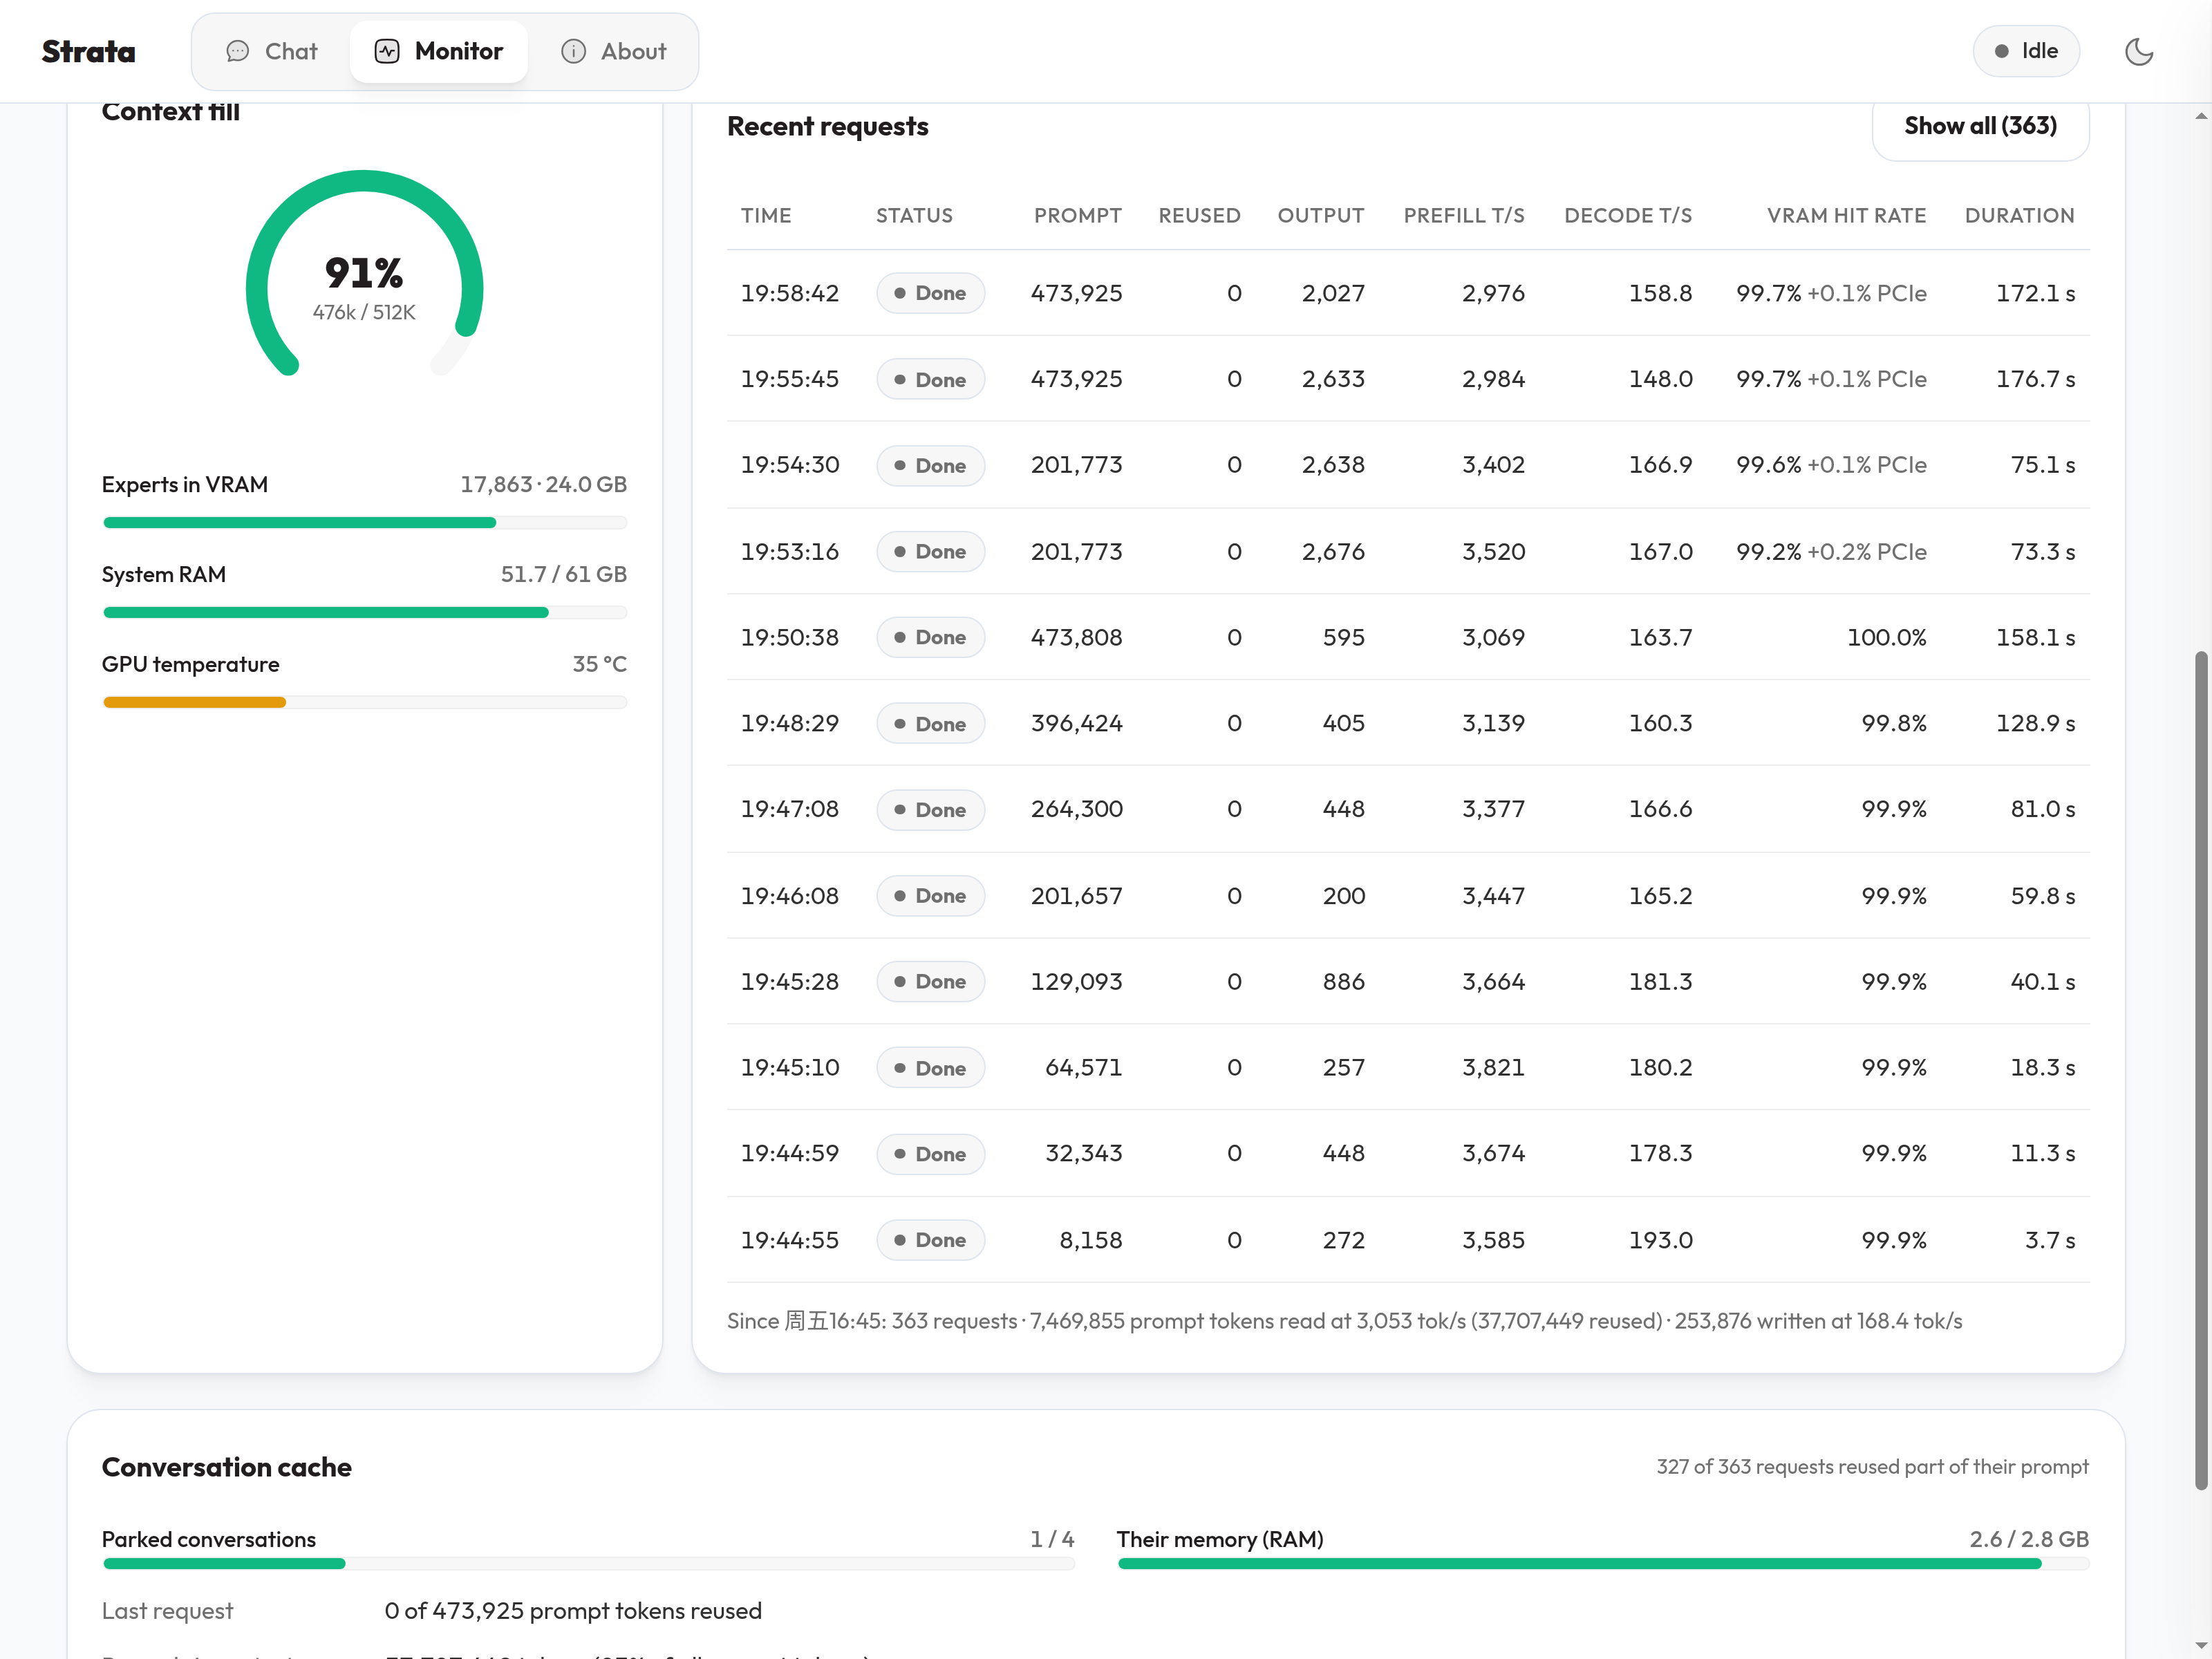
截图里上面七行是速度档,下面四行是质量对照——思考开着、生成长一点,decode 反而只有 130 到 150,正常的。
4K 那档 153.9 偏低,是冷启动后第一次解码,专家还在预热。往后从 8K 到 245K 基本平着走,最高 178.8 在 64K,245K 还有 170.3。中间不是单调的:128K 的 161.3 反而比 64K 低,这类波动主要是草稿接受率在抖(80% 和 85% 就差出来了),不是越深越慢。prefill 在 32K 到 64K 之间到顶,约 3.9K t/s,245K 时还有 3.5K。
截图上那行汇总挺省事:从服务起来到这一刻的 26 个请求,读了 160 万 token,平均 prefill 3,587 t/s,写了 1.6 万 token,平均 143 t/s。
同一个 245K 深度,上次我读到的是 155.4,这次 170.3,差 10%,但不是引擎变快了——上次那发只生成了 356 个 token,这次 827 个。生成窗口短,decode 会被逐 token 的固定开销和投机预热压下去,这个差别多半从这里来。两代数字我按不可比处理。
质量对照
同一道四步算术题(一周出货多少箱 → 折成件数 → 分段打折 → 算总金额),分别塞进 12.9 万和 24.7 万 token 的文档里,各问两次:
- 12.9 万:2/2 正确
- 24.7 万:2/2 正确
- 中间量和终值都对得上:700 箱 / 25,900 件 / 166,800 元
245K 还在模型原生的 256K 窗里,这一档不算外推。IQ2_XS 那边上 yarn 跑到 47 万的外推测试这次没做,两档的上下文上限本来就不一样。
几个要注意的
- 短生成会把 decode 读低:同一个引擎同一个模型,356 token 读 155.4,827 token 读 170.3。测速度得让模型多写点,至少三五百 token,不然测的是预热。
- 测的时候 agent 别跑在同一个引擎上:serving 只有一路,我的对话一轮插进去,压测请求就得排队,wall 变长,专家缓存也被自己的会话搅一遍。这次先把自己切到云端模型再开测,面板从头到尾都是 idle。
- 短提示的 prefill 不是上限:4K 那档只有 2,838,32K 才到 3,921。小 prompt 还吃着固定开销,拿它当引擎能力会低估一截。
- 内存余量是真紧:系统面板 58.1/61 GB,MemAvailable 最低 3.3 GiB,swap 已经用了 3G。同时开 ComfyUI 或者一堆浏览器标签,这档就顶不住。多轮缓存也只有 1.5 GB(IQ2_XS 那边是 2.8 GB),聊几轮之后前面的上下文会被 park,下一轮得重新读。
- 上次崩过的问题这次没复现,但不算解决:这次是纯压测,26 个请求零崩溃、服务没重启;跑几个小时的 agent 长任务,我还没试。
- 内存紧这题论坛有现成方案我还没试:2189 那篇参数篇里的
--resident-experts低内存模式,让显存和内存分工加载不同专家、不再重复占一份,据说能省几十 G 内存,代价是显存没命中时多一次回写。我这台 64G 跑 IQ3_S 正卡在这条线上,回头实测了来回帖。
日常使用
两档都留着,切换一句话的事。平时 IQ2_XS:512K 上下文、内存余量 9G 上下、多轮缓存宽裕;要动脑子写东西,或者一次把整份文档塞进去问清楚,就换 IQ3_S。质量档高四分(基准 93.26 对 89.16),代价是慢一点、上下文少一半。短上下文 IQ2_XS 快一截,到深上下文两边就接近了——不过两档我没在同一套流程下同时跑,速度对比只当参考。
Swift 1.5 这个微调版,官方说思考更短、质量基本不变,我这次只跑了两轮问答(面板上 Thought 都是两秒出头),没做同题对照,不好下结论,先用着看。
引擎版本提前交代一句:本帖全部数字是 Strata 0.2.6 / engine 0.1.55 跑的。论坛 2634 说 0.2.7.1 对 N 卡提升明显(路由器更倾向显存里已有的专家、少分页,12G 的 5070 跑 IQ3_S 平均都破 110 了),但 2496 楼里也有人报了新版死循环、掉速回滚的。我按老规矩先留基线再逐档升,升完实测了在评论区补数字。
复现附录
IQ3_S 这档的完整启动参数(Strata Control 的 run config,路径是我自己的,抄的时候改成你的):
--pack            ~/.models/strata-data/packs/swift-iq3_s
--native          ~/.models/strata-data/models/swift-IQ3_S/Swift-Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf
--ple-gguf        同上(PLE 查表用的就是首分片这个文件)
--expert-profile  /opt/Strata/data/expert-profile.bin
--expert-cache    auto
--prefill         auto
--spec            4
--spec-min-p      0.5
--mtp             ~/.models/strata-data/mtp/rt
--max-context     262144
--kv              int8
--vram-reserve-mib 700
IQ2_XS 那档同一套,三处不同:pack 和模型换成 IQ2_XS 的,
--max-context 524288加--rope-scaling yarn --rope-scale 2,再多一条--kv-resident 32768——512K 的 KV 太大,只让最近 32K 常驻显存,其余流到内存。互斥双档是两把 systemd 用户服务(
strata-swift-iq2xs/strata-swift-iq3s),共用 8080,谁起谁占。切档靠一个全局命令llm-switch,核心就三步:停掉目标以外的全部服务 → 起目标 → 轮询/health等到"loaded": true才算就绪(上限 600 秒,冷启 30 到 57 秒属正常)。我的目标表里除了两档 Strata 还挂了 ComfyUI 和 TTS——32G 的卡同一时刻只让一家占满,所以它们全在一个互斥池里,加新服务就是往表里添一行。llm-switch # 交互菜单,按数字选 llm-switch iq3_s # 直接切 llm-switch stop # 停掉所有推理服务脚本本体一百多行,一堆我自己的历史注释,不方便直接贴;评论区有人要的话我收拾个干净版发出来。
本帖相关的好帖
写这篇时把论坛相关帖翻了一遍,直接相关的列在这,省得各位考古:
- 2189《strata极致优化指南(参数篇)》——
--conversation-cache-mib缓存历史会话免重 prefill、--expert-cache手动档位、--resident-experts低内存模式,全套参数可直接抄 - 2578《strata优化个人总结》——4080S 32G + 128G 内存跑同款 Swift IQ3_S 的调优清单
- 2174《R9700 32G 两种量化对比》——4700+ 次调用实测 IQ3_S 对 UD-IQ4_XS,推理/代码/长上下文 3-bit 反而更强还更快,支持了我选 IQ3_S
- 2179《Strata计算器》——输入配置能估专家槽位,选量化档前丢进去算一遍
-
有了KV stream,--kv-resident 32768, 这个可以省下来很多VRAM给专家槽,KV copy的速度对总体速度好像影响很小,我16G显存都能放心开256K上下文了.

