
双2080Ti跑Strata + Qwen 3.8 Flash Next IQ3S优化经验 和 奇葩配置7950X + 双2080Ti实测数据鉴赏
-
1. 先交代机器配置:九九成稀罕物
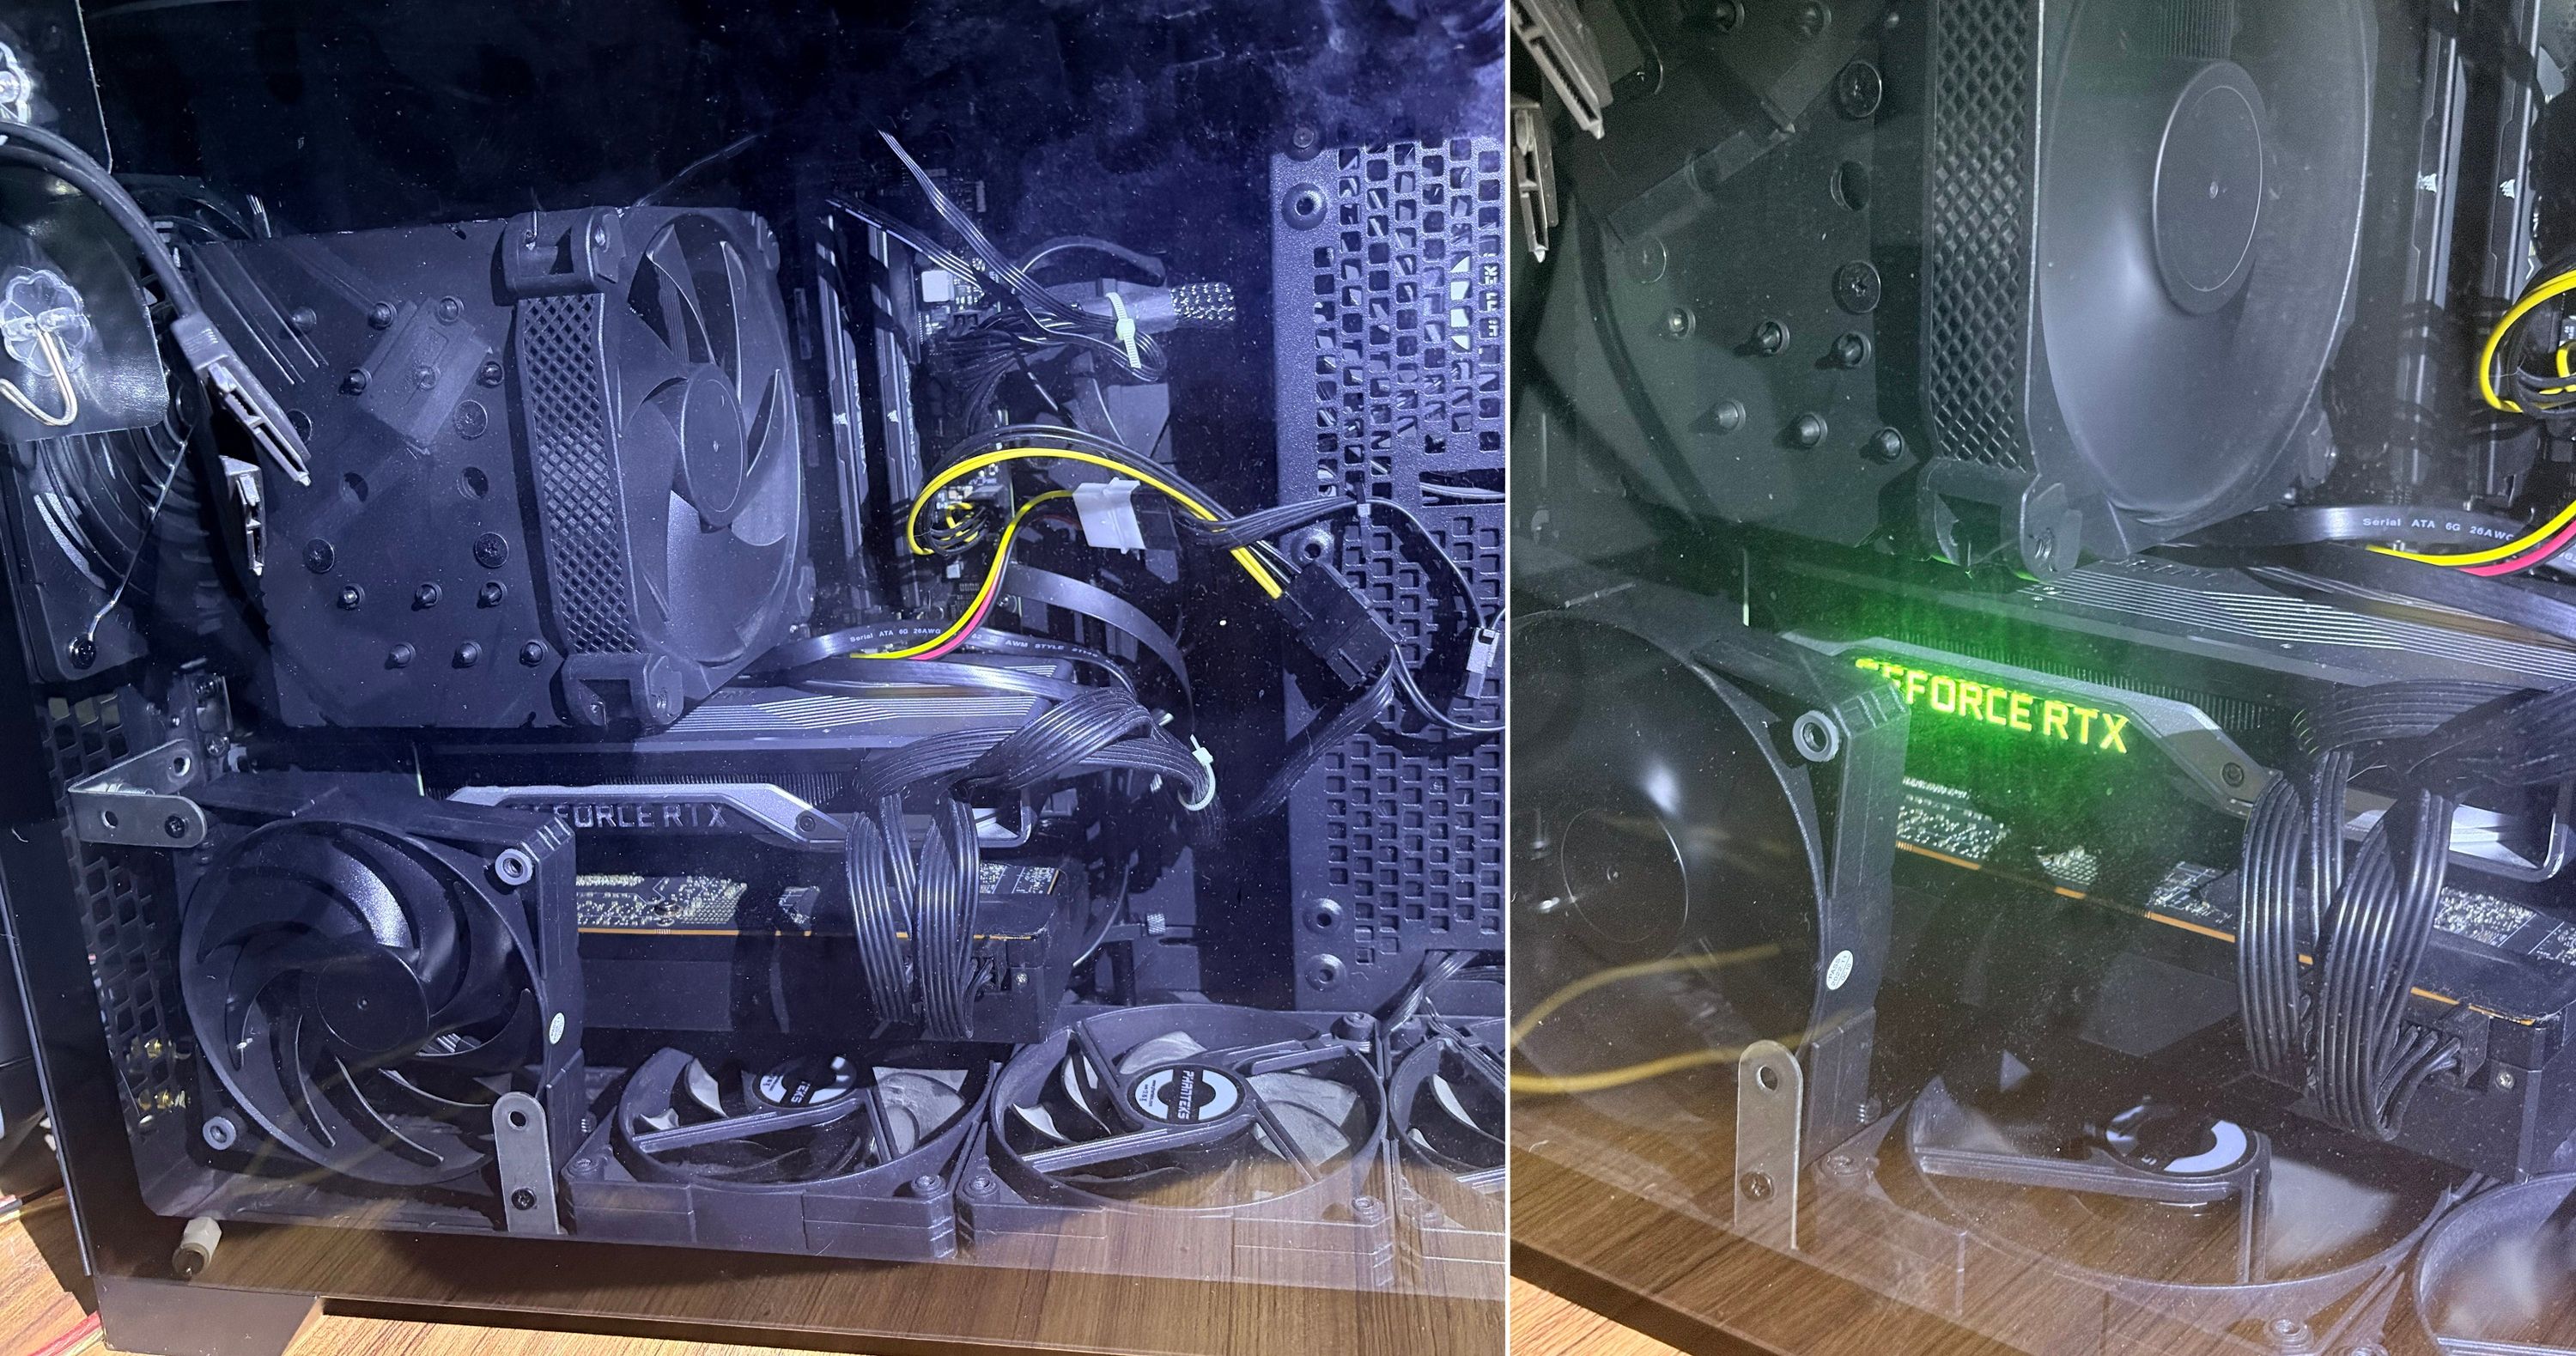
我的上一篇帖子写了 X99 + 双 V100 的机器,那台机器已经成为我现阶段的重活主力。这篇我想写一下在有双V100机器之前,我的Strata入门机。机器配置如下:
· CPU:AMD Ryzen 7950X 16C 32T AVX-512
· 内存:海盗船DDR5 5600 C40 32G x 2
· 主板:华硕 Proart B650
· 显卡:一块公版2080TI 再加 一块矿卡涡轮2080TI,有NVLink,都是11G显存的
· · 这块板 U 双卡只给 x8+x8,监控里 prefill 期间 PCIe 长时间拉满,确认形成瓶颈了。
· 硬盘(安装ubuntu server和strata的):三星 980 PRO 2TB
· 电源:海韵 850W
· 系统:Win11 + Ubuntu Server Minimal 26.04 双系统
组合在论坛里应该不好找。不过这机器是22年底配的,当时还在上学来着。当时就没想到今天这机器会拿来跑像qwen 3.8 flash next这么大的模型,而且当时主要需求也和AI关系不大。结果阴差阳错地给现在的我留下了入门真正有生产力的本地AI的机会。
这篇文章主要是想分享一下我这边双2080Ti跑Strata和Qwen 3.8 Flash Next IQ3S的优化经验,顺便给大家图一乐,毕竟我这奇葩配置可能不是很常见吧。这台模型档位也不同:IQ3_S(46.8G 权重,比上一篇的 UD-Q4_K_XL 轻一大截),256K 上下文。两篇的数字互不可比,本帖也不和上一篇比大小。
 图1:机器照片
2. 性能终档:先把"怎么测"说清楚
2.1 校验流程
本篇所有套件数字都按这个流程跑:
- 冷引擎:跑前重启服务,清掉跨对话缓存;
- 唯一负载:跑分窗口里这台机器只有套件本身(这台跑Strata的话目前是我的备用机,所以窗口好找);
- 完整身份校验:不跳模型哈希,全部权重文件的 SHA-256 写进档案;
- n=3 取中位数,档案目录独立留底,负结果档不删。
软件版本:Terminal 0.2.7 / 引擎 0.1.52(cuda13)/ 驱动 595.91.07。
2.2 短上下文档(conforming 终档
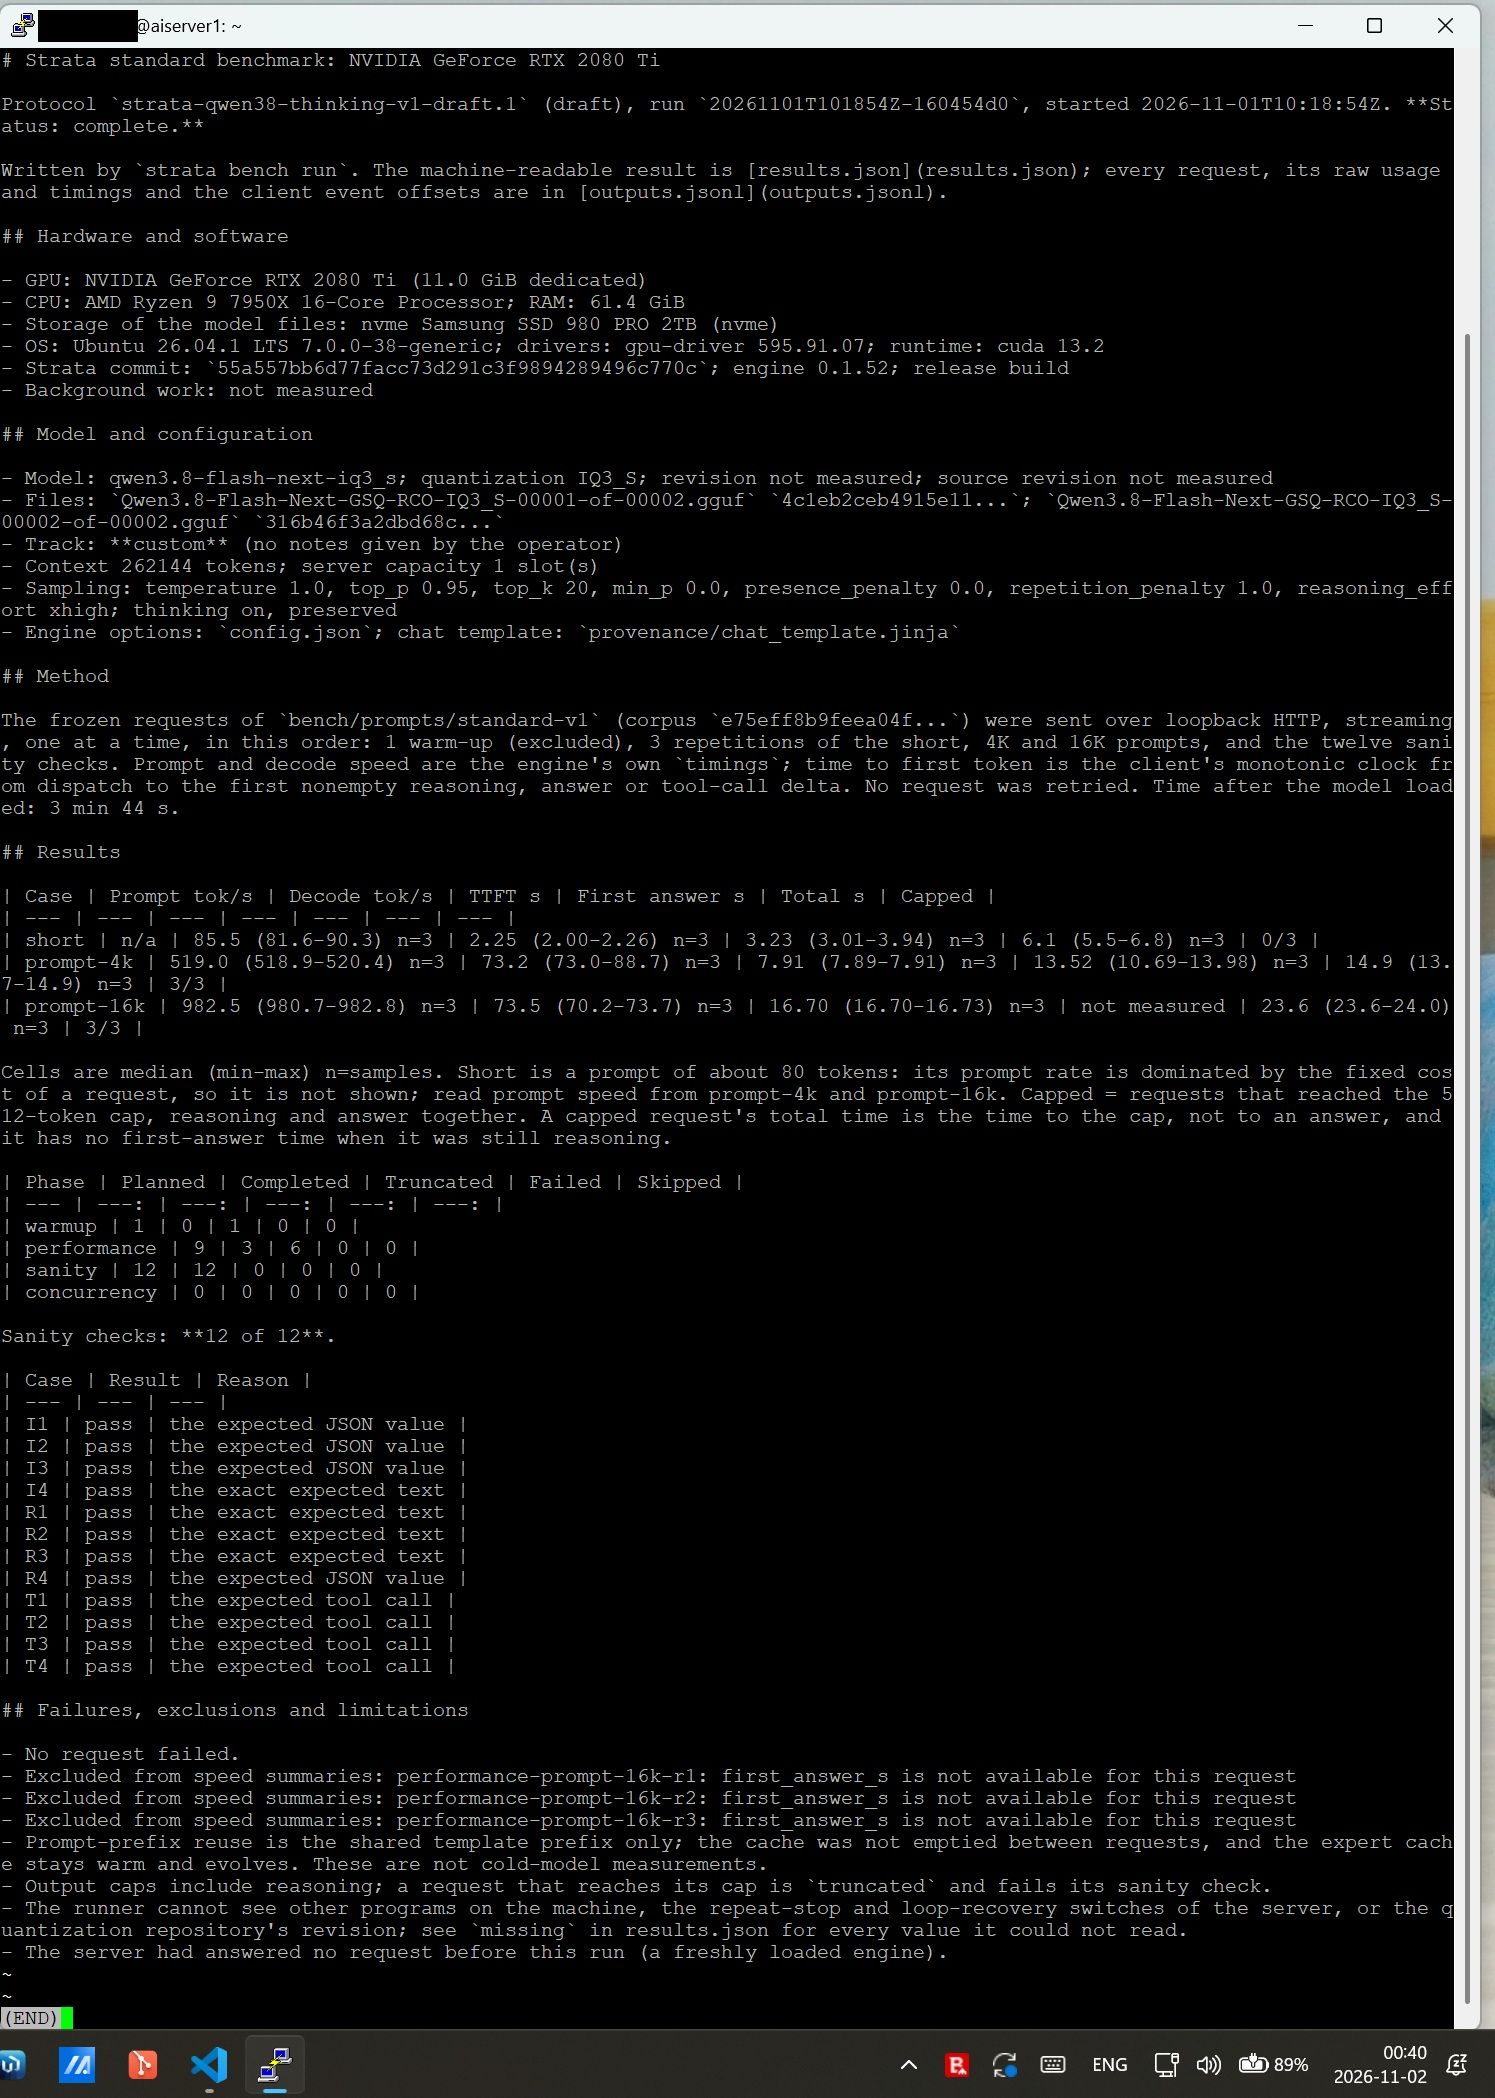
conf-nov1,冷引擎实测)指标(n=3 中位) 短题 4K 16K prompt 读速(tok/s) 34.5(协议也发布了,但短题小分母无意义,正文不聊它) 519.0 982.5 decode(tok/s) 85.5 73.2 73.5 TTFT 首 token 2.25s 7.91s 16.70s 正确性 12/12 在同一档里。一个诚实声明先说在前面:decode 数值天然随题目内容与草稿头接受率起伏(这台 conforming 档实测分布带 73~90,短题 max 90.3),所以本篇所有开关 A/B 都是同轮同批对照、只认成对数字——单看某一次 73 还是 87 没有意义,§3.1 的 69.3→87.6 是同轮 A/B。
图2a:strata benchconforming 终端报告页(含 12/12 与模型哈希行)。
2.3 长上下文档(标题里的 256K,真测到 216K)
语料是自家真实长文重排拼的(每次不同洗牌顺序 + 尾部 unique 编号,保证前缀全新、是真冷读),token 数全部取引擎 usage 回报,不是字符换算;测量脚本兼容思考流的
reasoning_content字段(上一篇交代过的坑,这次直接绕开):实测 prompt_tokens 冷读 TTFT 冷读 prefill tok/s* 深度 decode(tok/s) 同会话第二请求 TTFT 58.7K 45.4s 1293 79.4 0.6s 139.4K 98.5s 1415 77.0 0.9s 215.7K 150.8s 1430 67.6 0.1s (*由 usage 实测数相除,下同。冷读原始 usage JSON 一条:
"prompt_tokens": 58763, "completion_tokens": 162, "prompt_tokens_details": {"cached_tokens": 0}——cached_tokens: 0就是"真冷读"三个字的铁证。(这条与表里 58.7K 那次是同语料不同尾部编号的两次独立冷读,所以 token 数差 32,两条都留在档案里。)引擎计数对账:三档复用共reused_tokens 413779。)2.4 正确性
每个调优档位都是 12/12 sanity(指令遵循/检索/工具调用各 4 题)过了才敢上。三开关采纳前后、长档复测之后,累计多轮复跑零失败。速度收益如果拿正确性抵账,宁可不要。
PS:
- 数字有整有零:全是实测中位数,不凑整。
- 上一篇说过"跑分前重启清缓存",这篇照做了,一次过。上篇的教训救下篇的档,这就是留档案的好处。
2.5 这台画像的天花板:prefill 就是吃满 PCIe 3.0 x8 的活
读速数字先交代理由,这台的天花板不在卡上,在带宽上:
硬件事实两层。第一层:20 系卡是 PCIe 3.0 设备——平台是 4.0 的也没用,卡的代际封顶,这是买卡那天定死的;第二层:这块板双卡只给 x8+x8。两层交集 = 每卡一根原始 7.88GB/s 的速率(lspci 链路状态实测
Speed 8GT/s, Width x8 (downgraded),两卡逐字一致——下面会看到它被顶到线速是什么样子)。为什么分层 MoE 的 prefill 最吃带宽:专家池住内存,prefill 阶段每层每批 token 点到的专家都要现从内存搬进显存——这是全流程搬运量最大的阶段。
"拉满"不是定性说法,是采出来的数。
nvidia-smi dmon -s put每秒采 PCIe 吞吐和板卡功率,配一条 139,395 token 的真冷读(唯一前缀,usage 现场回着cached_tokens:0):卡 rx 峰值(显卡收端=专家搬入向) 持续段(≥85%峰值均值) 持续时长 窗口内功率 均值/功限 GPU0 7.46 GB/s 6.86 GB/s 71 秒 150W / 200W GPU1 7.90 GB/s 6.85 GB/s 84 秒 172W / 220W 7.90 GB/s 这一刀正尖尖顶在 3.0 x8 的原始带宽(7.88GB/s)上——带宽本身就是天花板;持续段 6.85 GB/s ≈ 原始带宽的 87%,是协议开销后的稳定顶法。同一窗口两卡功率均值 150/172W,离 200/220W 的功限还差着一截(瞬时峰值样本短暂越过功限属正常抖动,功限按均值起作用)。算力有富余、带宽顶线速——两个读数并排就是铁证。dmon 原始 196 行、链路 LnkSta(
Speed 8GT/s, Width x8 (downgraded)两卡逐字一致)、功限配对行,全在数据包,不信可以自己对账。具体详细测试数据:
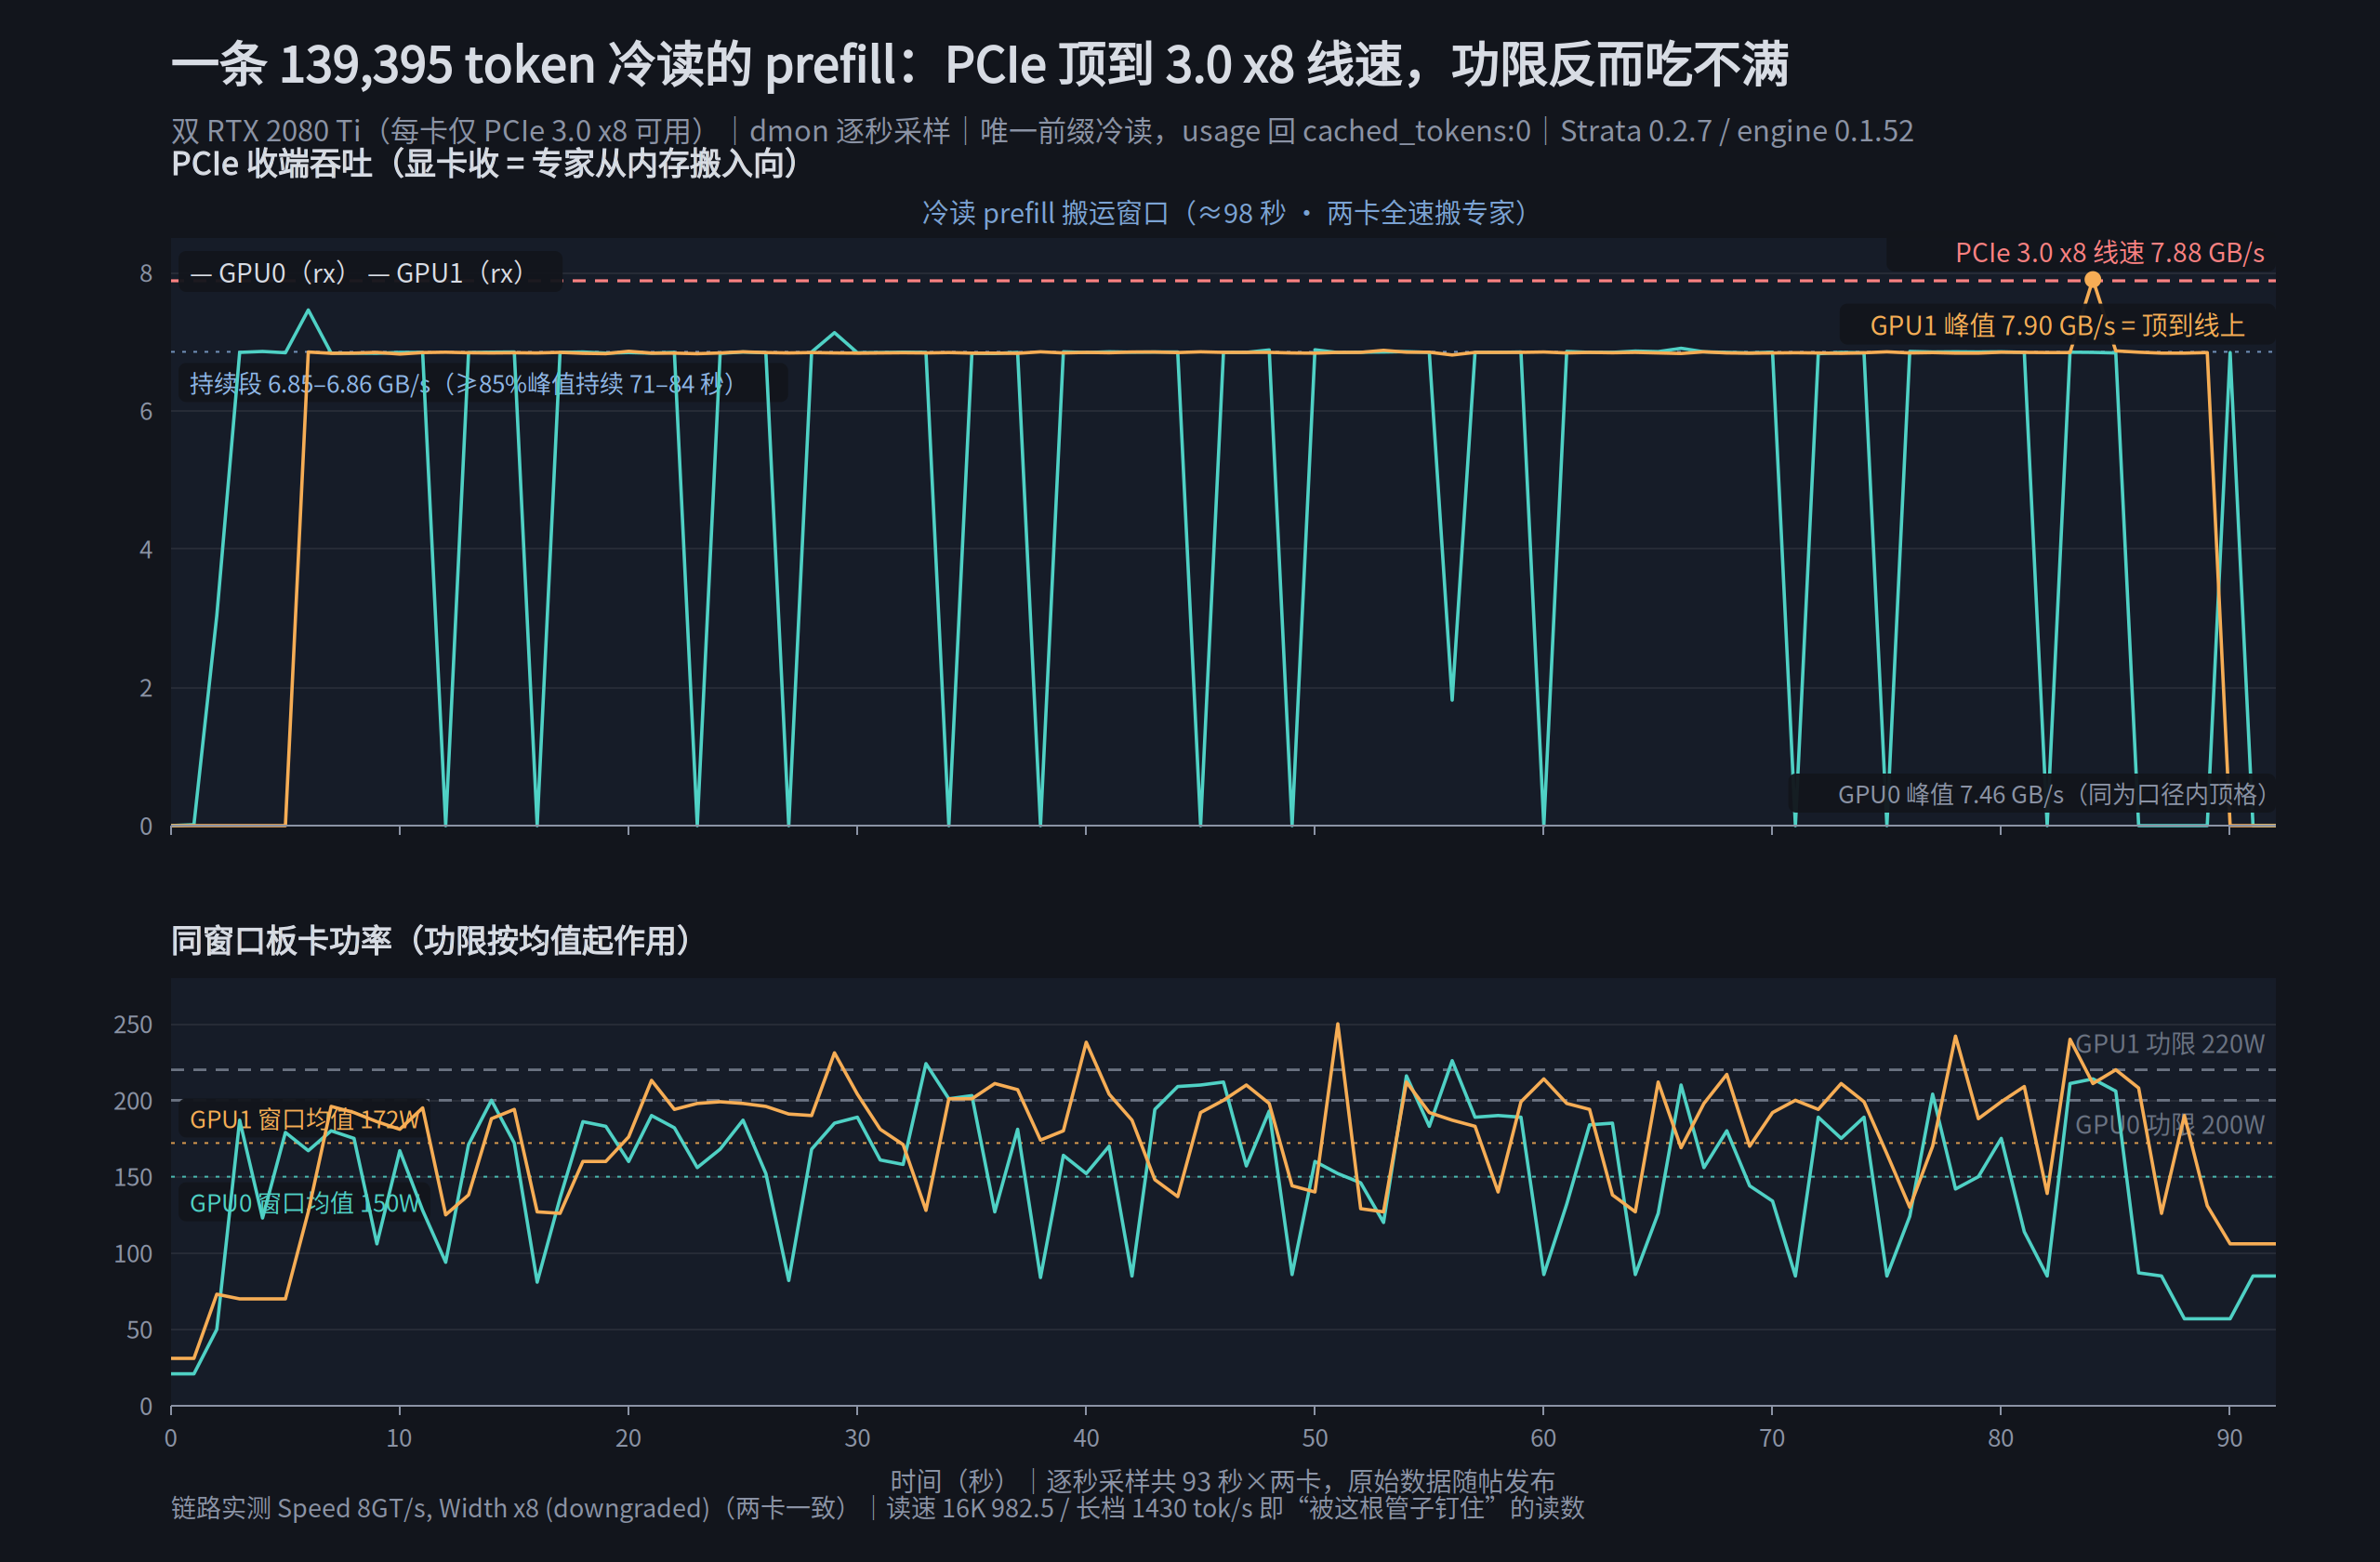
# PCIe 3.0 x8 prefill 吃满实测(2026-11-01 20:56 北京时间,aiserver1,机器重开机后首采) ## 测试方法 - 请求:`~/lp/lp_128k.txt`(家目录下)语料前加唯一 nonce(保证全量前缀未缓存),max_tokens=1、temperature=0,非流式。 - 采样:`nvidia-smi dmon -s put -d 1`(每秒,rxpci/txpci 列 = GPU 侧 PCIe 收/发 MB/s,pwr = 板卡功率 W),与请求并行,请求结束后停止。 - 引擎:Terminal 0.2.7 / 控制包 0.1.53 / engine 0.1.52 cuda13;驱动 595.91.07。 ## 请求原始行(证明真冷读) ELAPSED 98.5 usage {"prompt_tokens": 139395, "completion_tokens": 1, "total_tokens": 139396, "prompt_tokens_details": {"cached_tokens": 0}} ## 链路状态原始行(两卡一致) LnkSta: Speed 8GT/s, Width x8 (downgraded) LnkSta: Speed 8GT/s, Width x8 (downgraded) ## 功限配对原始行(nvidia-smi --query-gpu=index,power.limit,power.draw) 0, 200.00 W, 21.74 W 1, 220.00 W, 32.35 W ## 统计(由原始 dmon 日志程序化重算,rxpci 按 MB/s→GB/s ÷1000) GPU0 rx非零样本74 峰7.46GB/s 峰值85%以上均值6.86GB/s(持续71秒) 全程均值6.65GB/s | pwr 均150W 峰226W(功限200W) GPU1 rx非零样本84 峰7.90GB/s 峰值85%以上均值6.85GB/s(持续84秒) 全程均值6.85GB/s | pwr 均172W 峰250W(功限220W) - PCIe 3.0 x8 原始带宽 = 8GT/s × 8车道 × 128b/130b编码 ≈ 7.88 GB/s。 - GPU1 rx 峰值 7.90GB/s ≈ 线速;持续段 6.85-6.86GB/s ≈ 原始带宽的 87%(协议开销后的稳定顶法)。 - 同窗口功率均值 150/172W,均低于各自功限 200/220W(瞬时峰值样本短暂超限属功率均值的正常抖动,功限按均值起作用)。 - 结论口径:prefill 期间 PCIe 管子拉满、功限吃不满 = 带宽受限的直接画像(本次为精确数值版,替代此前"网页监控画像"的定性表述)。 ## dmon 原始日志全文(196 行) # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 21 34 - 0 2 0 0 0 0 0 0 1 31 30 - 0 0 0 0 0 0 0 0 0 21 34 - 0 2 0 0 0 0 14 2 1 31 30 - 0 0 0 0 0 0 0 0 0 50 35 - 2 3 0 0 0 0 3038 3 1 73 31 - 0 0 0 0 0 0 0 0 0 187 39 - 85 21 0 0 0 0 6846 783 1 70 32 - 0 1 0 0 0 0 0 0 0 123 41 - 100 26 0 0 0 0 6860 797 1 70 32 - 0 0 0 0 0 0 0 0 0 179 40 - 100 25 0 0 0 0 6841 782 1 70 32 - 0 0 0 0 0 0 0 0 0 167 40 - 100 24 0 0 0 0 7458 797 1 127 35 - 71 15 0 0 0 0 6852 783 0 180 42 - 100 26 0 0 0 0 6835 783 1 196 37 - 100 23 0 0 0 0 6831 781 0 175 41 - 100 27 0 0 0 0 6836 789 1 192 37 - 100 23 0 0 0 0 6836 794 0 106 40 - 100 24 0 0 0 0 6831 781 1 186 37 - 100 22 0 0 0 0 6847 784 0 167 42 - 42 10 0 0 0 0 6845 783 1 181 37 - 100 20 0 0 0 0 6822 793 0 128 41 - 100 26 0 0 0 0 6846 797 1 195 38 - 100 23 0 0 0 0 6844 782 0 94 41 - 100 24 0 0 0 0 0 0 1 125 39 - 100 24 0 0 0 0 6849 783 0 171 43 - 39 9 0 0 0 0 6843 787 1 138 39 - 100 22 0 0 0 0 6841 786 0 200 43 - 100 27 0 0 0 0 6849 784 1 188 39 - 100 23 0 0 0 0 6837 794 0 172 44 - 100 28 0 0 0 0 6851 796 1 194 39 - 100 25 0 0 0 0 6841 783 0 81 41 - 100 25 0 0 0 0 0 0 1 127 41 - 100 22 0 0 0 0 6837 784 0 136 43 - 36 7 0 0 0 0 6847 784 1 126 41 - 98 20 0 0 0 0 6845 783 0 186 44 - 100 28 0 0 0 0 6852 786 1 160 41 - 100 23 0 0 0 0 6831 794 0 183 44 - 100 28 0 0 0 0 6834 789 1 160 41 - 100 24 0 0 0 0 6827 795 0 160 43 - 100 26 0 0 0 0 6842 783 1 176 41 - 100 22 0 0 0 0 6863 785 0 190 45 - 38 8 0 0 0 0 6835 782 1 213 42 - 100 22 0 0 0 0 6836 782 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 182 44 - 100 29 0 0 0 0 6847 782 1 194 42 - 100 23 0 0 0 0 6836 782 0 156 44 - 100 27 0 0 0 0 0 3089 1 198 42 - 100 24 0 0 0 0 6827 782 0 168 44 - 39 7 0 0 0 0 6833 784 1 199 43 - 100 23 0 0 0 0 6837 783 0 187 45 - 100 29 0 0 0 0 6852 784 1 198 43 - 100 24 0 0 0 0 6854 782 0 152 45 - 100 30 0 0 0 0 6840 785 1 196 43 - 100 24 0 0 0 0 6844 782 0 82 43 - 100 26 0 0 0 0 0 0 1 191 43 - 100 23 0 0 0 0 6839 784 0 168 46 - 36 6 0 0 0 0 6851 784 1 190 44 - 98 22 0 0 0 0 6842 784 0 185 45 - 100 30 0 0 0 0 7130 798 1 231 44 - 100 24 0 0 0 0 6837 787 0 189 46 - 100 30 0 0 0 0 6840 782 1 204 44 - 100 24 0 0 0 0 6835 781 0 161 45 - 100 26 0 0 0 0 6843 782 1 181 44 - 100 24 0 0 0 0 6839 782 0 158 46 - 39 8 0 0 0 0 6848 783 1 171 46 - 100 21 0 0 0 0 6841 783 0 224 47 - 100 30 0 0 0 0 6846 783 1 128 46 - 100 25 0 0 0 0 6839 782 0 201 46 - 100 26 0 0 0 0 0 996 1 201 45 - 100 24 0 0 0 0 6844 795 0 203 46 - 39 8 0 0 0 0 6832 782 1 201 46 - 100 24 0 0 0 0 6834 783 0 127 47 - 100 29 0 0 0 0 6830 784 1 211 46 - 100 25 0 0 0 0 6836 782 0 181 47 - 100 30 0 0 0 0 6846 783 1 207 46 - 100 25 0 0 0 0 6831 782 0 84 45 - 100 27 0 0 0 0 0 0 1 174 46 - 100 25 0 0 0 0 6853 784 0 164 48 - 36 9 0 0 0 0 6854 784 1 180 46 - 98 21 0 0 0 0 6839 782 0 152 48 - 100 29 0 0 0 0 6844 784 1 238 47 - 100 25 0 0 0 0 6847 783 0 170 48 - 100 30 0 0 0 0 6854 783 1 204 47 - 100 25 0 0 0 0 6841 782 0 85 47 - 100 28 0 0 0 0 6849 784 1 187 47 - 100 25 0 0 0 0 6851 783 0 194 48 - 100 29 0 0 0 0 6852 784 1 148 49 - 100 23 0 0 0 0 6850 784 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 209 48 - 100 30 0 0 0 0 6851 784 1 137 49 - 100 25 0 0 0 0 6844 783 0 210 48 - 100 29 0 0 0 0 0 1196 1 192 48 - 100 24 0 0 0 0 6853 781 0 212 48 - 40 10 0 0 0 0 6847 784 1 200 48 - 100 23 0 0 0 0 6846 785 0 157 48 - 100 28 0 0 0 0 6846 785 1 210 48 - 100 26 0 0 0 0 6846 782 0 193 48 - 100 31 0 0 0 0 6880 783 1 198 48 - 100 24 0 0 0 0 6845 783 0 86 47 - 100 29 0 0 0 0 0 0 1 144 48 - 100 26 0 0 0 0 6837 784 0 160 50 - 36 10 0 0 0 0 6884 783 1 140 49 - 98 22 0 0 0 0 6836 782 0 152 49 - 100 27 0 0 0 0 6844 783 1 250 49 - 100 26 0 0 0 0 6846 783 0 146 50 - 100 30 0 0 0 0 6848 783 1 129 49 - 100 25 0 0 0 0 6845 783 0 120 49 - 100 30 0 0 0 0 6850 783 1 127 49 - 100 26 0 0 0 0 6876 783 0 216 50 - 100 27 0 0 0 0 6856 786 1 212 50 - 100 22 0 0 0 0 6849 784 0 183 50 - 100 30 0 0 0 0 6847 784 1 192 50 - 100 27 0 0 0 0 6849 783 0 226 50 - 100 30 0 0 0 0 1815 7162 1 187 50 - 100 26 0 0 0 0 6809 798 0 189 50 - 39 12 0 0 0 0 6846 783 1 183 50 - 100 22 0 0 0 0 6846 784 0 190 50 - 100 26 0 0 0 0 6847 784 1 140 51 - 100 27 0 0 0 0 6845 783 0 189 50 - 100 32 0 0 0 0 6851 784 1 199 51 - 100 27 0 0 0 0 6846 783 0 86 49 - 100 29 0 0 0 0 0 0 1 214 50 - 100 27 0 0 0 0 6852 782 0 132 50 - 37 11 0 0 0 0 6858 797 1 198 50 - 98 22 0 0 0 0 6839 781 0 184 51 - 100 27 0 0 0 0 6845 782 1 194 51 - 100 26 0 0 0 0 6845 783 0 185 51 - 100 32 0 0 0 0 6845 783 1 138 52 - 100 26 0 0 0 0 6840 782 0 86 51 - 39 11 0 0 0 0 6865 784 1 127 52 - 100 27 0 0 0 0 6847 783 0 126 51 - 99 27 0 0 0 0 6856 789 1 212 51 - 100 23 0 0 0 0 6838 784 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 210 51 - 100 32 0 0 0 0 6905 797 1 169 51 - 100 26 0 0 0 0 6829 791 0 156 51 - 100 30 0 0 0 0 6853 1106 1 198 51 - 100 27 0 0 0 0 6854 783 0 180 51 - 42 11 0 0 0 0 6847 783 1 217 52 - 100 24 0 0 0 0 6838 785 0 144 52 - 98 27 0 0 0 0 6839 782 1 170 53 - 100 26 0 0 0 0 6835 782 0 134 51 - 100 32 0 0 0 0 6848 783 1 192 53 - 100 27 0 0 0 0 6837 783 0 85 50 - 100 30 0 0 0 0 0 0 1 200 52 - 100 27 0 0 0 0 6840 782 0 189 51 - 42 12 0 0 0 0 6827 782 1 194 52 - 98 24 0 0 0 0 6838 782 0 175 51 - 93 26 0 0 0 0 6847 796 1 211 54 - 100 25 0 0 0 0 6832 783 0 189 52 - 100 31 0 0 0 0 6838 785 1 199 53 - 100 28 0 0 0 0 6840 784 0 85 50 - 48 14 0 0 0 0 0 619 1 165 53 - 100 26 0 0 0 0 6854 784 0 124 53 - 89 24 0 0 0 0 6859 785 1 130 53 - 100 25 0 0 0 0 6837 783 0 204 52 - 100 32 0 0 0 0 6852 787 1 170 53 - 100 29 0 0 0 0 6842 783 0 142 53 - 100 30 0 0 0 0 6854 785 1 242 54 - 100 25 0 0 0 0 6836 783 0 150 52 - 53 15 0 0 0 0 6851 785 1 188 53 - 100 25 0 0 0 0 6835 796 0 175 52 - 85 24 0 0 0 0 6853 783 1 199 53 - 100 25 0 0 0 0 6848 783 0 114 52 - 100 32 0 0 0 0 6846 785 1 209 54 - 100 28 0 0 0 0 6846 784 0 85 51 - 100 30 0 0 0 0 0 0 1 139 53 - 100 25 0 0 0 0 6842 795 0 211 53 - 56 16 0 0 0 0 6848 783 1 240 53 - 98 26 0 0 0 0 6844 782 0 214 53 - 78 18 0 0 0 0 6847 783 1 211 53 - 100 24 0 0 0 0 7901 784 0 206 54 - 100 23 0 0 0 0 6837 782 1 220 54 - 100 28 0 0 0 0 6868 782 0 87 51 - 60 13 0 0 0 0 0 0 1 208 54 - 100 25 0 0 0 0 6849 783 0 85 51 - 0 0 0 0 0 0 0 0 1 126 53 - 100 27 0 0 0 0 6836 781 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 57 49 - 0 0 0 0 0 0 0 0 1 190 54 - 100 22 0 0 0 0 6835 791 0 57 49 - 0 0 0 0 0 0 0 0 1 131 54 - 100 19 0 0 0 0 6842 782 0 57 49 - 0 0 0 0 0 0 6842 781 1 106 53 - 97 19 0 0 0 0 0 562 0 85 50 - 56 1 0 0 0 0 0 0 1 106 52 - 59 2 0 0 0 0 0 0 0 85 50 - 3 1 0 0 0 0 0 0 1 106 52 - 0 0 0 0 0 0 0 0所以 §2.2/§2.3 那些读速是"被带宽钉住的天花板",不是 GPU 的极限。如果 PCIe 通道有余量(同一张 Gen3 卡插 x16,通道直接翻倍到 15.75GB/s),prefill 还应该再往上走一截——能到多少这台测不了(双卡与单条 x16 在本板互斥),我不给倍数承诺,但方向是确定的:瓶颈在带宽不在卡芯。
这笔账顺手解开帖里另外两个疙瘩:为什么 §4 里计算类开关在 16K 口径测出来是零——带宽拉满时,计算再快也只是在带宽口排队,长题靠批量摊薄把每 token 的占管降下来,收益才透得出来;为什么 decode 却能 +26%——decode 每 token 只搬点亮路由的少数专家、99% 命中根本不太占带宽,它的天花板在计算路径上,开关自然够得着。
3. 优化参数全放送:每一条讲原理、给实测、标坑
先立总纲:这台机器优化前后面貌完全不同,但收益全部来自配置,一分钱硬件没加。sm_75 在 Strata 生态里属于"文档没专门写过"的架构,所以每个开关都必须自己 A/B——下面每条都有档案编号可查。
3.1 Turing 三开关(本帖最值钱的一条):decode +18~26%
Turing 没有原生的 BF16/TF32 张量核路径。官方为 Turing 页写了两个 opt-in 开关,还特意注明"这是既有代码路径,不是新写的 kernel";第三个
SM75_PERF的 kernel 来自 issue #3282 的实测(官方回复说考虑设为 sm_75 默认)。三个我都自己 A/B 过:开关 干什么(机理上能解释:) 我的实测 STRATA_BF16_TC=1prefill 的 BF16 投影操作数转 FP16 走 FP16 张量核(FP32 累加) 长题读 +7~19%(与下条叠加后的组合收益,单开关归因见档案臂) STRATA_SELECT_SIMT=1注意力块打分器(QSA)从 warp 通路换成分块 tiled FP32 通路(官方口径) 我这台 decode 大头增益(B 臂 +12~13%);官方 Quadro 数据里它是 prompt 项 +6%——decode 归因是本平台实测 STRATA_SM75_PERF=1为 sm_75 启用专用 kernel(机主提供,未成默认) decode 再 +12~13%(叠加在上两条之上);同机主的贪心重跑对照显示开关开/关生成文本集合与频次一致 叠加后:decode 4k 69.3→87.6(+26%)、16k 67.3→79.7(+18%)、80K 长题 +7.6%、171K 长题 +19.0%(standard-v1 与长题探针,同机同轮三臂对照,档案
sm75ab2-*)。注意每行"我的实测"是组合叠加中的归因,不是可加和的单开关数字。护栏也立着:官方文档对 BF16_TC 的提醒是"舍入次序变了,9 对配对请求里有 3 条回答变了"——这类开关本来就是拿舍入换速度。万一写作/工具调用里出现 JSON/数字类输出异常,撤
SM75_PERF这一条重启,一分钟回退——采纳当晚四轮 12/12 加后续复测都干净,但护栏留着不丢人。3.2 显式层切 + trim:专家槽的隐藏机关
--trim-stage-weights让每张卡只加载自己负责层的密集阶段权重,腾出的显存全换成专家缓存槽。机理简单,坑在一个"显式"上:- 层切设
auto时,引擎自己穷举出的摆放不算显式,trim 被静默忽略——不报错、不告警(引擎日志口径:两卡合计 4087 槽=CUDA0 2109+CUDA1 1978); - 顶层
layer_split=24(显式数字)后 trim 解锁:合计 5088 槽(3103+1985)——正好多出约一千个。重装第一晚开机对账时我发现槽数比预期少了约一千,顺藤摸瓜才抓到这个静默失效; - 顺手也试过
26:合计 5047 槽(2980+2067)、16K 读速与 24 持平——切点不是越大越好,24 是实测甜点。
3.3 显存安全余量:留着余量,读速反而全场最快
默认配置装载完 CUDA0 只剩 552 / CUDA1 只剩 430MiB(引擎自己打出 LOW 警告),第一个真实请求一开工就把红线告警 #2065 撞出来了——原话:"when the card is this full the driver can page GPU memory to system RAM, decode falls to a few tok/s",请求开始低余量告警连打好几行(free 474/454/444/440/420MiB,两卡混合)。余量梯度(11G 卡上的本机 A/B,每档独立 bench 档案):
档位 initial/later(MiB) 专家槽(两卡合计=CUDA0+CUDA1) 16K 读(tok/s) 装载后 free(CUDA0/CUDA1) 告警 默认 5088 964.9 552/430 请求期触发 #2065(告警行 474/454/444/440/420) 1100/1184 4634(2885+1749) 899.5 — 零 900/1184 4743(2994+1749) 902.9(-6.4% vs 964.9) — 零 900/900(终态) 4881(2994+1887) 972.5-973.3(全场最快) 752/630 零(连 215.7K 长档探针期间也零) "省显存"抠到骨头是给读速和 decode 交税的,留足余量几乎免费甚至倒赚;later 预留单独拔高是最亏的一档(900/1184 两头不讨好,-6.4%);余量数值是随配置变的常数,不是通用真理——上一篇那台 16G 卡的预留数照搬过来就是 1184 档的下场,正确姿势是读引擎开机警告点名的数、自己跑梯度,换机器必重测。并且留足显存余量以后显卡的功耗也降下来了一些,这对能效和散热都是有正面积极作用的。
3.4 跨对话缓存:7G 预算的小水杯也能解大渴
--conversation-cache-mib 7168 --conversation-cache-slots 16 --conversation-cache-min-tokens 2048 --conversation-cache-min-free-mib 2048:上一篇 128G 内存那台给 36G 预算,这台 64G 只给得起 7G,机制一样、账法不同——实测快照 ~671MB/2.07 万 token,park 250ms / restore 83.6ms,2 万 token 级会话约容纳 10 个;五会话停放后第二轮请求从 22s 冷读降到 7.1s。小预算的用法是让它只当"最近十来个会话"的速记本,evictions 渐进增长就随它,突增再动。3.5 其余在役参数一览
参数 一句话 --pipeline-windows 2文档写明 CUDA 上不默认开,必须手加(上一篇同款白捡项) --kv int8+--max-context 262144256K 上下文的容量前提 --spec 4 --spec-min-p 0.5+--mtpMTP 投机解码;实测草稿头工作正常(真请求 drafts accepted 137/264) STRATA_PF_FUSED/STRATA_SPLIT_MTP_BATCH/STRATA_STAGE_TRIM沿用上一代配置的无损项,换代后逐项复测过留下 ROUTE_PRIOR(0.1.52 新默认,≤13G 显存卡默认开) 手贱关掉试过:decode -15%。新默认背后都是消融,动它之前先当它是故意的 透明大页 这台引擎原生全量吃到(实测 AnonHugePages≈ 46.8G,正好等于专家池大小),上一篇那台 X99 要手动ARENA_THP=1——同一个优化在不同机器上的"存在形式"可能完全不同,验生效别看参数看日志3.6 一个在目前软件环境下没什么卵用的配置:NVLink
这卡当年最响的卖点 NVLink,桥我插着(
nvidia-smi nvlink -s实测每卡两条 25.8GB/s 链路是活的)——但在 Strata 的层切架构里卡间交接走 pinned 内存通路,NVLink 全程没戏份(文档口径如此,欢迎打脸)。买卡别为它加钱。4. 判决故事:三个开关从"白天否决"到"当晚平反"
这台机器最好看的一场戏,是我的配置连续两次错、第三次才对的全过程——比任何参数都值得抄。
白天:三开关首轮 A/B。
SM75_PERF在 sanity 的 JSON 转换题(I2)上两连败;速度上 16K 读 951/945(基线)对 956/956(该臂),decode 在噪声带。证据在手,当场否决,开关踢出配置。晚上越想越不对,做了三件事:
- 换长度刻度复测。做了长题探针(80K/171K,unique 前缀防缓存、
max_tokens=1、usage.prompt_tokens当分母)——+7% / +19% 出来了。原来短题区(≤21K)这台机器的瓶颈在 PCIe x8 专家换入带宽,计算加速在短题里空转:16K 是把长题真收益测成零的错误仪器。同一开关 16K +0.7%、171K +19%,从此我看任何 prefill 类开关先问"这个长度瓶颈在带宽还是在算力"。 - 查那道 sanity 题的底细。IQ 量化 + temp0 下,JSON/数字类题常存在两个得分几乎相等的候选 token,任何 kernel 舍入路径差异都能翻转它——公开机主帖(#3056)实测过开关全关时它同样抖。这叫"近平局题族"。
- 同开关复跑 sanity ×3:12/12、12/12、12/12 零失败。白天那两次,是题目自己本来就抖,不是 kernel 的锅。当晚恢复开关,终态就是 §2/§3.1 那些数字。
由此立下的判决纪律:sanity 单题失败 → 先查题型是否近平局族 → 再查该题开关全关时的历史失败记录 → 最后才怀疑 kernel。 顺序反了就是冤枉好开关。
外部基准也独立复现过"长度决定测得出测不出":#3282 里一位单卡 2080Ti 机主报同一开关在 16K 口径只有 +5~6%,在他 50K~150K 的真实负载带冷读 +32%(150K 冷读从约 226s 降到约 172s),decode 持平——和本文"16K +0 档、171K +19%"的形状完全一致。对数字之前先对长度刻度,别拿自己 16K 的读数怼别人 150K 的读数。
5. "外部作业抄不动"合集:同型号显卡 ≠ 同平台
这批全是社区真实数据 vs 我这台 2080Ti 的实测。都是 2080Ti,都抄不动,为什么每一条都查得明明白白:
外部结论(都是真实机主数据) 我的实测 为什么抄不动 EXP_MODE=8对 mode4 decode +2.7~8.5%(#2197 多位机主实测,楼里更高口径到 +12~16%)零收益(四臂对照全打平,偏差≤0.5%,sanity 四臂 12/12) 他们的红利是相对 mode 4 测的;咱引擎现行默认早已离开 mode 4(#2197 楼内自己给出 mode 8 对 mode 0 只 +~1.6%),对着现行默认复测,增量落进噪声带 "位等价开关组"(#3161,共五项)decode 均值 +5.6% 查无此账(我装的是其中四项,第五项与层切不兼容弃用) 一查验证机是双魔改 3080(sm_86)——其中一个开关在 Ampere 上本来就默认开,他的 +5.6% 是替新架构补默认,Turing 没有这笔账 上一篇那台的后期余量 1184(照搬成 900/1184 试) 16K 读 -6.4%(两头不讨好的最亏档) 见 §3.3,数值随配置变,跨机必重测 "文档会配合层切自动 trim" auto层切下 trim 静默失效,槽少 1000见 §3.2,必须显式数字切点 判决通用心法就一句:同型号显卡 ≠ 同平台——基线默认值、量化档、布局模式、CPU 平台,任何一个不同,别人的实测到你这就只是假设。包括我这篇的。
6. 终态配置放送(现役原样,已去 key;照抄前先读 §3.3 和 §5)
{
  "args": [
    "--pack", "~/.../packs/iq3_s",
    "--native", "~/.../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
    "--ple-gguf", "~/.../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
    "--expert-cache", "auto",
    "--prefill", "auto",
    "--spec", "4", "--spec-min-p", "0.5",
    "--mtp", "~/.../mtp/rt",
    "--max-context", "262144",
    "--kv", "int8",
    "--conversation-cache-mib", "7168",
    "--conversation-cache-slots", "16",
    "--conversation-cache-min-tokens", "2048",
    "--conversation-cache-min-free-mib", "2048",
    "--pipeline-windows", "2"
  ],
  "user_args": [
    "--trim-stage-weights",
    "--vram-reserve-mib", "900",
    "--vram-reserve-later-mib", "900"
  ],
  "port": 8080, "host": "127.0.0.1", "gpu": [0, 1],
  "layer_split": 24,
  "env": {
    "STRATA_BF16_TC": "1",
    "STRATA_SELECT_SIMT": "1",
    "STRATA_SM75_PERF": "1",
    "STRATA_PF_FUSED": "1",
    "STRATA_SPLIT_MTP_BATCH": "1",
    "STRATA_STAGE_TRIM": "1"
  }
}
(
args里内部组件路径省略为~/...;另有沿用的速度投影控制向量一组(--control-vector-scaled/--cvec-*/--pcie-frac/--adapt-*)与--expert-profile未展开贴出——它们是上一代沿来的沿用项、本篇不聊;layer_split=24必须显式数字,理由 §3.2。)配套三句话:服务生命周期归 systemd(
Restart=on-failure,开机自启,重启就绪约 30 秒——NVMe 的机器加载真不慢;引擎只听127.0.0.1:8080+ API key,对外由同机 Caddy 反代加 HTTPS,裸 8080 不进局域网;功限/风扇是我自己反复实测的甜点(200/220W + 风扇 75/60),每台机器该有自己的数,不适合直接抄。但可以参考的是,我的公版卡是300A核心,涡轮卡是300,并且公版卡显存体质也好,整卡200W TDP上限和那张涡轮卡220W最后能分给核心的TDP差不多,最后实测他们跑LLM基本性能一致。散热这方面公版卡就是差一点,要多拉高一点风扇转速,不过好在公版卡哪怕拉到75%声音也比涡轮卡60%小,但涡轮卡热量直接往机箱外面排确实散热更容易处理。
7. 未完事项(立字据)与结语
- 带模型哈希的 conforming 终档:已交(§2.1 流程)
- 192K 级长上下文真测:已交
- prefill 拉满带宽的精确采样值:已采(2026-11-01 重开机窗口,
dmon -s put配 139,395 token 唯一冷读,数字已进 §2.5 表格,原始 196 行在数据包 05 文件) - 观察名单三个小开关(
IO_PREFETCH/DISJOINT_ADAPT/PA_V2T):机理上都是噪声带预期,随下次引擎升级一起回归,不单开实验轮 - 引擎版本更新后重跑本篇全部判决(尤其三开关——社区在推 Turing kernel 默认化,哪天它们变成免费午餐,本篇 §3.1 就该退休了)
结语:这台机器上发生的最重要的事不是"加了三个开关快了 26%",而是仪器错了两次才发现真收益、题目自己抖差点冤枉了 kernel、照搬自己的旧参数也要翻车。所有档案、长档语料脚本、被我自己判死的负结果都留着,要复现或对线的话,楼里说一声。
PS:
- 升级换代可以不重复下载(但我先交了 11.4G 学费):先把结论说死——安装程序不会自己找文件,光移动文件也没用。它只认
~/.config/strata/settings.json里data_dir这一个指针,而升级之后这个文件还是旧安装留下的,指针仍指旧目录。正确三步: -
- ① 首启前把 data_dir 改指新数据目录(或安装时传
--data-dir);
- ① 首启前把 data_dir 改指新数据目录(或安装时传
-
- ② 把模型分片/MTP/packs(连
.done完成标记)整个mv进那个目录;
- ② 把模型分片/MTP/packs(连
-
- ③ 再启动下载,它会按清单核对、直接"认领"现有文件,权重和草稿层零下载(引擎本体是版本组件,几百 MB 必须重下)。
- 我第一次跳过了①让它自己跑,它就在旧目录原地静默重下 83.6G,跑到 11.4G 我才从速度不对劲察觉并掐停(半成品
.part当场删掉,没污染正式文件)。改指后重跑,权重果然一个字节没再下——全程唯一实际下载 ≈ 646MB 引擎包。教训:升级前先cat一遍 settings.json,看清 data_dir 指的哪,别信"它会自动认"; - 双启时钟地狱:Windows 把北京时间数值写进 RTC、Linux 当 UTC 读,开机差 8 小时还伪装成"NTP 正常"。根治两件套
timedatectl set-local-rtc 1+set-timezone Asia/Shanghai——只改 local-rtc 不改时区等于没改; - 给分层机制"帮倒忙"的故事(mlock 钉死动态分层)上一篇讲过了,这台照方抓药没再踩。
-
-
-

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

