2 x Tesla V100 32G, llama.cpp-v100, Qwen3.8-27B-Q8_0.gguf , decode 破百, prefill 16xx~19xx tok/s, 部署,調優與TP修補與解決循環問題
-
手上空著兩張V100, 其他模型都有機器跑了, 就想回頭搞搞Qwen 3.8 27B, 順便為Qwen 4.0暖暖身. 基於工作需求, Q8是必須的, 之前跑過大概decode 3,40 tok/s , prefill 7,800 tok/s, 就差強人意. 這次網上找找看有沒有什麼更強的部署, 還真的找到.
用著用著無限循環的老問題再度發生, 就讓GPT 6.1 sol去修復一下, 修好之後就沒有再發生了. 少了循環問題後, 3.8 27B還是挺能打的, 跑了幾個長鏈任務, 不比其他模型差, 就256K上下文少了點, 時不時就compact. 以下為安裝紀錄:Qwen3.8-27B 部署摘要
目前模型與服務
項目 正式設定 API 模型名稱 qwen-3.8-27bTarget models/Qwen3.8-27B-Q8_0.gguf,Q8_0 GGUF,約 29.05 GBDraft models/Qwen3.8-27B-DFlash2-F16.gguf,約 3.86 GB;來源 BF16 已轉 F16,未直接使用 BF16 運算推論引擎 1115714829/llama.cpp-v100v100-2.0.1.1,基準 commitf17d925,另有本機 TP 修補;執行檔build-tp/bin/llama-server硬體 2 × Tesla V100-SXM2-32GB,NVLink;每卡功耗上限 225 W GPU 切分 Tensor parallel, --split-mode tensor --tensor-split 1,1,全層 GPU offloadmax seq num / 最大併發 2, --parallel 2;兩路同時處理與生成均已實測每路實際可用 context 262144 tokens(256K,輸入+輸出) --ctx-size524800 tokens(總配置);獨立 KV, --no-kv-unified每路 KV token 容量 262400 tokens,為 256 對齊配置;524800 ÷ 2 Slot 上限 262152,含 8 個內部保留位置; SLOT_CTX=262152、--kv-unified-per-slot 262152主模型 KV cache K/V 均為 q8_0;payload 合計 17425 MiB ≈ 17.02 GiB,每卡對齊配置 8712.77 MiB Draft KV / recurrent state Draft KV 約 80 MiB/卡;target recurrent state 約 1197 MiB/卡,與主模型 KV 分開計算 Batch / ubatch logical batch 2048、physical ubatch 2048 投機解碼 draft-dflash,最多 7 個 draft tokens/輪其他快取 --cache-ram 2048:主機 RAM 前綴快取上限 2048 MiB;--ctx-checkpoints 4,不是 GPU KV 容量採樣預設 temperature 1.0、frequency_penalty 0.3、top_p 0.95、top_k 20、min_p 0 Thinking 預設 開啟、xhigh;請求可用 reasoning_effort覆寫;none關閉,high映射至xhigh記憶體保護 systemd MemoryMax=54G、MemorySwapMax=0實際容量以兩路各 261632 輸入+512 輸出=262144 tokens 驗證,並非把總 256K 除以兩路。額外 slot 位置用於投機解碼內部空間;runtime metadata 覆寫為 262152,未修改 GGUF、未啟用 YaRN/RoPE 縮放,也不宣稱原生 256K 以上的品質。
最近採樣參數變更
依使用者指示,將服務預設 temperature 從 0.4 改為 1.0、frequency_penalty 從 0 改為 0.3,
改動原因:Coding agent使用本模型時,出現大段推理文字循環,以及成功取得工具結果後仍反覆發出相同工具呼叫。使用者停止該次執行,之後指定這兩項採樣調整,以減少重複循環。temperature 改回 1.0 的用意是增加採樣多樣性,frequency_penalty 0.3 則對重複出現的 token 加入頻率懲罰;後者不是對相同工具名稱或參數的直接去重機制。temperature 0.4 是否為原問題根因尚未經對照測試確認。
後續測試結果:新參數 temperature 1.0/frequency_penalty 0.3 經多輪測試,原先的重複推理/工具呼叫循環問題未再復現。此處記錄使用者回報的測試結果,
驗證與測試數據
單位為 tokens/s;屬指定測試內容的觀測值。Native 冷測 temperature=0;warm/並行 chat 為 temperature=1,chat 測試明確關閉 thinking。目前 temperature=1.0、frequency_penalty=0.3 已重啟並驗證短 API,且使用者回報後續多輪測試未再復現原循環問題;下列歷史效能測試的 frequency_penalty=0,尚未按新採樣設定重跑整套效能基準。
測項 輸入/輸出與結果 Prefill Decode 正式服務單路 16K 冷測 16384+128,cache_n=0,通過 1949.28 180.53 兩路各 32K 冷測 各 32768+128,全通過;整組 38.17 秒 — — 兩路各 128K 冷測 各 131072+128,全通過;整組 211.30 秒 — — 兩路完整 256K 冷測 各 261632+512,cache_n=0,全部無截短;整組 603.08 秒(10.05 分鐘) 第一路 879.71 每路 106.08–107.32 滿長前綴兩路同時生成 各 261632+512,無截短;各重用 261628 個 prompt tokens、重算 4 個;整組 8.41 秒 不作冷 prefill 比較 每路 63.92–75.52 連續重用滿長前綴 再次兩路各輸出 512、無截短;整組 8.23 秒,再次觀察同時生成 2 路 — 每路 65.30–76.17 重啟後兩路 OpenAI chat 各完整輸出 512,HTTP 200,同時生成 2 路 — 每路約 157.45–157.48 冷長輸入有排程等待:上述 256K 冷測同時 processing=2、generating=1;另以 warm 測試確認滿長下 generating=2。第二路冷測 prompt timing 含等待,不當作獨立 prefill 基準;warm 數字也不等於冷輸入速度。
其他驗證:
- 正確性抽查:6 組 greedy 答案與原 layer 模式參考逐字一致;不是完整品質基準。
- TP 修補:修正 mirrored 非連續 tensor 的 async 傳輸限制;CPU/雙 GPU Meta 與 scheduler CTest 共 3/3 通過,兩張卡 CONT 算子各 78/78 通過;本機 patch 尚未上游合併。
- 邊界修正:原本只留 2 個位置,7 步投機的 warm 測試曾只輸出 511;改留 8 個位置後,完整冷測與連續兩輪 warm 皆輸出 512,失敗結果保留。
- 服務驗證:health、模型名稱、兩個 slot、metrics、實際 TP 函式庫、重啟與開機啟動皆通過。temperature/frequency_penalty 新預設、thinking 預設及各 reasoning level 均已有實際 API 驗證。
資源與未採用方案
- 最終滿長冷/熱/連續 warm 測試:每卡 VRAM 峰值 28500 MiB,實際
memory.free最低 3995 MiB;驅動另保留約 274 MiB,不能直接把 total−used 全算成可用。 - 同三輪測試:host 最低 available 51.04 GiB、服務 RSS 最高約 3.75 GiB,服務 swap 始終 0。其他測項已有 RAM 快取時 RSS 可較高;主機原有 swap 約 0.84 GiB,不代表主機 swap 為 0。
- 三路共用約 600K+F16+ubatch 2048 未採用:曾在 draft 載入時 OOM。額外 KV 本身只多約 1.22 GiB/卡,但共享路徑使用 dense mask,主模型計算緩衝曾升至約 7.30 GiB/卡;不是單純多 88K KV 放不下。使用者已決定維持兩路 256K,未降低 KV 精度。
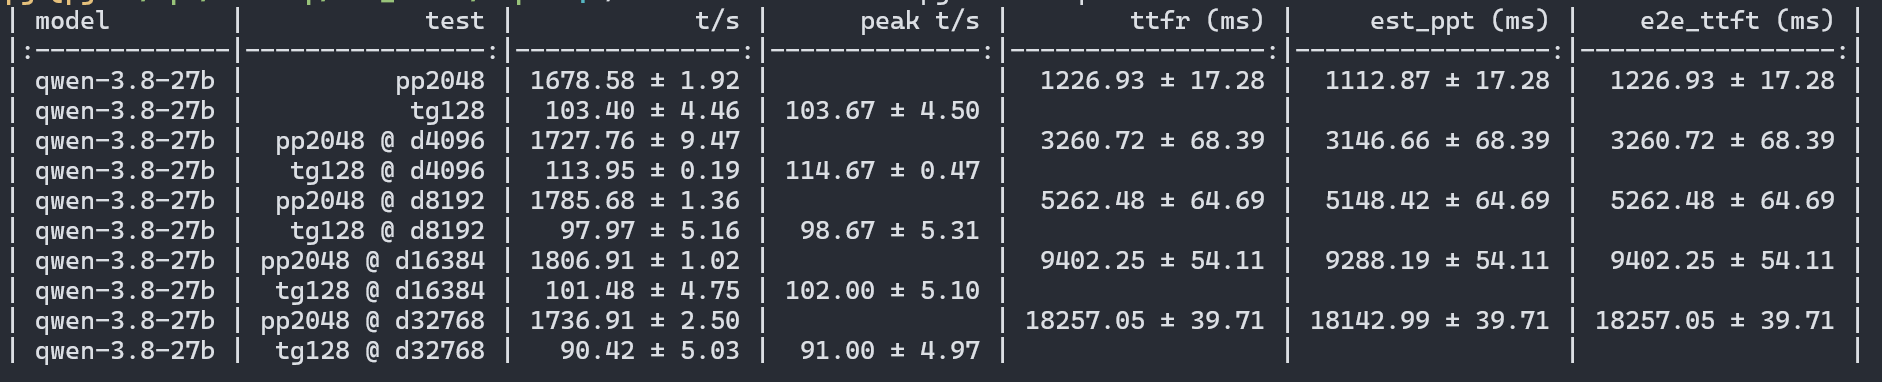
Llama bency 實測數據
-
V100-32G的本地大模型的效果超过了7900XTX 24G,不错啊