[實測VII] 新引擎 Basalt 跑3卡 Qwen 3.8 flash 406 tok/s、pp 175,050 讀 22 秒(7956.8 tok/s) —— 32K–256K 全檔位實測 + 安裝與調優
-
-
-
帖 7 · 我自己發的第一條留言(方法、原始 log、撤回清單)
1. 三種量法,三個不同的數(不能互比)
basalt-bench:冷 16,384-token prefill + 三個解碼 fixture(conv / struct / prose),三段解碼合在一起按 token 計 = 社群表同一種算法。--communitypreset 還加 64K prefill,而且每個都開新 engine 進程。- HTTP 服務:每條請求印
pp=<prompt>/<cached>c <秒> <t/s> tg=<n> <t/s> acc=<%> ttft=<秒> end=<stop|length> hit=<%> pcie=<%,我逐行讀。s1 read是中途進度行,不算完成數。 - 檔位掃檔:同一個 server、同一個 model,每檔一條帶獨有 marker 的 prompt(
Marker A 32K 1050.+ 同一段 filler 重複 1,050 / 2,100 / 4,200 / 8,000 次),冷一次、全 cache 一次,max_tokens 512。凍結 log 中每檔冷讀有 10 – 12 次、全 cache 有 6 – 7 次。
掃檔用 512 token 輸出是刻意的:用 128 token 時模型
end=stop自己收口(只有 44–52 個輸出),那些「解碼率」沒有意義;加長到 512 才全部是end=length。2. 原始 log(真實對話,從 449 條中抽 12 行,照 context 深度排)
pp=11951/0c 2.2s 5492t/s  tg=1153 490.4t/s acc=73%  ttft=2.2s  end=stop  hit=99.3%  pcie=4.5%
pp=22253/0c 3.1s 7258t/s  tg=1701 448.1t/s acc=75%  ttft=3.1s  end=stop  hit=99.4%  pcie=5.0%
pp=87478/0c 11.2s 7790t/s  tg=20175 436.1t/s acc=75%  ttft=11.3s  end=stop  hit=99.2%  pcie=6.6%
pp=88998/0c 11.4s 7786t/s  tg=439 305.2t/s acc=61%  ttft=11.6s  end=stop  hit=99.1%  pcie=5.8%
pp=98418/9821c 11.1s 7982t/s  tg=7241 416.8t/s acc=69%  ttft=11.2s  end=stop  hit=99.3%  pcie=6.0%
pp=116726/0c 14.4s 8098t/s  tg=1911 549.6t/s acc=89%  ttft=14.5s  end=stop  hit=98.5%  pcie=9.6%
pp=118275/0c 14.9s 7952t/s  tg=2835 274.8t/s acc=59%  ttft=15.0s  end=stop  hit=99.3%  pcie=6.8%
pp=122575/122548c 0.1s  tg=1768 582.5t/s acc=88%  ttft=0.1s  end=stop  hit=98.8%  pcie=9.1%
pp=132671/132127c 0.5s 1208t/s  tg=991 514.9t/s acc=80%  ttft=0.6s  end=stop  hit=99.3%  pcie=6.7%
pp=145386/0c 18.4s 7914t/s  tg=923 378.1t/s acc=71%  ttft=18.5s  end=stop  hit=98.8%  pcie=7.2%
pp=159352/0c 19.7s 8089t/s  tg=1766 108.9t/s acc=60%  ttft=19.8s  end=stop  hit=99.1%  pcie=9.1%
pp=175050/0c 22.2s 7886t/s  tg=585 306.7t/s acc=65%  ttft=22.4s  end=stop  hit=99.7%  pcie=8.9%
上面每一行都是 log 原文(只撇掉
[server] s1 done前綴),數字沒有改過。帖正文表格跟四張圖使用的凍結樣本(11-03 09:05:02):449 條、709,022 個輸出 token、1,743.7 秒解碼 = 406.6 tok/s(按 token 數平均)。逐條 109 – 587、中位 404.5;context 11,951 → 175,050(中位 119,935);接受率 56 – 93%;專家命中 97.0 – 99.8%;PCIe 4.3 – 16.5%。早一個凍結點(11-03 04:20:29)171 條:277,084 token / 703.7 秒 = 393.8 —— 兩個數字都來自同一份 log、同一個 model,只是凍結時刻不同。另外,重啟前 18 條(context 17.5K → 88.5K)是 389.6,那一段另存做realtraffic-18req.txt。輸出 token 數:平均 1,579.1、中位 879、沒有一條少於 100 個、104 條超過 2,000 個。帖正文的表格與四張圖用的是 11-03 09:05:02 凍結那一份 log:2,721 行、
s1 done545 條(458end=stop、85end=length、2end=cancelled),剔了 85 條跑盡輸出、2 條 cancelled、9 條固定輸出長度的探測 → 449 條 agent 請求。合計 709,022 個輸出 token ÷ 1,743.7 秒 = 406.6 tok/s;逐條 108.9 – 586.5、中位 404.5;TTFT 0.1 – 22.4 秒、中位 1.2;context 中位 119,935;新讀 13 – 175,050、中位 4,325、平均重用 59.9%;每條輸出中位 879、平均 1,579.1;接受 56 – 93%;命中 97.0 – 99.8%、PCIe 4.3 – 16.5%;342 條有印讀入速率(最高 8,564 t/s)、107 條沒有印。頭 N 條累計(按 token 平均):39 → 368.3、122 → 394.2、171 → 393.8、240 → 394.2、300 → 396.9、360 → 404.7、420 → 404.9、449 → 406.6。檔名post7-serve-snapshot-live.log(196,160 bytes)放在一起post7-traffic-stats-live.json;早一個凍結點(04:20:29、1,271 行、171 條)保留做post7-serve-snapshot.log同post7-traffic-stats.json,兩份剔除規則完全一樣。樣本計算:只計
end=stop而且tg>0(我的 agent 真正答完的請求)。同一份 log 中另有 85 條end=length(掃檔跑盡 512 個輸出)、2 條end=cancelled(log:248、log:340,兩條都是tg=0)、9 條固定輸出長度的探測請求(tg=512、64、128、51、52、44、30)——這 96 條全部剔除,剔除規則跟哪些 log 行計入了,我寫成post7-traffic-stats-live.json一起貼。log 凍結做post7-serve-snapshot-live.log(2,721 行,11-03 09:05:02),帖正文跟這裡所有數字都由這份凍結檔逐行算出,不是即時 log。最慢的那條 108.9 t/s 是 159,352 個 token 全新讀入、drafter 只有 60% 接受那條(log:1109);我故意送出的 248K / 44 個輸出那條(139.9 t/s)已經剔除,因為短輸出不應該當「解碼速度」。3. 檔位掃檔,全部冷讀全放(engine 自己的秒數與速率)
檔位 prompt tokens 冷讀次數 / 全 cache 次數 讀入秒數 讀入 t/s 分佈(中位) 冷解碼 512 分佈(中位) warm 解碼 512 分佈(中位) 32K 32,638 / 32,639 12 / 7 3.6 – 3.7 s 8,706 – 9,072(8,792) 247 – 319(286) 297 – 319(308) 64K 65,188 / 65,189 11 / 7 7.6 – 7.9 s 8,239 – 8,562(8,303) 251 – 289(274) 288 – 312(304) 128K 130,289 / 130,290 11 / 7 15.2 – 15.8 s 8,229 – 8,597(8,345) 243 – 294(262) 275 – 318(295) 256K 248,089 / 248,090 10 / 6 30.6 – 31.6 s 7,845 – 8,119(7,933) 244 – 282(263) 282 – 321(295) 讀入 32K→256K 中位跌 9.8%;解碼中位跌 8%。供電那輪(log:606 / 610 / 616 / 625)另外給 8,821 / 8,334 / 8,349 / 7,923,全部在上面的分佈之內。之前我講「三次取中位」,其實 log 每檔有 10 – 12 次冷讀,而 32K 那檔最高那次(9,072)是離群值:另外十次全部在 8,706 – 8,824。另外 log 還有一條
pp=32639而tg=0的 cancelled 行(8,807),我不當它是量度。4. 供電:counter 前後對照
窗口 145.737 秒,四條冷讀請求(32,640 / 65,190 / 130,291 / 248,091 個 token,
max_tokens 512、cached_tokens=0、end=length),每秒取樣一次,432 列 = 每張卡 144 列,0 列解析失敗。nvidia-smi -q -d PERFORMANCE在窗口前後各讀一次:before 04:48:53.188 after 04:51:21.680 GPU0 SW Power Capping 917105982 us -> 917105982 us GPU1 SW Power Capping 219719 us -> 219719 us GPU2 SW Power Capping 292071 us -> 292071 us SW Thermal / HW Thermal / Sync Boost / HW Power Braking: 0 us(三張卡,前後都是)逐秒 CSV 中這三個 counter 每一秒都是同一個數,窗口中途都沒有變動過。五個欄位 × 三張卡,增量全部 0 µs。
引擎那四行(log:1846 / 1862 / 1867 / 1875;同一個窗口內第二輪重複在 log:2025–2069):
pp=32640/0c 3.6s 9090t/s、pp=65190/0c 7.6s 8555t/s、pp=130291/0c 15.2s 8590t/s、pp=248091/0c 30.5s 8122t/s。客戶端牆鐘 10.768 / 34.695 / 32.698 / 57.013 秒、合計 135.174 秒:窗口內自己的 agent 同場用緊這部 server,所以牆鐘大過引擎秒數,牆鐘不當引擎時間。即時 flag 逐秒取樣(
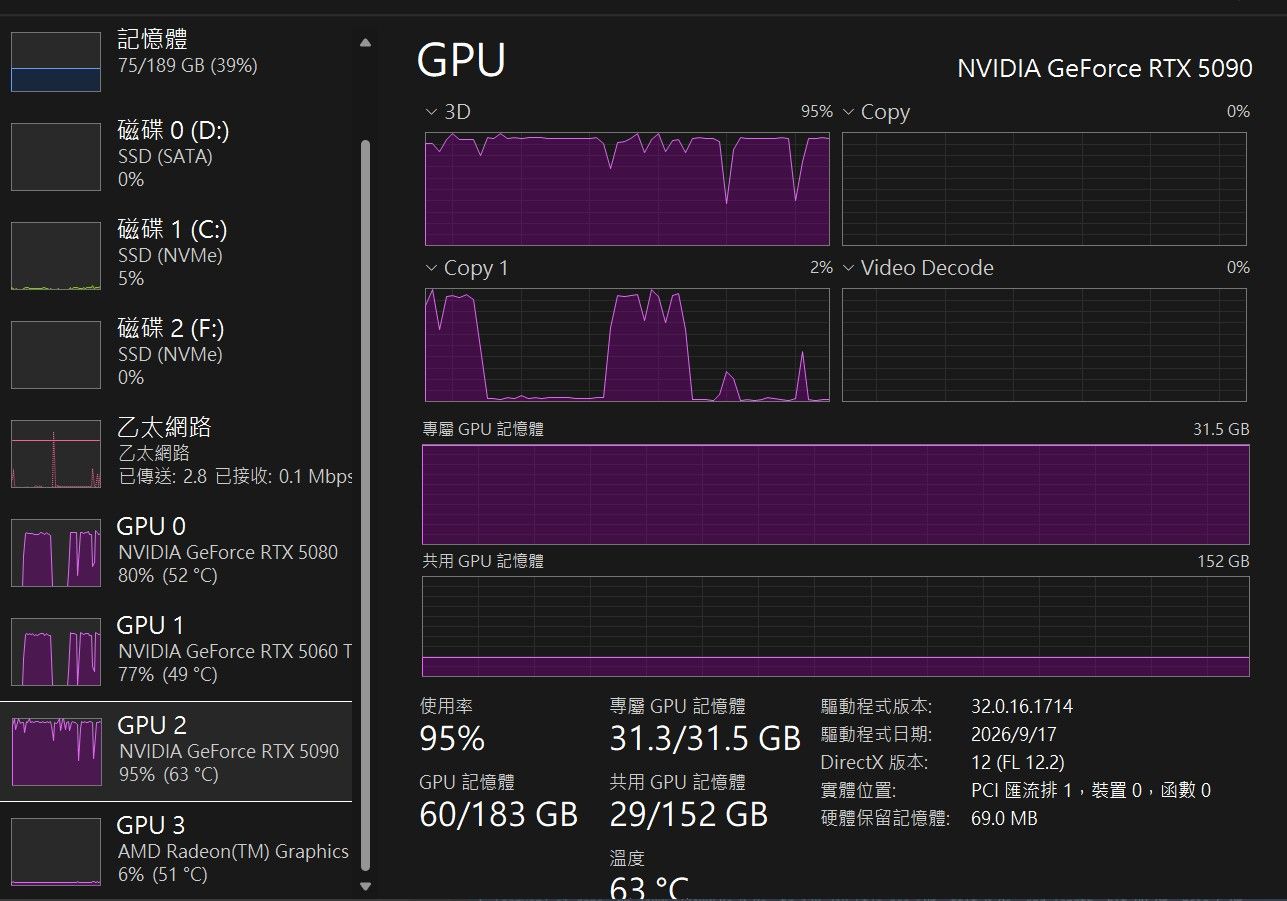
clocks_event_reasons.active)。5090 的 143 個 busy 樣本(utilization.gpu ≥ 50)中:78 個帶 power-cap bit(0x…04)、65 個只有0x400、hw_slowdown與sw_thermal_slowdown從未 Active。5080 / 5060 Ti 全部只有0x400,cap bit 從未亮起。0x400在這台機器是 Reliability:idle 樣本都 Active、前後相同,不是 power cap。帶 cap bit 的樣本 SM 中位 2,850 / 最高 2,895 MHz、功率中位 549 W;沒有帶的樣本 SM 中位 2,880 / 最高 2,940 MHz、功率中位 484 W。逐條請求,5090 帶 cap bit 的 busy 樣本:32K 3 / 11、64K 18 / 34、128K 22 / 32、256K 33 / 56。取樣條件與數值:5090 功率中位 540.2 / 最高 567.5 / 最低 287.8 W(上限 600 W,default 與 max 都是 600),SM 時鐘 2,842 / 2,857 / 2,940 MHz,溫度 62 / 70 / 74 °C,顯存最高 31,545 MiB,util 56 – 100(平均 96.4)。5080 中位 103.3 / 最高 110.9 W(上限 360)、SM 中位 2,865 / 最高 2,880、溫度 48 / 53 / 55 °C、11,574 MiB。5060 Ti 中位 42.7 / 最高 47.5 W(上限 180)、SM 2,670、溫度 46 / 51 / 52 °C,取樣期間用 13,812 MiB(ComfyUI 同場生圖;關閉之後 7,083 / 16,311)。
一句:counter 零增量是真的,「沒有 power cap」是錯的 —— 78 / 143 個 busy 樣本有亮起。站得住的講法:上限有參與,但累計扣牆 0 µs、時鐘 2,842 – 2,940 MHz、峰值 567.5 W 對 600 W、熱節流 0 µs。
踩坑:
nvidia-smi --query-gpu=clocks_event_reasons.current,...在 driver 617.14 直接報Field clocks_event_reasons.current is not a valid field to query,出一個零列 CSV。要寫clocks_event_reasons.active。我有一次取樣零列就是這個原因,同重導向無關。5. 跨 pack/跨卡數(全部
basalt-bench冷算法,短 context)pack 卡 讀入 pp16k 解碼(按 token 數) IQ3_XXS 我自己構造(drafter 未調優) 1×5090 Win 崩:2–5 tok/s, verify: a device wait timed out (mid chain: kind 1)崩 IQ3_XXS 官方 drafter 1×5090 Win 6,722 418 IQ3_XXS 官方 drafter 3× Win 5,418 563 IQ3_XXS 官方 drafter 1×5090 WSL2(ext4) 5,555 399 IQ3_XXS pack 放 /mnt/c1×5090 WSL2 3,432 382 NVFP4-DQ6_K 122.64 GiB 1×5090 Win 5,507 313 NVFP4-DQ6_K 3× Win 5,167 433 重複次數逐行交代:IQ3_XXS 單卡、三卡、WSL2 ext4 三行是三次交替取中位;NVFP4 三卡行三次(4,786 / 5,167 / 5,174,解碼 429 / 433 / 440);NVFP4 單卡跑了兩次(5,503 / 5,511,解碼 313.4 / 312.5);
/mnt/c同行一次(載入 125 秒對 10 秒)。每格都是 pp16384 + 三個 fixture,沒有混服務數字。5b. 248K 深度,服務路徑(另一種量法,不能與上面那張表直接比較)
同一個 HTTP server、一條 248,063-token prompt,冷一次再同一條(prompt cache):
pack/設定 248K 讀入 解碼 32 token 解碼 128 token(已 cache) 專家命中 / PCIe IQ3_XXS 1 卡,vision 不開 8,962(27.7 s) 282.9 262.7 91.2% / 0% IQ3_XXS 3 卡,vision 不開 7,952(31.2 s) 131.3 319.5 100.0% / 11.1% IQ3_XXS 3 卡,vision 開在 5060 Ti 7,965(31.1 s) 108.3 431.8 99.9% / 9.8% NVFP4 3 卡,vision 不開 8,364(29.7 s) 94.6 136.9 94.3% / 36.0% NVFP4 3 卡,vision 開在 5060 Ti 7,045(35.2 s) 52.3 88.2 93.9% / 35.6% 32 輸出 token 那列不能當速率(太短,主要是 drafter 免費跑);128 那列才有參考價值。NVFP4 開 vision 付 16% 讀入、36–45% 深度解碼,因為 5060 Ti 開 vision 之前已經 14.2 / 16.3 GiB,開完 16.0 / 16.3(98%)。
社群表同一 preset(
--community:16K / 64K 讀入各一次 + 三個解碼 fixture 合在一起按 token 計)的行,逐個取自 repo 的benchmarks.json,連 OS、RAM、CPU 一起列,因為這三項直接決定讀入同專家層:社群行 卡(功率上限) OS RAM CPU 16K / 64K / 解碼 IQ3_XXS 1×5090(500 W) Linux 62 GiB Core Ultra 9 285K 8,784.2 / 9,326.3 / 564.5 NVFP4 1×5090(500 W,PCIe 4.0 x16,H2D 28.9 GB/s) Windows 191 GiB Ryzen 7 7800X3D 2,431.2 / 5,600.8 / 199.1 NVFP4 1×5090(475 W) Linux 247 GiB — 9,556.4 / 10,541.5 / 311.8 NVFP4 5090(575 W)+ 5080(360 W) Linux 504 GiB EPYC 7702(64 核) 7,696.1 / 11,629.7 / 497.8 IQ3_XXS 2×5060 Ti(180 W) Linux 62 GiB i5-14600K 2,756.0 / 2,740.8 / 229.6 接著跟我的結果對比:我 Windows 單卡 NVFP4 解碼 313 高於社群 Windows 那行 199 —— 但那行 16K 讀入只有 2,431、64K 卻有 5,600.8,16K 反常地低(我猜 pack 未進 page cache),所以這個對比不強。我三卡的 433 低於社群 5090+5080 那行 497.8:那台機器有 504 GiB RAM 與 64 核 EPYC,專家層要放到 RAM 時比我 192 GB 便宜得多;我三卡的 5090 只有 28.0 GiB 落權重。社群單卡 IQ3_XXS 8,784 / 564.5 我未複現(我自己構造的 pack 有
dense_tc projection on native_mmvqfallback,見帖正文第 2 節),這個是我未測項目之一。5c. 副卡頻寬只有 x4(在自己的機器上量一次)
nvidia-smi --query-gpu=index,name,pcie.link.gen.current,pcie.link.gen.max,pcie.link.width.current,pcie.link.width.max --format=csv,noheader:0, NVIDIA GeForce RTX 5090, 5, 5, 16, 16 1, NVIDIA GeForce RTX 5080, 4, 4, 4, 16 2, NVIDIA GeForce RTX 5060 Ti, 4, 4, 4, 16兩張副卡本身是 Gen4 x16,在這台機器 negotiate 到 Gen4 x4。頻寬量法:torch 分配 256 MiB pinned buffer,來回 copy 八次取平均,先暖兩次,逐張卡單獨跑,跑完立即還原 VRAM。5090 沒有量測,它只剩下 1 GB 空間,我不想弄死自己的 agent。
卡(negotiate) pinned H2D pinned D2H pageable H2D RTX 5080(4.0 x4) 6.0 GiB/s 6.1 GiB/s 6.0 GiB/s RTX 5060 Ti(4.0 x4) 6.0 GiB/s 6.1 GiB/s 5.9 GiB/s 對照 §5b 張社群表:社群 Windows 那行寫 PCIe 4.0 x16、H2D 28.9 GB/s。我這裡是 6.0,不是引擎慢,是頻寬不同。
帖 6 那套引擎多卡只支援 layer split,每個 token 每層跨線,在 6 GiB/s 之上不可能賺到(28 → 27)。Basalt 只有被路由到副卡的專家才跨線:449 條 log 印住
hit= 97.0 – 99.8%、pcie= 4.3 – 16.5%,副卡就是淨賺(解碼 +35% / +22%)。開機那行cuda1-copy=10.7GiB cuda2-copy=5.0GiB就是副卡容納的 15.7 GiB 專家副本。llama.cpp 跟 NInfer 我沒有在這台機器跑過三卡。想打臉,貼出你機器的
pcie.link.width.current。6. 撤回
- NVFP4 三卡 讀入 3,902 / 解碼 308 → 5,167 / 433(131.7 GB 剛落盤立即跑,未進 page cache)。
- 「vision 免費」:那輪只證了 sidecar 的 VRAM 成本,但圖片路徑其實一直失敗(見帖正文第 6 節)。
- 「扣牆 counter 零增量 = 沒有供電牆」:counter 零增量是真,但即時 power-cap flag 有 78 / 143 個 busy 樣本亮起;現在的講法見帖正文第 5 節。同樣撤回「最高 3,090 MHz」:那個是
clocks.max.sm天花板,從未觀測到。 - 「每條答案 534 個 token」:534 是平均,中位是 322(當時 18 條)。凍結樣本 449 條:平均 1,579.1、中位 879 —— 後來我的對話越長越密。
7. vision 這個 bug 的修法(一行 + 回歸測試)
serve/engine/vision.py原本img.unlink(missing_ok=True),Windows 不準刪除開著的檔案 →PermissionError: [WinError 32]→ 整條請求失敗。改成重試刪除(100 次 × 20 ms),刪不掉就留給 temp 目錄,不會讓它變成請求失敗。修復前後同一張 1,760×660 圖:之前連線斷開,之後 HTTP 200、1,164 prompt token、1.6 秒;兩張圖入一條請求 2,870 token、1.5 秒。加了四個測試,連既有 vision 測試Ran 11 tests ... OK。8. 帖裡四張圖是怎麼做的
四張圖都是 PIL 排版,圖中每個數字都是腳本裡的常數直接畫出來,排版有斷言:0 重疊、0 出界、0 文字壓在 bar 上、每段文字對背景的對比度 ≥ 4.5:1、裝飾元素與文字、與 bar 完全不重疊。
帖裡那個人物是「大肥魚」—— DeepSeek 的社群二創人設,不是官方吉祥物:早期有人將藍鯨 logo 上傳給模型看,模型誤認做「藍色大肥魚」;後來網友試圖把畫師「溟月」與鯨魚元素結合,演化成 Q 版藍髮女僕「鯨魚娘」(藍長髮、鯨魚耳鰭、身後鯨尾、深藍白女僕裝、裙上刺繡)。官方一直沒有推出擬人化吉祥物,這個位置就留給社群自己填(整理版可看 36氪 與 APIYI 的兩篇)。我現在四張圖用的就是這套設計。
它不是找素材、也不是我手繪,是在這台機器用 ComfyUI 生成的:ComfyUI Desktop 0.42.1 + 官方 Qwen-Image 2.1 NVFP4 workflows(
02_Image_Editing與03_Transparent_RGBA;DiT 4,003 MB = 3.91 GiB,加 Qwen3-VL 8B NVFP4 text encoder 與 bf16 VAE),跑在 5060 Ti(CUDA_VISIBLE_DEVICES=2 --lowvram、port 8189),basalt 全程沒有停過。生成全部 40 步、cfg 1.0、euler / simple、resolution 1024。第一批(seed 881001 – 881004)以官方 logo 的 whale mark 以及更舊的 kawaii 版做條件圖,輸出 1,216×864 與 1,024×1024,全部是「鯨魚身加動畫眼」的那幾版,沒有採用。真正用的是之後兩批,條件圖全部改用社群 娘化 設計圖,prompt 寫明「保持同一個角色 —— 同一張臉、同一頭藍長髮與呆毛、同一對鯨魚耳鰭、同一套深藍女僕裝同白圍裙、裙上那個鯨魚刺繡 —— 只是改姿勢同取景」,negative list 寫滿
changed hair colour, changed eye colour, changed dress colour, different character, background scenery, photo, 3d render, text, letters, watermark, deformed hands, extra fingers, missing tail, cropped head, cropped feet。四張圖各用一個姿勢、一個尺寸,各自獨立生成、各自獨立拆背景:seed 883001 坐下、兩手放在裙上、鯨尾向右卷(60.3 秒,輸出 768×1376,拆好之後 900×1307,
fig1_logline(帖第一張)畫 172 px);seed 883002 站著舉手打招呼、另一隻手托住一碗白飯(44.1 秒,900×1610,fig2_traffic(帖第四張)畫 166 px);seed 883003 側身、伸手遮向左邊的 bar(44.1 秒,900×1467,fig3_cards(帖第二張)畫 162 px);seed 884002 站著、兩隻手抱住三卷卷軸(44.1 秒,輸出 768×1376,拆好之後 900×1598,fig4_prefill(帖第三張)畫 230 px —— 讀入那張圖要它大一些,所以另外生成了一個姿勢專門給它)。之前還有 seed 883004 斜身游水(900×1089)、seed 884001 坐在鯨尾上(900×1559,60.2 秒)以及 seed 882001 – 882004 站著打招呼(768×1376 與 1,024×1024,40.1 – 44.2 秒)幾個版本留在assets/,fish_anime_girl_full.png就是後者裡挑出來的一份。03_Transparent_RGBA那些雖然 mode 寫 RGBA,但全幅 alpha 只有 216 – 255,即是沒有真正的透明,所以背景要自己拆:由 12 – 14 個邊界 seed 做 floodfill(thresh 26)判背景(四張的角落顏色分別是 (251,252,253)、(252,253,255)、(252,253,254)、(253,254,255),四角 spread 只有 2 – 3),mask 再經MinFilter(3)與GaussianBlur(1.0),先可以分得開它件白圍裙同背景。最後加一層淡藍光暈(alphaMaxFilter(13)+GaussianBlur(4),填 (196, 221, 255) 85%),因為它條裙是深藍,沒有這層光暈會企不在深色面板上面。四份 master 分別是assets/fish_girl_sit_master.png、fish_girl_wave_master.png、fish_girl_point_master.png、fish_girl_carry_master.png;四張圖實際畫 172、162、230、166 px 寬(照帖內出現順序)(alpha 0.86、0.86、0.86、0.88),排版斷言照樣要求它與文字、與 bar 零重疊,撞到文字的氣泡會被移除,而不是迫使它移動位置。之前那版扁平 logo 剪影(seed 771001 – 771004,
assets/fish_comfy_master.png)以及更舊的 kawaii 版(assets/fish_comfy_master_v1_anime.png)都保留在這裡,兩批生成的 seed、尺寸、每張秒數、workflow 名以及拆背景參數全部寫在.agent-tmp/basalt-test/comfy_girl_log.md。收工立即關閉 ComfyUI,5060 Ti 返返 7,083 / 16,311 MiB(淨返 basalt;5090 31,543 / 32,607、5080 11,574 / 16,303)。9. 未測
質素沒有量測(IQ3_XXS 對 NVFP4 沒有 ppl / KLD);官方 IQ3_XXS pack 未跑,社群 8,784 未複現;並發 2 條以上未試;
expert-cache/prefill/kv-resident沒有 sweep;供電窗口只有一個(145 秒),掃檔全部在同一個時段;vision 修好後大圖成本未重跑;TdrDelay 未改過(Windows 顯示卡 TDR 未驗證)。補一張圖
-
-
補測:Basalt 兩卡 decode 35–44 → 343–446 tok/s —— vision 佔用 5080 最後 1.5 GiB,
peer-reserve-mib設 2048 即修上一輪貼的三卡數字有一個未受控的變數:三卡那一組,vision(
basalt-vision子程序)放在 5060 Ti,兩卡那一組只能放在 5080,而 5080 同時是專家層(expert tier)。把這個變數拆開之後,兩卡的落差就消失了——但原因不在卡數。先給結論:兩張卡完全可行,decode 與三張卡同級(352–568 對 285–467 tok/s);之前的十倍落差純粹是 vision 與專家爭用同一張 16 GB 卡的最後約 1.5 GiB,不是卡數不夠。
量法
(
vision的值是off、dynamic、cpu或 gpu 清單的編號,沒有 "on"——它一定要落在某處;下面一律寫成卡名,括號內是配置值。)同一部機(5090 + 5080 + 5060 Ti,兩張輔卡都在 PCIe 4.0 x4),同一個 74.38 GB 的 IQ3_XXS pack,
ctx=262144、kv=int8。單一請求、temperature 0、prompt 約 6,867 tok、輸出 133–256 tok;只取end=stop的行。每一格只量一次,不是重複取中位數,所以下面的數字有幾十 tok/s 的抖動。一、把 vision 搬走,兩卡就回來了
設定(2 卡:5090 + 5080) decode vision 在 5080( "1"),預設peer-reserve-mib60035–44 tok/s vision 在 5090( "0")345 / 366 / 389 vision: "cpu"(16 執行緒)396 / 424 / 441 vision: "off"352–568 三卡用同一個 script 是 285–467 tok/s,兩卡的 decode 本來就與三卡同級:兩卡不是「將就用」,是同一檔速度。落差完全來自 vision 佔用了那張 16 GB 專家卡,與卡數無關。
圖一(
post7b_fig1_reserve.png)按機器配置分五組:2 卡 ·vision: "cpu"、2 卡 · vision 在 GPU(同一張 5080 的 reserve 600/1536/2048,加 5090)、2 卡 ·vision: "off"、3 卡、1 卡(只有 5090)。同組之內只有 reserve 600 那一格掉到 35–44 tok/s,其餘全部 264–568;圖底是 pp 讀入的範圍帶,1 卡反而最高(9,110–9,443),其餘四組落在 5,357–8,942。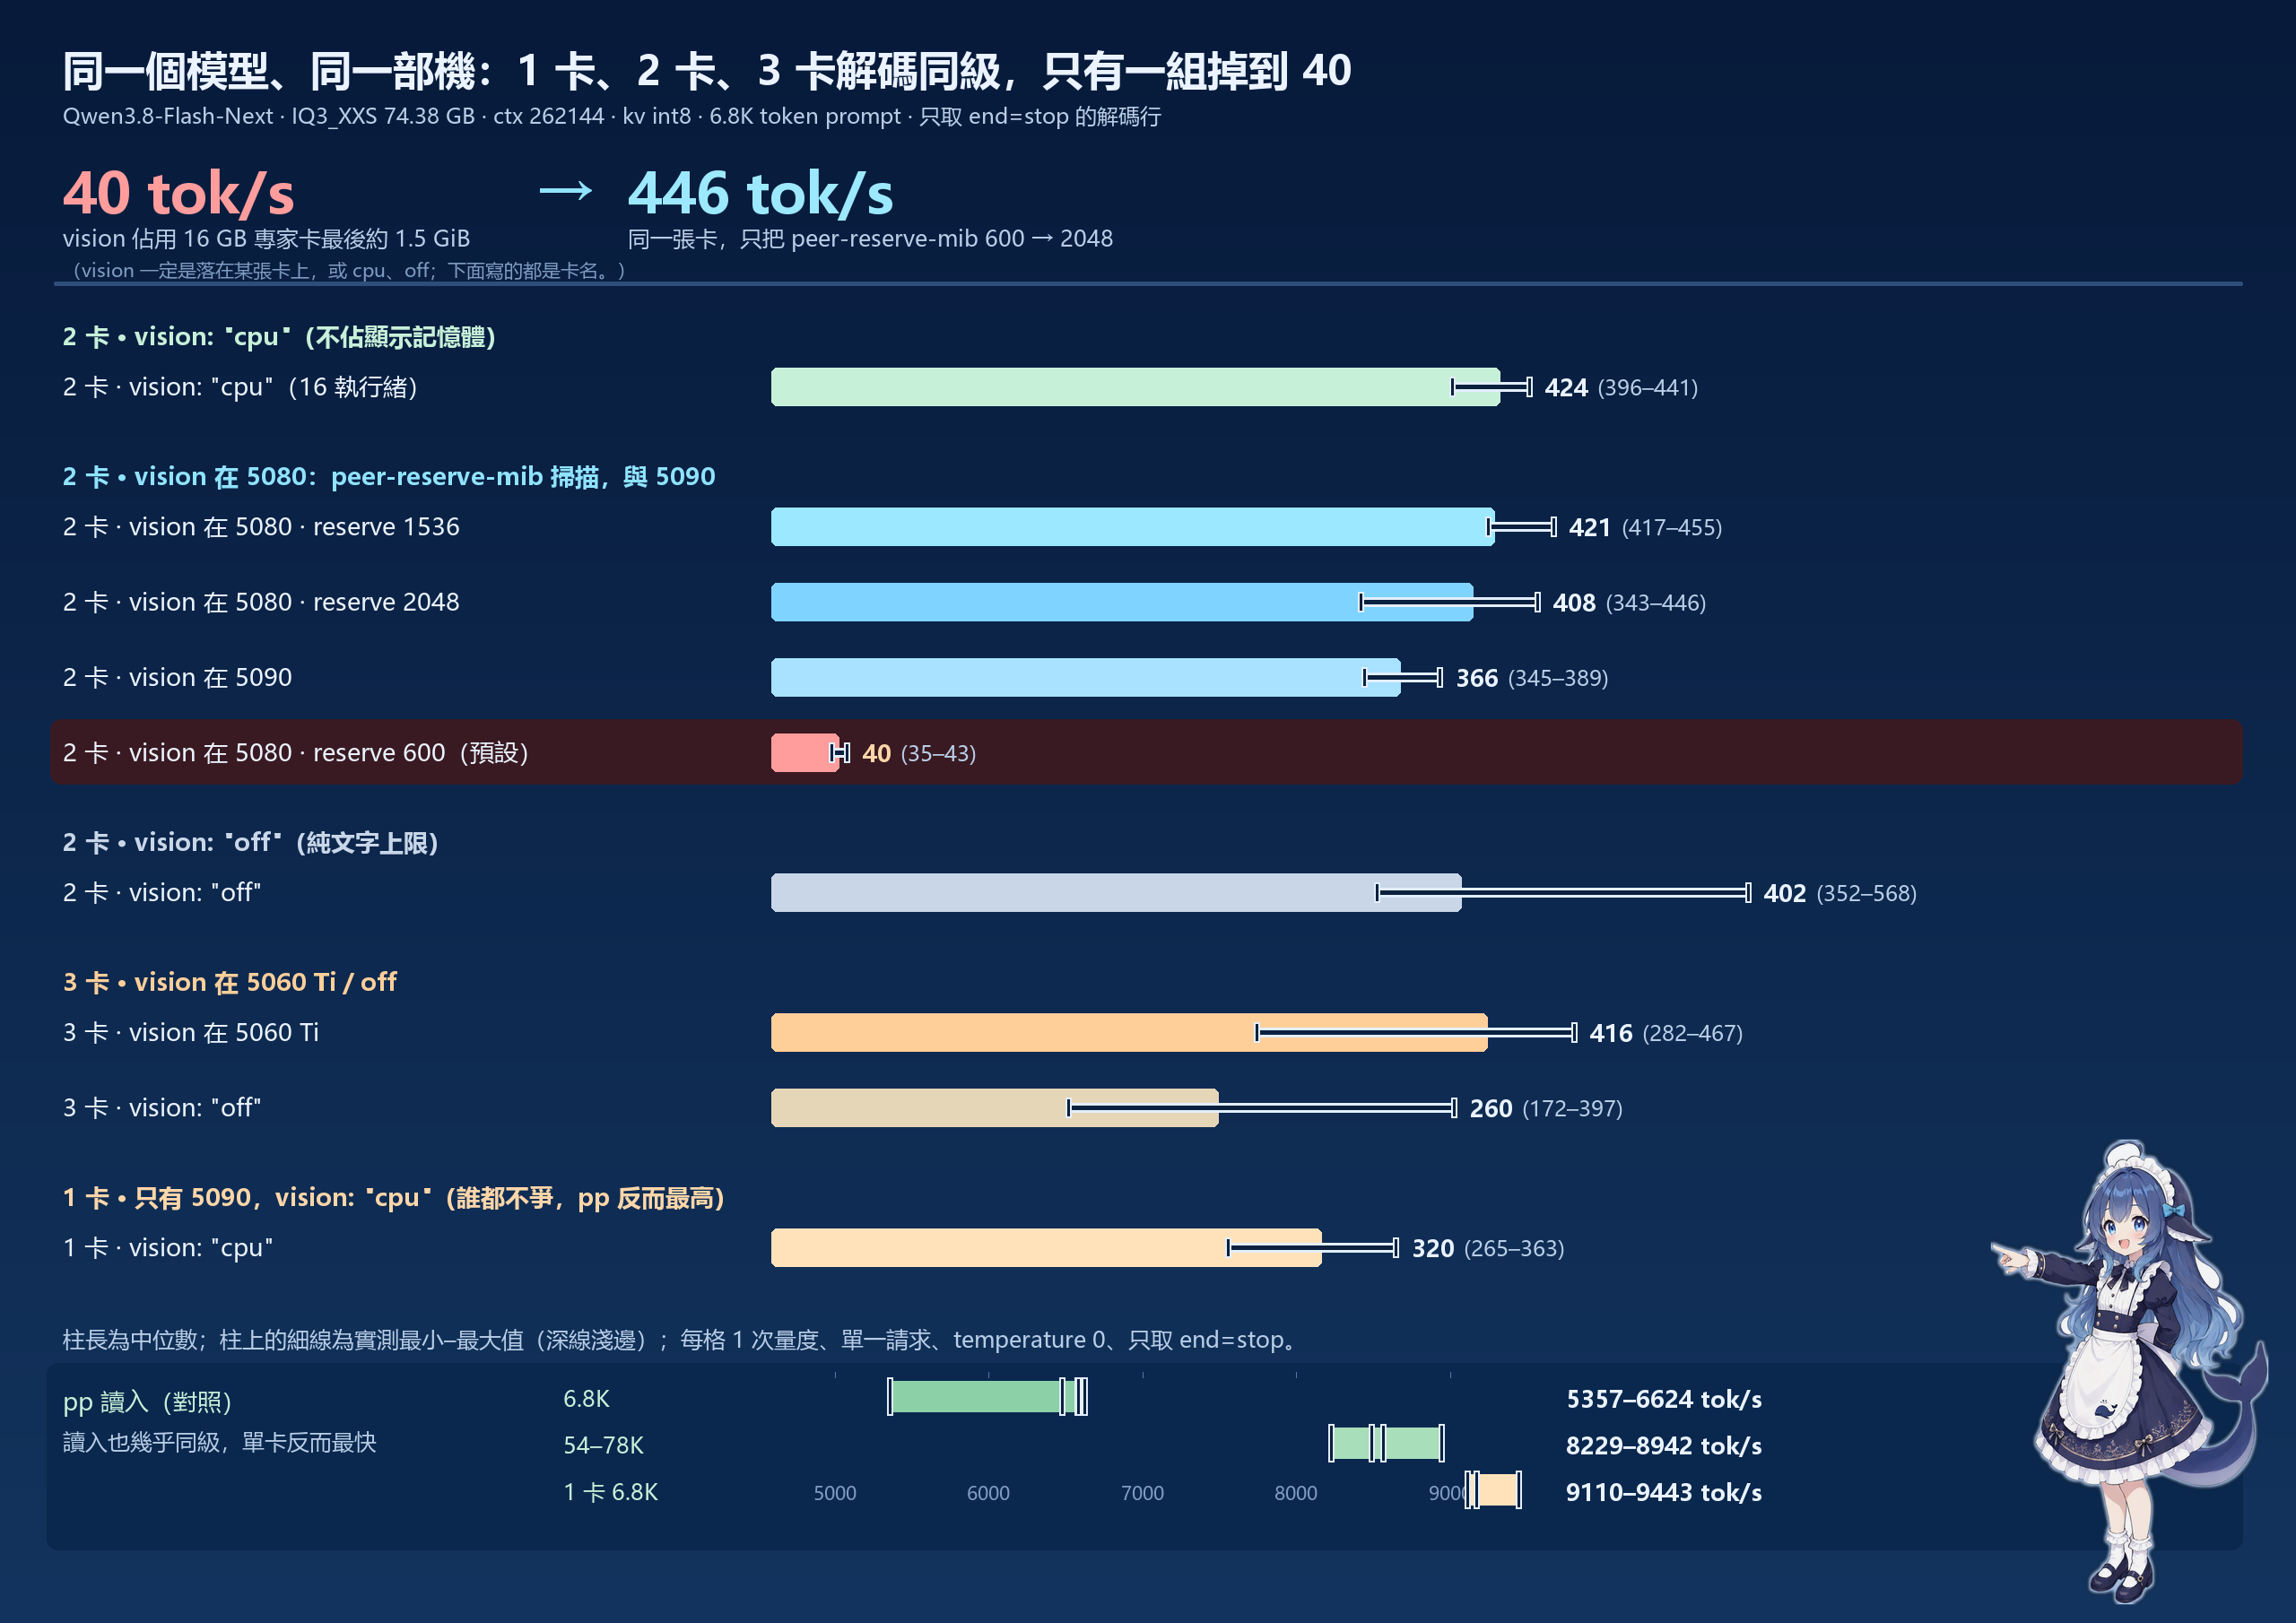
二、不是帶寬,也不是裝不下
慢與快兩組的載入行逐字相同:
loaded 43.8GiB cuda0=28.0GiB ram=15.7GiB cuda1-copy=13.9GiBexpert_slots=14981、expert_cache=24813 MiB、pcie_share=0.075–0.121在兩組都落在同一範圍:PCIe 佔比沒有隨變慢而上升,專家擺位也沒有改變。唯一改變的事實是,那張 16 GB 卡在 vision 佔位之後只剩約 450 MiB 可用(nvidia-smi顯示 15,847 / 16,303 MiB)。三、這支旗一直存在:
peer-reserve-mib它是「tier 卡留多少 VRAM 不用」,預設 600 MiB(
--peer-reserve-mib,config 放在engine段):peer-reserve-mibcuda1-copy5080 用量 decode 600(預設) 13.9 GiB 15,847 / 16,303 MiB 35–44 tok/s 1536 13.0 GiB 15,751 / 16,303 MiB 417 / 421 / 455 2048 12.5 GiB 15,241 / 16,303 MiB 343 / 408 / 446 三個設定的
expert_slots都是 14,981、RAM 端都是 15.7 GiB:縮掉的只是 tier 卡那一份 copy(13.9 → 12.5 GiB),專家一個沒少,代價是多約 1.4 GiB 走主機記憶體與 PCIe。影像輸入在有 reserve 的兩個設定下都正常(同一張測試圖,回答「A blue square on a red background」)。四、結論
一句話:decode 的速度不是由「幾張卡」或「VRAM 總量」決定,而是由「每一個窗口能不能在自己的預算內拿到路由到的專家」決定。 那張 16 GB 卡被佔掉最後約 1.5 GiB 之後,專家讀取由顯示記憶體換成驅動層換頁,一次掉十倍;載入行、專家數、PCIe 佔比全部都看不出異狀。
由此可帶走三個判斷:
- 這是懸崖,不是斜坡。 同一份載入行、只差約 1.5 GiB headroom,decode 由 343–446 變成 35–44,而 prefill 全程不變(6,531–8,942 tok/s,6,867 tok 的 prompt 約 1.0–1.2 秒)。所以「讀入快」不能推論「生成快」;任何與 expert tier 共用顯示記憶體的負載( vision 、桌面輸出、別的程式)都必須先從 reserve 扣,扣多少就是
peer-reserve-mib。 - 一張卡就夠用,加卡買到的不是算力。 不用圖時一卡、兩卡、三卡同級(265–363、352–568、285–467),需要影像輸入時兩卡配 2048 的 reserve 也一樣跑到 343–446;三卡真正多出來的是「多一份專家容量」與「讓 vision 搬到不必與專家爭位置的卡」。也就是說,這個 pack 在一張 5090 上已經很清楚可用,加第三張卡的唯一理由是你要更大的專家快取,而不是 decode 速度不夠。
- 安全邊際比直覺窄。 1536(只剩 552 MiB)與 2048(剩 1.06 GiB)都跑得順,說明換頁門檻不等於 vision 的大小;反過來說,這類設定沒有一個通用建議值,要用
nvidia-smi看實際剩餘再定。
同時撤回上一輪的一句話:「第三張卡解鎖 decode 十倍」不成立。加速來自 vision 搬離 5080,而不是多一張卡的算力或帶寬。
五、仍然未解的一件事
engine 在主卡(CUDA0)會為 vision 自動讓位(
cuda028.0 → 26.3 GiB),但 vision 放在 tier 卡時完全不讓,那份 copy 照樣 13.9 GiB。這是引擎可以修的行為,不應該變成使用者要記住的參數。六、單卡:一張 5090 也同級
把 5080 與 5060 Ti 都拿掉、只留 5090,vision 放 CPU,同一個 script 量到:
項目 實測 decode 265.8 / 301.4 / 320.2 / 344.7 / 363.4 tok/s pp(6,862 tok prompt) 9,110 / 9,169 tok/s(比多卡更高) pp(108,972 tok prompt) 9,443 tok/s,11.5 秒 載入 loaded 43.8GiB 11.7s cuda0=28.0GiB ram=15.7GiB,pcie=0.0%影像 vision: "cpu",同一張測試圖正常回答也就是說:這個 pack 在單張 5090 上已經與兩卡、三卡同級(264–467 tok/s),而且讀入最快——加卡的收益只在「多一份專家容量」;而只要 vision 不與專家爭位,連一張卡都跑得順。
七、可照抄的設定
兩卡、要影像、要快:
{
 "server": { "gpu": "0,1", "port": 18086, "host": "0.0.0.0", "vision": "1" },
 "engine": { "kv": "int8", "kv-resident": 32768, "resident-experts": true,
 "max-context": 262144, "peer-reserve-mib": 2048 }
}
vision 寧願放 CPU(
"vision": "cpu"):實測 396–441 tok/s,專家位一個不少,也不必付那 1.4 GiB 的 PCIe 流量。三卡不必動這支旗,把 vision 放在沒有專家份額的卡上即可。測量範圍
單機、單請求、每格一次、只取
end=stop的 decode 行;兩卡與三卡是相鄰時間內、同一個 script 交替量度;沒有並發、沒有 prompt prefix cache 重用(hit=0.985–0.999是專家快取命中率,不是 prompt 重用)。這些數字只適用於這個 pack 在 sm_120 上的這套設定,不能外推到其他量化或其他卡型。 - 這是懸崖,不是斜坡。 同一份載入行、只差約 1.5 GiB headroom,decode 由 343–446 變成 35–44,而 prefill 全程不變(6,531–8,942 tok/s,6,867 tok 的 prompt 約 1.0–1.2 秒)。所以「讀入快」不能推論「生成快」;任何與 expert tier 共用顯示記憶體的負載( vision 、桌面輸出、別的程式)都必須先從 reserve 扣,扣多少就是
-
-
-
-
-




 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!