
【抄作业】双 RX 7900 XTX 跑通 MiniMax-H3 真 TP=2:832 每步 2.0×,1344 单卡跑不动、双卡 30.38 s/步
-
之前在论坛看了不少双卡 TP 的帖子,自己也在 X99-TF + 双 7900 XTX 上折腾了一轮。这次 MiniMax-H3 的**真正张量并行(TP=2)**终于跑通,整理一下实测结果和最费时间的几个坑,给同平台的朋友作参考。
先说明:这里的 TP=2 不是双卡各生成半段视频再拼接,而是把同一个 DiT 的权重按张量切到两张卡上,推理时通过 RCCL 做跨卡all_reduce,共同完成同一次采样。先看结论
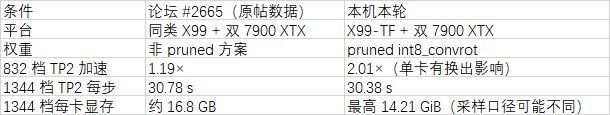
832×480 / 124 帧 / 8 步:单卡 14.98 s/步,双卡 7.47 s/步,采样每步约 2.0×;端到端 142.2 s → 83.5 s,约 1.70×。
1344×768 / 124 帧 / 8 步:双卡 30.38 s/步,端到端 284.2 s,采样期每卡显存 14.21 / 13.95 GiB;单卡初始化后持续换出权重,观察 10 分钟仍停留在第 1/8 步,本次测试条件下无法实用地完成。
两个 rank 输出的视频逐帧比较 PSNR 99.00 dB,在本次对比精度下几乎一致,画面正常,没有出现拼接或网格伪影。
真正耽误时间的是两个和 TP 切分无关的坑:非 pruned 权重出灰片,以及 turbo LoRA 因键名不匹配而没有加载。
**一句话:**在这套机器上,TP=2 不只是速度收益,更关键的是把单卡显存压力很大的档位变成可用的生成任务。不过,832 档的 2.0× 包含了单卡换出带来的劣势,不能直接理解成纯计算翻倍。一、测试平台与环境
项目 配置
主板 华南金牌 X99-TF
CPU Intel Xeon E5-2696 v3,18 核 / 36 线程
内存 系统可用约 125 GB DDR(DDR3 平台)
显卡 2 × AMD Radeon RX 7900 XTX 24 GB,gfx1100 / RDNA3
PCIe 两卡各挂 CPU 根端口,PCIe Gen3 ×16
系统 Ubuntu 24.04.5 LTS,内核 6.8.0-147
驱动 / PyTorch amdgpu 6.19.14;torch 2.14.0+rocm7.14
ComfyUI 0.43.0(commitb5a4321)
comfy-kitchen 0.2.40,HIP 后端 int8 可用
P2P 本机使用p2p_forcekretprobe 补丁;can_device_access_peer双向 True
DiT 模型 Comfy-Orgminimax_h3_fl2va_pruned_int8_convrot(20.97 GB)
其他模型 Qwen3-VL-32B int8 文本编码器;turbo 8 步 LoRA(ComfyUI 键名版)
P2P 的具体路线参考论坛 #2607。
本机补丁加载后,日志里能看到hook pci_p2pdma_distance_many -> 0,跨卡拷贝带宽测试约 10 GB/s。要注意:hipDeviceCanAccessPeer返回 True,不代表实际数据路径一定没有经过主机中转。二、TP=2 实现思路
1. 两个进程、一卡一进程
启动两个 ComfyUI 实例,通过ROCR_VISIBLE_DEVICES分别只暴露一张 GPU;两个进程以world_size=2初始化分布式进程组:# 简化示意,并非完整可直接启动的插件 import torch.distributed as dist dist.init_process_group(backend="nccl", init_method="env://", world_size=2)ROCm 环境下这里仍用
nccl后端接口,底层由 RCCL 执行通信。将同一工作流交给两个实例,行并行层通过all_reduce汇总部分结果。两边采样步骤需要保持同步。2. 权重怎么切
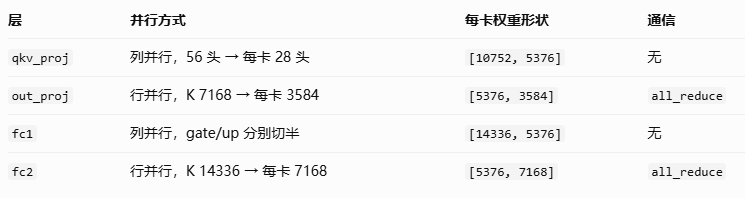
关键实现点:
在模型构造前切分load_diffusion_model_state_dict提供的state_dict,让模型从权重形状推导每卡heads=28、ffn=7168。这轮没有直接修改 ComfyUI 核心源码。
weight_scale是[N, 1]的按输出行 scale:沿输出行切时跟着切,沿输入 K 维切时不动;comfy_quant元数据保持完整。
每个 Transformer 块对out_proj和fc2各做一次 bf16 SUMall_reduce,52 块合计每步 104 次。
每步从 rank0 广播latent、timestep、context、mask等输入,避免两个实例输入不一致。
LoRA 同步分片:列并行层按输出维切lora_B;行并行层按输入 K 维切lora_A。这次 52 块共涉及 312 个 LoRA 张量。
一个容易漏掉的地方:fc2并不总经过普通模块的forward,部分路径会使用comfy.ops.linear_input_act。因此,仅在模块forward上挂归约是不够的,这个融合路径也要处理,否则两个 rank 的输出会不一致。3. P2P 在这里的作用
本机 X99 平台使用了绕过pci_p2pdma距离检查的 kretprobe 补丁。未经处理时,测得的跨卡拷贝约 2.7 GB/s;补丁后某方向的异步拷贝约 10 GB/s。对这种每步大量all_reduce的工作负载,跨卡数据路径值得优先确认。
但单向异步拷贝带宽不等于 RCCLall_reduce的有效带宽,也不能仅靠它量化补丁对视频生成速度的贡献;这轮没有做 P2P 开/关的 H3 TP2 端到端 A/B 测试。三、实际成绩
测试使用同一工作流、同一 seed;采样设置为res_multistep / simple、CFG 1、shift 12/3、CK attention、turbo 8 步(512 档使用 4 步)。比较时主要变化是 DiT 从单卡改为双卡 TP=2。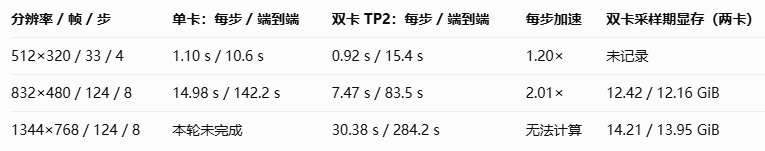
关于测试口径:
512 档的每步耗时确实有约 1.2× 收益,但端到端反而更慢(15.4 s vs 10.6 s);双实例启动和加载开销在小任务里很明显。
832 档每步 14.98 / 7.47 ≈ 2.01×,端到端 142.2 / 83.5 ≈ 1.70×。
1344 档单卡并非经过完整耗时基准:初始化约 2 分 44 秒后,继续观察 10 分钟仍在第 1/8 步,并伴随反复权重换出,因此记为本轮条件下不可用,不写成永久无法运行或严格意义的 OOM。
双卡采样期显存取 DiT 加载完成至 VAE 解码前,不是包含文本编码器加载的整轮最高峰值。输出一致性与画质
两个 TP rank 的视频逐帧对比,PSNR 为 99.00 dB:在该测量精度下近乎一致。实际视频没有发现拼接、网格类伪影。严格说 PSNR 99 dB 不是位级完全相同的数学证明;若要证明逐像素完全相等,还需要另测最大绝对差或逐元素 equality。
832 档的双卡结果与单卡视频相比,PSNR 15.22 dB:构图、主体和光照基本一致,但细节不完全相同。这和论坛 #2665 所报告的现象相近;它提醒我们:两个 rank 的一致性与TP 输出和单卡输出的一致性是两个不同问题。
为什么 832 档接近 2×,小分辨率却收益有限?
按本轮记录,52 块 × 两次归约,每步 104 次all_reduce,单次传输规模约 155 MB(bf16),按这一口径累计约 16 GB/步。通信随 token / 时空序列长度增加,而 attention 部分计算增长更快,大任务更容易摊薄通信开销。
更重要的是,本机 832 档单卡已经接近显存上限并发生权重换出,TP2 切分后显存下降,避免了这部分额外开销。所以 2.0× 是本平台、这套权重、这档输入的实际每步加速比,不能简单归因于两张 GPU 算力叠加。纯计算时间与纯通信时间分离测试,本轮尚未完成。与论坛 #2665 对照
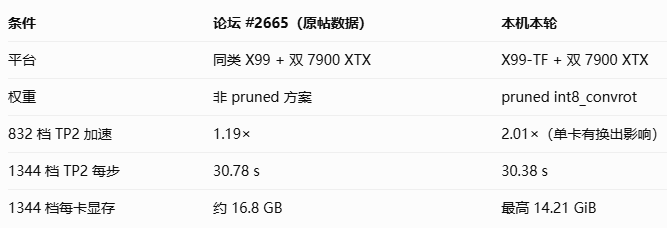
在当前权重和单卡显存压力下,TP2 同时解决了部分换出开销和容量问题。
四、最耗时间的坑
坑 1:模型能跑、数值也不是零,最后却生成一片灰
最开始使用魔塔上的非 prunedint8_convrot权重。表现是采样过程正常推进,但 latent 逐步变平:第 1 步 std 约 16,到第 8 步降至约 5.6,最终解码为均匀灰雾。
为排查这个问题,检查过:int8 权重范围(约 -127 到 127,absmean 27)、DiT forward 非零输出、VAE 编解码往返(PSNR 38 dB)、KSampler /SamplerCustomAdvanced、euler /res_multistep、动态 VRAM 开关、CK attention / SDPA、首帧有无以及 LoRA 开关。以上组合都没有解决灰片。
决定性排查是单卡也会出灰片。 因此它不是 TP 归约或切分导致的。随后换成 Comfy-Org 的minimax_h3_fl2va_pruned_int8_convrot.safetensors(20.97 GB),相同流程能生成正常画面,std 提升到约 91.5。
本轮能得出的结论是:那份非 pruned 权重与我当前 ComfyUI 0.43 / convrot 推理组合不兼容或存在未定位的适配问题。无法仅凭更换权重成功,就断定原文件本身损坏或所有版本都不兼容。
坑 2:turbo LoRA 没报致命错误,却完全没起作用
最开始开关 LoRA 后的视频对比 PSNR 约 99 dB,几乎没变化。日志中实际上有lora key not loaded:LoRA 文件使用 diffusers 命名,例如transformer_blocks.N.attn.to_q、ff.net.0.proj,ComfyUI MiniMax-H3 的 key_map 则是attn.qkv_proj、mlp.fc1一套,键名对不上就会跳过。
修复思路:
to_q / to_k / to_v对应 fusedqkv_proj.weight的三个切片;
to_out.0→out_proj;
ff.net.0.proj→fc1;
ff.net.2→fc2;
refiner_blocks→token_refiner.blocks;
TP 下再按 rank 正确切 LoRA 张量。
注意 fused qkv 的切片偏移应按每卡切分后的段长计算:0 / half / 2*half,不要重复叠加 rank 偏移。否则 rank1 可能触发:start (10752) + length (3584) exceeds dimension size另外,LoRA 是否真正生效最好通过实际加载键数和开关 LoRA 的输出差异验证,别只看工作流上有没有 LoRA 节点。
坑 3:fc2融合路径漏掉归约
fc2可能走comfy.ops.linear_input_act,绕过被 hook 的普通forward。如果只 patchforward,该层不会归约,两卡输出对不上,本轮出现过 PSNR 约 12 dB 的异常。处理方式是把融合路径也纳入归约逻辑。
坑 4:ComfyUI 节点缓存让测试“4 秒完成 8 步”
同一个输入、同 seed 原样重复提交,有时会命中节点缓存,看着速度离谱,其实没有重新执行采样。测性能前确认采样节点真正运行;必要时改 seed 或其他能使节点失效的输入,并记录实际执行日志。
坑 5:关掉动态 VRAM 导致进度卡住
试过--disable-dynamic-vram,日志出现:loaded partially … 1350 MB offloaded, lowvram patches: 59随后采样卡在 0%,两卡都不推进。本轮最终保持默认动态加载行为,不将禁用动态 VRAM 作为优化建议。
坑 6:清理进程时把自己的 SSH shell 也杀了
别直接用宽泛的:pkill -f "main.py --port ..."它可能匹配发出命令的 SSH shell 命令行,导致 exit 255。更稳妥的做法是先确认监听端口对应的 PID,再明确杀目标进程:
ss -ltnp 'sport = :8190'确认 PID 和命令行确实属于目标 ComfyUI 实例后,再使用
kill <PID>。五、显存要怎么看
这轮显存测量特别容易误判,因为 Qwen3-VL-32B int8 文本编码器本身占用很大,而且两个 rank 都会加载。若直接拿任务全程的显存峰值比较,很容易把文本编码器阶段的峰值误当作DiT TP2 采样阶段的显存。
因此正文的 832 档 12.42 / 12.16 GiB、1344 档 14.21 / 13.95 GiB,都是尽量限定在采样期的测量值。这是讨论“DiT 权重切分有没有节约显存”时更有意义的口径。六、总结与后续
这次最大的收获是:X99 Gen3 ×16 + 双 RX 7900 XTX,确实能把 MiniMax-H3 的 DiT 按张量切分并跨卡归约,同一次采样由两卡协作完成。
就实际使用而言:
512×320 小任务:每步略快,但端到端受启动开销影响,未必合算;
832×480 / 124 帧:每步实测约 2.0×,端到端 1.70×,但这包含单卡显存压力与权重换出因素;
1344×768 / 124 帧:双卡约 284 秒出片,单卡在本轮观察窗口内未能完成,双卡的价值主要体现在可用性和显存余量。
后续如果继续折腾,主要是三个方向:文本编码器卸载以降低峰值、区分 RCCL 通信与计算耗时并尝试重叠,以及补测 1536×864 档位。这些是计划,不是已经测出的成绩。
感谢论坛几篇帖子提供思路和可比较的数据:
#2643:切分表和实现思路;
#2665:同类平台的 H3 TP2 实测与比较口径;
#2750:精确归约和工程细节;
#2607:X99 P2P kretprobe 方案。
这篇主要是一次本机复现 + 实测 + 排坑记录。欢迎其他 X99 / 7900 XTX 用户交流数据,尤其是不同权重版本、P2P 开关对 RCCL 的影响,以及高分辨率显存口径。
-
之前在论坛看了不少双卡 TP 的帖子,自己也在 X99-TF + 双 7900 XTX 上折腾了一轮。这次 MiniMax-H3 的**真正张量并行(TP=2)**终于跑通,整理一下实测结果和最费时间的几个坑,给同平台的朋友作参考。
先说明:这里的 TP=2 不是双卡各生成半段视频再拼接,而是把同一个 DiT 的权重按张量切到两张卡上,推理时通过 RCCL 做跨卡all_reduce,共同完成同一次采样。先看结论
832×480 / 124 帧 / 8 步:单卡 14.98 s/步,双卡 7.47 s/步,采样每步约 2.0×;端到端 142.2 s → 83.5 s,约 1.70×。
1344×768 / 124 帧 / 8 步:双卡 30.38 s/步,端到端 284.2 s,采样期每卡显存 14.21 / 13.95 GiB;单卡初始化后持续换出权重,观察 10 分钟仍停留在第 1/8 步,本次测试条件下无法实用地完成。
两个 rank 输出的视频逐帧比较 PSNR 99.00 dB,在本次对比精度下几乎一致,画面正常,没有出现拼接或网格伪影。
真正耽误时间的是两个和 TP 切分无关的坑:非 pruned 权重出灰片,以及 turbo LoRA 因键名不匹配而没有加载。
**一句话:**在这套机器上,TP=2 不只是速度收益,更关键的是把单卡显存压力很大的档位变成可用的生成任务。不过,832 档的 2.0× 包含了单卡换出带来的劣势,不能直接理解成纯计算翻倍。一、测试平台与环境
项目 配置
主板 华南金牌 X99-TF
CPU Intel Xeon E5-2696 v3,18 核 / 36 线程
内存 系统可用约 125 GB DDR(DDR3 平台)
显卡 2 × AMD Radeon RX 7900 XTX 24 GB,gfx1100 / RDNA3
PCIe 两卡各挂 CPU 根端口,PCIe Gen3 ×16
系统 Ubuntu 24.04.5 LTS,内核 6.8.0-147
驱动 / PyTorch amdgpu 6.19.14;torch 2.14.0+rocm7.14
ComfyUI 0.43.0(commitb5a4321)
comfy-kitchen 0.2.40,HIP 后端 int8 可用
P2P 本机使用p2p_forcekretprobe 补丁;can_device_access_peer双向 True
DiT 模型 Comfy-Orgminimax_h3_fl2va_pruned_int8_convrot(20.97 GB)
其他模型 Qwen3-VL-32B int8 文本编码器;turbo 8 步 LoRA(ComfyUI 键名版)
P2P 的具体路线参考论坛 #2607。
本机补丁加载后,日志里能看到hook pci_p2pdma_distance_many -> 0,跨卡拷贝带宽测试约 10 GB/s。要注意:hipDeviceCanAccessPeer返回 True,不代表实际数据路径一定没有经过主机中转。二、TP=2 实现思路
1. 两个进程、一卡一进程
启动两个 ComfyUI 实例,通过ROCR_VISIBLE_DEVICES分别只暴露一张 GPU;两个进程以world_size=2初始化分布式进程组:# 简化示意,并非完整可直接启动的插件 import torch.distributed as dist dist.init_process_group(backend="nccl", init_method="env://", world_size=2)ROCm 环境下这里仍用
nccl后端接口,底层由 RCCL 执行通信。将同一工作流交给两个实例,行并行层通过all_reduce汇总部分结果。两边采样步骤需要保持同步。2. 权重怎么切
关键实现点:
在模型构造前切分load_diffusion_model_state_dict提供的state_dict,让模型从权重形状推导每卡heads=28、ffn=7168。这轮没有直接修改 ComfyUI 核心源码。
weight_scale是[N, 1]的按输出行 scale:沿输出行切时跟着切,沿输入 K 维切时不动;comfy_quant元数据保持完整。
每个 Transformer 块对out_proj和fc2各做一次 bf16 SUMall_reduce,52 块合计每步 104 次。
每步从 rank0 广播latent、timestep、context、mask等输入,避免两个实例输入不一致。
LoRA 同步分片:列并行层按输出维切lora_B;行并行层按输入 K 维切lora_A。这次 52 块共涉及 312 个 LoRA 张量。
一个容易漏掉的地方:fc2并不总经过普通模块的forward,部分路径会使用comfy.ops.linear_input_act。因此,仅在模块forward上挂归约是不够的,这个融合路径也要处理,否则两个 rank 的输出会不一致。3. P2P 在这里的作用
本机 X99 平台使用了绕过pci_p2pdma距离检查的 kretprobe 补丁。未经处理时,测得的跨卡拷贝约 2.7 GB/s;补丁后某方向的异步拷贝约 10 GB/s。对这种每步大量all_reduce的工作负载,跨卡数据路径值得优先确认。
但单向异步拷贝带宽不等于 RCCLall_reduce的有效带宽,也不能仅靠它量化补丁对视频生成速度的贡献;这轮没有做 P2P 开/关的 H3 TP2 端到端 A/B 测试。三、实际成绩
测试使用同一工作流、同一 seed;采样设置为res_multistep / simple、CFG 1、shift 12/3、CK attention、turbo 8 步(512 档使用 4 步)。比较时主要变化是 DiT 从单卡改为双卡 TP=2。关于测试口径:
512 档的每步耗时确实有约 1.2× 收益,但端到端反而更慢(15.4 s vs 10.6 s);双实例启动和加载开销在小任务里很明显。
832 档每步 14.98 / 7.47 ≈ 2.01×,端到端 142.2 / 83.5 ≈ 1.70×。
1344 档单卡并非经过完整耗时基准:初始化约 2 分 44 秒后,继续观察 10 分钟仍在第 1/8 步,并伴随反复权重换出,因此记为本轮条件下不可用,不写成永久无法运行或严格意义的 OOM。
双卡采样期显存取 DiT 加载完成至 VAE 解码前,不是包含文本编码器加载的整轮最高峰值。输出一致性与画质
两个 TP rank 的视频逐帧对比,PSNR 为 99.00 dB:在该测量精度下近乎一致。实际视频没有发现拼接、网格类伪影。严格说 PSNR 99 dB 不是位级完全相同的数学证明;若要证明逐像素完全相等,还需要另测最大绝对差或逐元素 equality。
832 档的双卡结果与单卡视频相比,PSNR 15.22 dB:构图、主体和光照基本一致,但细节不完全相同。这和论坛 #2665 所报告的现象相近;它提醒我们:两个 rank 的一致性与TP 输出和单卡输出的一致性是两个不同问题。
为什么 832 档接近 2×,小分辨率却收益有限?
按本轮记录,52 块 × 两次归约,每步 104 次all_reduce,单次传输规模约 155 MB(bf16),按这一口径累计约 16 GB/步。通信随 token / 时空序列长度增加,而 attention 部分计算增长更快,大任务更容易摊薄通信开销。
更重要的是,本机 832 档单卡已经接近显存上限并发生权重换出,TP2 切分后显存下降,避免了这部分额外开销。所以 2.0× 是本平台、这套权重、这档输入的实际每步加速比,不能简单归因于两张 GPU 算力叠加。纯计算时间与纯通信时间分离测试,本轮尚未完成。与论坛 #2665 对照
在当前权重和单卡显存压力下,TP2 同时解决了部分换出开销和容量问题。
四、最耗时间的坑
坑 1:模型能跑、数值也不是零,最后却生成一片灰
最开始使用魔塔上的非 prunedint8_convrot权重。表现是采样过程正常推进,但 latent 逐步变平:第 1 步 std 约 16,到第 8 步降至约 5.6,最终解码为均匀灰雾。
为排查这个问题,检查过:int8 权重范围(约 -127 到 127,absmean 27)、DiT forward 非零输出、VAE 编解码往返(PSNR 38 dB)、KSampler /SamplerCustomAdvanced、euler /res_multistep、动态 VRAM 开关、CK attention / SDPA、首帧有无以及 LoRA 开关。以上组合都没有解决灰片。
决定性排查是单卡也会出灰片。 因此它不是 TP 归约或切分导致的。随后换成 Comfy-Org 的minimax_h3_fl2va_pruned_int8_convrot.safetensors(20.97 GB),相同流程能生成正常画面,std 提升到约 91.5。
本轮能得出的结论是:那份非 pruned 权重与我当前 ComfyUI 0.43 / convrot 推理组合不兼容或存在未定位的适配问题。无法仅凭更换权重成功,就断定原文件本身损坏或所有版本都不兼容。
坑 2:turbo LoRA 没报致命错误,却完全没起作用
最开始开关 LoRA 后的视频对比 PSNR 约 99 dB,几乎没变化。日志中实际上有lora key not loaded:LoRA 文件使用 diffusers 命名,例如transformer_blocks.N.attn.to_q、ff.net.0.proj,ComfyUI MiniMax-H3 的 key_map 则是attn.qkv_proj、mlp.fc1一套,键名对不上就会跳过。
修复思路:
to_q / to_k / to_v对应 fusedqkv_proj.weight的三个切片;
to_out.0→out_proj;
ff.net.0.proj→fc1;
ff.net.2→fc2;
refiner_blocks→token_refiner.blocks;
TP 下再按 rank 正确切 LoRA 张量。
注意 fused qkv 的切片偏移应按每卡切分后的段长计算:0 / half / 2*half,不要重复叠加 rank 偏移。否则 rank1 可能触发:start (10752) + length (3584) exceeds dimension size另外,LoRA 是否真正生效最好通过实际加载键数和开关 LoRA 的输出差异验证,别只看工作流上有没有 LoRA 节点。
坑 3:fc2融合路径漏掉归约
fc2可能走comfy.ops.linear_input_act,绕过被 hook 的普通forward。如果只 patchforward,该层不会归约,两卡输出对不上,本轮出现过 PSNR 约 12 dB 的异常。处理方式是把融合路径也纳入归约逻辑。
坑 4:ComfyUI 节点缓存让测试“4 秒完成 8 步”
同一个输入、同 seed 原样重复提交,有时会命中节点缓存,看着速度离谱,其实没有重新执行采样。测性能前确认采样节点真正运行;必要时改 seed 或其他能使节点失效的输入,并记录实际执行日志。
坑 5:关掉动态 VRAM 导致进度卡住
试过--disable-dynamic-vram,日志出现:loaded partially … 1350 MB offloaded, lowvram patches: 59随后采样卡在 0%,两卡都不推进。本轮最终保持默认动态加载行为,不将禁用动态 VRAM 作为优化建议。
坑 6:清理进程时把自己的 SSH shell 也杀了
别直接用宽泛的:pkill -f "main.py --port ..."它可能匹配发出命令的 SSH shell 命令行,导致 exit 255。更稳妥的做法是先确认监听端口对应的 PID,再明确杀目标进程:
ss -ltnp 'sport = :8190'确认 PID 和命令行确实属于目标 ComfyUI 实例后,再使用
kill <PID>。五、显存要怎么看
这轮显存测量特别容易误判,因为 Qwen3-VL-32B int8 文本编码器本身占用很大,而且两个 rank 都会加载。若直接拿任务全程的显存峰值比较,很容易把文本编码器阶段的峰值误当作DiT TP2 采样阶段的显存。
因此正文的 832 档 12.42 / 12.16 GiB、1344 档 14.21 / 13.95 GiB,都是尽量限定在采样期的测量值。这是讨论“DiT 权重切分有没有节约显存”时更有意义的口径。六、总结与后续
这次最大的收获是:X99 Gen3 ×16 + 双 RX 7900 XTX,确实能把 MiniMax-H3 的 DiT 按张量切分并跨卡归约,同一次采样由两卡协作完成。
就实际使用而言:
512×320 小任务:每步略快,但端到端受启动开销影响,未必合算;
832×480 / 124 帧:每步实测约 2.0×,端到端 1.70×,但这包含单卡显存压力与权重换出因素;
1344×768 / 124 帧:双卡约 284 秒出片,单卡在本轮观察窗口内未能完成,双卡的价值主要体现在可用性和显存余量。
后续如果继续折腾,主要是三个方向:文本编码器卸载以降低峰值、区分 RCCL 通信与计算耗时并尝试重叠,以及补测 1536×864 档位。这些是计划,不是已经测出的成绩。
感谢论坛几篇帖子提供思路和可比较的数据:
#2643:切分表和实现思路;
#2665:同类平台的 H3 TP2 实测与比较口径;
#2750:精确归约和工程细节;
#2607:X99 P2P kretprobe 方案。
这篇主要是一次本机复现 + 实测 + 排坑记录。欢迎其他 X99 / 7900 XTX 用户交流数据,尤其是不同权重版本、P2P 开关对 RCCL 的影响,以及高分辨率显存口径。
@Wang-Wei 你的生成速度有问题,建议让AI自查一下有没有过SHM
-
@Wang-Wei 你的生成速度有问题,建议让AI自查一下有没有过SHM
-
@Wang-Wei 你的生成速度有问题,建议让AI自查一下有没有过SHM
生成速度有问题,建议让AI自查一下有没有过SHM
我让Hermes测了,它的回答:
过了 SHM,但不是"走了慢路",实测数据如下(X99-TF + 2×7900 XTX,PCIe 3.0 x16,ROCm 7.14 / RCCL 2.30.4 / ComfyUI 0.43):
-
RCCL 确实是主机中转,不是直连 P2P。NCCL_DEBUG=INFO 打出:
Check P2P Type isAllDirectP2p 0 directMode 0 isAllCudaP2p 1
Channel 00 : 0[5000] -> 1[8000] via SHM/direct/direct(Channel 01 同)
真实跑 H3 TP2 的实例日志里也是这两行,不是测试脚本的假象。 -
试过这些开关,传输名和带宽一个都没变:NCCL_SHM_DISABLE=1、NCCL_P2P_LEVEL=PXB、NCCL_P2P_LEVEL=SYS、NCCL_ALGO=Tree、NCCL_MIN_NCHANNELS=4、NCCL_SHM_USE_CUDA_MEMCPY=1。这条 RCCL 在本拓扑下固定选 SHM。
-
但 SHM 的带宽已经贴 PCIe 上限,不是瓶颈:155 MB bf16 all_reduce 20.3 ms = 7.65 GB/s(4 MB 7.28、16 MB 7.52 GB/s)。
-
反倒是裸 P2P 方向不对称,硬切直连会更差:hipMemcpyPeerAsync 256 MB 实测 0→1 9.83 GB/s、1→0 2.33 GB/s。ring all_reduce 两个方向都要用,会被 2.33 GB/s 那一侧卡死。
-
量级核对:104 次 all_reduce/步 × 155 MB ≈ 16 GB/步 → 通信约 2.1 s/步;832×480/124f/8 步实测 7.48–7.56 s/步,通信占 28%。就算通信能到 9.8 GB/s 也只省 0.5 s/步(约 7%),所以速度不是卡在 SHM 上。
-
补一句口径:/dev/shm 跑动时根本不涨(SHM transport 用 hipHostMalloc + IPC,不落 shm 文件),用 df /dev/shm 判断"有没有过 SHM"会误判,得看 RCCL 的 via ... 日志。
-

