拆解本地AI推理基本流程,寻找硬件瓶颈,CPU/内存/SSD/主板/显卡等硬件哪些参数可以妥协,哪些必须重视,从而采购合适的AI硬件!
-
本期视频呢,我们从一些最基本的原理,就是 AI 大模型它是怎么运行的、它的整个流程,我们从这个方面来讲解,然后来让大家掌握一些基本的知识,以此来判断你在买硬件跑 AI 的时候,有哪些环节是可以忽略的,哪些环节是必须坚持的,是吧?哪些环节能做牺牲,哪些环节不能做牺牲。
那么我们看到这是一个完整的主板,上面有 CPU,是吧,有这个内存、有硬盘,然后有显卡,对吧?当然了,是有些什么 PCIe 的插槽,是吧?这个就是大多数情况下,我们普通人能够接触到的这么一个硬件架构。
首先我们讲这个内存和硬盘,它这里举的例子是 NVMe SSD,一般来讲的话是 M.2 接口,那么它有支持这个 PCIe 3.0/4.0 的标准啊。比如说你 3.0 的,它可能就慢一点;4.0 标准的可能就快一点。如果说你想要用这个 SSD 作为缓存的话,尤其是苹果喜欢这么搞,那么你最好是 4.0 的,就是它的带宽越高越好。一般来说达到什么 7GB/s 左右,这个带宽就已经是非常好用了,7GB/s 啊。
那么实际上我们跑大模型的绝大部分状况,我们不需要用这个 NVMe,我们就 SATA 接口的 SSD,它实际上也够用,甚至你用机械硬盘都够用。它无非就是加载模型的时候慢了一点,但是这个过程对于我们跑大部分 AI 大模型来说,这一部分的时间它就是一次性的开销,它对于全局的影响是微乎其微的。而且我们必须说,使用这个 SSD 作为高速缓存,这个一般只有在云端那种素质比较高的集群环境下,就是本身 SSD 它的硬件素质就非常的高,速度非常的快,是吧,然后又是集群的环境,它才有意义。那我们本地这种放一两个 SSD,是吧,就真的没有必要,而且我们也买不到云端的那种高素质的硬件,我们也买不起,是吧?所以这一块就基本上你怎么便宜怎么来,没有必要太过在意。你使用这个 SSD 作为缓存的话是损伤它的寿命的,这个并不是一个特别可取的行为。对吧?有人说这个苹果的硬件寿命长,你再长也经不住这么折腾啊,尽量不要这么做。
这个硬盘里面放了完整的模型权重,包括这个什么专家,是吧,也包括它的一些比如说 N-gram 啊,它的这种知识表,是吧,这些都放在这个硬盘中。那么我们要执行 AI 任务、执行推理的时候,首先要把这个数据从硬盘中读到内存中来。就是说 CPU 在执行任务中,它肯定是从这个内存中读取,效率是更高。就是读写啊,数据都是放到这个内存中来。在很多简单的计算机系统中,它是没有硬盘的啊,它也不需要硬盘。其实在很多情况下,这个计算机系统的运行是不需要这个硬盘参与的。没有硬盘,它只要有这个内存,其实任务也都是能跑的,只是关机之后,它的数据可能会丢失。早期呢有很多人做这个什么 RAMFS,就是把系统直接给它加载到内存中去,那样子它可能说速度就非常的快。是吧,因为早期我们知道这个机械硬盘的速度是相当慢的,有内存就够了。
那么当所有的数据加载到内存中之后,我们如果要执行下一步的推理,它最终的推理场景是发生在这个显卡的内部。那么如果说我们这里是一个简单的,比如说千问 29B,它的这个 4 比特量化之后的模型权重就只有 16.5G 左右,它可以完整地放进这个显卡的内部。那么很简单,我们就没有必要去做各种复杂的分层架构,我们就直接再把所有的权重文件、专家,包括它的 KV 缓存,全部给它放到这个显卡中来,就通过这个 PCIe 接口把它放进来。这个 PCIe 接口也是一个重点,我们一会再详细展开。现在我们先进到这个显卡的内部。那么当这个专家权重一路搬搬搬,最终搬到这个显卡内部的时候,它是放在这个 VRAM,就是显存中。
那么它计算是怎么计算的呢?计算是由这个 GPU 来完成计算。以这个英伟达为例,它这里面有很多计算核心,啊,SM0、SM1,是吧?它里面都是什么 Tensor Core 啊、CUDA 核心,这些我们就不详细讲解了。如果是 AMD,它也是有这个 AMD 自己定义的计算单元。那么这个显存跟这个 GPU 之间交换的话,要看这个显存带宽。如果说你这个显存带宽高的话,你交换数据的效率就高,GPU 就能够满载跑起来。如果说显存带宽残疾,那尽管这个 GPU 的计算能力非常的强,但是由于这个数据搬运跟不上,这就导致 GPU 可能在这里空等。所以说显存是一个非常重要的概念,它是我们选购显卡时候的一个核心标准。那当然了,另外一个就是算力了。
我给大家举两个例子,比如说你是 4090 48G,是吧,它现在解锁了。哎,它以前算力可能说比 5090 差很远,但是解锁了之后,哎,跟 5090 差不多了,甚至比 5090 数值上还要更高一点。那你说现在它跑大模型还是跑这个 ComfyUI,真的能比 5090 快吗?其实解锁了之后也还是被 5090 吊打。一个很重要的原因就是,4090 它的这个带宽是这个 960 几 G 每秒,然后 5090 应该是 1.77T 每秒,就是 1770 兆每秒,那差了一倍啊。这个就是非常关键的,就是你算力跟上来了,但是你的木桶效应、你的短板是显存,所以说你就算是算力解锁了,你也没有办法去挑战 5090,更不要说还有这个生态上的差距了。啊,生态上的差距我们本期视频就不详细展开了,要不然这个视频就做得太复杂了。
那你说是不是带宽最重要,这个 GPU 就不重要呢?啊,当然也不是了。刚才不是讲了吗?算力啊、生态啊都有影响。你比如说你是 V100 32G,你跟这个 4090 48G 比,是吧?我们就先不要比这个显存容量,我们就比带宽,带宽你大概都是 1T 左右,啊,900 多 G 嘛,是不是?但是你这个 V100,你的这个 GPU 太落后了,你的生态呀、算力呀,跟 4090 比差距是很大的。所以说 GPU 跟带宽它们都很重要,算力跟带宽,这是你采购一张显卡的核心标准。
那么我们回到外面这个流程图上来。刚才讲的是一个比较简单的方式,就是我们这个模型权重能够完整放到一张显卡中去,那这是一种非常非常罕见的情况。因为现在我们本地流行跑的都是一些 MoE 专家模型,像什么千问 27B Flash Next、GLM 5.3 Flash 或者 DeepSeek V4 Flash,是吧?它们本身尺寸都非常大。我们就以入门级的这个千问 Flash Next 的模型来举例,是吧?它这个权重大概七八十 G,再加上几十个 G 的这个什么 Engram 知识权重,啊,我不知道有没有算它了,反正加起来这个东西怎么说也有个 100G 级别。那你说你这个 GPU 一张放不下,两张也放不下呀,是吧?那它肯定就要把一部分内容放在这个内存中,有一部分给它放在这个显卡中,甚至这两张显卡可能是双卡 TP 或者这个 PP 来运行,然后通过 CPU 来居中调度。
是吧,我们就以双卡 TP 举例,比如说这是两张 7900 XTX,它们现在通过这个 SGLang 框架来双卡 TP 跑这个大模型。当然了,Strata 这些新的架构也都支持 TP 啊,我现在就说举个例子啊,不要去抠文字,抠细节就没有意思了。它把一半的权重放到这个 GPU0,就是第一张显卡,然后另一半权重给它放到 GPU1 啊,它也有不同的专家对应不同的专家,是吧?那么两张显卡就并行计算,它们这个计算产生的中间张量,就通过这个 PCIe 接口汇总到 CPU 这边来,由 CPU 来进行综合调度,把它进行总结,你就可以这样理解,然后把这个推理任务再给它继续下去。
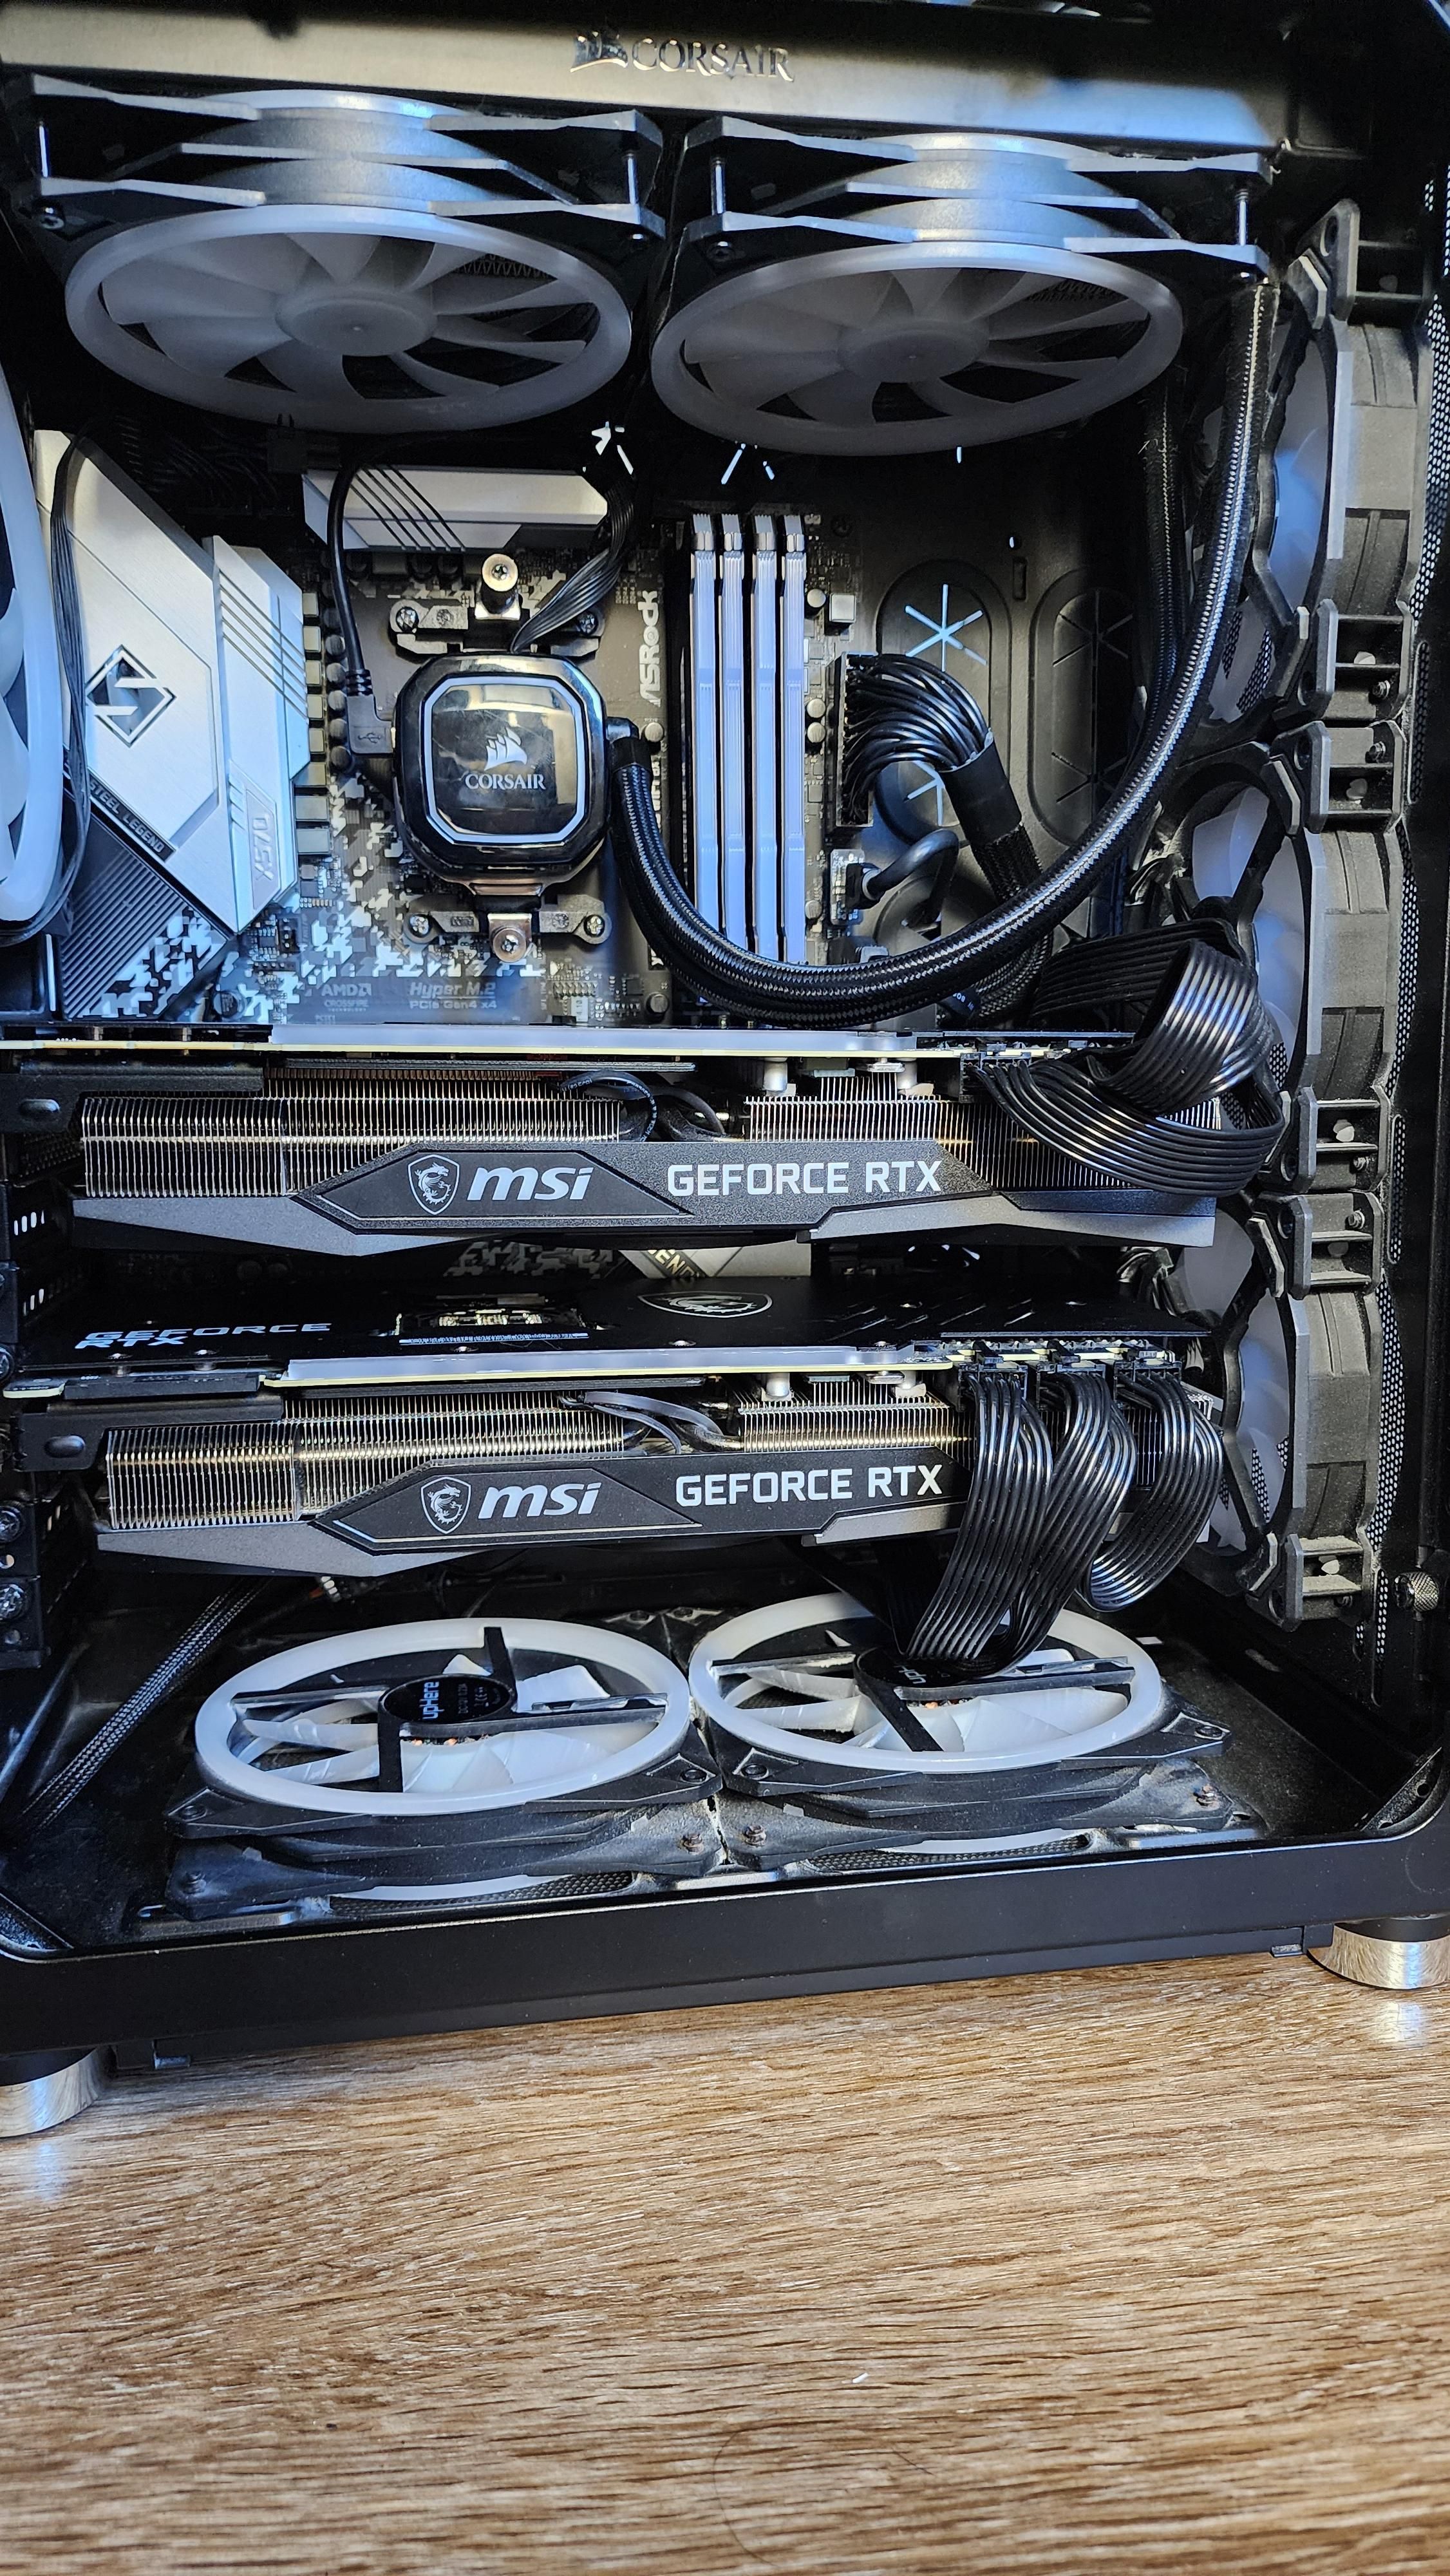
那大家可以看到,它们跟这个 CPU 之间是怎么通信的呢?它们要经过这个 PCIe 接口,这个时候 PCIe 就重要了。PCIe 我们知道分为 3.0/4.0/5.0,呃,我们就不讲详细的数值了,我们就简单理解。比如说 PCIe 3.0 分为 x2/x4/x8/x16,是吧?你乘 2,你的速度就是 x4 的一半;x4,你的速度就是 x8 的一半。一般我们都有一个满的 PCIe x16 接口,3.0/4.0/5.0 都有可能。然后这个 3.0 的带宽就是 4.0 的一半,4.0 的带宽是 5.0 的一半。
哦,你可以理解一下,我们比如说 PCIe 3.0 x8,它的带宽可能跟 PCIe 4.0 x4 的带宽一样;PCIe 3.0 x16 跟 PCIe 4.0 x8 的带宽就是一样的。那有些显卡,比如说 5060 Ti,它只支持 x8 的接口,但是它是 PCIe 5.0,所以说你最好就是给它上 PCIe 5.0 的主板,就这样才能充分发挥这张卡的算力。要不然它的 PCIe 就吃不满,本身有残疾。当然了,这仅仅是从数值上来看的,实际使用中,它只要能够给到 PCIe 4.0 x8 的带宽,也就够它用了,也就够这个 5060 Ti 这张卡发挥了。毕竟呢我们现在讲这个 PCIe,我们一旦进入到显卡内部,是吧,我们还要面对显存带宽跟 GPU。5060 Ti 它本身的素质就这个样子,所以就是说 PCIe 4.0 x8 就配得上它。
啊,我们再返回上一层,回到这个大的结果上来。我们必须说,所有的任务调度是由 CPU 来执行的,但是两张显卡计算的中间张量,通过 CPU 合并、交互之后,是吧,它最后的结果是由这个 GPU0,就是你的主力 GPU 来合并。这个东西是可以指定的啊,由它来合并结果,合并完结果之后再进行下一层。刚才可能说讲得有点不太细,这个稍微补充一下。
那么两张显卡之间,我们说通过 PCIe 接口跟 CPU 通信,是吧?那有的情况下,我们是不希望经过 CPU,因为你经过 CPU 的话,你要在这个内存中去搬运数据,这又会涉及到内存,内存我们一会单独讲,这个就复杂了。最好就是说两张显卡交互不经过这个 CPU,直接跨卡通信。诶,这样的效果是不是更好一点?哦,这种情况也是有的,就是说很多主板支持显卡之间 P2P。P2P 是什么?P to P,点对点。就你两张 GPU 之间都通过这个 PCIe 接口连在一起,然后显卡之间就直接通信,这样的效率是最高的。那么如果不支持的话,对不起,你要走内存。走内存在有些时候效率慢一点,可以接受,但是在有的情况下它又慢得多,又不能接受。
然后这个内存呢,我们也知道分为 DDR3/4/5,它一般来说跟你主板的 PCIe 接口 3/4/5 是对应的,但是它不是完整对应,不是严格对应,就基本上是同代对应。然后跟这个 PCIe 接口一样,内存它的 DDR3/4/5 之间带宽也是一比二比四这种关系。但是我们知道内存它还有通道数啊,比如说 DDR3 1600,是吧?你这个四通道,你的带宽相当于是 DDR4 3200 双通道的带宽,相当于 DDR5 6400 单通道的带宽。大家能够明白这之间的差距吗?
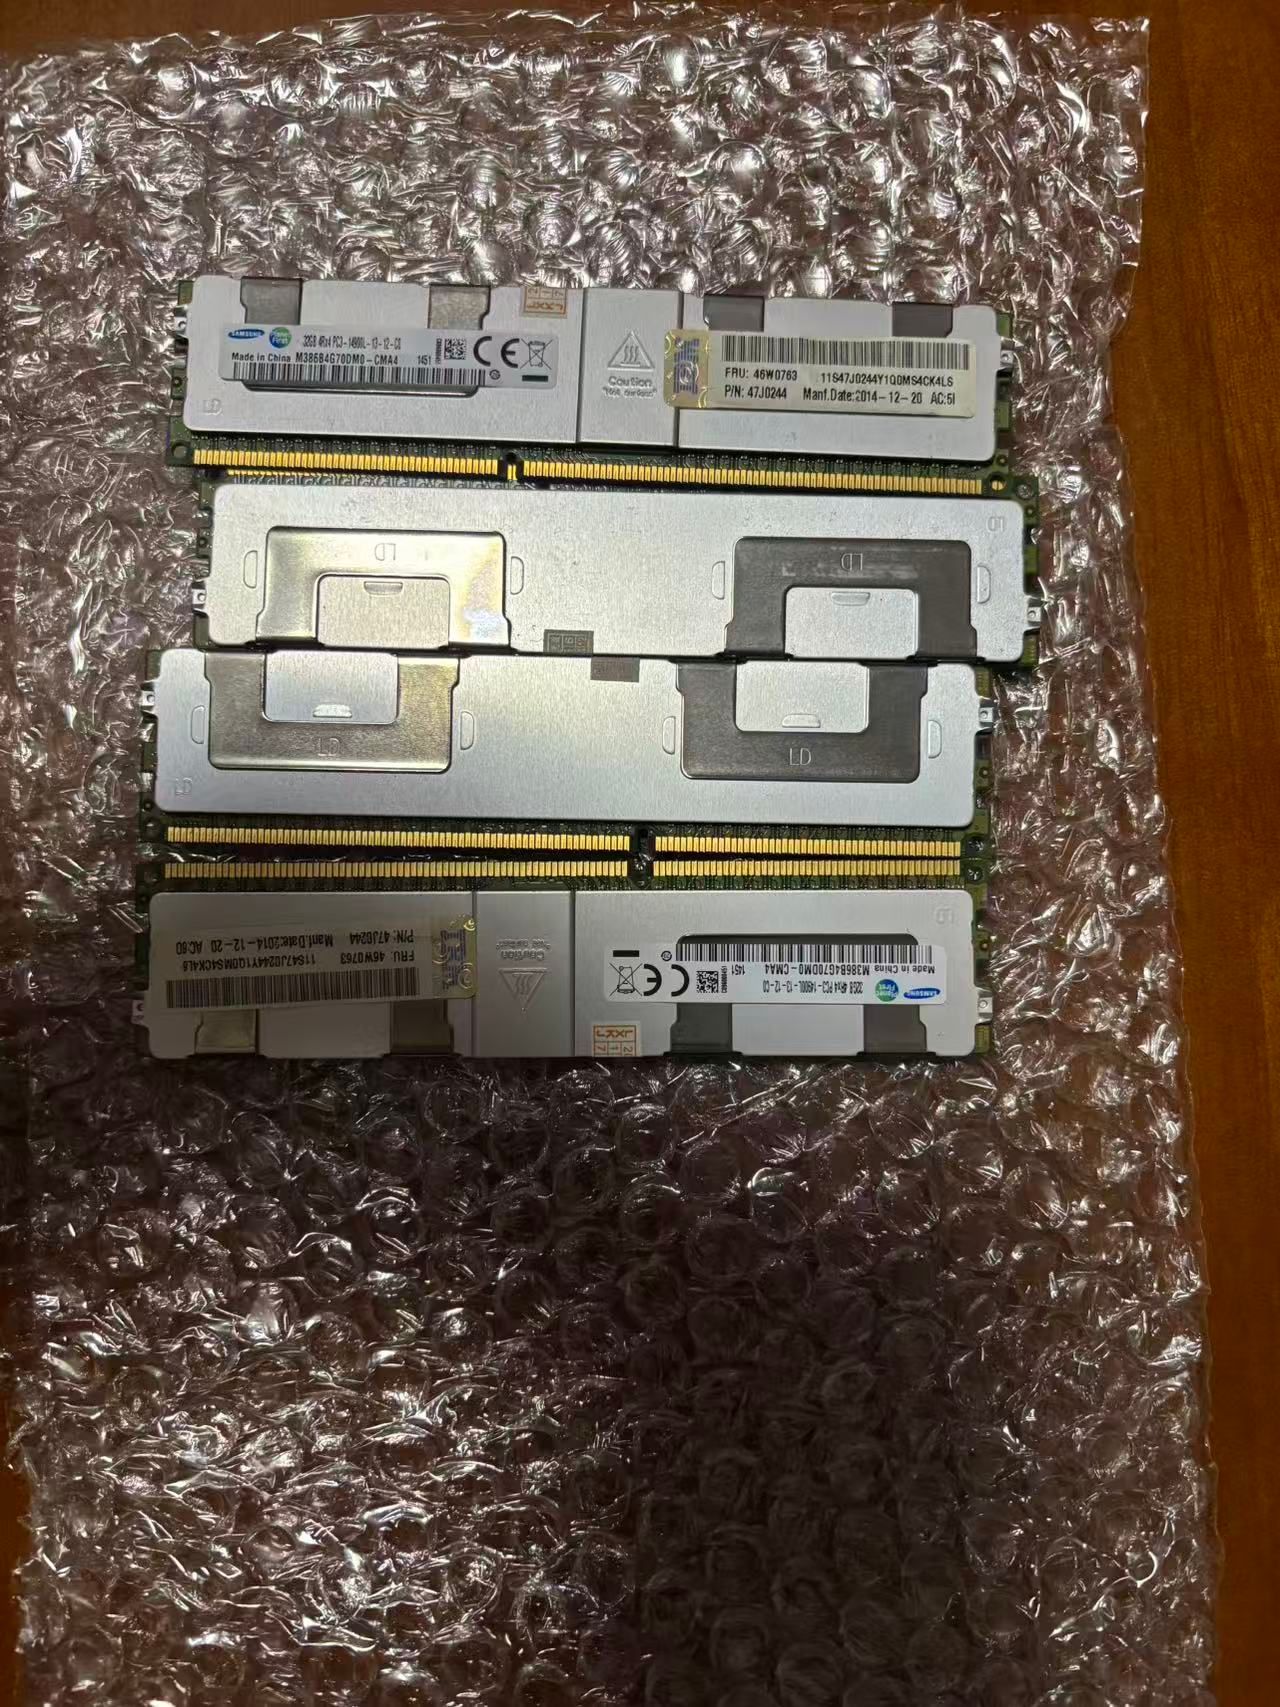
一般来说,在这个内存、PCIe 带宽,包括显存带宽这些环节中,内存是最不容易成为瓶颈的。呃,就 DDR3 1866,是吧?那你如果说有个什么四通道,甚至有八通道,你这个内存带宽是绰绰有余的,任何场景都够用了,你哪怕跑四张显卡都够用。那么主要的瓶颈就有可能产生在这个 PCIe 上。PCIe 一般来说,家用主板上面都只有一个 PCIe 3.0 x16 的带宽,或者 4.0/5.0 x16 的带宽,那么其它的卡它可能是 PCIe x4 的,那就是天生的残疾了。
那有的卡是比较高级的,像有些 PCIe 5.0 的主板非常贵,是吧?它会支持通道拆分,就是它上面有两个 PCIe 插槽,如果你插两张显卡的话,它就会拆分为两个 PCIe 5.0 x8 接口。哎,在这种情况下,它就相当于 PCIe 4.0 x16 的两张 PCIe 接口,你插两张显卡的话,它的效率都还不错,都还非常高。但是呢我也知道,我们论坛大部分人其实都是屌丝了,我们是买不起这种比较新的、这么贵的主板,何况你现在这个 DDR5 内存的价格就贵到天上去了。
那么我们本地有一些便宜的方案,就是我们论坛经常讨论的 X99 洋垃圾方案。就现在我们是比如说华南金牌、精粤,是吧?他们有这个 X99 的主板,然后提供了两个 PCIe 3.0 x16 的接口,而且软件上面 AMD、英伟达的显卡都可以打通 P2P,搭配这个 DDR3 1866 或者 1600、128G 的内存条,是吧?你再随便给它配一个 SATA SSD,或者说是 NVMe SSD。目前这一套方案跑下来,你搭配什么 7900 XTX、3090,是吧,甚至 4090,是吧?你甚至用它来驱动 RTX Pro 5000、6000,它一样是带得动。
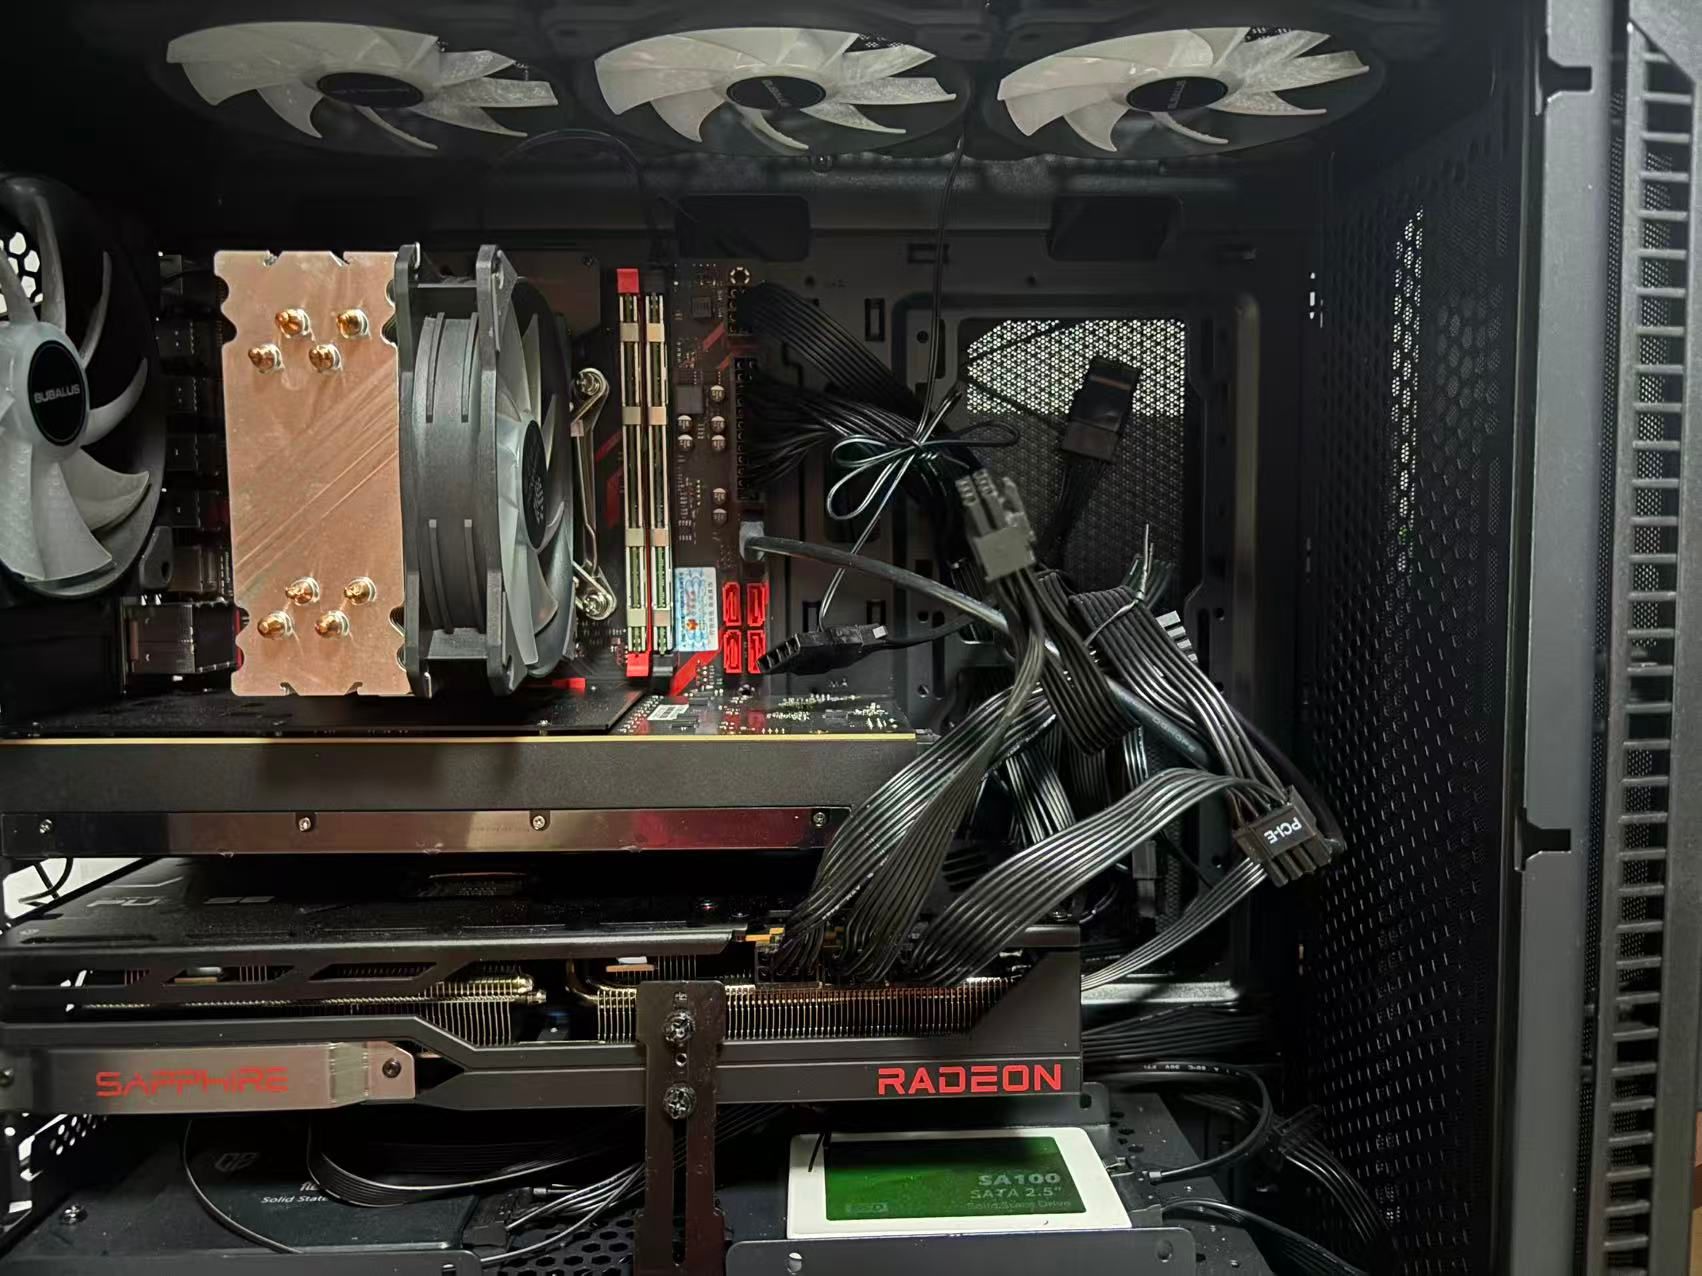
但是呢我相信啊,你买这个 Pro 5000,尤其是买 Pro 6000 的人,你们也不会去买这个 DDR3 的平台了。就我们以这个 4090D 48G、4090 48G,我自己买的是 4090D 48G 啊。我测出来的体验,包括论坛大量帖子的实测,就是这一整套配置是没有什么明显短板的,是可以拉满的,就是双卡 TP 跑这个大模型、MoE 大模型,或者说跑 MiniMax H3 这样的视频模型,它都是没有明显瓶颈的。
然后你两张显卡有很多选择,我像我刚才说的,双 7900 XTX、双 3090,是吧,双 3080、双 2080 Ti、双 7900 XTX、双 V100 16G,是吧,双 4060 Ti、双 5060 Ti 你都能玩。总之自己去测试,选择适合自己的,根据你手中已经有的硬件,最小代价去实现它,早一点投入干活。
-
-
@terry 得亏你的粉丝群够硬核,不然本期的完播率堪忧

-
-
-
@terry 得亏你的粉丝群够硬核,不然本期的完播率堪忧
-