【求助】ComfyUI 双显卡配置:双 RTX 5070 Ti 16GB,还是 RTX 5070 Ti + 5060 Ti 更合适?5090太......😭😭😭
-
各位大佬好!
我就是个苦命牛马,最近被老大安排帮美编升级 AI 工作站,主要用于 ComfyUI 本地 AI 视频生成。
老大想搞双显卡,但目前有几个技术问题不太确定,想请教一下各位有经验的大佬。
一、双显卡该怎么选择?
目前考虑两个方案:
方案 A:双 RTX 5070 Ti 16GB
主板 PCIe 5.0 通道拆分为 x8/x8,两张 5070 Ti 分别运行在 PCIe 5.0 x8 模式。
想请问:
- PCIe 5.0 x8 相比 x16,实际 AI 推理性能会下降多少?
- 双卡运行 ComfyUI 时,模型加载、显存交换和跨卡数据传输会不会受到明显影响?
- 两张 5070 Ti 是否值得投入?毕竟 x8 跑不出 x16 的完整带宽。
方案 B:RTX 5070 Ti 16GB + RTX 5060 Ti 16GB
保留现有的 5060 Ti 16GB,再增购一张 5070 Ti 16GB。
这样既能节省预算,也能尝试让两张显卡分别承担不同任务。
不知道实际效率会不会比双 5070 Ti 更划算?
二、ComfyUI 双显卡如何分配任务?
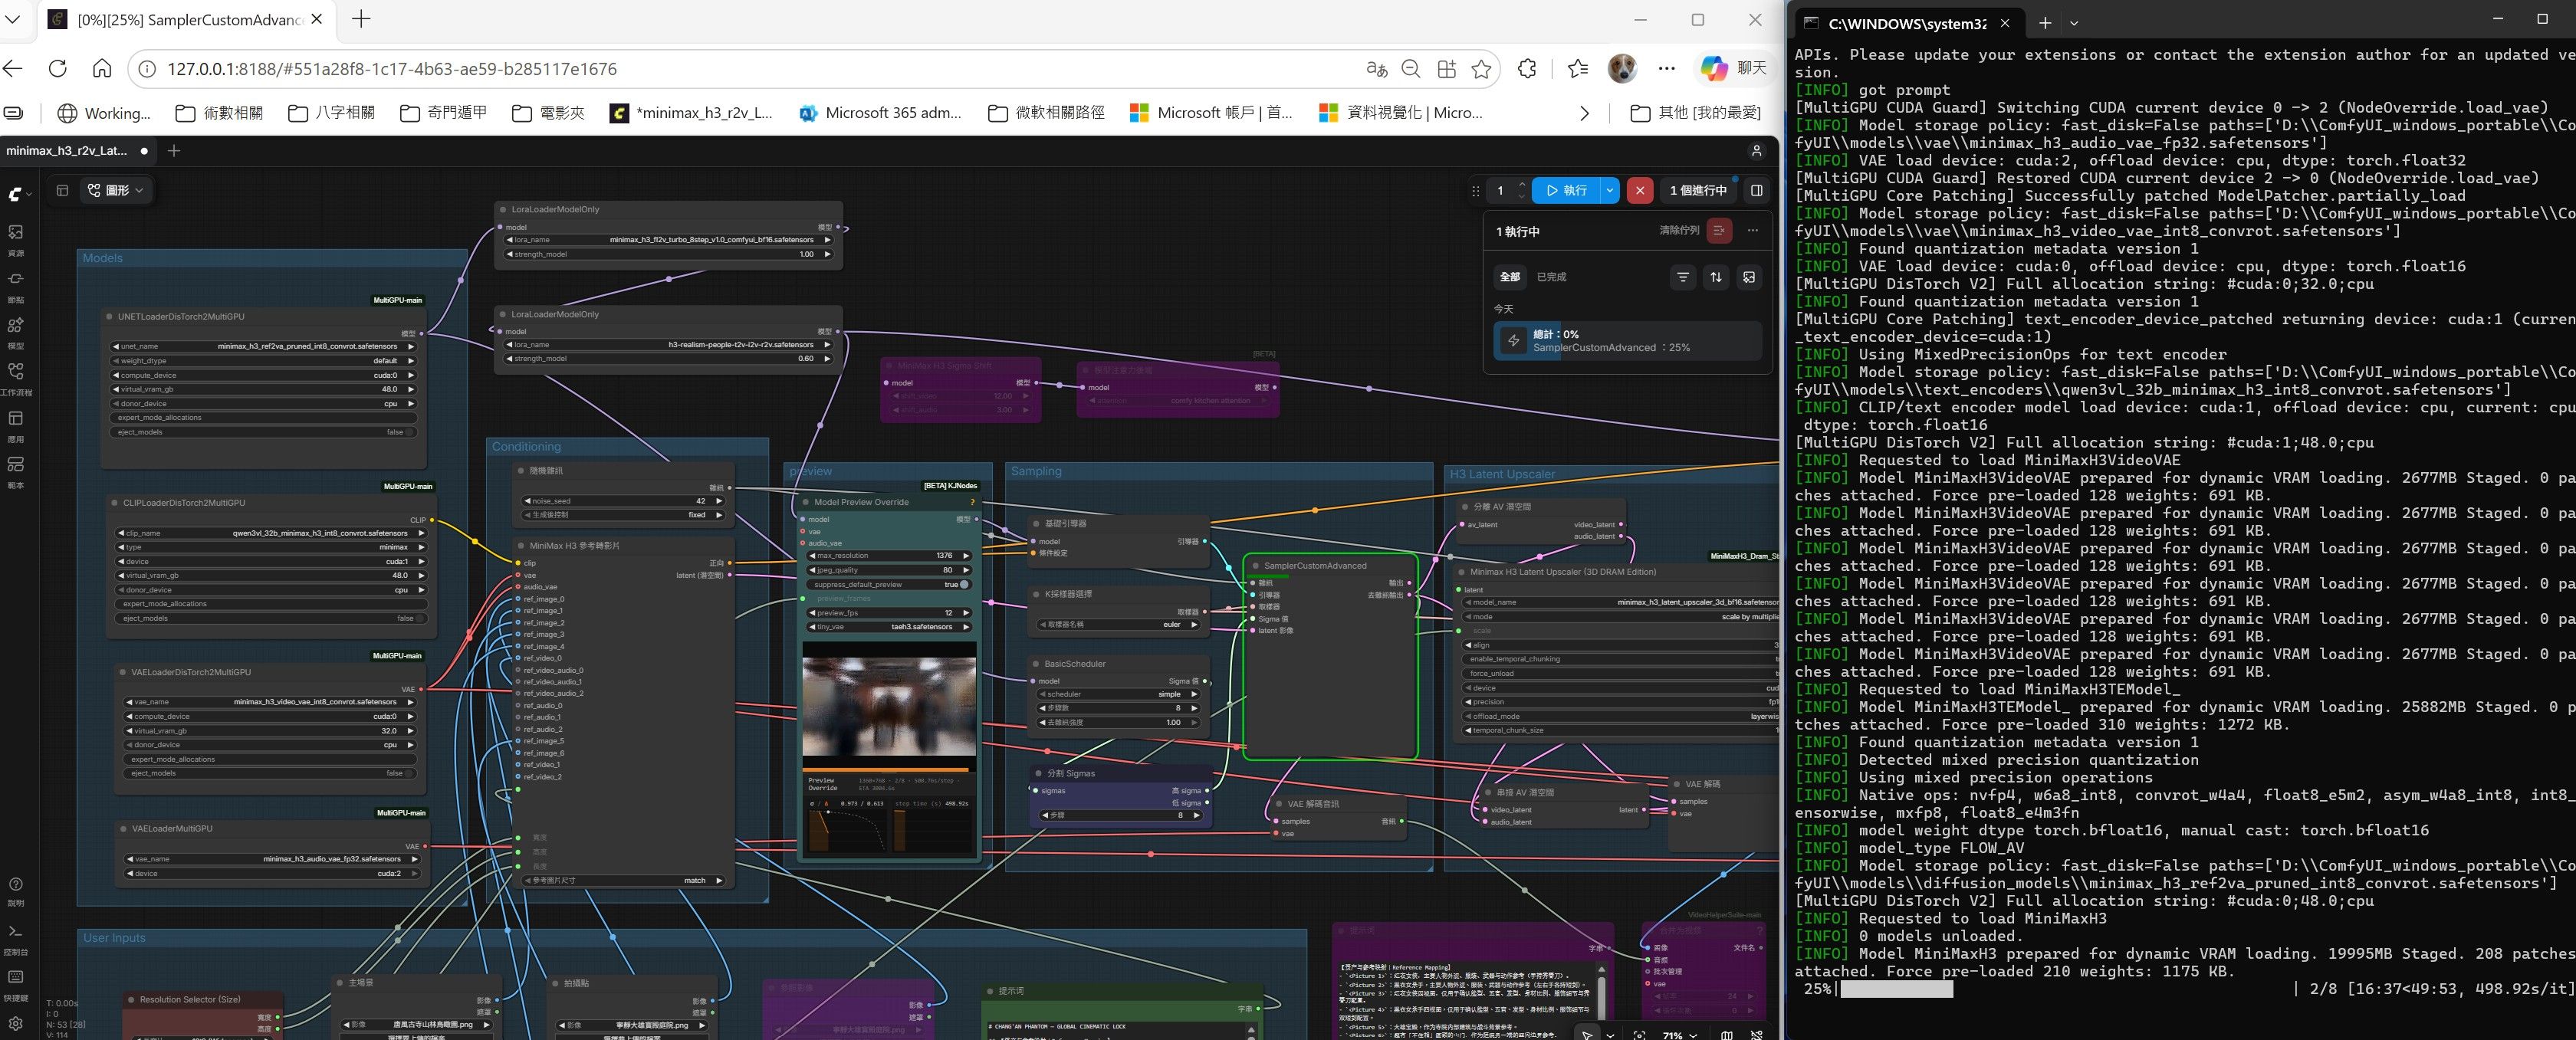
之前我们已经尝试过异构双显卡运行,采用以下方式:
- UNet → cuda:0(主显卡,负责采样)
- CLIP → cuda:1(副显卡,负责文本编码)
目前已经获得初步成效,证明部分模型组件可以分配到不同显卡运行。
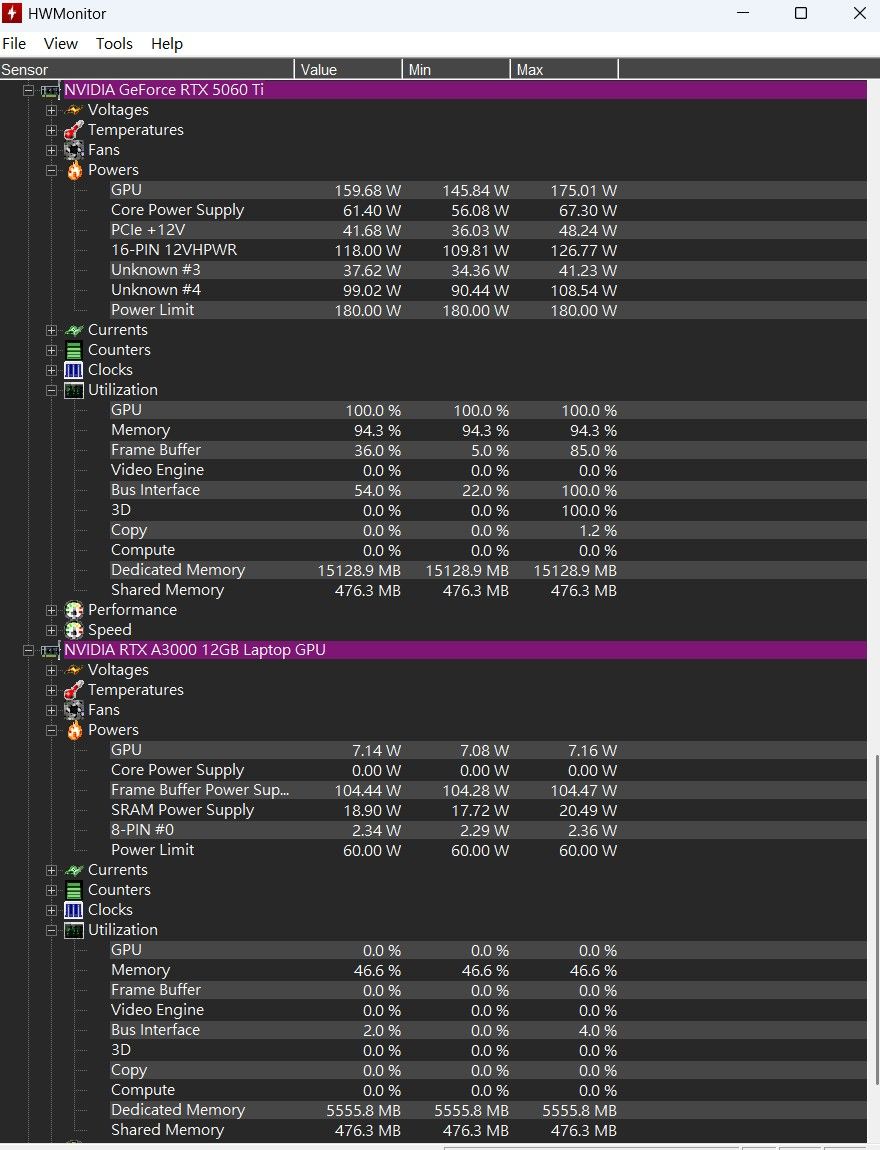
最新版的comfyui ,经测试无法异卡同时运作但还有几个疑问:
- 双显卡同时运行时,ComfyUI 的启动脚本 "*.bat" 应该如何设置?
- 能否通过启动参数指定 cuda:0 和 cuda:1 的工作任务。
- 两张显卡能否真正协同加速同一个视频生成任务,还是只能分别承担 UNet、CLIP、VAE 等工作?
- 如果采用双 5070 Ti,是否有更好的模型分配方案?
- PCIe 5.0 x8/x8 的带宽是否足够支撑双卡模型分配和数据传输?
三、目前主机配置
硬件| 配置
CPU| AMD Ryzen 7 9800X3D
主板| ASUS ROG STRIX X870E-E
内存| DDR5 128GB(32GB × 4,4800MT/s,两台主机内存合并)
SSD| 1TB × 2
现有显卡| RTX 5060 Ti 16GB
计划升级| 双 5070 Ti 或 5070 Ti + 5060 Ti
电源| 1000W
软件| ComfyUI
主要用途| AI 视频生成、模型推理四、最后想请教
我们的主要目标不是同时跑两个独立任务,而是希望两张显卡能够协同完成同一个 AI 视频生成任务,尽可能提高生成效率,并改善显存不足的问题。
目前比较纠结的是:
到底值得直接上双 5070 Ti 16GB,还是保留现有 5060 Ti,再加一张 5070 Ti 就够了?
如果有大佬实际使用过 ComfyUI 双卡、MultiGPU、DisTorch 或其他跨卡模型分配方案,也希望能分享一下启动参数、工作流配置以及实际性能表现。
预算毕竟是老大的,折腾和排错却是我们牛马的。

先谢谢各位大佬指点!
-
恭请参阅,异卡双组合问题点改善:ComfyUI 0.43.0 / ComfyUI-MultiGPU(该仓库已由所有者于 2026 年 9 月 30 日归档。目前处于只读状态。)
MiniMax H3 多显卡 CUDA 700 错误排查与修复完整报告。 RTX A3000 时,曾在反量化核心发生 CUDA 700。关键发现:MultiGPU 的 DLPack 装置保护补丁异常。MiniMax H3 多显卡 CUDA 700 错误排查与修复完整报告
技术事故报告|2026 年 11 月 4 日|Windows 11 / ComfyUI Portable / NVIDIA CUDA 13.0
已完成首次修复验证
一、执行摘要
本次排查针对 ComfyUI 使用 RTX 5060 Ti 与 RTX A3000 异卡协同执行 MiniMax H3 时,出现 CUDA 700(illegal memory access) 的问题。
经过 GPU 硬件测试、CUDA 核心函式测试、MultiGPU 外挂原始码检查,以及停用特定补丁的 A/B 验证后,成功让 H3 完成全部 10 步采样,工作流正常结束。
采样结果
10/10
100% 完成
运行时间
325.20s
约 5 分 25 秒
备份验证
PASS
SHA256 一致
核心结论: 本次问题最有证据支持的故障因素,是 ComfyUI-MultiGPU-main 中针对 comfy-kitchen 的 DLPack 装置保护补丁,而非 RTX A3000 无法执行 CUDA INT8 ConvRot 核心。
只停用该补丁、保留其他多卡与 DynamicVRAM 功能后,H3 即成功执行。这是强烈的 A/B 证据,但尚未证明补丁内部哪一条具体程序路径造成非法内存存取。
二、测试环境
项目 版本或配置
操作系统 Windows 11
CPU AMD Ryzen 7 9800X3D
RAM DDR5 128GB
GPU0 RTX 5060 Ti 16GB,Compute Capability 12.0
GPU1 RTX A3000 Laptop GPU 12GB,Compute Capability 8.6
GPU2 RTX 3060 12GB,Compute Capability 8.6
ComfyUI 0.43.0
Python 3.13.14,Portable embedded
PyTorch 2.14.1+cu130
CUDA Runtime 13.0
comfy-aimdo 0.6.0
comfy-kitchen 0.2.40
多卡外挂 ComfyUI-MultiGPU-main,DisTorch V2
内存管理 LOW_VRAM、DynamicVRAM、cudaMallocAsync
主要工作目录:
D:\ComfyUI_windows_portable
python_embeded
python.exe
ComfyUI
custom_nodes
ComfyUI-MultiGPU-main
init.py
GPU 工作分配
GPU0 — RTX 5060 Ti 16GB
主要运算
UNet 采样、Video VAE、Audio VAE
GPU1 — RTX A3000 12GB
辅助运算
Qwen3-VL 32B INT8 ConvRot 文字编码器
GPU2 — RTX 3060 12GB
保留
尚未加入本次成功的 H3 工作分配
三、原始故障现象
问题主要发生在将 Qwen3-VL 32B CLIP 配置到 RTX A3000 后,H3 尚未正式进入 UNet 采样,就在文字编码或权重反量化过程发生错误。
涉及的 CUDA 核心包括:
comfy_kitchen.backends.cuda.dequantize_nvfp4comfy_kitchen.backends.cuda.dequantize_int8_convrot_weight
典型错误:
CUDA error: an illegal memory access was encountered
CUDA error 700
torch.AcceleratorError
曾经观察到的现象:
• CLIP 放在 RTX 5060 Ti 时可以运作。
• CLIP 放在 RTX A3000 时,曾在反量化核心发生 CUDA 700。
• Video VAE 放在 RTX A3000 时,也曾于 group_norm_silu_pad3d 发生错误。
• GPU0、GPU1、GPU2 都能通过基本 CUDA 矩阵运算测试。
因此,早期怀疑范围包括 GPU 架构兼容性、comfy-kitchen CUDA 核心、跨卡张量搬运、CUDA stream 与 MultiGPU 补丁。
四、逐项排查与排除
测试项目 结果 判断
三张 GPU 的 CUDA 识别 PASS PyTorch 可辨识全部 GPU
FP32 矩阵运算 PASS 基本 CUDA 运算正常
FP16 矩阵运算 PASS 基本半精度运算正常
A3000 INT8 ConvRot 单独测试 PASS 核心可在该卡独立执行
RTX 3060 INT8 ConvRot 单独测试 PASS 核心可在该卡独立执行
原本 MultiGPU DLPack 补丁 失败配置中启用 列入主要嫌疑
停用 DLPack 补丁 PASS H3 完成 10/10
INT8 ConvRot 精度测试
在 RTX A3000 与 RTX 3060 上,使用以下测试数据:
q shape = (64, 256)
scale shape = (64, 1)
q dtype = int8
scale dtype = float32
group_size = 64
比较 comfy-kitchen 原生 CUDA 反量化与 PyTorch fallback:
GPU 最大绝对差异 结果
RTX A3000 约 4.77 × 10⁻⁷ PASS
RTX 3060 约 3.58 × 10⁻⁷ PASS
这表示在该测试尺寸与执行条件下,两张卡都能正确完成 INT8 ConvRot 反量化。
重要限制: 小型独立测试通过,不等于所有 H3 模型尺寸、CUDA stream、CUDA graph 或 DynamicVRAM 情境都保证兼容。但已足以排除「A3000 完全不能执行该核心」的说法。
五、关键发现:MultiGPU 的 DLPack 装置保护补丁
经检查:
ComfyUI-MultiGPU-main_init_.py
发现外挂包含以下函式:
def _patch_comfy_kitchen_dlpack_device_guard(): ...
相关位置约在第 527~581 行,启动呼叫位于第 592 行。
5.1 原补丁的运作方式
该补丁会包装:
comfy_kitchen.backends.cuda._wrap_for_dlpack
并比较:
• 张量实际所在的 CUDA 装置:tensor.device
• MultiGPU 认定的执行装置:get_current_device()
当两者不一致,而且无法使用 GPU P2P 存取时,补丁可能执行:
staged_tensor = tensor.to("cpu").to(exec_device)
也就是将张量先移到 CPU,再搬往指定 GPU。
5.2 为什么这段程序值得怀疑?
comfy-kitchen 原生 CUDA 反量化流程可能先依照输入张量所在的 GPU 取得 CUDA stream:
stream_ptr = torch.cuda.current_stream(q_2d.device).cuda_stream
之后才将输入、scale 和输出张量包装成 DLPack。
若 MultiGPU 在 DLPack 包装阶段改变了张量所在的 GPU,就可能出现以下不一致:
原始张量:cuda:1
RTX A3000
DLPack 补丁介入
可能经 CPU staging 搬运张量
张量装置可能改变,但原 stream 已选定
潜在的装置/stream 不一致
可能导致 CUDA 700
这是一条合理的技术故障路径,但目前没有直接的 CUDA trace 证明每次错误都由此引起。
另外,DLPack 张量生命周期、异步操作及 CUDA graph 兼容性也可能参与故障,尚未逐项验证。
六、实际修复方式
本次采用最小修改原则,不更换 PyTorch、不重装 CUDA、不删除 MultiGPU,也不修改 H3 工作流。
6.1 修改前
_patch_model_management_current_stream()_patch_comfy_sample_runtime_device()_patch_comfy_kitchen_dlpack_device_guard()_initialize_aimdo_visible_cuda_devices()
6.2 修改后
_patch_model_management_current_stream()_patch_comfy_sample_runtime_device()# _patch_comfy_kitchen_dlpack_device_guard() # TEMP DISABLED_initialize_aimdo_visible_cuda_devices()
只停用一项:
_patch_comfy_kitchen_dlpack_device_guard()
其他 MultiGPU 修补、DisTorch V2、DynamicVRAM 与 CUDA 装置初始化功能均予保留。
本次修复不等于完全移除 DLPack 功能。 停用的是 MultiGPU 外挂对 comfy-kitchen DLPack 包装函式的额外拦截与搬运逻辑,原生 DLPack 仍然存在。
七、修复后的完整测试结果
成功日志:
100%|██████████| 10/10 [03:26<00:00, 20.70s/it][INFO] Comfy model compiler graph breaks: 1, rogues: 0
[INFO] Requested to load MiniMaxH3AudioVAE
[INFO] Model MiniMaxH3AudioVAE prepared for dynamic VRAM loading.
576MB Staged. 0 patches attached.
Force pre-loaded 401 weights: 539 KB.[INFO] Requested to load MiniMaxH3VideoVAE
[INFO] Model MiniMaxH3VideoVAE prepared for dynamic VRAM loading.
4965MB Staged. 0 patches attached.
Force pre-loaded 128 weights: 352 KB.[INFO] Prompt executed in 325.20 seconds
7.1 结果解读
日志 意义
10/10 UNet 全部采样步数完成
03:26 采样进度条显示约 206 秒
20.70s/it 每步平均约 20.70 秒
graph breaks: 1 编译执行过程出现一次 graph break,非致命错误
rogues: 0 该统计值为零
576MB Staged Audio VAE 已准备动态加载
4965MB Staged Video VAE 已准备动态加载
Prompt executed in 325.20 seconds ComfyUI 报告整体执行完成
整体时间与采样时间差约 119 秒,包含其他工作流阶段及额外开销,不能直接全部归因于 VAE 解碼。
本次日志已证明工作流没有因 CUDA 700 中断,但若要正式确认输出影片质量、声音与每帧完整性,仍应检查实际输出档案。
八、成功版本备份与完整性验证
本次保留两份备份。
备份 大小 用途
init.py.bak_before_dlpack_test 37,697 bytes 修改前版本
init.py.H3_2GPU_SUCCESS_20261104.bak 37,716 bytes 本次成功版本
目前使用的 init.py 为 37,716 bytes。
SHA256 验证结果
目前版本与成功备份完全一致
SHA256
8EA2FC10630E9D0F87BE1251306246FBA742CDE91057F9D280B8990580F7C43E
比对结果:True
这表示成功版的 init.py 已被完整保存。
8.1 未来需要还原成功版时
请先关闭 ComfyUI,再执行:
$root = "D:\ComfyUI_windows_portable\ComfyUI\custom_nodes\ComfyUI-MultiGPU-main"Copy-Item
-LiteralPath "$root\__init__.py.H3_2GPU_SUCCESS_20261104.bak"
-Destination "$root_init_.py" `
-Force
此指令只还原 MultiGPU 的 init.py,不会还原其他外挂、PyTorch 或整个 ComfyUI 环境。
九、8188 正式启动与 8189 诊断环境
本次修复是修改 MultiGPU 插件码,而非修改 HTTP 埠号。因此:
8188 与 8189 并不是 CUDA 700 的直接原因。
只要两个 BAT 使用相同的 ComfyUI、Python、外挂版本、CUDA 装置顺序及兼容的启动参数,就会加载相同的 DLPack 补丁修改。
但截至本报告,已取得的完整成功纪录尚不足以证明 8188 正式 BAT 已独立通过同样的 H3 测试。
建议切回 8188 后,使用原本成功的双卡分配再执行一次 10 步工作流,并确认启动日志不再显示:
[MultiGPU] Applied comfy_kitchen CUDA DLPack device guard patch (P2P-aware)
注意:没有显示这行只能作为辅助判断,最终仍应以实际程序状态与完整生成结果确认。
十、问题根因与证据等级
判断项目 证据程度 结论
A3000 完全无法执行 INT8 ConvRot 已被独立测试反驳 不成立
三张 GPU 基本 CUDA 运算失败 已被测试反驳 不成立
MultiGPU DLPack 补丁与故障有关 强烈 A/B 证据 高度可信
CPU staging 导致 stream 不一致 原始码推论 尚待直接验证
comfy-aimdo 本身是根因 证据不足 未确立
CUDA 13.0 本身是根因 证据不足 未确立
双卡 H3 可以成功执行 已有完整执行日志 已验证一次
三卡 H3 可以稳定执行 尚未测试 未验证
本次排查也发现,所使用的 pollockjj/ComfyUI-MultiGPU 项目已于 2026 年 9 月 30 日被封存为只读。这使后续与新版 ComfyUI、comfy-kitchen 及 DynamicVRAM 的兼容性维护更加重要。
不过,项目封存本身并不能证明它就是 CUDA 700 的原因。
十一、后续测试计划
第一阶段:双卡重复验证
维持 GPU0 UNet/VAE、GPU1 CLIP,连续测试 2~3 次,确认生成成功率、输出完整性及耗时。
第二阶段:8188 正式 BAT 验证
确认 BAT 启动路径、CUDA 装置顺序、外挂加载讯息,并以相同工作流生成一次。
第三阶段:RTX 3060 加入测试
优先只将 Audio VAE 移至 GPU2,其他分配保持不变。测试成功后再考虑 Video VAE,避免同时变动多个因素。
第四阶段:效能与稳定性比较
记录 GPU 显存峰值、系统 RAM 峰值、UNet 采样时间、VAE 译码时间、整体耗时及 CUDA 错误次数。
十二、最终结论
本次排查最重要的成果,不只是成功完成一次 H3 影片生成,而是找到了一个可重现、可验证、可还原的最小修复方法。- 原先在 A3000 执行 CLIP 时出现 CUDA 700。
- 独立测试证明 A3000 能执行基本 CUDA 运算及指定尺寸的 INT8 ConvRot 反量化。
- 原始码检查发现 MultiGPU 会在 DLPack 包装阶段进行额外装置检查与可能的 CPU staging。
- 仅停用该补丁后,H3 完成 10/10 采样,整个工作流正常结束。
- 成功版本已备份,并通过 SHA256 完整性验证。
目前建议将这份双卡成功配置视为稳定性测试基准,而不是立即宣告所有多卡兼容性问题都已永久解决。
本次修复也证明,至少在这组测试条件下,RTX 5060 Ti 与 RTX A3000 可以协同完成 MiniMax H3 工作流;因此,没有必要仅因本次 CUDA 700 错误就立即更换显示适配器或重建整套 ComfyUI 环境。
-
-
先给结论:ComfyUI 目前没有官方的张量并行,双卡不会把同一个采样步按 2× 加速;它主要解决「显存容量」和「分阶段/分模块放置」。同一个视频任务想靠第二张卡线性提速,不现实。
1)选型:同一采样链路优先双 5070 Ti,不建议 5070 Ti + 5060 Ti 混跑。5070 Ti 16G 约 896 GB/s、5060 Ti 16G 约 448 GB/s,混用时慢卡会拖住它负责的那一段。5060 Ti 更适合单独做 VAE/CLIP/放大,或跑第二个任务,不适合和 5070 Ti 拼一个 UNet。若目标是「单卡更快」而不是「更大模型」,预算应优先考虑一张 5090 32G,而不是两张 16G。
2)ComfyUI 双卡怎么用:官方没有
--cuda-device 0,1这种把 UNet 切两半的启动参数。可用的路子是 MultiGPU / DisTorch 这类节点,把不同节点或模型块放到 cuda:0 / cuda:1;UNet 采样通常仍由一张卡主导,另一张卡承担 CLIP、VAE、文本编码、放大或 block offload。所谓「协同」多数是容量拼接和流水线分工,不是每个 denoise step 都双卡并行。跨卡块交换走 PCIe,每步都换就会明显掉速。3)PCIe 5.0 x8/x8:对模型加载、VAE/文本编码和「偶尔换块」够用(5.0 x8 约 32 GB/s,约等于 4.0 x16);只有 DisTorch 每步都跨卡搬权重时,x8 才会成为瓶颈。9800X3D + X870E 原生就是 x8/x8,这一点不用纠结。
4)电源:双 5070 Ti(约 300W×2)+ 9800X3D 满载约 750–850W,1000W 品质好的 ATX 3.1 能带,但建议留余量到 1200W,视频生成是长时间满载。
5)落地建议:先用现有 5060 Ti 把基线跑出来(同一工作流、同一分辨率/帧数,记每步耗时、显存峰值、是否 offload);再决定是加 5070 Ti 做「主采样卡」,还是直接上 5090。若必须双卡,买第二张 5070 Ti 比混 5060 Ti 更稳;5060 Ti 留着做辅助卡或第二台机器。别指望双 16G 在 ComfyUI 里变成 32G 单卡。