跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 如何将Minimax H3生成的片子生成干净的 2K/4K/8K?

如何将Minimax H3生成的片子生成干净的 2K/4K/8K?

已定时 已固定 已锁定 已移动 AI音视频画图
minimax视频生成comfyui
1 帖子 1 发布者 168 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • K
    K
    koala
    硕果累累 贵族大夫
    编写于 最后由 koala 编辑
    #1

    ComfyUI 的制作视频升频,基于 MiniMax H3。加载一个片段,设置一个比例因子,按下运行:Tessera 会逐块、逐块地细化它,生成干净的 2K/4K/8K ——在一个消费级 GPU 上,任何剪辑长度下。流式 VAE 编码/解码意味着全分辨率像素剪辑在内存中永远不存在。
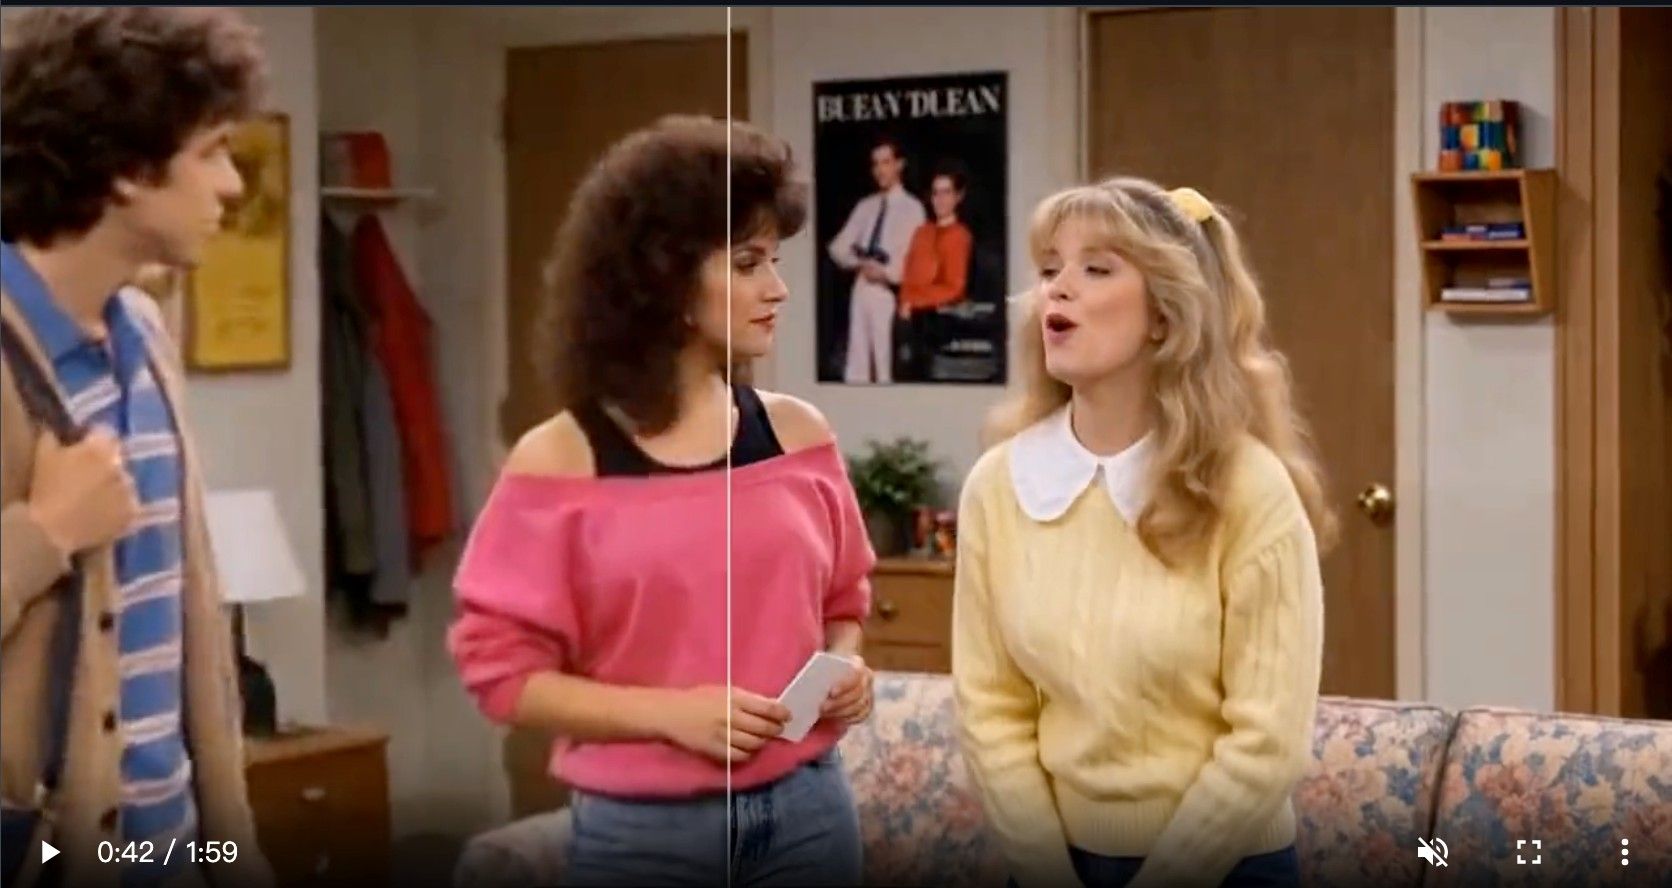
    image.jpeg

    https://private-user-images.githubusercontent.com/25267376/690267938-f27ced3c-fc75-4c98-8823-88c82a61410a.mp4?jwt=eyJ0eXAiOiJKV1QiLCJhbGciOiJIUzI1NiJ9.eyJpc3MiOiJnaXRodWIuY29tIiwiYXVkIjoicmF3LmdpdGh1YnVzZXJjb250ZW50LmNvbSIsImtleSI6ImtleTUiLCJleHAiOjE3OTM3MTEzOTgsIm5iZiI6MTc5MzcxMTA5OCwicGF0aCI6Ii8yNTI2NzM3Ni82OTAyNjc5MzgtZjI3Y2VkM2MtZmM3NS00Yzk4LTg4MjMtODhjODJhNjE0MTBhLm1wND9YLUFtei1BbGdvcml0aG09QVdTNC1ITUFDLVNIQTI1NiZYLUFtei1DcmVkZW50aWFsPUFLSUFWQ09EWUxTQTUzUFFLNFpBJTJGMjAyNjExMDMlMkZ1cy1lYXN0LTElMkZzMyUyRmF3czRfcmVxdWVzdCZYLUFtei1EYXRlPTIwMjYxMTAzVDEzMDQ1OFomWC1BbXotRXhwaXJlcz0zMDAmWC1BbXotU2lnbmF0dXJlPWM3NDQ1Y2ZhYTY1ZGZlY2ExMGM3Y2ZjODcwMTFlNWVlZGFmNGEzNzUyNjc2MDQ4ZmRhODQyNTdlNjhjZTRmYjkmWC1BbXotU2lnbmVkSGVhZGVycz1ob3N0JnJlc3BvbnNlLWNvbnRlbnQtdHlwZT12aWRlbyUyRm1wNCJ9.MuxrLNAWFyN5CrioMj05lMkPkROyKG7sGrSu0IJavsU

    cd ComfyUI/custom_nodes
    git clone https://github.com/hashu786/ComfyUI-Tessera
    

    本人7900XTX实测拿到的关键数据,基本放弃:

    配置:5 秒 0.4MP 片段(864×480 / 120 帧)做 2.0 倍放大,输出 1728×960
    TesseraDilate 把 120 帧膨胀到 141 帧(1.18 倍),TesseraEncode 分 4 窗编码,单节点 ETA 205 分钟,整链路含 Refine 预计超 3.4 小时
    根因:AMD 7900 XTX + ROCm 7.2 无注意力加速内核,H3 扩散采样速度约 CUDA 的 1/3,砍帧/砍分辨率改不了量级。

    对比:社区 N 卡跑同量级 2K 实测 47 分钟,官方 4K 单条 3 小时(N 卡),简直是又快又好。

    1 条回复 最后回复
    -1

    你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

    厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

    有了你的建议,这篇帖子会更精彩哦 💗

    注册 登录
    回复
    • 在新帖中回复
    登录后回复
    • 从旧到新
    • 从新到旧
    • 最多赞同


    • 登录

    • 登录或注册以进行搜索。
    • 第一个帖子
      最后一个帖子
    0
    • 版块
    • 最新
    • 标签
    • 热门
    • 用户
    • 群组