不同的LLMs 風格體驗
-
使用了一些LLMs 突然有些感受
Deepseek 像優雅的紳士
Qwen Flash 像博學多聞的老師
Qwen 27B 像埋頭苦幹的工程師
Ornith-1.5 像音速小子橫衝直撞 但總能撞回到正確的位置
ChatGPT 像什麼都會 很會聊 聊天高手 標準的公關特質(Public Relationship)
Claude 像商業導師 很會計算
Gemini 像多媒體專家
Perplexity 像百科全書
Hermes Agent 貼心 情緒價值提供專家
Deeepseek Harness 硬漢作風
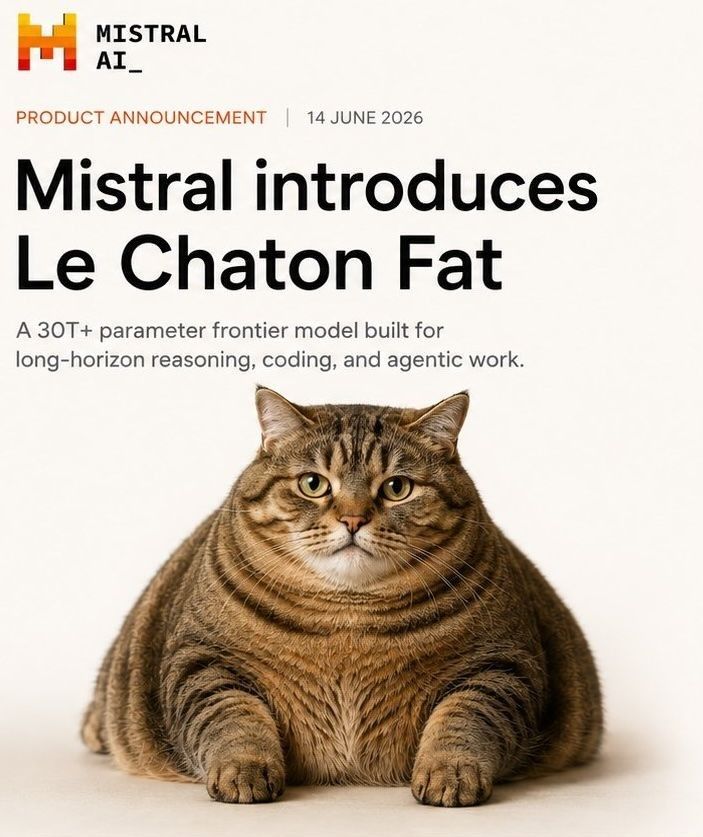
"Character.ai" 沒有你想不到的 聊天伴侶Mistral 沒用過 不知到會不會充滿法國人的浪漫?
-
使用了一些LLMs 突然有些感受
Deepseek 像優雅的紳士
Qwen Flash 像博學多聞的老師
Qwen 27B 像埋頭苦幹的工程師
Ornith-1.5 像音速小子橫衝直撞 但總能撞回到正確的位置
ChatGPT 像什麼都會 很會聊 聊天高手 標準的公關特質(Public Relationship)
Claude 像商業導師 很會計算
Gemini 像多媒體專家
Perplexity 像百科全書
Hermes Agent 貼心 情緒價值提供專家
Deeepseek Harness 硬漢作風
"Character.ai" 沒有你想不到的 聊天伴侶Mistral 沒用過 不知到會不會充滿法國人的浪漫?
-
-
-
-
-
-
@kos-or 学习谈不上,其实我是在前两年,通过这篇论文学习的大致内容Personality Traits in Large Language Models
可以简单粗暴的理解为,高质量的模型,就是会凸显某种性格特质。(所谓的BIG 5)。
后训练的时候是以能力最强为目标的,目前的论文是观察到,恰巧能力最强时,模型会收敛到某个性格特质中。也可以简单粗暴的理解为,如果一个LLM的性格特点很鲜明,那么从某种意义上讲,他训练的就比较成功。我个人认为这也很符合逻辑,27B的模型一定是探索、多疑、勤劳的,否则以27B的信息体量他不可能完成复杂工作。
5T的超大规模模型则可以更多面一些,可能会更浪漫,更像人。如果他和27B一样多疑,那可能推理层面的成本就直接飞了,运行效率直接就是灾难。后面依照这个论文为基础,衍生出了很多执行层面的论文,比如如何解决“谄媚”问题(著名的梗:you're absolutely right),如何训练人格从而不依赖系统提示词Open Character Training。时间原因我就没有细研究了。
虚心交流,一起进步
-
@kos-or 学习谈不上,其实我是在前两年,通过这篇论文学习的大致内容Personality Traits in Large Language Models
可以简单粗暴的理解为,高质量的模型,就是会凸显某种性格特质。(所谓的BIG 5)。
后训练的时候是以能力最强为目标的,目前的论文是观察到,恰巧能力最强时,模型会收敛到某个性格特质中。也可以简单粗暴的理解为,如果一个LLM的性格特点很鲜明,那么从某种意义上讲,他训练的就比较成功。我个人认为这也很符合逻辑,27B的模型一定是探索、多疑、勤劳的,否则以27B的信息体量他不可能完成复杂工作。
5T的超大规模模型则可以更多面一些,可能会更浪漫,更像人。如果他和27B一样多疑,那可能推理层面的成本就直接飞了,运行效率直接就是灾难。后面依照这个论文为基础,衍生出了很多执行层面的论文,比如如何解决“谄媚”问题(著名的梗:you're absolutely right),如何训练人格从而不依赖系统提示词Open Character Training。时间原因我就没有细研究了。