LLM 帕雷托線(斬殺線)準嗎? 我選了最沒有CP值的claude模型是正確的嗎?
-
關於雲端 LLM 選型
想誠心請教一個「圖表 vs 實務」的開放性問題:
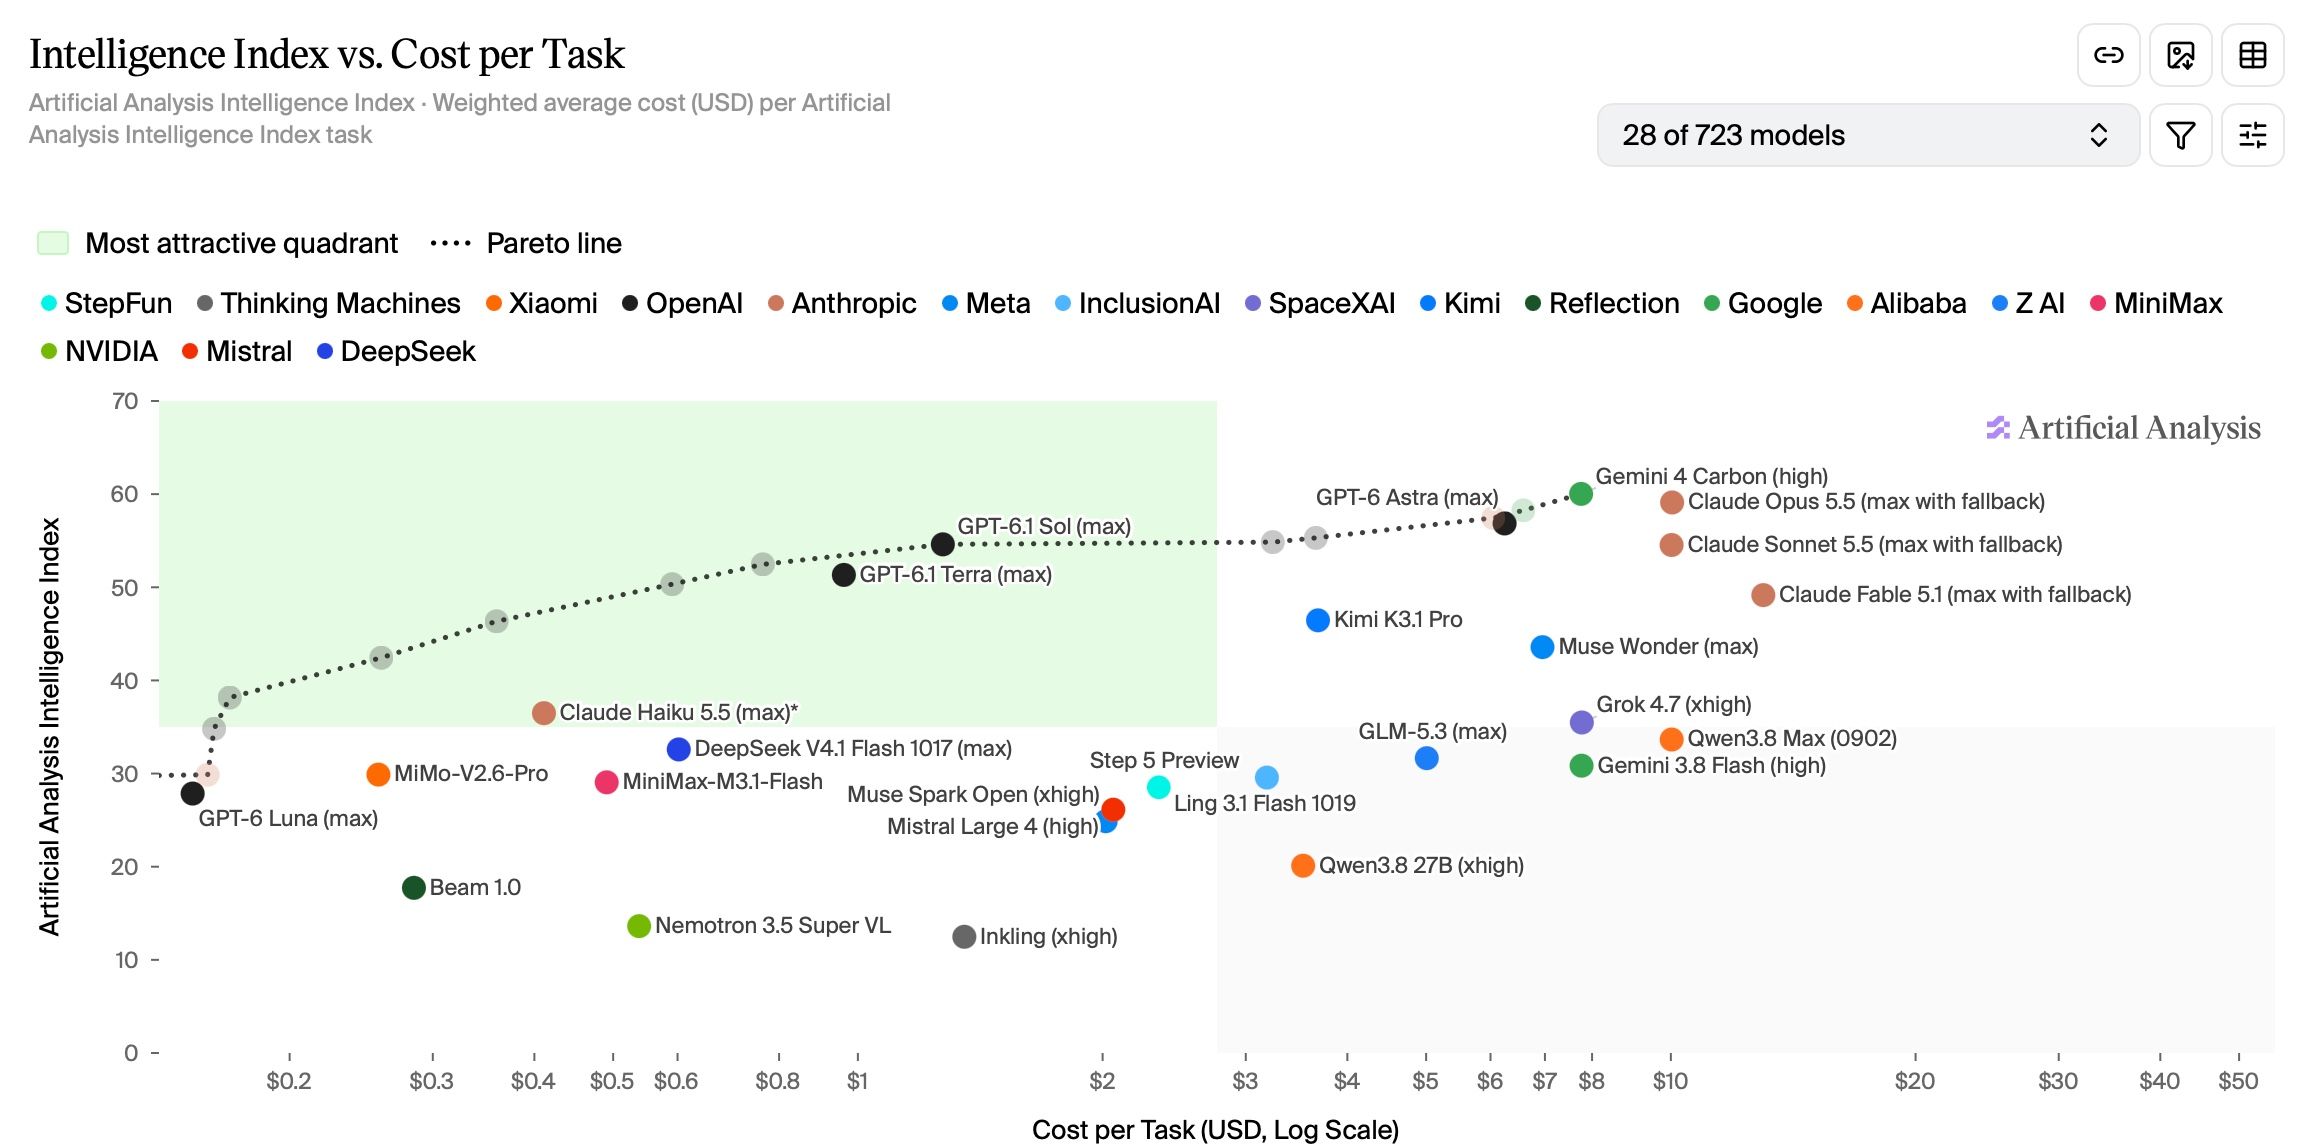
看 Artificial Analysis 最新這張評測圖,黑色虛線的帕雷托效率線非常清晰。我自己是看誰出錢,現在公司出預算所以用最貴的 Claude;如果自己出錢大概會去用 Codex。
但我想探討的是,如果排除本地部署的隱私需求,單純接雲端 API,大家會怎麼看待那些在圖表上在帕雷托線之下、離效率線比較遠的模型?
例如 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash或者是 Grok 4.7。
在商務或工程產線的真實世界裡,到底有哪些關鍵的 Trade-offs(例如提示詞遷移成本、特定任務的穩定度、或是雲端平台的生態鎖定),會讓一個團隊決定放著黑線上「同樣價錢最聰明、同樣智能最便宜」的模型不用,而選擇留在線下的次優解?
歡迎各位實際在帶專案的開發者或架構師分享你們的觀點或實務經驗。 -
-