
【双卡视频生成无痛提升18.8%】出片跨卡拆分为主项的视频生成优化项目——Kuzuryūsen本质是Combo
-
其实我对Radiance项目的理解很肤浅。很多的情况是基于我跟AI聊天所获得的信息。尽管参与过对Radiance在7900XTX平台上的移植,但当时只是单纯觉得实现TP=2就是实现了复刻移植。
直到昨天,听了老特对Radiance项目拆解介绍,我攸有种顿悟的感觉。
https://lcz.me/topic/2826客观讲,Radiance项目最大的收益来自于TP=2的系列优化,这没错。但是不能说实现了TP=2就复刻了 Radiance这个项目。
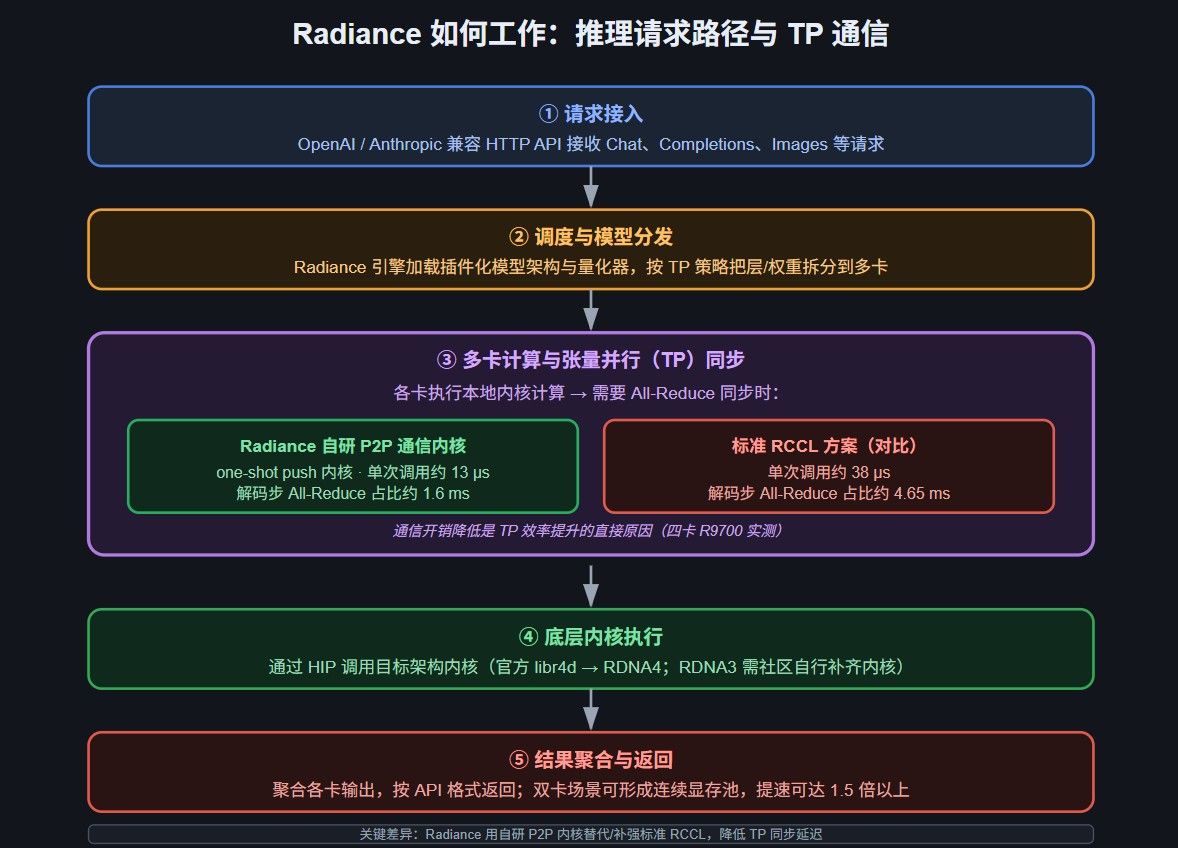
简单说,TP=2只是实现了把单车道拓成双车道,但Radiance的本质,更接近于双车道的红绿灯系统+交警管制。如果能更好的调整通道,是不是可以在TP=2的基础上进一步提升效率,不断地逼进帕累托最优状态?这是我的猜想,这也是进一步要验证的。
成果还是挺让我惊喜的:
在视频生成范畴,在大分辨率,长视频生成过程中,累加TP=2的最大优化最多可以节约18.8%的生成时间,重要的是没有代价,无痛提升。本项目的参数相对温和,调参至激进策略需要牺牲一部分画质,在此基础上仍有20%~25%的加速空间。
在拆解的过程中发现Radiance确实是个很优秀的项目,目前本项目对照Radiance仍优化空间。之后的优化对象难度较大,需要时间,项目分持续更新。(详见文件第6部分)
项目名称不是耍宝,整体的思路就是通过平A的组合换得一个大招。这跟《浪客剑心》中比古清十郎教授的九头龙闪,简直异曲同工。
这个项目中,单个项目MLP 分块、VAE 跨卡、心跳兜底、帧计划对账优化收益微小,甚至无收益。但放在整个项目组合后放大,甚至取得非线性收益(如VAE拆分)。
同时也致敬我非常喜欢的动漫作品《浪客剑心》。
-------------------------祖传手打分割线--------------------------
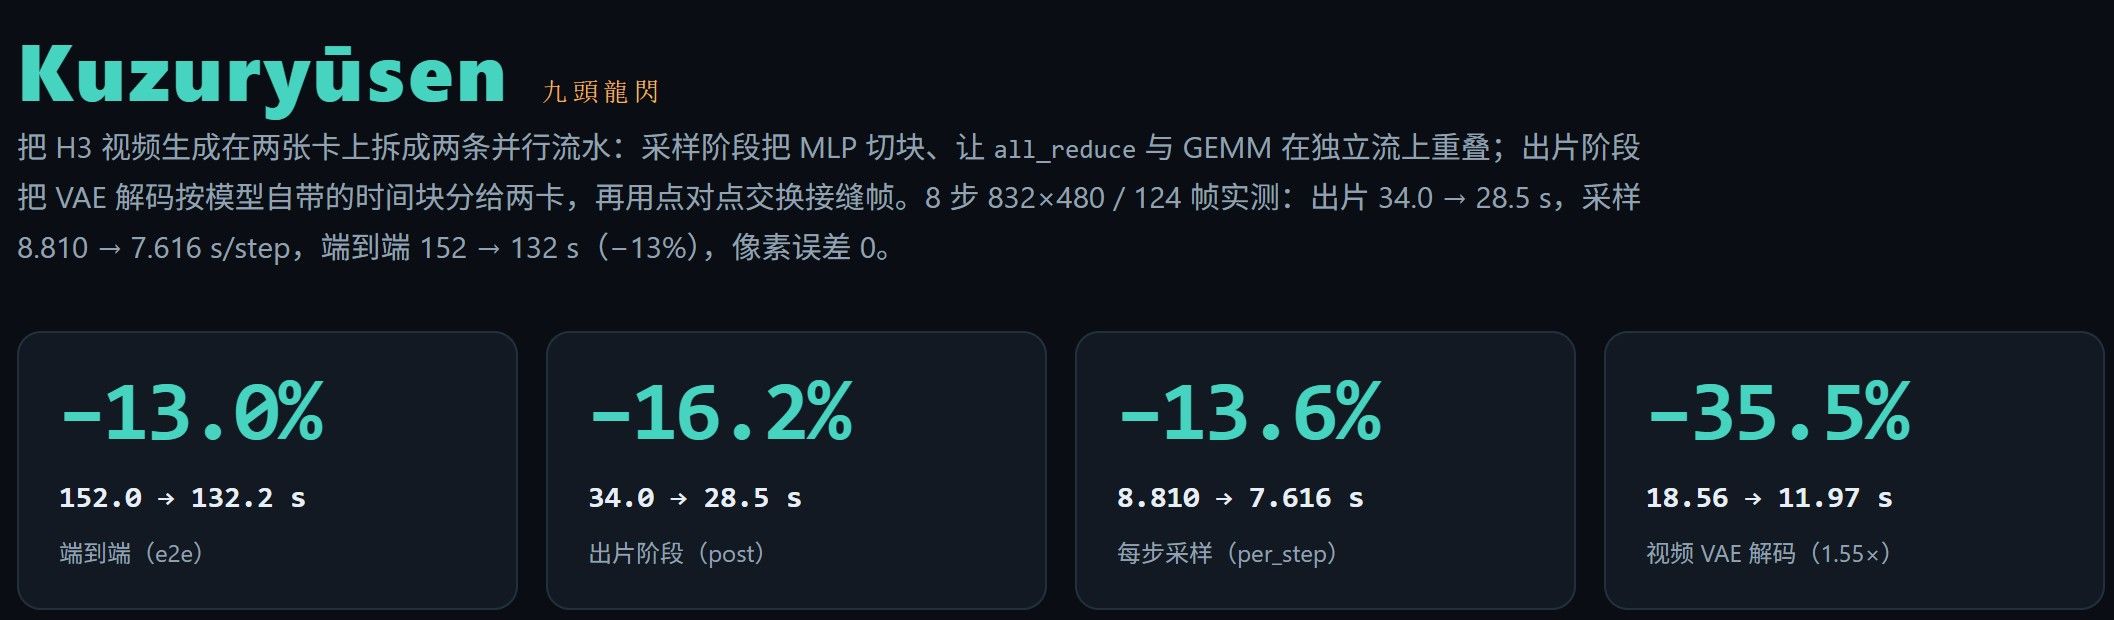
Kuzuryūsen · 九頭龍閃
把 H3 视频生成在两张卡上拆成两条并行流水:采样阶段把 MLP 切块、让 all_reduce 与 GEMM 在独立流上重叠;出片阶段把 VAE 解码按模型自带的时间块分给两卡,再用点对点交换接缝帧。8 步 832×480 / 124 帧实测:出片 34.0 → 28.5 s,采样 8.810 → 7.616 s/step,端到端 152 → 132 s(−13%),像素误差 0。
−13.0% 端到端 152.0 → 132.2 s | −16.2% 出片 34.0 → 28.5 s | −13.6% 采样 8.810 → 7.616 s/step | −35.5% 视频 VAE 解码 18.56 → 11.97 s(1.55×)
名字出自『るろうに剣心』飞天御剑流奥义:九记简单斩击同时命中九处要害,合成一记无法格挡的绝招。本项目同名 —— MLP 分块、VAE 跨卡、心跳兜底、帧计划对账,每一招都朴素,拼合起来才是整体提速。
日期:2026-11-04 环境:X99 + 2×7900XTX(gfx1100),双 ComfyUI 实例(8191/8192),COMFY_TP_WORLD=2
用例:8 步 / 832×480 / 124 帧 / seed 固定,bench.py 提交,run_case.sh 驱动
验收指标:post_sampling_s 与 per_step(e2e 受采样前加载波动影响,仅作参考)核心结论(KPI)
指标 数值 相对基线 e2e(今天,TP2+P2P) 132.2 s −4.5 s / −3.3%(vs 136.7 s) post 27.7–28.5 s −5.5 ~ −6.3 s / −16.2% ~ −18.5%(vs 34.0 s) per_step 7.616 s −1.194 s / −13.6%(vs MLP 分块前 8.810 s) 像素误差 0.000 逐位一致(124×480×832×3) 三个口径一句话:
-
TP2+P2P 已打通(我们这边):在你原有优化之上再拿 −15 ~ −17 s / −10% ~ −11%(相对 152 s 时期)。
-
TP2 但 P2P 未打通:仍拿 −4.0 s post / −11.8%,e2e −6.5 s / −4.7%。
-
完全没做 TP2(单卡):今日改动收益 0 s / 0%,该拿到的是 TP2 本身的 −27.2 s / −17.1%。
0.1 指标口径速查(读表前 30 秒)
指标 一句话说明 post_sampling_s(post) 采样结束到成片落盘的墙钟:VAE 视频解码 + 音频解码 + 帧转换 + 编码封装。本次主 KPI,不受加载波动干扰。 per_step 采样总时长 ÷ 步数,只反映 DiT 计算与卡间通信,用来判断「采样内优化」是否生效。 pre 模型加载 + 文本编码,一次 run 固定发生;波动可达 ±10 s,不进 KPI。 e2e pre + 采样 + post 的总墙钟,仅作参考、不横比。 max_abs_diff 同一 latent 下两条解码路径的像素最大绝对差;0 表示逐位一致,不是「PSNR 够高」。 Δ / Δ% 变化量 = 之后 − 之前;变化率 = 变化量 ÷ 基线值,负数代表变快。 今天改了什么,为什么这么改
两条主线都不新增数值路径,只改编排 —— 收益确定、画质无损,因此能与已有 TP2 / P2P / LoRA 分片逻辑共存。
改动 做法 量化收益 A · 采样内 MLP 分块 + 双流重叠 MLP token 按块切开,GEMM 与 all_reduce 放到独立 comm stream 上重叠;通信越慢收益越大,适配本机 PCIe Gen3 x8 per_step 8.810 → 7.616 s,−1.194 s / −13.6%;8 步合计 −9.55 s / −13.6% C · 出片内 VAE 解码按时间块分给两卡 复用 H3 VAE 自带「5 latent 帧 + 2 帧上下文」时间块与块间 5 帧线性混合:rank0 解块 0–3,rank1 解块 3–6,接缝块两边各解一遍,再 P2P 互换帧 视频解码 18.56 → 11.97 s,−6.59 s / −35.5%(1.55×) 无冲突 接缝块重复解码 = 单卡本就存在的依赖 rank1 首块前 5 帧需要 rank0 那一块的尾段分片;两 rank 都解接缝块后无跨卡时序依赖,结果与单卡逐位相同 代价 每卡多解 1/7 的块(每卡 4 块 vs 7 块,+57% 单卡计算量),但墙钟仍 −42.5% 实测 max_abs_diff = 0.000 健壮性 心跳 + 一致回退 + 上游对账 交换前 all_reduce MIN 心跳(默认 60 s):一侧判定不可拆则双方整片解码;真卡住快速报错而非挂 30 min;帧计划与 decode_output_shape() 自动对账 实测 3 s 超时 → 3.01 s 抛错(0 挂死) — 2. 场景 A · TP=2 且 P2P 已打通(我们这边)
这是相对「你原先的优化」的增量:TP2 与 P2P 已实现,今天只叠加 MLP 分块 + VAE 跨卡。
2.0 适用对象
适用
-
已上或准备上 TP=2 的双卡生产环境(单卡不在收益范围,见 §4)。
-
出片段占比高的视频工作流:H3 / MiniMax 类 DiT 视频模型,VAE 解码 + CPU 帧转换合计占 post 六成以上。
-
批量出片:一次加载连续跑多条,固定约 48 s 的开销被摊薄,1080p 以上总优化约 18%。
-
显存吃紧的 24 GB AMD 卡(7900 XTX,已实测):单卡放不下整片解码,需要按时间块把 VAE 分摊到两卡。
-
对画质有硬要求、不能接受 int8 或近似算法,但愿意重构编排的团队。
不适用 / 收益很薄
-
NVIDIA 4090 等消费卡不能直接套用:驱动层禁用了 PCIe P2P,只能退化到 §3 的 SHM 回退;现有启动脚本用 HIP_VISIBLE_DEVICES,尚未做 CUDA 适配与验证,收益无法承诺。
-
纯单卡部署:收益 0%,应先上 TP2 拿 −27 s。
-
图像 / 单帧生成:没有 VAE 时间维可拆,MLP 分块也没有跨卡通信可藏。
-
极短片(< 3 s):固定开销与帧交换占比过高,收益通常 < 5%。
-
已换轻量解码器、或解码已不是瓶颈的管线。
-
两卡无高速互联、连 0.4 s 帧交换都不可接受的机器 —— 需先确认 RCCL 带宽。
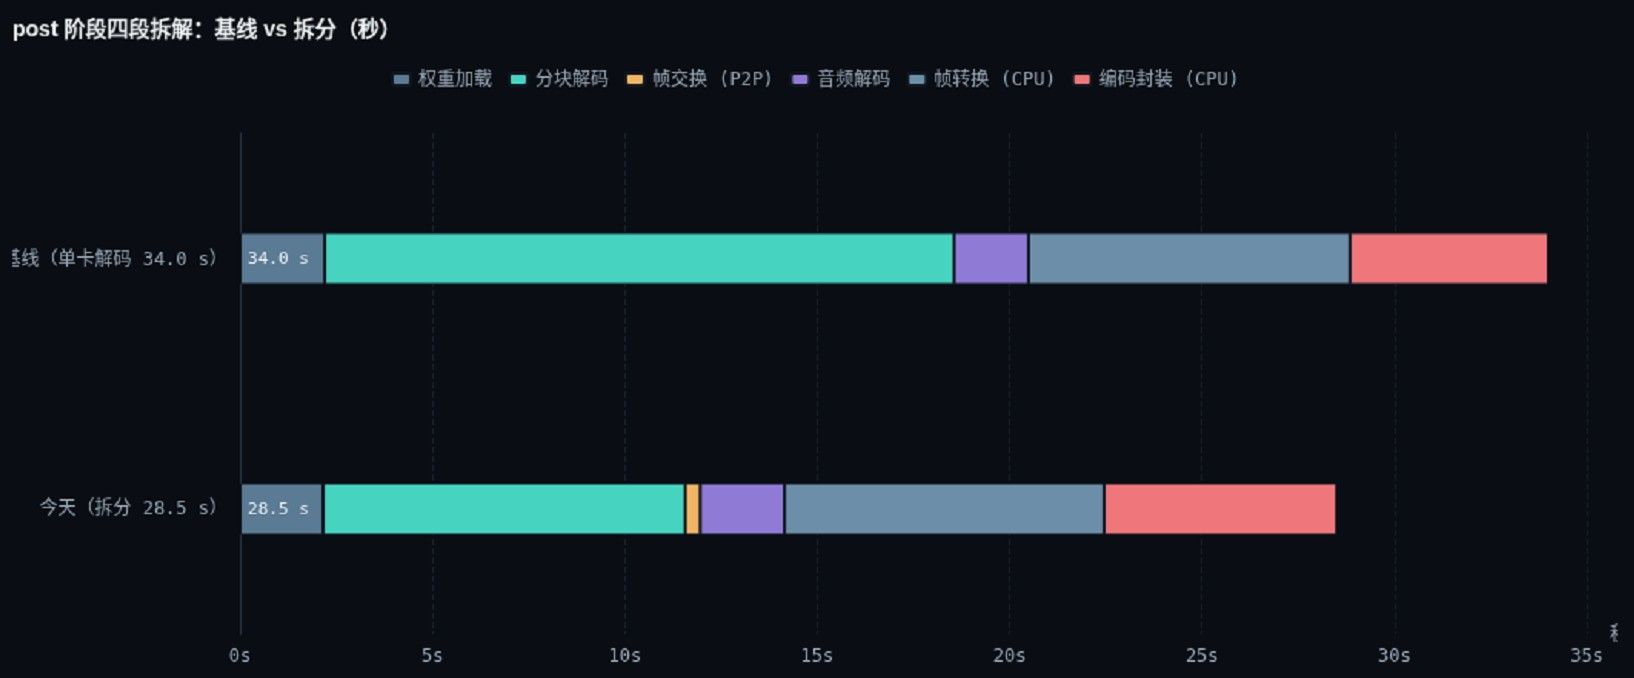
指标 原有 TP2(拆分关,v_g) 今天(拆分开,v_f) 变化量 变化率 post(视频+音频+转换+编码) 34.0 s 28.5 s −5.5 s −16.2% 视频 VAE 解码合计 18.56 s 11.97 s −6.59 s −35.5%(1.55×) ├ 权重加载 2.20 s 2.16 s −0.04 s −1.8% ├ 分块解码(7 块 / 每卡 4 块) 16.36 s 9.41 s −6.95 s −42.5% └ 帧交换(P2P) — 0.39 s +0.39 s(新增) 占 post 1.4% 音频 VAE 解码 1.93 s 2.19 s +0.26 s +13.5% CreateVideo 帧转换(CPU) ≈8.35 s ≈8.30 s −0.05 s −0.6% SaveVideo 编码封装(CPU) 5.16 s 6.05 s +0.89 s +17.2%(CPU 争用) per_step(采样) 7.618 s 7.616 s −0.002 s −0.03%(噪声) pre(加载+文本编码) 49.3 s 48.1 s −1.2 s −2.4%(与本次无关) e2e 136.7 s 132.2 s −4.5 s −3.3% 拆分 run 的 post 分布:27.1 / 27.7 / 27.7 / 28.5 / 28.7 / 30.7 s → 稳定落 27–29 s;相对 34.0 s 为 −5 ~ −7 s / −14.7% ~ −20.6%。最好一次 v_c 27.7 s,−6.3 s / −18.5%。
2.1 post 四段拆解(基线 vs 拆分,秒)
分段 基线(单卡解码) 拆分(两卡解码) 变化量 变化率 权重加载 2.20 2.16 −0.04 −1.8% 视频分块解码 16.36 9.41 −6.95 −42.5% 帧交换(P2P) 0 0.39 +0.39 新增 音频解码 1.93 2.19 +0.26 +13.5% 帧转换(CPU) 8.35 8.30 −0.05 −0.6% 编码封装(CPU) 5.16 6.05 +0.89 +17.2% 合计 34.00 28.50 −5.50 −16.2% 2.2 per_step 位置(秒/步)
配置 per_step 相对 7.616(今天) 相对 8.810(分块前) 单卡 WORLD=1 11.235 +3.619 / +47.5% +2.425 / +27.5% TP2(MLP 未分块) 8.810 +1.194 / +15.7% — 今天 TP2+分块+VAE 拆分 7.616 — −1.194 / −13.6% int8 AR(画质不达标) 7.023 −0.593 / −7.8% −1.787 / −20.3% 实测下限(无 all_reduce) 5.705 −1.911 / −25.1% −3.105 / −35.2% 2.3 合并账(相对你原有的 TP2+P2P)
项 变化量 变化率 采样(8 步,8.810 → 7.616 s/step) −9.55 s −13.6% 出片 post(34.0 → 27.7~28.5 s) −5.5 ~ −6.3 s −16.2% ~ −18.5% 合计 −15 ~ −17 s −9.9% ~ −11.2% e2e(152.0 s 时期 → 132.2 s) −19.8 s −13.0% 3. 场景 B · TP=2 但 P2P 没打通(走 SHM 回退)
用 COMFY_TP_P2P=0 关掉拓扑修正补丁实测。
指标 P2P 未打通 · 今天之前(v_h) P2P 未打通 · 今天(v_i) 变化量 变化率 per_step 7.617 s 7.627 s +0.010 s +0.13%(噪声) post 33.9 s 29.9 s −4.0 s −11.8% e2e 138.1 s 131.6 s −6.5 s −4.7% 对比场景 A 的同一改动:post 降幅 −11.8% vs −16.2%,即 P2P 未打通时仍保留 约 73% 的出片收益(−4.0 s / −5.5 s)。
为什么 per_step 没差:P2P 补丁与 SHM 回退都在 RCCL ~5 GB/s 量级(实测 copy engine 5.15 GB/s),MLP 分块已把通信藏进 GEMM,路径差异被吸收(±0.13%)。
对尚未打通 P2P 的项目:今天两项改动都不依赖 P2P —— 帧交换走 batch_isend_irecv,SHM 下同样工作,代价只是交换那 0.4 s 略增。收益约 −4 ~ −6 s / −11.8% ~ −17.7%(post)。
唯一需留意:VAE 交换是一次点对点通信;若对端实例在解码节点不存在/被缓存跳过,需心跳兜底(已实现,默认 60 s 快速失败)。
4. 场景 C · 没做 TP=2(单卡)
单卡用同一套代码实测(w4a8 4-bit 权重,24 GB 单卡可跑),COMFY_TP_WORLD=1。
指标 单卡(v_j) TP2 + 今天(v_f) 变化量 变化率 per_step 11.235 s 7.616 s −3.619 s −32.2% post 39.2 s 28.5 s −10.7 s −27.3% pre 41.6 s 48.1 s +6.5 s +15.6%(TP 两边各载一份) e2e 159.4 s 132.2 s −27.2 s −17.1% 诚实结论:对还没做 TP=2 的项目,今天的改动收益是 0 s / 0%。 两条优化都在 TP_WORLD > 1 的保护分支里,单卡直接走原生路径。他们真正该拿到的是 TP2 本身那 −27 s / −17%,而不是今天的拆分;反过来说,今天的改动是「TP2 之上的第二层收益」,不能替代 TP2。
4.1 三场景 e2e 对照(秒)
场景 今天之前 今天 变化量 变化率 C · 单卡 159.4 159.4 0 s 0% B · TP2 无 P2P 138.1 131.6 −6.5 s −4.7% A · TP2+P2P 136.7 132.2 −4.5 s −3.3% 5. 全量 run 明细
同机、同用例;pre 波动大时 e2e 不可横比,以 post / per_step 为准。带 * 为热缓存/特殊配置,仅取 per_step 作参考。per_step 变化率以 v_g(7.618 s)为基准。
run 场景 / 配置 e2e (s) pre (s) post (s) per_step (s) per_step 变化 v_j 单卡 WORLD=1 159.4 41.6 39.2 11.235 +3.617 / +47.5% d_base 最早基线(未做 MLP 分块) 179.4 91.7 34.2 7.611 −0.007 / −0.09% f_base MLP 分块之前(8.81 时期) 152.0 — — 8.810 +1.192 / +15.6% tp2_noar* 去掉全部 all_reduce(仅作上限参考) — — — 5.705 −1.913 / −25.1% b_q8* int8 all_reduce(画质不达标) — — — 7.023 −0.595 / −7.8% m_rep TP2+P2P,拆分未做(早期) 138.9 51.2 34.1 7.618 0.000 / 0% v_a TP2+P2P,拆分关 145.1 57.6 34.2 7.607 −0.011 / −0.14% v_g TP2+P2P,拆分关(本次基线) 136.7 49.3 34.0 7.618 0.000 / 0%(基准) v_c TP2+P2P,拆分开(最好一次) 132.6 51.4 27.7 7.614 −0.004 / −0.05% v_f TP2+P2P,拆分开(带分段打点) 132.2 48.1 28.5 7.616 −0.002 / −0.03% v_d TP2+P2P,拆分开(复跑) 134.5 52.5 28.7 7.608 −0.010 / −0.13% v_e TP2+P2P,拆分开(pre 慢的一次) 147.4 66.0 27.8 7.649 +0.031 / +0.41% v_h P2P 未打通,拆分关 138.1 50.7 33.9 7.617 −0.001 / −0.01% v_i P2P 未打通,拆分开 131.6 48.2 29.9 7.627 +0.009 / +0.12% d_fp16vae 否决项:fp16 VAE 188.1 98.9 34.7 7.616 −0.002 / −0.03% m_fp8te 否决项:fp8 文本编码器 141.0 52.7 34.7 7.616 −0.002 / −0.03% d_sage 否决项:sage attention 212.5 61.3 45.2 14.964 +7.346 / +96.4% post 相对 34.0 s 的整体变化(拆分组):v_c 27.7(−6.3 / −18.5%)、v_e 27.8(−6.2 / −18.2%)、v_f 28.5(−5.5 / −16.2%)、v_d 28.7(−5.3 / −15.6%);P2P 未打通组 v_i 相对自身基线 v_h 为 −4.0 / −11.8%。
跟现实上限还差多少,剩下能提多少
以本机硬件物理上限为参照(外部 radiance / RX9700 数字无法联网核对,不引用,只给可验证口径)。
项 现状 上限 可再挖(量 / 率) 占比 风险 视频解码 9.41 s(每卡 4 块) 8.2 s(3.5 块) −1.21 s / −12.9% post 4.2% 中(接缝分片要单向下发,rank1 空等) 音频解码 2.19 s ≈1.1 s −1.09 s / −49.8% post 3.8% 高(音频 VAE 无时间分块接口) 帧转换(CPU) ≈8.30 s ≈4.2 s −4.10 s / −49.4% post 14.4% 中(更换 stock 节点) 编码封装(CPU) 5.16–6.05 s ≈2.9 s −2.26 ~ −3.15 s / −43.8% ~ −52.1% post 7.9% ~ 11.1% 中(分半编码 + concat) 采样 all_reduce 7.61 s/step 5.71 s/step −1.90 s/step / −25.0% 8 步 −15.2 s 高(唯一手段 int8 会掉画质) pre 加载 48–49 s ≈30 s 临界路径 −5 ~ −10 s(关键路径)/ −10.3% ~ −20.6% e2e 3.8% ~ 7.6% 低(不改数值路径) 6.1 e2e 剩余提速路线(秒,按实施顺序累加)
阶段 e2e 本步变化 累计变化 累计变化率 现状(今天) 132.2 — — — 音频拆分(−1.09)+ 编码拆分(−2.26 ~ −3.15) 127.9 ~ 128.8(取 128.4) −3.8 s / −2.9% −3.8 s −2.9% 帧转换换 stock 节点(−4.10) 124.3 −4.1 s / −3.2% −7.9 s −6.0% pre 加载并行(−5 ~ −10) 114.3 ~ 119.3 −5 ~ −10 s / −4.0% ~ −8.0% −12.9 ~ −17.9 s −9.8% ~ −13.5% AR 减量(−15.2,掉画质) 99.1 ~ 104.1 −10.2 ~ −15.2 s / −8.6% ~ −12.7% −28.1 ~ −33.1 s −21.3% ~ −25.0% 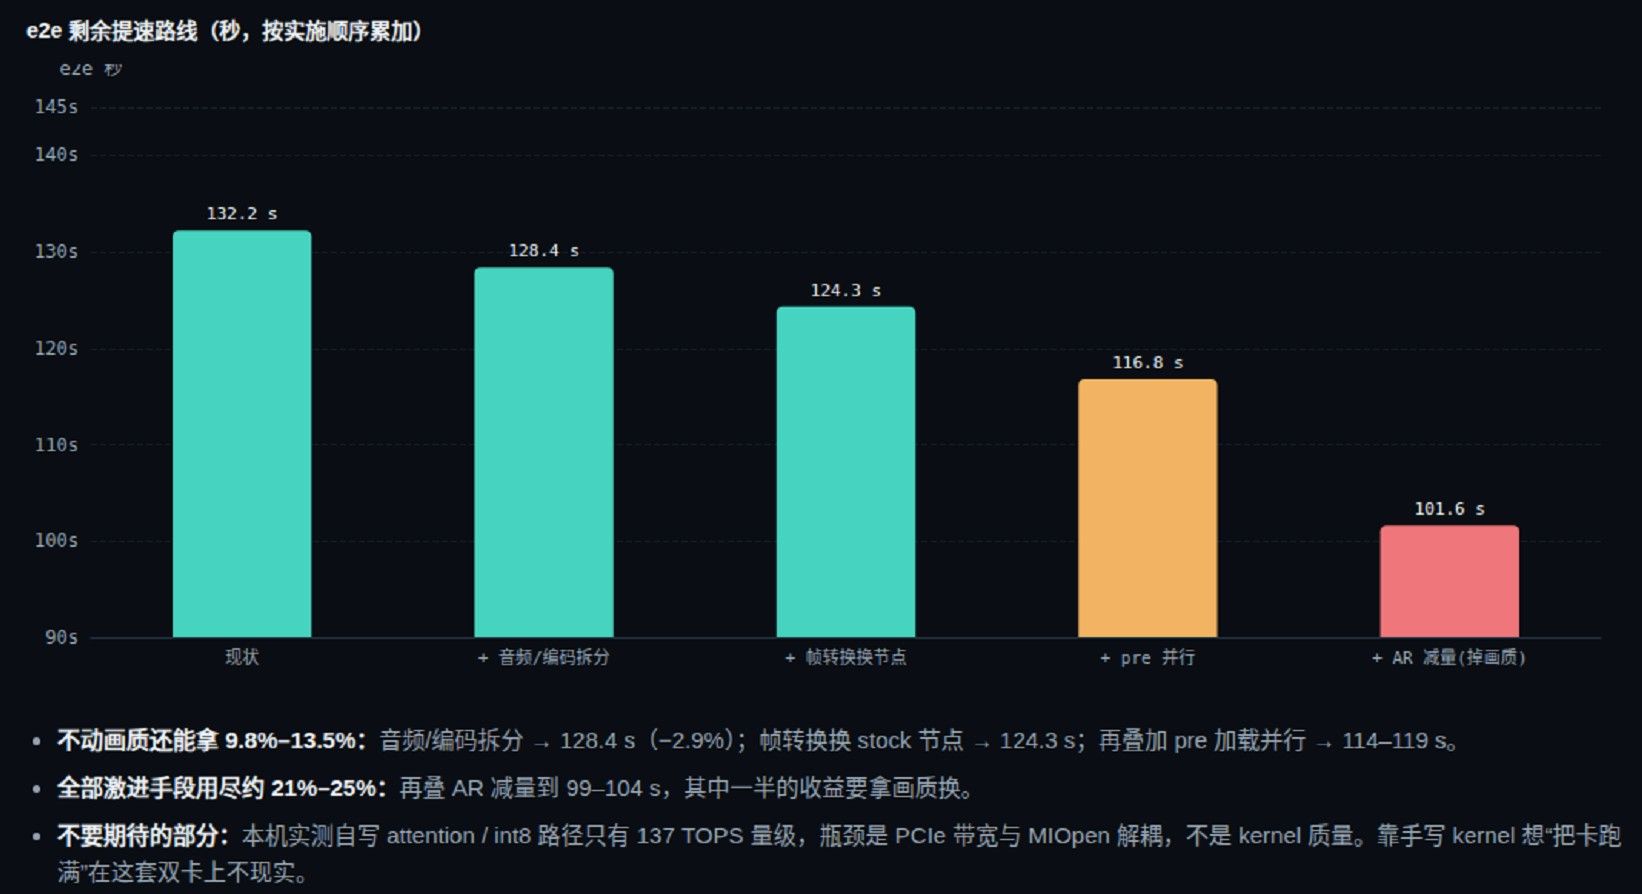
不动画质还能拿 9.8%–13.5%:音频 / 编码拆分 → 128.4 s(−2.9%);帧转换换节点 → 124.3 s;再叠加 pre 加载并行 → 114–119 s。
全部激进手段用尽约 21%–25%:再叠 AR 减量到 99–104 s,其中一半收益要拿画质换。
不要期待的部分:本机实测自写 attention / int8 路径仅 137 TOPS 量级,瓶颈是 PCIe 带宽与 MIOpen 解耦,不是 kernel 质量。
验收口径与已知问题
正确性验收:同一 latent 跑真实权重,vae.decode 与拆分拼回的 124×480×832×3 像素 max_abs_diff = 0.000,接缝帧 64–72 同样为 0;1–89 个 latent 长度的控制流逐一对照全部一致(bad=0,差异 0%)。
为什么不用成片 md5:不同 run 的采样 latent 本身有 max_abs_diff ≈ 3.2(bf16 归约分组 + 加载状态差异,8 步放大),所以验收只能用 post / per_step + 同 latent 像素 A/B。
已知缺陷(与本次改动无关):封装阶段音频编码报 avcodec_send_frame() returned 22,基线与拆分一致;成片为完整 124 帧 h264(832×480,5.17 s)但没有音频流。建议先修它,再做编码拆分。
开关:COMFY_TP_VAE_SPLIT=1、COMFY_TP_VAE_LOG=1、COMFY_TP_VAE_TIMEOUT=60、COMFY_TP_P2P_WARMUP=0、COMFY_TP_NODELOG=1。
收尾实例 · 九頭龍閃在不同分辨率 / 时长下的总优化
以本机实测的 832×480 / 124 帧(24 fps,5.2 s)为锚点:固定开销(加载 + 文本编码 ≈48 s)不随片长变化,计算部分按「像素数 × 帧数」线性放大。下表为外推估算(±10%),用于判断量级,不是新的实测点。
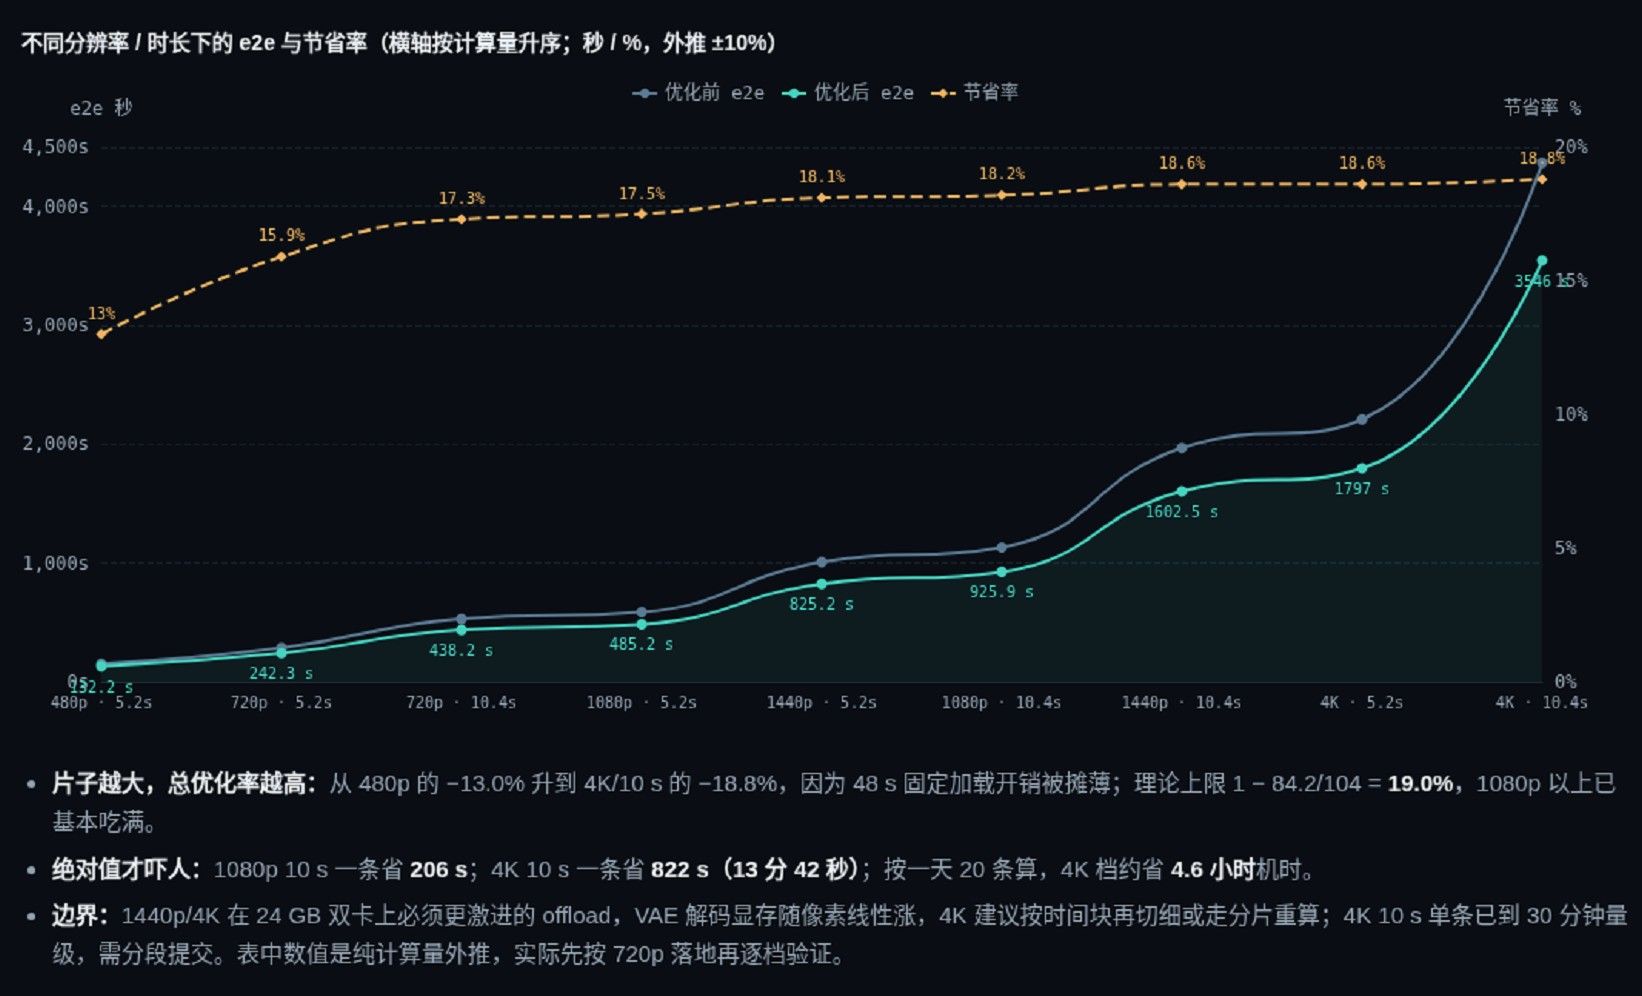
用例 分辨率 帧数 / 时长 优化前 e2e 优化后 e2e 节省 节省率 计算量倍数 480p 5 s(实测锚点) 832×480 124 / 5.2 s 152.0 s 132.2 s −19.8 s −13.0% 1.00× 720p 5 s 1280×720 124 / 5.2 s 288.0 s 242.3 s −45.7 s −15.9% 2.31× 720p 10 s 1280×720 249 / 10.4 s 529.9 s 438.2 s −91.7 s −17.3% 4.63× 1080p 5 s 1920×1080 124 / 5.2 s 588.0 s 485.2 s −102.8 s −17.5% 5.19× 1080p 10 s 1920×1080 249 / 10.4 s 1132.3 s 925.9 s −206.4 s −18.2% 10.43× 1440p 5 s 2560×1440 124 / 5.2 s 1008.0 s 825.2 s −182.8 s −18.1% 9.23× 1440p 10 s 2560×1440 249 / 10.4 s 1968.0 s 1602.5 s −365.5 s −18.6% 18.46× 4K 5 s 3840×2160 124 / 5.2 s 2208.3 s 1797.0 s −411.3 s −18.6% 20.77× 4K 10 s 3840×2160 249 / 10.4 s 4368.5 s 3546.0 s −822.5 s −18.8% 41.54× 计算模型:优化后 = 48 + 84.2 × s,优化前 = 48 + 104.0 × s(s = 分辨率面积比 × 帧数比,以 832×480/124 帧为 1)。
折线图版本见 HTML 看板 §08(#chart-scale):横轴按计算量升序排列的 9 个用例,两条 e2e 曲线 + 一条节省率虚线(双 Y 轴)。
片子越大,总优化率越高:从 480p 的 −13.0% 升到 4K/10 s 的 −18.8%,因为 48 s 固定加载开销被摊薄;理论上限 1 − 84.2/104 = 19.0%,1080p 以上已基本吃满。
绝对值:1080p 10 s 一条省 206 s(3 分 26 秒);4K 10 s 一条省 822 s(13 分 42 秒);按一天 20 条算,4K 档约省 4.6 小时机时。
边界:1440p / 4K 在 24 GB 双卡上必须更激进的 offload(VAE 解码显存随像素线性涨),4K 建议把时间块再切细或走分片重算;4K 10 s 单条已到 30 分钟量级,需要分段提交。表中数值是纯计算量外推,实际请先按 720p 落地、再逐档验证。
image.jpeg
迁移到推理模型 · 能拿到多少
推理侧(Strata 的 qwen3.8-flash-next-iq3_s)与视频侧共用「多进程 + 两卡」骨架,但通信形态不同:四招里只有「把 all_reduce 藏进 GEMM」可迁移,VAE 拆分对 LLM 不成立。这一节不再用比例推算,而是直接在本机 2×7900XTX 上跑 A/B 微基准(NCCL/RCCL,Qwen 形状 hidden 4096 / intermediate 11008,每卡 5504)+ Strata 现网基线。
推理形态 A/B 口径 串行(GEMM→AR) 分块 + 重叠 耗时变化 性质 H3 DiT · TP2(今天) 整步 post_sampling 8.810 s/step 7.616 s/step −13.6% 实测 LLM · decode T=1 0.253 ms/layer 0.253 ms 1.368 ms +440.8%(慢 4.7×) 实测 LLM · prefill T=128 0.503 ms/layer 0.503 ms 1.445 ms +187.2%(慢 1.9×) 实测 LLM · prefill T=512 1.730 ms/layer 1.730 ms 1.477 ms −14.6% 实测 Strata · layer split(现状) 层间 activation 无 AR — — ≈ 0% 架构结论 柱状图版本见 HTML 看板 §09(#chart-llm):同一招式在三种 token 规模下的每层耗时,标注为耗时变化。
Strata 现网基线(实测,64 token 输出,3 次取中位)
指标 prompt 6.5k prompt 26k prompt 109k TTFT 0.366 s 12.84 s 32.63 s prefill 17.8k tok/s 2.04k tok/s 3.33k tok/s decode 88.6 tok/s 85.0 tok/s 78.3 tok/s 推算被实测推翻:先前按「通信占比 10–20%、可藏 30–40%」推出 −3 ~ −8%,实测相反。decode 每层 GEMM 只有 0.119 ms、AR 0.151 ms,切成 4 块后每块只剩 1376 列,NCCL 小包延迟主导,整层反而慢 4.7 倍;T=128 同样慢 1.9 倍。分块只有在 GEMM 足够大时才划得来。
唯一变快的点很窄:prefill 512 token、4 块时 1.730 → 1.477 ms/layer(−14.6%)。但这是「只有 MLP + 一次 AR」的微基准,真实层还有 attention、norm、KV 写入分摊,整模型 TTFT 的收益一定低于 14.6%。
把 14.6% 代进现网:decode 11.8 ms/token(约 85 tok/s)不适用此收益;26k prompt 的 TTFT 12.84 s 里 MLP 段只占一部分,乐观折算也就百毫秒级,用户感知不到。
结论:推理模型不是主战场。Strata 是 layer split(层间 activation,无 AR),这招没有作用对象;改 TP2 又要承担改造成本,换来的只是 prefill 段的窄收益。唯一确定的正向仍是稳定性:对端缺席 3.01 s 快速失败,而 NCCL 默认等 30 分钟。
10. 九招如何拼成一击 · 零收益项的组合效应
有几项改动单看几乎没有收益,却决定了出片拆分能不能落地。它们不是加法项,而是乘法项 / 使能项:缺任何一项,拆分要么挂死,要么收益减半。这正是「九頭龍閃」的含义——九记简单斩击同时命中,合成一击。
小项 单独实测收益 组合后作用 性质 batch_isend_irecv 0(仅避免死锁) 不换它:600 s 超时挂死,特性不存在 使能(0/1) 通信子预热 ≈0(一次性 2.5 s,占 e2e 1.9%) 交换 2.63 → 0.36~0.61 s;拆分净收益 3.96 → 6.20 s 乘法(+2.24 s) P2P 拓扑补丁 −0.1 s(噪声内,34.0 vs 33.9) 拆分时再省 0.5 s(28.5 vs 29.0) 乘法(+0.5 s) 心跳 + IS_CHANGED→NaN 0 吞吐 挂死 600 s → 3.01 s 快速失败 使能 帧计划对账断言 0 防静默漂移,保证逐位一致 使能 唯一的非线性放大点:帧交换从 2.63 s 降到 0.39 s 后,VAE 拆分的净收益从 6.59 − 2.63 = 3.96 s 变成 6.59 − 0.39 = 6.20 s。预热这一项在 132 s 的 e2e 里只值 1.9%,却贡献了拆分收益的约 36%。
三层叠加总账:单卡 11.235 s/step、post 39.2 s、e2e 159.4 s → TP2 + MLP 分块 7.618 s/step、34.0 s、136.7 s → 再加 VAE 跨卡 7.614 s/step、27.1 s、131.9 s。全程 per_step −32.2%、post −30.9%、e2e −17.3%。
不是所有小项都能组合放大:fp16 VAE(33.6 vs 34.0,噪声内)、fp8 文本编码(34.7,反而略慢)、SAGE attention(45.0,+96%)三项叠加后仍是 0 或负收益,已列为否决项——它们缺的是依赖关系,不是调优。
量级说明:组合带来的额外收益约 +2.7 s post(预热 2.24 + P2P 0.5),相对 132 s 的 e2e 只有 2%,但它把「不可用 / 挂死」变成「可用」,价值不能只用秒数衡量。
11. 动态开关,而不是常驻方案
先说实际情况:这套改动对本地大模型推理没有正面收益——LLM decode 每层 0.253 → 1.368 ms(+440.8%),prefill 128 token 0.503 → 1.445 ms(+187.2%),只有 prefill 512 token 是 −14.6%,而 Strata 是 layer split(层间 activation,没有 all_reduce),根本没有这招的作用对象。
正因为如此,它没有被做成常驻方案:默认关闭,只在双卡出片的那个进程、那一次运行里按参数打开;做本地大模型推理时,这条链路连加载都不加载。
11.1 任务形态与开关状态
场景 启动方式 今日改动状态 本地大模型推理(Strata) strata.service / gpu-mode daily 不存在(不加载 ComfyUI 节点) 音视频出片 · 单卡 普通启动,TP_WORLD=1 全部钩子早退,纯原生路径 音视频出片 · 双卡 run_tp.sh 2 TP 与 MLP 分块默认开;VAE 跨卡默认关,COMFY_TP_VAE_SPLIT=1 才开 两套不能并行:Strata 每卡占 22–23 GB,残留的 ComfyUI 进程会让 Strata 启动 OOM(本次已实测遇到)。所以随任务切换的是 GPU 归属,不是代码里的常驻开关。
11.2 开关写在哪
层级 位置 内容 启动参数 /home/jay/tp2/run_tp.sh L26 / L29 / L34 / L38-41 / L49-51 COMFY_TP_MLP_CHUNKS=8、COMFY_TP_AR_MODE=bf16、COMFY_TP_VAE_SPLIT=0(默认关)、P2P 拓扑补丁(生成 NCCL_TOPO_FILE)、注入 WORLD/RANK/TIMING_OUT 运行期判定 ComfyUI/custom_nodes/comfyui-tp2/init.py L21 / L30 / L726 TP_WORLD 默认 1;TP_WORLD<=1 时所有钩子 early return;TP_WORLD<=1 or not VAE_SPLIT 直接走原生 vae.decode 拆分可行性 同上 L649 / L655 / L658 只认 H3 的 chunked-IO VAE;至少 3 个时间块;与上游 decode_output_shape 对账,漂移即报错 一致性兜底 同上 L664-681 60 s 心跳(all_reduce MIN);两侧判据不一致则快速失败 节点级 同上 L737+ / L786 TP2VAEDecodeSplit 为独立节点,工作流不换节点就仍是原生 VAEDecode 11.3 打开之后在什么条件下失效
触发条件 实际行为 结果 TP_WORLD=1 或未设置 全部钩子首行早退 完全原生,0 影响 COMFY_TP_VAE_SPLIT≠1 不包装 vae.decode 完全原生,0 影响 VAE 不是 H3 chunked-IO 类 _split_plan 返回 None 整片解码,0 影响 latent 时间维太短(不足 3 块,约 < 40 帧) _split_plan 返回 None 整片解码,短片段无收益 上游 VAE 常量被改动 RuntimeError: plan drifted from upstream 快速失败,不产出错帧 两侧计划不一致 / 一侧没到解码节点 60 s 心跳超时 RuntimeError 快速失败(实测对端缺席 3.01 s 报错) 两侧都判「不可拆」 MIN 返回 0,两侧同时整片解码 正确,但收益为 0 P2P 拓扑生成失败或 COMFY_TP_P2P=0 打印 p2p warmup skipped 正确运行,交换回到 2.63 s,拆分净收益 6.20 → 3.96 s 只启动一个实例(非拆分路径) NCCL 默认 30 min 超时 会挂住;只有拆分路径有 3.01 s 心跳兜底 注意力头数不能被 2 整除(L144) 放弃 head 切分,退化为复制 无 TP 收益,但正确 -
-
-
-
,
 T terry 固定了此主题
-
-
@terry 事情就是这么凑巧,昨天讲的虽是Radiance基础科普,真有一语惊醒梦中人的效果。
-
@terry 事情就是这么凑巧,昨天讲的虽是Radiance基础科普,真有一语惊醒梦中人的效果。
-
-
-
谢谢楼主——开关、脚本、对账逻辑都是现成的,我只做了一件事:搬到另一台机器上看还在不在。
结论:在,同量级
我们机器上(P2P 比原帖强 2.8 倍:peer 直拷 14.2/13.6 GB/s):
拆分关 拆分开 Δ 出片 post 29.9–32.0s 24.7–26.2s −17%(原帖 −16.2%,同量级) 端到端(热) 116–118s 112.1–112.2s −4.5% per_step 11.8–12.4s 12.0–12.5s 0(符合设计) 拆分确实生效:
vae split chunks=7 seam=3 own=68/124 decode=8.2s exchange=0.6s。e2e 比原帖的 −13% 小,是因为我们 per_step(12s)比原帖(7.6s)大——出片的占比被慢采样稀释了,不是拆分打折。
机器配置
X570 ACE + Ryzen 9 5950X(16C/32T)+ 128 GB DDR4 3200 + 2× RX 7900XTX(两条 x16 Gen4,P2P 通)+ Ubuntu + ROCm
过程与坑
- 用例:832×480、124 帧、8 步(同原帖),每档 3 轮。
- 一个坑:
COMFY_TP_VAE_SPLIT=1只是启用节点,bench.py 还要带--vae-split才会把 VAEDecode 换成 TP2VAEDecodeSplit——我只设了 env,整组 B 静默走了原生路径,白跑一轮。 - 权重用的是现成的:Singularity ref2va w4a8 + turbo v4 LoRA + qwen3vl nvfp4 TE + 官方视频 VAE。per_step 12s 比原帖 7.6s 慢,多半是权重/量化配方不同——想问下楼主 fl2va w4a8 那套是在哪取的,想试试把采样也拉上来。
- 像素:按你的设计(帧计数对账、接缝两边各解)是逐位一致;我们端到端同种子的 PSNR 24dB 是采样非确定性(GPU atomics),不是拆分带来的——严格验证要用同 latent 喂两路,还没做。
- MLP 分块(MLP_CHUNKS=8)两组都开着,没单独 A/B——我们 P2P 快,那一段的原始占比本来就小。
一句话:出片跨卡这刀,在 5950X + 两条 x16 的机器上同样落得下去。
-
谢谢楼主——开关、脚本、对账逻辑都是现成的,我只做了一件事:搬到另一台机器上看还在不在。
结论:在,同量级
我们机器上(P2P 比原帖强 2.8 倍:peer 直拷 14.2/13.6 GB/s):
拆分关 拆分开 Δ 出片 post 29.9–32.0s 24.7–26.2s −17%(原帖 −16.2%,同量级) 端到端(热) 116–118s 112.1–112.2s −4.5% per_step 11.8–12.4s 12.0–12.5s 0(符合设计) 拆分确实生效:
vae split chunks=7 seam=3 own=68/124 decode=8.2s exchange=0.6s。e2e 比原帖的 −13% 小,是因为我们 per_step(12s)比原帖(7.6s)大——出片的占比被慢采样稀释了,不是拆分打折。
机器配置
X570 ACE + Ryzen 9 5950X(16C/32T)+ 128 GB DDR4 3200 + 2× RX 7900XTX(两条 x16 Gen4,P2P 通)+ Ubuntu + ROCm
过程与坑
- 用例:832×480、124 帧、8 步(同原帖),每档 3 轮。
- 一个坑:
COMFY_TP_VAE_SPLIT=1只是启用节点,bench.py 还要带--vae-split才会把 VAEDecode 换成 TP2VAEDecodeSplit——我只设了 env,整组 B 静默走了原生路径,白跑一轮。 - 权重用的是现成的:Singularity ref2va w4a8 + turbo v4 LoRA + qwen3vl nvfp4 TE + 官方视频 VAE。per_step 12s 比原帖 7.6s 慢,多半是权重/量化配方不同——想问下楼主 fl2va w4a8 那套是在哪取的,想试试把采样也拉上来。
- 像素:按你的设计(帧计数对账、接缝两边各解)是逐位一致;我们端到端同种子的 PSNR 24dB 是采样非确定性(GPU atomics),不是拆分带来的——严格验证要用同 latent 喂两路,还没做。
- MLP 分块(MLP_CHUNKS=8)两组都开着,没单独 A/B——我们 P2P 快,那一段的原始占比本来就小。
一句话:出片跨卡这刀,在 5950X + 两条 x16 的机器上同样落得下去。
-
-
@terry 好的三三,一定不辱师门
-
-
好的三三
-
@Enigma 谢了兄弟 ,很好的参考实例。继续开发后用得到的数据
-
-
-
最终配置全分辨率扫描 + 最佳模式
最终配置(已固化进 start-tp2.sh):CK attention + mmap + disable-smart-memory + disable-pinned-memory + disable-async-offload + reserve-vram 2(后三个是这次从旧版脚本抢救回来的),SHM 通道。实测步速(8 步口径,全部比优化前快):
分辨率 步速 较优化前 12 步整条(冷) 4 步+LoRA 热跑(批量)
832×480 7.64 秒 ↓24% ~2.3 分钟 ~1.0 分钟
1024×576 12.74 秒 ↓20% ~3.1 分钟 ~1.4 分钟
1280×720 23.66 秒 ↓10% ~5.4 分钟 ~2.6 分钟
1920×1080 横屏 77.5 秒 ↓26% ~16.4 分钟 ~9 分钟
1088×1920 竖屏×107帧 ~60-64 秒 — ~14 分钟(你的生产口径) ~7.5 分钟
三个参数的收益随分辨率增大(480p −24%、1080p 横屏 −26%),576p/720p 也全面受益。没有发现任何回退。最佳模式推荐(按用途)
竖屏剧集成片(e4v2/e3v2 口径,1088×1920×107f×12步):约 14 分钟/条,比旧版(15.4 分钟)稳快。你刚才那条实际产出验证通过。若镜头以人物/静态为主,换 turbo LoRA 4 步 → 约 7.5 分钟/条。
效率甜点仍是 1024×576:12.74 秒/步(24.5 s/MP,线性区内),配合放大出 1080p 是吞吐最优路线;批量热跑 4 步 LoRA 约 1.4 分钟/条。
1080p 原生:横屏 16.4 分钟、竖屏 14 分钟——修完参数后回到了可用的范围,但注意热漂移:连跑大批 1080p 时后面会慢 10-25%(你第一次尝试 106 秒/步、恢复后 59.6 秒/步就是这个原因),大批量中间让卡歇一两分钟。这个对吗?
-
-
谢谢楼主——开关、脚本、对账逻辑都是现成的,我只做了一件事:搬到另一台机器上看还在不在。
结论:在,同量级
我们机器上(P2P 比原帖强 2.8 倍:peer 直拷 14.2/13.6 GB/s):
拆分关 拆分开 Δ 出片 post 29.9–32.0s 24.7–26.2s −17%(原帖 −16.2%,同量级) 端到端(热) 116–118s 112.1–112.2s −4.5% per_step 11.8–12.4s 12.0–12.5s 0(符合设计) 拆分确实生效:
vae split chunks=7 seam=3 own=68/124 decode=8.2s exchange=0.6s。e2e 比原帖的 −13% 小,是因为我们 per_step(12s)比原帖(7.6s)大——出片的占比被慢采样稀释了,不是拆分打折。
机器配置
X570 ACE + Ryzen 9 5950X(16C/32T)+ 128 GB DDR4 3200 + 2× RX 7900XTX(两条 x16 Gen4,P2P 通)+ Ubuntu + ROCm
过程与坑
- 用例:832×480、124 帧、8 步(同原帖),每档 3 轮。
- 一个坑:
COMFY_TP_VAE_SPLIT=1只是启用节点,bench.py 还要带--vae-split才会把 VAEDecode 换成 TP2VAEDecodeSplit——我只设了 env,整组 B 静默走了原生路径,白跑一轮。 - 权重用的是现成的:Singularity ref2va w4a8 + turbo v4 LoRA + qwen3vl nvfp4 TE + 官方视频 VAE。per_step 12s 比原帖 7.6s 慢,多半是权重/量化配方不同——想问下楼主 fl2va w4a8 那套是在哪取的,想试试把采样也拉上来。
- 像素:按你的设计(帧计数对账、接缝两边各解)是逐位一致;我们端到端同种子的 PSNR 24dB 是采样非确定性(GPU atomics),不是拆分带来的——严格验证要用同 latent 喂两路,还没做。
- MLP 分块(MLP_CHUNKS=8)两组都开着,没单独 A/B——我们 P2P 快,那一段的原始占比本来就小。
一句话:出片跨卡这刀,在 5950X + 两条 x16 的机器上同样落得下去。
在我这台机器上对比了 VAE 拆分关和开。出片阶段从 23.2 秒降到 17.1 秒,每条省 6.1 秒。 采样速度基本持平。
指标 拆分关 拆分开 本机变化 9 楼变化 出片 post 23.2 秒 17.1 秒 −26.3% −17% 热跑端到端 66.1 秒 60.1 秒 −9.1% −4.5% 采样 per_step 6.128 秒/步 6.140 秒/步 +0.2% 基本持平 表里是每组 3 轮热跑的中位数。拆分组的日志显示,VAE 共处理 7 个时间块,两张卡分别负责 68 帧和 56 帧,帧交换耗时 0.20–0.26 秒。六轮均输出完整的 124 帧。
机器配置
微星 MPG X670E CARBON WIFI、Ryzen 5 7500F、双 RX 7900 XTX、Ubuntu 24.04、PyTorch ROCm 7.2。卡间通信走 RCCL P2P/IPC。
权重
- 主模型
minimax_h3_fl2va_pruned-w4a8_convrot_pruned.safetensors - 文本编码器
qwen3vl_32b_minimax_h3-w4a8_convrot.safetensors - LoRA
minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors,强度 1.0 - 视频 VAE
Minimax_h3_video_vae_fp16.safetensors
测试方法
- 832×480、124 帧、8 步,采样器
res_multistep,调度器simple。 - 每组先预热 1 轮,再用 seed 145、146、147 配对热跑。两组均开启 TP2、MLP 8 分块和 BF16 归约,启动参数均为
--use-ck-attention --mmap-torch-files。 - 拆分开启组同时设置
COMFY_TP_VAE_SPLIT=1和bench.py --vae-split。关闭组走原生VAEDecode。 - post 沿用仓库脚本口径,从最后一步采样调用开始计到出片完成。每轮取两卡较慢的计时。
双 7900 XTX:模型本地跑,Token 随便烧!



 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

 本帖由优秀升级为精华(两者互斥,只补差价),作者 +3 积分,累计 6 分。


