256G/512G大内存跑LLM划算吗?128G DDR3为什么是黄金容量?DDR3/4/5 & PCIE3/4/5对性能影响明显,DDR5+PCIE5的体验才会好起来!
-
论坛呢有不少网友都是发表了自己用大内存跑这个AI大模型,然后显卡可能说稍微低配一点,就是没有必要那么夸张。但是呢有人就问这个512G还有256G怎么选?其实我说实话啊,就我们论坛的这个超级版主Williams啊,他已经给出了结论,就是分为128G或者512G两档。就如果说你的目标是跑这个什么DeepSeek V4.1 Flash,你256G内存肯定是不行的啊。256G内存你只能跑这个什么IQ4量化的版本。IQ4量化的版本,我跟这个ChatGPT聊天,它说如果是跑这个通用任务,它的精度肯定要差很多。但是如果只是用来搞这个编程,还有这个agent,它也是够用的。不过有些复杂推理中,它可能会崩,精度会崩。你想一想,你花个256G去搞一个大模型,啊你本身的成本也是不低的。哪怕你是用华南金牌的这个什么X99-T8,你插8根32G的DDR3条子,是吧,它本身也不便宜。当然了,它也不贵啊,就是说可以负担。但是呢,就是你跑起来这个DeepSeek,本身的效果是不怎么样的,啊就是量化比较严重,精度损失比较大。然后它的速度,我们这边论坛实测是这个20不到,那这个就没有什么实用性。是吧,就是256G内存本身就比较尴尬。
如果说你是有128G的这个内存,你就搭配一张7900 XTX,或者搭配两张,或者两张V100,是吧,两张2080 Ti都可以。你跑这个什么大模型的速度,包括这个跑ComfyUI的速度都是可以接受的。当然了,V100可能稍差一点啊。这个如果是V100 32G,我们论坛也有帖子,就是有些LoRA不支持,其它的也还能将就。就是128G它是个非常甜点的配置。呃,128G的DDR3 1866的条子是1千出头,然后这个板U套装大概,你买到贵的就是X99-TF了,是吧,或者说是这个精粤的叫什么TI D3 Plus,是吧?你便宜的可能说五六百就搞定啊,贵的大概七八百、八九百。这就两千块钱,是吧?其它的一些东西随便搭配一下,它也花不了几个钱。它比显卡是便宜多了,那么这个方案就非常值得玩。
你跑这个什么千问Flash Next,它这个治理是比这个DeepSeek V4.1 Flash要差一点啊。但是你本地,你说大模型,一般我们有这个复杂的任务肯定是交给这个在线API来完成。那么本地大模型只有在在线API不能用、掉线的时候,或者说我们有抗审查需求的时候,比如说我们要创作剧本,害怕这个自己的创意泄露,那在这种情况下,千问3.8 Flash Next是绝对可以满足你创作需求的。就没有必要去强上DeepSeek V4.1 Flash,是吧?它现在毕竟是550B模型,还要外挂什么N-gram知识表,这尺寸还是非常惊人的。就再怎么量化,呃你256G的内存跑起来都不大好。
当然了,这位哥们他是DDR4的平台。你说DDR4能不能提升?啊,是能的。之前这个DeepSeek V4.1 Flash,包括这个V4刚出来的时候,我们论坛有朋友用这个1T的DDR4内存来跑。嗯,他那个好像是通道数也比较高,然后带宽也比较高,但是最后得出来的结论是不行,就他DDR4还是有瓶颈,你起码还是要上DDR5,上这个什么PCIe 5.0这个接口。哦,他当时跑的架构是FastLLM,我们国产的啊。就是总之tokens是非常的低。或者有人也用这个什么KTransformers,好像用这个架构跑过,都不大好。现在这个Strata进步之后呢,它有一个工程叫做Project Maya,是Strata的一个分支。啊,大家用它来跑这个什么MoE大模型效率是比较高的。我们论坛有朋友,他是内存是64G,比较低了啊,但是他是上的两张RTX Pro 6000,两张显存就是这个192G,加上内存刚好是256G。
他跑这个什么GLM 5.3 Flash,用这个Project Maya跑速度就非常的不错,然后IQ3S的这个权重,他的体验是比较好了。就大家可以来看看编号2882啊,Lunar Moon,农历月亮吗?这么爱国吗?绿色,绿色。用这个东西来测试,大家可以去看一下它的这个具体的效果。它decode的速度能够达到130左右,其实非常不错了啊。然后预填充啊各方面,包括长上下文的这个测试,这个也算不了长上下文了,这个也是中等长度的上下文。它这个GLM 5.3 Flash,它是300B左右的这个模型啊,它跟那个什么DeepSeek V4 Flash是一个档次的,就是它比这个什么DeepSeek V4 Flash要小很多,小一半。这个东西说只能做做这个参考了。就是我是建议啊,大家没有必要去强上256G内存。你看别人才用了64G,你就买好一点的卡,是吧?因为DDR3这个平台是比较尴尬的,我个人认为意义不大。
那么如果说你上到DDR5平台、PCIe 5.0,哦,那这个带宽又翻倍了,那它意义就完全不一样了。它这个MoE模型在这个专家加载和卸载的时候速度会翻倍,那么它基本上就没有什么瓶颈了。这个速度的提升我认为可能都不只是相比于DDR3、PCIe 3.0都不只是4倍的问题了,因为它这个木桶效应,一旦最低的短板解决,那可能要提升10倍以上,那效果可能就好得多了。
也就是说,如果说你有这个新的平台,你是DDR5平台的,你上个什么512G,然后搭配两张还不错的显卡,是吧?比如说你这个RTX Pro 4500 32G的,是吧?或者是AI Pro R9700,也是32G的,是吧?你搭配两张来跑这个DeepSeek V4.1 Flash,它的热门专家放到这个显卡中去,放到显存中去,然后冷门专家放到内存中去,这个就完全不会触碰到这个SSD了,就是两级缓存,它的效率是非常高的,应该可以非常轻松地跑起来,而且它的速度、并发量都不会差。可是你要知道,512G的这个DDR5内存,我操,这个价格你想一想,是吧?这不便宜啊,这金子一样的价格,真的没有必要。你就算在本地部署起了这个DeepSeek V4.1 Flash,你又如何呢?是吧?可能最后你的性价比还不如用这个什么4个DGX Spark,是吧,或者3个DGX Spark,你去跑这个DeepSeek V4.1 Flash的官方原版,说不定效果还更好一点,是吧?4个Spark还小巧玲珑,是吧?打用个什么3D打印搞个架子。哎,我们论坛不是有老哥说要发这个作业的吗?怎么到现在没发,跳票了?
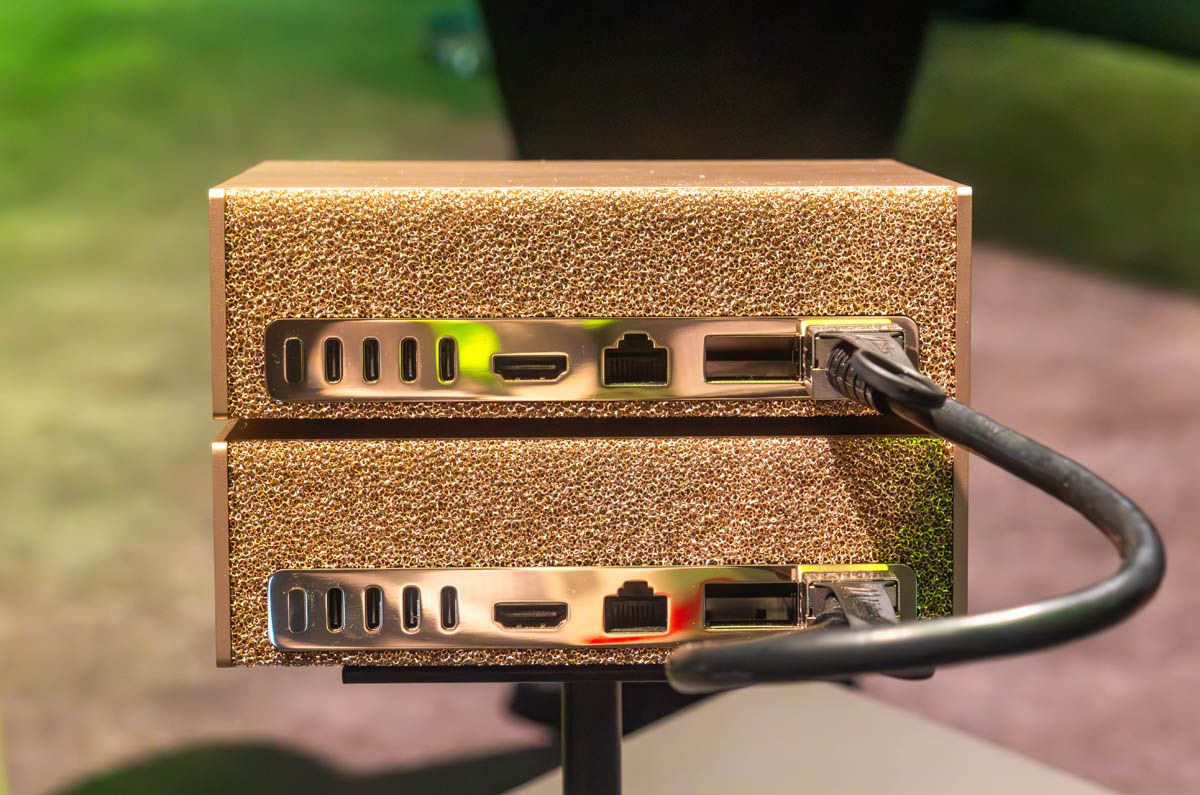
就大内存跑大模型,我们版主给的这个建议我是比较认同的啊,就两个档次:第一,DDR3的128G就够。你只要是四通道的内存,是吧?你这个算力上没有什么木桶效应的短板,你跑这个Qwen 3.8 Flash Next,在我们论坛能跑出非常高的数据啊,就是你什么decode的速度超过100多tokens,那是轻轻松松的事。然后你长上下文,是吧,这个多会话都是没有问题的。要么你就咬咬牙,上这个512G的DDR5,那你能跑很多模型。或者说你256G的DDR5,我认为意义也是比较大的。那中间的,你这种中不溜的,你上个什么256G的DDR4或者512G的DDR4,我觉得体验不会好到哪去。当然了,手中有这样的资源,你可以去尝试一下。啊,反正呢,根据论坛已经跑出来的实测结果,我对这个是比较悲观的。
就我们之前在视频中我是多次讲过,呃,跑MoE模型,现在这个Strata架构它兴起之后,它其实有很多类似的这种架构,是吧?其它的一些,包括说我们可能说这一轮革命一开始好像还不是开源的那个叫什么Strix Halo,从那个架构开始的,然后慢慢也包括什么NInfer了这些新的架构,然后慢慢有后面的这些什么GUFO,然后Strata,是吧?也包括最近比较牛逼的这个Radiance。他们现在可能说在效率上面比早年用这个FastLLM要强不少,但是它突破不了物理瓶颈嘛。就三个瓶颈嘛:第一就是内存带宽的瓶颈;第二,PCIe,你是3.0、4.0还是5.0,PCIe带宽的瓶颈;第三就是你这个显存,你内部这个显卡的显存和带宽,是吧?这也是一个瓶颈。你这几个瓶颈决定了跑MoE模型时候的这个交互效率,然后你的显卡本身的算力还得在线,就基础算力得在线。
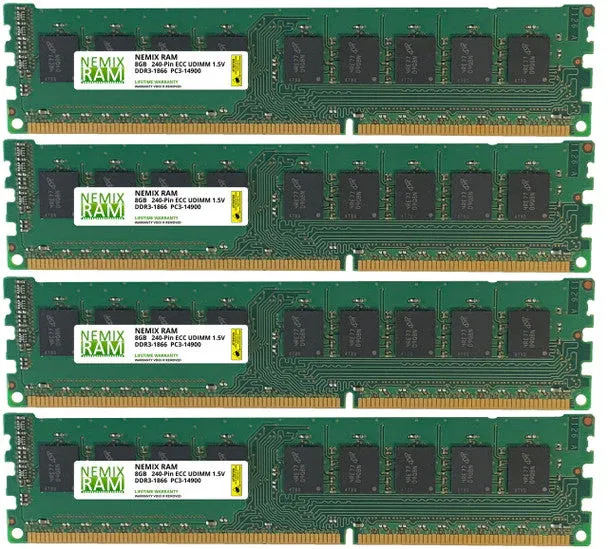
就说从这个经验角度来讲的话,我是建议大家直接上128G的DDR3就够了啊,就跑个千问Flash Next,这个模型智力是在线的啊,马上4.0家族出来,是吧?而且你还可以跑这个千问27B的嘛,是不是这个在本地是足够用了?没有必要去好高骛远。你想提高一点要求,想拔高,那你要付出的代价可能是10倍以上,完全不值得。你可能提高了15%的性能,是吧?结果付出了1,000%的这个代价,呃,完全不值得啊。
-
-
同意哈!现阶段花4、5千上128G DDR4真有点49年入国军的感觉,再翻个倍上128G DDR5那绝对觉对是被门夹了。最近因为双卡、多卡测试,去看了多PCI-E4.0的主板,真心肉疼,撕裂者系列板U系列,华南寨板都敢涨价,二手就不说了。X99老系列也就DDR3还剩点性价比了。我3090 DDR5 128g strata Q4,比7900xtx DDR4 128G也就快10-15tok/s,IQ3快30-40,不过实用性不高,我基本都起的Q4, Q4模型8-32K两者输出差距不到10tok/s,长上下文DDR5 ultra 265才占优。
所以现在都单机单卡,agent调用还有冗余。双卡感觉还得等等新价格新优化。内存128真心甜点,strata架构96G更适合。 -
结尾的性价比。15:1000性价比很实在。当公益告示吧。
目前首要策略榨干手头硬件。
重点注意杠杆盘制高点入手。
入手和2026加入国军没啥区别了!尤其是NV。Intel慎入。AMD仁者见仁智者见智。 -
在马来西亚,虽然华南寨板的价格都已经赶得上我原本的第12代板了。。。但是我还是强烈推荐ddr3 系列,毕竟xeon的核心数目和4通道,可以比肩intel 12代和ddr4双通道,加上strata 极度吃重cpu多核心,这个也是重点考虑对象