跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 16G 5070Ti把用Strata的flash next换成Basalt,实测快1.4倍!白拿的性能!

16G 5070Ti把用Strata的flash next换成Basalt,实测快1.4倍!白拿的性能!

已定时 固定直到 2026/11/9 23:38 已锁定 已移动 优秀 LLM讨论区
rtx5070strataqwen-flash
20 帖子 7 发布者 802 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • fcmeF
    fcmeF
    fcme
    王侯将相
    编写于 最后由 编辑
    #7

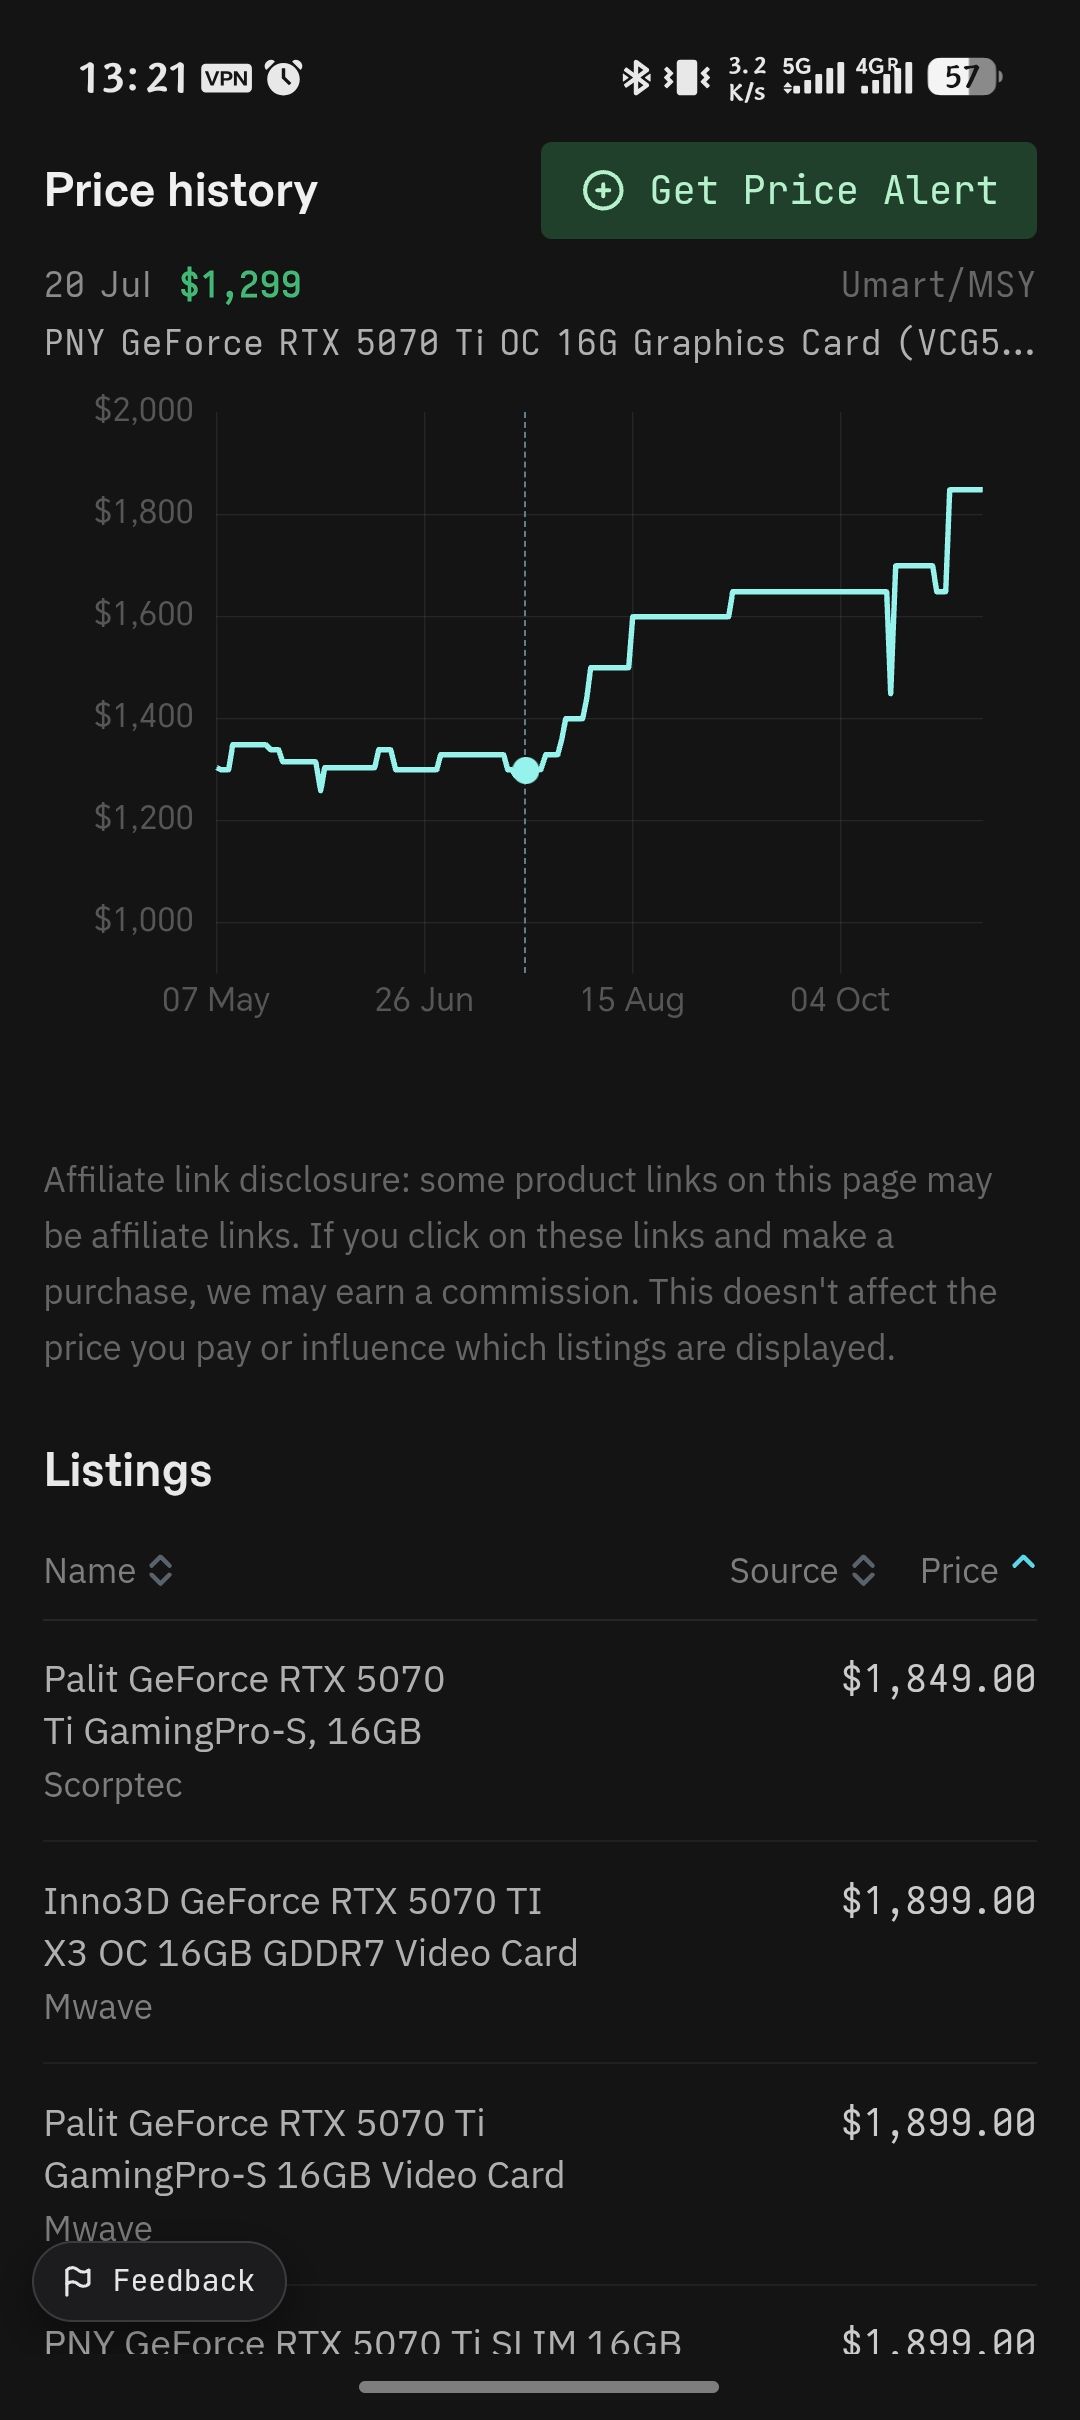
    现在tmd就没有不涨的卡!

    单位澳元,汇率大概4.7左右。
    Screenshot_20261107_132137_com_android_chrome_ChromeTabbedActivity.jpg

    个人的repo,欢迎指教
    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

    kos orK 2 条回复 最后回复
    3
    • fcmeF fcme

      现在tmd就没有不涨的卡!

      单位澳元,汇率大概4.7左右。
      Screenshot_20261107_132137_com_android_chrome_ChromeTabbedActivity.jpg

      kos orK
      kos orK
      kos or
      至尊皇帝
      编写于 最后由 编辑
      #8

      @fcme

      5070 Ti 這可能是舊庫存的價格
      新庫存已經上調大約$200美元

      聽說3060 12GB 漲了一倍

      顯卡集團真是賺翻了

      1 条回复 最后回复
      0
      • fcmeF fcme

        现在tmd就没有不涨的卡!

        单位澳元,汇率大概4.7左右。
        Screenshot_20261107_132137_com_android_chrome_ChromeTabbedActivity.jpg

        kos orK
        kos orK
        kos or
        至尊皇帝
        编写于 最后由 编辑
        #9

        @fcme said:

        现在tmd就没有不涨的卡!

        無法理解 3090 這種用了多年的礦卡
        7900 XTX 這種老卡
        還會漲價?

        fcmeF 1 条回复 最后回复
        0
        • fcmeF fcme

          @kos-or
          确实我也不太相信能生生暴涨2倍这么多,实际虽然没到也是很香了。
          当然限制在我的CPU和PCIe都太老了😂

          kos orK
          kos orK
          kos or
          至尊皇帝
          编写于 最后由 编辑
          #10

          @fcme said:

          当然限制在我的CPU和PCIe都太老了

          你喔 就萬事俱備

          只欠東風 😳

          東風一來 火力全開 🤗

          1 条回复 最后回复
          0
          • imbiplaza ASUSI
            imbiplaza ASUSI
            imbiplaza ASUS
            谪仙人
            编写于 最后由 编辑
            #11

            The Intel® Xeon® Gold 6252 Processor
            • Cores and Threads: 24 cores and 48 threads

            看来还是超多核心才会有的效果,我想升级xeon了

            fcmeF 1 条回复 最后回复
            0
            • kos orK kos or

              @fcme said:

              现在tmd就没有不涨的卡!

              無法理解 3090 這種用了多年的礦卡
              7900 XTX 這種老卡
              還會漲價?

              fcmeF
              fcmeF
              fcme
              王侯将相
              编写于 最后由 编辑
              #12

              @kos-or
              离谱的时代,哎

              个人的repo,欢迎指教
              https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
              https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

              1 条回复 最后回复
              1
              • imbiplaza ASUSI imbiplaza ASUS

                The Intel® Xeon® Gold 6252 Processor
                • Cores and Threads: 24 cores and 48 threads

                看来还是超多核心才会有的效果,我想升级xeon了

                fcmeF
                fcmeF
                fcme
                王侯将相
                编写于 最后由 编辑
                #13

                @imbiplaza-ASUS
                主要是CPU支持的AI加速指令集要到位

                个人的repo,欢迎指教
                https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                imbiplaza ASUSI 1 条回复 最后回复
                1
                • fcmeF fcme

                  @imbiplaza-ASUS
                  主要是CPU支持的AI加速指令集要到位

                  imbiplaza ASUSI
                  imbiplaza ASUSI
                  imbiplaza ASUS
                  谪仙人
                  编写于 最后由 编辑
                  #14

                  @fcme

                  等strata 作者不断想办法榨取电脑的资源,然而我也想知道amd 的epyc是不是更好

                  fcmeF 1 条回复 最后回复
                  1
                  • imbiplaza ASUSI imbiplaza ASUS

                    @fcme

                    等strata 作者不断想办法榨取电脑的资源,然而我也想知道amd 的epyc是不是更好

                    fcmeF
                    fcmeF
                    fcme
                    王侯将相
                    编写于 最后由 编辑
                    #15

                    @imbiplaza-ASUS
                    貌似是指令集支持更好些,单CPU的pice通道也更多。我的7820是双CPU,调度比较坑爹,后来就直接把CPU2关了。

                    个人的repo,欢迎指教
                    https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                    1 条回复 最后回复
                    0
                    • XiaoteX
                      XiaoteX
                      Xiaote
                      易有太极
                      编写于 最后由 编辑
                      #16

                      ✅ 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

                      奖励凭证:优秀 +3 分 · 编号 e2892-1686-1

                      老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                      1 条回复 最后回复
                      0
                      • ,terryT terry 固定了此主题
                      • fcmeF fcme

                        背景:一直对Strata的在5070Ti 16G 跑的8030 端口之前跑的Strata 0.2.9(IQ3_XXS,204800 上下文)的速度不太满意,今天突然发现一个青出于蓝而胜于蓝的选项。直接开测。

                        Basalt 是 Strata 的 fork,改动集中在 CPU 调度层:更细的 row-range 任务切分、i-quant 走 AVX-VNNI、单文件 .basalt 格式。社区里常见 2 倍的说法,所以拿同机同模型做了对比。

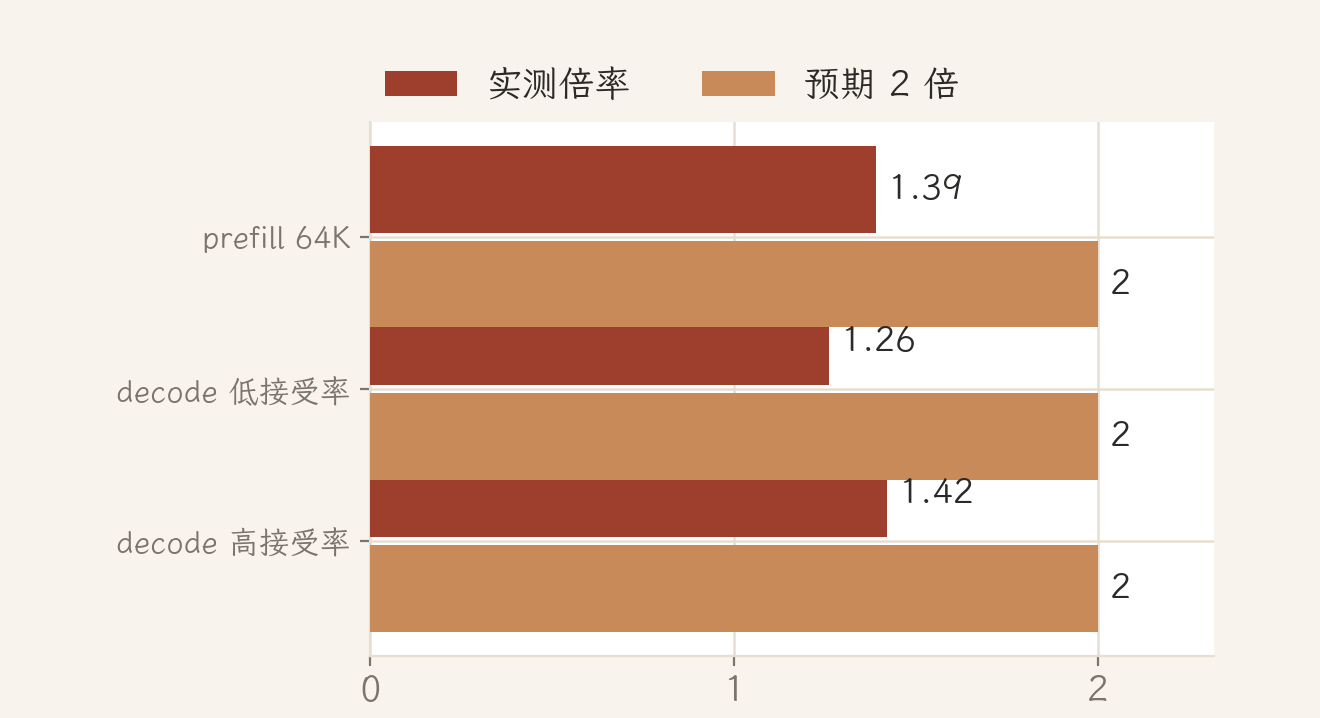
                        结论:确实更快,但没有 2 倍,实测 1.26 到 1.42 倍。
                        chart_compare.png

                        一、前后对比

                        同一台机器、同一个模型(Qwen3.8-Flash-Next GSQ-RCO IQ3_XXS)、同一张卡(250 W 锁功耗),basalt-bench 固定 seed:

                        指标 Strata 0.2.9 Basalt 0.3.0 倍率
                        prefill 64K 1960 tok/s 2725 tok/s 1.39
                        decode(MTP 接受率 65-70%) 58 tok/s 73 tok/s 1.26
                        decode(接受率 97-98%) 104 tok/s 148 tok/s 1.42

                        decode 的差异主要来自 MTP 接受率:接受率高时窗口里挤进更多 token,固定开销被摊薄。两个引擎都是这个规律。

                        二、为什么不是 2 倍

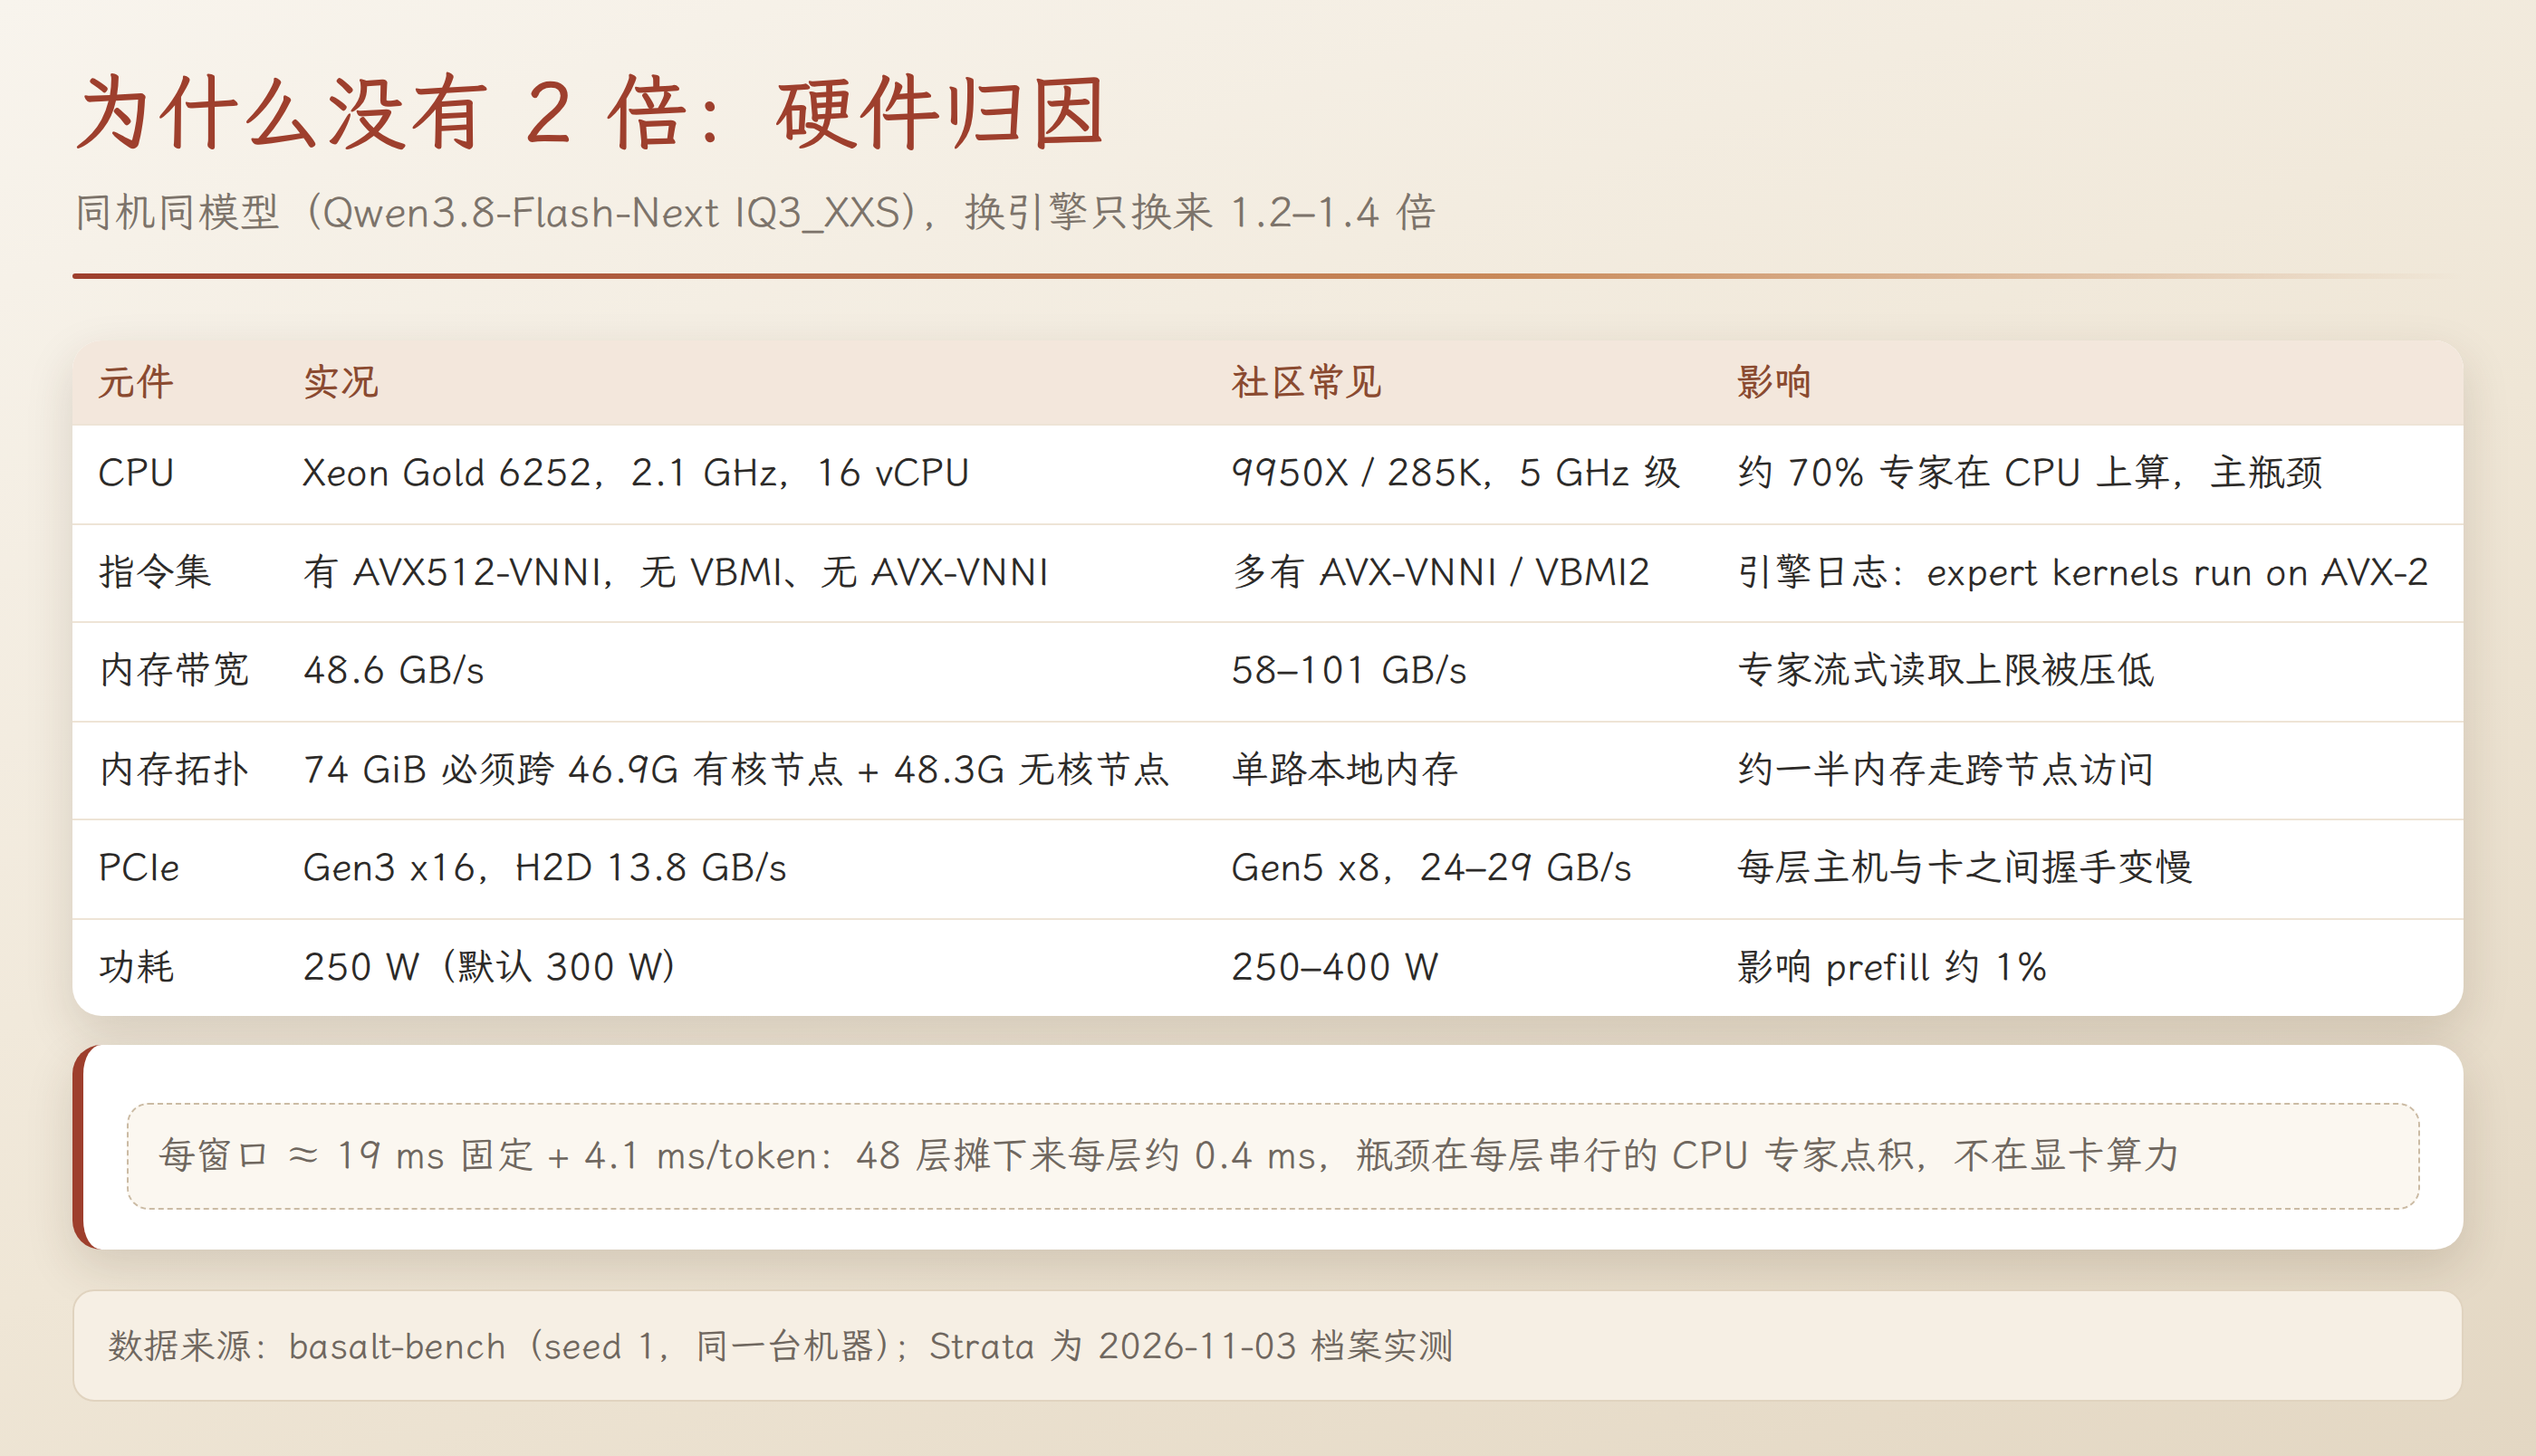
                        社区里 2 倍的数据基本出自 5 GHz、带 AVX-VNNI 的桌面 CPU(9950X、285K 之类)。这台是 Xeon Gold 6252,2019 年的 Cascade Lake,2.1 GHz。
                        card_bottleneck.png

                        从三个 fixture 反推窗口开销,能拟合出:每个 decode 窗口约 19 ms 固定 + 4.1 ms/token。48 层摊下来每层约 0.4 ms,花在 CPU 侧串行的专家点积和主机与卡之间的握手上,不在显卡算力。

                        几个直接证据:

                        • 引擎启动日志自己写了:this CPU has no AVX-512: the expert kernels run on AVX-2。这颗 U 有 AVX512-VNNI,但缺 VBMI/VBMI2,Basalt 判定不可用退回 AVX2;而 AVX-VNNI(VEX 版)它也没有,恰好是 Basalt 重点优化的那条路。
                        • 把显存里的专家数从 6.7 GiB(Strata)提到 13.3 GiB(Basalt),翻了一倍,速度只涨 1.2 到 1.4 倍。瓶颈不在显存。
                        • basalt-bench --hardware 实测:RAM 读 48.6 GB/s,PCIe 3.0 x16、H2D 13.8 GB/s。宿主链路 LnkCap 支持 32 GT/s,LnkSta 只跑 8 GT/s,因为 6252 平台本身就是 PCIe 3.0。
                        • 内存拓扑更隐蔽:宿主 node0 有 46.9 GB(带核),node1 有 48.3 GB 但没有核。虚拟机 74 GiB 必然跨两个节点,约一半内存每次访问都要过跨节点链路。

                        所以这台机器上是两个引擎同时撞同一堵墙:Strata 慢是因为墙,Basalt 也只快在墙内能优化的那部分。

                        三、容器化,损失多少

                        原来是裸进程(systemd),现在跑容器:

                        • 镜像 basalt-5070ti-256k-img:latest,3.05 GB,基于 nvidia/cuda:13.0.0-runtime-ubuntu24.04,只装 python3、jinja2、regex、numpy。
                        • 权重只读挂载,配置只读挂载,状态目录可写。

                        同口径基准:

                        指标 裸进程 容器 差值
                        prefill 64K 2725 2648 -2.8%
                        decode conv 73 72 0%
                        decode struct 148 151 +2%
                        decode prose 72 72 0%

                        基本在噪声里。关键是三个参数别省:--ulimit memlock=-1(否则专家页锁失败退回文件映射,速度直接掉)、--shm-size 给够、不要设 CPU 配额。

                        四、预热和跨对话缓存

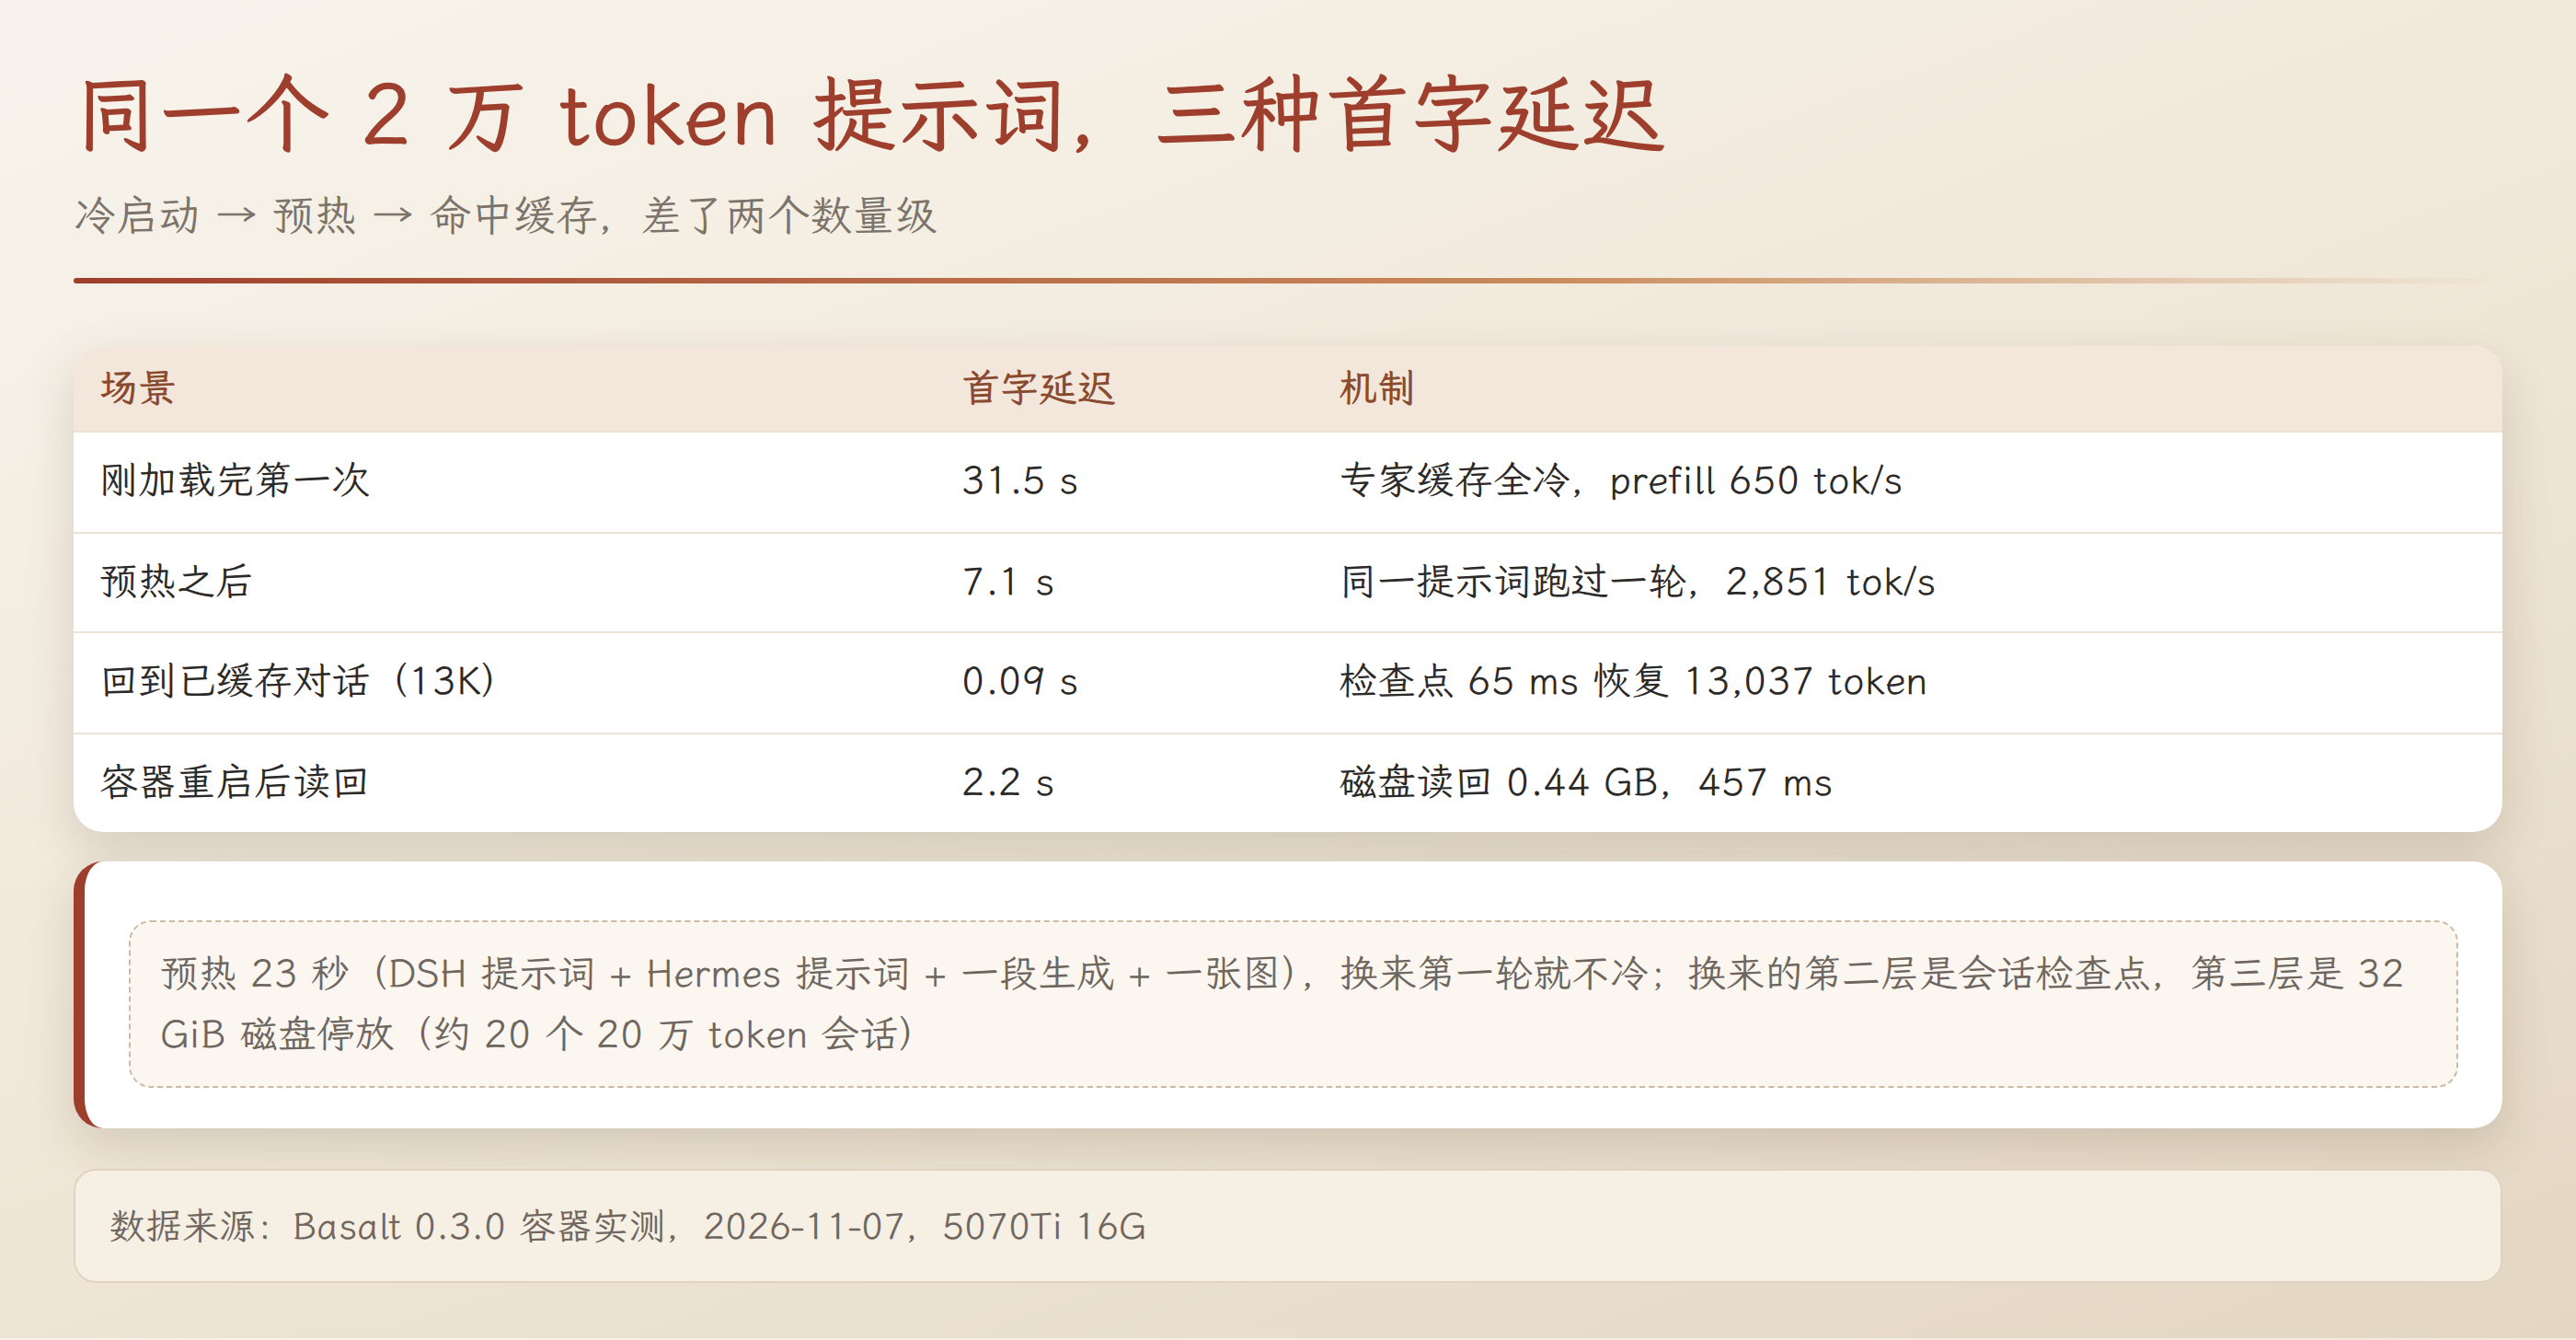
                        容器入口脚本会在模型加载完后自动预热 23 秒:DSH 的系统提示词(7.3K token)、Hermes 的提示词(0.8K)、一段 300 字生成、一张图(识图路径)。都是为了把专家缓存和 MTP 状态跑热。

                        效果是数量级的:
                        card_speedup.png

                        同一个 2 万 token 提示词,冷启动 31.5 秒,预热后 7.1 秒。这解释了「刚启动那几轮为什么慢」——不是配置坏了。

                        第二层是会话检查点:离开再回到同一个对话,日志里是 restored 13037 tokens (checkpoint) in 65.4 ms,同一提示词从 4.3 秒掉到 90 毫秒。

                        第三层是磁盘停放:容器重启后照样能读回,read 13037 tokens from disk in 457.4 ms。实测快照约 8.1 KB/token,一个 19.5 万 token 的会话落盘 1.5 GiB,32 GiB 预算大概放得下 20 个 20 万 token 的会话。

                        五、配置与启动

                        {
                          "version": 2,
                          "models": [{
                            "model": "/models/Qwen3.8-FN-GSQ-RCO-IQ3_XXS.basalt",
                            "alias": "5070Ti-QFNext-iQ3xxs-Basalt",
                            "gpu": "0",
                            "max-context": 262144,
                            "kv": "int8",
                            "vision": "dynamic"
                          }],
                          "engine": {
                            "resident-experts": true,
                            "vram-reserve-mib": 256,
                            "spec": 8,
                            "expert-profile-save": "/state/expert-profile-learned.bin",
                            "conversation-cache-mib": 2048,
                            "conversation-cache-slots": 4,
                            "conversation-cache-min-tokens": 8192,
                            "conversation-cache-disk-mib": 32768,
                            "conversation-cache-dir": "/state/conversations"
                          },
                          "server": { "host": "0.0.0.0", "port": 8030 }
                        }
                        

                        启动:

                        docker run -d --name Basalt-5070ti-256K-img \
                          --gpus "device=0" \
                          --ulimit memlock=-1 \
                          --shm-size=2g \
                          -p 8030:8030 \
                          -v /data/aimodels/basalt:/models:ro \
                          -v /data/basalt-state:/state \
                          -v /data/basalt-state/warmup:/warmup:ro \
                          -v /path/basalt_config.json:/config.json:ro \
                          --restart unless-stopped \
                          basalt-5070ti-256k-img:latest
                        

                        加载 43.8 GiB(显存 13.0 + 内存 30.8),冷启动约 85 秒,262144 上下文可用,识图一张图 1 到 2 秒。

                        参数是实测筛过的,别照抄网上的:kv k8v4 省 23% 的 KV 但 prefill 掉 7%;spec 4 让结构化输出从 148 掉到 133;resident-budget-gib 压到 26 GiB 会触发专家溢写到 SSD,prefill 直接腰斩。256K 上下文相对 66K 的 prefill 只差 0.2%,所以直接拉满。

                        六、容器化踩到的三个坑

                        1. CUDA 版本门槛:镜像标签写着 cuda>=13.5 就要求驱动支持 13.5。这台驱动 580.159.03 报的 CUDA 是 13.0,用 13.5 的 runtime 镜像直接起不来,必须退到 13.0.0-runtime。
                        2. 源码树路径写死:二进制会 chdir 到编译时的源码树,容器里没有那个目录就报 cannot enter the source tree。加一条软链 /home/fcc/build/basalt -> /opt/basalt 即可。
                        3. serve 依赖不全:serve/ 会往 sys.path 塞 tools/,只拷 bin 和 serve 会在 model_file、regex 上炸,记得把 tools/ 一起打进去。

                        七、结语

                        Basalt 本身没问题,它的优势是 CPU 调度和专家管理;问题在于瓶颈会不会被让出来。16G 卡 + 老 Xeon + PCIe 3.0 这套组合,换引擎能拿到 1.2 到 1.4 倍;如果你是新平台(5 GHz + AVX-VNNI + 本地内存),社区那些 2 倍数据应该更接近。

                        仓库:https://github.com/jesdga95/basalt
                        权重:https://huggingface.co/jesdga/Qwen3.8-Flash-Next-Basalt

                        perterP
                        perterP
                        perter
                        王侯将相
                        编写于 最后由 编辑
                        #17

                        @fcme
                        Strata 0.2.12也优化了 DFlash2 ,应用程序和终端的版本是 0.2.12。控制和所有引擎软件包的版本是 0.1.58。UD-IQ4_XS-v31 和 UD-Q4_K_XL 的prefill提高了3倍。

                        fcmeF 1 条回复 最后回复
                        0
                        • perterP perter

                          @fcme
                          Strata 0.2.12也优化了 DFlash2 ,应用程序和终端的版本是 0.2.12。控制和所有引擎软件包的版本是 0.1.58。UD-IQ4_XS-v31 和 UD-Q4_K_XL 的prefill提高了3倍。

                          fcmeF
                          fcmeF
                          fcme
                          王侯将相
                          编写于 最后由 编辑
                          #18

                          @perter
                          我去,这么牛逼的吗?不过我没有用到Q4那个级别。明天再看看,今天太晚了

                          个人的repo,欢迎指教
                          https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                          https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                          1 条回复 最后回复
                          0
                          • fcmeF fcme

                            背景:一直对Strata的在5070Ti 16G 跑的8030 端口之前跑的Strata 0.2.9(IQ3_XXS,204800 上下文)的速度不太满意,今天突然发现一个青出于蓝而胜于蓝的选项。直接开测。

                            Basalt 是 Strata 的 fork,改动集中在 CPU 调度层:更细的 row-range 任务切分、i-quant 走 AVX-VNNI、单文件 .basalt 格式。社区里常见 2 倍的说法,所以拿同机同模型做了对比。

                            结论:确实更快,但没有 2 倍,实测 1.26 到 1.42 倍。

                            chart_compare.png

                            一、前后对比

                            同一台机器、同一个模型(Qwen3.8-Flash-Next GSQ-RCO IQ3_XXS)、同一张卡(250 W 锁功耗),basalt-bench 固定 seed:

                            指标 Strata 0.2.9 Basalt 0.3.0 倍率
                            prefill 64K 1960 tok/s 2725 tok/s 1.39
                            decode(MTP 接受率 65-70%) 58 tok/s 73 tok/s 1.26
                            decode(接受率 97-98%) 104 tok/s 148 tok/s 1.42

                            decode 的差异主要来自 MTP 接受率:接受率高时窗口里挤进更多 token,固定开销被摊薄。两个引擎都是这个规律。

                            二、为什么不是 2 倍

                            社区里 2 倍的数据基本出自 5 GHz、带 AVX-VNNI 的桌面 CPU(9950X、285K 之类)。这台是 Xeon Gold 6252,2019 年的 Cascade Lake,2.1 GHz。

                            card_bottleneck.png

                            从三个 fixture 反推窗口开销,能拟合出:每个 decode 窗口约 19 ms 固定 + 4.1 ms/token。48 层摊下来每层约 0.4 ms,花在 CPU 侧串行的专家点积和主机与卡之间的握手上,不在显卡算力。

                            几个直接证据:

                            • 引擎启动日志自己写了:this CPU has no AVX-512: the expert kernels run on AVX-2。这颗 U 有 AVX512-VNNI,但缺 VBMI/VBMI2,Basalt 判定不可用退回 AVX2;而 AVX-VNNI(VEX 版)它也没有,恰好是 Basalt 重点优化的那条路。
                            • 把显存里的专家数从 6.7 GiB(Strata)提到 13.3 GiB(Basalt),翻了一倍,速度只涨 1.2 到 1.4 倍。瓶颈不在显存。
                            • basalt-bench --hardware 实测:RAM 读 48.6 GB/s,PCIe 3.0 x16、H2D 13.8 GB/s。宿主链路 LnkCap 支持 32 GT/s,LnkSta 只跑 8 GT/s,因为 6252 平台本身就是 PCIe 3.0。
                            • 内存拓扑更隐蔽:宿主 node0 有 46.9 GB(带核),node1 有 48.3 GB 但没有核。虚拟机 74 GiB 必然跨两个节点,约一半内存每次访问都要过跨节点链路。

                            所以这台机器上是两个引擎同时撞同一堵墙:Strata 慢是因为墙,Basalt 也只快在墙内能优化的那部分。

                            三、容器化,损失多少

                            原来是裸进程(systemd),现在跑容器:

                            • 镜像 basalt-5070ti-256k-img:latest,3.05 GB,基于 nvidia/cuda:13.0.0-runtime-ubuntu24.04,只装 python3、jinja2、regex、numpy。
                            • 权重只读挂载,配置只读挂载,状态目录可写。

                            同口径基准:

                            指标 裸进程 容器 差值
                            prefill 64K 2725 2648 -2.8%
                            decode conv 73 72 0%
                            decode struct 148 151 +2%
                            decode prose 72 72 0%

                            基本在噪声里。关键是三个参数别省:--ulimit memlock=-1(否则专家页锁失败退回文件映射,速度直接掉)、--shm-size 给够、不要设 CPU 配额。

                            四、预热和跨对话缓存

                            容器入口脚本会在模型加载完后自动预热 23 秒:DSH 的系统提示词(7.3K token)、Hermes 的提示词(0.8K)、一段 300 字生成、一张图(识图路径)。都是为了把专家缓存和 MTP 状态跑热。

                            效果是数量级的:

                            card_speedup.png

                            同一个 2 万 token 提示词,冷启动 31.5 秒,预热后 7.1 秒。这解释了「刚启动那几轮为什么慢」——不是配置坏了。

                            第二层是会话检查点:离开再回到同一个对话,日志里是 restored 13037 tokens (checkpoint) in 65.4 ms,同一提示词从 4.3 秒掉到 90 毫秒。

                            第三层是磁盘停放:容器重启后照样能读回,read 13037 tokens from disk in 457.4 ms。实测快照约 8.1 KB/token,一个 19.5 万 token 的会话落盘 1.5 GiB,32 GiB 预算大概放得下 20 个 20 万 token 的会话。

                            五、配置与启动

                            {
                              "version": 2,
                              "models": [{
                                "model": "/models/Qwen3.8-FN-GSQ-RCO-IQ3_XXS.basalt",
                                "alias": "5070Ti-QFNext-iQ3xxs-Basalt",
                                "gpu": "0",
                                "max-context": 262144,
                                "kv": "int8",
                                "vision": "dynamic"
                              }],
                              "engine": {
                                "resident-experts": true,
                                "vram-reserve-mib": 256,
                                "spec": 8,
                                "expert-profile-save": "/state/expert-profile-learned.bin",
                                "conversation-cache-mib": 2048,
                                "conversation-cache-slots": 4,
                                "conversation-cache-min-tokens": 8192,
                                "conversation-cache-disk-mib": 32768,
                                "conversation-cache-dir": "/state/conversations"
                              },
                              "server": { "host": "0.0.0.0", "port": 8030 }
                            }
                            

                            启动:

                            docker run -d --name Basalt-5070ti-256K-img \
                              --gpus "device=0" \
                              --ulimit memlock=-1 \
                              --shm-size=2g \
                              -p 8030:8030 \
                              -v /data/aimodels/basalt:/models:ro \
                              -v /data/basalt-state:/state \
                              -v /data/basalt-state/warmup:/warmup:ro \
                              -v /path/basalt_config.json:/config.json:ro \
                              --restart unless-stopped \
                              basalt-5070ti-256k-img:latest
                            

                            加载 43.8 GiB(显存 13.0 + 内存 30.8),冷启动约 85 秒,262144 上下文可用,识图一张图 1 到 2 秒。

                            参数是实测筛过的,别照抄网上的:kv k8v4 省 23% 的 KV 但 prefill 掉 7%;spec 4 让结构化输出从 148 掉到 133;resident-budget-gib 压到 26 GiB 会触发专家溢写到 SSD,prefill 直接腰斩。256K 上下文相对 66K 的 prefill 只差 0.2%,所以直接拉满。

                            六、容器化踩到的三个坑

                            1. CUDA 版本门槛:镜像标签写着 cuda>=13.5 就要求驱动支持 13.5。这台驱动 580.159.03 报的 CUDA 是 13.0,用 13.5 的 runtime 镜像直接起不来,必须退到 13.0.0-runtime。
                            2. 源码树路径写死:二进制会 chdir 到编译时的源码树,容器里没有那个目录就报 cannot enter the source tree。加一条软链 /home/fcc/build/basalt -> /opt/basalt 即可。
                            3. serve 依赖不全:serve/ 会往 sys.path 塞 tools/,只拷 bin 和 serve 会在 model_file、regex 上炸,记得把 tools/ 一起打进去。

                            七、结语

                            Basalt 本身没问题,它的优势是 CPU 调度和专家管理;问题在于瓶颈会不会被让出来。16G 卡 + 老 Xeon + PCIe 3.0 这套组合,换引擎能拿到 1.2 到 1.4 倍;如果你是新平台(5 GHz + AVX-VNNI + 本地内存),社区那些 2 倍数据应该更接近。

                            仓库:https://github.com/jesdga95/basalt
                            权重:https://huggingface.co/jesdga/Qwen3.8-Flash-Next-Basalt

                            XXXX
                            XXXX
                            XXX
                            体面乡绅 硕果累累
                            编写于 最后由 编辑
                            #19

                            @fcme
                            我在2 x 5060TI 16G, RAM:64G 上跑, 單發OK, P2速度就崩了.

                            AI:崩速根因定案為③ layer-split 在對面 slot 解碼時自動關閉 → 兩條長 prefill 在 GPU0 串行,不是 KV 搶 VRAM。16 GB×2 上 GPU1 的 VRAM 已滿載 peer experts,沒空間借給 prefill.
                            fcmeF 1 条回复 最后回复
                            0
                            • XXXX XXX

                              @fcme
                              我在2 x 5060TI 16G, RAM:64G 上跑, 單發OK, P2速度就崩了.

                              AI:崩速根因定案為③ layer-split 在對面 slot 解碼時自動關閉 → 兩條長 prefill 在 GPU0 串行,不是 KV 搶 VRAM。16 GB×2 上 GPU1 的 VRAM 已滿載 peer experts,沒空間借給 prefill.

                              fcmeF
                              fcmeF
                              fcme
                              王侯将相
                              编写于 最后由 编辑
                              #20

                              @XXX 感觉基于llamacpp的项目并发都很弱鸡,几乎没有!

                              个人的repo,欢迎指教
                              https://github.com/halonc/R9700-Strata-Qwen3.8-Flash-Next-Tuning
                              https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                              1 条回复 最后回复
                              0

                              你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                              厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                              有了你的建议,这篇帖子会更精彩哦 💗

                              注册 登录
                              回复
                              • 在新帖中回复
                              登录后回复
                              • 从旧到新
                              • 从新到旧
                              • 最多赞同


                              • 登录

                              • 登录或注册以进行搜索。
                              • 第一个帖子
                                最后一个帖子
                              0
                              • 版块
                              • 最新
                              • 标签
                              • 热门
                              • 用户
                              • 群组