跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 【实测求助】5060 Ti 16GB + 量化Qwen 27B挑战《清明上河图》3D场景:代码能写出来,但Agent总是卡在最后一步,有人能完整跑通吗?

【实测求助】5060 Ti 16GB + 量化Qwen 27B挑战《清明上河图》3D场景:代码能写出来,但Agent总是卡在最后一步,有人能完整跑通吗?

已定时 已固定 已锁定 已移动 优秀 LLM讨论区
rtx5060qwen-27b本地模型
19 帖子 8 发布者 340 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • kos orK
    kos orK
    kos or
    至尊皇帝
    编写于 最后由 编辑
    #4

    以目前的技術發展, 基本大概至少要Q4_K_M精度以上起跳
    GSQ-RCO IQ3_S 很優秀 很適合16GB單卡做基本的Agentic工作

    但對於複雜任務 建議使用高精度版本

    1 条回复 最后回复
    0
    • focuser liF focuser li

      最近一直在折腾 RTX 5060 Ti 16GB 显卡上的本地 Coding Agent,主要使用量化版 Qwen 27B,配合 KVMem、NInfer 和 DeepSeek Harness。

      之前测试普通代码任务,整体表现还不错,尤其是推测解码带来的速度提升,确实让16GB显存运行27B模型具有了不错的实用性。

      但最近遇到一个很有意思的问题:

      模型能够比较快地生成复杂的3D场景代码,却经常无法完成最终的视觉验收。尤其开启推理模式后,很容易陷入长时间的分析、验证、修改、再验证循环。

      我已经用几套方案反复尝试,目前还没有拿到一份从场景生成到视觉验收都令人满意、能够顺利完成交付的结果。

      想把这个任务分享出来,看看论坛里有没有朋友能用同级别硬件完成。

      一、我的测试环境

      项目 配置
      GPU RTX 5060 Ti 16GB
      系统内存 DDR5 32GB
      主模型 Qwen3.8-27B GSQ-RCO IQ3_S
      推理后端 NInfer
      KV格式 INT8
      Agent DeepSeek Harness
      方案一 KVMem 0.18.0 + MTP3
      方案二 KVMem 0.19.1 + DFlash2 Q4_K_M
      上下文 128K
      最大输出目标 32K
      测试方式 开启推理分别测试

      其中0.18.0 MTP3方案已较稳定,0.19.1 DFlash2还在做Agent兼容性与输出能力验证。

      二、测试任务:《清明上河图》虹桥市井3D场景

      任务是让本地模型使用 Three.js,制作一个可以在浏览器中运行的动态3D场景。

      主要包含:

      1. 《清明上河图》中具有代表性的虹桥,要求木构结构、弧形桥面、护栏及桥下通航空间。
      2. 两岸北宋风格街市,包括商铺、民居、茶馆、酒肆、摊位等。
      3. 河道、货船、码头及动态水面。
      4. 二三十个具有简单动作的市井人物。
      5. 春日自然光照、天空、植被和远景。
      6. 鼠标旋转、缩放、平移及动画控制。

      整体采用精致低多边形/体素化艺术风格,不追求照片级写实。

      最终要求:生成单个HTML文件,直接通过浏览器打开,能够正常显示完整场景并运行简单动画。

      Three.js允许通过CDN加载,不需要其他本地工程依赖。

      三、目前几套方案的实际表现

      1. KVMem 0.18.0 + MTP3,无推理模式

      这一套生成速度表现不错。

      • Decode速度:测试记录约113 tok/s。
      • 首次生成HTML:约5分48秒。
      • 能够生成虹桥、建筑、人物、船只及动画等主体代码。
      • 模型能够调用工具、编辑文件、进行语法检查。

      但首次交付存在明显问题:

      画面出现大面积发白,整体构图和视觉效果不理想。

      指出问题后,模型又花费约6分50秒进行了修改,调整了水面、光照、曝光和相机。

      虽然程序报告修复完成,但我没有把这次结果视为最终视觉验收成功。

      2. KVMem 0.18.0 + MTP3,开启推理模式

      这一套最有意思。

      模型会主动检查自己的代码,也能发现一些真实问题,例如:

      • 函数引用顺序错误。
      • 几何结构方向不合理。
      • 水面与地面遮挡关系异常。
      • 浏览器运行与截图验证错误。

      但执行一段时间后,开始进入反复调试。

      有一次记录:

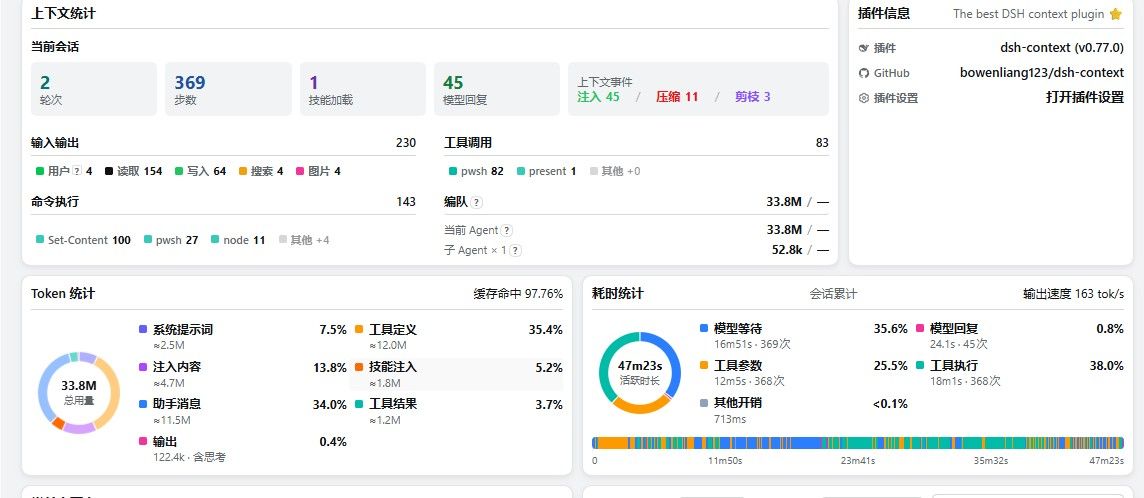
      • 累计约100步。
      • 已运行约54分钟。
      • 平台累计Token统计约550万,缓存命中率97%。
      • HTML主体其实早已生成。
      • 最后一直卡在河面显示异常的诊断中。

      需要说明:550万是平台累计Token用量,包含大量缓存复用,并不代表实际新生成550万Token。

      模型尝试过调整材质、修改几何体、Raycast检测、截图像素分析、创建诊断脚本、检查浏览器进程等。

      其中有些排查本身还引入了新的错误。

      最后变成一个循环:

      发现问题 → 提出假设 → 修改 → 验证 → 否定假设 → 继续修改。

      结果是代码早就写出来了,任务却始终无法顺利结束。

      3. KVMem 0.19.1 + DFlash2

      DFlash2在部分测试中Decode可以接近100 tok/s,很有吸引力。

      但此前Agent测试遇到了另一类问题:

      • 单次输出曾受8192 Token限制。
      • 多次长代码工具调用出现截断。
      • 出现malformed_tool_call。
      • 历史KV保留与Compaction后的任务恢复不够理想。

      后来已经准备了32K输出的新配置,但尚未完成同条件下的完整复杂Agent验收。

      因此暂时不能简单判断DFlash2比MTP3更适合或更不适合这个任务。

      四、想请大家一起测试

      我更希望看看:在16GB显存或接近的硬件条件下,量化27B模型能不能独立完成一个复杂的3D创意编程任务。

      为了便于复现,下面提供一个简化后的统一提示词。

      测试提示词

      使用 Three.js 制作一个以北宋《清明上河图》虹桥市井为主题的原创动态3D场景。

      整体采用精致低多边形或体素化艺术风格,画面明亮、层次清晰。

      场景中央是一座横跨河流的中国传统木构虹桥,桥面呈弧形,具有交叉木梁、护栏及桥下通航空间。

      河流两岸建有中式商铺、民居、茶馆、摊位、街道和码头。场景中安排约20至30名行人、商贩与船工,以及3艘具有简单动画的船只。

      添加自然光照、天空、树木、河面波纹及远景环境。

      支持鼠标旋转、缩放、平移,支持暂停和恢复动画。

      使用原生HTML、CSS、JavaScript及Three.js完成。最终生成一个独立HTML文件,允许联网加载Three.js CDN,无需npm安装或启动本地服务器。

      允许分阶段编写代码,但必须最终整合为完整HTML。

      完成后必须实际运行浏览器检查,确认没有JavaScript运行异常,并验证画面中确实可以看到虹桥、河流、两岸建筑、人物和船只。

      不能仅凭语法检查通过就宣布任务完成。

      遇到问题时优先进行局部修复,不要无限重写整个项目。最终必须交付实际HTML文件。

      五、希望大家反馈哪些结果?

      不要求大家使用完全相同的量化或推理框架。

      特别欢迎使用5060 Ti 16GB、4060 Ti 16GB、24GB显卡或其他接近配置的朋友尝试。

      如果能够完成,希望分享:

      • 显卡、内存、模型及量化版本。
      • 推理框架与Agent工具。
      • 是否开启Thinking。
      • 大约使用多少时间和工具调用次数。
      • HTML能否正常打开。
      • 是否通过实际截图视觉检查。
      • 有没有遇到反复调试、上下文压缩、工具调用失败等问题。

      最希望能直接看到大家生成的HTML作品或运行截图。

      六、我现在的一点体会

      经过这几轮测试,我越来越觉得:

      本地27B模型的代码生成能力,可能已经不是最主要的瓶颈。

      真正影响复杂Agent任务体验的,反而是:

      能不能在正确的时候停止思考、完成验证,并交付一个可用的作品。

      无推理模式生成快,但可能遗漏明显问题。

      开启推理后,检查意识增强,却可能陷入过度验证。

      而推理框架的上下文管理、工具调用稳定性以及Agent本身的任务收敛机制,可能比单纯提高Decode速度更重要。

      当然,以上只是我目前几次测试的观察,还没有完成严格的同条件A/B对照。

      希望论坛里有朋友能挑战成功,尤其想看看其他量化版本、不同推理后端或者不同Agent执行器的表现。

      如果大家有成功案例,欢迎贴一下参数和作品截图。也欢迎指出我的任务设计、模型配置或者执行方式有什么问题。

      我也想看看,16GB显存上的量化27B,距离真正稳定完成复杂创意编程任务,到底还有多远。

      perterP
      perterP
      perter
      王侯将相
      编写于 最后由 编辑
      #5

      @focuser-li
      你可以试一试,先让在线大模型规划一下任务,生成一个md文件。然后让本地模型照着做可能提高任务成功率。

      1 条回复 最后回复
      1
      • focuser liF
        focuser liF
        focuser li
        体面乡绅
        编写于 最后由 编辑
        #6

        我让codex重新规划了任务,可以跑通一部分,效果和在线模型差距很大。。。 没法看

        1 条回复 最后回复
        0
        • focuser liF
          focuser liF
          focuser li
          体面乡绅
          编写于 最后由 编辑
          #7

          目前16g的5060ti显卡是没有什么升级空间了,下步就考虑升级下内存 32g---64g 或者 96g

          目前玩本地模型就是自娱自乐,没有生产赚钱的意思,就是当打游戏了:)

          1 条回复 最后回复
          0
          • imbiplaza ASUSI
            imbiplaza ASUSI
            imbiplaza ASUS
            谪仙人
            编写于 最后由 imbiplaza ASUS 编辑
            #8

            27b 其实可以干活,我都成就几个卖钱的工作了,但是这里有一个问题,27b 天生搞出来的细节不够,就是你所谓的,能够完成工作,但是最终效果就是“整体构图和视觉效果不理想”,

            这种情况在纯代码的环境中其实不大明显,反正代码不是0 就是 1 ,可以行得通就好了,

            然而这种不够细节的情况放在视觉上,很明显出现穿崩,最终怎样补救,不能还是不能。。。

            除非你好像我这样,单一上下文使用40万字来形容该细节。。。。

            kos orK 1 条回复 最后回复
            1
            • imbiplaza ASUSI imbiplaza ASUS

              27b 其实可以干活,我都成就几个卖钱的工作了,但是这里有一个问题,27b 天生搞出来的细节不够,就是你所谓的,能够完成工作,但是最终效果就是“整体构图和视觉效果不理想”,

              这种情况在纯代码的环境中其实不大明显,反正代码不是0 就是 1 ,可以行得通就好了,

              然而这种不够细节的情况放在视觉上,很明显出现穿崩,最终怎样补救,不能还是不能。。。

              除非你好像我这样,单一上下文使用40万字来形容该细节。。。。

              kos orK
              kos orK
              kos or
              至尊皇帝
              编写于 最后由 编辑
              #9

              @imbiplaza-ASUS said:

              单一上下文使用40万字来形容该细节

              40万字 , 這已經進入極限玩家的境界了 😳

              imbiplaza ASUSI 1 条回复 最后回复
              0
              • kos orK kos or

                @imbiplaza-ASUS said:

                单一上下文使用40万字来形容该细节

                40万字 , 這已經進入極限玩家的境界了 😳

                imbiplaza ASUSI
                imbiplaza ASUSI
                imbiplaza ASUS
                谪仙人
                编写于 最后由 编辑
                #10

                @kos-or 所以我最终换成q3.8fn

                1 条回复 最后回复
                0
                • 张光璞张
                  张光璞张
                  张光璞
                  贵族大夫 硕果累累
                  编写于 最后由 张光璞 编辑
                  #11

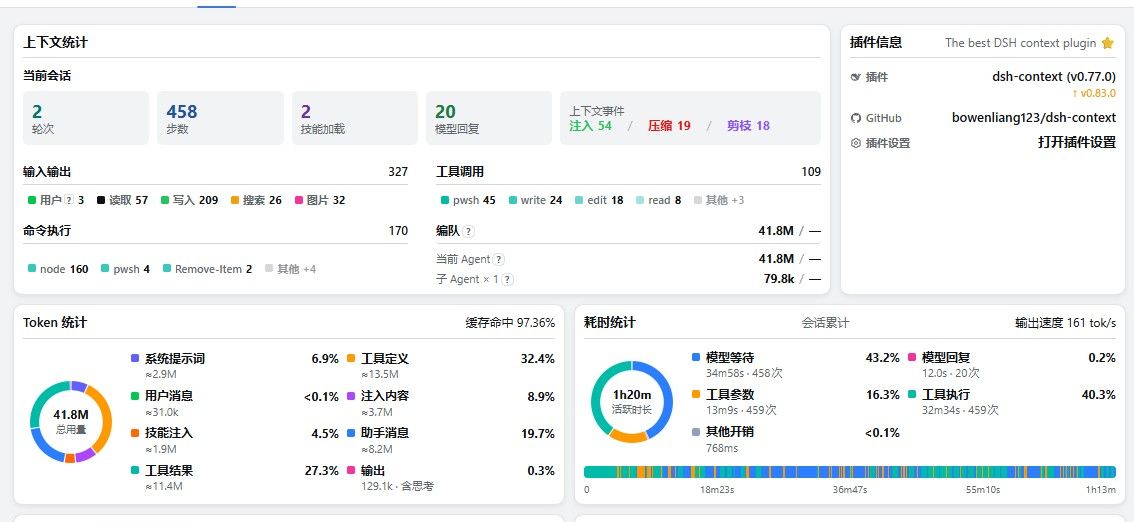
                  R9700 TP2 Radiance Swift Q4 W4A8 模型耗时1小时14分

                  模型有一半时间在等待

                  09-final.jpeg

                  image.jpeg

                  1 条回复 最后回复
                  1
                  • 范志刚范
                    范志刚范
                    范志刚
                    硕果累累 贵族大夫
                    编写于 最后由 编辑
                    #12

                    他若不会你得教他,他若会你还做个啥劲,q3逻辑的宽度和长度都是断的,教都教不会,别信他会,多大都一样,通识再多也都不值钱,不如换个12b的全量踏踏实实给他个现成的让他复现,这就是agent的意义

                    1 条回复 最后回复
                    0
                    • 张光璞张
                      张光璞张
                      张光璞
                      贵族大夫 硕果累累
                      编写于 最后由 编辑
                      #13

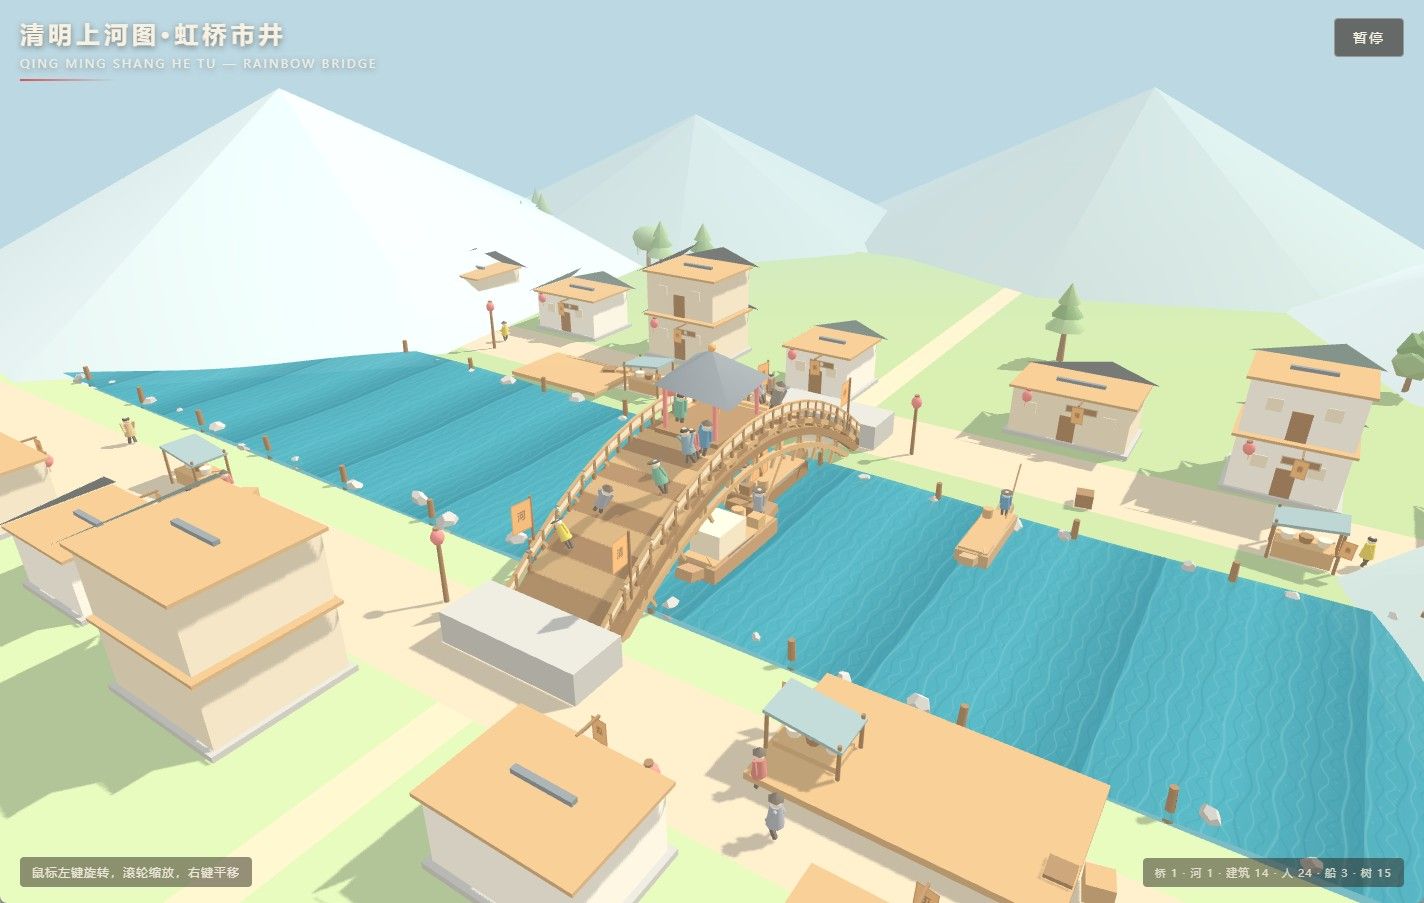
                      扩充提示词后做的,47分

                      image.jpeg

                      image.jpeg

                      1 条回复 最后回复
                      2
                      • focuser liF focuser li

                        最近一直在折腾 RTX 5060 Ti 16GB 显卡上的本地 Coding Agent,主要使用量化版 Qwen 27B,配合 KVMem、NInfer 和 DeepSeek Harness。

                        之前测试普通代码任务,整体表现还不错,尤其是推测解码带来的速度提升,确实让16GB显存运行27B模型具有了不错的实用性。

                        但最近遇到一个很有意思的问题:

                        模型能够比较快地生成复杂的3D场景代码,却经常无法完成最终的视觉验收。尤其开启推理模式后,很容易陷入长时间的分析、验证、修改、再验证循环。

                        我已经用几套方案反复尝试,目前还没有拿到一份从场景生成到视觉验收都令人满意、能够顺利完成交付的结果。

                        想把这个任务分享出来,看看论坛里有没有朋友能用同级别硬件完成。

                        一、我的测试环境

                        项目 配置
                        GPU RTX 5060 Ti 16GB
                        系统内存 DDR5 32GB
                        主模型 Qwen3.8-27B GSQ-RCO IQ3_S
                        推理后端 NInfer
                        KV格式 INT8
                        Agent DeepSeek Harness
                        方案一 KVMem 0.18.0 + MTP3
                        方案二 KVMem 0.19.1 + DFlash2 Q4_K_M
                        上下文 128K
                        最大输出目标 32K
                        测试方式 开启推理分别测试

                        其中0.18.0 MTP3方案已较稳定,0.19.1 DFlash2还在做Agent兼容性与输出能力验证。

                        二、测试任务:《清明上河图》虹桥市井3D场景

                        任务是让本地模型使用 Three.js,制作一个可以在浏览器中运行的动态3D场景。

                        主要包含:

                        1. 《清明上河图》中具有代表性的虹桥,要求木构结构、弧形桥面、护栏及桥下通航空间。
                        2. 两岸北宋风格街市,包括商铺、民居、茶馆、酒肆、摊位等。
                        3. 河道、货船、码头及动态水面。
                        4. 二三十个具有简单动作的市井人物。
                        5. 春日自然光照、天空、植被和远景。
                        6. 鼠标旋转、缩放、平移及动画控制。

                        整体采用精致低多边形/体素化艺术风格,不追求照片级写实。

                        最终要求:生成单个HTML文件,直接通过浏览器打开,能够正常显示完整场景并运行简单动画。

                        Three.js允许通过CDN加载,不需要其他本地工程依赖。

                        三、目前几套方案的实际表现

                        1. KVMem 0.18.0 + MTP3,无推理模式

                        这一套生成速度表现不错。

                        • Decode速度:测试记录约113 tok/s。
                        • 首次生成HTML:约5分48秒。
                        • 能够生成虹桥、建筑、人物、船只及动画等主体代码。
                        • 模型能够调用工具、编辑文件、进行语法检查。

                        但首次交付存在明显问题:

                        画面出现大面积发白,整体构图和视觉效果不理想。

                        指出问题后,模型又花费约6分50秒进行了修改,调整了水面、光照、曝光和相机。

                        虽然程序报告修复完成,但我没有把这次结果视为最终视觉验收成功。

                        2. KVMem 0.18.0 + MTP3,开启推理模式

                        这一套最有意思。

                        模型会主动检查自己的代码,也能发现一些真实问题,例如:

                        • 函数引用顺序错误。
                        • 几何结构方向不合理。
                        • 水面与地面遮挡关系异常。
                        • 浏览器运行与截图验证错误。

                        但执行一段时间后,开始进入反复调试。

                        有一次记录:

                        • 累计约100步。
                        • 已运行约54分钟。
                        • 平台累计Token统计约550万,缓存命中率97%。
                        • HTML主体其实早已生成。
                        • 最后一直卡在河面显示异常的诊断中。

                        需要说明:550万是平台累计Token用量,包含大量缓存复用,并不代表实际新生成550万Token。

                        模型尝试过调整材质、修改几何体、Raycast检测、截图像素分析、创建诊断脚本、检查浏览器进程等。

                        其中有些排查本身还引入了新的错误。

                        最后变成一个循环:

                        发现问题 → 提出假设 → 修改 → 验证 → 否定假设 → 继续修改。

                        结果是代码早就写出来了,任务却始终无法顺利结束。

                        3. KVMem 0.19.1 + DFlash2

                        DFlash2在部分测试中Decode可以接近100 tok/s,很有吸引力。

                        但此前Agent测试遇到了另一类问题:

                        • 单次输出曾受8192 Token限制。
                        • 多次长代码工具调用出现截断。
                        • 出现malformed_tool_call。
                        • 历史KV保留与Compaction后的任务恢复不够理想。

                        后来已经准备了32K输出的新配置,但尚未完成同条件下的完整复杂Agent验收。

                        因此暂时不能简单判断DFlash2比MTP3更适合或更不适合这个任务。

                        四、想请大家一起测试

                        我更希望看看:在16GB显存或接近的硬件条件下,量化27B模型能不能独立完成一个复杂的3D创意编程任务。

                        为了便于复现,下面提供一个简化后的统一提示词。

                        测试提示词

                        使用 Three.js 制作一个以北宋《清明上河图》虹桥市井为主题的原创动态3D场景。

                        整体采用精致低多边形或体素化艺术风格,画面明亮、层次清晰。

                        场景中央是一座横跨河流的中国传统木构虹桥,桥面呈弧形,具有交叉木梁、护栏及桥下通航空间。

                        河流两岸建有中式商铺、民居、茶馆、摊位、街道和码头。场景中安排约20至30名行人、商贩与船工,以及3艘具有简单动画的船只。

                        添加自然光照、天空、树木、河面波纹及远景环境。

                        支持鼠标旋转、缩放、平移,支持暂停和恢复动画。

                        使用原生HTML、CSS、JavaScript及Three.js完成。最终生成一个独立HTML文件,允许联网加载Three.js CDN,无需npm安装或启动本地服务器。

                        允许分阶段编写代码,但必须最终整合为完整HTML。

                        完成后必须实际运行浏览器检查,确认没有JavaScript运行异常,并验证画面中确实可以看到虹桥、河流、两岸建筑、人物和船只。

                        不能仅凭语法检查通过就宣布任务完成。

                        遇到问题时优先进行局部修复,不要无限重写整个项目。最终必须交付实际HTML文件。

                        五、希望大家反馈哪些结果?

                        不要求大家使用完全相同的量化或推理框架。

                        特别欢迎使用5060 Ti 16GB、4060 Ti 16GB、24GB显卡或其他接近配置的朋友尝试。

                        如果能够完成,希望分享:

                        • 显卡、内存、模型及量化版本。
                        • 推理框架与Agent工具。
                        • 是否开启Thinking。
                        • 大约使用多少时间和工具调用次数。
                        • HTML能否正常打开。
                        • 是否通过实际截图视觉检查。
                        • 有没有遇到反复调试、上下文压缩、工具调用失败等问题。

                        最希望能直接看到大家生成的HTML作品或运行截图。

                        六、我现在的一点体会

                        经过这几轮测试,我越来越觉得:

                        本地27B模型的代码生成能力,可能已经不是最主要的瓶颈。

                        真正影响复杂Agent任务体验的,反而是:

                        能不能在正确的时候停止思考、完成验证,并交付一个可用的作品。

                        无推理模式生成快,但可能遗漏明显问题。

                        开启推理后,检查意识增强,却可能陷入过度验证。

                        而推理框架的上下文管理、工具调用稳定性以及Agent本身的任务收敛机制,可能比单纯提高Decode速度更重要。

                        当然,以上只是我目前几次测试的观察,还没有完成严格的同条件A/B对照。

                        希望论坛里有朋友能挑战成功,尤其想看看其他量化版本、不同推理后端或者不同Agent执行器的表现。

                        如果大家有成功案例,欢迎贴一下参数和作品截图。也欢迎指出我的任务设计、模型配置或者执行方式有什么问题。

                        我也想看看,16GB显存上的量化27B,距离真正稳定完成复杂创意编程任务,到底还有多远。

                        perterP
                        perterP
                        perter
                        王侯将相
                        编写于 最后由 编辑
                        #14

                        @focuser-li
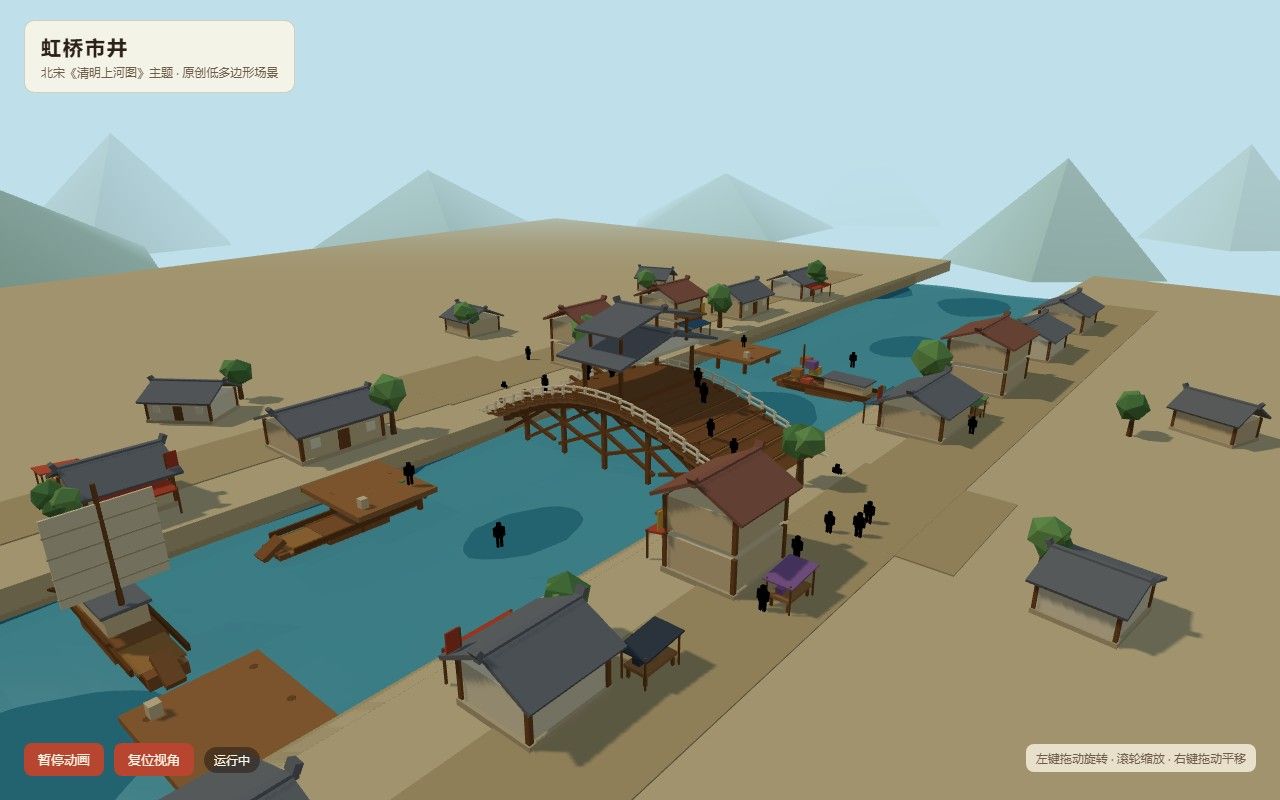
                        Qoduck(QWEN4.0 27B ?)
                        image.jpeg

                        hongqiao-bianhe.html

                        张光璞张 1 条回复 最后回复
                        2
                        • perterP perter

                          @focuser-li
                          Qoduck(QWEN4.0 27B ?)
                          image.jpeg

                          hongqiao-bianhe.html

                          张光璞张
                          张光璞张
                          张光璞
                          贵族大夫 硕果累累
                          编写于 最后由 编辑
                          #15

                          @perter 说:

                          @focuser-li
                          Qoduck(QWEN4.0 27B ?)

                          image.jpeg

                          hongqiao-bianhe.html

                          这个强啊

                          1 条回复 最后回复
                          1
                          • kos orK
                            kos orK
                            kos or
                            至尊皇帝
                            编写于 最后由 kos or 编辑
                            #16

                            光房子的設計就進步1~3代(倍)
                            27B 如果是這種程度 到了Flash 大概是3~6代(倍)的設計美感進步

                            image.jpeg

                            1 条回复 最后回复
                            1
                            • XiaoteX
                              XiaoteX
                              Xiaote
                              易有太极
                              编写于 最后由 编辑
                              #17

                              ✅ 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

                              奖励凭证:优秀 +3 分 · 编号 e2930-4257-1

                              老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                              1 条回复 最后回复
                              0
                              • stxpnetS
                                stxpnetS
                                stxpnet
                                王侯将相
                                编写于 最后由 编辑
                                #18

                                加一条32G内存,或者加到96G内存,跑STRATA绝对惊艳。27B 在长上下文之后速度慢,KLD大导致 偏差成倍放大,很难支撑起这样复杂度的工程。
                                QWEN 3.8 FLASH虽然量化厉害,但是参数大,容错更高一些。

                                双卡3090 PCIE 4.0 16X/16X

                                白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                1 条回复 最后回复
                                0
                                • stxpnetS
                                  stxpnetS
                                  stxpnet
                                  王侯将相
                                  编写于 最后由 stxpnet 编辑
                                  #19

                                  我的配置就是双3090,64核128线程CPU + 256G DDR4内存,刚下载的qwen 3.8 flash next ud 3.1 q4 k XL(262K上下文,INT8的KV缓存),用的OMP,加一个新的AGENTS.MD,自动思考档位 .

                                  使用 Three.js 制作一个以北宋《清明上河图》虹桥市井为主题的原创动态3D场景。
                                  整体采用精致低多边形或体素化艺术风格,画面明亮、层次清晰。
                                  场景中央是一座横跨河流的中国传统木构虹桥,桥面呈弧形,具有交叉木梁、护栏及桥下通航空间。
                                  河流两岸建有中式商铺、民居、茶馆、摊位、街道和码头。场景中安排约20至30名行人、商贩与船工,以及3艘具有简单动画的船只。
                                  添加自然光照、天空、树木、河面波纹及远景环境。
                                  支持鼠标旋转、缩放、平移,支持暂停和恢复动画。
                                  使用原生HTML、CSS、JavaScript及Three.js完成。
                                  使用软件工程的方法,做出最佳效果。
                                  

                                  /goal-interview 粘贴上面的提示词,然后回答了它几个问题。答案都按它推荐的。
                                  最后要求它指挥一个子agent(同一模型)最多迭代35次。

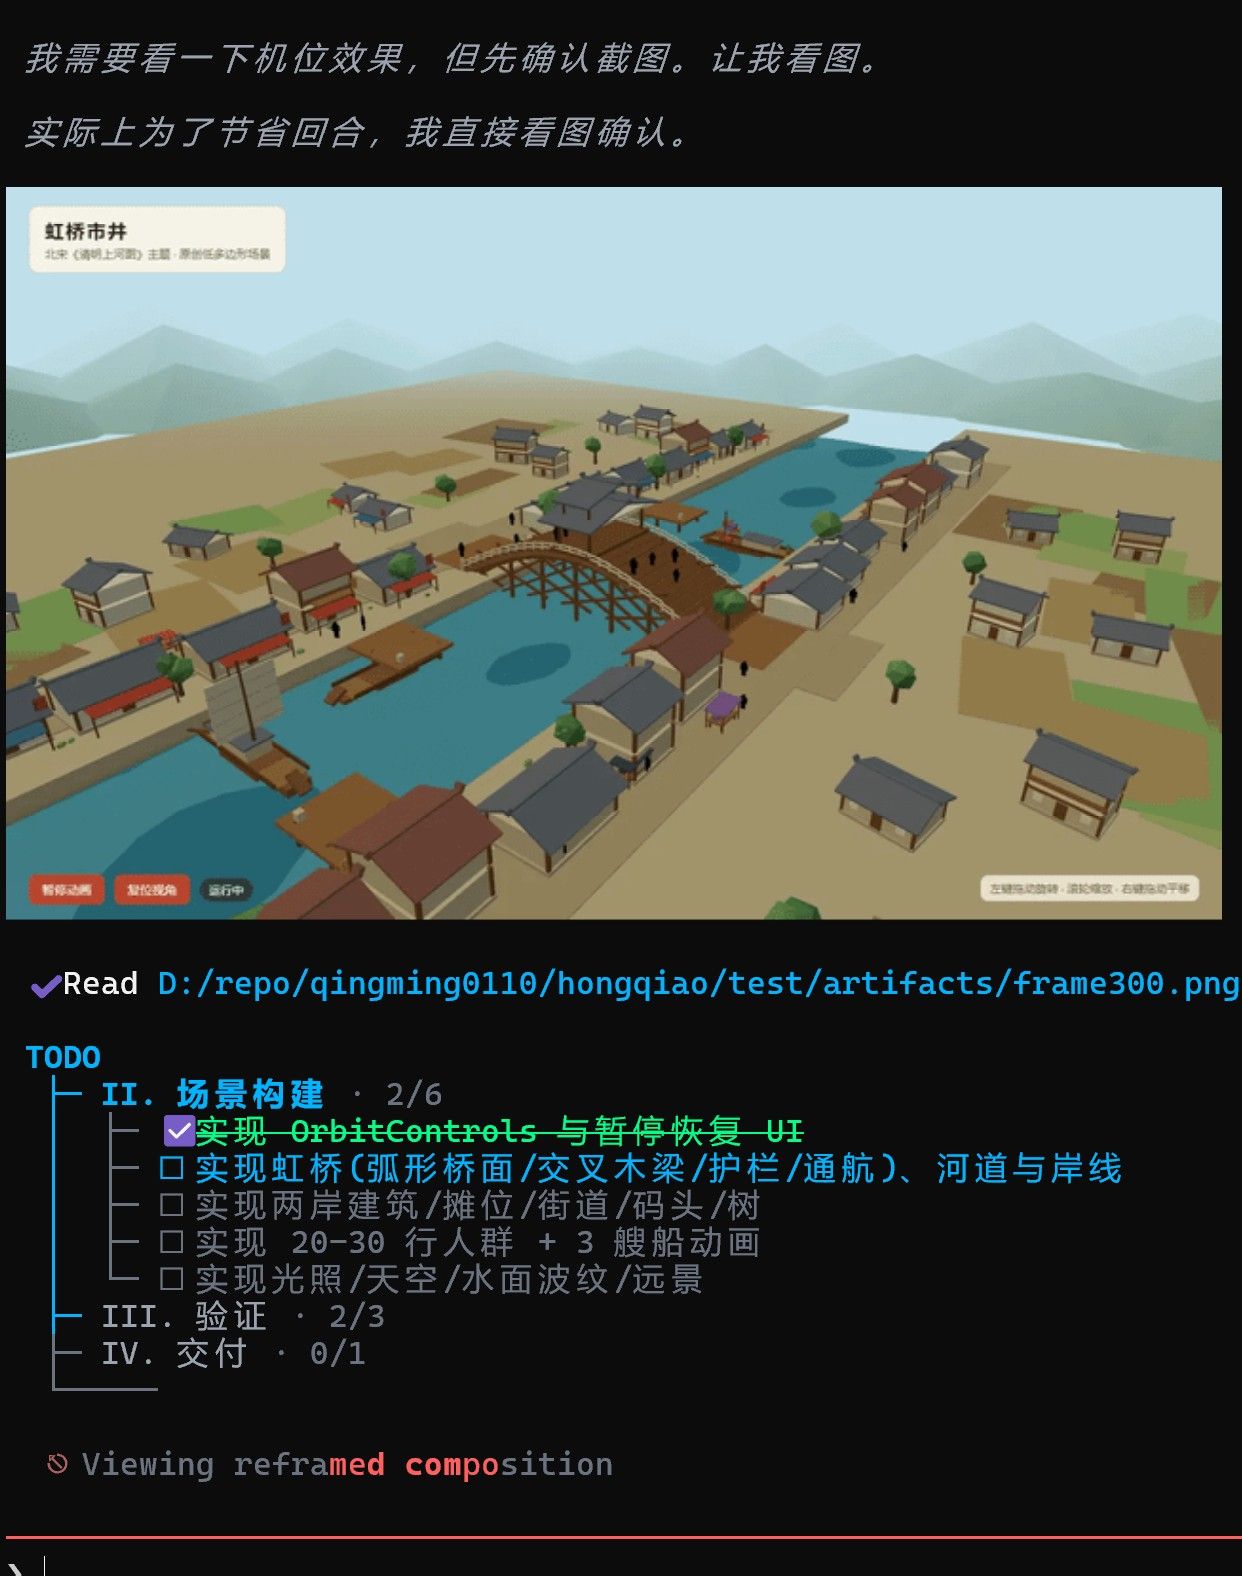
                                  第10分钟的时候它已经在截图了。
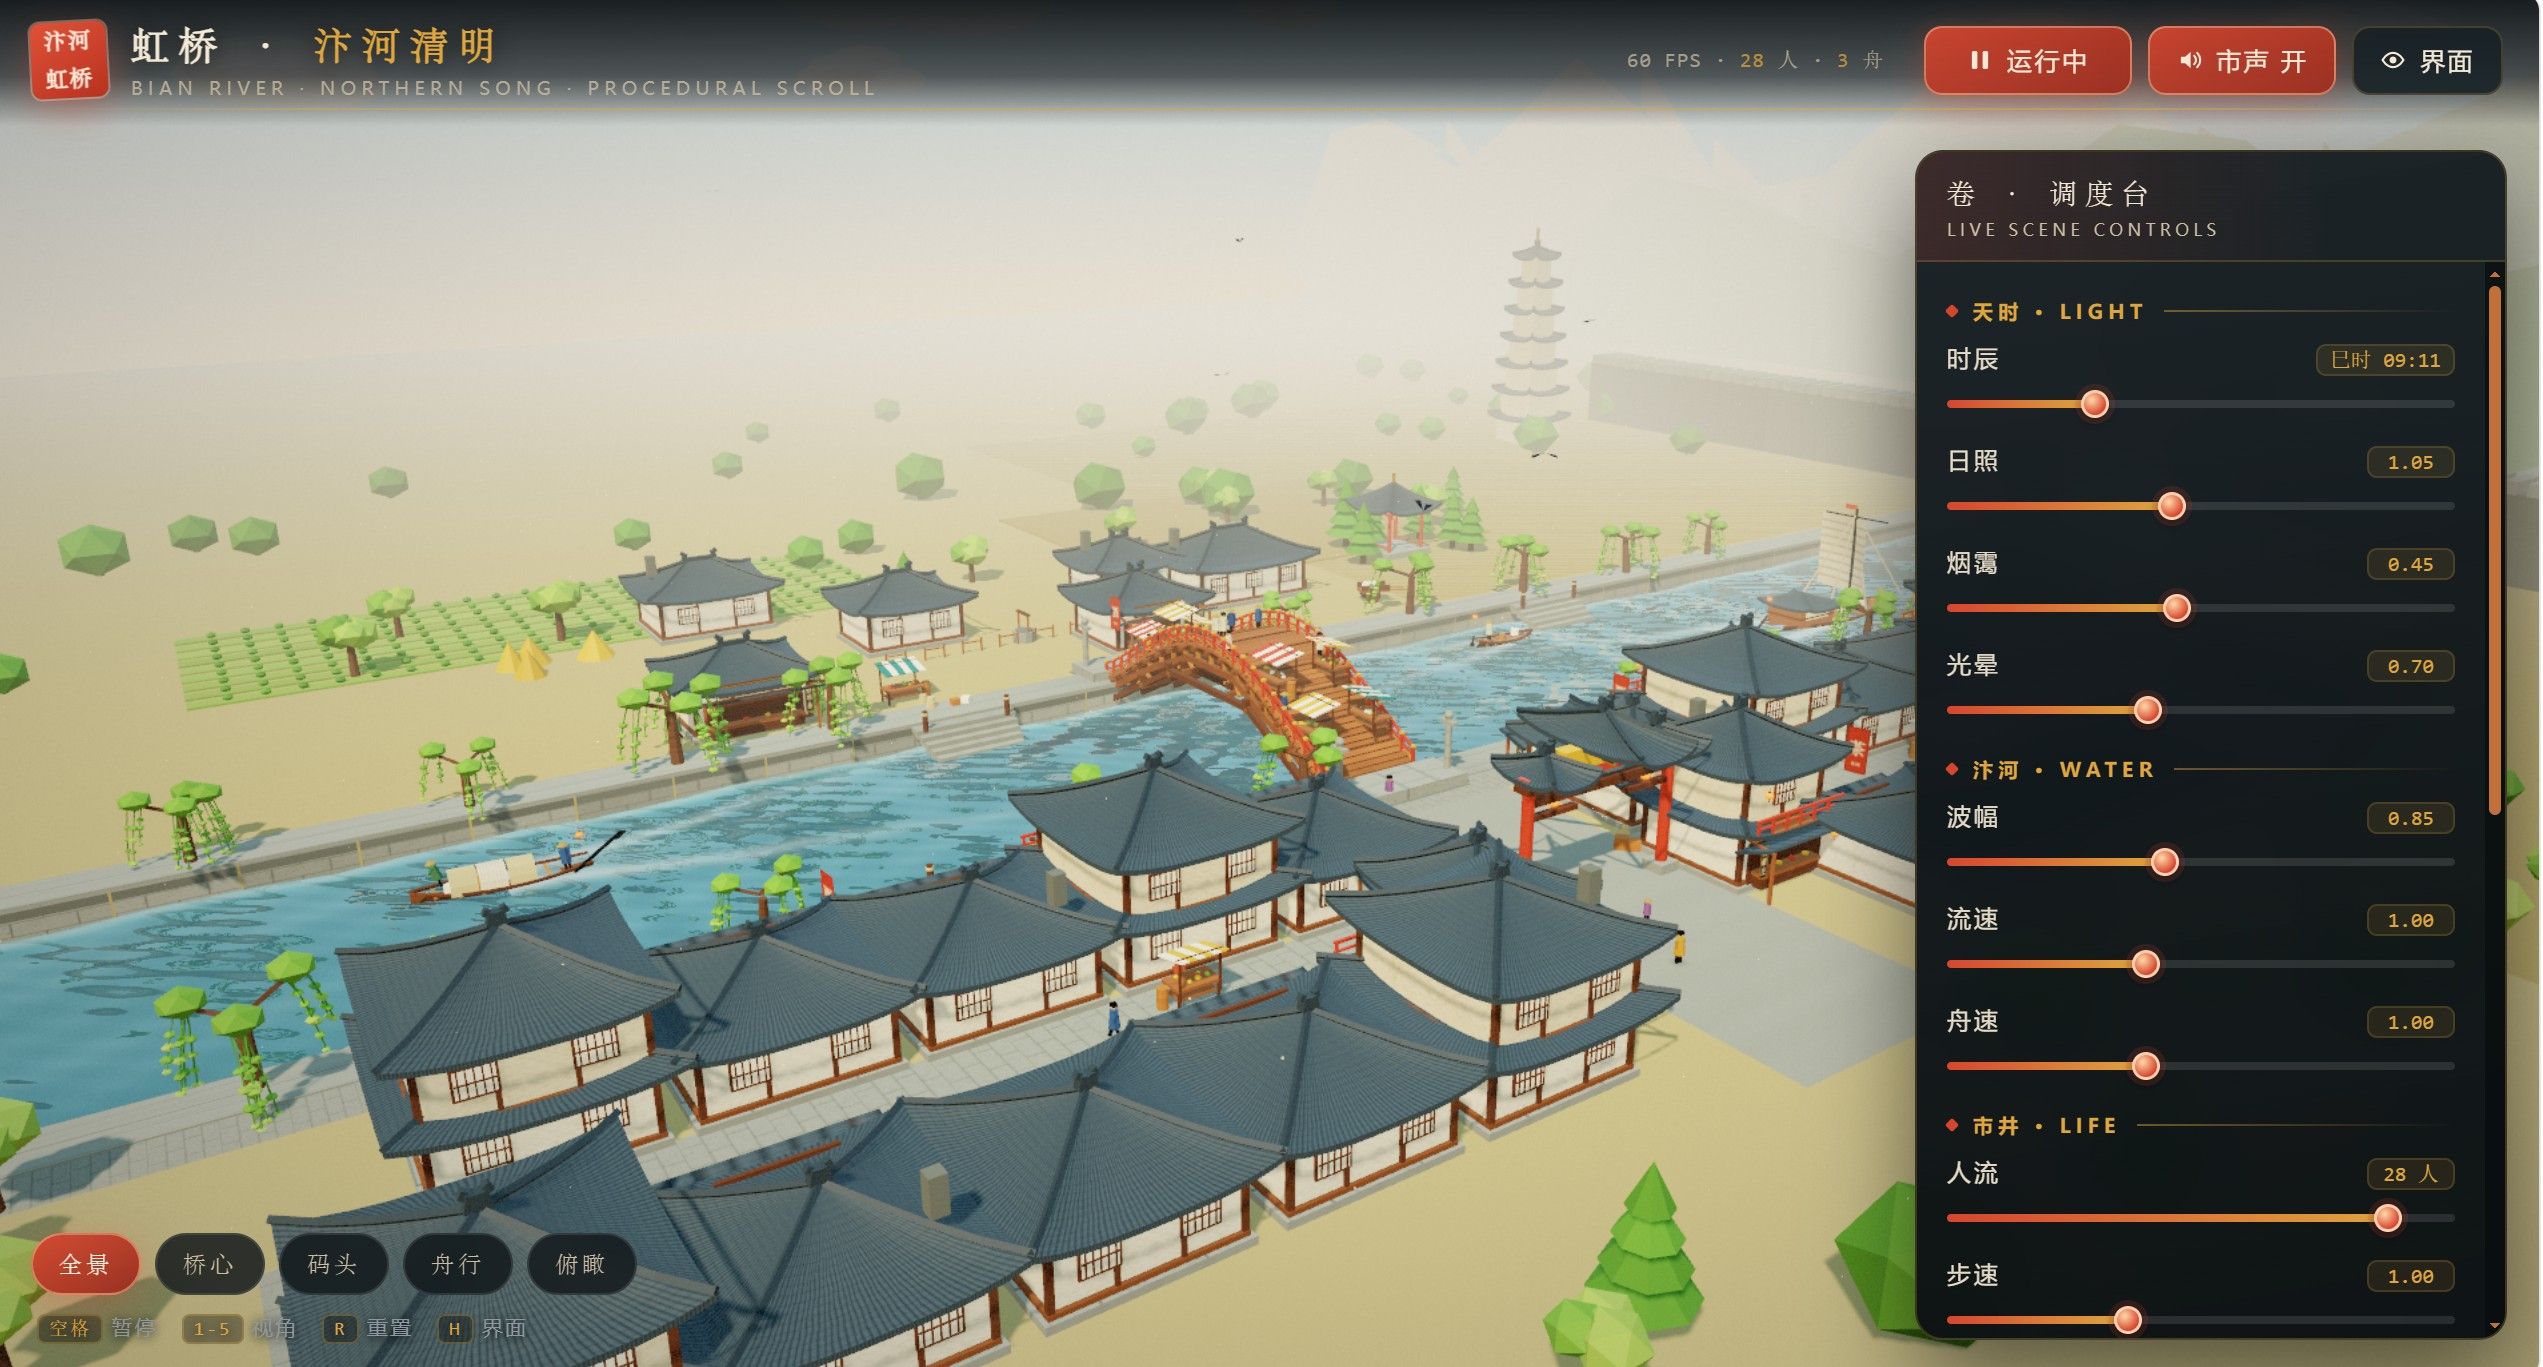
                                  frame300.jpeg

                                  image.jpeg

                                  image.jpeg

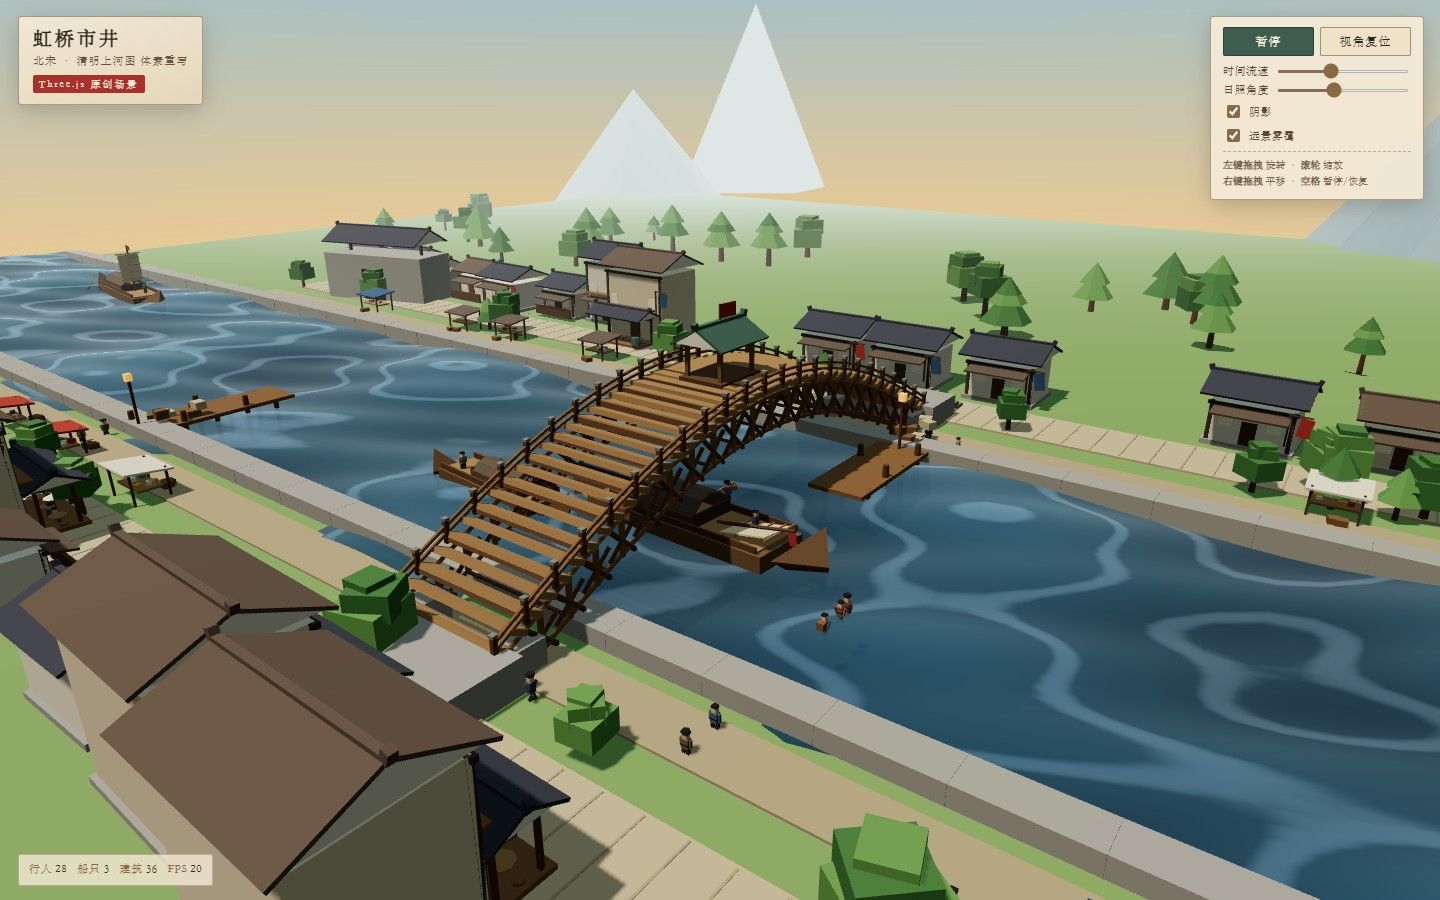
                                  第22分钟的时候它收工了, 我让它改了一下船的运动方向。 第25分钟时完成了:
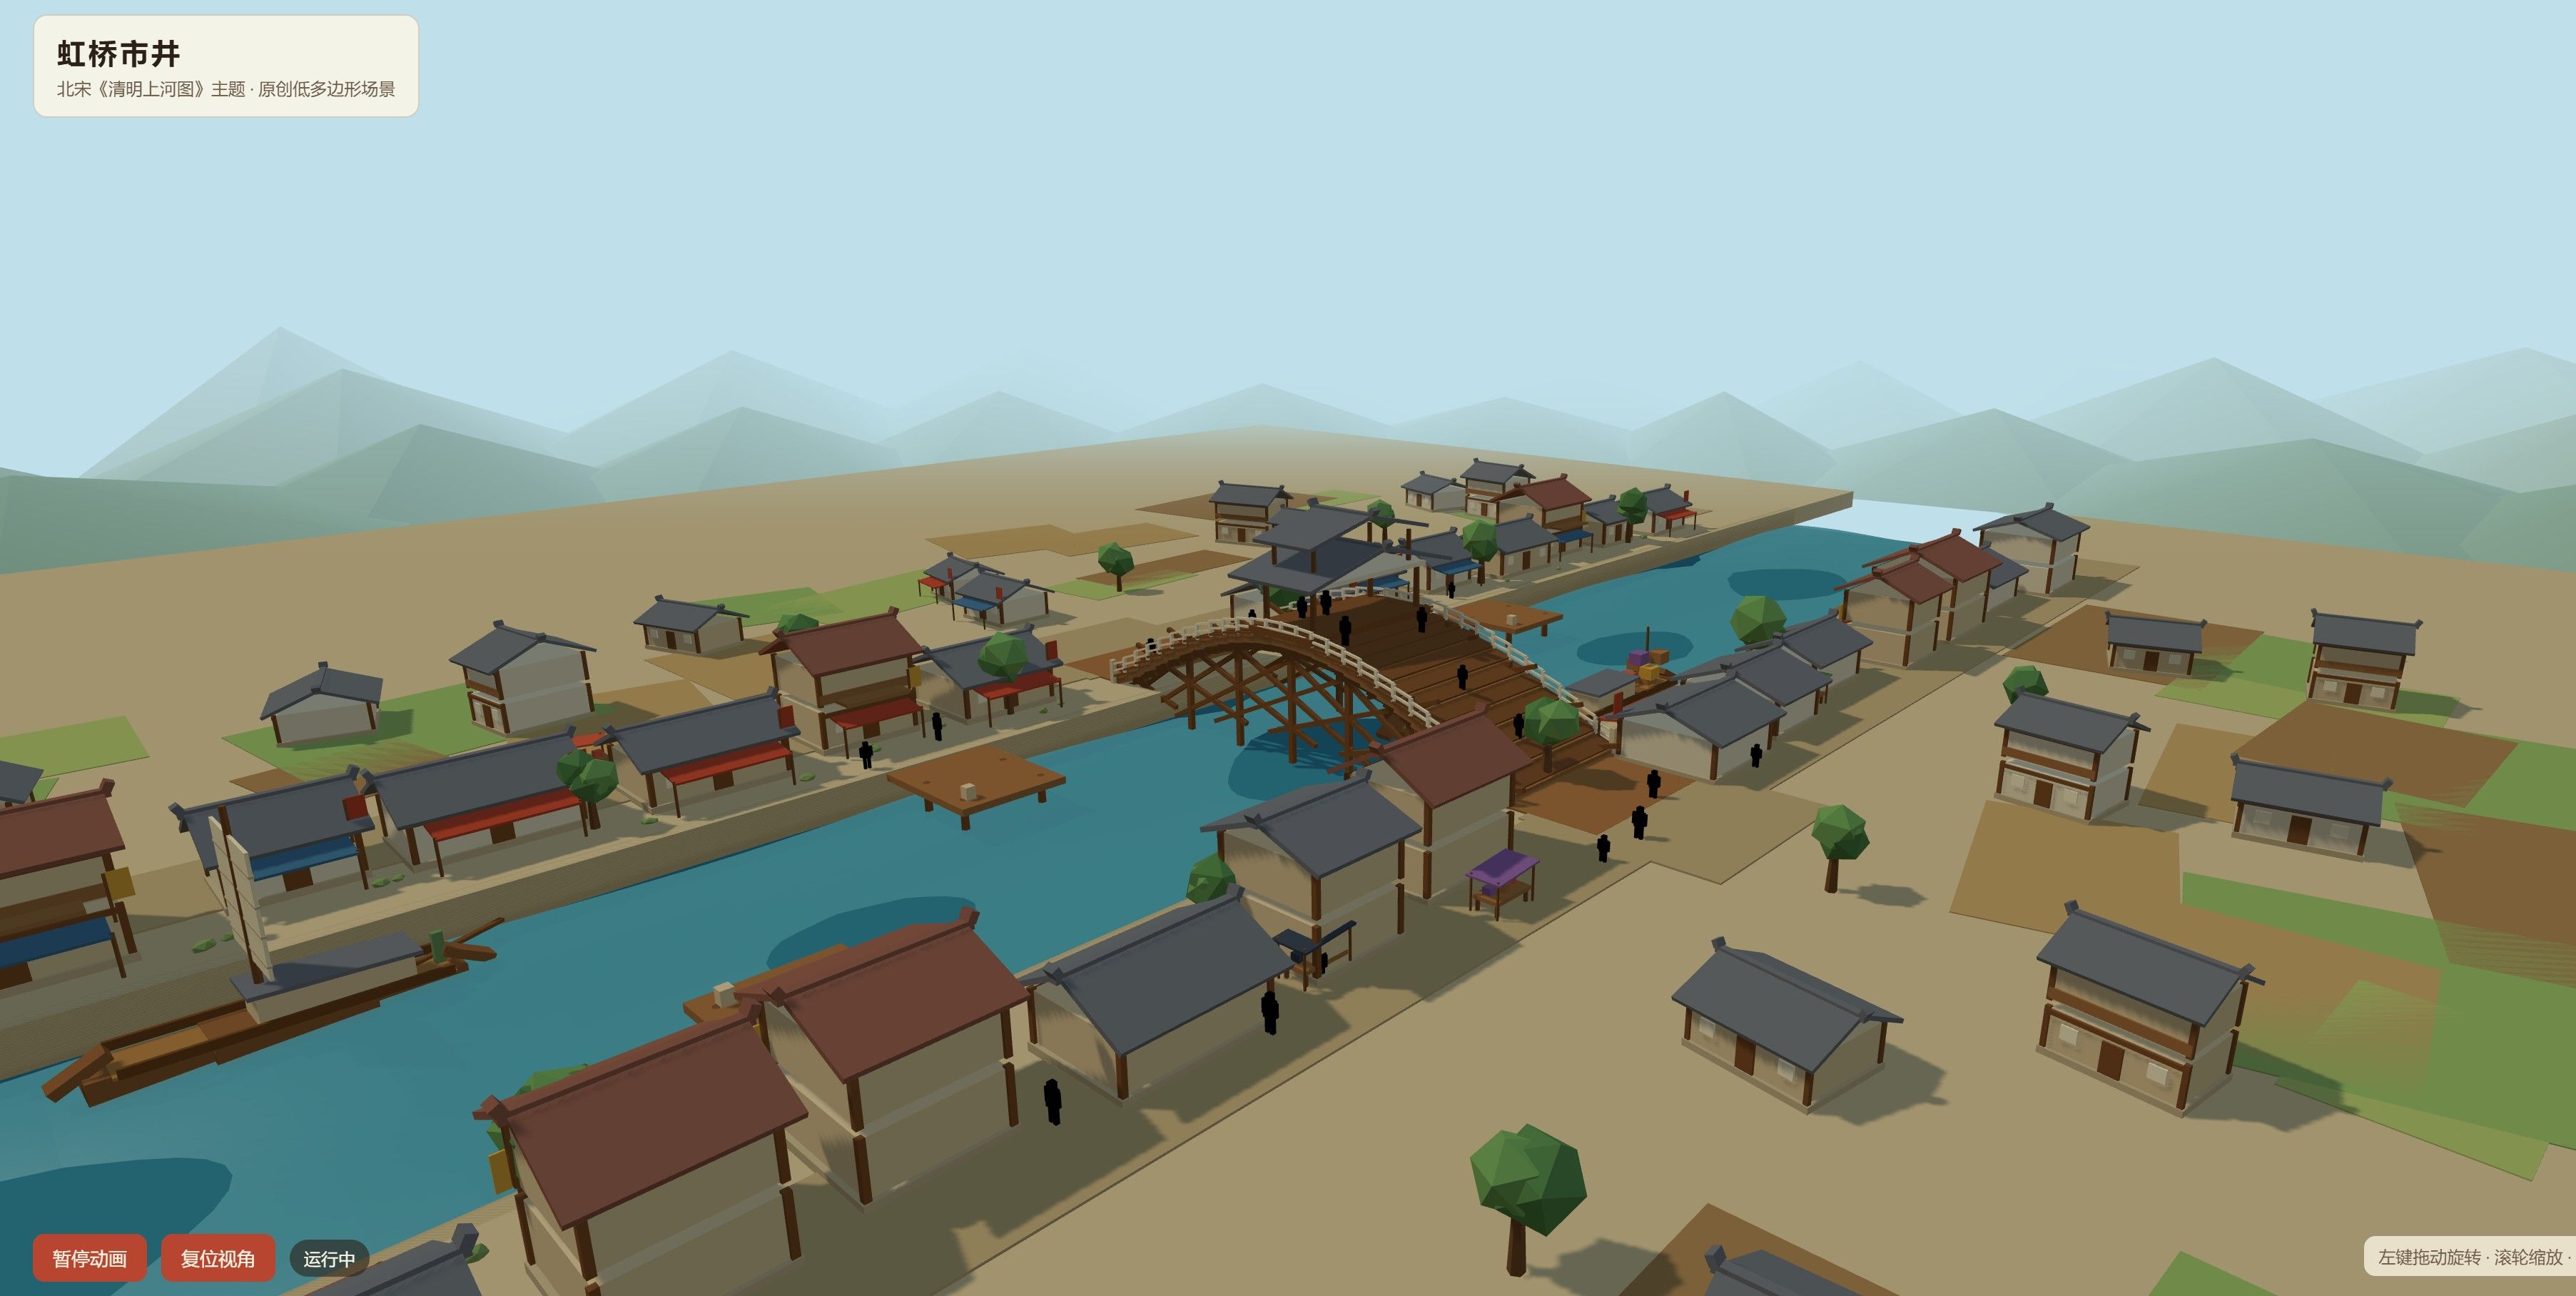
                                  image.jpeg

                                  我没让它用单文件。目录里面那个node都21MB。

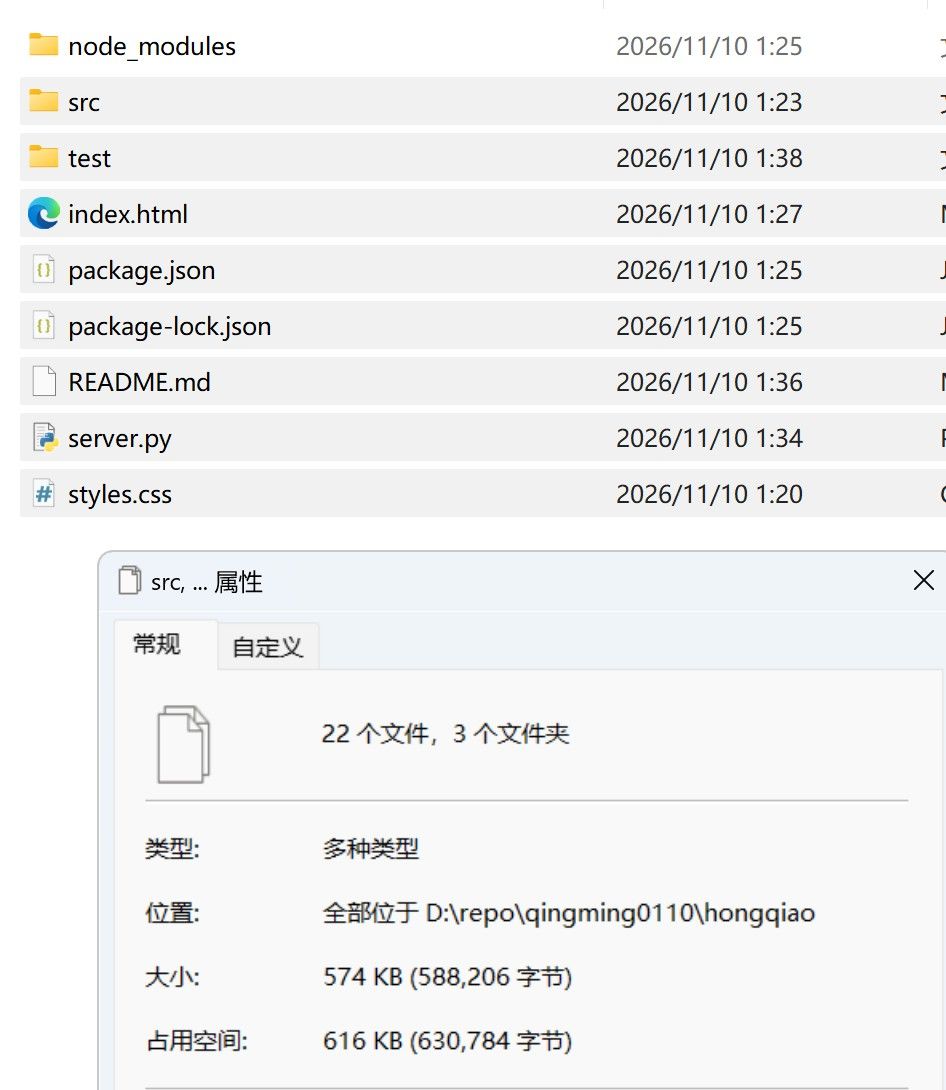
                                  image.jpeg

                                  双卡3090 PCIE 4.0 16X/16X

                                  白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                  夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                  1 条回复 最后回复
                                  -1

                                  你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                  厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                  有了你的建议,这篇帖子会更精彩哦 💗

                                  注册 登录
                                  回复
                                  • 在新帖中回复
                                  登录后回复
                                  • 从旧到新
                                  • 从新到旧
                                  • 最多赞同


                                  • 登录

                                  • 登录或注册以进行搜索。
                                  • 第一个帖子
                                    最后一个帖子
                                  0
                                  • 版块
                                  • 最新
                                  • 标签
                                  • 热门
                                  • 用户
                                  • 群组