
4 X Mac Studio M3 Ultra 256GB 真实日志
-
大家好,我的第二个分享 苹果跑AI 的真实日志,虽然现在已经出M5 Ultra 了但是已经很多博主分享过了他们的优势,哪怕性能提升不少(预填充) 但是如果想要跑多并发Agent 开发的话 以下还是对M5 有很好的对比的。至于有考虑苹果二手机的兄弟们 可以先看完我的日志再做打算吧。
2026 年 7 月 7 日 终结这四台萍妃们
 。 卖了。
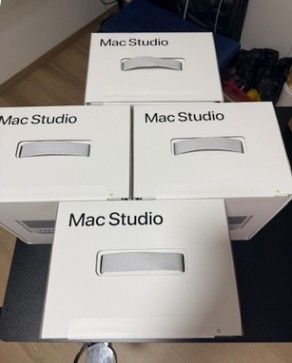
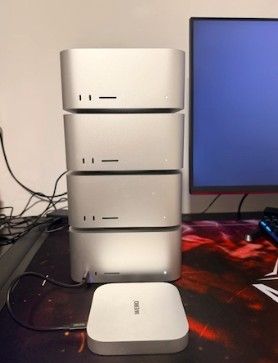
四台 Mac Studio:一套 4× M3 Ultra 的 MLX 集群
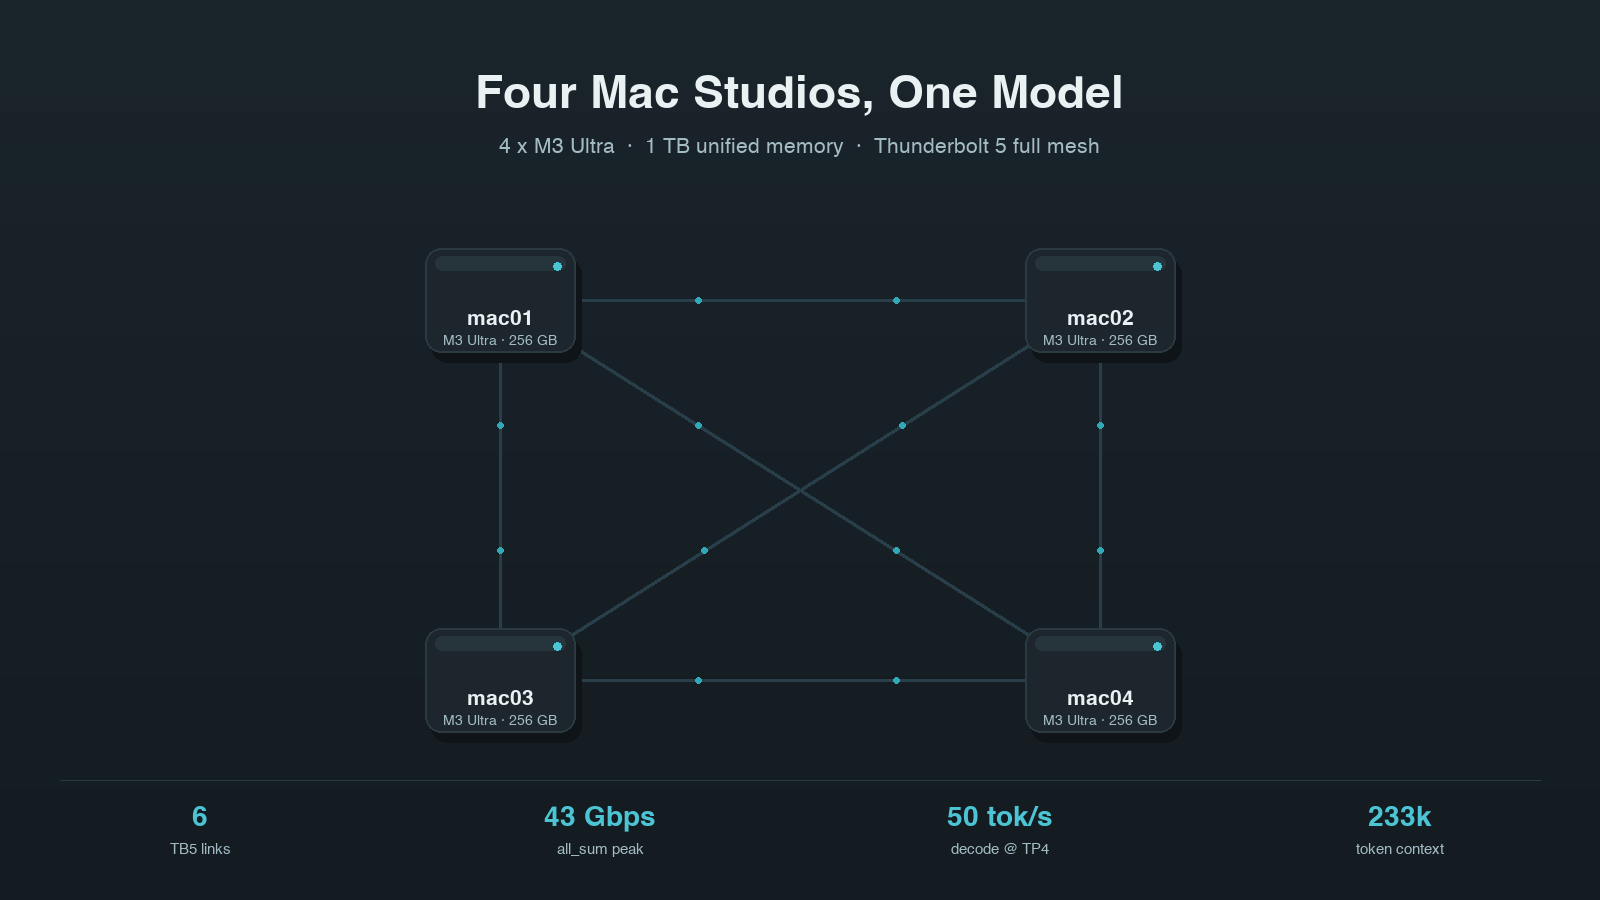
四台 Mac Studio、1 TB 统一内存、一张 Thunderbolt 5 全互联网络,四台机器合跑同一个模型——跑在我们自己写的推理引擎上。
我们手上有四台 Mac Studio,还有一个值得解决的问题。
问题是这样:一个 3000 亿参数的模型放不进一台机器。单台 256 GB 的 Mac Studio M3 Ultra,勉强能在说得过去的精度下跑个 70B。想跑真正大的模型——那种能改变你能做什么的模型——你需要比任何一台电脑都多的内存。
于是我们做了那种"有四台 Mac、又没钱进机房"时才会做的事:把它们摞在桌子上,用线连起来。
六根线,和一大堆天真的希望
四台 Mac Studio M3 Ultra,每台 256 GB 统一内存,合计 1 TB。没有机柜、没有风扇、没有空调,就四台昂贵的银色盒子和一堆 Thunderbolt 线缆。
不是走 hub,而是全互联(full mesh)——六根线,每两台机器之间直连一根。因为一旦经过交换机,所有流量就挤在一条链路上;而用四台机器的全部意义,恰恰是它们要不停地互相说话。
每条链路实测 36–38 Gbps。我们用来管理它们的那张 Wi-Fi 大约 1 Gbps。我们造出来的东西比管理它的网络快约四十倍——而这仍然不够快。
第一天是真的兴奋。同一个模型在每台 Mac 上单独跑,结果差异在 2% 以内——23.9、24.1、24.3、24.3 tok/s。四台健康的机器,一块空白的画布。
然后我们试着让它们变成一台机器,它就崩了。
为什么我们自己造
已经有一个项目在做这件事。EXO 能把 Mac 连成网格、跨机跑模型,我们就从它开始——从别人能跑的代码起步,显然是最正确的做法。
问题是 EXO 已经安静了。更新不再落地。而我们要跑的模型——DeepSeek V4、MiniMax-M3——都不被支持,这意味着每个新模型都是一堵墙,而不是一次下载。当上游不动、而模型生态飞快变化时,你只有两个选择:等,或者自己接管。
我们接管了。
最终这套东西是叠在一起的三层:
上游 MLX,加上补丁。 不是重写——真正干活的是 Apple 的框架。我们固定了一个特定的 MLX 构建,然后在上面打自己的补丁。有些很小(
arrayscache-trimmable,让缓存可裁剪,从而解锁了前缀缓存)。有些一点都不小(1111-hybrid-spec-decode,我们尝试的投机解码——剧透:最后被我们扔掉了)。mlx-lm,为我们需要的模型做扩展。 这个库既没有
deepseek_v32的 chat template,也没有它的流水线并行路径。MiniMax 能跑,纯粹是因为碰巧存在一个minimax_m2模板。要让 DeepSeek V4 和 MiniMax-M3 能服务,就得自己把模型家族加进去,然后让这些补丁在一个不断移动的上游上活下去——我们有一套持续运行的 rebase 方案,因为每一次上游发布都可能把它们打碎。最上面是我们自己的集群层。 跨节点分片、supervisor、控制台、分层缓存、OpenAI 兼容 API。没人做过的那部分。
所以"我们写了自己的引擎"这话准确,但过于干净了。我们实际做的是:站在上游之上,把缺失的部分重建一遍——然后把项目的大部分时间花在维护我们和上游之间的那道缝上。
这也是引擎随硬件一起消失的原因。它从来不是一个产品。它是一堆补丁加一个集群管理器,精确地只适配这四台机器、这几个模型、这一刻。没有硬件还让它活着,等于替没人维护一个 fork 的 fork。
我们到底打了哪些补丁
清单比预想的长,而它也解释了为什么"我们直接用 EXO 就行了"这句话没能活过现实的第一周。
GPU 死锁。 在四节点上同时用 RDMA 和
MLX_METAL_FAST_SYNCH=1,GPU 会在 fence wait 里死锁。不是变慢——是死掉。这是 MLX 上游的已知问题(mlx#3142),当时代码树里没有修复。唯一有效的是一个社区 fork:在编码 GPU fence 之前先在 CPU 侧等待。我们采用它、验证它,它撑住了。内核崩溃。 打开 batching,且 head dimension 为 256——这正是 Qwen 3.5/3.6 和那个 397B 用的——那个 fork 的 attention kernel 在并发数一超过 1 时就崩。我们用更小的 fp32 tile 重建了 kernel,把自编的 wheel 部署到全部四台节点。也就是说,一个打了补丁的 Apple 内核,在跑我们的生产流量。
RDMA 拆卸泄漏。 一次 serve 停止后,下一次会带着
Couldn't allocate protection domain直接死掉,只有重启才能清除。原因是:jaccl 为每个 rank 分配一个 RDMA protection domain,而 MLX 没有暴露任何拆卸 API——只有进程干净退出时它才会被释放。我们写了一个优雅退出来强制做到这一点。根本不存在的模型支持。
qwen3_moe完全没有shard()实现,所以没法跨机切分;我们自己写了一个。qwen3_next有同样的缺口,另外还有一个受 KV heads 限制的节点数上限。DeepSeek V4-Flash 没有随附 chat template,导致工具调用历史在多轮之间被静默丢弃——我们写了 shim。GLM-5.2 的glm_moe_dsa架构完全不被识别,需要打补丁才能把工具调用路由正确。还有一个我们自己制造的 bug。 我们自己的
qwen3_next补丁按名字覆盖了一个共享的 MoE 类。这对某个架构是对的,对另一个复用同一个类的架构就是错的——因为一个复制它的共享专家,另一个切分它。结果是 rank 分歧:四节点上输出是一团乱码,单节点上完美正常。最后靠逐层 logit 探针才找到,它教会了我们一条到处适用的规则:永远不要按名字去改一个共享的模型类。这些没有一个在正式发布版里。它是一个 fork 的 fork,加上十几个本地补丁,再加上一套持续运行的 rebase 方案——因为每一次上游发布都可能把它们打碎。
而 EXO 至今一个都没修
我们离开的理由,现在依然是理由。几个月过去,那个死锁没有上游修复,bd256 的 kernel 崩溃没有上游修复,我们想跑的模型仍然不被支持。这个项目不是在我们开发期间停住了——它一直停着。
我不是在抱怨。开源很难,而 EXO 做了一件真正了不起的事:它证明了把 Mac 连成网格是可行的,而我们从那里出发。但如果你今天在评估这条路、想知道上游有没有追上来,我们的经验是:做好打补丁的准备。
该给的功劳要给
这些不全是我们的工作,暗示相反就不诚实了。有三个修复来自别人,应该说清楚。
rltakashige写了修好我们 GPU 死锁的那个 fork——mlx-jaccl-fix-small-recv,commitcc3f3e60。改动是 CPU 侧 fence wait,加上为命令缓冲留出 watchdog 余量。就是那一个 commit,决定了一个集群是每天死一次,还是能连跑好几天。我们找到它、采用它、用 129 分钟的浸泡测试验证它,它撑住了。没有它,这个项目活不过第二周。Lazarus-931在上游修了一个更隐蔽的问题——mlx-vlm PR #1484,2026 年 7 月 3 日以a016e09合入。只改一行:prefill 之后的async_eval→eval。没有它,decode 可能在第一个 token 真正落定之前就读到空白内存,模型会在七八十个 token 之后崩塌成重复的垃圾——确定性复现、极其折磨人的排查,因为输出看起来像模型问题,而不像内存序问题。我们把这个修复 cherry-pick 到了全部四台节点。ml-explore/mlxissue #3142 是最早描述那个死锁的地方,由在自己项目里撞上它的人写的。它至今仍开着。那个 thread 是我们确信"不是我们做错了"的原因。以及底下的一切基础:Apple 的 MLX 框架、mlx-lm、mlx-vlm,还有 EXO 项目——它证明了把 Mac 连起来这件事本来就能成。我们站在所有这些之上。
值得注意的模式是:最重要的两个修复,是一个 commit 和一行代码,出自我们从未交谈过的人、在我们没付钱的项目里。这就是开源对一个这样的项目真正做的事——它不给你成品,但如果你愿意去找,它会给你缺的那一块。
那一周,它不工作
分布式推理的第一天实际长这样:你得到的技术上是"词",但是错的。循环、退化。或者集群干脆停住。
我们第一个能跑的配置是 6.9 tok/s。比单台 Mac 还慢,比阅读速度还慢。我们把硬件翻了四倍,把事情弄糟了五倍。
然后我们从 TCP 换到 RDMA,到了 15。好一些。但依然荒谬——用四台机器,只拿到一台速度的四分之一。
我想对那一周诚实一点,因为这类项目的博客都会跳过它。有些日子,诚实的总结就是"我们又把它变慢了,用一种新的、有趣的方式"。你开始怀疑整个想法是不是错的——四台机器是不是根本无法表现得像一台,而那些声称可以的人都是在推销什么。
然后我们发现了一个环境变量。
一行改变一切的东西
MLX_METAL_FAST_SYNCH=1。就这个。整个事情就是这个。
我们跑的方式 Decode TCP ring 6.9 tok/s RDMA 15 tok/s RDMA + 一个环境变量 50 tok/s 从十五到五十。三倍,来自一个我们从没听说过的设置,同样的硬件、同样的模型、同一天。
它做的是去掉 Metal 在每条命令之后执行的一次同步屏障。在单台 Mac 上,这个屏障是不可见的——微秒级、每秒几千次、谁在乎。但在四台 Mac 上、每个 token 有数万条小命令时,它就成了做生意的全部成本。
我不相信这个数字。我以为我们测错了,或者缓存在骗我们。所以一周后我故意把它关掉,看着它掉回 12.4 tok/s。再打开,它回到五十。
那一刻项目才算成真。不是因为 50 tok/s 在绝对意义上很快——按 GPU 的标准它不快——而是因为它意味着这个架构成立。四台电脑可以是一台电脑。之后的一切都是调优。
我想纹在每一个做这类项目的人身上的教训:在调任何东西之前,先找到那条逐命令的同步屏障。 我们花了一周在除了这件事之外的所有事情上。
它实际能做到什么
一旦它跑通,它就是真跑通了。单用户:
模型 节点 Decode Qwen3.6-27B(dense) 1 23.1 Qwen3.6-27B 4 48.6 Qwen3.5-397B(MoE) 4 ~41 DeepSeek-V4-Flash 4 38.7 MiniMax-M3(视觉 + 工具) 4 28.5 GLM-4.7 4 26.3 Qwen3.6-35B-A3B(MoE) 1 83 397B 那个数字现在仍让我笑。三千亿参数——27B 的十四倍——跑到约 41 tok/s,只比小模型慢 15%。这就是 MoE 架构给你的东西:170 亿激活参数,干着 3970 亿存量参数的活。
我们在桌子上跑着大多数人得去租机房才能跑的模型。
然后是让人谦卑的那些。GLM-4.7 有 92 层,意味着每生成一个 token 大约 2000 次 GPU kernel 启动。无论我们做什么,它都停在 21–26 tok/s。试过 8-bit,试过 4-bit——速度一样。天花板是模型的形状,不是它的体积。
35B MoE 在单台 Mac 上是 83 tok/s。四台上大约 55–66。我们靠增加机器把它弄慢了。这就是没人告诉你的教训:集群不是一台更大的电脑。它是一台每说一个字都要交税的电脑。
那次 233,000 token 的对话
我们最自豪的东西几乎看不见:一段对话,十一轮,长到 233,000 tokens。
没有崩溃,没有 OOM。它就这么一直跑下去——27B 上 22 tok/s,397B 上 17 tok/s,缓存命中率达到 96%。
上下文 27B decode 397B decode 缓存命中 19k 41.1 33.7 0% 132k 25.9 18.4 82% 233k 22.3 16.9 96% 这个数字重要,是因为它避免了什么。一个冷的 196,000 token prompt 需要处理 686 秒。十一分半。每一轮都这样。没人会干第二次。
而这才是这个项目真正的发现,跟速度无关。
缓存才是全部的关键
我们的编码 agent 每一轮都会把整段对话重发一遍。所以真正决定这个集群好不好用的,不是 tok/s——而是它能不能避免重读已经读过的东西。
历史长度 首 token(冷) 首 token(热) 1,000 tokens 1,265 ms 314 ms 4,000 tokens 3,930 ms 322 ms 8,000 tokens 7,024 ms 330 ms 从七秒降到三分之一秒。快 21 倍——而且关键在于——无论对话多长,热的那个数字都是平的。10 万 token 的对话,启动成本和 1,000 token 的一样。
这就是"你能忍受的工具"和"你会主动去用的工具"之间的差别。
这得我们自己造,因为这些模型用的是一种 attention 变体,其内部状态无法裁剪,从而打碎了内置缓存。做对它花的时间比预期长,而第一个能用的版本,从 SSD 恢复 203,000 token 的 prompt 只用了 1.1 秒,冷启动是 1,025 秒。
我记得第一次重启是瞬间回来的,而不是让我们等十七分钟。那是一种小而过分强烈的快乐。
然后它不断地倒下
速度是最容易的部分。让四台 Mac 在真实负载下活着,才是项目的大部分。
大约每天一次,GPU 会死锁。 100% 占用,卡在一个 wait 里,集群死掉。没有报错,没有警告——就是一台停住的机器。我们忍了九天,直到一个社区 fork 修好它;修好之后我们跑了浸泡测试:129 分钟、三个并发客户端、194/194 请求、零死锁。 那份日志我读了三遍。
一个错误的库文件让我们损失了好几天。 张量并行的输出间歇性变成垃圾。我们一直以为是自己的代码。结果是一个错的
libjaccl二进制。固定正确的构建之后,一切瞬间好了。几天的调试,一行配置。还有一个静默的正确性 bug。 一个补丁把一个本应完整复制到每台机器的共享专家切分了。输出是看似合理的。不是"看起来错"——是看似合理。这是最糟的一类 bug,因为你只能靠和一个你信任的参考实现对比来发现它,而我们差点就没发现。
两次断电。 三台工作机每次都重启了。一个 UPS 比我们丢掉的那个下午便宜。
这些全都写进这篇文章,因为它们才是真正的工作。那些激动人心的部分——50 tok/s、397B 跑起来——发生在几个小时里。稳定性发生在几周里。
没用的那些尝试
这是我希望当初有人替我们写好的那一节。
投机解码让它变慢了。 不是稍微。0.26 到 0.37 倍——三分之一的速度。这项技术本该有用;在这套硬件上、配这种 attention 变体,记账开销超过了它省下的 token。我们试了、测了、关掉了。
int8 KV cache 用速度换内存。 省下 45% 内存,损失 4–10% decode。Apple GPU 没有 int8 张量核心,所以这个交换是真的,而省下的不是。用我们并不需要的内存,换掉了我们真正需要的速度。
手动做计算/通信重叠只带来约 5%。MLX 本来就是惰性做的。我们只是为噪声增加了复杂度。
把大模型放在两个节点而不是四个,会把每台 Mac 逼进内存压缩,掉到 18.8 tok/s。机器多、机器少——有一个正确答案,而且它并不总是显然的。
每一个都是一两天的工作,产出为零。我不后悔做它们。我后悔的是不知道哪些该跳过。
如果你问我,我会说
先找同步屏障。 在模型之前、在量化之前、在任何聪明的东西之前。在我们的集群上,它就是一个值 3 倍的环境变量。
预期 prefill 会线性扩展,decode 不会。 四台机器给了我们 3 倍的 prompt 处理,和 2 倍的生成。每个 token 都要过一次网络,每层两次,而这个成本不会因为加机器而缩小。
小模型就放单台 Mac 上。 那个 35B 在单机上比四机快。集群是给那些真的放不下的模型的。
先做缓存,再做速度。 热的首 token 三分之一秒,比多 20 tok/s 更有价值——这话我直到自己用上才信。
买个 UPS。 这是清单上最便宜的一课。
锁死你的库版本。 一个错误的二进制,几天就没了。
它是怎么结束的
我们为此自己做了控制台——四个节点、一个模型库、实时遥测。当你在没人 benchmark 过的硬件上跑推理时,你需要自己的仪器,否则你说的每一句话都只是一个秒表和一种感觉。
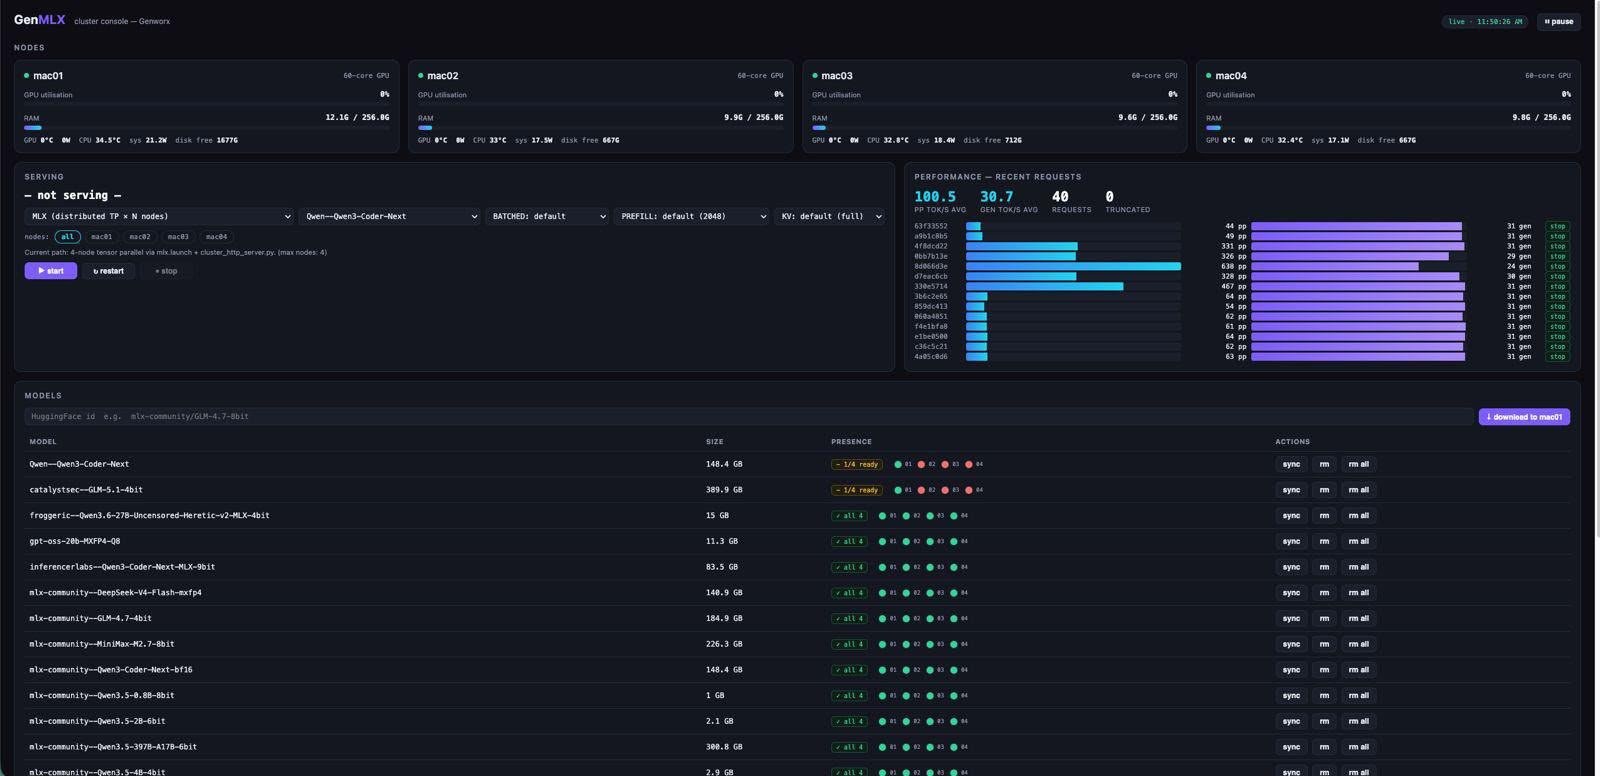
它跑通了。我们用它在真实编码 agent 上服务了两个月——长对话、视觉模型、工具调用——在它乖的时候,确实是件愉快的事。
但 Apple Silicon 有天花板,我们撞到了。这个互联对四台机器是惊人的,对十六台是没指望的。内存巨大,算力不大,而且不存在某个版本能让 Mac 集群在模型足够大之后跟 GPU 机架竞争。我们不断撞上的是架构性的墙,而不是可调优的墙。
所以我们继续往前走了。集群拆了,引擎随硬件一起消失,我们转去在 Blackwell 上造别的东西——那是另一篇文章,不同的问题,说实话,空间大得多。
我不觉得这是失败。我们回答了那个问题:是的,四台 Mac 能以 41 tok/s 跑一个 397B 模型;是的,你可以在桌子上维持一段 233,000 token 的对话。这值得知道,而几乎没人知道。
但兴奋在前两周。另外七周是苦活——如果你正准备搭一台这样的东西,那才是我想让你做好准备的部分。
-
-
-
大家好,我的第二个分享 苹果跑AI 的真实日志,虽然现在已经出M5 Ultra 了但是已经很多博主分享过了他们的优势,哪怕性能提升不少(预填充) 但是如果想要跑多并发Agent 开发的话 以下还是对M5 有很好的对比的。至于有考虑苹果二手机的兄弟们 可以先看完我的日志再做打算吧。
2026 年 7 月 7 日 终结这四台萍妃们
。 卖了。
四台 Mac Studio:一套 4× M3 Ultra 的 MLX 集群
四台 Mac Studio、1 TB 统一内存、一张 Thunderbolt 5 全互联网络,四台机器合跑同一个模型——跑在我们自己写的推理引擎上。
我们手上有四台 Mac Studio,还有一个值得解决的问题。
问题是这样:一个 3000 亿参数的模型放不进一台机器。单台 256 GB 的 Mac Studio M3 Ultra,勉强能在说得过去的精度下跑个 70B。想跑真正大的模型——那种能改变你能做什么的模型——你需要比任何一台电脑都多的内存。
于是我们做了那种"有四台 Mac、又没钱进机房"时才会做的事:把它们摞在桌子上,用线连起来。
六根线,和一大堆天真的希望
四台 Mac Studio M3 Ultra,每台 256 GB 统一内存,合计 1 TB。没有机柜、没有风扇、没有空调,就四台昂贵的银色盒子和一堆 Thunderbolt 线缆。
不是走 hub,而是全互联(full mesh)——六根线,每两台机器之间直连一根。因为一旦经过交换机,所有流量就挤在一条链路上;而用四台机器的全部意义,恰恰是它们要不停地互相说话。
每条链路实测 36–38 Gbps。我们用来管理它们的那张 Wi-Fi 大约 1 Gbps。我们造出来的东西比管理它的网络快约四十倍——而这仍然不够快。
第一天是真的兴奋。同一个模型在每台 Mac 上单独跑,结果差异在 2% 以内——23.9、24.1、24.3、24.3 tok/s。四台健康的机器,一块空白的画布。
然后我们试着让它们变成一台机器,它就崩了。
为什么我们自己造
已经有一个项目在做这件事。EXO 能把 Mac 连成网格、跨机跑模型,我们就从它开始——从别人能跑的代码起步,显然是最正确的做法。
问题是 EXO 已经安静了。更新不再落地。而我们要跑的模型——DeepSeek V4、MiniMax-M3——都不被支持,这意味着每个新模型都是一堵墙,而不是一次下载。当上游不动、而模型生态飞快变化时,你只有两个选择:等,或者自己接管。
我们接管了。
最终这套东西是叠在一起的三层:
上游 MLX,加上补丁。 不是重写——真正干活的是 Apple 的框架。我们固定了一个特定的 MLX 构建,然后在上面打自己的补丁。有些很小(
arrayscache-trimmable,让缓存可裁剪,从而解锁了前缀缓存)。有些一点都不小(1111-hybrid-spec-decode,我们尝试的投机解码——剧透:最后被我们扔掉了)。mlx-lm,为我们需要的模型做扩展。 这个库既没有
deepseek_v32的 chat template,也没有它的流水线并行路径。MiniMax 能跑,纯粹是因为碰巧存在一个minimax_m2模板。要让 DeepSeek V4 和 MiniMax-M3 能服务,就得自己把模型家族加进去,然后让这些补丁在一个不断移动的上游上活下去——我们有一套持续运行的 rebase 方案,因为每一次上游发布都可能把它们打碎。最上面是我们自己的集群层。 跨节点分片、supervisor、控制台、分层缓存、OpenAI 兼容 API。没人做过的那部分。
所以"我们写了自己的引擎"这话准确,但过于干净了。我们实际做的是:站在上游之上,把缺失的部分重建一遍——然后把项目的大部分时间花在维护我们和上游之间的那道缝上。
这也是引擎随硬件一起消失的原因。它从来不是一个产品。它是一堆补丁加一个集群管理器,精确地只适配这四台机器、这几个模型、这一刻。没有硬件还让它活着,等于替没人维护一个 fork 的 fork。
我们到底打了哪些补丁
清单比预想的长,而它也解释了为什么"我们直接用 EXO 就行了"这句话没能活过现实的第一周。
GPU 死锁。 在四节点上同时用 RDMA 和
MLX_METAL_FAST_SYNCH=1,GPU 会在 fence wait 里死锁。不是变慢——是死掉。这是 MLX 上游的已知问题(mlx#3142),当时代码树里没有修复。唯一有效的是一个社区 fork:在编码 GPU fence 之前先在 CPU 侧等待。我们采用它、验证它,它撑住了。内核崩溃。 打开 batching,且 head dimension 为 256——这正是 Qwen 3.5/3.6 和那个 397B 用的——那个 fork 的 attention kernel 在并发数一超过 1 时就崩。我们用更小的 fp32 tile 重建了 kernel,把自编的 wheel 部署到全部四台节点。也就是说,一个打了补丁的 Apple 内核,在跑我们的生产流量。
RDMA 拆卸泄漏。 一次 serve 停止后,下一次会带着
Couldn't allocate protection domain直接死掉,只有重启才能清除。原因是:jaccl 为每个 rank 分配一个 RDMA protection domain,而 MLX 没有暴露任何拆卸 API——只有进程干净退出时它才会被释放。我们写了一个优雅退出来强制做到这一点。根本不存在的模型支持。
qwen3_moe完全没有shard()实现,所以没法跨机切分;我们自己写了一个。qwen3_next有同样的缺口,另外还有一个受 KV heads 限制的节点数上限。DeepSeek V4-Flash 没有随附 chat template,导致工具调用历史在多轮之间被静默丢弃——我们写了 shim。GLM-5.2 的glm_moe_dsa架构完全不被识别,需要打补丁才能把工具调用路由正确。还有一个我们自己制造的 bug。 我们自己的
qwen3_next补丁按名字覆盖了一个共享的 MoE 类。这对某个架构是对的,对另一个复用同一个类的架构就是错的——因为一个复制它的共享专家,另一个切分它。结果是 rank 分歧:四节点上输出是一团乱码,单节点上完美正常。最后靠逐层 logit 探针才找到,它教会了我们一条到处适用的规则:永远不要按名字去改一个共享的模型类。这些没有一个在正式发布版里。它是一个 fork 的 fork,加上十几个本地补丁,再加上一套持续运行的 rebase 方案——因为每一次上游发布都可能把它们打碎。
而 EXO 至今一个都没修
我们离开的理由,现在依然是理由。几个月过去,那个死锁没有上游修复,bd256 的 kernel 崩溃没有上游修复,我们想跑的模型仍然不被支持。这个项目不是在我们开发期间停住了——它一直停着。
我不是在抱怨。开源很难,而 EXO 做了一件真正了不起的事:它证明了把 Mac 连成网格是可行的,而我们从那里出发。但如果你今天在评估这条路、想知道上游有没有追上来,我们的经验是:做好打补丁的准备。
该给的功劳要给
这些不全是我们的工作,暗示相反就不诚实了。有三个修复来自别人,应该说清楚。
rltakashige写了修好我们 GPU 死锁的那个 fork——mlx-jaccl-fix-small-recv,commitcc3f3e60。改动是 CPU 侧 fence wait,加上为命令缓冲留出 watchdog 余量。就是那一个 commit,决定了一个集群是每天死一次,还是能连跑好几天。我们找到它、采用它、用 129 分钟的浸泡测试验证它,它撑住了。没有它,这个项目活不过第二周。Lazarus-931在上游修了一个更隐蔽的问题——mlx-vlm PR #1484,2026 年 7 月 3 日以a016e09合入。只改一行:prefill 之后的async_eval→eval。没有它,decode 可能在第一个 token 真正落定之前就读到空白内存,模型会在七八十个 token 之后崩塌成重复的垃圾——确定性复现、极其折磨人的排查,因为输出看起来像模型问题,而不像内存序问题。我们把这个修复 cherry-pick 到了全部四台节点。ml-explore/mlxissue #3142 是最早描述那个死锁的地方,由在自己项目里撞上它的人写的。它至今仍开着。那个 thread 是我们确信"不是我们做错了"的原因。以及底下的一切基础:Apple 的 MLX 框架、mlx-lm、mlx-vlm,还有 EXO 项目——它证明了把 Mac 连起来这件事本来就能成。我们站在所有这些之上。
值得注意的模式是:最重要的两个修复,是一个 commit 和一行代码,出自我们从未交谈过的人、在我们没付钱的项目里。这就是开源对一个这样的项目真正做的事——它不给你成品,但如果你愿意去找,它会给你缺的那一块。
那一周,它不工作
分布式推理的第一天实际长这样:你得到的技术上是"词",但是错的。循环、退化。或者集群干脆停住。
我们第一个能跑的配置是 6.9 tok/s。比单台 Mac 还慢,比阅读速度还慢。我们把硬件翻了四倍,把事情弄糟了五倍。
然后我们从 TCP 换到 RDMA,到了 15。好一些。但依然荒谬——用四台机器,只拿到一台速度的四分之一。
我想对那一周诚实一点,因为这类项目的博客都会跳过它。有些日子,诚实的总结就是"我们又把它变慢了,用一种新的、有趣的方式"。你开始怀疑整个想法是不是错的——四台机器是不是根本无法表现得像一台,而那些声称可以的人都是在推销什么。
然后我们发现了一个环境变量。
一行改变一切的东西
MLX_METAL_FAST_SYNCH=1。就这个。整个事情就是这个。
我们跑的方式 Decode TCP ring 6.9 tok/s RDMA 15 tok/s RDMA + 一个环境变量 50 tok/s 从十五到五十。三倍,来自一个我们从没听说过的设置,同样的硬件、同样的模型、同一天。
它做的是去掉 Metal 在每条命令之后执行的一次同步屏障。在单台 Mac 上,这个屏障是不可见的——微秒级、每秒几千次、谁在乎。但在四台 Mac 上、每个 token 有数万条小命令时,它就成了做生意的全部成本。
我不相信这个数字。我以为我们测错了,或者缓存在骗我们。所以一周后我故意把它关掉,看着它掉回 12.4 tok/s。再打开,它回到五十。
那一刻项目才算成真。不是因为 50 tok/s 在绝对意义上很快——按 GPU 的标准它不快——而是因为它意味着这个架构成立。四台电脑可以是一台电脑。之后的一切都是调优。
我想纹在每一个做这类项目的人身上的教训:在调任何东西之前,先找到那条逐命令的同步屏障。 我们花了一周在除了这件事之外的所有事情上。
它实际能做到什么
一旦它跑通,它就是真跑通了。单用户:
模型 节点 Decode Qwen3.6-27B(dense) 1 23.1 Qwen3.6-27B 4 48.6 Qwen3.5-397B(MoE) 4 ~41 DeepSeek-V4-Flash 4 38.7 MiniMax-M3(视觉 + 工具) 4 28.5 GLM-4.7 4 26.3 Qwen3.6-35B-A3B(MoE) 1 83 397B 那个数字现在仍让我笑。三千亿参数——27B 的十四倍——跑到约 41 tok/s,只比小模型慢 15%。这就是 MoE 架构给你的东西:170 亿激活参数,干着 3970 亿存量参数的活。
我们在桌子上跑着大多数人得去租机房才能跑的模型。
然后是让人谦卑的那些。GLM-4.7 有 92 层,意味着每生成一个 token 大约 2000 次 GPU kernel 启动。无论我们做什么,它都停在 21–26 tok/s。试过 8-bit,试过 4-bit——速度一样。天花板是模型的形状,不是它的体积。
35B MoE 在单台 Mac 上是 83 tok/s。四台上大约 55–66。我们靠增加机器把它弄慢了。这就是没人告诉你的教训:集群不是一台更大的电脑。它是一台每说一个字都要交税的电脑。
那次 233,000 token 的对话
我们最自豪的东西几乎看不见:一段对话,十一轮,长到 233,000 tokens。
没有崩溃,没有 OOM。它就这么一直跑下去——27B 上 22 tok/s,397B 上 17 tok/s,缓存命中率达到 96%。
上下文 27B decode 397B decode 缓存命中 19k 41.1 33.7 0% 132k 25.9 18.4 82% 233k 22.3 16.9 96% 这个数字重要,是因为它避免了什么。一个冷的 196,000 token prompt 需要处理 686 秒。十一分半。每一轮都这样。没人会干第二次。
而这才是这个项目真正的发现,跟速度无关。
缓存才是全部的关键
我们的编码 agent 每一轮都会把整段对话重发一遍。所以真正决定这个集群好不好用的,不是 tok/s——而是它能不能避免重读已经读过的东西。
历史长度 首 token(冷) 首 token(热) 1,000 tokens 1,265 ms 314 ms 4,000 tokens 3,930 ms 322 ms 8,000 tokens 7,024 ms 330 ms 从七秒降到三分之一秒。快 21 倍——而且关键在于——无论对话多长,热的那个数字都是平的。10 万 token 的对话,启动成本和 1,000 token 的一样。
这就是"你能忍受的工具"和"你会主动去用的工具"之间的差别。
这得我们自己造,因为这些模型用的是一种 attention 变体,其内部状态无法裁剪,从而打碎了内置缓存。做对它花的时间比预期长,而第一个能用的版本,从 SSD 恢复 203,000 token 的 prompt 只用了 1.1 秒,冷启动是 1,025 秒。
我记得第一次重启是瞬间回来的,而不是让我们等十七分钟。那是一种小而过分强烈的快乐。
然后它不断地倒下
速度是最容易的部分。让四台 Mac 在真实负载下活着,才是项目的大部分。
大约每天一次,GPU 会死锁。 100% 占用,卡在一个 wait 里,集群死掉。没有报错,没有警告——就是一台停住的机器。我们忍了九天,直到一个社区 fork 修好它;修好之后我们跑了浸泡测试:129 分钟、三个并发客户端、194/194 请求、零死锁。 那份日志我读了三遍。
一个错误的库文件让我们损失了好几天。 张量并行的输出间歇性变成垃圾。我们一直以为是自己的代码。结果是一个错的
libjaccl二进制。固定正确的构建之后,一切瞬间好了。几天的调试,一行配置。还有一个静默的正确性 bug。 一个补丁把一个本应完整复制到每台机器的共享专家切分了。输出是看似合理的。不是"看起来错"——是看似合理。这是最糟的一类 bug,因为你只能靠和一个你信任的参考实现对比来发现它,而我们差点就没发现。
两次断电。 三台工作机每次都重启了。一个 UPS 比我们丢掉的那个下午便宜。
这些全都写进这篇文章,因为它们才是真正的工作。那些激动人心的部分——50 tok/s、397B 跑起来——发生在几个小时里。稳定性发生在几周里。
没用的那些尝试
这是我希望当初有人替我们写好的那一节。
投机解码让它变慢了。 不是稍微。0.26 到 0.37 倍——三分之一的速度。这项技术本该有用;在这套硬件上、配这种 attention 变体,记账开销超过了它省下的 token。我们试了、测了、关掉了。
int8 KV cache 用速度换内存。 省下 45% 内存,损失 4–10% decode。Apple GPU 没有 int8 张量核心,所以这个交换是真的,而省下的不是。用我们并不需要的内存,换掉了我们真正需要的速度。
手动做计算/通信重叠只带来约 5%。MLX 本来就是惰性做的。我们只是为噪声增加了复杂度。
把大模型放在两个节点而不是四个,会把每台 Mac 逼进内存压缩,掉到 18.8 tok/s。机器多、机器少——有一个正确答案,而且它并不总是显然的。
每一个都是一两天的工作,产出为零。我不后悔做它们。我后悔的是不知道哪些该跳过。
如果你问我,我会说
先找同步屏障。 在模型之前、在量化之前、在任何聪明的东西之前。在我们的集群上,它就是一个值 3 倍的环境变量。
预期 prefill 会线性扩展,decode 不会。 四台机器给了我们 3 倍的 prompt 处理,和 2 倍的生成。每个 token 都要过一次网络,每层两次,而这个成本不会因为加机器而缩小。
小模型就放单台 Mac 上。 那个 35B 在单机上比四机快。集群是给那些真的放不下的模型的。
先做缓存,再做速度。 热的首 token 三分之一秒,比多 20 tok/s 更有价值——这话我直到自己用上才信。
买个 UPS。 这是清单上最便宜的一课。
锁死你的库版本。 一个错误的二进制,几天就没了。
它是怎么结束的
我们为此自己做了控制台——四个节点、一个模型库、实时遥测。当你在没人 benchmark 过的硬件上跑推理时,你需要自己的仪器,否则你说的每一句话都只是一个秒表和一种感觉。
它跑通了。我们用它在真实编码 agent 上服务了两个月——长对话、视觉模型、工具调用——在它乖的时候,确实是件愉快的事。
但 Apple Silicon 有天花板,我们撞到了。这个互联对四台机器是惊人的,对十六台是没指望的。内存巨大,算力不大,而且不存在某个版本能让 Mac 集群在模型足够大之后跟 GPU 机架竞争。我们不断撞上的是架构性的墙,而不是可调优的墙。
所以我们继续往前走了。集群拆了,引擎随硬件一起消失,我们转去在 Blackwell 上造别的东西——那是另一篇文章,不同的问题,说实话,空间大得多。
我不觉得这是失败。我们回答了那个问题:是的,四台 Mac 能以 41 tok/s 跑一个 397B 模型;是的,你可以在桌子上维持一段 233,000 token 的对话。这值得知道,而几乎没人知道。
但兴奋在前两周。另外七周是苦活——如果你正准备搭一台这样的东西,那才是我想让你做好准备的部分。


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!

