
花了 10 美元在 Vast.ai 跑 H3:5080、4080 SUPER、5070 Ti 和双 7900 XTX 实测
-
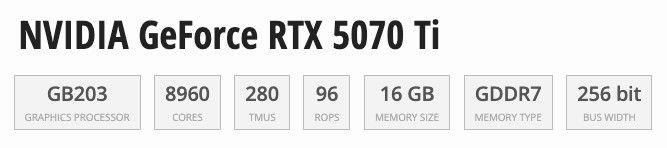
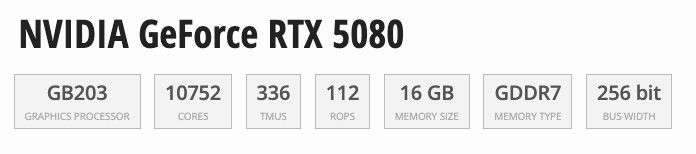
为了决定本地 H3 工作流要不要加张 NVIDIA 卡,我在 Vast.ai 上租了几台机器,前后花了大约 10 美元。选卡时参考了 3DMark Time Spy 的分数档位,挑了几张和手头 RX 7900 XTX 有对照价值的卡:RTX 5080、RTX 4080 SUPER 和 RTX 5070 Ti。这里不是测游戏帧率,而是把我自己的 MiniMax H3 / Pika 工作流直接搬上去跑。
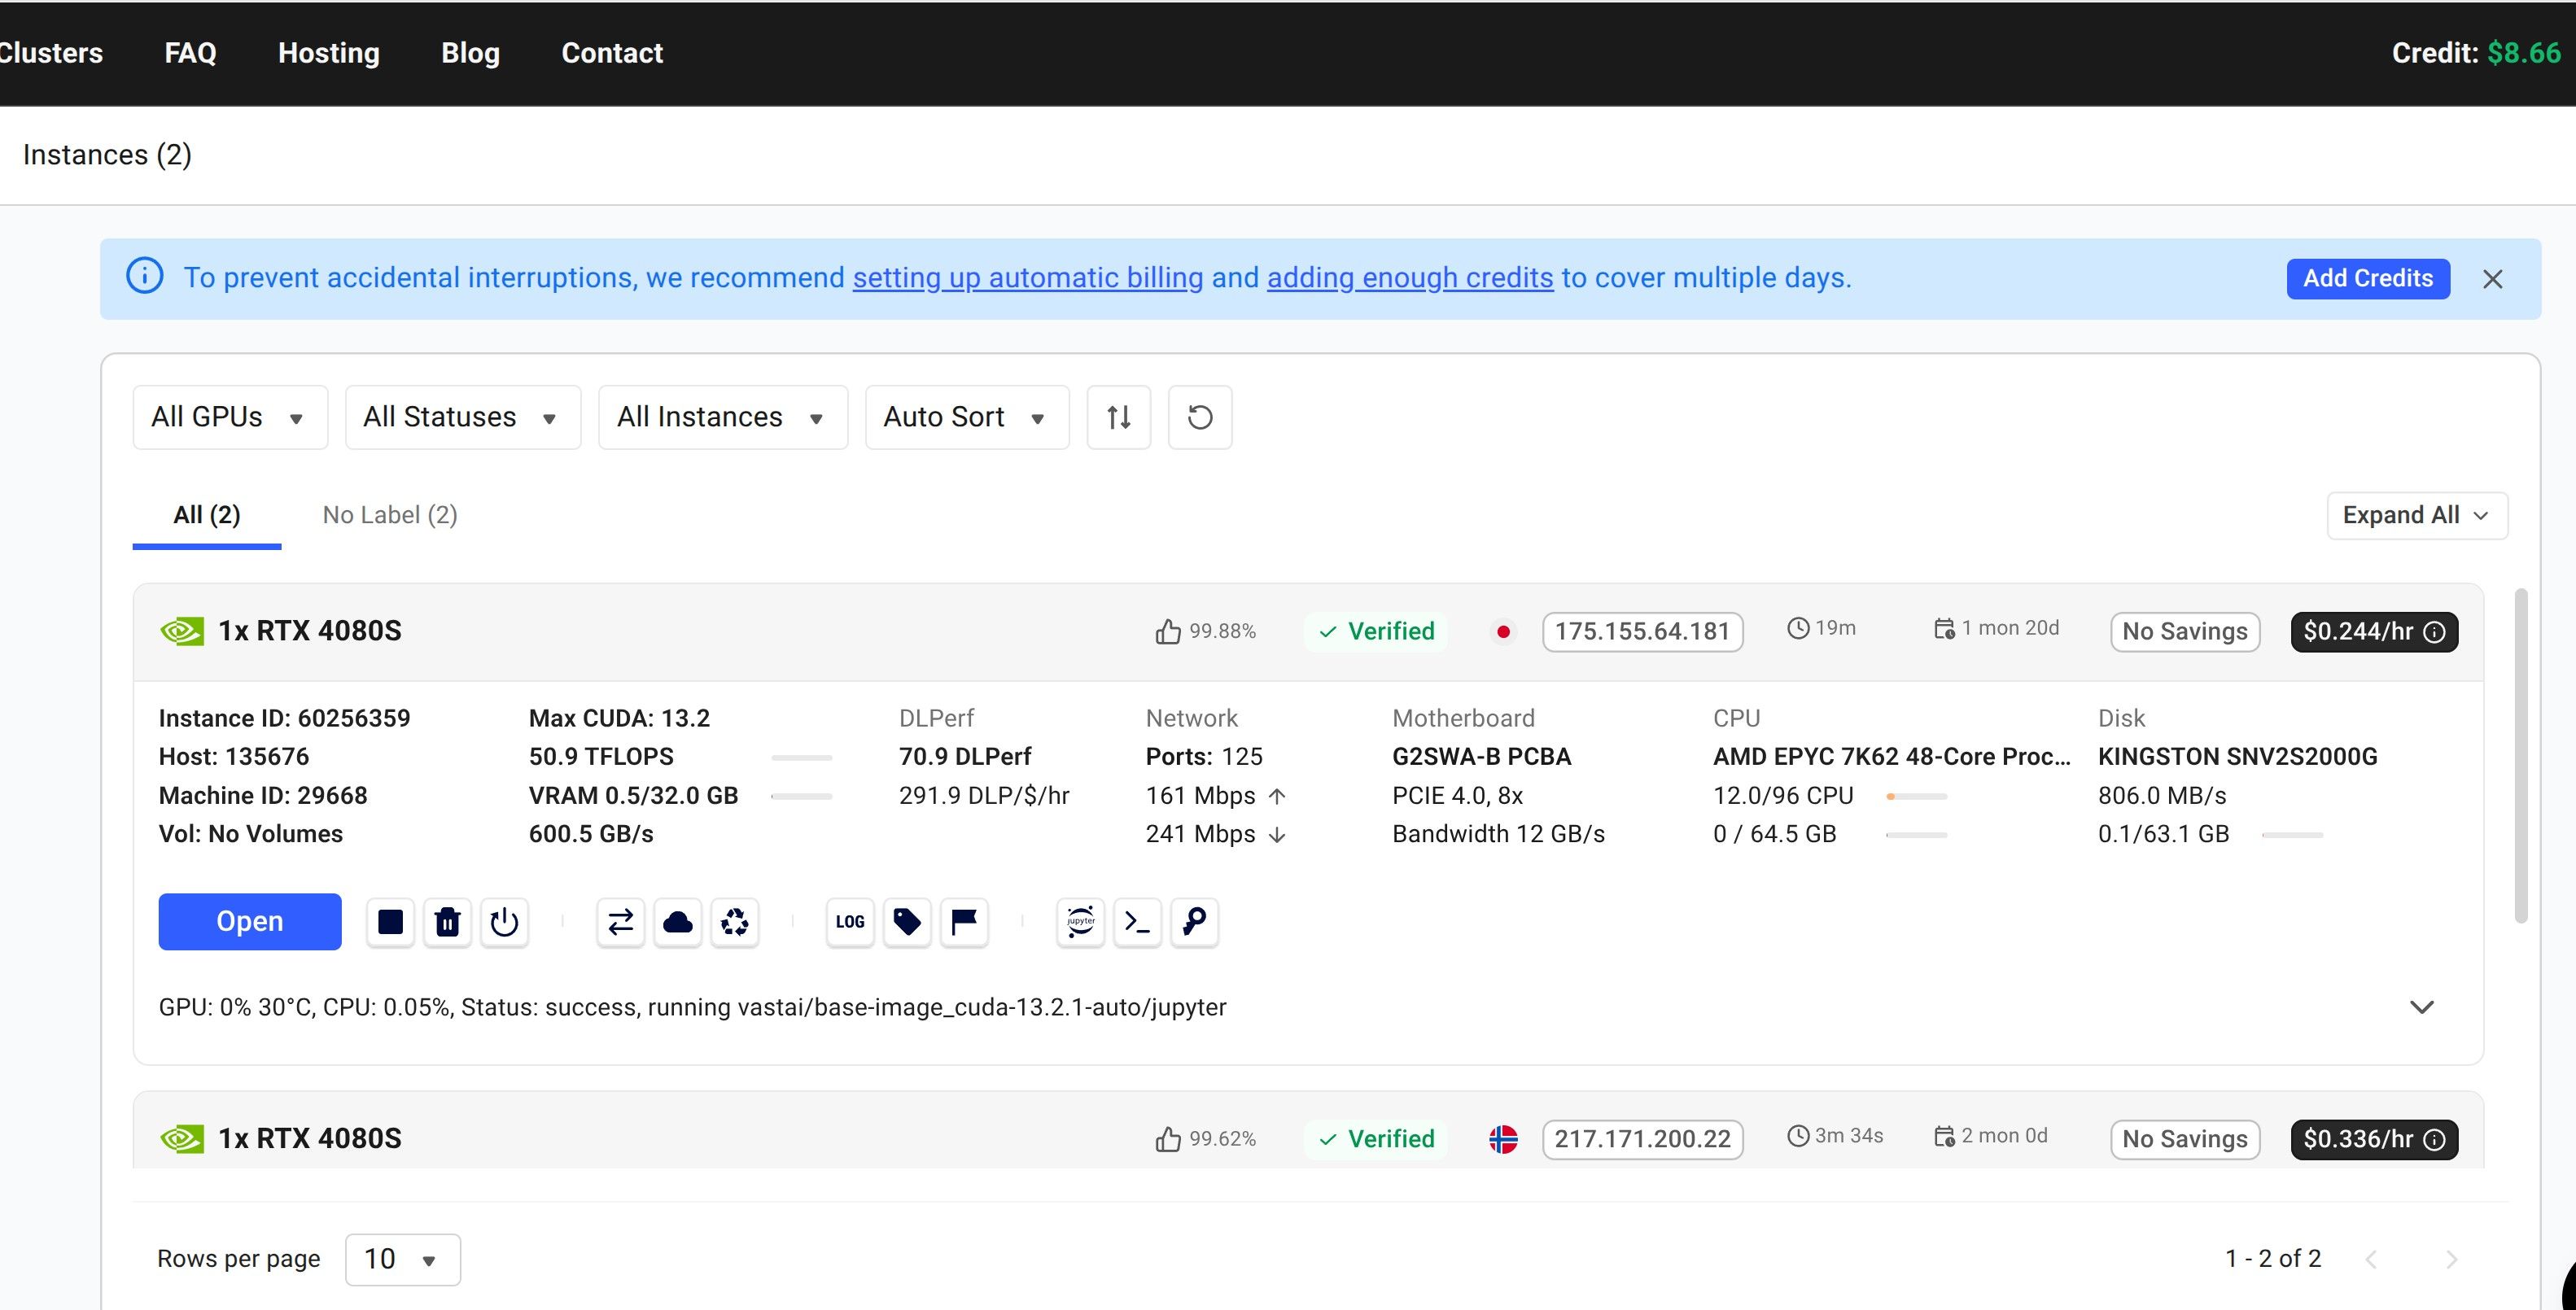
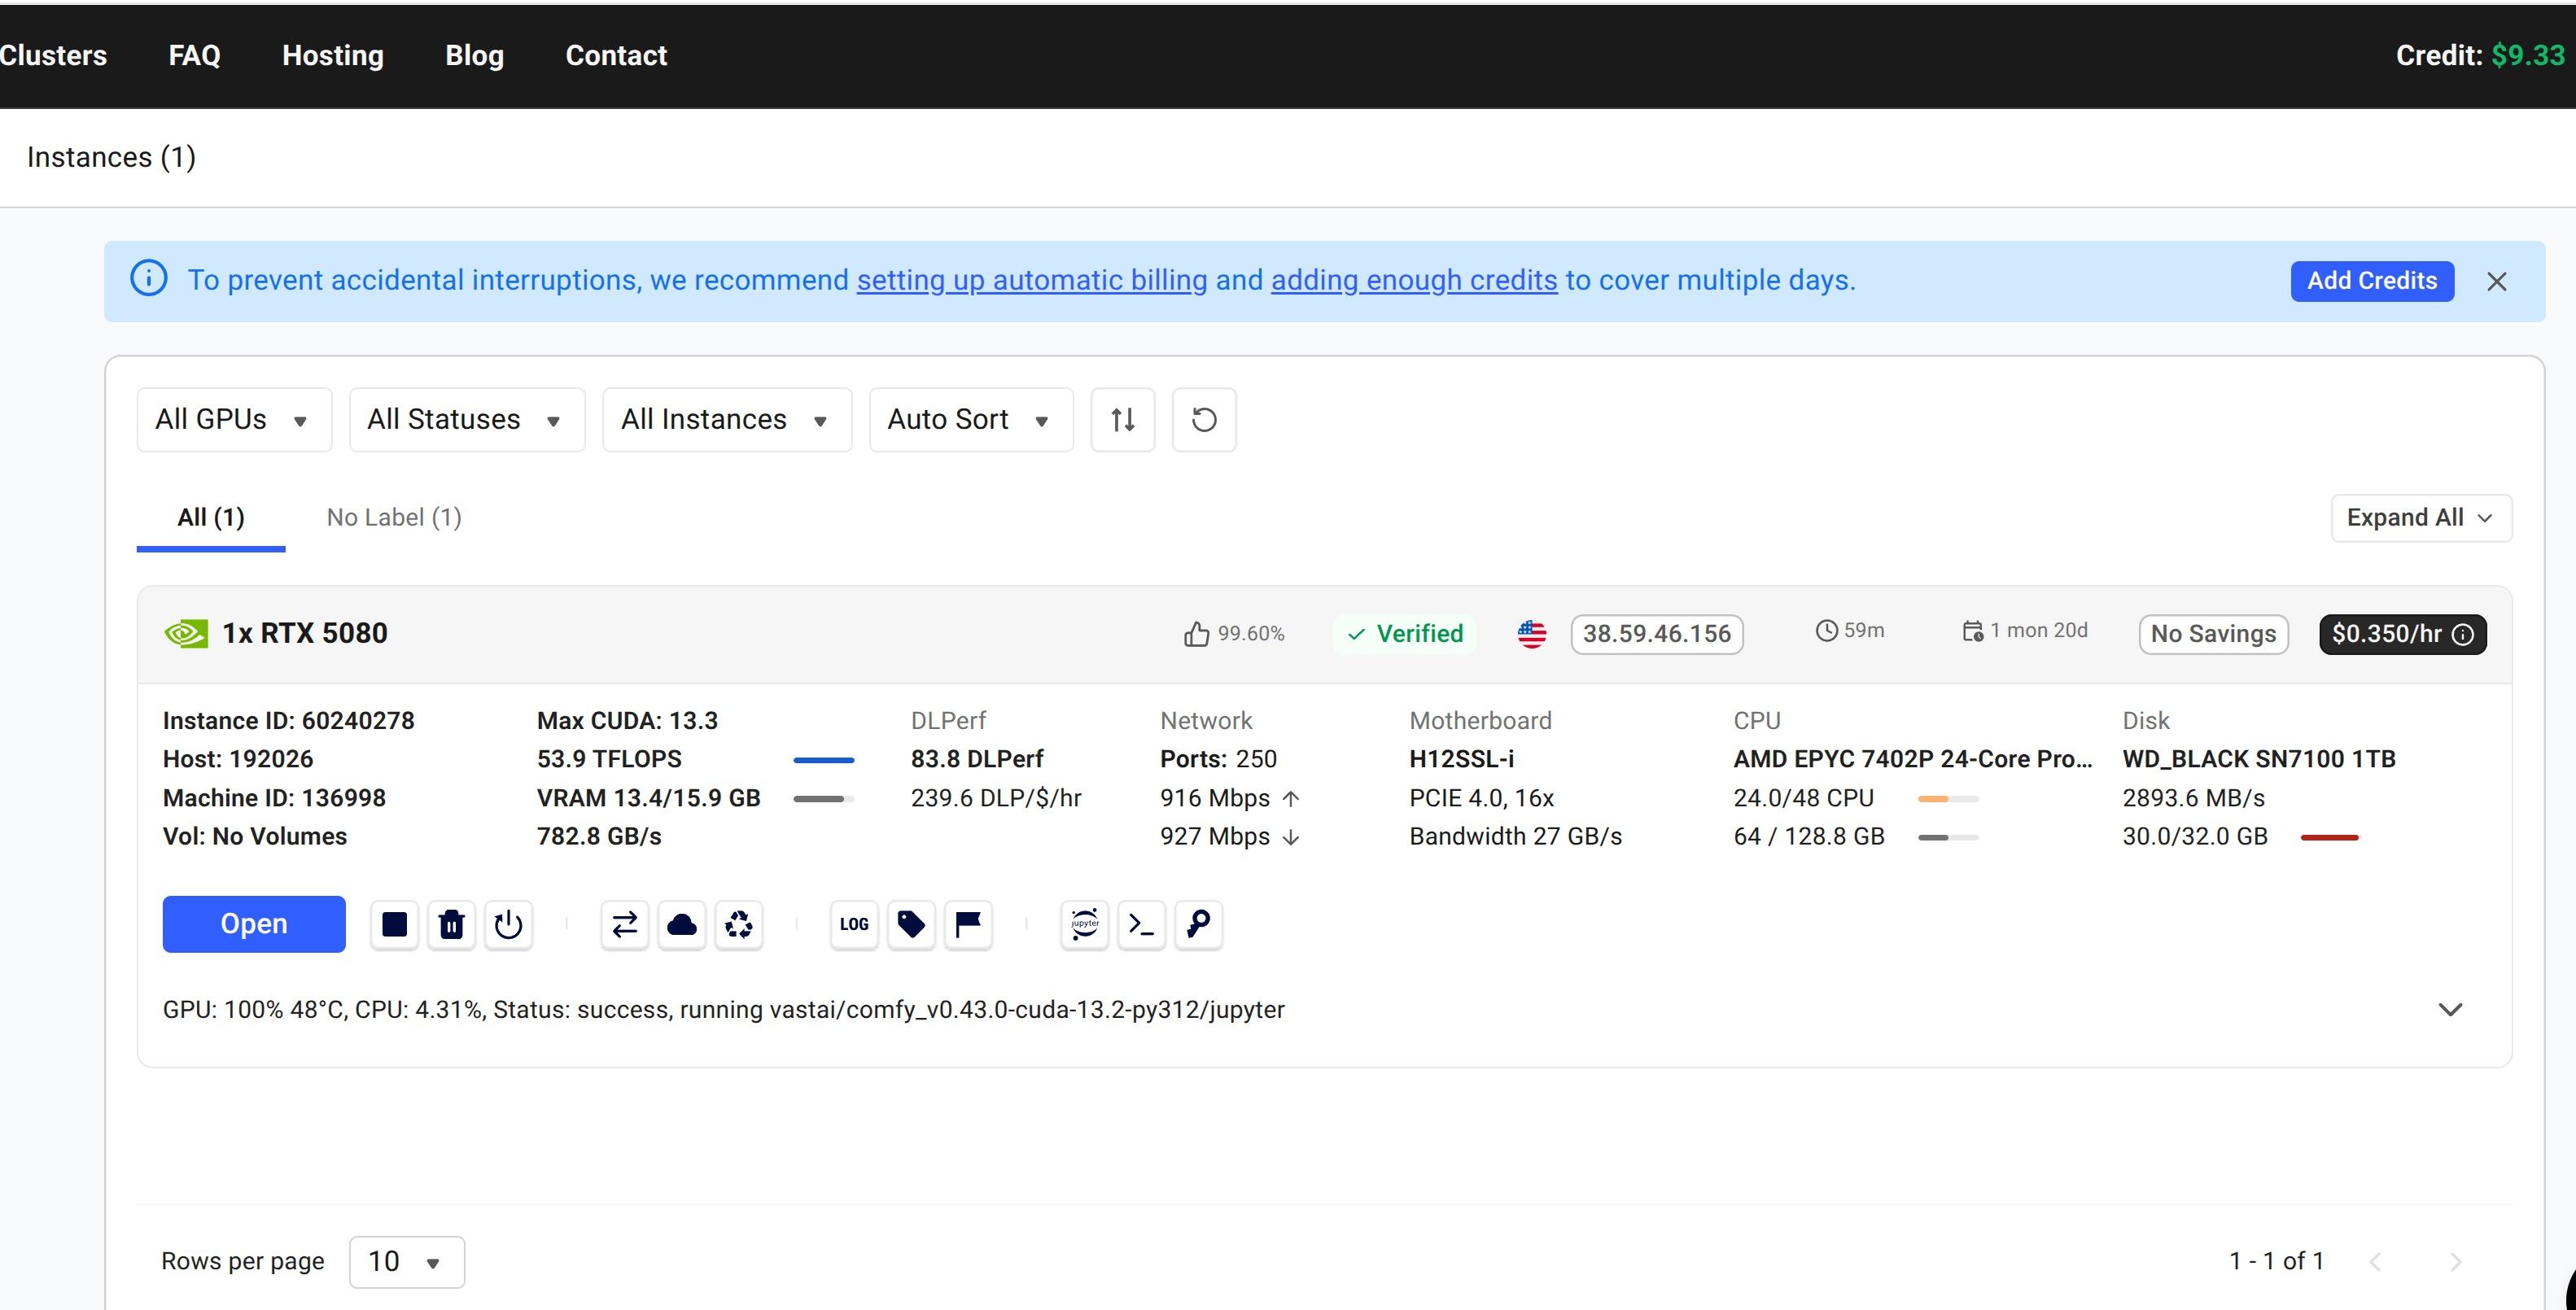
在 8 秒、1080p、7 张参考图这项里,5070 Ti 的 E2E 是 632 秒,双 7900 XTX TP2 是 1166 秒。测完后我买了张 5070 Ti 专门跑 H3,双 7900 XTX 留给 Strata。
1080p 这组用的是之前做的《雨伞》短片场景:YouTube 成片。
测试设置
- MiniMax H3 hybrid INT8-ConvRot 基座,Pika H3 Flex LoRA,strength 1.0。
- LCM、CFG 1、6 steps、Sol-Attn,24 fps。
- 测了 8 秒 768p / S01 / 5 张参考图、15 秒 768p / S01–S03 / 7 张参考图,以及 8 秒 1080p / S01–S03 / 7 张参考图。
- 同规格对照复用同一组提示词、参考图和 seed。
- E2E 从任务开始到 MP4 导出,包含 conditioning、DiT、视频和音频 VAE;不含模型下载。
- 成片通过 ffprobe 和完整 FFmpeg 解码检查。我没有做主观画质评分。
Vast 的卡都在不同主机上跑,CPU、RAM、SSD 和 PCIe 链路不一致;本机 AMD 使用的 ROCm 软件栈也不同。所以下面是整机环境下的实测,适合做购买参考,不能当成控制变量后的 GPU 单项排名。
E2E 结果
单位是秒,越低越快。三列依次对应:8 秒 768p(S01、5 张参考图)、15 秒 768p(S01–S03、7 张参考图)、8 秒 1080p(S01–S03、7 张参考图)。
GPU 8 秒 768p 15 秒 768p 8 秒 1080p RTX 5080 16GB 294.83 515.32 548.99 RTX 4080 SUPER 16GB 323.91 570.39 611.83 RTX 4080 SUPER 实测 32GB 281.47 627.76 675.82 RTX 5070 Ti 16GB 332.67 594.00 632.41 双 RX 7900 XTX TP2 阶段和约 538.27¹ — 1166.37 ¹ 7900 XTX 的 8 秒 768p 没有统一 E2E 计时;538.27 秒是 conditioning、DiT 和 VAE 阶段相加,不含可对齐的 MP4 导出时间。
8 秒 1080p 这项,5070 Ti 大约用了双 7900 XTX TP2 54% 的时间。单卡 5070 Ti 在这次工作流里快约 1.84 倍。这个差距挺明显,不过两边不是同一套软件和硬件环境,不能把倍率推广到所有 H3 工作流。
5080 在 15 秒 768p 和 8 秒 1080p 两项最快;8 秒 768p 则是实测 32GB 显存的 4080 SUPER 最快,281.47 秒。5070 Ti 和 4080 SUPER 16GB 的三项成绩彼此接近。两台 4080 SUPER 来自不同主机:32GB 那台在 768p S01 领先,但另外两项都比 16GB 那台慢;它还观测到 PCIe 4.0 ×8,所以不能只看显存容量解释差异。
Vast.ai 实例配置
下面是测试时面板显示的配置和挂牌价;价格会随主机变化。
GPU 显存 CPU / 系统 RAM SSD / 实测速度 PCIe 当时价格 RTX 5080 16GB AMD EPYC 7402P 24-Core / 128.8GB WD_BLACK SN7100 1TB / 2775MB/s PCIe 4.0 ×16 $0.350/h RTX 4080 SUPER 16GB Intel Xeon W-2155 / 64GB Kingston SNV3S500G 500GB / 1086MB/s 未记录 $0.184/h RTX 4080 SUPER 实例 约 32GB¹ AMD EPYC 7702 64-Core / 85.9GB Kingston SFYRD2000G 2TB / 3860MB/s PCIe 4.0 ×8 $0.336/h RTX 5070 Ti 16GB AMD EPYC 7282 16-Core / 128.7GB Corsair MP600 ELITE / 4568MB/s 未记录 $0.356/h ¹ Vast 面板显示 RTX 4080 SUPER;运行时读到的可用显存是 32,760 MiB。
几台 Vast 实例都用 ComfyUI 0.43.0、PyTorch 2.10.0+cu130,启动参数是
--disable-dynamic-vram、--lowvram、--use-ck-attention。本机双 7900 XTX 是 Ryzen 9 3900X、125GiB RAM,ComfyUI 0.43、PyTorch 2.14.0+ROCm 7.2,DiT 走 TP2 分在两张卡上。offload 和 16GB 显存
这次我觉得很有意思的一点,是 16GB NVIDIA 实例上的 ComfyUI 日志:大约 19,999 MB 的 DiT 权重被 offload 到主机 RAM,日志里当时 GPU 常驻权重是 0 MB,另有约 1,397 MB buffer。模型计算还是在 GPU 上做,权重按需搬过去。
所以“16GB 显存全拿来放 QKV”不太准确。权重 offload 确实给显存腾出了不少空间,但 GPU 还要放当前计算层、激活、Q/K/V 和注意力临时张量等。更准确地说,是把大部分 DiT 权重放在系统 RAM 管理,让显存有更多余量给计算过程。
7900 XTX 也能做 CPU/RAM offload,我自己的体验是这样会慢很多。不过这次双 7900 XTX 的数据是 TP2,不是 CPU offload 跑出来的,不能把 1166 秒当成 AMD offload 模式的成绩。
时长上也有边界:16GB 的 5080、5070 Ti 和 4080 SUPER 都在 1080p / 10 秒测试中 OOM;32GB 的 4080 SUPER 没测 10 秒。双 7900 XTX 以前跑通过 12 秒 1080p,但那次是 W4A8 基座、4 张参考图,和这里的 7 图 INT8 工作流不同,不拿来比速度。
最后
测完我买了 RTX 5070 Ti 专门跑 H3,双 7900 XTX 继续跑 Strata。对我来说,这次最大的收获不是哪张卡跑分高,而是把自己的工作流放上去之后,知道了真实速度和显存边界。
跑 H3 这种大模型,生态、软件实现和驱动支持,有时候确实比纸面算力还重要。
-
-
@kos-or 刚开车去把方圆40公里唯一一张二手5070ti 抢回来了,现在在跑测试,比vast.ai上的测试还快一丢丢,感觉性价比拉满。
本机 RTX 5070 Ti 单卡复测(无 TP2)
本轮是在拔掉两张 RX 7900 XTX、改装 RTX 5070 Ti 后进行。RTX 5070 Ti 单卡负责 H3 推理;5700 XT 接在 PCIe 4.0 ×4 插槽用于显示,未被 CUDA 推理使用。5070 Ti 自身的 PCIe 链路宽度没有记录。
场景 CLIP encode 参考图 VAE Conditioning 图 DiT sampler 视频 VAE decode / 阶段 音频 VAE decode / 阶段 E2E 峰值显存 8 秒 768p,S01,5 图 未单独记录 未单独记录 30.36s(CLIP 与参考图 VAE 合计图时间) 205.11s 45.23s / 54.85s 4.33s / 4.77s 327.20s¹ 14,595 MiB(14.25 GiB) 15 秒 768p,S01–S03,7 图 29.54s(权重加载 0.73s) 2.52s 33.52s 404.62s 73.42s / 86.74s 0.80s / 1.05s 561.89s 14,433 MiB(14.09 GiB) 两段输出均为 1366×768、24fps;8 秒为 192 帧,15 秒为 360 帧。ffprobe 检查通过,且完整 FFmpeg 解码返回成功。
本机环境:RTX 5070 Ti 16GB、AMD Ryzen 9 3900X、125 GiB 系统内存;ComfyUI 0.43.0、PyTorch 2.10.0+cu130、CUDA 13.0、Comfy Kitchen CUDA Sol-Attn,启动参数
--disable-dynamic-vram --lowvram --use-ck-attention。单卡运行,没有 TP2。 -
-
-
-
-
-
-
AMD的卡後台搞好產圖挺快的(走機智羅那一套),直接套NV的環境會慘不忍睹,就算後台搞好跑H3真的差這麼多喔?
-
-
我看了一下我是用ddr3和pcie3.0洋垃圾x99cd3跑的,gpu 一直满载功率也满载,所以怀疑pcie不是瓶颈,之前看网上有人说32g内存会不够768p 15秒长视频 64G内存会比较舒适,如果是oom可能还是内存不够,我测的5070ti 768p 15秒 8步 是 702.2 s 不过可能测试参数不一样,我也是刚学comfyUI几天好多还不太懂,查AI也总是误导,说要升 pcie 5.0,但是搭配 ddr5实在太贵,64G现在五六千,成本太高,我就先用自己的老平台ddr3试了试没想到效果还不错
-
我看了一下我是用ddr3和pcie3.0洋垃圾x99cd3跑的,gpu 一直满载功率也满载,所以怀疑pcie不是瓶颈,之前看网上有人说32g内存会不够768p 15秒长视频 64G内存会比较舒适,如果是oom可能还是内存不够,我测的5070ti 768p 15秒 8步 是 702.2 s 不过可能测试参数不一样,我也是刚学comfyUI几天好多还不太懂,查AI也总是误导,说要升 pcie 5.0,但是搭配 ddr5实在太贵,64G现在五六千,成本太高,我就先用自己的老平台ddr3试了试没想到效果还不错
-
-
-
-
@kos-or 刚开车去把方圆40公里唯一一张二手5070ti 抢回来了,现在在跑测试,比vast.ai上的测试还快一丢丢,感觉性价比拉满。
本机 RTX 5070 Ti 单卡复测(无 TP2)
本轮是在拔掉两张 RX 7900 XTX、改装 RTX 5070 Ti 后进行。RTX 5070 Ti 单卡负责 H3 推理;5700 XT 接在 PCIe 4.0 ×4 插槽用于显示,未被 CUDA 推理使用。5070 Ti 自身的 PCIe 链路宽度没有记录。
场景 CLIP encode 参考图 VAE Conditioning 图 DiT sampler 视频 VAE decode / 阶段 音频 VAE decode / 阶段 E2E 峰值显存 8 秒 768p,S01,5 图 未单独记录 未单独记录 30.36s(CLIP 与参考图 VAE 合计图时间) 205.11s 45.23s / 54.85s 4.33s / 4.77s 327.20s¹ 14,595 MiB(14.25 GiB) 15 秒 768p,S01–S03,7 图 29.54s(权重加载 0.73s) 2.52s 33.52s 404.62s 73.42s / 86.74s 0.80s / 1.05s 561.89s 14,433 MiB(14.09 GiB) 两段输出均为 1366×768、24fps;8 秒为 192 帧,15 秒为 360 帧。ffprobe 检查通过,且完整 FFmpeg 解码返回成功。
本机环境:RTX 5070 Ti 16GB、AMD Ryzen 9 3900X、125 GiB 系统内存;ComfyUI 0.43.0、PyTorch 2.10.0+cu130、CUDA 13.0、Comfy Kitchen CUDA Sol-Attn,启动参数
--disable-dynamic-vram --lowvram --use-ck-attention。单卡运行,没有 TP2。 -
-
,
 T terry 引用了 此主题
-
-





 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!
 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!