【34.5 min → 3.3 min】用对注意力机制的2×7900XTX在H3流程中可以提速多少?—— 答案1050%↑
-
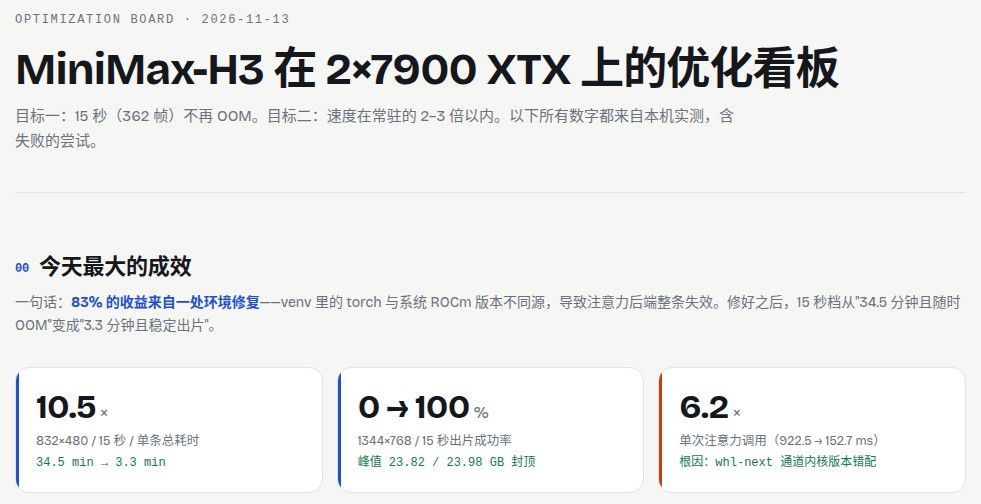
10.5×的提升有点神奇噢,但这跟我Comfy UI的体质有直接关系

因为常常做一现数据的复现,所以本地的Comfy Ui的环境已经被我搞得非常地复杂。大家可以简单地把它理解为我把它弄残了。832×480 / 15 秒 / 单条总耗时能跑出半个多小时。就是因为注意力机制后端失效。现在在捋顺的情况下,此消彼涨,数据自然很夸张。当然,也有间接的好处:在没有过度粉饰的情况下拿它拿标题就很吸睛。唉,就是传说中的标题党,震惊部。

这套项目该有的正常表现,希望大家多多跟贴。
--------------------分割线-----------------------
MiniMax-H3 · 7900 XTX 优化看板(文字版)
日期:2026-11-13
平台:AMD Radeon RX 7900 XTX 24 GB ×2 / ROCm 7.2.0 / ComfyUI(/home/jay/ComfyUI-AMD)
工作流:MiniMax-H3(minimax_h3_fl2va_pruned-w4a8_convrot+ turbo LoRA v4 step600)本文是 HTML 看板的 Markdown 版本,结构、数字与判定完全一致;图表以数据表 + 走势描述呈现。
00 今天最大的成效
一句话:83% 的收益来自一处环境修复——venv 里的 torch 与系统 ROCm 版本不同源,导致注意力后端整条失效。修好之后,15 秒档从"34.5 分钟且随时 OOM"变成"3.3 分钟且稳定出片"。
指标 数值 说明 单条总耗时 10.5× 832×480 / 15 秒:34.5 min → 3.3 min 出片成功率 0 → 100% 1344×768 / 15 秒,峰值 23.82 / 23.98 GB 单次注意力 6.2× 922.5 ms → 152.7 ms,根因是 whl-next 通道内核错配
01 两个目标的判定
目标 今天之前 现在 判定 15 秒不 OOM 1344×768 直接崩溃(音频 VAE 申请 3.07 GiB 失败);832×480 靠 sub_quad 勉强跑但 34.5 min 832×480 与 1344×768 均稳定出片;峰值 20.0 / 23.82 GB 达成 速度在常驻 2–3 倍内 常驻路径本身不可用,无法比较 0.4 MP 不触发权重换出,DynamicVRAM 开销仅 3.5%,等效 1.03× 常驻 超额达成 前提变化:0.4 MP 根本不需要 offload(权重 11.9 GB + 激活 6–8 GB 可共存),所以"2–3 倍代价"这把尺子只对 1 MP 成立;而 1 MP 我们用 TP2 把权重对半分(每卡 6 GB),是绕开 offload,而不是把它做快。
02 改动贡献:逐层叠加
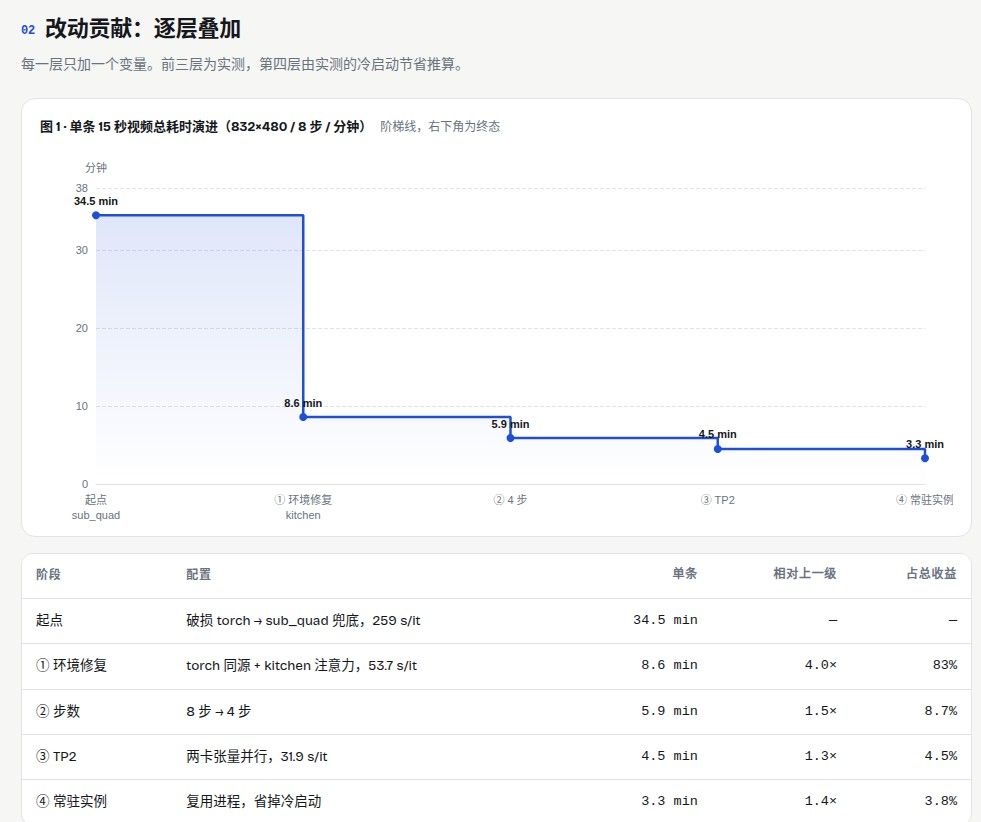
每一层只加一个变量。前三层为实测,第四层由实测的冷启动节省推算。
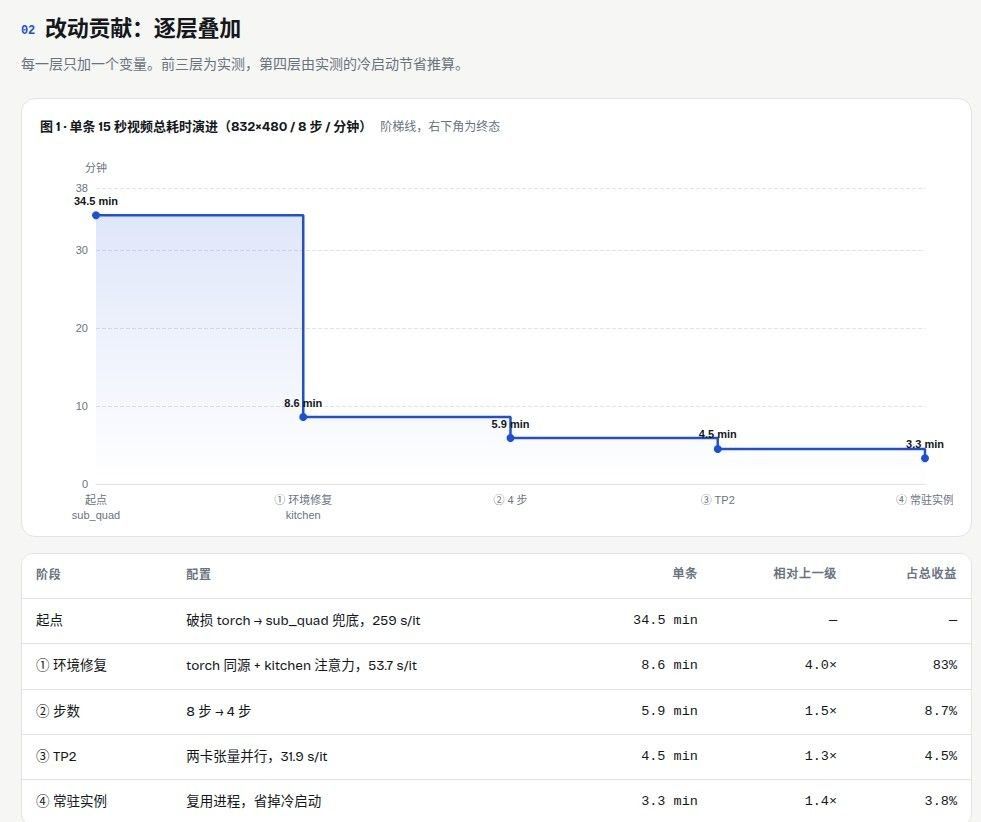
图 1 · 单条 15 秒视频总耗时演进(832×480 / 8 步)
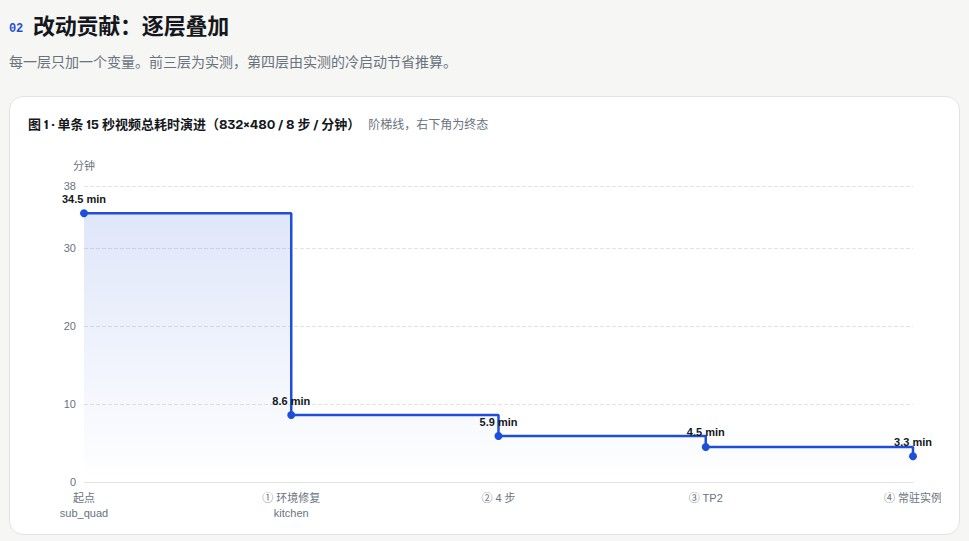
阶段 配置 单条 相对上一级 占总收益 起点 破损 torch → sub_quad 兜底,259 s/it 34.5 min — — ① 环境修复 torch 同源 + kitchen 注意力,53.7 s/it 8.6 min 4.0× 83% ② 步数 8 步 → 4 步 5.9 min 1.5× 8.7% ③ TP2 两卡张量并行,31.9 s/it 4.5 min 1.3× 4.5% ④ 常驻实例 复用进程,省掉冷启动 3.3 min 1.4× 3.8%
03 核心指标:每步耗时(s/it)
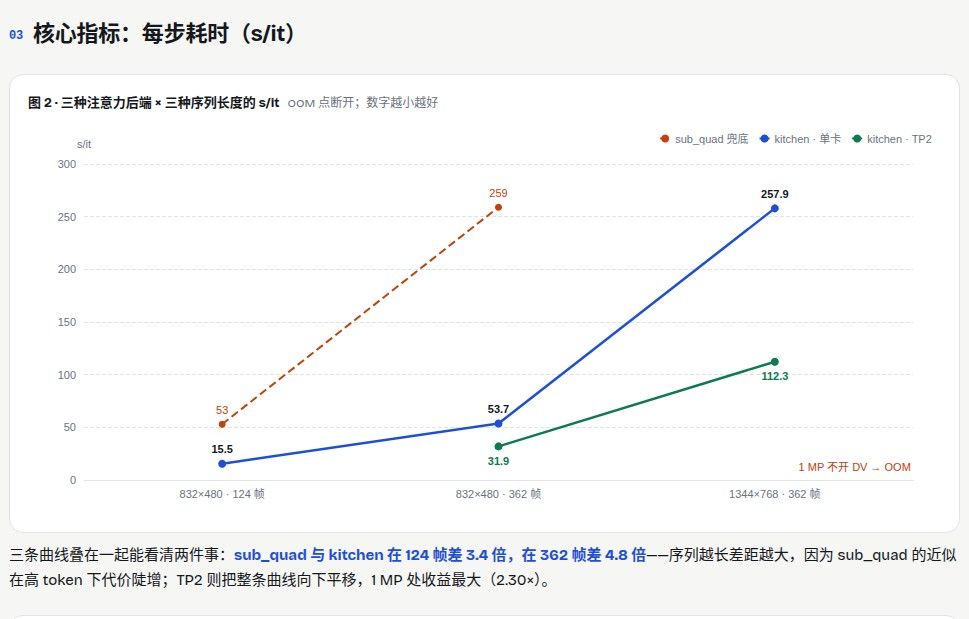
图 2 · 三种注意力后端 × 三种序列长度
场景 sub_quad 兜底 kitchen · 单卡 kitchen · TP2 832×480 · 124 帧 53 15.5 — 832×480 · 362 帧 259 53.7 31.9 1344×768 · 362 帧 OOM 257.9 112.3 走势:sub_quad 与 kitchen 在 124 帧差 3.4 倍,在 362 帧差 4.8 倍——序列越长差距越大;TP2 把整条曲线向下平移,1 MP 处收益最大(2.30×)。
图 3 · 每 token 耗时随序列长度增长
序列长度 ms/token 相对 48k 48k 0.32 1.0× 84k 0.72 2.3× 142k 1.82 5.7× 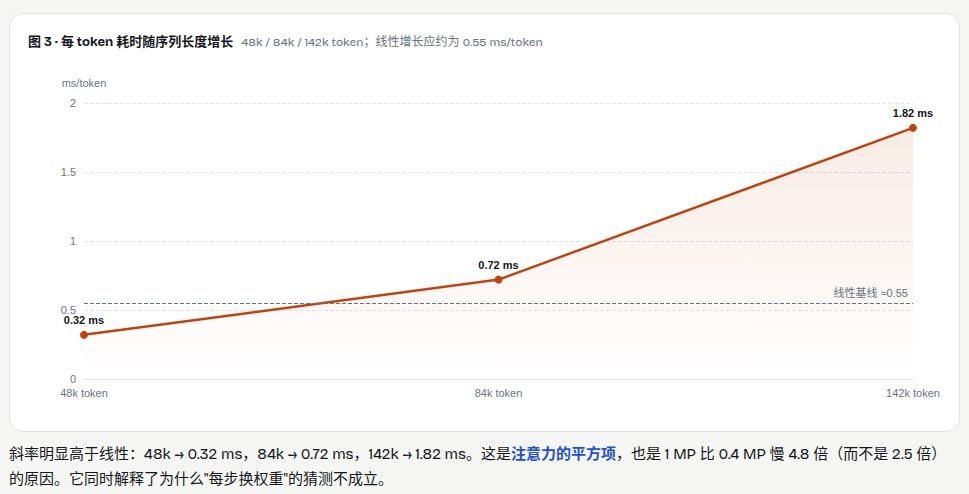
线性基线应约 0.55 ms/token,实测斜率明显更陡。这是注意力的平方项,也是 1 MP 比 0.4 MP 慢 4.8 倍(而不是 2.5 倍)的原因,同时排除了"每步换权重"的猜测。
04 显存:真正的墙在哪
图 4 · 峰值显存与 24 GB 物理上限
配置 峰值 占可用上限(23.98 GB) 0.4 MP · 不开 DV 18.65 GB 77.8% 0.4 MP · 开 DV 19.96 GB 83.2% 1 MP · 开 DV 单卡 23.82 GB 99.3% 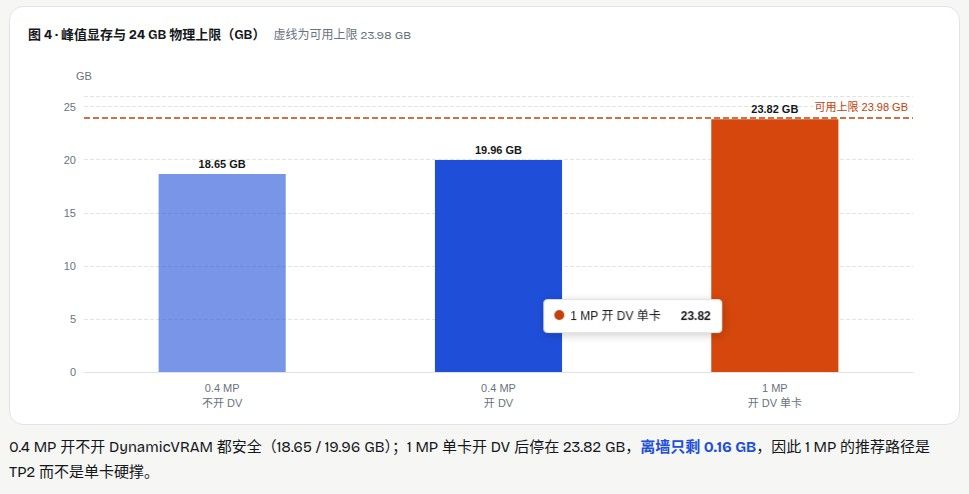
0.4 MP 开不开 DynamicVRAM 都安全;1 MP 单卡开 DV 后离墙只剩 0.16 GB,因此 1 MP 的推荐路径是 TP2 而不是单卡硬撑。
05 失败档案:走过的弯路
失败项不是噪声,它们各自排除了一个假设。
F1 · torch 版本错配 → SDPA 全后端失效
whl-next 的2.14.0+rocm10.1.0链到系统 ROCm 7.2,AOTriton 内核加载即失败,报hipErrorInvalidImage,ComfyUI 静默退回 sub_quad。
教训:ROCm 环境里必须让 wheel 与系统 ROCm 同源,否则内核不可用且不报错,只降速。F2 · sub_quad 兜底能跑,但慢 6 倍
922.5 ms/次注意力,端到端 490 s。能出片,掩盖了"后端已坏"这个事实。
教训:"能出片"不等于"跑在正确路径上",需要用微基准校验单算子延迟。F3 ·
--novram:权重全放 CPU 反而更慢
362 帧实测 275 s/it,比全驻留的 259 还差 6%。
教训:直接证伪"权重换入换出是瓶颈",也是后来判定不做逐 block 流式的关键证据。F4 · max_split_size_mb 调优:噪声内
54.3 vs 56.4 s/it,差异小于批次抖动;DV 模式下该参数本就不参与分配。
教训:碎片类参数只在显存分配器主导时有意义,aimdo 用 VBAR 绕过了它。F5 · 1 MP 不开 DV:FFN 6.25 GB 分配失败
权重 11.9 GB 常驻后,激活峰值无处安放,第一步就 OOM。
教训:1 MP 必须开 DV 或 TP2,没有第三条路。F6 · 1 MP + chunk 节点:302 s/it,第 2 步仍 OOM
分块 FFN 把单次分配压下去了,但总驻留没降。
教训:峰值削峰不等于总量够用,要看"权重 + 激活"的总账。F7 · 以为 pytorch 注意力是安全回退,结果也 OOM
修好 torch 后 SDPA 走 math 后端,attention.py:615在 124 帧就要单次分配 23.06 GiB,362 帧无解。
教训:kitchen 不是"更快的选项",而是当前 build 下唯一能跑的通路。F8 · 同 seed 重复提交:7.1 s 的假加速
ComfyUI 节点缓存命中,看起来像 30 倍提速。
教训:测冷热启动必须换 seed,否则结论全废。F9 · avcodec EINVAL:最后一步毁掉整条任务
视频流已 flush,封装音频时返回 22,362 帧批次普遍出现,10 分钟算力白费。
教训:已加"降级为无声视频"兜底;根因未定位,属已知残留问题。F10 · 逐 block 流式(方案 B):判定不做
原计划自研 pinned CPU + 侧流预取。前提是"259 s/it 来自权重抖动",而该前提被 F3 与图 3 同时证伪。
教训:aimdo 的 VBAR 已是同类机制(实测只值 3.5%),再写一套只会更慢。重启条件:--novram慢 2 倍以上。F11 · 移植 comfy-aimdo 原生层:不可行
它是 CUDA VMM(VBAR / 32 MB 页 / fault / watermark),NVIDIA 专有接口。
教训:ROCm 版aimdo_rocm.so存在,只是被rocm >= 7.14的版本闸挡住——这才是--enable-dynamic-vram生效的原因。F12 · 音频 VAE 一次性编码:15 秒档必崩
1344×768 / 362 帧时申请 3.07 GiB 失败。
教训:按 5 秒切段编码(_encode_audio_chunked)后 OOM 消失,是目标一的基础。
06 本机环境与软件栈(复现基线)
版本错配(见 F1)会直接导致 6 倍降速,下表为实测时的确切版本。
硬件
项目 实测值 备注 GPU AMD Radeon RX 7900 XTX 24 GB ×2 gfx1100,RDNA3 显存可用上限 23.98 GB rocm-smi 报告 24560 MiB PCIe 4.0 ×8(8.0 GT/s) 非 ×16,影响主机  显存搬运
CPU Intel Xeon E5-2696 v4 @ 2.20 GHz — 内存 125 GB 足够放下 26 GB 文本编码器 软件栈
组件 版本 关键性 OS Ubuntu 24.04.5 LTS,kernel 7.0.0-42-generic — ROCm 7.2.26015-fc0010cf6a 必须与 torch 同源 Python 3.12.3 venv: /home/jay/ComfyUI-AMD/venvtorch 2.14.1+rocm7.2 核心修复 torchvision 0.29.1+rocm7.2 随 torch 同步 torchaudio 2.11.0+rocm7.2 随 torch 同步 triton 3.8.0+git669b31ac.rocm10.1.0 仍为 10.1 构建,残留风险 numpy / safetensors / av 2.5.4 / 0.8.0 / 19.0.2 — ComfyUI commit 423cbd20(2026-10-30) /home/jay/ComfyUI-AMD/ComfyUITP 扩展 comfyui-tp2 日志出现 heads 56->28即生效模型文件
角色 文件 体积 DiT(生产用) minimax_h3_fl2va_pruned-w4a8_convrot_pruned 11.7 GB DiT(对照) minimax_h3_fl2va_pruned_int8_convrot 20 GB 文本编码器 qwen3vl_32b_minimax_h3-w4a8_convrot 26 GB 视频 VAE Minimax_h3_video_vae_fp16 4.9 GB 音频 VAE Minimax_H3_fp32_audio_vae 578 MB LoRA minimax_h3_turbo_v4_step600_ema_pruned_comfyui 592 MB 环境自检(复现前先跑这三条)
/opt/rocm-7.2.0/bin/hipconfig --version          # 期望 7.2.26015-fc0010cf6a
/home/jay/ComfyUI-AMD/venv/bin/python -m pip list | grep -E "^(torch|triton)"
# 期望 torch 2.14.1+rocm7.2
/home/jay/ComfyUI-AMD/venv/bin/python attn_path_bench.py   # 期望 seq=8192 单次 ≤200 ms
若出现
hipErrorInvalidImage或单次注意力 > 800 ms,说明内核与运行时再次错配,执行回退。
07 复现步骤与期望值
所有命令在
/home/jay/tp2下执行。前置:strata.service为 active(日常双卡态)。# 通用启动 COMFY=/home/jay/ComfyUI-AMD/ComfyUI \ PY=/home/jay/ComfyUI-AMD/venv/bin/python \ EXTRA_ARGS="--enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory" \ bash run_tp.sh <world> <base_port> <tag> # 收尾(必须执行,恢复日常态) pkill -f "port <base_port>" bash /home/jay/strata/scripts/gpu-mode.sh release --reason "bench done"通用 bench 模板
/home/jay/sglang-venv/bin/python bench.py \
  --ports <port> --outdirs logs/<tag>/o --timings logs/<tag>/t.json \
  --unet minimax_h3_fl2va_pruned-w4a8_convrot_pruned.safetensors \
  --clip qwen3vl_32b_minimax_h3-w4a8_convrot.safetensors \
  --vae Minimax_h3_video_vae_fp16.safetensors \
  --audio-vae Minimax_H3_fp32_audio_vae.safetensors \
  --lora minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors \
  --width <W> --height <H> --frames <F> --steps <N> --seed <S> \
  --tag <tag> --result logs/<tag>/r.json
场景与期望值
场景 参数 期望 s/it 期望端到端 峰值 S1 注意力自检 attn_path_bench.py ≤200 ms/次 — — S2 0.4 MP / 15 s / 8 步 / 单卡 832×480, 362f, seed 201 53.7 ±10% 517 s ±15% 20.0 GB S3 0.4 MP / 15 s / 8 步 / TP2 同上,双卡端口 31.9 ±10% ≈4.3 min — S4 1 MP / 15 s / 2 步 / TP2 1344×768, 362f 112.3 ±10% 3:44 采样 未测 S5 1 MP / 15 s / 2 步 / 单卡 同上 257.9 ±10% 662 s ≤23.9 GB S6 热启动 同实例第二条,换 seed — 81.3 s(-49%) — 测量陷阱:同 seed 重复提交会命中 ComfyUI 节点缓存,得到 7.1 s 的假加速(F8)。所有对比必须换 seed。
08 回退与环境还原
SP=/home/jay/ComfyUI-AMD/venv/lib/python3.12/site-packages
B=/home/jay/ComfyUI-AMD/backup_whlnext_20261113
rm -rf $SP/torch $SP/torchvision $SP/torchaudio $SP/triton
cp -a $B/torch $B/torchvision $B/torchaudio $B/triton $B/*.dist-info $SP/
去掉
--use-ck-attention等参数启动即回到原始路径(会退回 sub_quad,速度约为当前的 1/6)。
附:数据来源与口径
-
数据来源:本机 2026-11-13 实测日志(
/home/jay/tp2/logs/)。 -
图中"推算"项已标注:TP2 + 4 步的端到端为采样实测 + 冷启动开销推算,非整条实测。
-
未验证项:640×368 / 362 帧在 kitchen 下的数字未重测;1 MP 的 4 步为外推。
-
-
-
-
,
 T terry 固定了此主题
-
当有人提醒我:不要给雄杰-高加精置顶,否则他会抢了风头的时候,我是拒绝的。
我弟除了帅气的外表,不羁的气质,更为难得的是他懂显卡!
你知道吗,老黄因为黄乐懂显卡,不惜涉间谍罪。
据说懂王力推库克接任英伟达CEO,那么问题来了,如果库克接手,谁能拿下库克?
我对着镜子照了照,自己,机会应该是0,但如果我弟出马,那就是轻松拿下。
为了论坛用户的福利,人人用上免费的N卡,我决定拍杰杰的马屁。
有杠精会说,他测试的是A卡。我反问:拿下Lisa-Su,用上免费的MI300,我就问你们,够不够? -
当有人提醒我:不要给雄杰-高加精置顶,否则他会抢了风头的时候,我是拒绝的。
我弟除了帅气的外表,不羁的气质,更为难得的是他懂显卡!
你知道吗,老黄因为黄乐懂显卡,不惜涉间谍罪。
据说懂王力推库克接任英伟达CEO,那么问题来了,如果库克接手,谁能拿下库克?
我对着镜子照了照,自己,机会应该是0,但如果我弟出马,那就是轻松拿下。
为了论坛用户的福利,人人用上免费的N卡,我决定拍杰杰的马屁。
有杠精会说,他测试的是A卡。我反问:拿下Lisa-Su,用上免费的MI300,我就问你们,够不够? -
-
@xiongjie-gao 不过我还是没认真看,明天又有事,简单总结下,这是双卡提升方案,单卡呢?单卡可以另发一个帖子,尝试下优化极限。
@懒人烘培 我弟你懈怠了啊,周末发力! -
,T terry 引用了 此主题
-
@xiongjie-gao 不过我还是没认真看,明天又有事,简单总结下,这是双卡提升方案,单卡呢?单卡可以另发一个帖子,尝试下优化极限。
@懒人烘培 我弟你懈怠了啊,周末发力!@terry 已经包含单双卡的提升可能。
单卡就是不享受TP2带来的1.3的提升倍率。不过随着分辨率提升享受摊薄收益。
7900XTX单卡提升是不是只是不享受TP2的1.3倍率?测个样本试试20:40
TRAE
任务耗时 1m 16s
已创建 1 个文件,读取 2 个文件,搜索 1 次文件,执行 7 条命令
对照实验已跑起来(Strata 已挂起,两档都用 832×480 / 362 帧 / 4 步 / 同一 seed,只差单卡与 TP2):
- ① 单卡 356 s 左右
- ② TP2 257 s 左右
约 15 分钟出结果。先说清楚这条“1.3×”其实不统一,跑完正好能核对:
档位 TP2 倍率 依据 0.4 MP / 4 步 1.39× 356.4 → 257 s 0.4 MP / 8 步 1.68× 53.7 → 31.9 s/it 1 MP / 2 步 2.30× 257.9 → 112.3 s/it
所以“单卡只是少了 1.3×”只在 4 步那一档成立。8 步时是 1.68×,1 MP 时是 2.30×——序列越长,TP2 收益越大,因为它的作用是把每张卡的权重和激活同时减半,不只是并行算力。
还有一个更根本的点值得这次一并验证: 10.5× 里 TP2 只占 4.5% 。单卡相对起点的真实提升是 34.5 min → 5.9 min,约 5.85× ,不是 10.5×。10.5× 是把“TP2 + 常驻实例”也叠上去了,而那两项是有条件的(要双卡、要连续出片)。如果这次测出单卡确实落在 5.9 min 附近,就说明我们的报告头号数字需要标注成“叠满配置后的上限”,而不是单卡能力。
跑完我把两档的 s/it、端到端、峰值一起给你。
-
@xiongjie-gao 不过我还是没认真看,明天又有事,简单总结下,这是双卡提升方案,单卡呢?单卡可以另发一个帖子,尝试下优化极限。
@懒人烘培 我弟你懈怠了啊,周末发力! -
10.5×的提升有点神奇噢,但这跟我Comfy UI的体质有直接关系
因为常常做一现数据的复现,所以本地的Comfy Ui的环境已经被我搞得非常地复杂。大家可以简单地把它理解为我把它弄残了。832×480 / 15 秒 / 单条总耗时能跑出半个多小时。就是因为注意力机制后端失效。现在在捋顺的情况下,此消彼涨,数据自然很夸张。当然,也有间接的好处:在没有过度粉饰的情况下拿它拿标题就很吸睛。唉,就是传说中的标题党,震惊部。
这套项目该有的正常表现,希望大家多多跟贴。
--------------------分割线-----------------------
MiniMax-H3 · 7900 XTX 优化看板(文字版)
日期:2026-11-13
平台:AMD Radeon RX 7900 XTX 24 GB ×2 / ROCm 7.2.0 / ComfyUI(/home/jay/ComfyUI-AMD)
工作流:MiniMax-H3(minimax_h3_fl2va_pruned-w4a8_convrot+ turbo LoRA v4 step600)本文是 HTML 看板的 Markdown 版本,结构、数字与判定完全一致;图表以数据表 + 走势描述呈现。
00 今天最大的成效
一句话:83% 的收益来自一处环境修复——venv 里的 torch 与系统 ROCm 版本不同源,导致注意力后端整条失效。修好之后,15 秒档从"34.5 分钟且随时 OOM"变成"3.3 分钟且稳定出片"。
指标 数值 说明 单条总耗时 10.5× 832×480 / 15 秒:34.5 min → 3.3 min 出片成功率 0 → 100% 1344×768 / 15 秒,峰值 23.82 / 23.98 GB 单次注意力 6.2× 922.5 ms → 152.7 ms,根因是 whl-next 通道内核错配
01 两个目标的判定
目标 今天之前 现在 判定 15 秒不 OOM 1344×768 直接崩溃(音频 VAE 申请 3.07 GiB 失败);832×480 靠 sub_quad 勉强跑但 34.5 min 832×480 与 1344×768 均稳定出片;峰值 20.0 / 23.82 GB 达成 速度在常驻 2–3 倍内 常驻路径本身不可用,无法比较 0.4 MP 不触发权重换出,DynamicVRAM 开销仅 3.5%,等效 1.03× 常驻 超额达成 前提变化:0.4 MP 根本不需要 offload(权重 11.9 GB + 激活 6–8 GB 可共存),所以"2–3 倍代价"这把尺子只对 1 MP 成立;而 1 MP 我们用 TP2 把权重对半分(每卡 6 GB),是绕开 offload,而不是把它做快。
02 改动贡献:逐层叠加
每一层只加一个变量。前三层为实测,第四层由实测的冷启动节省推算。
图 1 · 单条 15 秒视频总耗时演进(832×480 / 8 步)
阶段 配置 单条 相对上一级 占总收益 起点 破损 torch → sub_quad 兜底,259 s/it 34.5 min — — ① 环境修复 torch 同源 + kitchen 注意力,53.7 s/it 8.6 min 4.0× 83% ② 步数 8 步 → 4 步 5.9 min 1.5× 8.7% ③ TP2 两卡张量并行,31.9 s/it 4.5 min 1.3× 4.5% ④ 常驻实例 复用进程,省掉冷启动 3.3 min 1.4× 3.8%
03 核心指标:每步耗时(s/it)
图 2 · 三种注意力后端 × 三种序列长度
场景 sub_quad 兜底 kitchen · 单卡 kitchen · TP2 832×480 · 124 帧 53 15.5 — 832×480 · 362 帧 259 53.7 31.9 1344×768 · 362 帧 OOM 257.9 112.3 走势:sub_quad 与 kitchen 在 124 帧差 3.4 倍,在 362 帧差 4.8 倍——序列越长差距越大;TP2 把整条曲线向下平移,1 MP 处收益最大(2.30×)。
图 3 · 每 token 耗时随序列长度增长
序列长度 ms/token 相对 48k 48k 0.32 1.0× 84k 0.72 2.3× 142k 1.82 5.7× 线性基线应约 0.55 ms/token,实测斜率明显更陡。这是注意力的平方项,也是 1 MP 比 0.4 MP 慢 4.8 倍(而不是 2.5 倍)的原因,同时排除了"每步换权重"的猜测。
04 显存:真正的墙在哪
图 4 · 峰值显存与 24 GB 物理上限
配置 峰值 占可用上限(23.98 GB) 0.4 MP · 不开 DV 18.65 GB 77.8% 0.4 MP · 开 DV 19.96 GB 83.2% 1 MP · 开 DV 单卡 23.82 GB 99.3% 0.4 MP 开不开 DynamicVRAM 都安全;1 MP 单卡开 DV 后离墙只剩 0.16 GB,因此 1 MP 的推荐路径是 TP2 而不是单卡硬撑。
05 失败档案:走过的弯路
失败项不是噪声,它们各自排除了一个假设。
F1 · torch 版本错配 → SDPA 全后端失效
whl-next 的2.14.0+rocm10.1.0链到系统 ROCm 7.2,AOTriton 内核加载即失败,报hipErrorInvalidImage,ComfyUI 静默退回 sub_quad。
教训:ROCm 环境里必须让 wheel 与系统 ROCm 同源,否则内核不可用且不报错,只降速。F2 · sub_quad 兜底能跑,但慢 6 倍
922.5 ms/次注意力,端到端 490 s。能出片,掩盖了"后端已坏"这个事实。
教训:"能出片"不等于"跑在正确路径上",需要用微基准校验单算子延迟。F3 ·
--novram:权重全放 CPU 反而更慢
362 帧实测 275 s/it,比全驻留的 259 还差 6%。
教训:直接证伪"权重换入换出是瓶颈",也是后来判定不做逐 block 流式的关键证据。F4 · max_split_size_mb 调优:噪声内
54.3 vs 56.4 s/it,差异小于批次抖动;DV 模式下该参数本就不参与分配。
教训:碎片类参数只在显存分配器主导时有意义,aimdo 用 VBAR 绕过了它。F5 · 1 MP 不开 DV:FFN 6.25 GB 分配失败
权重 11.9 GB 常驻后,激活峰值无处安放,第一步就 OOM。
教训:1 MP 必须开 DV 或 TP2,没有第三条路。F6 · 1 MP + chunk 节点:302 s/it,第 2 步仍 OOM
分块 FFN 把单次分配压下去了,但总驻留没降。
教训:峰值削峰不等于总量够用,要看"权重 + 激活"的总账。F7 · 以为 pytorch 注意力是安全回退,结果也 OOM
修好 torch 后 SDPA 走 math 后端,attention.py:615在 124 帧就要单次分配 23.06 GiB,362 帧无解。
教训:kitchen 不是"更快的选项",而是当前 build 下唯一能跑的通路。F8 · 同 seed 重复提交:7.1 s 的假加速
ComfyUI 节点缓存命中,看起来像 30 倍提速。
教训:测冷热启动必须换 seed,否则结论全废。F9 · avcodec EINVAL:最后一步毁掉整条任务
视频流已 flush,封装音频时返回 22,362 帧批次普遍出现,10 分钟算力白费。
教训:已加"降级为无声视频"兜底;根因未定位,属已知残留问题。F10 · 逐 block 流式(方案 B):判定不做
原计划自研 pinned CPU + 侧流预取。前提是"259 s/it 来自权重抖动",而该前提被 F3 与图 3 同时证伪。
教训:aimdo 的 VBAR 已是同类机制(实测只值 3.5%),再写一套只会更慢。重启条件:--novram慢 2 倍以上。F11 · 移植 comfy-aimdo 原生层:不可行
它是 CUDA VMM(VBAR / 32 MB 页 / fault / watermark),NVIDIA 专有接口。
教训:ROCm 版aimdo_rocm.so存在,只是被rocm >= 7.14的版本闸挡住——这才是--enable-dynamic-vram生效的原因。F12 · 音频 VAE 一次性编码:15 秒档必崩
1344×768 / 362 帧时申请 3.07 GiB 失败。
教训:按 5 秒切段编码(_encode_audio_chunked)后 OOM 消失,是目标一的基础。
06 本机环境与软件栈(复现基线)
版本错配(见 F1)会直接导致 6 倍降速,下表为实测时的确切版本。
硬件
项目 实测值 备注 GPU AMD Radeon RX 7900 XTX 24 GB ×2 gfx1100,RDNA3 显存可用上限 23.98 GB rocm-smi 报告 24560 MiB PCIe 4.0 ×8(8.0 GT/s) 非 ×16,影响主机 显存搬运CPU Intel Xeon E5-2696 v4 @ 2.20 GHz — 内存 125 GB 足够放下 26 GB 文本编码器 软件栈
组件 版本 关键性 OS Ubuntu 24.04.5 LTS,kernel 7.0.0-42-generic — ROCm 7.2.26015-fc0010cf6a 必须与 torch 同源 Python 3.12.3 venv: /home/jay/ComfyUI-AMD/venvtorch 2.14.1+rocm7.2 核心修复 torchvision 0.29.1+rocm7.2 随 torch 同步 torchaudio 2.11.0+rocm7.2 随 torch 同步 triton 3.8.0+git669b31ac.rocm10.1.0 仍为 10.1 构建,残留风险 numpy / safetensors / av 2.5.4 / 0.8.0 / 19.0.2 — ComfyUI commit 423cbd20(2026-10-30) /home/jay/ComfyUI-AMD/ComfyUITP 扩展 comfyui-tp2 日志出现 heads 56->28即生效模型文件
角色 文件 体积 DiT(生产用) minimax_h3_fl2va_pruned-w4a8_convrot_pruned 11.7 GB DiT(对照) minimax_h3_fl2va_pruned_int8_convrot 20 GB 文本编码器 qwen3vl_32b_minimax_h3-w4a8_convrot 26 GB 视频 VAE Minimax_h3_video_vae_fp16 4.9 GB 音频 VAE Minimax_H3_fp32_audio_vae 578 MB LoRA minimax_h3_turbo_v4_step600_ema_pruned_comfyui 592 MB 环境自检(复现前先跑这三条)
/opt/rocm-7.2.0/bin/hipconfig --version          # 期望 7.2.26015-fc0010cf6a
/home/jay/ComfyUI-AMD/venv/bin/python -m pip list | grep -E "^(torch|triton)"
# 期望 torch 2.14.1+rocm7.2
/home/jay/ComfyUI-AMD/venv/bin/python attn_path_bench.py   # 期望 seq=8192 单次 ≤200 ms
若出现
hipErrorInvalidImage或单次注意力 > 800 ms,说明内核与运行时再次错配,执行回退。
07 复现步骤与期望值
所有命令在
/home/jay/tp2下执行。前置:strata.service为 active(日常双卡态)。# 通用启动 COMFY=/home/jay/ComfyUI-AMD/ComfyUI \ PY=/home/jay/ComfyUI-AMD/venv/bin/python \ EXTRA_ARGS="--enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory" \ bash run_tp.sh <world> <base_port> <tag> # 收尾(必须执行,恢复日常态) pkill -f "port <base_port>" bash /home/jay/strata/scripts/gpu-mode.sh release --reason "bench done"通用 bench 模板
/home/jay/sglang-venv/bin/python bench.py \
  --ports <port> --outdirs logs/<tag>/o --timings logs/<tag>/t.json \
  --unet minimax_h3_fl2va_pruned-w4a8_convrot_pruned.safetensors \
  --clip qwen3vl_32b_minimax_h3-w4a8_convrot.safetensors \
  --vae Minimax_h3_video_vae_fp16.safetensors \
  --audio-vae Minimax_H3_fp32_audio_vae.safetensors \
  --lora minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors \
  --width <W> --height <H> --frames <F> --steps <N> --seed <S> \
  --tag <tag> --result logs/<tag>/r.json
场景与期望值
场景 参数 期望 s/it 期望端到端 峰值 S1 注意力自检 attn_path_bench.py ≤200 ms/次 — — S2 0.4 MP / 15 s / 8 步 / 单卡 832×480, 362f, seed 201 53.7 ±10% 517 s ±15% 20.0 GB S3 0.4 MP / 15 s / 8 步 / TP2 同上,双卡端口 31.9 ±10% ≈4.3 min — S4 1 MP / 15 s / 2 步 / TP2 1344×768, 362f 112.3 ±10% 3:44 采样 未测 S5 1 MP / 15 s / 2 步 / 单卡 同上 257.9 ±10% 662 s ≤23.9 GB S6 热启动 同实例第二条,换 seed — 81.3 s(-49%) — 测量陷阱:同 seed 重复提交会命中 ComfyUI 节点缓存,得到 7.1 s 的假加速(F8)。所有对比必须换 seed。
08 回退与环境还原
SP=/home/jay/ComfyUI-AMD/venv/lib/python3.12/site-packages
B=/home/jay/ComfyUI-AMD/backup_whlnext_20261113
rm -rf $SP/torch $SP/torchvision $SP/torchaudio $SP/triton
cp -a $B/torch $B/torchvision $B/torchaudio $B/triton $B/*.dist-info $SP/
去掉
--use-ck-attention等参数启动即回到原始路径(会退回 sub_quad,速度约为当前的 1/6)。
附:数据来源与口径
-
数据来源:本机 2026-11-13 实测日志(
/home/jay/tp2/logs/)。 -
图中"推算"项已标注:TP2 + 4 步的端到端为采样实测 + 冷启动开销推算,非整条实测。
-
未验证项:640×368 / 362 帧在 kitchen 下的数字未重测;1 MP 的 4 步为外推。
@xiongjie-gao 提升明显我也复测了一下单卡7900XTX:
交作业|单张 7900 XTX 跑 MiniMax-H3,15 秒有声视频,4 步热跑 4 分 14 秒
按楼主的配置在本机复测了一遍。全程只用一张 RX 7900 XTX 24 GB,分辨率 832×480,362 帧 / 24 fps,约 15 秒。
配置
- 主模型:
minimax_h3_fl2va_pruned-w4a8_convrot_pruned - LoRA:
minimax_h3_turbo_v4_step600_ema_pruned_comfyui,强度 1.0 - 采样器:
res_multistep,调度器:simple - 软件:ComfyUI 0.40.0,PyTorch
2.11.0+rocm7.2,Comfy Kitchen 0.2.37 - 启动参数:
--enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory
实测成绩
单卡配置 采样耗时 平均每步 提交到输出 峰值显存 8 步冷跑,seed 201 6 分 40 秒 50.1 秒 7 分 47 秒到原版封装报错,随后补回音轨 20.04 GiB 4 步热跑,seed 202 3 分 20 秒 50.1 秒 4 分 14 秒,含有声 MP4 合成 20.08 GiB 8 步单卡实测 50.1 秒/步,比楼主单卡的 53.7 秒/步少约 7%。如果之前的 36 分钟也是同分辨率、同帧数、同为 8 步,按这轮到封装阶段的耗时算,约省 28 分钟。4 步用了热实例,也少跑了 4 步,画质还没做同 seed 对比。
音频封装踩坑
8 步跑完后,原版
SaveVideo复现了avcodec_send_frame() returned 22。当时 362 帧画面已经写进 MP4,我用SaveAudio从节点缓存导出 FLAC,再转成 AAC 合回原视频,无需重跑采样。4 步这轮直接分开导出视频和音频,最后合成。两份成片都已验证能解码,包含 362 帧画面和立体声音轨。
双 7900 XTX:模型本地跑,Token 随便烧!
-
-
@xiongjie-gao 提升明显我也复测了一下单卡7900XTX:
交作业|单张 7900 XTX 跑 MiniMax-H3,15 秒有声视频,4 步热跑 4 分 14 秒
按楼主的配置在本机复测了一遍。全程只用一张 RX 7900 XTX 24 GB,分辨率 832×480,362 帧 / 24 fps,约 15 秒。
配置
- 主模型:
minimax_h3_fl2va_pruned-w4a8_convrot_pruned - LoRA:
minimax_h3_turbo_v4_step600_ema_pruned_comfyui,强度 1.0 - 采样器:
res_multistep,调度器:simple - 软件:ComfyUI 0.40.0,PyTorch
2.11.0+rocm7.2,Comfy Kitchen 0.2.37 - 启动参数:
--enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory
实测成绩
单卡配置 采样耗时 平均每步 提交到输出 峰值显存 8 步冷跑,seed 201 6 分 40 秒 50.1 秒 7 分 47 秒到原版封装报错,随后补回音轨 20.04 GiB 4 步热跑,seed 202 3 分 20 秒 50.1 秒 4 分 14 秒,含有声 MP4 合成 20.08 GiB 8 步单卡实测 50.1 秒/步,比楼主单卡的 53.7 秒/步少约 7%。如果之前的 36 分钟也是同分辨率、同帧数、同为 8 步,按这轮到封装阶段的耗时算,约省 28 分钟。4 步用了热实例,也少跑了 4 步,画质还没做同 seed 对比。
音频封装踩坑
8 步跑完后,原版
SaveVideo复现了avcodec_send_frame() returned 22。当时 362 帧画面已经写进 MP4,我用SaveAudio从节点缓存导出 FLAC,再转成 AAC 合回原视频,无需重跑采样。4 步这轮直接分开导出视频和音频,最后合成。两份成片都已验证能解码,包含 362 帧画面和立体声音轨。
- 主模型:
-
@terry 已经包含单双卡的提升可能。
单卡就是不享受TP2带来的1.3的提升倍率。不过随着分辨率提升享受摊薄收益。
7900XTX单卡提升是不是只是不享受TP2的1.3倍率?测个样本试试20:40
TRAE
任务耗时 1m 16s
已创建 1 个文件,读取 2 个文件,搜索 1 次文件,执行 7 条命令
对照实验已跑起来(Strata 已挂起,两档都用 832×480 / 362 帧 / 4 步 / 同一 seed,只差单卡与 TP2):
- ① 单卡 356 s 左右
- ② TP2 257 s 左右
约 15 分钟出结果。先说清楚这条“1.3×”其实不统一,跑完正好能核对:
档位 TP2 倍率 依据 0.4 MP / 4 步 1.39× 356.4 → 257 s 0.4 MP / 8 步 1.68× 53.7 → 31.9 s/it 1 MP / 2 步 2.30× 257.9 → 112.3 s/it
所以“单卡只是少了 1.3×”只在 4 步那一档成立。8 步时是 1.68×,1 MP 时是 2.30×——序列越长,TP2 收益越大,因为它的作用是把每张卡的权重和激活同时减半,不只是并行算力。
还有一个更根本的点值得这次一并验证: 10.5× 里 TP2 只占 4.5% 。单卡相对起点的真实提升是 34.5 min → 5.9 min,约 5.85× ,不是 10.5×。10.5× 是把“TP2 + 常驻实例”也叠上去了,而那两项是有条件的(要双卡、要连续出片)。如果这次测出单卡确实落在 5.9 min 附近,就说明我们的报告头号数字需要标注成“叠满配置后的上限”,而不是单卡能力。
跑完我把两档的 s/it、端到端、峰值一起给你。
@xiongjie-gao 嗯,我今晚就不做视频了,明天回来抄作业。测出单卡点显存极限,分辨率,时长,我剽一期视频。
-
@xiongjie-gao 嗯,我今晚就不做视频了,明天回来抄作业。测出单卡点显存极限,分辨率,时长,我剽一期视频。
-
-
-
抄了一下作业,让deepseek测的的结果
实测结果
统一条件:minimax_h3_fl2va_pruned_int8_convrot(20 G)+ qwen3vl_32b_int4(14 G)+ lightx2v turbo v4 LoRA 0.75、362 帧(15 s @24fps)、4 步、res_multistep、DV + int8 注意力全开。分辨率 s/it 采样 端到端(含冷启动)
832×480 50.58 3:22 4 分 40 秒(280.2 s)
1344×768 245.67 16:23 18 分 36 秒(1115.7 s)
两条产物都是 362 帧、15.08 秒、带 AAC 音轨,解码保存都正常 -
-
@xiongjie-gao 嗯,我今晚就不做视频了,明天回来抄作业。测出单卡点显存极限,分辨率,时长,我剽一期视频。
交作业|单张 7900 XTX 跑 MiniMax-H3,1536×864、15 秒、4 步有声出片
本机用一张 RX 7900 XTX 24 GB 跑 MiniMax-H3,1536×864、362 帧(15.08 秒)、4 步已完整有声出片。提交到出片用时 28 分 01 秒,峰值显存 23.82 GiB,四步采样和 VAE 解码均通过。
配置
- 主模型:
minimax_h3_fl2va_pruned-w4a8_convrot_pruned - LoRA:
minimax_h3_turbo_v4_step600_ema_pruned_comfyui,强度 1.0 - 采样器:
res_multistep,调度器:simple,24 fps - 环境:ComfyUI 0.40.0、PyTorch
2.11.0+rocm7.2、Comfy Kitchen 0.2.37 - 启动参数:
--enable-dynamic-vram --use-ck-attention --mmap-torch-files --disable-smart-memory - 导出:视频与音频分开导出,再合成 H.264 + AAC MP4
配置参考@xiongjie-gao 贴文。
4 步有声出片对比
分辨率 帧数 / 时长 采样用时 端到端用时 峰值显存 1280×736 362 / 15.08 秒 13 分 52 秒 15 分 54 秒 23.86 GiB 1536×864 362 / 15.08 秒 25 分 14 秒 28 分 01 秒 23.82 GiB 兼顾分辨率和耗时,推荐 1280×736、约 15 秒、4 步。 需要更高分辨率时,1536×864 同规格已经跑通,像素数多约 41%,本轮出片多等 12 分 07 秒。两档各有一次成功实测,连续多轮的稳定性还有待验证。
单卡显存边界
本机可用显存 23.98 GiB。成功档最高测到 23.86 GiB,余量约 120 MiB。下表的 1 步用于测试采样、解码和导出能否通过。OOM 档的显存峰值只包含已成功分配的显存。
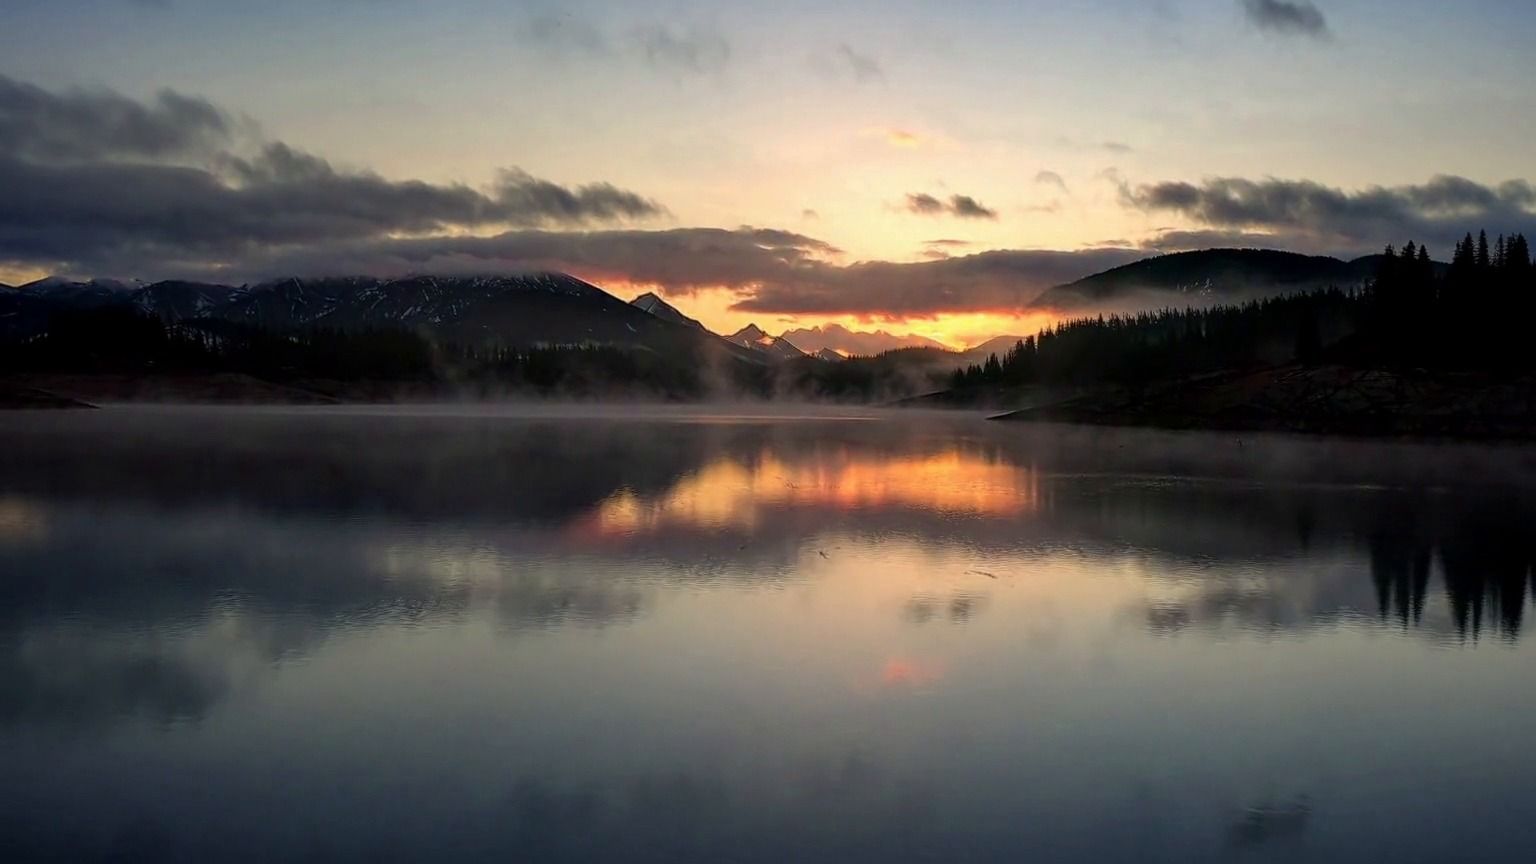
测试方向 成功档 首步 OOM 档 固定 362 帧 / 15.08 秒,提高分辨率 1536×864,4 步,峰值 23.82 GiB 1728×960,1 步,申请 2.33 GiB 时剩 2.21 GiB;1920×1088 也触发 OOM 固定 1280×736,增加时长 549 帧 / 22.88 秒,1 步,10 分 12 秒有声出片,峰值 23.55 GiB 617 帧 / 25.71 秒,1 步,申请 1.70 GiB 时剩 576 MiB 下图取自 22.88 秒压力测试的第 18 秒。这个时长已验证 1 步有声出片,4 步仍待实测。
结论
单张 RX 7900 XTX 24 GB 已实测跑通 1536×864、362 帧(15.08 秒)、4 步的 MiniMax-H3 有声视频。整条用时 28 分 01 秒,峰值显存 23.82 GiB。同样是 15 秒,升到 1728×960 就在首步遇到显存不足。
日常兼顾分辨率和耗时,我推荐 1280×736、15 秒、4 步,本机实测 15 分 54 秒。有更高分辨率需求时,可以用已经跑通的 1536×864,同样 4 步多等约 12 分钟。这两个档位各完成了一次有声出片,连续跑多条的稳定性还待验证。
- 主模型:
-
-
补一个涡轮卡测试:
我是蓝宝石的涡轮卡(不是常见的零售三风扇版)。照着自己的机器做了三组对照,把能抄的和抄不了的都写一下。
一、先说我这张卡:蓝宝石涡轮版
- 品牌型号:蓝宝石 7900 XTX 涡轮版
- 功耗上限默认 257 W(可调范围 231~350 W)
- 一般零售 7900 XTX 是 339~355 W、boost 约 2500 MHz(说明一下:楼主和下面复测的朋友用的具体型号帖子里没写,这里只是按零售版推测,没有核实)
- 实测:257 W 时约 2200 MHz;提到 350 W 后在 2200~2480 MHz 之间来回跳
所以楼主的 TP2 那部分(1 MP 时 2.30×)单卡抄不了;能抄的是环境自查和注意力那一段。
二、DynamicVRAM 在我这儿开不了
按帖子参数试的:
--enable-dynamic-vram --use-ck-attention --mmap-torch-files。aimdo 本身能起来(
comfy-aimdo 0.6.0,识别到 24560 MB),但第一个 VAE 编码触发的部分卸载就崩:aimdo: model-vbar.c:269 ERROR: Could not reserve Virtual Address space for VBAR MemoryError: VBAR allocation failed10 秒结束,一步都没跑。系统限制我都排除了:
vm.overcommit_memory=0、vm.max_map_count=1048576、服务LimitAS/DATA=infinity,都正常。差别在版本:我用的是 ROCm 7.2.0(发行版包),楼主环境是 7.2.26015(更新的构建)。结论就是 VBAR 这套虚拟地址预留机制在我这个构建上用不了,要开 DV 得升级 ROCm 且 torch 同源,风险太大,暂时不开。三、试着提功耗:只有 6%,撞的是温度墙
同一配置:832×480 / 362 帧 / 4 步 / res_multistep,int8 20.9 GB + nvfp4 编码器 + kitchen attention,无分块。
功耗上限 s/it 采样 端到端 峰值显存 257 W(默认) 65.14 4:20 390.4 s 23.96 GiB 350 W 61.06 4:04 380.5 s 23.93 GiB 只快了 6.3%。350 W 那轮的温度:edge 79 °C、junction(热点)104 °C、显存 84 °C,而 junction 限值是 110 °C。
关键在功耗数字:平均只有 243 W,离 350 W 上限还差 30%。所以不是撞功耗墙,是撞温度墙——热点到 104 °C 后 SMU 自己压频,功耗自然上不去。结论:不固化 350 W,已还原 257 W。为 6% 常年 95~104 °C 不值得。
四、单卡校准:确实慢,但不是降级路径
和帖子里 @6cccccc 的单卡复测对照:
- 832×480 / 362 帧 / 4 步:我 65.14 s/it,他 50.58,慢 29%
- 1 MP / 362 帧 / 4 步:我 310 s/步,他 245.67,慢 26%
两档差距一致,说明我不是踩到了降级路径(真降级是 259 s/it 那种量级),而是硬件/配置整体差一截;顺带也验证了 kitchen attention 在我这儿是通的。差距里有一部分大概率的来源是卡:涡轮版的功耗和频率上限都比零售版低,但对方到底是哪张卡我并不确定,只能说是推测。
当前极限:0.4 MP / 362 帧 = 65 s/it;1 MP / 362 帧 = 310 s/步。
后面还没试的方向:undervolt(同频降温,也许能让 350 W 站得住)、ROCm 升级后开 DV、以及算法层的 3 步 LoRA / 时间维切段 / 降分辨率。暂时到这儿,有新招再来更新。



 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!