
[H3剑心比赛] RTX Pro 6000 96G 单卡 · 一条片子 5 分半|MiniMax H3 3D / 2D
-
-
-
-
-
唯一感觉还可以的。果然pro 6000 才能是视频生产力。
其他卡的视频我也都看了。画面残影,瞬时模糊,噪点,音频 不定时爆音现象明显。
这个作品我投一票。可以用。个人主页:xlkj.org Telegram https://t.me/xlkjorg
-
,
 W williamlouis 引用了 此主题
-
唯一感觉还可以的。果然pro 6000 才能是视频生产力。
其他卡的视频我也都看了。画面残影,瞬时模糊,噪点,音频 不定时爆音现象明显。
这个作品我投一票。可以用。@williamlouis 我把贴子扔给AI让它逐桢学习
AI告诉我这是硬件代差带来的实力差距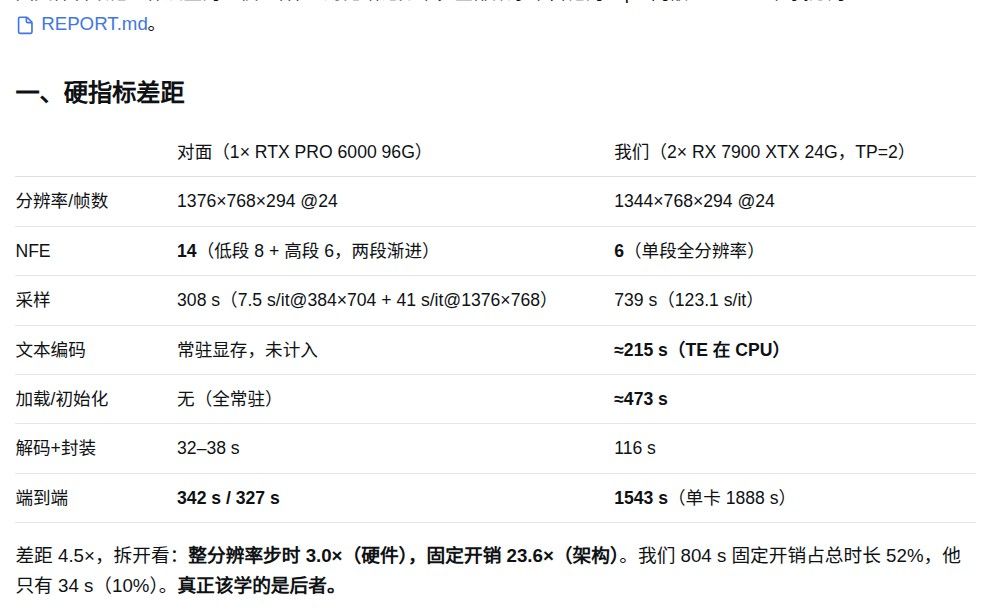
-
唯一感觉还可以的。果然pro 6000 才能是视频生产力。
其他卡的视频我也都看了。画面残影,瞬时模糊,噪点,音频 不定时爆音现象明显。
这个作品我投一票。可以用。不懂是不是rtxpro ecc 的关系,我的也没有他们的问题
-
-
唯一感觉还可以的。果然pro 6000 才能是视频生产力。
其他卡的视频我也都看了。画面残影,瞬时模糊,噪点,音频 不定时爆音现象明显。
这个作品我投一票。可以用。 -
-
-
-
用楼主的提示词跑了一段,用回我自己的工作流,楼主的提示词我自己优化成拳脚格斗和成龙式的动作
时间13分钟,全程1m , 工作流是官方h3, 加入ck, sol, turbo lora,没有用坊间的那些二段低清放大处理,最后才使用rtx 放大
-
用楼主的提示词跑了一段,用回我自己的工作流,楼主的提示词我自己优化成拳脚格斗和成龙式的动作
时间13分钟,全程1m , 工作流是官方h3, 加入ck, sol, turbo lora,没有用坊间的那些二段低清放大处理,最后才使用rtx 放大
-
用楼主的提示词跑了一段,用回我自己的工作流,楼主的提示词我自己优化成拳脚格斗和成龙式的动作
时间13分钟,全程1m , 工作流是官方h3, 加入ck, sol, turbo lora,没有用坊间的那些二段低清放大处理,最后才使用rtx 放大
-
@imbiplaza-ASUS 我还有邪修的方式,可以更像电影。只是时间会很久,需要一段视频作为参考。其实参考视频生成视频有很多不一样的用法。
@roid-isis
i2v 我可以做到90秒出15s 视频但是r2v 就要非常久了
-
楼主的方法我在 RTX 5080 16 GB 上复刻了一遍,来汇报一下情况。结论:照着做能跑通,一条 12 秒大约 8 分钟,比 Pro 6000 慢 1.4–1.5 倍。
成片(我这边的复刻,不是正式参赛那版):
时间
Pro 6000 96G(楼主) 5080 16G(我) 3D 端到端 327 s 497 s(8:17) 2D 端到端 342 s 472 s(7:52) 低段 8 步 57 s / 60 s 78 s / 71 s 高段 6 步(1376×768) 230 s / 248 s(38–41 s/步) 346 s / 333 s(约 56–58 s/步) 计时是 ComfyUI 日志的
Prompt executed in。我是 1344×768(比赛规格),楼主是 1376×768,像素略少一点,所以高段步时的差距比看起来还小一点。没想到的是:16 GB 显存、模型要从内存里流式换入换出,只慢了 1.4–1.5 倍。我之前用同一张卡、官方默认注意力、20 步全分辨率,一条要 45 分钟(约 130 s/步),这次直接降到 8 分钟。我没有拆开做单项对比,只能推测大头来自 INT8 注意力(
comfy kitchen attention)和两段式,不能说各占多少。我做了哪些改动
照搬的部分:两段式 SelfLift(8 步低分辨率 + 6 步全分辨率,euler,14 步 simple 调度)、SigmaShift 12/3、FFN 分块 chunks=2、
comfy kitchen attention、潜变量上采器、LoRA 栈(Fight Flow 0.9 / Combat V2 0.9 / Motion Repair 0.7)、楼主的重写提示词。适配 16 GB 或者没拿到的地方:
- 底模换成裁剪版:Singularity v1.3 int8 的裁剪版(21 GB),不是 34 GB 的完整版。HF:
WarmBloodAban/Minimax-h3_Singularity。 - 文本编码器用 NVFP4(14.6 GB,官方 Comfy-Org 的),没用 int8 的 24 GB。5080 原生支持 FP4,省内存。
- 高分辨率段的 LoRA 用
r144,不是工作流里的r512。我在 HF 上没找到 r512 的公开下载,只找到同系列的rh-minimax-h3-fl2va-bf16-turbo-multistep-fro099-r144-pruned(RunningHubAI)。所以我这边的画面和楼主的不完全可比。 - 没有背景图,参考图没去背景。本能寺只靠提示词文字,没用 RMBG。
- 条件节点:直接用了 T8 的
MiniMaxH3AudioConditioningT8,参数照楼主的工作流。 - 分辨率写死 1344×768,低段自动变成 384×672。
- 提示词:风格句按 3D / 2D 各换了一句,最前面加了一行图片对应说明(标明哪些是 2D 立绘、哪些是 3D 手办)。
- KJ 预览节点没装,SOL 注意力(楼主工作流里本来是绕过的)也没启用。
顺带发现的一件事
楼主帖子里写的是"8-step turbo 蒸馏模型",我读 JSON 才发现:低段和高段用的不是同一套 LoRA。
- 低段:lightx2v 的
ref2v_turbo_8step_v1.1→ Fight Flow → Combat V2 → Motion Repair 0.7。 - 高段(
model_hires):fl2va_bf16_turbo_multistep_fro099_r512_pruned→ Motion Repair 0.3,没有 Fight Flow 和 Combat。
这个结构不看 JSON 很难发现,照着帖子文字复刻容易把整套 LoRA 都加到两段里。
另外,Combat V2 和 Motion Repair V2 我在 HF 的
JOKER141下找到了:MiniMax-H3-Combat-Base-V2、MiniMax-H3-General-Motion-Continuity-Repair;Fight Flow V1 在JOKER141/H3-Fight-Flow-Fight-Interaction-LoRA。其他想复刻的人可以直接下。效果和没验证的
- 四个分镜、燃烧的本能寺、结尾剑心单膝跪地和志志雄远处站立,两版都出现了。
- 我只看了关键帧,没逐帧看,也没仔细听音频。只试了一个种子(2026111402),样本很小。
- 我之前单独试过 8 步 LoRA(单段、不带这些战斗 LoRA)在中段碰撞有明显拖影;这套组合里关键帧上没看到,但拖影要看动态才能确认。
- 成片是模型输出的 294 帧里取前 288 帧(12.000 s),没有剪接。
想请教楼主
- 高段的
r512版本能不能给个下载地址?想看看换了以后画面有没有变化。 - 低段 8 步 + 高段 6 步的分界(
transition_step=8)是试出来的吗?有没有试过 6+8 之类的别的分法?
另外这个方法在 16 GB 卡上能跑,对想用 5080 / 5070 Ti 这类卡参赛的人应该有参考价值。
- 底模换成裁剪版:Singularity v1.3 int8 的裁剪版(21 GB),不是 34 GB 的完整版。HF:






 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!
 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!
