
【H3剑心比赛】2×7900XTX | TP=2 | P2P open | MiniMax H3主流生成2D、3D影像
-
交个参赛作业,顺便还修了个BUG
之前搞的Kuzuryusen项目,可以在MiniMax H3工作流中可以无痛提升18.8%。
项目链接:https://lcz.me/topic/2857
当时少考虑了项目的复杂性,少考虑了Lora加载的情况导致报错:
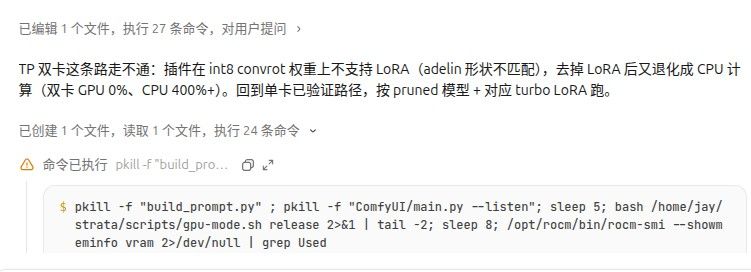
所以就修了这个BUG,并在Repo中更新。
跑了三版(2D,单卡、2D,TP=2、3D,TP=2),也是顺便验证项目的有效性。先交作业
H3 FINAL 3D:
https://youtu.be/IpkkcJagdVM
H3 FINAL 2D TP2:
https://youtu.be/HsgJ8mvc2bQ
H3 FINAL 3D TP2
Youtube VideoH3 打斗片 · 复现手册
目标:在同类机器上,凭本文件 +
workflow/*.json+comfyui-tp2补丁 + 3 个核心文件补丁,复现出H3_FINAL_3D/H3_FINAL_3D_TP2/H3_FINAL_2D_TP2三条 1344×768、12.25 s 带音轨的片子。
所有版本、md5、参数、耗时均为本机实测或日志原文;推算值已标注"推算"。
任务来源:https://lcz.me/topic/3045
1. 交付物
产物 路径 大小 规格 生成模式 总耗时 3D 单卡 h3_output/H3_FINAL_3D.mp414.2 MB 1344×768 / 294f / 12.25s / H.264+AAC 24fps 单卡 8188 31:28 3D TP=2 h3_output/H3_FINAL_3D_TP2.mp415.1 MB 同上 双卡 8191/8192 26:00 2D TP=2 h3_output/H3_FINAL_2D_TP2.mp417.5 MB 同上 双卡 8191/8192 25:43
2. 硬件
项 值 CPU Intel Xeon E5-2696 v4 @ 2.20 GHz(22 逻辑核) 内存 131,782,056 kB ≈ 125.7 GiB(跑双卡时必须留 ≥ 60 GiB 空闲:两个 rank 各加载 27 GB 文本编码器) GPU 2 × AMD Radeon RX 7900 XTX,24 GB,gfx1100 GPU 链路 sysfs 报告 16.0 GT/s ×16(两卡经同一 PCIe switch);实测 P2P 拷贝 5.14 GB/s ROCm 7.2(hip 7.2.53211) 存储 权重在 /mnt/ai/models/ComfyUI(345 GB),安装目录在/mnt/ai/ComfyUI-AMD
3. 软件栈
用途 安装目录 代码版本 解释器 torch 单卡 / TP=2 出片(8188、8191/8192) /home/jay/ComfyUI-AMD/ComfyUI(=/mnt/ai/ComfyUI-AMD/ComfyUI)Revision 6237 423cbd20(ComfyUI 0.43.2,2026-10-30)/home/jay/ComfyUI-AMD/venv(Python 3.12.3)2.14.1+rocm7.2 备用 / 对照(本次未参与交付片) /home/jay/ComfyUIcommit 426f5ee/home/jay/sglang-venv2.13.0+rocm7.2 三条交付片全部出自 ComfyUI-AMD 这一份安装 + 2.14.1+rocm7.2;TP=2 只是换了启动参数(
--use-ck-attention --mmap-torch-files、两个进程、两个端口),解释器与依赖与单卡完全相同。启动命令(脚本已封装):
# 单卡:workflow/run_single.sh
cd /home/jay/ComfyUI-AMD/ComfyUI && ../venv/bin/python main.py --disable-xformers --port 8188

# 双卡(交付片实际用法,必须显式覆盖 COMFY/PY,脚本默认指向 /home/jay/ComfyUI):
COMFY=/home/jay/ComfyUI-AMD/ComfyUI \
PY=/home/jay/ComfyUI-AMD/venv/bin/python \
MIN_FREE_MIB=16384 bash /home/jay/tp2/run_tp.sh 2 8191 h3fix
#   run_tp.sh 内部再加:--use-ck-attention --mmap-torch-files --listen 127.0.0.1 --port 8191/8192
#                       MASTER_ADDR=127.0.0.1  MASTER_PORT=base_port+300
--use-ck-attention --mmap-torch-files是 TP 的默认EXTRA_ARGS;--mmap-torch-files让权重按需 mmap,实测采样前准备 91.7 → 58.0 s。
4. 插件(custom_nodes)
图里真正用到的只有三处来源:
提供方 提供的东西 说明 ComfyUI 核心 comfy_extras/nodes_minimax_h3.pyMiniMaxH3ReferenceToVideo、MiniMaxH3SigmaShift、MiniMaxH3LatentAV、EmptyMiniMaxH3LatentAV、LTXVSeparateAVLatent等 8 个 H3 节点必须是有 H3 支持的 ComfyUI 版本(本机 423cbd20)custom_nodes/comfyui-tp2TP 切分、LoRA runtime patch、 TP2VAEDecodeSplit本项目的核心补丁,见 §5 custom_nodes/ComfyUI-KJNodesImageResizeKJv2(参考图 1536 长边、divisible_by=32)也可用核心 ImageScale替代同装但本次未参与计算(出片、分析可选用):
ComfyUI-VideoHelperSuite、rgthree-comfy、rocm-sdpa-fix、ComfyUI_MiniMaxH3_Director、ComfyUI-YCNodes-MiniMax-H3、ComfyUI-H3-LongVideo、Comfyui_Minimax_h3_latent_Upscaler、ComfyUI-Spectrum-MiniMax-H3、ComfyUI_Qwen_H3_Prompt、ComfyUI-Prompt-Assistant、comfyui-portrait-master-zh-cn、audio-separation-nodes-comfyui、seedvr2_videoupscaler、selflift-Avatar、ComfyUI-Manager。
5. 补丁
交付片依赖两层补丁,必须同时存在。核心 ComfyUI 不是原版,
git status里有 3 个改动文件(另有若干models/*/put_*_here、input/example.png的删除,是安装时清示例,与出片无关)。5.0 指纹与回滚
文件 行数 md5 作用 custom_nodes/comfyui-tp2/__init__.py838 14fd4c4edef91b68ddc15a264b5051c2TP=2 全部切分 / 通信 / LoRA runtime patch comfy/sd.py— a9f96a489358ca59210b6c38587f26d6VAE encode 三维输入按 1e6 元素分段 + 失败原因写日志 comfy_extras/nodes_audio.py— 6f1691eb8913de31899baae6447f4a33音频 VAE 分块编码,OOM 时整段退 CPU 再拼回 comfy_api/latest/_input_impl/video_types.py— e1a9d9f0d13756fdc045ed28ad9618c1音轨 mux 抛 av.error.ArgumentError时降级为无声成片,不丢整条回滚:
# TP 补丁回到 377 行(补丁前)版本 cp /home/jay/tp2/backups/comfyui-tp2.bak-377line-11071942/__init__.py \ /home/jay/ComfyUI-AMD/ComfyUI/custom_nodes/comfyui-tp2/__init__.py # md5 da086f0b39585fd4520b970e1c46a5a7 # 核心三个文件 cd /home/jay/ComfyUI-AMD/ComfyUI && git checkout -- comfy/sd.py comfy_extras/nodes_audio.py comfy_api/latest/_input_impl/video_types.py/home/jay/ComfyUI(426f5ee)里另有一份 832 行版 tp2(md54d206ff98746d4cb67dfd254d2400d63),不是交付片用的版本,不要混。5.1 它做了什么
能力 实现要点 行/列并行 qkv、fc1 列并行;out_proj、fc2 行并行;attention 按 head 切(56 → 28/rank) LoRA runtime patch 不再把 LoRA 合并进 int8 convrot 权重,而是各 rank split 成 patch;启动日志 [tp2] rank0 lora split keys=208/416、208 patches attached。这是解决adaln_proj.linear.weight shape '[96768, 8]'的那一步MLP 分块重叠(A 轨) COMFY_TP_MLP_CHUNKS=8,第 i 块 allreduce 与第 i+1 块 GEMM 在两条 stream 重叠全归约 dtype COMFY_TP_AR_MODE=bf16(默认);int8可再省 8%,但 4 步 latent 均值偏差 5%、PSNR 24.5 dB,画质未验收,不要开出片跨卡解码 COMFY_TP_VAE_SPLIT=1时把VAEDecode换成TP2VAEDecodeSplit,两卡按 VAE 时间块各解一半(8 步 832×480×124 实测 post 34.2 → 27.1 s,与单卡逐位一致)。本次没开P2P 拓扑修正 p2p_patch.py --print生成/home/jay/tp2/p2p_topology.xml,让 RCCL 走 P2P/IPC 而不是回退 SHM。注意:该拓扑是手工构造(把两卡写成同一 switch 下 16 GT/s ×16),目的是让 RCCL 不降级,真实带宽以 §9 实测 5.14 GB/s 为准显存仲裁 run_tp.sh调gpu-mode.sh acquire(挂起 Strata),启动后把 holder 钉到真实main.pypid,否则 60 s 后 watchdog 会 release 并把出片挤掉5.2 环境变量
变量 本次值 作用 COMFY_TP_WORLD/COMFY_TP_RANK2 / 0,1 由 launcher 注入 COMFY_TP_MLP_CHUNKS8 MLP 分块重叠 COMFY_TP_AR_MODEbf16 全归约精度(int8 画质未过) COMFY_TP_VAE_SPLIT0 出片跨卡解码(实测可再省 18~23 s) COMFY_TP_P2P1 启用拓扑修正 COMFY_TP_P2P_WARMUP1 启动时预热 P2P COMFY_TP_AR_SKIP/COMFY_TP_ROW_BF16/COMFY_TP_DUP未设 调试开关 H3_AUDIO_ENCODE_CHUNK5(默认) 音频 VAE 编码分段秒数( nodes_audio.py补丁读它;长音轨单次编码会打爆 24 GB)MIN_FREE_MIB16384 acquire 时要求的最小空闲显存
6. 模型文件
/mnt/ai/models/ComfyUI(~/ComfyUI/models下为软链):角色 文件 大小 备注 UNET(本次用) diffusion_models/MiniMax/minimax_h3_ref2va_pruned_int8_convrot.safetensors20.97 GB pruned 基座 UNET(动作 LoRA 只能配这个) diffusion_models/MiniMax/minimax_h3_hybrid_fl2va_ref2va_b20-49-int8.safetensors20.97 GB hybrid 基座 Turbo LoRA loras/minimax_h3_turbo_v4_step600_ema_pruned_comfyui.safetensors0.62 GB 必须配 pruned;hybrid 配 turbo_v4_step600_comfyui_T8-convert或 Combat文本编码器 text_encoders/qwen3vl_32b_minimax_h3_int8_convrot.safetensors27.14 GB 24 GB 卡放不下 → device=cpu视频 VAE vae/minimax_h3_video_vae_fp16.safetensors5.21 GB TP 端文件名首字母大写 Minimax_h3_video_vae_fp16音频 VAE vae/minimax_h3_audio_vae_fp32.safetensors0.61 GB <br /> 配对铁律:
pruned只配*_ema_pruned*;hybrid只配T8-convert/Combat/VBVR/FrameRush。混用必报adaln_proj维度错。
7. 出片参数
7.1 公共
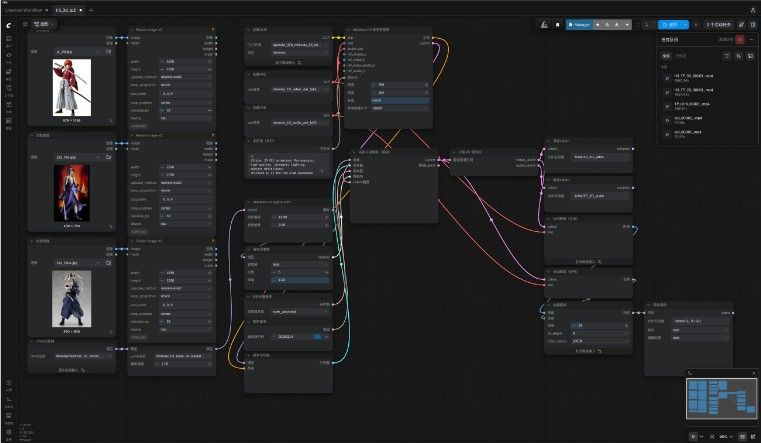
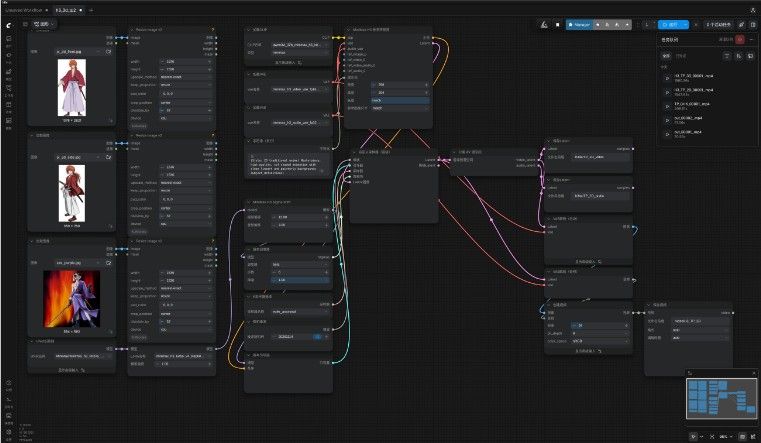
参数 值 分辨率 / 帧数 / fps 1344×768 / 294(=17×17+5,H3 的合法帧数网格)/ 24 steps / scheduler / sampler 6 / beta/euler_ancestralsigma shift video 12.0 → audio 3.0( MiniMaxH3SigmaShift)seed / 噪声 20261114( RandomNoise)LoRA 强度 1.0 参考图预处理 ImageResizeKJv2:1536×1536、nearest-exact、resize、divisible_by=32、device=cpu解码 VAEDecodeTiledtile 512 / overlap 64 / temporal 64-8 +VAEDecodeAudio封装 CreateVideo(fps=24, bit_depth=8)→SaveVideo(mp4, h264)提示词骨架 (Style: …)+subject_definitions(三张参考图逐个点名)+Subject/Action/Environment7.2 三版差异
项 3D 单卡 3D TP=2 2D TP=2 JSON workflow/s3d.jsonworkflow/s3d_tp2.jsonworkflow/s2d_tp2.json风格行 (Style: 3D CGI animation)同左 (Style: 2D traditional anime)参考图 jx_3d.jpg/zzx_fire.jpg/zzx_blue.jpg同左 jx_2d_front.jpg/jx_2d_side.jpg/zzx_purple.jpgattention ModelAttentionBackend = comfy kitchen attention服务端 --use-ck-attention,图上不挂该节点同 TP 端口 8188 8191 + 8192(两端口同时提交) 同 TP 启动 workflow/run_single.shMIN_FREE_MIB=16384 bash run_tp.sh 2 8191 h3fix同 TP
8. 脚本与 JSON
文件 作用 用法 workflow/build_prompt.py读参数 JSON → 组 API 图( build()返回(graph, frames))→ 多端口同时 POST/prompt→ 轮询/historypython3 build_prompt.py --params s3d_tp2.jsonworkflow/run_single.sh单卡:acquire → execComfyUI(PID 与锁同生共死)直接跑 /home/jay/tp2/run_tp.sh双卡 launcher:acquire、注入 TP 环境变量、生成 NCCL_TOPO_FILE、起两 rank、钉 holderbash run_tp.sh 2 8191 <tag>/home/jay/tp2/p2p_patch.py生成 P2P 拓扑 xml --print输出路径workflow/make_ui_workflow.py从 /history的 API prompt 还原前端 UI workflow(节点坐标/连线/素材)python3 make_ui_workflow.py H3_TP_3D <out.json>workflow/capture_ui.pyheadless Chrome + CDP 截 ComfyUI 画布 python3 capture_ui.py out.png 2600 1520 <wf.json>workflow/make_assets.py成片抽帧 + 日志截图 直接跑 workflow/bench_encode.py编码单测(256×256×22f、1 步,跑两次取第二次) 需 TP 服务在跑 workflow/bench_decode.py解码单测( EmptyMiniMaxH3LatentAV1344×768×294 → 解码 → 封装)需 TP 服务在跑 3D工作流
2D工作流
参数 JSON:
文件 用途 s3d.json3D 单卡正式 s3d_tp2.json3D TP=2 正式 
s2d_tp2.json2D TP=2 正式 s2d.json2D 单卡(未跑,留档) chk.json/s2d_tp.json832×480×56 探针(4 步,验证补丁是否出画面) 前端工作流(可直接 File → Open):
/home/jay/ComfyUI/user/default/workflows/h3_3d_tp2.json、h3_2d_tp2.json。
9. 实测指标
9.1 阶段耗时(1344×768×294)
阶段 单卡 TP=2 测量方式 采样 6 步 1300 s(216.6 s/it) 739 s(123.1 s/it) 进度条 6/6累计文本编码 ≈170 s(推算) ≈215 s 模型驻留后重跑编码 222.3 s,扣 1 步 + 22 帧解码 解码+音轨+封装 ≈116 s(推算) 116.0 s bench_decode.py实测 116.04 s加载/初始化 ≈472 s(推算) ≈473 s 总耗时 − 上三项 合计 1888 s 1543 s Prompt executed9.2 并行效率
指标 值 P2P 拷贝带宽 5.14 GB/s(256 MB × 20 次) 每步理想 / 实际 108.3 s / 123.1 s → 并行效率 87.9% 每步通信开销 14.8 s(12%) 采样加速 / 端到端加速 1.76× / 1.21× Amdahl 上限 1.45×(采样占单卡 68.9%) 9.3 探针(改补丁后必跑)
832×480×56、4 步:406 s,5.37 s/it,抽帧人眼确认非噪声。
10. 复现步骤
步 动作 验收 0 装 ROCm 7.2 + ComfyUI 423cbd20(含 H3 节点)+comfyui-tp2838 行版 +ComfyUI-KJNodes,并按 §5.0 打上 3 个核心补丁、按 §6 放模型md5sum四行与 §5.0 一致;/object_info能查到MiniMaxH3ReferenceToVideo1 停 Strata / 腾内存(≥ 60 GiB 空闲) gpu-mode.sh status显示工作态2 起服务:单卡 run_single.sh;双卡COMFY=/home/jay/ComfyUI-AMD/ComfyUI PY=/home/jay/ComfyUI-AMD/venv/bin/python MIN_FREE_MIB=16384 bash /home/jay/tp2/run_tp.sh 2 8191 h3fix日志出现 ComfyUI Path: /home/jay/ComfyUI-AMD/ComfyUI;双卡还要有[tp2] rank0 lora split keys=208/416与208 patches attached3 探针: chk.json(832×480×56、4 步)抽帧正常;GPU 双卡 100% 4 正式: build_prompt.py --params s3d_tp2.json或s2d_tp2.json采样 123 s/it 左右(单卡 216 s/it),无 CPU 退化 5 落盘兜底: LTXVSeparateAVLatent→SaveLatent×2 → 解码 →SaveVideolatent 存在即可重解,不必重跑采样 6 验收: ffprobe核对 1344×768/294f/12.25s/有音轨;make_assets.py抽帧三条规格一致 7 归档: make_ui_workflow.py+capture_ui.py出真机截图assets/comfyui_workflow_*.png
11. 陷阱
- LoRA 与基座必须配对,否则
adaln_proj.linear.weight shape '[96768, 8]'。 - TP 下
save_latents不要直接喂SaveLatent:AV 合流是 NestedTensor,先LTXVSeparateAVLatent。 - 双卡内存按 2 倍算:每个 rank 一份 27 GB TE,两个 rank 都从 CPU 读。
- 去掉 LoRA 若出现 GPU 0% / CPU 400%,是 fallback 到 CPU,不是慢。
- 单步突然变快要警惕:87.6 s/it 那版是 head 双重切分未修的坏实现,输出全噪声。
gpu-mode.sh acquire的 holder 必须是真main.py的 pid,否则 60 s 后被 watchdog release,出片被 Strata 挤掉。- TP2 与单卡同 seed 画面不等价(归约顺序不同),交付必须同模式同 seed 出生,不能拼。
COMFY_TP_AR_MODE=int8画质未验收,别用在交付片。
- LoRA 与基座必须配对,否则
-
,
 X xiongjie gao 引用了 此主题
-
-

