
748B MoE 云端踩坑手记:Google Colab A100 与 G4 (RTX PRO 6000 Blackwell) 实测对比及工程收口
-
748B MoE 云端踩坑手记:Google Colab A100 与 G4 (RTX PRO 6000 Blackwell) 实测对比及工程收口
在云端用单卡跑几百 GB 的超大规模 MoE,最磨人的往往不是生成速度慢几拍,而是明明帐面上算下来有接近 270 GB 的显存加内存池,实际把几十 K 上下文塞进去时,却因为一条磁盘队列上限或一个默认参数,直接卡成六七分钟一轮的漫长等待。
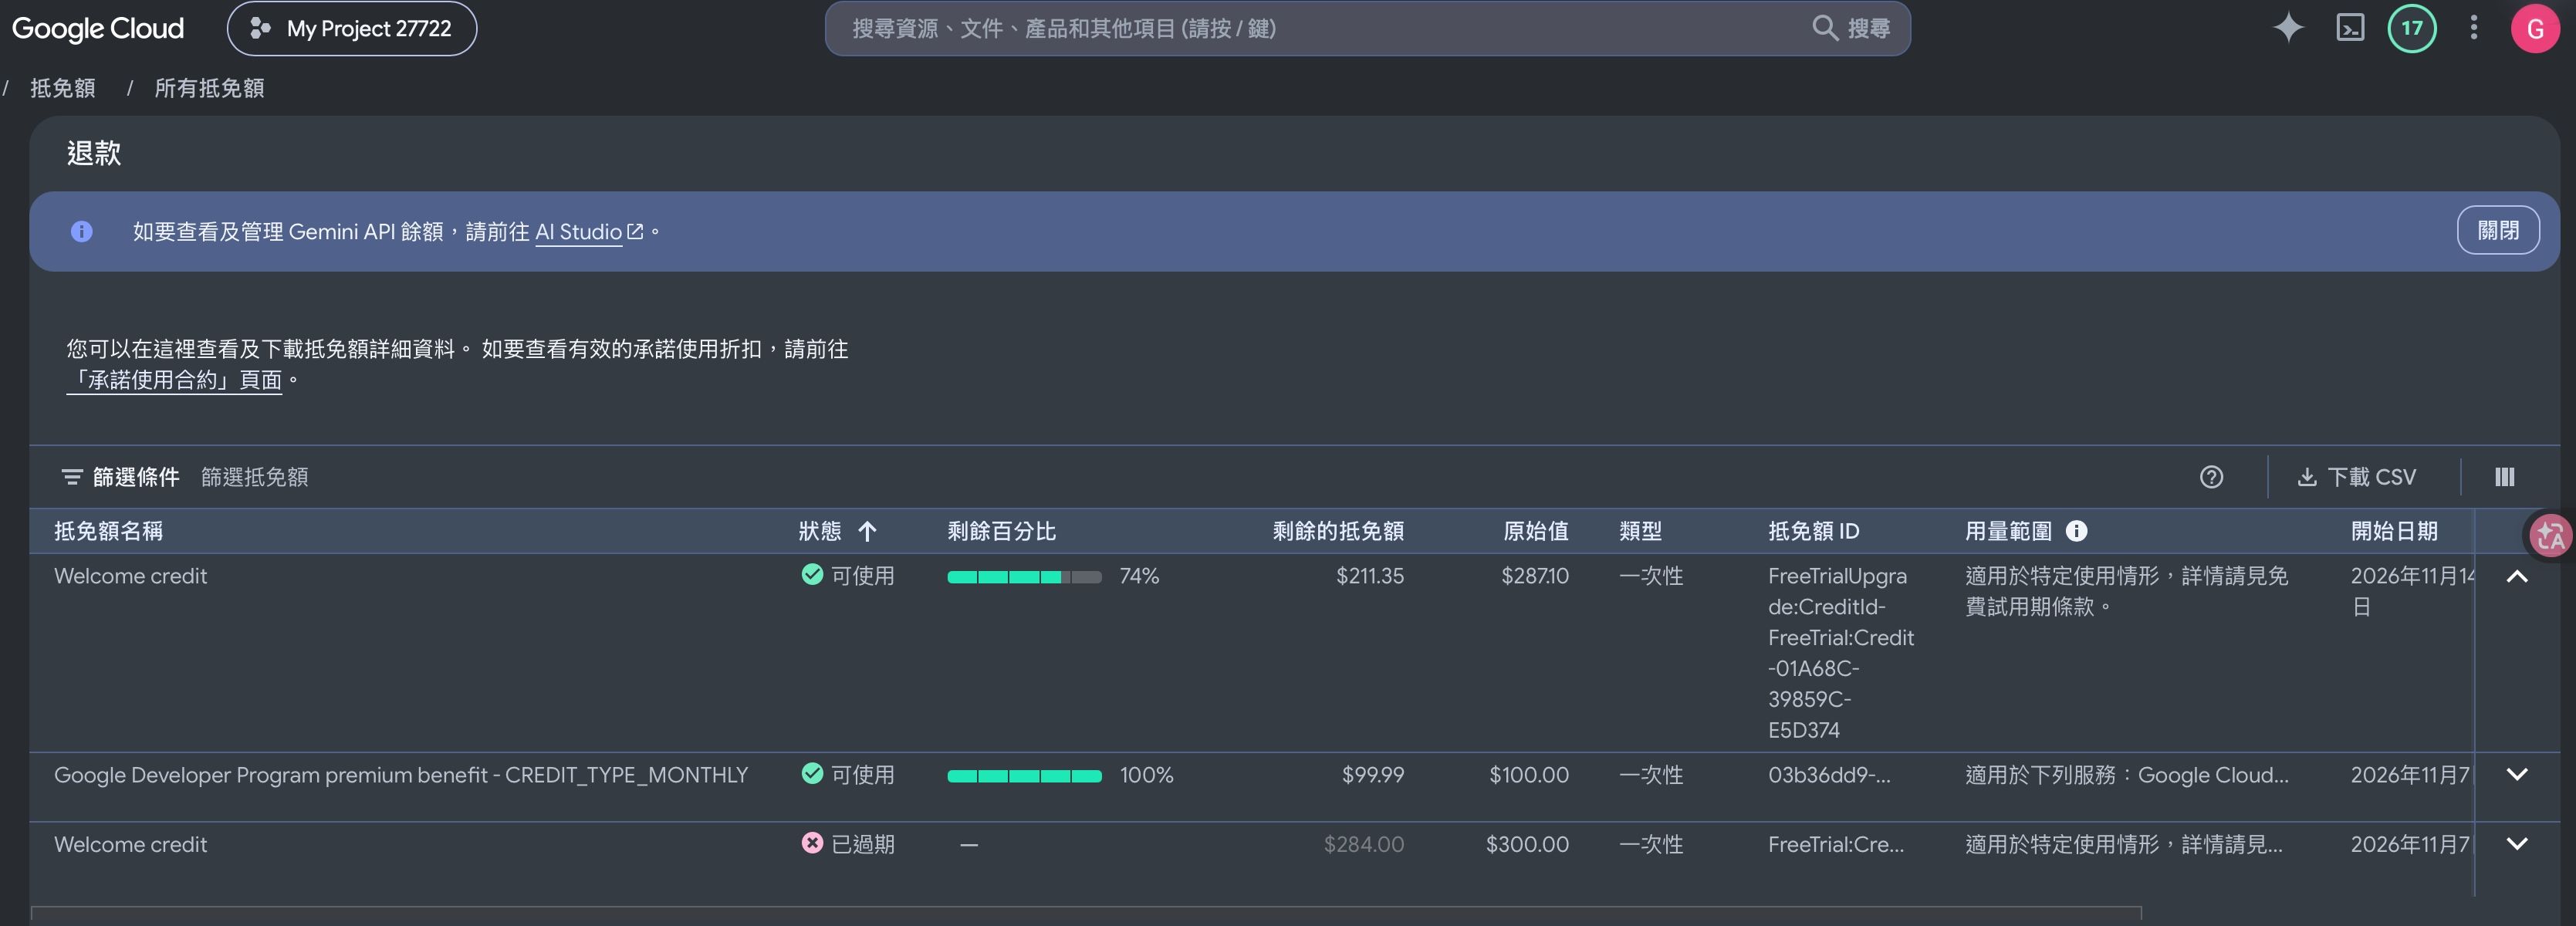
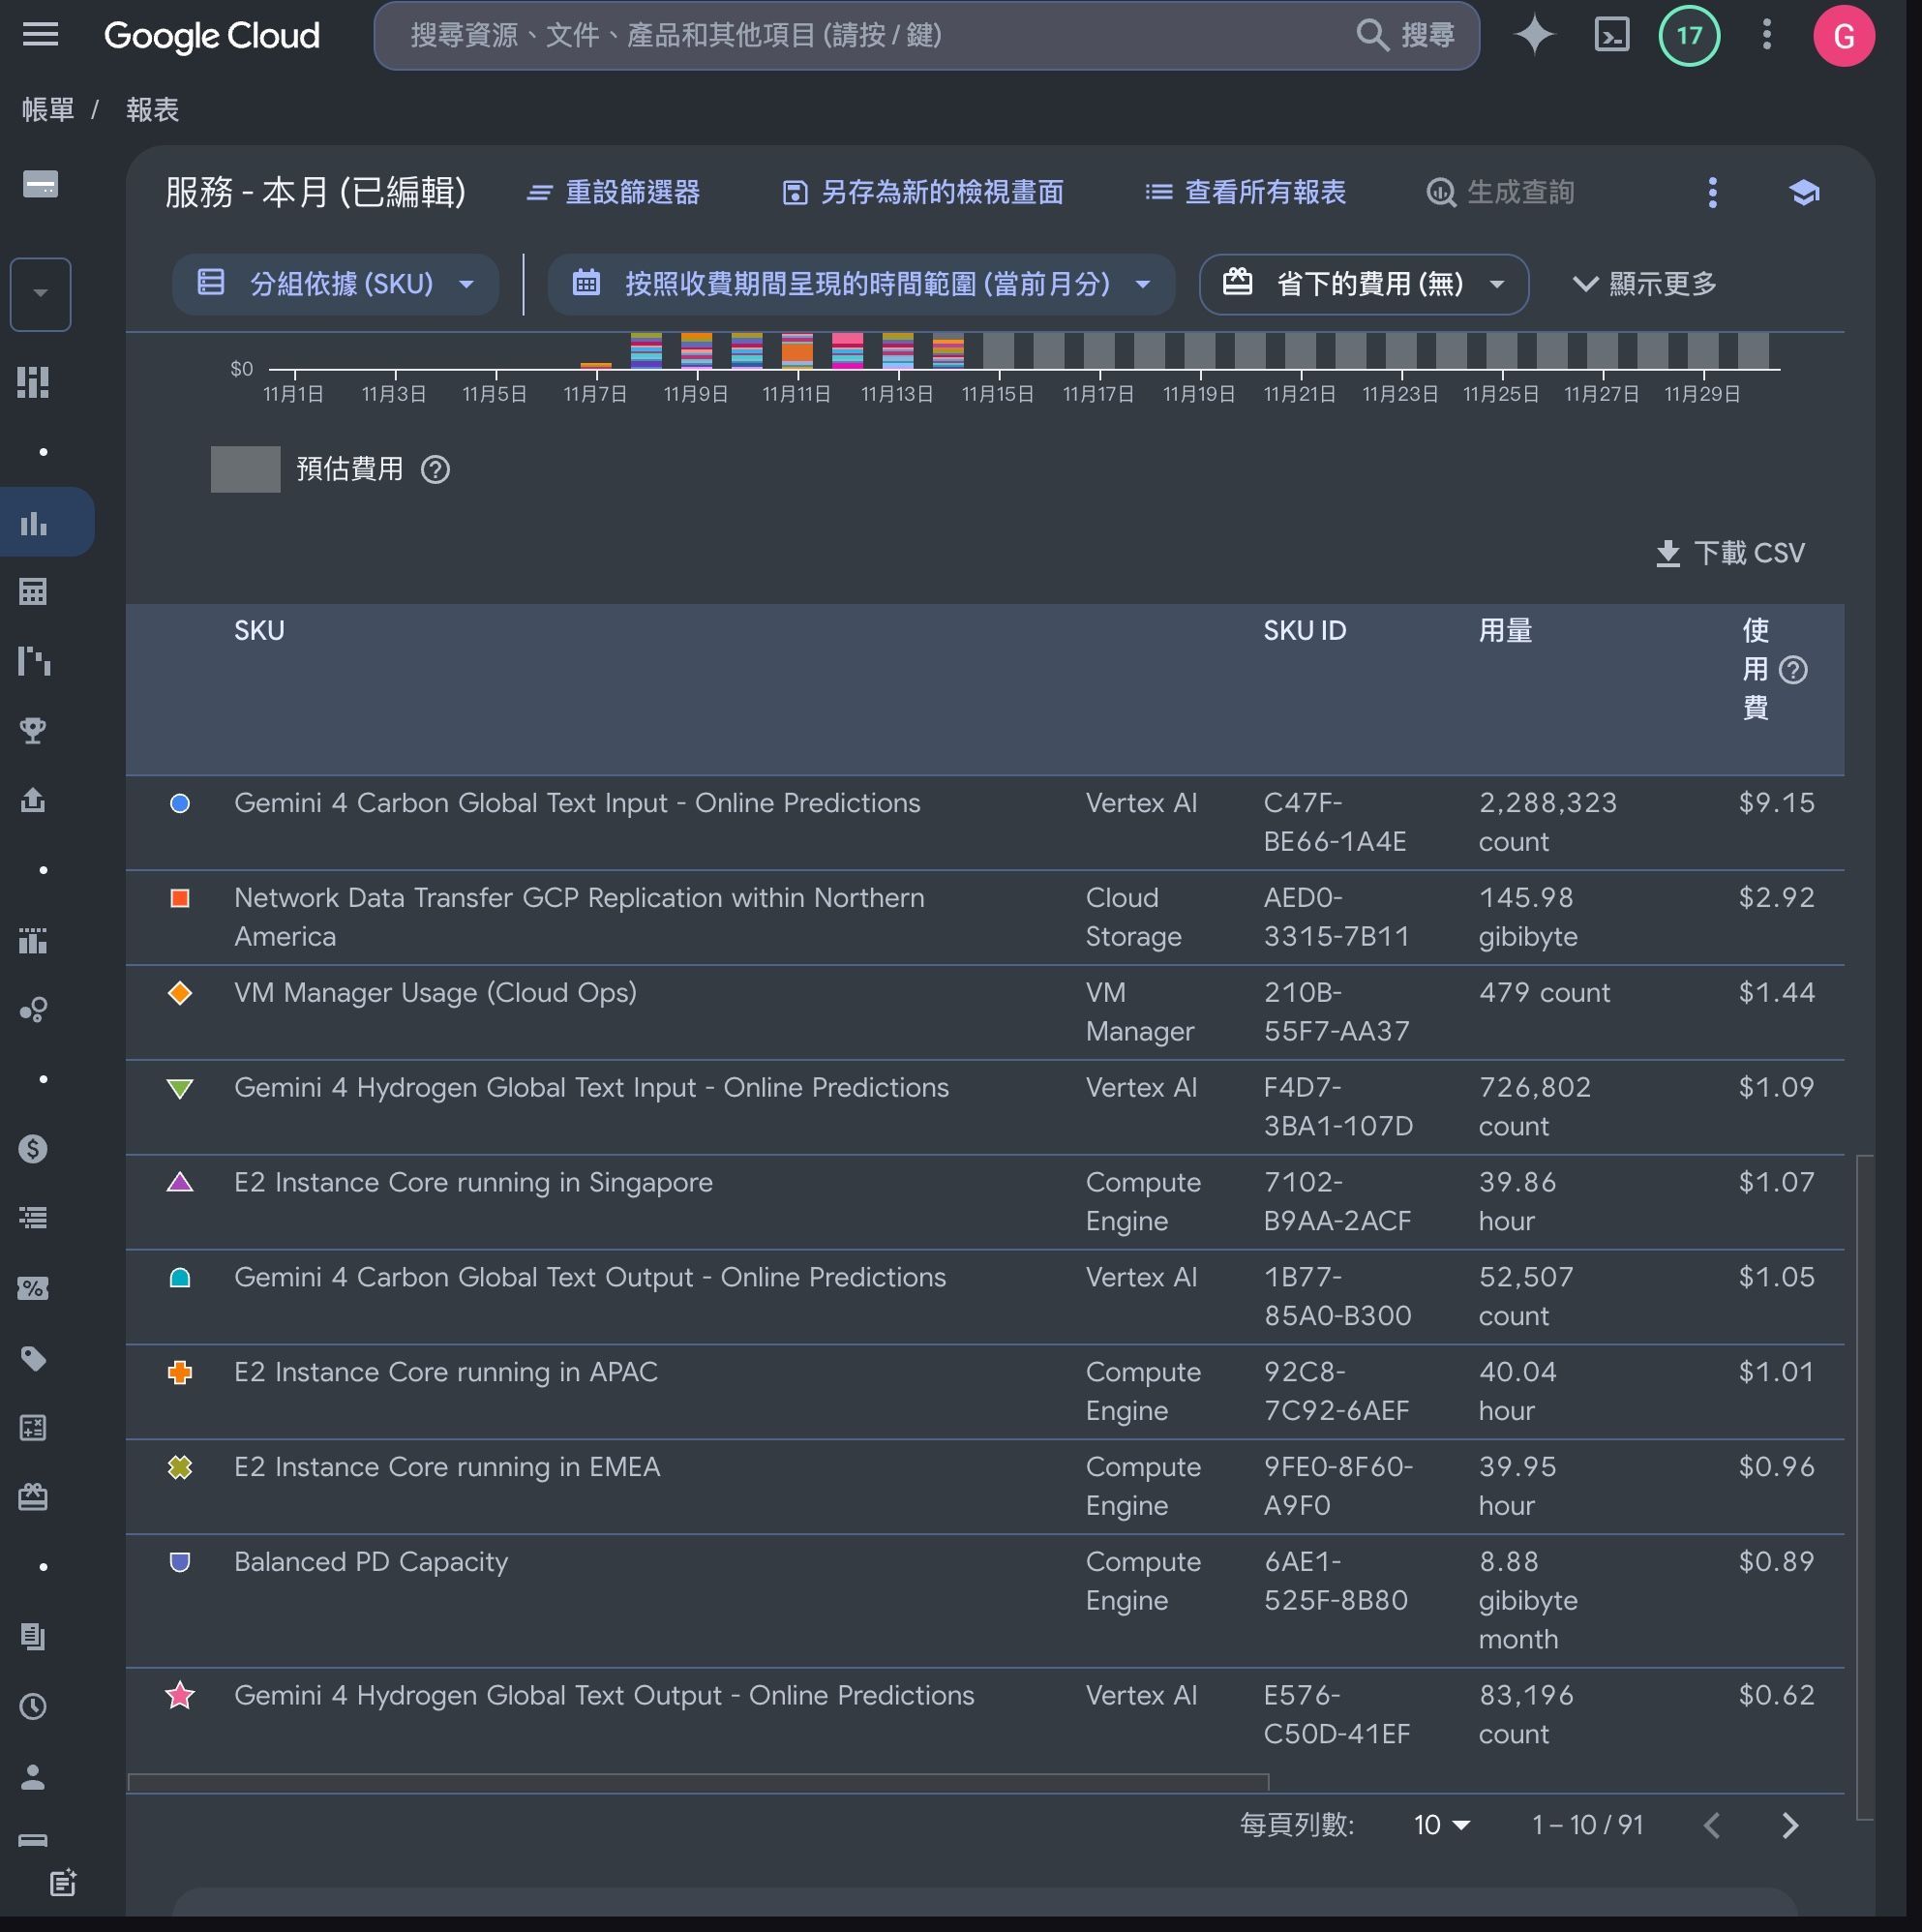
折腾这事的起因其实很实在:土区的 Gemini 20x Ultra 订阅一个月只要 2,999 里拉。本来开这个档位主要是为了敞开用 Gemini 4 系列模型,结果发现套餐里还顺带给足了 Google Colab 的高配算力额度( 每月赠送2500算力点数,按当前G4(RTX 6000)计算,能跑248小时每月,约10天 ,下文描述的GCS桶也涵盖在Ultra Plan每月100赠金的范围内=不额外花钱)。额度放着也是白放,干脆拿来在 Colab 上自己搭后端部署无审查模型。毕竟商业闭源模型再强也有不少条条框框,用现成的附赠算力拉起一套 748B 参数的
DeepSeek-V4.1-Flash-1017无审查版(Mix-256G/abliterated-256g),平时主力刷 Gemini 4,遇到需要无审查输出、完全掌控底层采样或者挂长程本地 Agent 随便造的场景就切到自建后端,两边刚好互补。这几天我们就用这套额度,在 Colab 的 A100 High-RAM(80 GB) 和新上线的 G4(NVIDIA RTX PRO 6000 Blackwell Server Edition 96 GB) 上来回试错。最后调通的那台 G4 实例一路顶满 Colab 24 小时强制断电上限(23 小时 50 分钟),在真实编码 Agent 场景里稳定吞吐了 313 轮以上高上下文请求才下线。
这篇笔记把选卡扣费对比、前后踩过的八个实际坑位,以及最终收敛出来的
LD_PRELOAD加速与一键脚本完整记下来。文内涉及的所有桶名、密钥、项目 ID、本机路径与隧道域名都已脱敏,对应的精简部署代码也整理进了公开仓库 peterhon168/colab-maya-ds4-256g。
一、为什么要从
128g硬切到Mix-256G?最初在 A100 上试跑时,我们先用了压缩幅度更大的
abliterated-128g(权重约 114 GB)。那套方案跑起来确实轻快,实测 Prefill 均速455 tok/s、生成均速66.9 tok/s,显存命中率能到95.6% ~ 98.7%。真正投入长期编码 Agent 任务后,低比特退化露出了马脚:同一批长推理任务里,监控统计连续出现了 6 次 Loop Guard 触发,其中 2 次在长思考阶段彻底陷入死循环,最后被系统强行掐断思考并截断输出。为了保住推理上限与复杂工具调用稳定性,只能咬牙切换回权重精度更高的
Mix-256G。但一算
Mix-256G的文件账单,麻烦就来了。整套包并不是一个单一的 GGUF,而是由四块完全不同 I/O 脾气的资产拼起来的,总计约355 GB(约333 GiB):- 核心权重与路由专家(
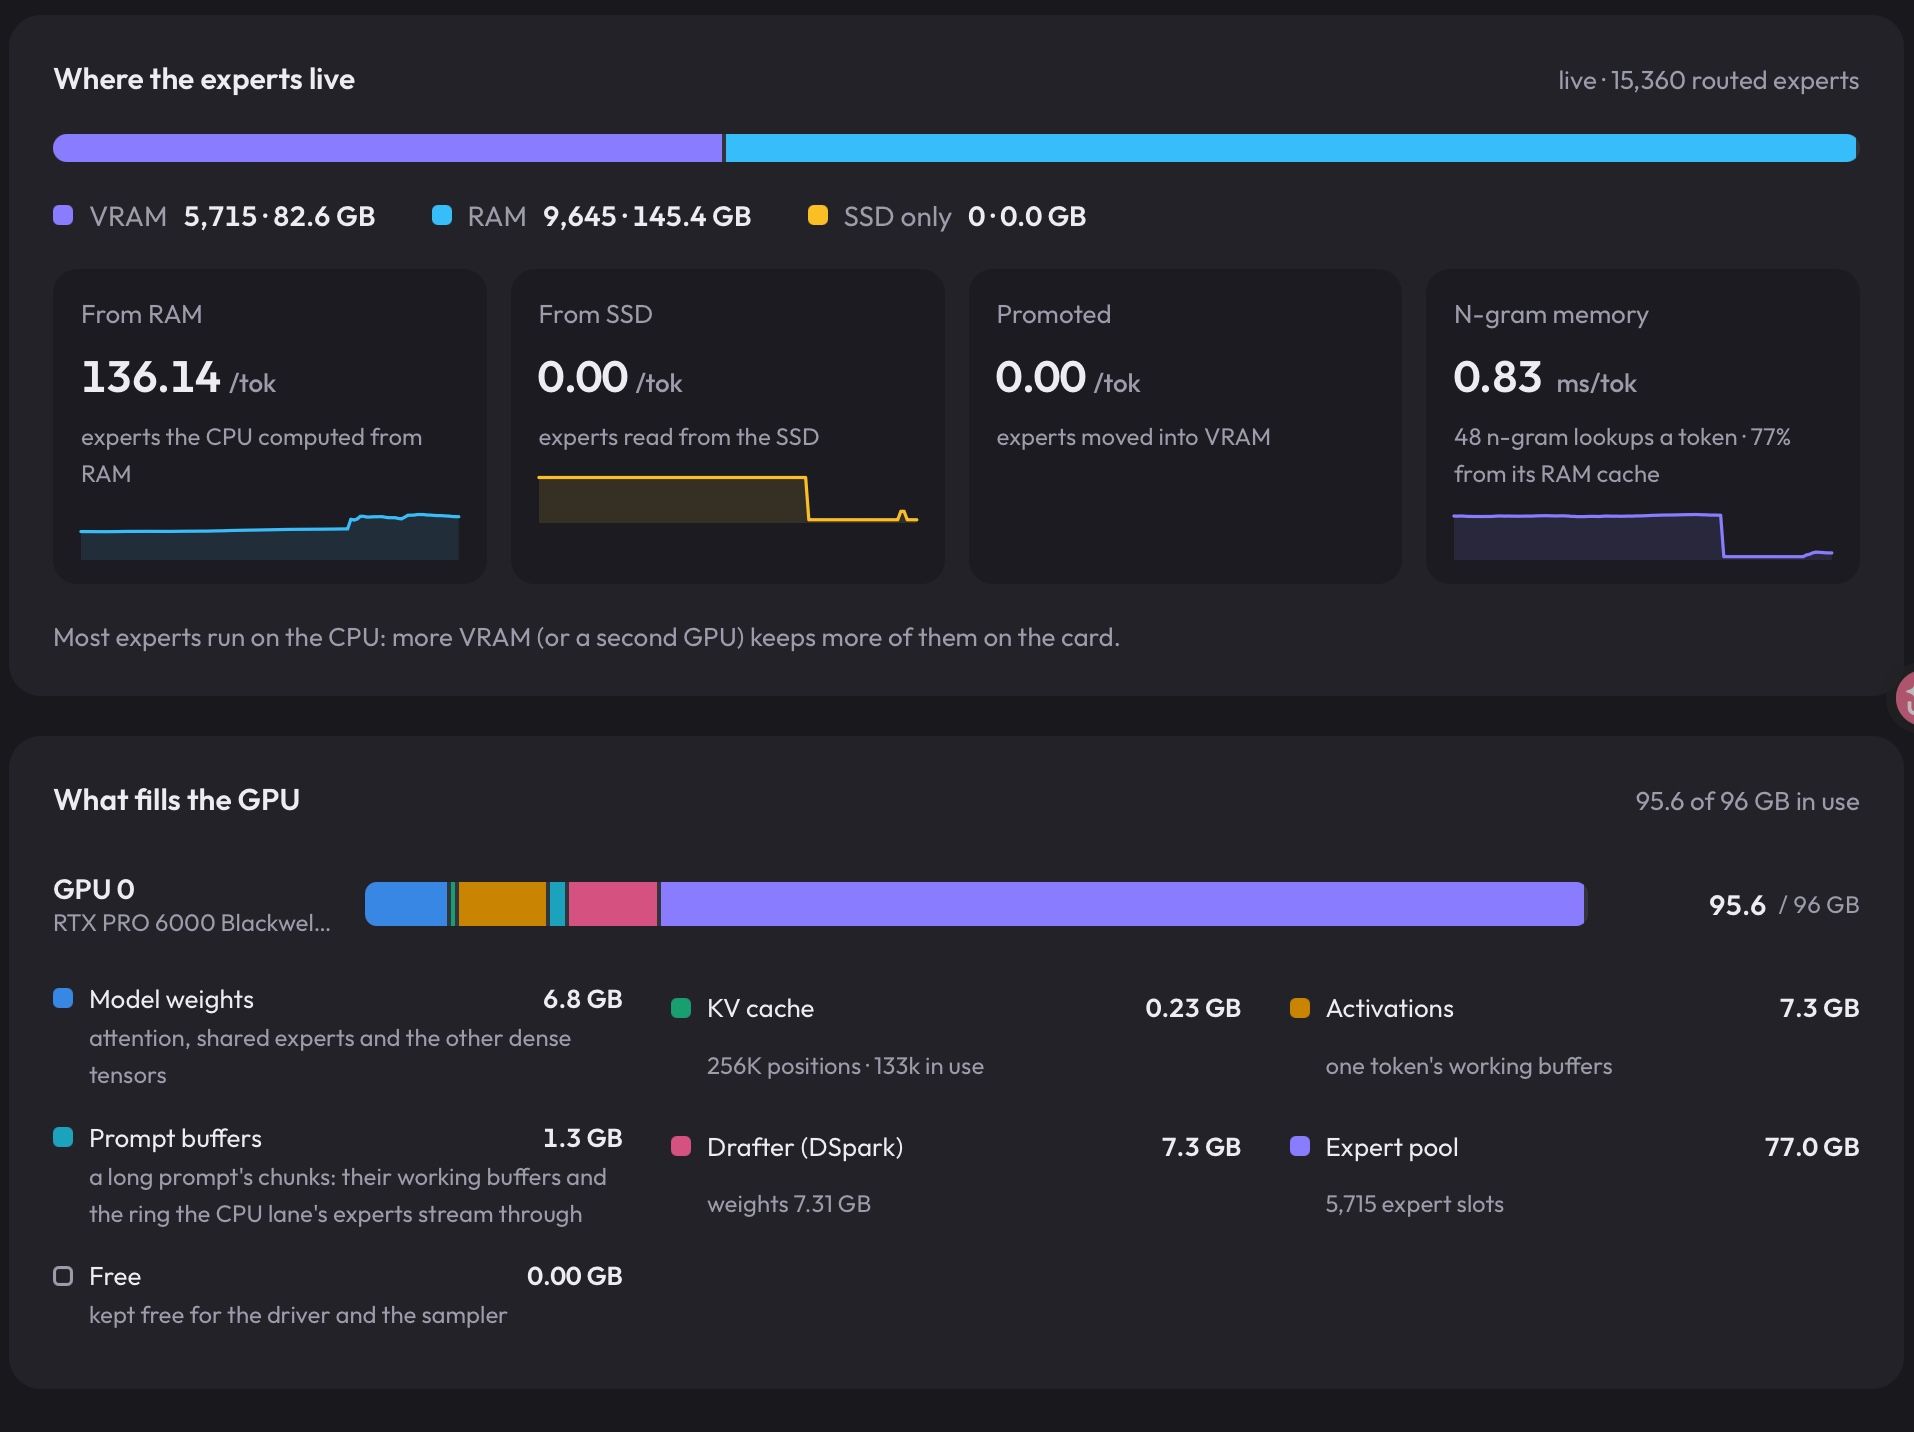
Shards 00001, 00003~00007):合计约227 GB。热点专家与密集层常驻显存,剩下的约 9,600 个低频路由专家如果想免于推理期读盘,就必须全部锁进系统主存。 Shard 00002(103 GiB/110.6 GB):整个架构里最挑盘的一块。里面装的是第 1 层与第 14 层的双层Engram静态记忆查找表。每次读取或生成 token,引擎都要对它发起 48 次随机读,每次仅 144 ~ 264 字节。dspark/dspark.bin(7.42 GiB):Project Maya 的原生投机解码草稿模型(DSpark),负责多 token 草拟与并行校验。开启后有效生成速度能抬高很多,代价是会吃掉大约 7.3 GB 显存。vision/vision.bin(926 MiB):原生视觉编码器模块。实际测下来它的显存策略极其克制,平时几乎不占卡位,后面单独展开。
问题一下子就摆在桌面上:Colab 单机系统内存不到 180 GiB,本地硬盘也往往只有两百多 GiB,怎么把 355 GB 的资产塞进去,还要让 144 字节随机查表和上百 GB 的内存常驻互不打架?
二、先算算力账:Colab 上 A100、G4 与 H100 怎么选?
虽然烧的是
2,999里拉土区 Gemini 20x Ultra 自带的算力单元(如果按官方零售补充包单买大约是100 CU ≈ $10,即1 CU ≈ $0.10),但额度终归有数,怎么把每一份 CU 花在刀刃上还是得算清楚。我们实际核查了目前 Colab 最高三档 GPU 运行时的扣费与硬件规格:对比维度 A100 High-RAM ( 80G)G4 ( RTX PRO 6000 Blackwell)H100 ( 80G)每小时算力消耗 8.88 CU / hr(约$0.89/h)10.05 CU / hr(约$1.00/h)~16.5 – 19.2 CU / hr(随区浮动)GPU 型号与架构 A100-SXM4-80GB(sm_80)RTX PRO 6000 Blackwell Server(sm_120)H100-80GB(sm_90)显存容量 80.0 GB96.0 GBGDDR7 ECC(可用~95.6 GB)80.0 GB系统主存 167.1 GiB(DDR4)176.9 GiB(DDR5)~200 – 230 GiBVRAM + RAM 总池 247.1 GB272.5 GB(净增25.4 GB)~280 – 310 GBCPU 与内存计算通道 12 vCPUIntel Xeon (AVX512-VNNI)48线程 AMD EPYC 9B45 Zen 5(24 线程通道跑至147.1 GB/s)Xeon GPU 功耗墙与总线 400 W/ PCIe Gen4Colab 解锁 600.00 WTDP / PCIe Gen5 x16(H2D DMA 实测56.8 GB/s)700 W/ PCIe Gen5本地磁盘配置 双盘 585 GB可用<br>盘 A/:236 GB<br>盘 B/mnt/local-scratch:369 GB(实测写~409 MB/s)单盘仅 235.7 GB可用<br>nvme_card-pd根盘顺序写~375–380 MB/s,随机 4K 锁死~1,860 IOPS视区域配额而定 抢卡与连续稳定性 中等(高峰偶有排队) 极易(新资源池秒开,连开不排队) 极难抢,常降级或中途被抢占 对照下来,有几个容易忽视但决定整套部署走向的事实:
首先是 H100 在 Colab 上性价比最低。每小时几乎烧掉 G4 的 1.8 倍单元,显存反倒少了 16 GB,而且队列极小,很多时候光是把几百 GB 模型下载完,中途就已经被资源抢占踢下线,算上冷启动耗费完全划不来。
其次是 Colab G4 解锁了完整
600 W功耗墙。平时看到型号带Server Edition,很多人会以为被锁死在400 W机架散热包络里;但在 Colab 实测开启nvidia-smi -pm 1后,功耗上限就是完整600.00 W,Prefill 大矩阵运算时频率与 GDDR7 带宽都能顶满跑。另外还要特别提醒用
colabCLI 建机的朋友:创建 G4 运行时绝不能顺手加上--high-mem。colab new --gpu G4 --high-mem会向后端发送&shape=hm,直接被拒绝并报HTTP 400: Backend rejected accelerator 'G4',因为 G4 本身只有单一的176.9 GiBStandard 规格。老老实实跑colab new -s easycolab --gpu G4即可。
三、一路踩出来的八个坑与对应解法
A100 给双盘但只有 80G 显存、老 Xeon 12 核和 167G 内存;G4 给 96G 显存、Zen 5 48 线程与 600W 功耗墙,却只给一块 235.7 GB 且随机 4K 被锁在 1,860 IOPS 的单盘。后面所有的折腾,几乎都围绕着这两组先天落差展开。
坑 1:把大权重或源码编译放进 Google Drive,并发一开直接
D状态死锁最早图省事,想着挂载 Google Drive
/content/drive复用下载好的 GGUF 和源码树。结果引擎刚起,maya-ds4的读线程大面积钻进 Linux 不可中断睡眠(D状态),机器完全失联;后来在 headless CLI 环境下连 A100 想挂载 Drive 复用历史sm_80二进制时,又连续遇上DriveFS元数据鉴权报mount failed和rclone报403 SERVICE_DISABLED。说到底,网盘客户端那套 FUSE 设计根本扛不住百线程级随机
pread加上POSIX_FADV_WILLNEED预读风暴。解法:彻底把 Google Drive 剥离出模型加载和编译路径。把 G4 (
sm_120) 与 A100 (sm_80) 预先编好的 40MB 级可执行文件、修好的serve/、完整tools/以及耗时约 10 分钟生成的pack_gguf.py元数据全打成压缩包随本地仓库分发(合起来大约 62 MB,开机 30 秒就能还原好)。355 GB 的 GGUF 模型本身,要么用同区域 Google Cloud Storage (GCS),要么用hf_transfer直接走 Hugging Face CDN 落地。
坑 2:G4 单盘塞不下
355 GB引发的0.97 tok/s惨案与容器 OOM在还没接入 GCS 之前,为了在 G4 唯一一块
235.7 GB本地盘上硬塞下355 GB资产,我们走了一步险棋:把 Linux/dev/shm内存盘强行remount到110G来放Shard 00002(103 GiB Engram 表),腾出 SSD 装其它分片。这一刀虽然让磁盘没爆,却切掉了大半主机内存。
176.9 GiBDDR5 被/dev/shm吞掉 103 GiB 后,真正留给 CPU 专家的可用空间只剩约65 GiB,紧接着连吃两记闷棍:- 吞吐暴跌到
0.97 tok/s:因为内存实在挤不下了,6.7%(大约 1,000 来个)的低频专家只能留在慢盘上按需读取。偏偏引擎默认的ahead_mode=1会提前一层狂发POSIX_FADV_WILLNEED预取,加上动态专家替换抖动,导致每吐 1 个 token 就在本地盘里来回翻炒192.7 MB数据,速度直接掉到 1 tok/s 以内。 - 乱压余量直接触发容器 OOM:当时试图把内存安全边际
DS4_RAM_MARGIN_GB压低到2.5 GB抢多一点空间,结果刚发首个对话分配 KV 与激活缓冲,容器立刻把主进程强杀(exit code -9)。
单盘保底解法(对应开源仓库的 Mode B2):如果在没有 GCS 的纯单盘 G4 上必须跑起来,得先把
DS4_RAM_MARGIN_GB调回安全的8.0 GB,配合--no-expert-cache与DS4_AHEAD=0关掉预读,再设置MAYA_DS4_DISK_SKIP_W=1.01(跳过落盘冷专家)以及DS4_PROMPT_PICK=length:65536(把预填充逼入 16-token 解码小窗口避开流式扫盘)。这套组合拳实测能立刻把生成速度从0.97 tok/s救回48.7 tok/s,零磁盘读;但它依然有两块硬伤:一是 Prefill 速率被小窗口死死锁在~142 tok/s,二是确实跳过了 6.7% 的冷专家。正因为咽不下这口气,我们才决心接上 GCS 把/dev/shm的 103 GiB 彻底解放出来。
坑 3:接上同区 GCS 释放全部内存,却踩中
Shard 00002随机读陷阱与49 分钟冷启动挂好同区域 GCS 桶后,先把
110G内存盘归还系统,终于能让 100% 的专家全部驻留VRAM + RAM。但刚一上挂载,又结结实实撞上两堵墙:第一堵墙是千万不能把
Shard 00002留在 FUSE 挂载目录/mnt/gcs里。实测直接让/mnt/gcs扛随机144 ~ 264 B行查表,每秒只能扫出15 ~ 18 rows/s,整机瞬间塌方成8 tok/s;相比之下即便是被限流了的本地 NVMe 也能跑到几千到上万 rows/s。所以分工边界必须划死:Shard 00001 ~ 00004、dspark、vision(共约201 GiB)落到本地 NVMe 根盘,Shards 00005 / 00006 / 00007(约131 GiB)因为只在启动期顺序加载一次然后 100% 进内存,才安全地留在/mnt/gcs做软链。第二堵墙更意想不到:冷加载硬生生跑了
49 分钟(2,940 秒)!抓了网络计数才看出来,00005 ~ 00007明明只有131 GiB,可经过gcsfuse后向 GCS 拉取的总流量高达~645 GB,整整 5.1 倍读放大。原因在于maya-ds4加载权重时开了几十个并发线程按不同张量偏移分片读同一个文件,在gcsfuse内核层看来就是几十路跨段跳跃读,诱发它不断打开、丢弃又重建海量顺序预读窗口,全跑成无效网络流量。
坑 4:百亿权重全锁内存了,为什么长文本 Prefill 还是两位数(
65 ~ 73 tok/s)?模型终于在 GCS 加持下实现
100%显存加内存常驻、disk_gb = 0.0。本以为这下该起飞了,结果刚跑真实 Agent 任务,灌进去一段28.8K的 Prompt,面板显示Prefill: 65 tok/s——硬等了468.4 秒(接近 8 分钟)。回头用POSIX_FADV_DONTNEED清空系统页缓存、单独构造 75K 高熵零缓存长文测试,一样卡在73 tok/s。要抓出凶手,第一步先得拆掉遮羞布:原版
serve/server.py默认会把底层引擎吐出的STAT监控行过滤掉,导致在服务模式下根本看不见每个 token 到底把时间花在哪。给server.py打了 3 行补丁放行DS4_STAT_LOG=1后,一眼就抓到现行:engram_ms每次长文本都飙到几十秒。继续向下查底座存储限制,真正罪魁祸首浮出水面:Colab G4 根盘
nvme_card-pd被云底座限制在大约1,860 IOPS的 4KB 随机读上限,队列深度QD=16就是它全部能吃的极限。每次 Prefill 块一进来,768路并发一起去Shard 00002找几百字节的行,结果 750 多条线程全都排在只有 16 个车位的窄门口干瞪眼。既然主机手握 50 Gbps gVNIC 网卡且 GCS 就在同区机房,最直觉的方案就是把溢出的查表流量分流给 GCS HTTPS 接口。可一开始做单一并发上限门控时,立刻撞进了尴尬的“跷跷板”里:
- 如果把本地盘门槛压低或线程总数压到
64(例如LOCAL_MAX=32):75K冷 Prefill 仅能爬到144.5 tok/s;更要命的是连 Decode 也惨遭牵连,10 轮连续生成里后 6 轮中位数掉到19.02 tok/s(最高也就35.2 tok/s)。原因是开着DSpark验证时每次要并发上百路查表,只要有极少数几个请求溢流到 GCS 吃了哪怕12 ~ 45 ms的网络 RTT 长尾,整个计算步调就会被 GPU 栅栏卡在最慢那条线上。 - 反过来试着把
LOCAL_MAX放大到160保护 Decode:Decode 确实少溢出了,可一旦长文本进来,160 个并发线程全被塞进1,860 IOPS的本地盘排队等成86 ms长队,75K冷 Prefill 速度直接从449腰斩跌回239.0 tok/s。
这里顺便提一个看监控面板时容易误判的统计假象:哪怕把通路修到极致了,在 Agent 几十轮高复用上下文对话中,你偶尔还是会在面板上看到某一轮写着
Prefill: 63.8 tok/s。先别急着排查退化,展开日志看看那一轮的真实数字:Prompt 136,279,Reused 136,266,实际新读入的只有 13 个 token,引擎全程只用了0.203 秒(203.7 ms)。拿极小的 13 除以包含固定核调度的 0.203 秒,表观算出来就是两位数;只要后面突然粘进几千字的工具回显,速率立刻会跳回几百上千。
坑 5:破局——双模态
LD_PRELOAD(gcs_tls_pread.so)与 Blackwell 专项精调想同时拿下“冷启免读放大”、“Prefill 吃满 50G 网卡”和“Decode 绝不碰网络尾延迟”这三件事,其实不用动
maya-ds4那几十 MB 的 C++ 源码重编一遍。我们直接写了大约 990 行独立 C 模块src/gcs_tls_pread.c,编译成动态库经LD_PRELOAD接管文件打开与定位读,把两条负载截然不同的 I/O 链路完全拆开治:- 冷加载
> 256 KBFUSE HTTP/2Range直连旁路(49 分钟 -> 11.6 分钟):- 凡是被
fstatfs识别为/mnt/gcs上打开的句柄,超过256 KB的pread64全量拦截并彻底绕开gcsfuse,复用线程本地libcurlHTTP/2 长连接,凭后台守护进程(maya_gcs_token_refresher.sh)每 1500 秒原子更新写入/dev/shm/.maya_gcs_token(权限600)的 OAuth 令牌向storage.googleapis.com发起精确字节范围拉取;256 KB 以下的小头部读也配套上了 2 MB 线程级窗口。实测直接把冷启动流量从~645 GB压回实打实的~145 GB,纯加载时间砍进11.6 ~ 12.5 分钟。
- 凡是被
Shard 00002三级双模态调度(s2_pread64):- 第一级:零系统调用 Page Cache 命中:追踪到
-00002-of-00007.gguf时立刻附加POSIX_FADV_RANDOM并全局只读MAP_SHAREDmmap,每次读前先走一遍极轻量的mincore()检查——页面已在内核内存池就原地memcpy()返回,连内核上下文切换都省下。 - 第二级:双模态并发阀门
MAYA_S2_GCS_THRESH=160:用原子计数器盯住此刻整个引擎同时压在Shard 00002上的并发读总数。只要tot <= 160(正好完整覆盖正常单条解码与DSpark六步并发验证的<= 144路窗口),100% 原地锁死走本地 NVMe——不仅零网络长尾,而且趁机把热点查表页稳步充进 Linux Page Cache。 - 第三级:
DS4_ENGRAM_THREADS=768+MAYA_S2_LOCAL_MAX=16+8×8HTTP/2 连接池:只有当长 Prompt 注入掀起高并发巨浪(tot > 160)时,阀门开启分流模式:本地 NVMe 严守16个席位跑满1,860 IOPS不阻塞的黄金区,余下的752个并发线程直接排入 8 个工作分片、每片维护 8 条长连接的 64 路 HTTP/2 多路复用 TLS 池(curl_multi),通过50 GbpsgVNIC 直连 GCS 并发吐回行数据;万一上游网关连接超时或遇到 401,立即回退原生real_pread64()本地兜底并同步重刷令牌,保证数据零丢失。
- 第一级:零系统调用 Page Cache 命中:追踪到
搭好这条高速通道后,我们在 Blackwell GPU 上顺手定型了整套环境变量(固化在
resources/maya-ds4.json里):DS4_INDEX_TC=1与DS4_CPU_PREPARE_ROWS=1:将 DeepSeek-V4.1 的kKvFp4pLightning Indexer 切上 Blackwell 第 5 代 Tensor Core(长输入梯度提速),启动期预先验证 4 种 CPU 量化行格式。--prefill-chunk 32768+DS4_LENT_RAM_GB=7.5+DS4_YOCO_CONE=1:单次提示处理块从16384翻倍到32768(提示期间向显存专家区临时借用约7.72 GB、每层 13 槽),同时把内存借用备份槽扩大到8.0 GB(428个槽位),提示跑完仅用 ~110 ms 就全部从锁页内存无损收回,不碰磁盘半下。- 两条一定要绕开的反优化误区:在 G4 全显存加全内存常驻配置里,切勿盲目照搬单盘调优里的
DS4_RECENT=0(会直接丢掉约 30% 解码速度),也别开DS4_ENGRAM_PREFETCH(会引爆后台域读风暴,反过来把正在算 MXFP4 矩阵的 24 个 Zen 5AVX512-VNNI线程堵死)。
在完全去掉调试补丁、干净重启后的生产进程上做独立基准复核,交出的数字非常扎实:
77.8K ~ 80.4K高熵零缓存(DONTNEED驱逐页缓存后)冷 Prefill:391.74 ~ 449.1 tok/s(相比基线73 tok/s提升 5.4× ~ 6.1×)。- 稳态
DSpark解码:10 轮连续400-token 基准中后 6 轮中位数42.02 tok/s(单轮49.35 tok/s),等4 GiBEgRowCache(约1,627 万行槽位)与 OS Page Cache 暖透之后,中位数抬升至46.64 tok/s,单轮峰值可达55.01 ~ 57.7 tok/s。
坑 6:
16,384输出莫名撞墙、死循环治理与客户端记忆惯性后端算力拉满了,实际往
pi/pi-web客户端接的时候却连撞两回软钉子:长代码写到16,384tokens 就硬生生卡死报错,以及长思考偶尔还是在最后关头复读打转。定位下来必须服务端和客户端三管齐下才打通:
- 采样配置补上
"min_p": 0.05:搭配temperature: 0.6与top_p: 0.95,把低于主选词概率 5% 的噪点长尾全部裁掉。之后哪怕在十几万上下文里连续深思熟虑,也极少触及死循环且全部能够轻罚自愈。 - 修补
serve/server.py两处输出上限:原版当请求带入thinking_budget: 16384时,Service.prepare给后续回答留出的空间常把总输出预算压回 16K 边线,/v1/models返回也偏保守。补丁放宽计算余量并在/v1/models明确宣告max_output_tokens: 65536后,服务侧才彻底解禁。 - 清理客户端运行中会话的内存缓存:只改硬盘上的
models.json往往点“继续”还会报错,因为本地网关进程在活跃会话内存里死咬着旧的maxTokens。所以我们在scripts/keepalive_colab.sh同步本地 URL 时顺便做到了强制把maxTokens拉到65536、补上视觉输入类型,并主动向网关发起配置更新与热刷新请求。
坑 7:
--vision on的显存成本居然近乎于零最初一直担心
89.86 GB已经被专家池塞到只剩366 MiB空余,再开视觉模型会不会直接把热专家挤爆甚至触发 OOM。打开
--vision on看了日志和/metrics后才算摸透ds4的巧思:这套vision.bin(32 个视觉块,共926 MiB)平时 100% 蹲在主机锁页内存里,静态占用 GPU 显存刚好0 MiB。只有当请求里真附带图片时,它才向已经规划好的 Prompt 缓冲区临时借用~318 ~ 319 MiB显存做前向编码(每图最高 1,024 tokens),算完立刻归还。也就是说,几乎白赚了一套高上下文原生识图能力。
坑 8:跑满 24 小时断电复盘(Error 530),以及新开空机抓出的最后三颗雷
前面那台经过完整精调的 G4 实例,上线后一路持续扛着真实编码 Agent 连续工作了将近一整天,我们在它被 Colab 强制断电前抢出了全量 5,173 行运行日志,真实生产表现甚至反超离线基准:
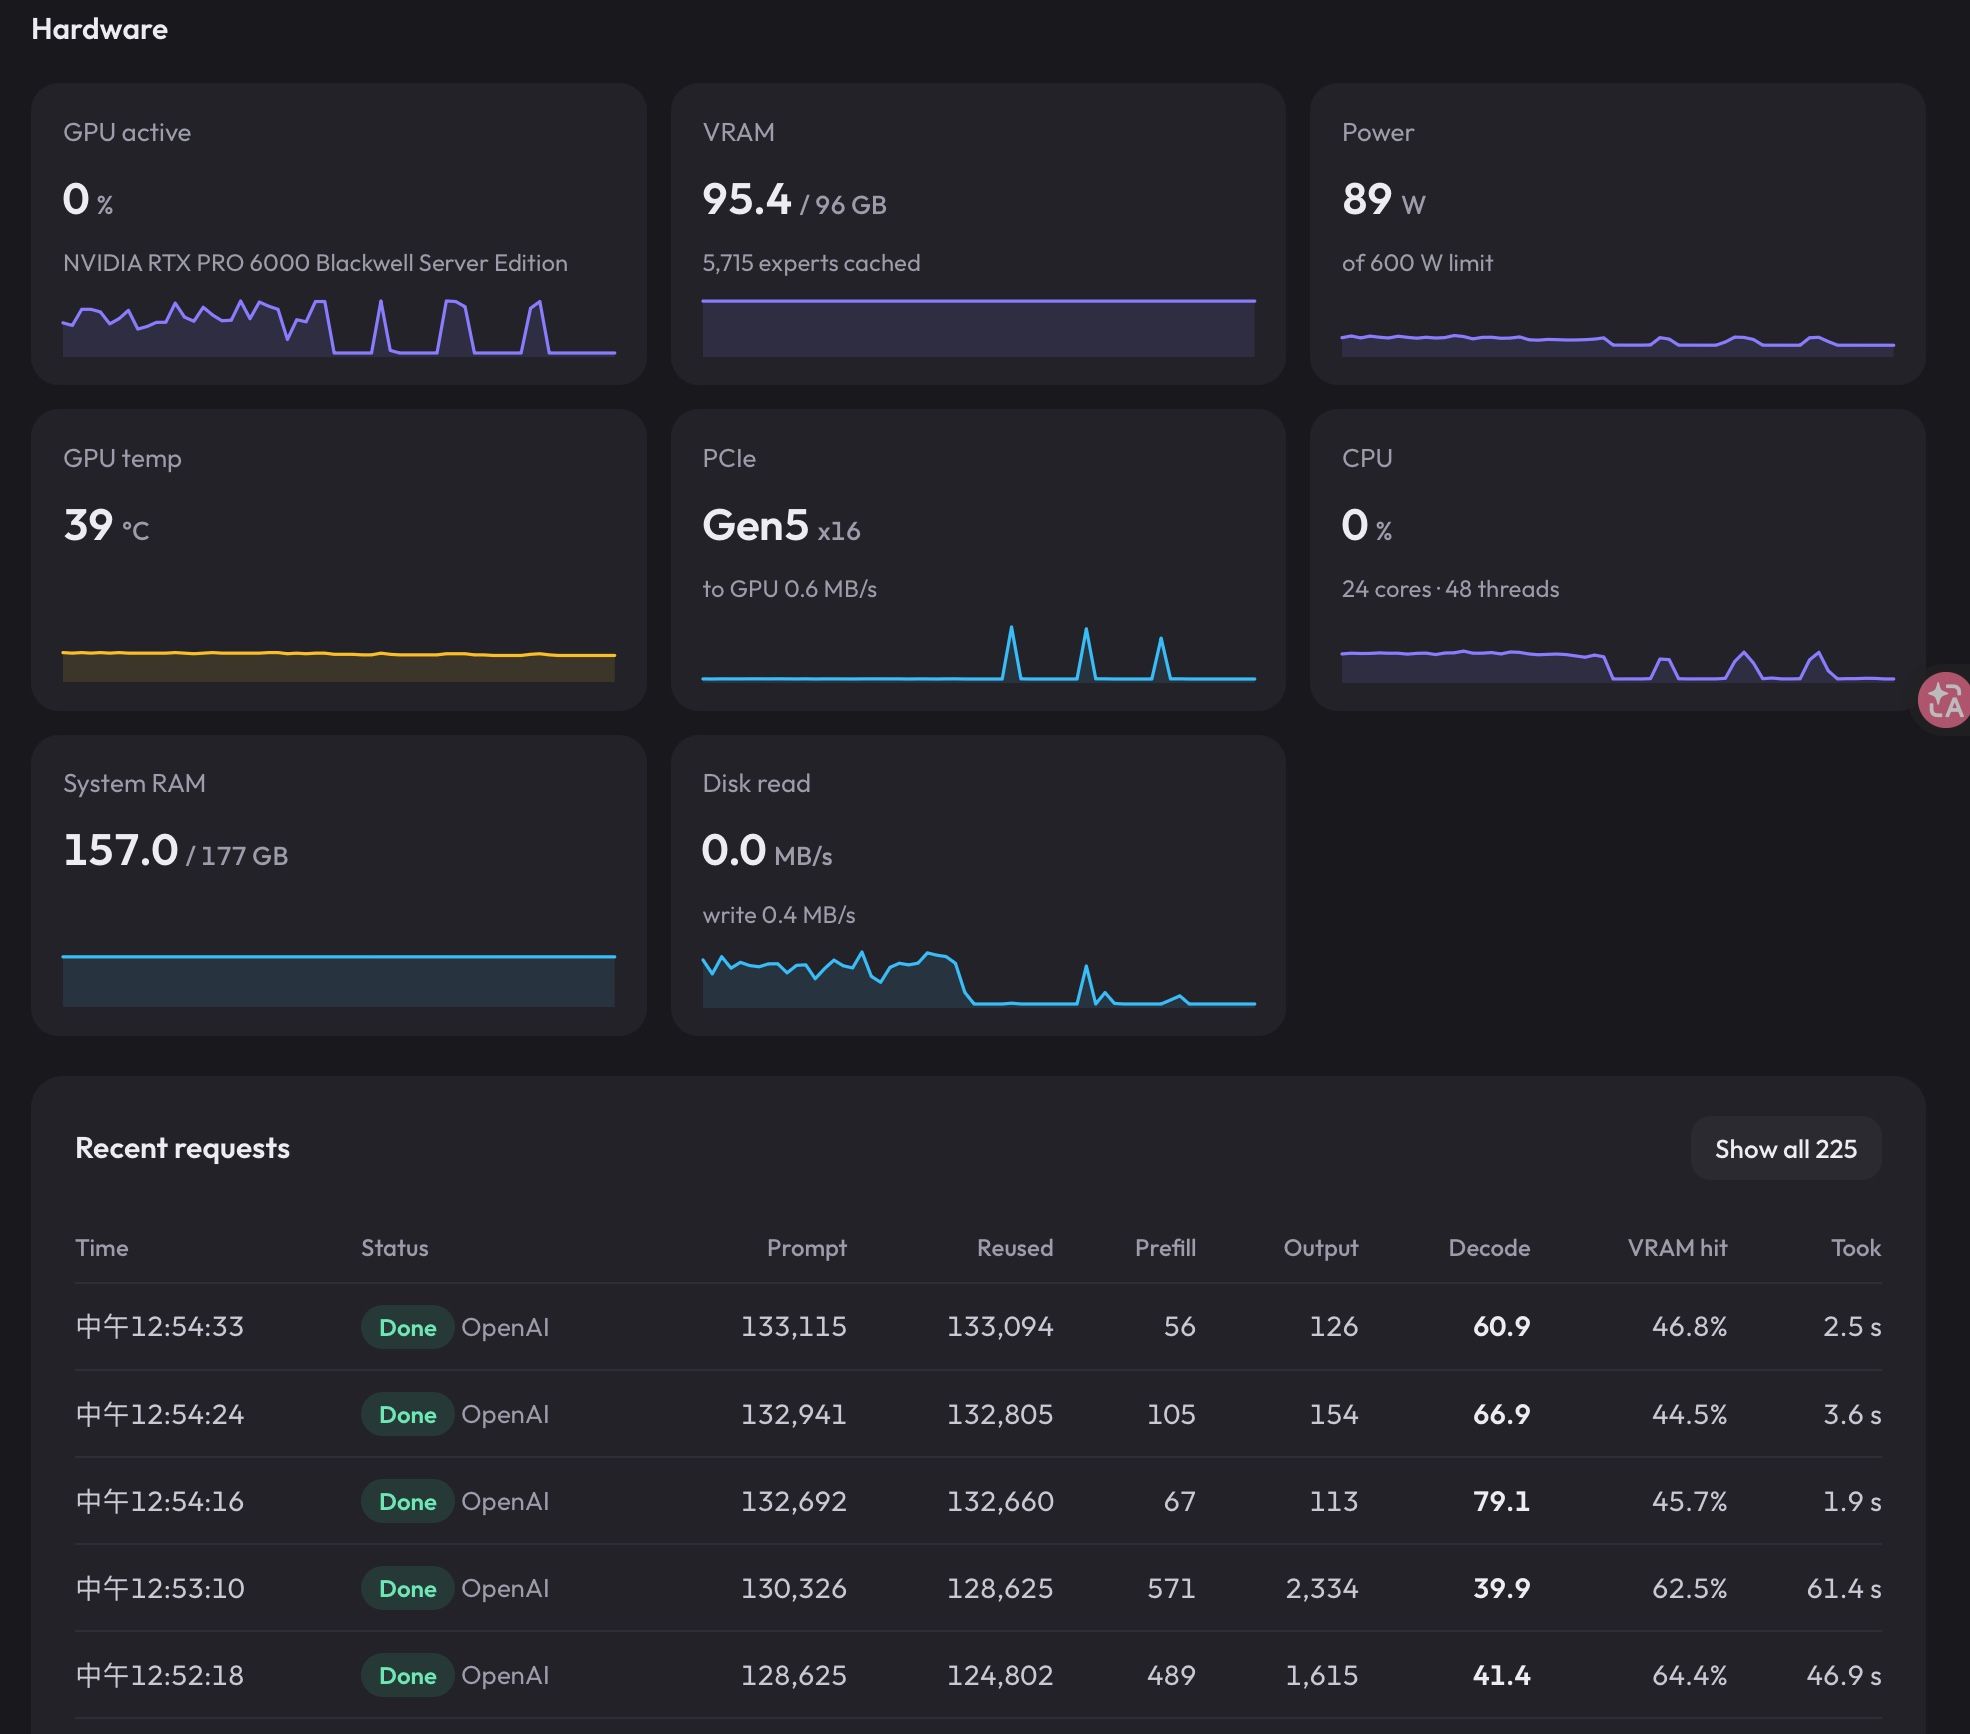
313轮长程真实请求统计:累计新读 Prompt42.5 万tokens 均速531 tok/s(大段代码灌入峰值546.7 ~ 5,596.9 tok/s),累计 KV 缓存复用高达3,525.8 万tokens(复用率98.8%);累计写出13.7 万tokens,全局加权53.2 tok/s,单轮中位数65.95 tok/s、P9097.42 tok/s。尤其在≥ 100K的 178 轮超长上下文请求中,中位数稳在72.57 tok/s,最高一路推到186K ~ 204K窗口(超过 262K 总长的 70%)依然不掉速。- 唯一抓到的一次轻微插曲:全晚唯独在第
4062行出现过一次中段回落(prompt=90,802时新增6,347tokens 花了60.75 s)。翻后台计数器一核对瞬间破案:前面连续几十分钟都在跑小并发增量,GCS HTTP/2 池子空转太久被 Google 前端网关静默回收长连接,恰好又赶上 OAuth Token 轮换到第 3 纪元。突发来袭时首批流超时,直接顺滑走回real_pread64()本地兜底(那轮整整无损接住284,548次查询)并完成重连,零报错且下一波10,777tokens 瞬间弹回1,300.9 tok/s(仅8.28 s)。
正当大家以为能再战两天时,前端画面猝不及防甩回一张通红的
Error 530(CloudflareError 1033)——算表一看正好到 24 小时整。这是 Google Colab 运行时的硬生存天花板(哪怕一直满载不闲置也会到点关机回收;日常如果不发请求,则是 60 分钟 空闲断线)。为了日常不断连,本地得挂着scripts/keepalive_colab.sh每 12 分钟发一次 Jupyter 心跳,同时带上 Mac 端90s进程组超时强杀护栏防卡死,还要小心绕开 macOS 自带bash 3.2在set -u下遇到$VAR后紧邻中文标点报未绑定变量的老旧 bug。最后,今天早晨开了一台崭新空盘 G4 验证全自动一键拉起时,干净环境又抓出了打包流程里的最后 3 个隐藏缺陷:
- 运行时 tar 包当初做了减重,顺手漏掉了
tools/根目录下的maya_import.py等文件,且安装脚本只检tools/ds4/目录就放行了;新建干净.venv时又少装了pillow、psutil、pyyaml、nvidia-ml-py,导致启动刚进maya.py就报错退出。现在仓库里的打包和scripts/start_g4_256g.sh已全部按v1.1.56(22fc101)补全依赖检查。 - 在启动清场阶段用
pkill -f杀残留,在bash -c这类命令行参数里自带目标关键字的子壳里会把自己连带杀掉,改为直接扫描/proc/<pid>/cmdline并主动跳过 shell 进程解决。 - 最后给新开空机算一笔实打实的时间账与流量账:同一台机子只重拉引擎约 12 分钟;一台全新空盘 G4 实例,从 Mac 敲命令算起,约
0.5 分钟传 62 MB 预编译包、0.5 分钟编译 FUSE/C 加速器、10 分钟左右受限于根盘顺序写上限把必需的201 GiB分片落盘,再加上12 分钟上下冷加载就绪,全程约21 ~ 24 分钟。
补充省钱收口(冷启零 GCS 流量改造):最早版
Mode B1每次全新开机直接从同区 GCS 存储桶拉取201 GiB落盘再加载131 GiB分片,一次冷启就要烧掉约343 GiB的 GCS 出站流量(几十美元赠金很快会被开机费刷穿)。后续我们把整套启动链路改造成了默认零冷启 GCS 流量方案:写了一个轻量的只读 C FUSE3 守护程序src/hf_ro_fuse.c挂载/mnt/hf,直接对接 Hugging Face 免费提供的 GCP CDN(us.gcp.cdn.hf.co,0流量费)与HF_XET_HIGH_PERFORMANCE=1(Colab G4 实测单片可达~305 MiB/s);本地落盘的Shards 1–4、dspark、vision与/mnt/hf上的Shards 5–7全部走免费通路,而 GCS 只保留给Shard 00002在长文本Prefill > 160并发溢流时的8×8 HTTP/2突发加速(重度长文本一天也仅几 GB 出站),把月账单稳稳压进 Gemini Ultra 附带的每月$100Cloud 赠金预算里。
四、结语:A100 与 G4 在真实工作流里各归各位
折腾了一圈下来,这两台看似互相替代的机器其实各自站住了很清楚的边界:
- 想要最高日常体验、长上下文编码流畅度和秒开稳定性的主力首选:G4 + Mode B1(GCS 双模态加速)。每小时只比 A100 多扣
1.17 CU(若按零售算力包折算也就多一毛二美金不到),换来的是多出的 15.6 GB 显存、600 W满血 TDP、PCIe 5.0 通道、48线程 Zen 5 DDR5 通道以及十万级上下文下依然几十到近百tok/s的流畅吐字。 - 不想折腾 GCS 存储桶、只打算靠 Hugging Face 单干且追求绝对
100%零跳过专家:选带/mnt/local-scratch副盘的 A100 High-RAM + Mode A。先天双盘585 GB让Shard 00002与219 GB主干各自从容落地,不用写任何LD_PRELOAD拦截器,8.88 CU/h也是三档里最省钱的选择。 - 如果既开了 G4 单盘、手里又暂时没配 GCS:启用兜底的 Mode B2(
/dev/shm+MAYA_DS4_DISK_SKIP_W=1.01) 也能在 15 分钟上下跑通,适合中短对话调试,记得别直接拿它硬吞几万字冷文本就行。
目前这整套配置、
C源码拦截器、多模式自适应拉起脚本和脱敏后的预编译运行包,都已经按 MIT 协议整理在公开仓库 peterhon168/colab-maya-ds4-256g 中(核心引擎二进制源自上游mw00/project-mayav1.1.56)。只要按说明把自己的 GCP/HF 凭据放到仓库外部的~/.config/maya-gcs/目录,就能在一台新开的 Colab G4 或 A100 上用一条命令自动跑完后面的所有步骤。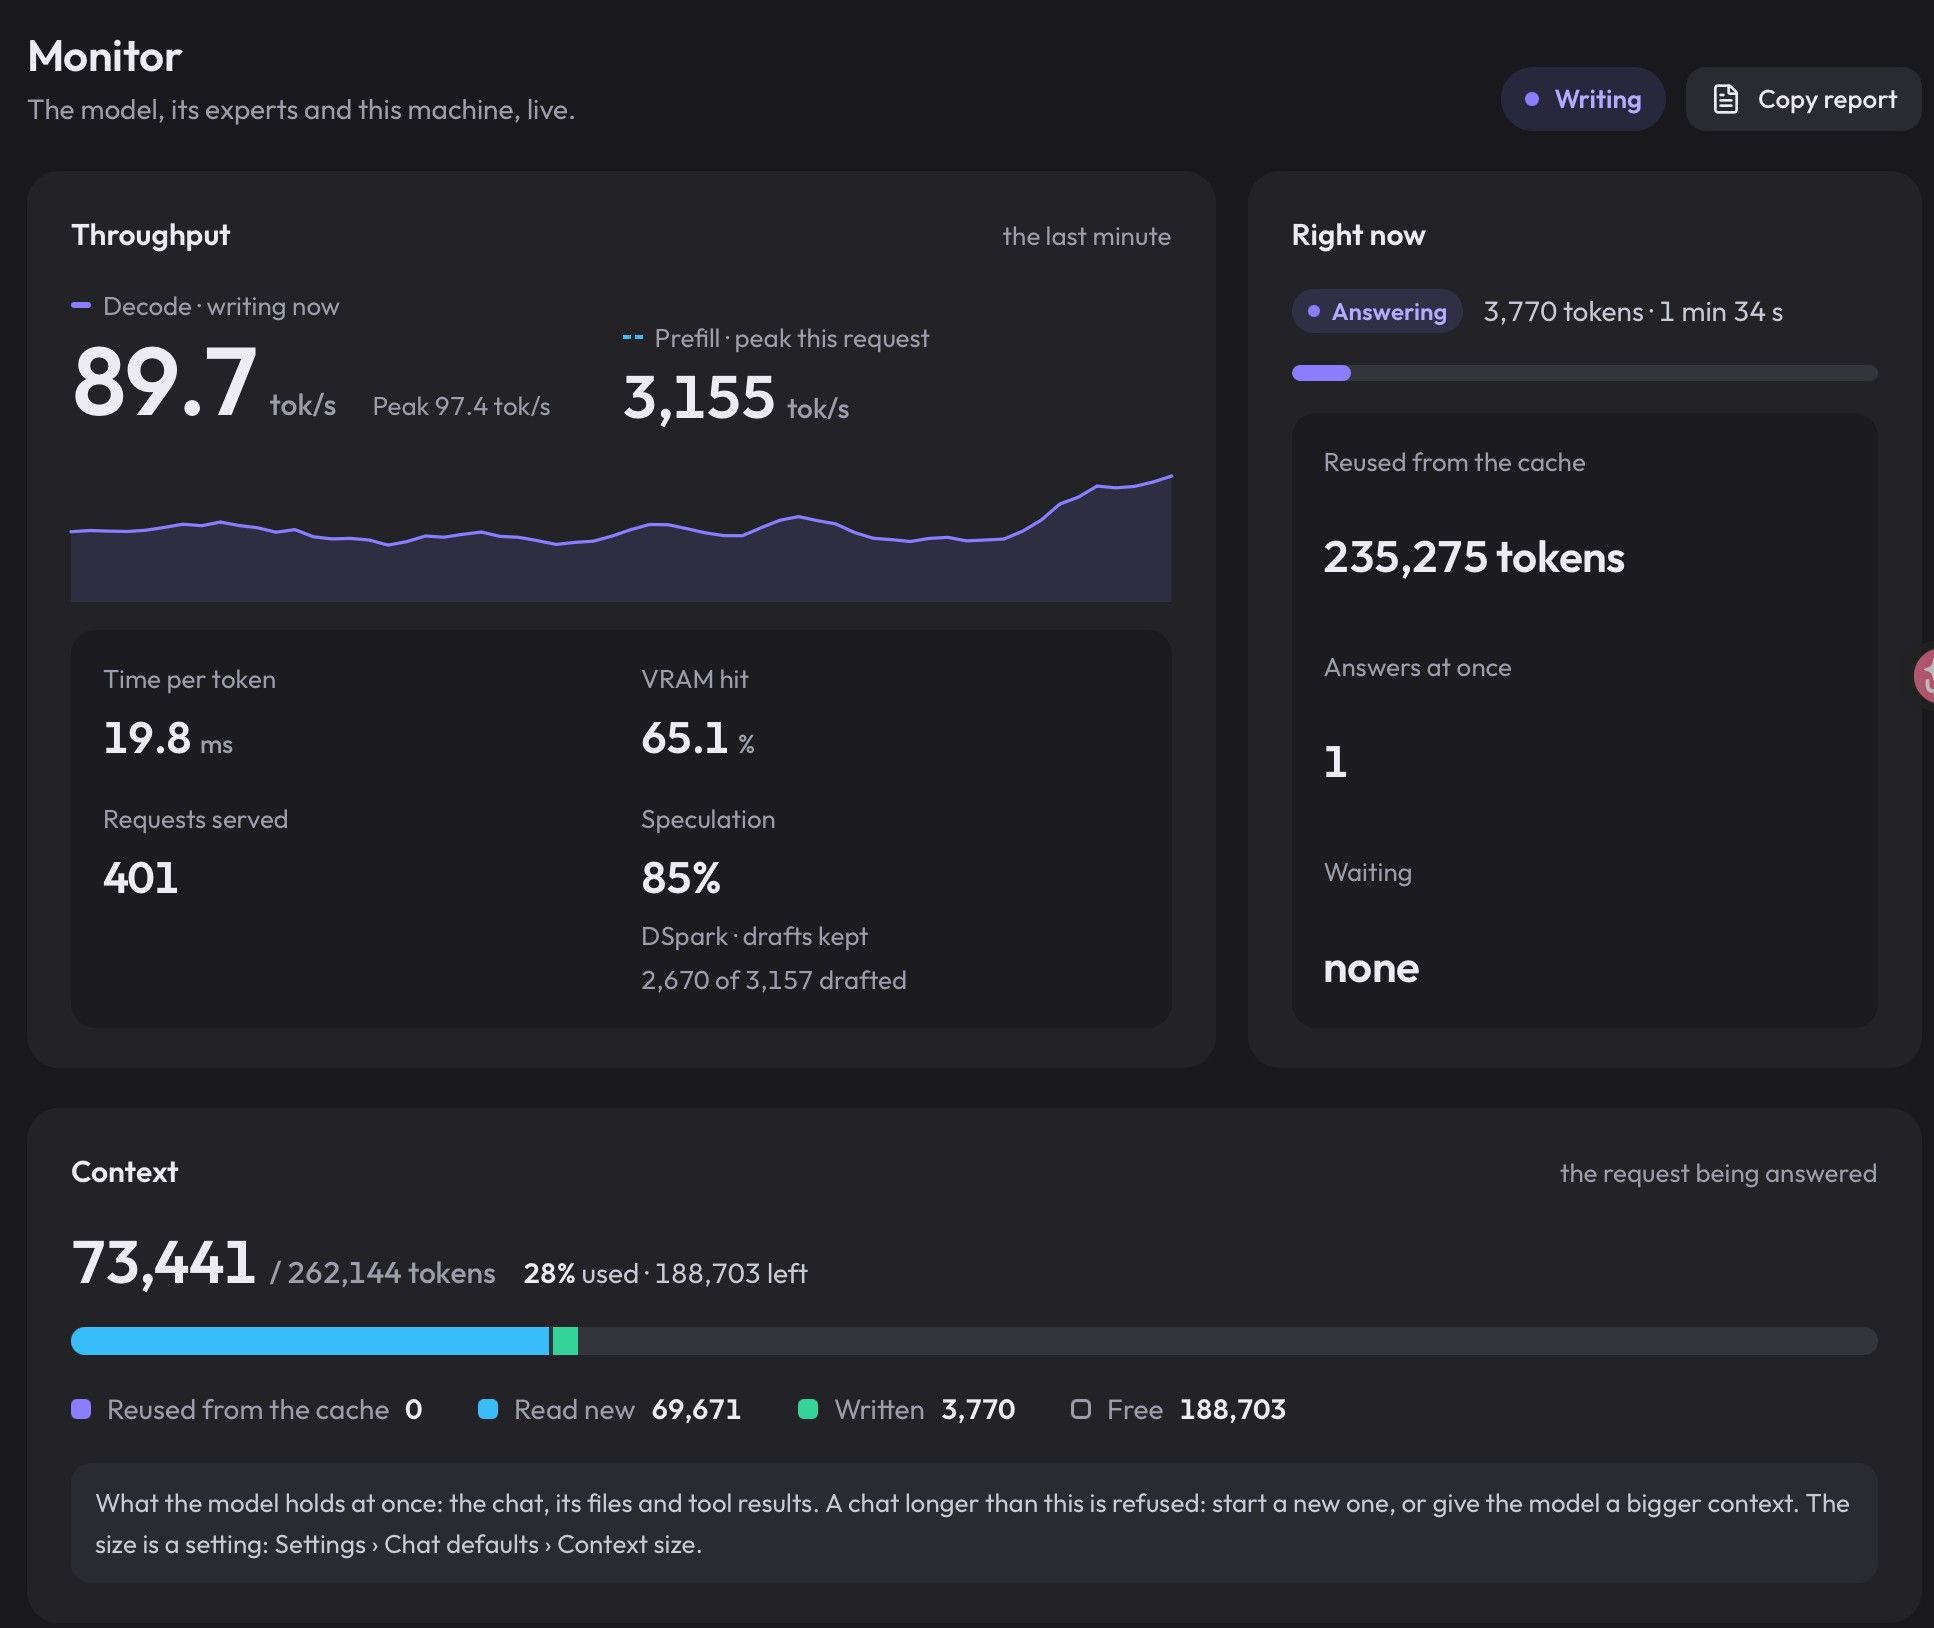
- 核心权重与路由专家(
-

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!