
[H3劍心比賽] RTX 5060 Ti 16 GB 單卡|minimax_h3_ref2v_turbo_4step_v0.1 3D / 2D
-
【場測回帖】MiniMax H3 R2V 1344×768 12s — RTX 5060 Ti 16G(純原生環境)
視頻鏈接(YouTube)
- 3D CGI 風格:{YOUTUBE_3D_LINK}
- 2D 手繪動畫風格:{YOUTUBE_2D_LINK}
一、硬件配置
項目 規格 GPU NVIDIA GeForce RTX 5060 Ti 16G(GB206, Blackwell sm_120) CPU Intel i5-13500(20 核) RAM 64 GB 驅動 / CUDA 580.178.04(Open Kernel Module)/ 13.0 PyTorch 2.12.1+cu130 ComfyUI 0.45.3 原生支持(零 custom nodes,官方 R2V 模板同構) 二、工作流(JSON 見附件
workflow_api_3D_v4.json/workflow_api_2D_v4.json)官方 MiniMax H3 R2V(Reference-to-Video) 原生節點路線:
CLIPLoader(qwen3vl_32b_nvfp4_awq) ─┐ UNETLoader(ref2va_pruned_int8_convrot) → LoraLoaderModelOnly(turbo_4step) ─┬→ BasicGuider ─┐ VAELoader(video_vae_fp16) ────────────┐ │ ├→ SamplerCustomAdvanced VAELoader(audio_vae_fp32) ────────────┴→ MiniMaxH3ReferenceToVideo(6×ref, 1344×768, 294f) ─┘ (res_multistep/simple) → VAEDecode + VAEDecodeAudio → CreateVideo(24fps) → SaveVideo- 1344×768;12s→24fps×12=288 幀按官方模板公式對齊 17k+5 格 = 294 幀(實長 12.25s)
- 參考圖:帖方提供 6 張(3+3),4x 預放大後縮至短邊 1366、
ref_image_size=max - 提示詞:帖內統一 Prompt,僅 style 標籤與
<Picture 1..6>綁定句按模板慣例調整;v4 另加 3 條動作修正指令(跑向方向/碰刀點位/一人一刀),原文見prompt_3D_v4.txt - 兩支同種子 20261115,只差 style 標籤
三、加速手段
手段 使用 官方 Turbo 4-step LoRA(minimax_h3_ref2v_turbo_4step_v0.1)  20步→4步(兩支同標準,公平對比)
int8_convrot 量化 DiT(官方倉庫,Comfy 推薦 cu130 首選) 16G 顯卡唯一可行档次nvfp4_awq Qwen3-VL-32B 文字編碼器 Blackwell 原生 FP4Video VAE fp16(int8_convrot VAE 實測影響還原度,已換) 動態 VRAM 調度(comfy-aimdo) 16G 分頁載入 20G DiTSageAttention / CK flash-attn / SOL Attention  未使用——torch 原生 SDPA(日誌 "Using pytorch attention")。50xx+cu130 上第三方 attention 生態仍缺,原生路徑即最快
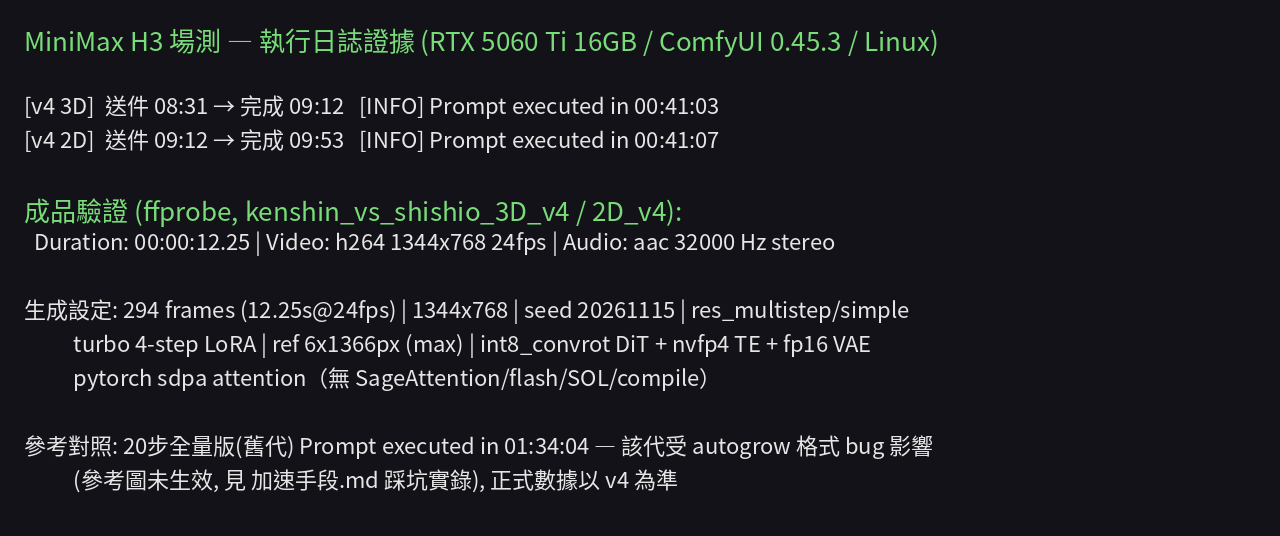
四、完整運行時間與日誌證據(見
log_evidence_v4.png/raw_log_evidence.txt)視頻 Total Time(日誌原文) 成品驗證 3D v4 00:41:03(Prompt executed) ffprobe: 12.25s / 1344×768 / 24fps / h264+aac 2D v4 00:41:07(Prompt executed) 同上 - 單步實測 ~600 s/it(4 步×~10 分鐘,294 幀 1344×768);含 32B 文字編碼器載入與影音雙解碼
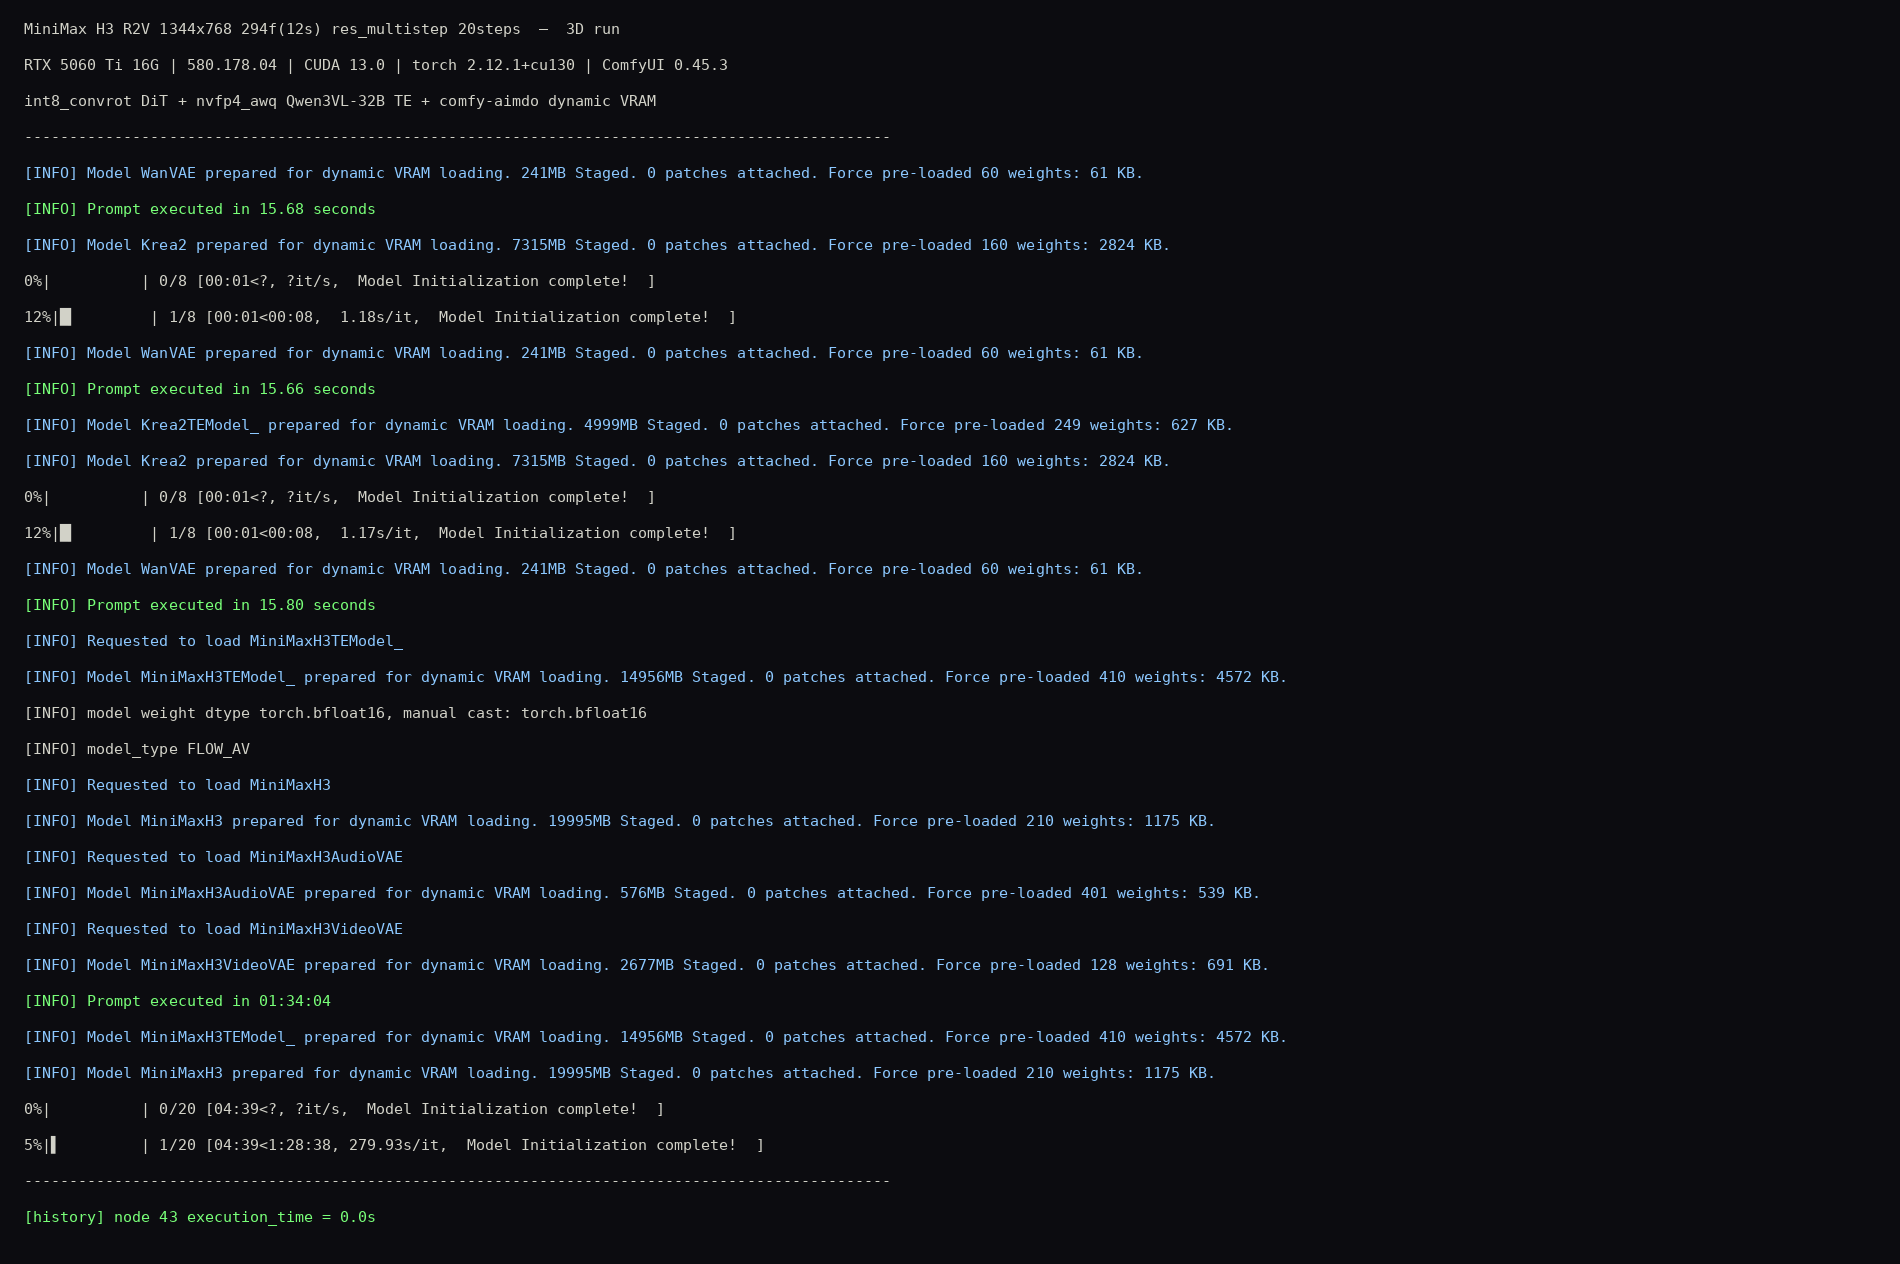
- 對照組:未掛 Turbo 的 20 步滿步版 Total 1h34m04s(
log_evidence_20步對照組.png,舊代受下述 autogrow bug 影響參考圖未生效,僅作速度參考)
五、踩坑實錄(16G 卡的「生態虧」)
- API 格式 autogrow 陷阱:
ref_images以 dict 內嵌連結經 API 提交會被執行器靜默丟棄——零參考生成(同種子像素級證實),必須用扁平鍵ref_images.ref_image_N。官方 UI 匯出即扁平鍵,雲端不受影響,純 API 玩家會白跑半天 - VRAM 牆:6×2048px 參考圖在 TE 視覺編碼必 OOM(16G),6×1366 可行——參考圖解析度直接影響角色還原,16G 卡要在「解析度 vs 參考圖張數」間取捨
- 量化檔位差異:int8_convrot video VAE vs fp16 VAE 對角色細節還原有可感知差距,已換 fp16
六、2D vs 3D 作法差別(同卡同標準)
两支視頻同管线、同权重、同种子、同参考图、同分辨率/帧数/步数,作法上只有三层差异:
層面 3D CGI 版 2D 手繪版 唯一變數 style 標籤 (Style: 3D CGI animation)style 標籤 (Style: 2D traditional anime)與參考圖的相容性 參考圖是 2D 同人圖,style 標籤要「對抗」參考圖的扁平畫風 → 風格拉扯較明顯,角色細節(髮絲、衣紋)被 3D 化重繪 參考圖本來就是 2D,style 標籤順勢而為 → 筆觸、配色與原圖貼合度高 實測缺陷傾向(同種子) 双人特寫時身分互竄(碰刀瞬間換臉)、道具增生(單刀變雙刀)——3D 場景細節多、注意力被物件搶 對運動方向指令更敏感(「跑向對方」被誤解成背對跑)——2D 鏡頭語言簡潔,動作描述錯誤無緩衝空間 有效修正話術 Identity lock+Weapons lock 兩段鎖(外貌特徵禁互換/一人一刀) 動作描述加方位副詞(TOWARD/face-to-face/closing the distance) Total Time 00:41:03 00:41:07(差異<0.2%,風格不影響速度) 結論:模型對兩種風格都是原生能力,成本完全相同;差異全在 prompt 工程——3D 要鎖「身分與道具」,2D 要鎖「動作方位」。參考圖本身的畫風是 2D 時,2D 版的角色還原天然吃香,这不是卡的問題,是 R2V 特性。
主觀畫質觀感(待補):{QUALITY_NOTES}
七、環境對等聲明
純公版起跑線:ComfyUI 0.45.3 官方安裝、零 custom nodes、官方 R2V 模板同構、官方 Turbo LoRA。唯一因地制宜是 16G 顯卡採用官方推薦 int8_convrot+nvfp4 量化組合。是骡子是馬拉出來遛——16G 消費級 Blackwell 的全部真實成本(量化取捨+VRAM 重試+無第三方 attention)都已如實列在上面。
prompt_2D_v4.txt prompt_3D_v4.txt raw_log_evidence.txt workflow_api_2D_v4.json workflow_api_3D_v4.jsonPS: 開始都丟給AI, 後續成片有幾次不合理的地方, 讓AI修正.
-
,
 X XXX 引用了 此主题
-
-

