
【H3剑心比赛】 AMD 7900XTX 24G 单卡|MiniMax H3 3D / 2D
-
首先感谢锤哥的邀请,看到比赛题目的时候心里咯噔一下,让AMD的显卡去跟论坛里面的N卡大佬做视频比赛,这不是关公面前耍大刀吗——找切!
玩过A卡做视频的都知道,这个本身就不是同维度的竞争。但是硬件既然买了,就要尊重他存在的客观性,把他本身的能力极限找出来,卡在我们手上也算物有所值。我就来打个酱油,凑个数。
弱势的卡,拼速度是绝对拼不过的,对于视频生成,我的用卡理念是:
在 能动 和 能用 之间,我选择——能用!
在下能力有限(主要是钱有限),视频大概也只能到这个水平了,大家轻喷,以后我再多努力向论坛的诸位大哥多学习。
该方法不具备生产力!
该方法不具备生产力!
该方法不具备生产力!MiniMax H3 单卡 1344x768|3D
Youtube VideoMiniMax H3 单卡 1344x768|2D
Youtube Video###############################################
MiniMax H3 单卡 自由发挥
Youtube Video我说一下为什么会有这个自由发挥,因为MinimaxH3是一套吃提示词的工作流,这次重点测试同一套提示词能生成什么,也就无法发挥这个工作流的真实能力,那么在无法控制的情况下只能靠抽卡咯,这个是我抽得还算不错的,额外供大家开心一乐。
硬件配置:
AMD Radeon RX 7900 XTX 24GB(gfx1100),ROCm 7.2,单卡
CPU 侧 ComfyUI v0.31.0,端口 8288
注意力后端 comfy kitchen attention(ROCm 不支持 Sage / Flash / CK Flash / SOL)
显存峰值约 22GB,单步 217 秒(3D)/ 213 秒(2D),9 步采样
工作流:
见附件 workflow_3D.json 与 workflow_2D.json(ComfyUI API 格式,可直接 POST 到 /prompt)
主干 minimax_h3_fl2va_pruned_int8_convrot + qwen3vl_32b_minimax_h3_int8_convrot
采样 euler / beta / 8 步 + H3SigmaRefiner 1 步精修
LoRA:8 步蒸馏 1.0 + 打戏 KungFu step4500 0.3
双参考图锁角色,ref_image_size = match
加速手段:
1. UNET 与文本编码器均用 int8 convrot 量化
2. 8 步蒸馏 LoRA(turbo_8step_v1.0_768p)把步数压到 8 + 1
3. comfy kitchen attention 降低长序列显存与算力
4. ReservedVRAMSetter + VRAM_Debug 每任务前清显存,启动带 --reserve-vram 2
运行日志:
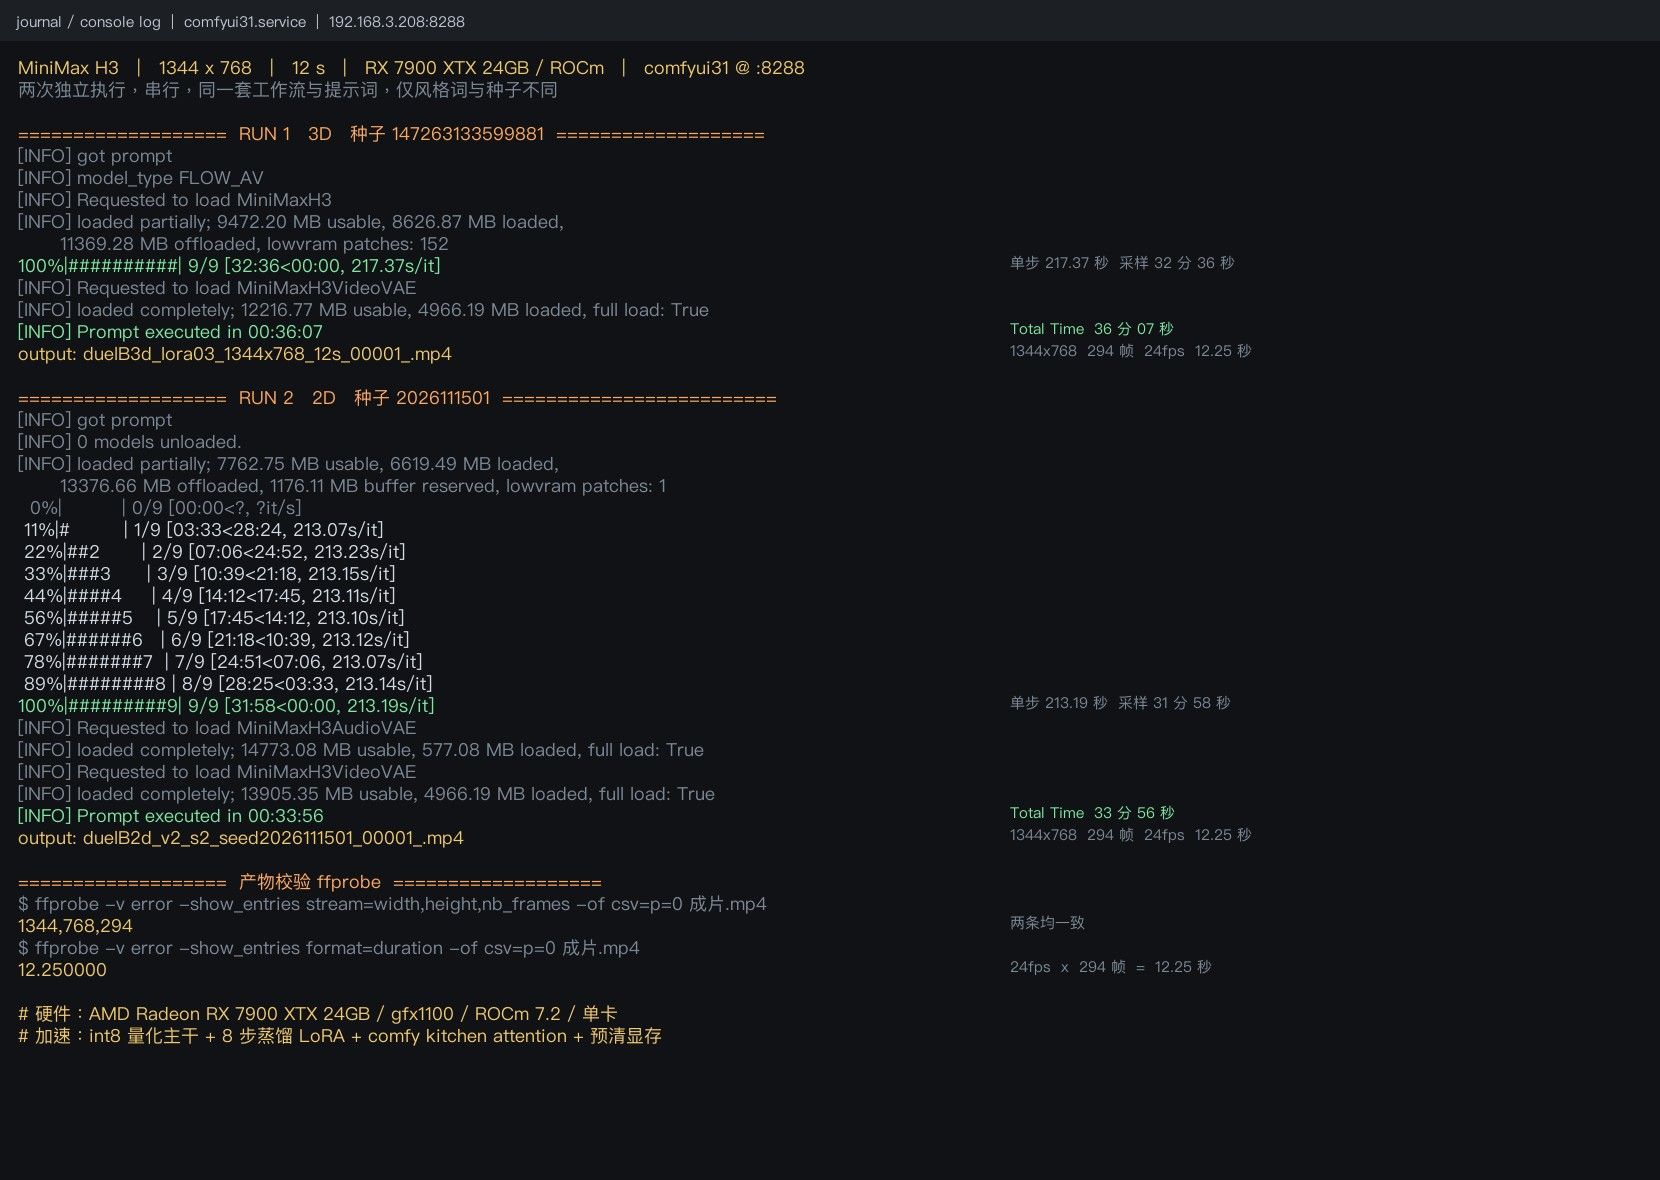
见附件 日志证据_Total_Time.png
3D: Prompt executed in 00:36:07,9/9 步,217.37 秒/步,采样 32 分 36 秒
2D: Prompt executed in 00:33:56,9/9 步,213.19 秒/步,采样 31 分 58 秒
产物校验:1344x768 / 294 帧 / 24fps / 12.25 秒 / AAC 音轨,两条一致
日志证据_Total_Time.png
-
,K koala 引用了 此主题
-
-
-
-
硬件配置:
CPU: Intel Xeon E5-2686 v4 @ 2.30GHz,18 核 36 线程,单路;主板 X99-TF 内存: 128GB(4 x 32GB ECC),实测可用 121Gi,交换 8Gi GPU: AMD Radeon RX 7900 XTX 24GB(gfx1100,48 CU,L2 6MB),单卡,物理机非虚拟机 系统: Ubuntu 26.04.1 LTS,内核 7.0.0-43-generic 计算栈: ROCm 7.2.0 / PyTorch 2.11.0+rocm7.2(HIP 7.2.26015)/ Python 3.12.3 推理引擎: ComfyUI 0.33.0(commit ff6c8a8a),端口 8288 注意力: 全局 PyTorch cross attention,工作流内节点 524 指定 comfy kitchen attention ROCm 不支持 SageAttention / FlashAttention / CK Flash / SOL Attention 耗时: 单步 217.37 秒(3D)/ 213.19 秒(2D),各 9 步 -
硬件配置:
CPU: Intel Xeon E5-2686 v4 @ 2.30GHz,18 核 36 线程,单路;主板 X99-TF 内存: 128GB(4 x 32GB ECC),实测可用 121Gi,交换 8Gi GPU: AMD Radeon RX 7900 XTX 24GB(gfx1100,48 CU,L2 6MB),单卡,物理机非虚拟机 系统: Ubuntu 26.04.1 LTS,内核 7.0.0-43-generic 计算栈: ROCm 7.2.0 / PyTorch 2.11.0+rocm7.2(HIP 7.2.26015)/ Python 3.12.3 推理引擎: ComfyUI 0.33.0(commit ff6c8a8a),端口 8288 注意力: 全局 PyTorch cross attention,工作流内节点 524 指定 comfy kitchen attention ROCm 不支持 SageAttention / FlashAttention / CK Flash / SOL Attention 耗时: 单步 217.37 秒(3D)/ 213.19 秒(2D),各 9 步 -

 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!
