我的格斗画面视频分享
-
-
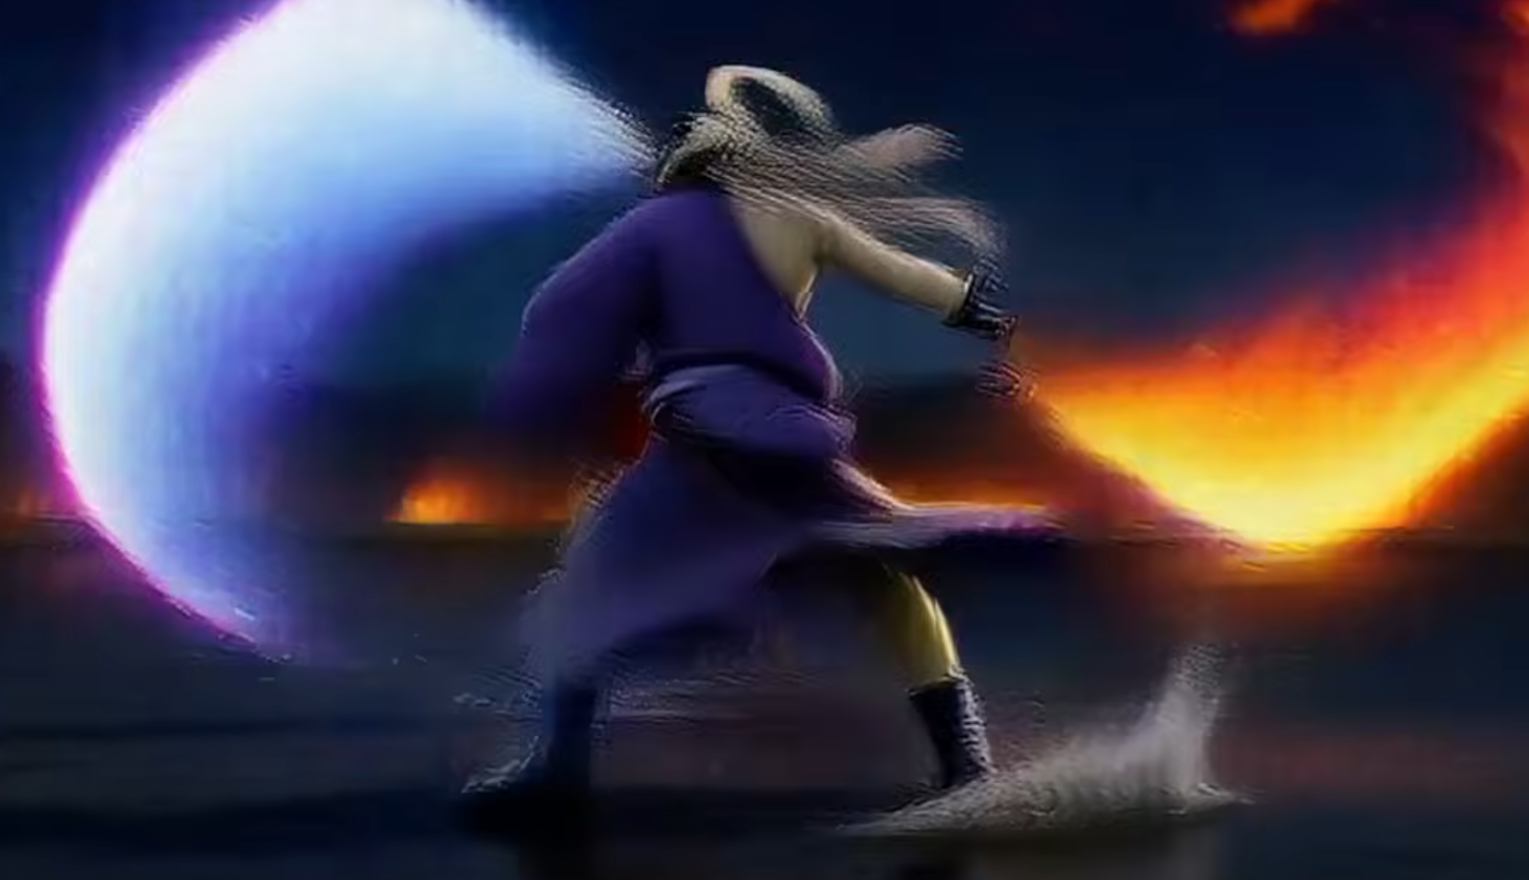
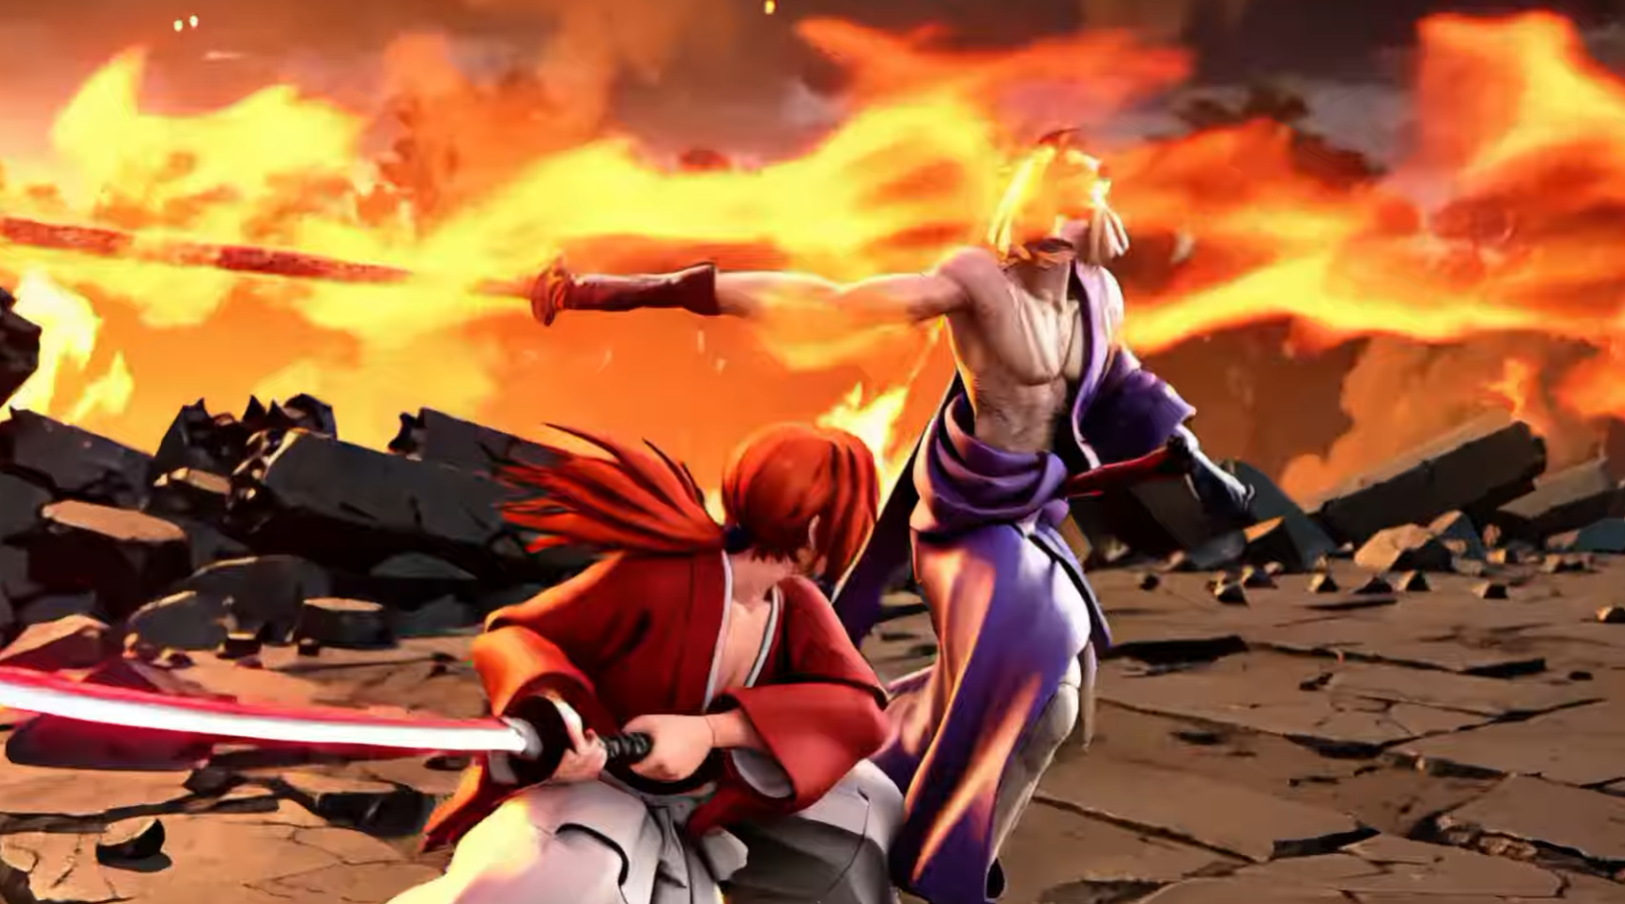
看大家都在参赛, 我也有点儿心痒痒, 做了个剑心视频, 非参赛版. 没有遵循 老特 的要求, 他是要测性能. 我还是追求美感和效果.
硬件: RTX pro 5000 48G
软件: Minimax H3 和 H3 image . Suno背景音乐.
剪辑: Hermes -
,系统 取消固定了此主题
-
看大家都在参赛, 我也有点儿心痒痒, 做了个剑心视频, 非参赛版. 没有遵循 老特 的要求, 他是要测性能. 我还是追求美感和效果.
硬件: RTX pro 5000 48G
软件: Minimax H3 和 H3 image . Suno背景音乐.
剪辑: Hermes -
,
 T terry 引用了 此主题
-
-
是不是加速Lora造成的? 你用的是什么加速Lora?
我常用的是这两个:
minimax_h3_turbo_v4_step600_ema.safetensors
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors -
-
@imbiplaza-asus 我让AI 分析了一下你的工作流, 可能比较重要的是 底模+Motion Repair + Combat 这两个Lora, 有可能.
我自己的只挂了一个8步加速的Lora, 没有其他的. 我刚刚随便找了个参赛的, 工作流也差不多. 我另外挂了一个9B的官方提示词优化器节点, 但是效果很一般, 没啥帮助. (不过有可能是因为这个节点是 minimax H3 image的, 我直接挂载 视频的工作流上了)
如下是AI分析:
仔细看了一下这篇在 抡锤者社区 (lcz.me) 讨论的配置,虽然他把打斗 LoRA(H3_Combat_V2)和动作修复(Motion_Repair_V2)拉到了 2 的高强度,但它之所以没有直接“糊成一坨”或撕裂,主要在于它的链路里藏了几个关键平衡点:-
底模和量化版本救了它:
他用的底模是 Minimax-h3_Singularity_x_10Eros-Max_PRISM_int8.safetensors(属于融合底模 + int8 量化)。这种融合模型在训练或裁剪时往往增强了对大动作和构图的容错率,比纯官方原版硬抗高强度 LoRA 更有韧性。 -
加速 LoRA 降权到了 0.8:
虽然用了 minimax_h3_turbo_v4_step600_ema.safetensors,但他把强度压到了 0.8。这避免了 Turbo 模型的激进蒸馏在 8 步极限采样下直接产生严重的噪点和残影。 -
专用的动作修复机制:
链路里同时挂了 Motion_Repair_V2。虽然高强度会带来一点代价(比如评论区也有人吐槽“动是动了,但对脸部会有影响”),但它确实强行修正了剧烈挥刀时的肢体穿模和崩坏。
简而言之,他这套配置是用 “融合底模的泛化性 + 动作修复 LoRA 的强行拉扯” 互相抵消了激进参数带来的副作用,所以才能在 8 步快节奏直出的情况下维持住港漫风的格斗质感。
-
-
@imbiplaza-asus 让它对比了我的工作流 :
workflow-api.json以下是AI生成:
通过对你当前的工作流 (
workflow-api.json) 与论坛中imbiplaza-ASUS分享的格斗工作流(带有Motion_Repair和CombatLoRA 的版本)进行深度对比,两者的主要技术差异体现在以下几个核心维度:
1. 核心 LoRA 挂载与扩展策略
-
你的工作流:
-
走的是官方干净、标准的单 LoRA 路线。只挂载了一个官方标准的
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors(强度1.0)。 -
没有引入任何社区魔改的动作修复或打斗强化 LoRA。
-
imbiplaza-ASUS 的工作流:
-
采用了多 LoRA 串联堆叠策略。在主加速 LoRA 之外,额外串联了
Motion_Repair_V2(动作修复)和H3_Combat_V2(战斗强化),并且将这两者的强度丧心病狂地拉到了2.0。
2. 底模与量化选择
-
你的工作流:
-
贴近官方架构,使用
minimax_h3_ref2v_va_pruned_int8_convrot.safetensors作为 UNet,CLIP 采用了qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors。 -
imbiplaza-ASUS 的工作流:
-
使用的是第三方融合底模(如带有
Singularity与10Eros-Max_PRISM的混血 int8 版本)。这种融合底模在训练时往往对大幅度肢体动作有更好的包容度。
3. 采样器与步数配置
-
你的工作流:
-
使用了更细腻的
res_multistep采样器选择器,配合simple调度器,步数严格设为8 步(denoise: 1.0)。 -
imbiplaza-ASUS 的工作流:
-
同样是 8 步极限快节奏直出,但因为堆叠了高强度的动作 LoRA,极其依赖
Motion_Repair去强行纠正剧烈挥刀时的穿模和崩坏。
4. 提示词与参考图结构(Control/Reference)
-
你的工作流:
-
提示词极为严谨、工程化(包含非常详尽的时间轴分段控制
0.0–1.5,1.5–2.0等运动速率和镜头轨道规范),并喂入了 8 张极其精确的参考图(涵盖剑心三视图、志志雄三视图、环境底图及动态起始帧)。 -
imbiplaza-ASUS 的工作流:
-
相对偏向社区常见的模板化叙事提示词(如论坛里附带的
12-Second Single Continuous Shot Combat文本),主要依靠强力 LoRA 的自身发挥去“带起”港漫风格的打斗氛围。
总结
- 你的版本更像是“高精度、严约束的导演剪辑版”:靠完美的 8 张参考图、严密的提示词时间轴和纯净官方底模来抠细节、控镜头,追求画面和逻辑的克制美感。
- imbiplaza-ASUS 的版本则是“暴力改装的港漫重火力版”:不惜通过堆叠双倍强度的打斗/修复 LoRA 和融合底模,来换取极致夸张的武打张力和视觉冲击力,但代价是如果没压住容易带来局部像素撕裂或面部微变形。
-
-
-
是不是加速Lora造成的? 你用的是什么加速Lora?
@Tony-Wang
所有加速lora测试下来,还是这两个lora配合官方模型是最好的。
https://huggingface.co/larryvrh/MiniMax-H3-Turbo-Lora- minimax_h3_turbo_v4_step600_ema.safetensors
- minimax_h3_turbo_4step_ema_ckpt850.safetensors
最好使用Custom nodes: Larryvrh/ComfyUI-MiniMax-H3-Turbo 来加载lora
-
-
@imbiplaza-ASUS 官方模型天生缺陷。