
Minimax H3视频生成大赛一阶段总结:AMD/Nvidia/Apple各有所长,期待Intel用户拿出优秀作品参赛!
-
论坛的AI音视频画图板块正在举行一个比赛,就是MiniMax H3视频生成大赛。那么这个比赛是由我亲自组织、亲自发起,然后我自己来审阅。有5个评委,连同我在内有5个评委,最终决出哪个平台搭配它的硬件方案生成的视频性价比最高。提示词是统一的,就是剑心跟志志雄打斗,分别出一个3D和一个2D版本。是吧,你看志志雄就完全没有2D的参考图,有人还提出这个意见。其实不用提意见,就是你参考图是3D的,不妨碍你生成2D风格的视频。大家一定就是参加活动之前,你有非常严重的疑问,你可以提一下;但是其他的时候就尽量按照标准来做就行了,大家肯定都是可以完成的。然后我也@了这些经常发视频教程,或者发大模型教程、分享自己操作过程的人。其他的人呢,如果说我没有@你们,你们也是可以参与的,而且我没有@到你,你最后夺冠了是吧,还多奖励你10分,作为这个黑马奖。确实有很多人,因为讲实话我不可能记住每一个人的ID,是吧,发个帖子我每个人都要想到。
从这个参赛的过程来看,大家就是非常积极,帖子很多。那么有些人我是直接给加了优秀,进入下一轮;有些人进入下一轮了,就拿到参赛积分,但是我没有给他加优秀。因为讲实话,有些瑕疵是比较明显的,加优秀有点说不过去,毕竟优秀才奖励3分,是吧?你参赛只要通过了、进入下一轮,你就有20个积分。我觉得大家也不用在意这个虚荣。然后有些朋友其实是可以直接加精、设置成精华,参与下一轮的,但是咱不是说了嘛,要最后走流程,我们还是得等一个星期到了,是吧?等7天到了,看看所有的作品中,由我本人挑选6个。这个是相当主观的,我必须说,因为你们只要是进入下一轮、只要合格了,都拿到20积分了,是吧?那么后面我要选出六个人进入下一轮,并且从这六个人中决出冠亚季军,分别奖励60分、30分和15分,那就相当主观了,大家也不要斤斤计较。
然后我还要说一下,有些朋友就非常遗憾,你们的作品我看了,确实我没有办法给你们加分,也没有办法让你们进入下一轮,就是太糊了。你起码得自己看得过去,是吧?我才能过审。那有些朋友,你看有几个人的作品是非常不错的,但是呢,他没有提供JSON工作流,或者说这哥们直接视频就没有办法播放。说实话,如果这个帖子最终没有把不可播放这个事情修复掉,我会把他封号。你不能浪费大家的时间,知道吗?这是最基本的。反正比赛结束之后,如果说这个帖子还没有把视频设为公开,他发了一个参赛帖子,那么直接封号,因为浪费了大家的时间。
我来说一下,具体的结果我最后会让AI来分析一下什么平台比较牛逼。那么我先云评一下,根据我已经看到的,我们也打开一些实际的帖子。我就随便选的,谁在上面我就点谁。第一个我们奔赛老兄,不用说了,我们论坛就是非常牛逼的,无论是跑大模型,还是搞底层架构的创新、搞效率革命,是吧?他跟高兄、雄杰高,是我们论坛可以说是富有创意的两个人。当然了,其他的大神也不差,但是像他们两个这么能折腾,大模型跟视频都能折腾的,还是不多的。我们看看他的效果吧,他是双R9700,就是两张R9700 TP跑的,后端用的是ComfyUI加上什么Radiance TP2。
画面非常清晰,没有什么噪点,没有什么模糊的马赛克效应、果冻效应。然后他也给了仓库,GitHub上自己给了仓库,他能够复现。他是两张R9700,我们不得不说,他买的时候虽然是两万出头,但是现在可能要三万,甚至三万五了。那这个硬件的价格我们也会考虑在内,我们不是说你最终生成的效果牛逼,我们就给你高分,不是的。就是因为有的人硬件比较差,我们要看最终的性价比,也不是说你快就行,这是一个综合考虑。他的速度是509秒,两个都是。我觉得,怎么讲呢,想要做成他这样的效果,能够用他这么高的效率,我觉得可能不太容易。
老哥说还有下一轮,不是下一轮啊,下一轮就不需要你们发新作品了,下一轮由我把你提名给五人评委,决出谁是冠军。后面我们当然也会组织新的比赛,而且我也让论坛的StxpNet,这位哥们对于大模型比较懂,然后我会,我也会让他组织大模型相关比赛,是吧?我也会积极地去参与。
我们再看一看Benton Yi老兄。Benton Yi老哥有4个DGX Spark,我本来是发帖让他用DGX参赛的,然后视频录到一半,我发现他用的是4090来参赛的。这个我只能再@他一下,让他用DGX再跑一次。这个4090它的效果也是相当不错的。
就是有些老哥,我没有给你们过,就是因为拼接太严重了。我是要求10大秒连续,你知道吗?你们那个拼接中间的拼接缝,我看了我都看不下去了。是吧,这个效果也是相当不错、相当炸裂。但是我必须说,这个是我设定的提示词,一个相对傻逼的场面,这个限制了大家的发挥。我们论坛有很多人,他们发的MiniMax H3视频,从创意到构图、到运镜、到最后的成品,效果都是相当不错的。这个只能说,这一次比赛我组织得比较匆忙,很多事情我没有考虑得清楚一点,然后呢我主要也是为了摸摸大家的底,看看大家有什么硬件,自己对于AI音视频掌握到什么程度,先摸个底。
我们再看看有人7900XTX单卡。哦,刚才4090那个Benton Yi老哥,他的时间是31分钟。就有人说4090可以快很多,确实,但是你做视频不是只快呀。你看看你们生成的效果,是吧?你拿效果、工作流去跟别人对比一下,这不是快的问题。
我觉得这个视频虽然是7900XTX单卡做的,他的时间可能不怎么快,但是这个效果我觉得真的是非常不错。他自己说该方法不具备生产力,我觉得自谦了,没必要啊。我们论坛不装逼,我们就看效果,是骡子是马拉出来溜溜,我们不打嘴炮,没意思。然后看看他让H3自己搞的,看是什么样子。
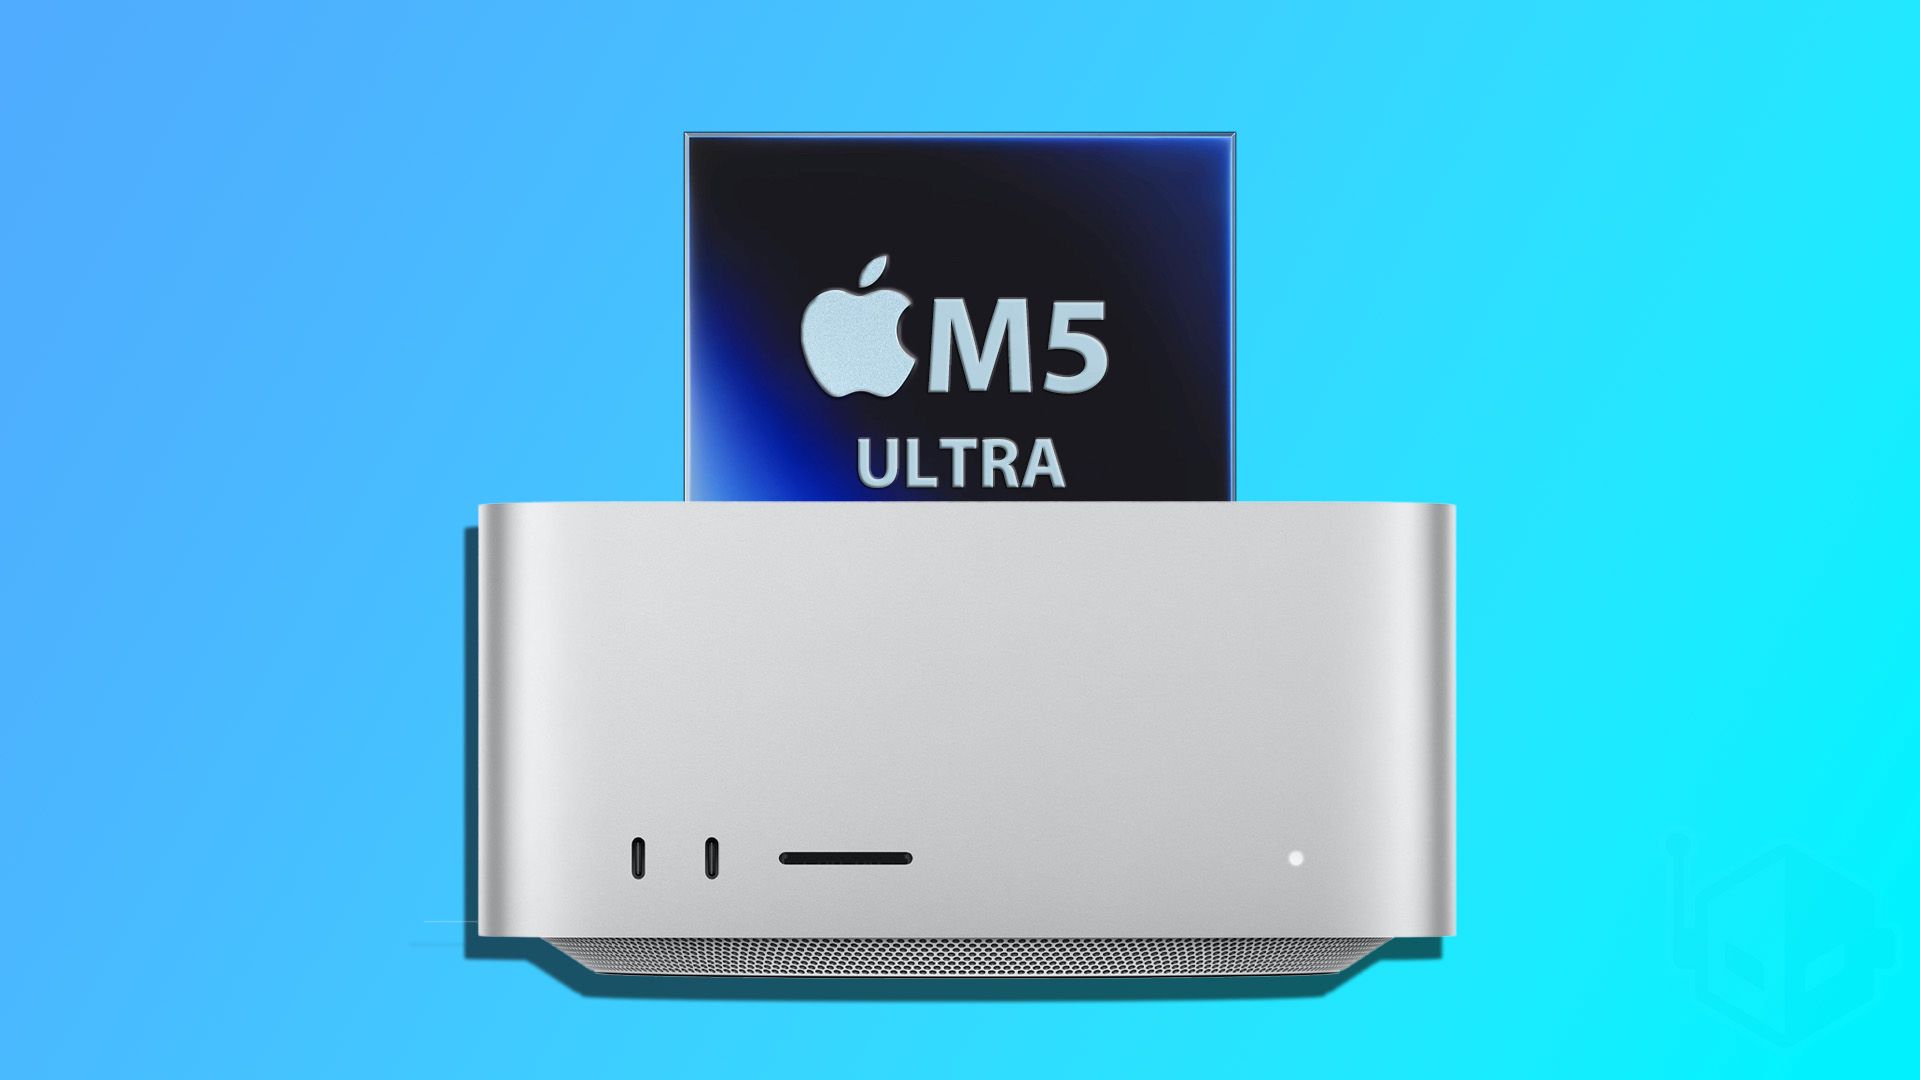
这个是苹果M5 Ultra 256G。我们论坛已经有哥们到了512G,他已经发帖预告了,但是好像跳票了,可能到货慢了一点,或者说自己测试还没有来得及做,我们也非常期待。我会专门做一期视频来讲它的测试。然后我们看看CC Tgo的M5 Ultra 256G。
这个因为是苹果系统,讲实话,苹果的生态是有点问题的。它现在虽然H3.c速度非常不错,它跑出来的时间,我后期让AI自己来总结吧,就是也都是非常不错的。它也是花了37分钟,跟4090差不多。但是它的效果没有4090好,就是我认为CC Tgo它本身在运镜方面是没有问题的,但是你看到它中间打斗的时候,画面比较激烈的时候,马赛克感是有的,可能是它这个性能优化还是需要再调一调,它还是有问题的,它比N卡还是有差距的。当然我们也不能说这是苹果自身的问题,因为我们刚才看到了,同样是A卡、同样是N卡,有的人跑出来那个效果,我就不一一放了,我就放这几个比较好的。就你们那个效果,不怪硬件,知道吗?因为用同样硬件的人家跑出来的效果就是好很多。
然后我相信我后面只选6个人,估计可能有比较好的作品会被砍掉。其实像这个Ralf Zhu,他做的也是非常不错的,我们这就不一一放了。Ralf Zhu,大家可以去关注一下他的ID,去看看他发的很多作品,就是相当不错。结论呢我暂时就不放,因为还有一个星期,是吧?我们还有第二轮评审,我选出6个我认为最好的。落选的兄弟也不要有意见,还有我们以后还有新的比赛。以后我不会自己写死提示词,这次为什么要把它写死了?就是硬件摸底。还有一个很重要的原因就是硬件摸底,这是我私心比较重,我想在这上面嫖一些视频,不用我自己去测试。
初步的总结我就是说什么呢,很多人会发,说你看我什么4080S,16G,或者说是什么5080,我的速度比两张7900XTX还快;有的人说我的XTX跑得不好;有的人说我的AI Pro R9700效果就是没有N卡好。是吧?其实我刚才给你们展示的例子,无论是苹果还是AMD的卡,他们都能跑出非常高的效率、非常高的品质,它速度是不慢的。你同样是4090,有的人跑出来,你速度是快了,但是你跑的那个效果跟狗屎一样,就毫无生产力,没有任何价值。甚至有的哥们的帖子,你们心也别往心里去,我看了之后我都觉得,我C,那那就不是15秒生成的,你那肯定有明显的拼接痕迹,是吧?
所以说暂时我的结论就是,硬件上面英伟达生态毫无疑问是遥遥领先,这个它的体验也是比较好。AMD和苹果需要你们本身懂,你懂了之后,它们并不落后太多。它们的体验虽然不如N卡,但是并不落后什么。相比于它们其他方面的优势,或者相比于价格、性价比优势,这些缺点不值一提。然后关于AMD的卡,它跑这个视频慢、跑MiniMax H3慢,那还是你们不会用啊。我们论坛雄杰高,是吧,杰杰,就是我经常说人帅屌大钱多的杰杰。人家有这个优化,你们自己来抄一下作业,提速10倍。但是我必须说杰杰最近变坏了,这个提速10倍是有点标题党的意思,是在特殊场景下,但是总体上它的提速效果是非常不错的,并且论坛已经有人验证过了。这个我可能会专门做一期视频来讲。杰哥你最近把这个帖子再完善一下,不要让我做视频的时候被别人喷,是吧?我们的烘焙老兄已经进行了优化,提速相当明显,最起码提速一倍没有什么问题。
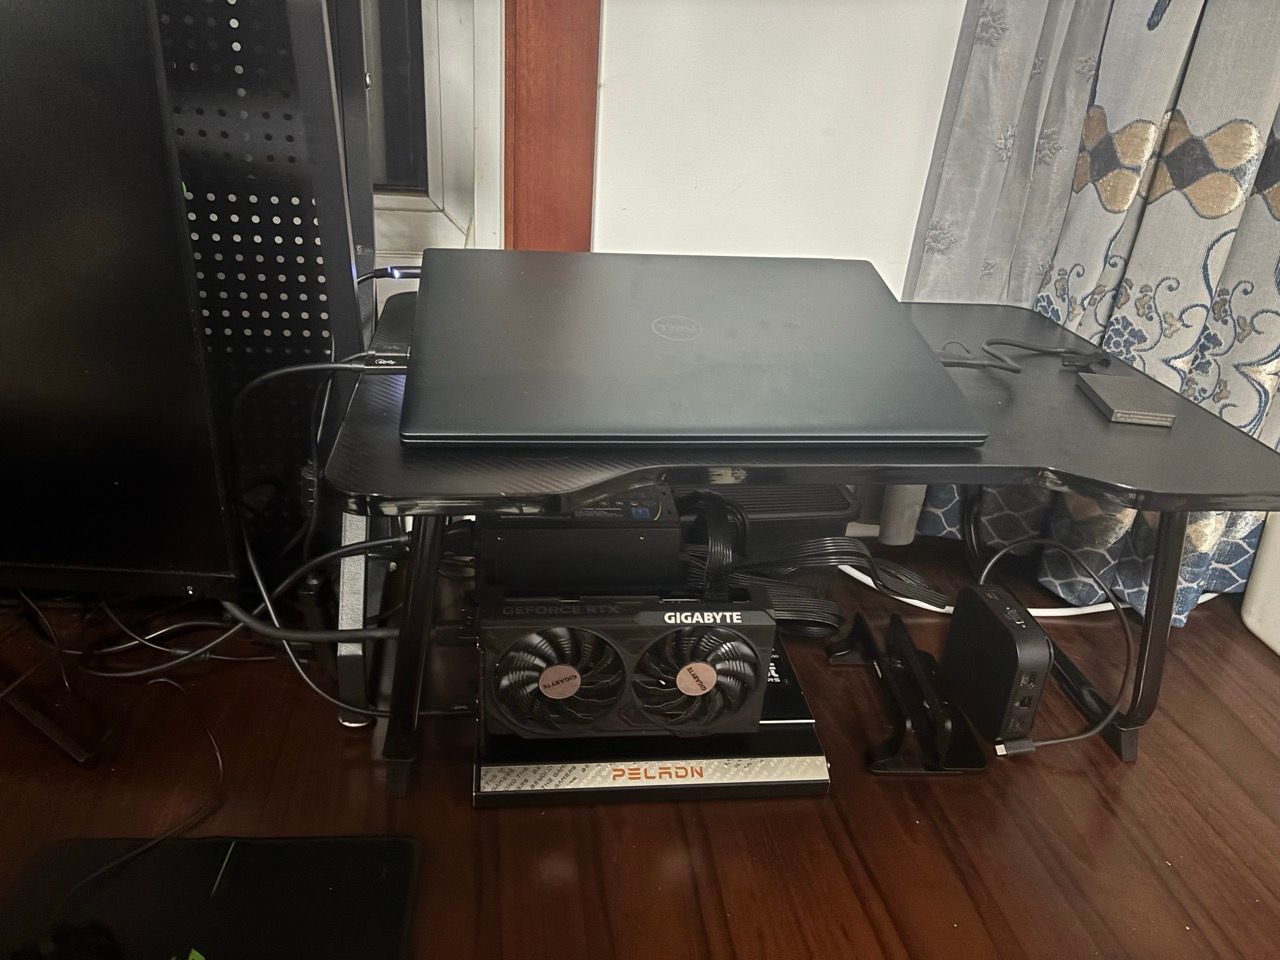
因为呢我现在是想换到镇上去住,我们家镇上的房子要找人去给它打理一下。毕竟时间长了,需要重新弄一下。因为我在现在这个房子里面,虽然这房子面积也蛮大的,可是你就能窝在这个小房间里。我以前在沙发上、在橱柜前都录过视频,讲实话,打光各方面效果真的是还不错,是吧?但是这个房子,我妈装得跟浴场大厅一样,到处贴了瓷砖,它有点反光。而且你跟老人在一起,是吧?那坛坛罐罐的,你刚把它收拾过去,他过两天又给它放上去了。再加上我儿子调皮捣蛋,零食到处扔,我在这里是没办法工作的。那去镇上就有很多事情要搞,你起码得装一装、弄一弄啊。那这段时间继续躺平,靠大家来支撑我的新机。实际上我把它放在另外一个房间,因为这个房间已经弄满了。其实想一想,你做个视频主播,他的成本还真的是蛮高的。你别的不说,就光是你足够大的桌子、一个独立的房间,这个对于很多人来说其实就不好实现,尤其是大城市,是吧?那房价,是不是?
反正先这样吧,欢迎大家积极参与论坛的各项测评。就这次活动组织得比较匆忙,但是我们且行且珍惜,后面我们想办法组织更高水平的活动,一起来把本地AI部署,无论是大模型还是ComfyUI,把交流水平提升一下,帮助大家尽早落实到现实生产力。啊,我也会尽早去开启新的频道,再一次从零开始给大家演示怎么挣到钱。这一次演示就是后台数据什么东西全部对你们开放,就我这个频道,你们爱怎么抄怎么抄,是吧?我就是作为一个实验产品给大家演示怎么赚钱。
-
-
-
有1張A770 16GB, 但問了下AI也是折騰, 但實際來回不知道要花多少倍時間...
Gemini
如果以生成一段 15 秒影片(24fps,約 360 幀) 來看,Intel Arc A770 16GB 的總耗時大約會是 ASUS Dual GeForce RTX 5060 Ti 16GB 的 4 到 6 倍以上——而且前提是 A770 沒有在過程中因為缺少對應算子或記憶體碎片化而報錯中斷。先试一试用480来出视频,看看会不会有什么破图的地方,再升级成768..
480处理效率应该会在100秒1步 - 200秒1步, 使用8步加速,大约是30分钟,如果使用20步无加速,大约60分钟
-
先试一试用480来出视频,看看会不会有什么破图的地方,再升级成768..
480处理效率应该会在100秒1步 - 200秒1步, 使用8步加速,大约是30分钟,如果使用20步无加速,大约60分钟
-
@imbiplaza-ASUS
剛試了下, 光設置環境1小時還沒弄完. -
what...发生什么事情
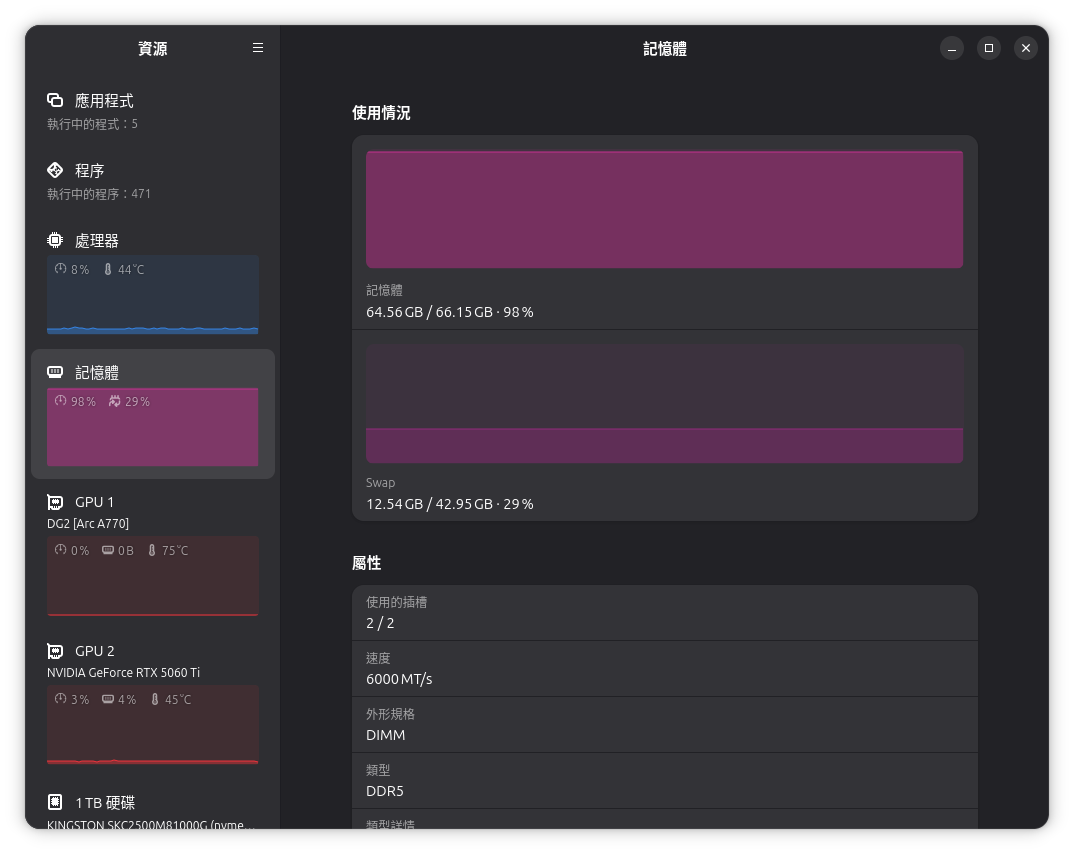
自結報告:
MiniMax H3 @ Intel Arc A770(PC18)— 方案報告(已放棄並回滾)
日期:2026-11-17 | 執行:Bot18(Hermes)| 決定:使用者指示停止,已完整回滾
1. 目標
在 PC18 僅使用 Intel Arc A770(DG2,16G)跑 ComfyUI + MiniMax H3 影片生成。
2. 環境建置(後已移除)
- Intel 計算棧:intel-opencl-icd、libze-intel-gpu1、libze1、clinfo、intel-media-va-driver-non-free(iceoff 加入 render/video 群組)
- ComfyUI 0.45.0 全新安裝,venv
.venv-xpu(torch 2.15.0+xpu,XPU 偵測 A770 15.1G 正常) - 模型:Comfy-Org/MiniMax-H3 全套(約 90G:DiT int8/fp8、TE int8_convrot、video VAE int8/fp16、audio VAE fp32、turbo LoRA)
- 服務:systemd user unit
comfy-h3,port 8190
3. 測試矩陣與結果(全部實測)
# DiT 權重 LoRA 解析度/幀 結果 1 int8_convrot turbo 8step 864×480×124 完成 285s,畫面 ~80% 黑塊(靜默權重損壞) 2 int8_convrot turbo 8step 864×480×124(fp16 VAE) 完成 300s,同樣損壞 → 排除 VAE 3 int8_convrot 無(20 步) 608×352×124 乾淨,畫面與 prompt 完全吻合 → 鎖定 LoRA 掛載路徑 4 fp8_scaled turbo 8step 608×352×124 乾淨 8/10,150s 5 fp8_scaled turbo 8step 864×480×124 完成 315s,右 1/3 持久網格 artifact 6 fp8_scaled turbo 8step 768×432×124 乾淨 9/10,255s 7 int8_convrot 無(20 步) 608×352×124 去噪完成,儲存階段 avcodec 錯誤(未結案,方案已中止) 4. 根因分析
- XPU 運行時掛 LoRA 到 int8_convrot 權重會靜默損壞(同 ComfyUI issue #14720 模式):run 報 success、音訊正常、視頻全黑/馬賽克。繞法:改用 fp8_scaled 或離線併入 LoRA。
- 尺寸相關 artifact:fp8+LoRA 於寬度 >768 時右側出現網格紋。已排除 oneDNN fused SDPA 通用 bug(隨機資料 T=16384 bf16 對 CPU fp32 參考 maxdiff ~1e-3);DG2 無 flash attention(僅 PVC/Battlemage)、無 memory-efficient backend(fallback math 會 OOM),無替代核心可用。
- 記憶體:20 步長片 RAM 峰值 ~59G/61G(僅 8G swap)反覆 OOM;32G swapfile 可撐但慢。
- 對照:同代碼 NVIDIA 路線無此問題;Intel 計算棧安裝本身全數正常(OpenCL/Level Zero/XPU torch 全綠)。
5. 結論
A770 在「fp8_scaled + 768×432 以下 + 8 步 turbo」組合可產出乾淨影片(約 4 分鐘/5 秒片),但:
- 864p 以上不可用(artifact)
- int8 權重 + LoRA 必壞
- DG2 缺 flash/efficient attention,無調校空間
- 16G VRAM + 90G 模型 = 全程磁碟串流,長片記憶體極限邊緣
使用者決定放棄此方案。已完整回滾。
6. 回滾明細(全部驗證通過)
- systemd unit
comfy-h3停止並移除,port 8190 釋放 ~/comfyui-h3(103G,含全部模型與 venv)刪除,/home 恢復 120G used- 32G /swapfile 关闭刪除(swap 恢復原 8G)
- apt 移除:intel-opencl-icd(+legacy)、libze-intel-gpu1(+legacy)、libze1、clinfo、intel-media-va-driver-non-free、libigc/libigdfcl/libigdgmm 全部相依,autoremove --purge,殘留數 0
- iceoff 群組移除 render/video,恢復原狀
- Hermes:skill
minimax-h3-a770刪除;記憶已標記「方案放棄,勿重提 A770 推論」
7. 若未來重啟此方案(筆記)
- 直接從 fp8_scaled + ≤768×432 起步,跳過 int8 權重
- LoRA 先離線併入 pruned_bf16(CPU)再推論
- 先開 ≥32G swap
- Battlemage 新卡有 flash attention,同代碼可用率顯著較高


