【H3剑心比赛】 Intel Arc Pro B70 32 GB 单卡本地跑 MiniMax H3:3D + 2D
-
两条视频都是在一张 Intel Arc Pro B70(32 GB)上用 ComfyUI 本地生成的,没用云端,也没用 N 卡。
统一提示词只把第一行的风格改成(Style: 3D CGI animation)或(Style: 2D traditional anime),其余原样保留,没有加参考图编号标签。1. 硬件配置
项目 配置 显卡 Intel Arc Pro B70 32 GB(Battlemage G31),主板 CPU 直连槽,PCIe 5.0 x16 CPU Intel Core i5-13600K 内存 128 GB DDR4 系统 Ubuntu 26.04.1 LTS,内核 7.0.0-43 GPU 驱动 compute-runtime(Level Zero / OpenCL)26.40.40196.15,IGC 2.42.14,oneAPI 2026.1 功耗 默认功耗墙,没有超频或解锁;采样时显卡平均约 295 W、2.2 GHz,核心最高 72 °C 2. 工作流(JSON 附后)
workflow_2D_api_seed2026111403.json
workflow_3D_api_seed2026111404.json只用 ComfyUI 内置节点,结构和官方 MiniMax H3 Ref2VA 模板一致:
UNETLoader → MiniMaxH3ReferenceToVideo(参考图 + 提示词)→ RandomNoise / BasicGuider / KSamplerSelect(res_multistep) / BasicScheduler(simple, 20 步) → SamplerCustomAdvanced → VAEDecode + VAEDecodeAudio → CreateVideo(24 fps) → SaveVideo项目 3D 版 2D 版 主模型 minimax_h3_ref2va_pruned_int8_convrot 同左 文本编码器 qwen3vl_32b_minimax_h3_int8_convrot 同左 VAE minimax_h3_video_vae_int8_convrot + minimax_h3_audio_vae_fp32 同左 采样 res_multistep,simple,20 步(官方默认),不用加速 LoRA 同左 分辨率 / 时长 1344×768,12 秒 同左 参考图 6 张全部,ref_image_size = max 剑心 2D 图 2 张 + 志志雄 1 张,ref_image_size = match 种子 2026111404 2026111403 提示词 统一提示词,风格行改为 3D CGI animation 统一提示词,风格行改为 2D traditional anime 关于 12 秒:H3 的帧数必须是 17k+5,所以模型生成 294 帧,解码后用
ImageFromBatch保留前 288 帧,音频用TrimAudioDuration裁到 12.00 秒,最终是 24 fps × 288 帧 = 12.00 秒。2D 版只用了 3 张参考图,原因:用全部 6 张时,志志雄的两张 3D 手办图会把画面后半段带成 3D 质感;去掉后整片能保持 2D 画风。
3. 加速手段
这次以画质优先,没用任何减步数的加速 LoRA,也没开 SOL 稀疏注意力。只做了 Intel 显卡这边的运行环境优化:
- PyTorch 2.15 XPU 版 + oneAPI 2026.1:原生 Intel GPU 后端。
- Intel OmniXPU(omni_xpu_kernel 0.2.0b3,CUTE 注意力后端):在 B70 上替换注意力、归一化、RoPE 和 int8 线性层的计算核。
- int8 convrot 权重:主模型、32B 文本编码器和视频 VAE 都用 int8,32 GB 显存装得下,也省带宽。
- comfy-aimdo 0.6.0 DynamicVRAM:模型权重按需在显存和内存之间调度,避免 32 GB 显存不够时报错,
--reserve-vram 4。 - comfy-kitchen 0.2.40:XPU 版本的量化和计算核。
- ComfyUI 0.44.0:只加了一处本地补丁,让视频 VAE 解码前先卸载其他模型,避免解码时显存溢出到共享内存。
4. 运行日志(Total Time)
截图里的关键行:
3D 版
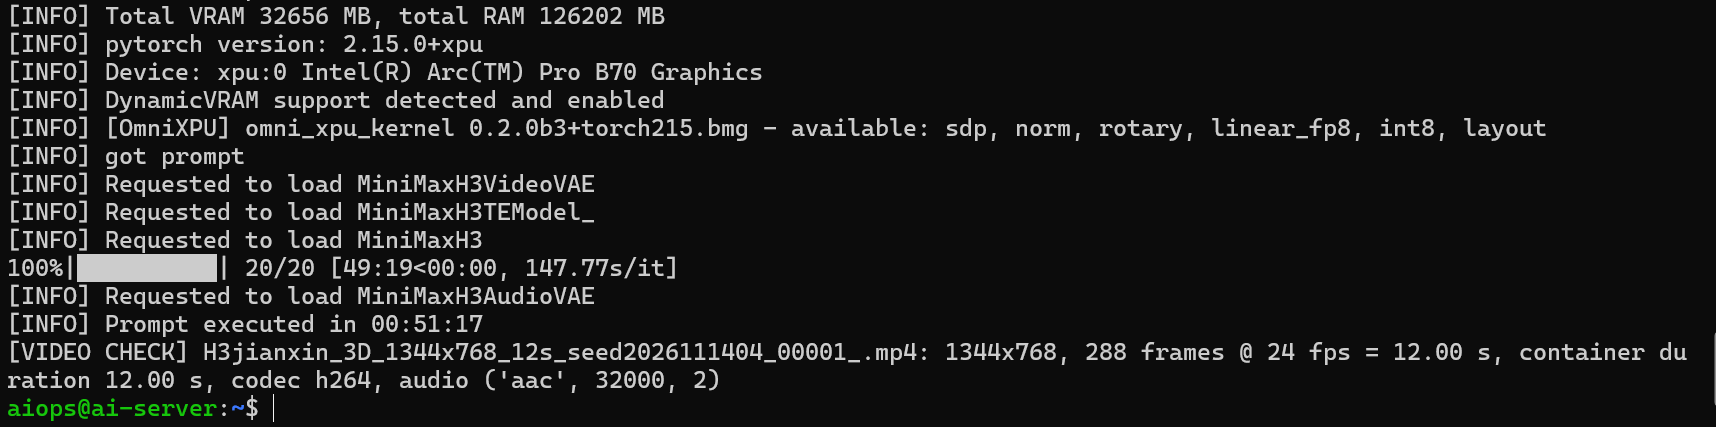
Device: xpu:0 Intel(R) Arc(TM) Pro B70 Graphics
100%|██████████| 20/20 [49:19<00:00, 147.77s/it]
Prompt executed in 00:51:17
[VIDEO CHECK] ... 1344x768, 288 frames @ 24 fps = 12.00 s, audio aac 32 kHz 2ch
2D 版
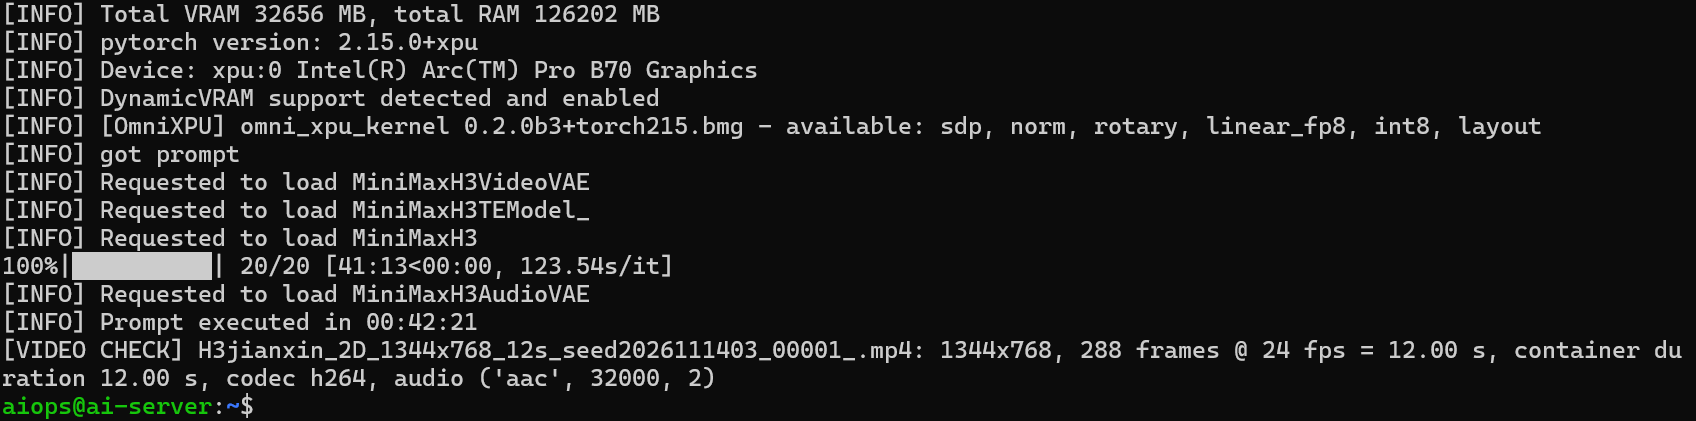
Device: xpu:0 Intel(R) Arc(TM) Pro B70 Graphics
100%|██████████| 20/20 [41:13<00:00, 123.54s/it]
Prompt executed in 00:42:21
[VIDEO CHECK] ... 1344x768, 288 frames @ 24 fps = 12.00 s, audio aac 32 kHz 2ch
Prompt executed in是 ComfyUI 从收到任务到保存视频的总时间,包括加载模型、编码参考图和提示词、20 步采样、视频和音频解码以及保存。[VIDEO CHECK]行是生成后用 PyAV 读取成片得到的实际分辨率、帧数和时长。注:YouTube 显示 0:13 是平台转码后取整造成的,原文件为 288 帧 @ 24 fps = 12.00 秒,见日志中
[VIDEO CHECK]一行。两版用时差 9 分钟,主要应该是因为 3D 版用了 6 张、尺寸为 max 的参考图,模型要处理的参考 token 更多。
5. 一点心得
- 同样的设置,换个种子结果差别很大(比如结尾有没有两人一起面向镜头)。我先用 864×480 跑 12 秒的低分辨率草稿挑方向,再跑正式分辨率。
- 草稿和正式版分辨率不同,同一个种子到正式版画面也会变,所以草稿只能用来判断方向,不能当成正式版的预览。
- 2D 风格最容易出的问题是后半段被 3D 参考图带偏,减少 3D 参考图后好很多。
- Pika 6 步 LoRA 速度快很多(864×480 草稿约 3.5 分钟),但在这条提示词上,两人对刀那段总会停住好几秒,所以正式版还是用了官方 20 步。
-
,
 M Max Wang 引用了 此主题
-
-
-
我喜欢动作就好像kenji那样,甄子丹 vs 吴京的对打,或者徐克的刀这部戏的动作,intel 能够出这个效果绝对上佳,但是换成真正生产力就,嗯嗯嗯
-
我正好视频里需要这个数据,补齐了,2D版有点糊,但是你的运行很连贯,是佳作。要是早点发帖我弟一期总结视频就加入了,不过可以单独出一个视频讲解英特尔。以后还需要你提供更多数据。
通过初审,20积分奖励比赛结束后统一结算。 -
不懂为什么大家的视频不多不少都有画面抖动的残影。。。可能是pruned的问题?或者是参考图的解像度不足?
可以使用z image 放大后处理更好 -
-
不懂为什么大家的视频不多不少都有画面抖动的残影。。。可能是pruned的问题?或者是参考图的解像度不足?
可以使用z image 放大后处理更好 -
-
-
-


 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!