
Strata 装进 Mac:M5 Ultra 256GB 跑 104G 大模型,外加内网台式机 3080 Ti 12G联动
-
Strata 装进 Mac:M5 Ultra 256GB 跑 104G 大模型,外加内网台式机 3080 Ti 12G联动
同机器,Strata 用源码命令行装一遍、官方 dmg 装一遍,再跟 mlx-serve 同题对比。先放结论:
- 壳的差别就一句话:dmg 装完就能用,源码路线六步 setup。跑起来是同一个引擎,速度没有差别。
- 大内存机上,流式惩罚消失:128GB 机器上 prefill 慢 3–4 倍,256GB 机器收窄到 1.6 倍。
- 跟 mlx-serve 对比:decode 打平、prefill 慢 1.6 倍、质量 5 题全过。没有任何一维赢,换引擎无收益——路径探索到此闭环。
测试环境
项 值 机型 Mac Studio,M5 Ultra 36 核,256GB 统一内存 模型 unsloth/Qwen3.8-Flash-Next-GGUF,UD-Q4_K_XL 档,104GB 四分片 引擎 Strata 0.2.15(app)+ engine 0.1.60-macos-arm64-metal 对照 mlx-serve,同机常驻,4.7bpw 同家族模型 两条安装路,都走通了
源码路线:clone →
setup.sh,依次干七件事(Python 检查、编 Metal 引擎、下模型、对 sha256、pack 打包、MTP 草稿层、起服务)。全脚本可自动化,适合无人值守。注意 pack 产物 85GB,磁盘要留够。dmg 路线:装 app → 界面选模型自动下载 → 自动 pack、自动拉引擎组件、自动生成实例 api_key。视觉投影和 DFlash2 草稿层都是界面里点选。装完就能用。
装完核验:dmg sha256 对官方 SHA256SUMS 逐字符一致;
spctl报 accepted, Notarized Developer ID。磁盘账:共 183GB(模型 104GB + pack + 草稿层)。
app 版真实负载 4 小时:90 条请求的账
app 起服务后接进 agent 链路当日常大脑跑了 4 小时,引擎日志留下 90 条真实请求——不是跑分脚本,是长会话真实流量:
指标 读数 decode 中位 117 tok/s,波动带 48–200 投机解码接受率 69.2%(77,182 / 111,531 草稿,MTP + DFlash2) prefill 冷读 均值 ~2.8K,峰值 3.4K tok/s 缓存命中 67K 长会话滚到下一轮,221ms 吃完(复用 67K,只读增量 437) 最长会话 prompt 67.7K token 驻留 全加载后还剩 154,918 MiB 空闲显存,80 个专家常驻(R4 hit path ON) 两条值得单说:
- 前缀缓存是长会话的胜负手。agent 负载每轮只增几百 token,命中时 prefill 几乎免费——"上下文越堆越慢"在这套组合上不成立。
- 69.2% 投机接受率是真实流量攒的,直接解释 decode 波动带上沿为什么能冲到 200。
跟 mlx-serve 同题对拉
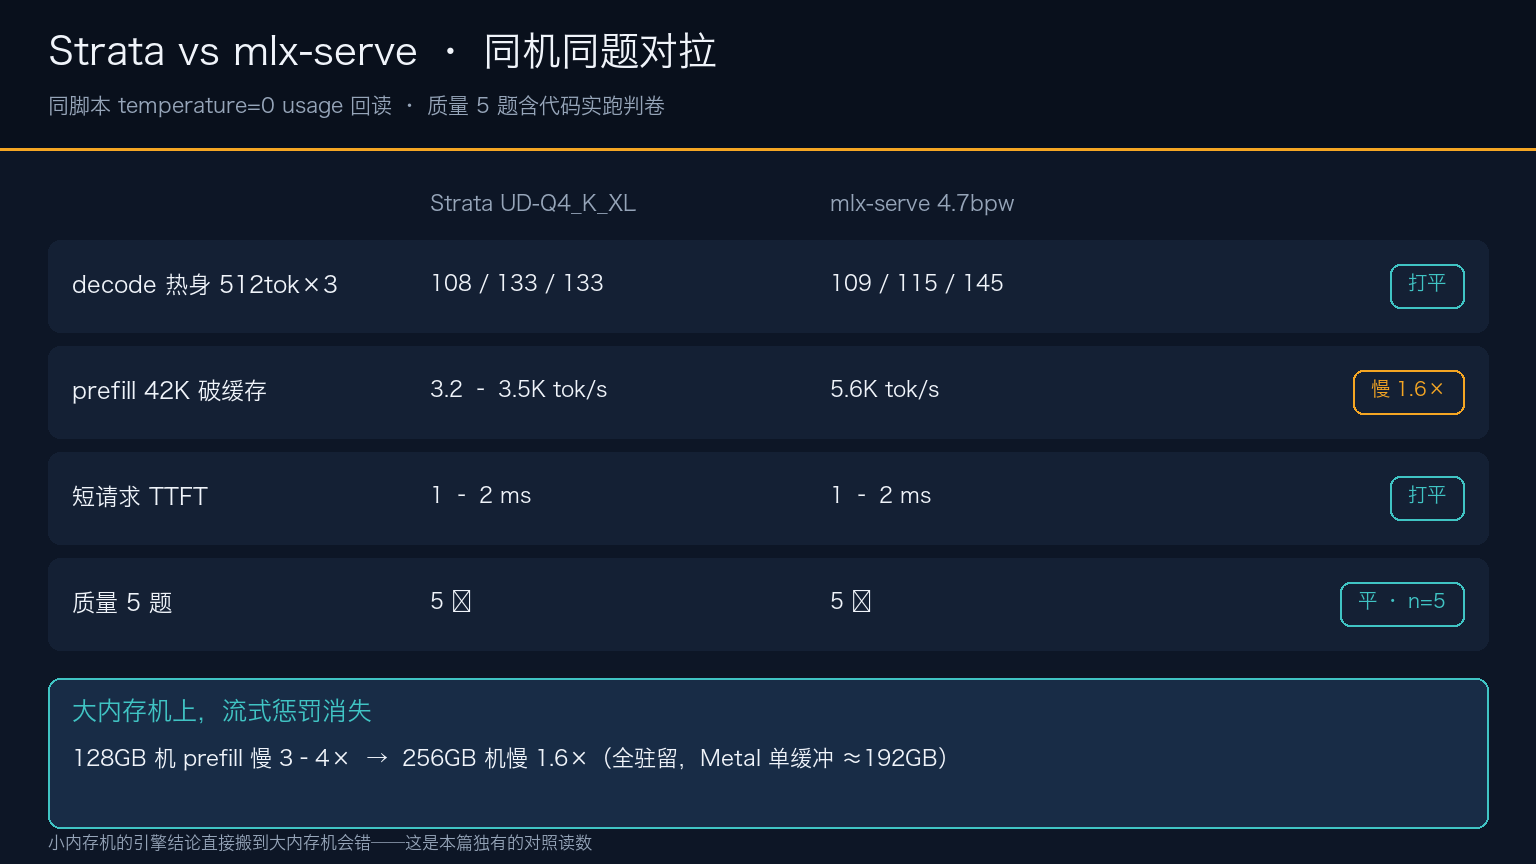
同脚本、temperature=0、usage 回读:
指标 Strata UD-Q4_K_XL mlx-serve 4.7bpw 判词 decode 热身(512 tok ×3) 108 / 133 / 133 109 / 115 / 145 波动带重叠,打平 prefill 42K(破缓存 ×2) 3.2–3.5K tok/s 5.6K tok/s Strata 慢 1.6× 短请求 TTFT 1–2 ms 1–2 ms 平 质量 5 题(含代码实跑判卷) 5 
5 平(n=5) 双引擎共存账:mlx-serve 大脑常驻 + Strata 全驻,memory_pressure 49% free,swap 仅 579MB。256GB 扛两套无压力;小内存机器别照抄这条。
局域网那台 3080 Ti:接入、跑况与用法
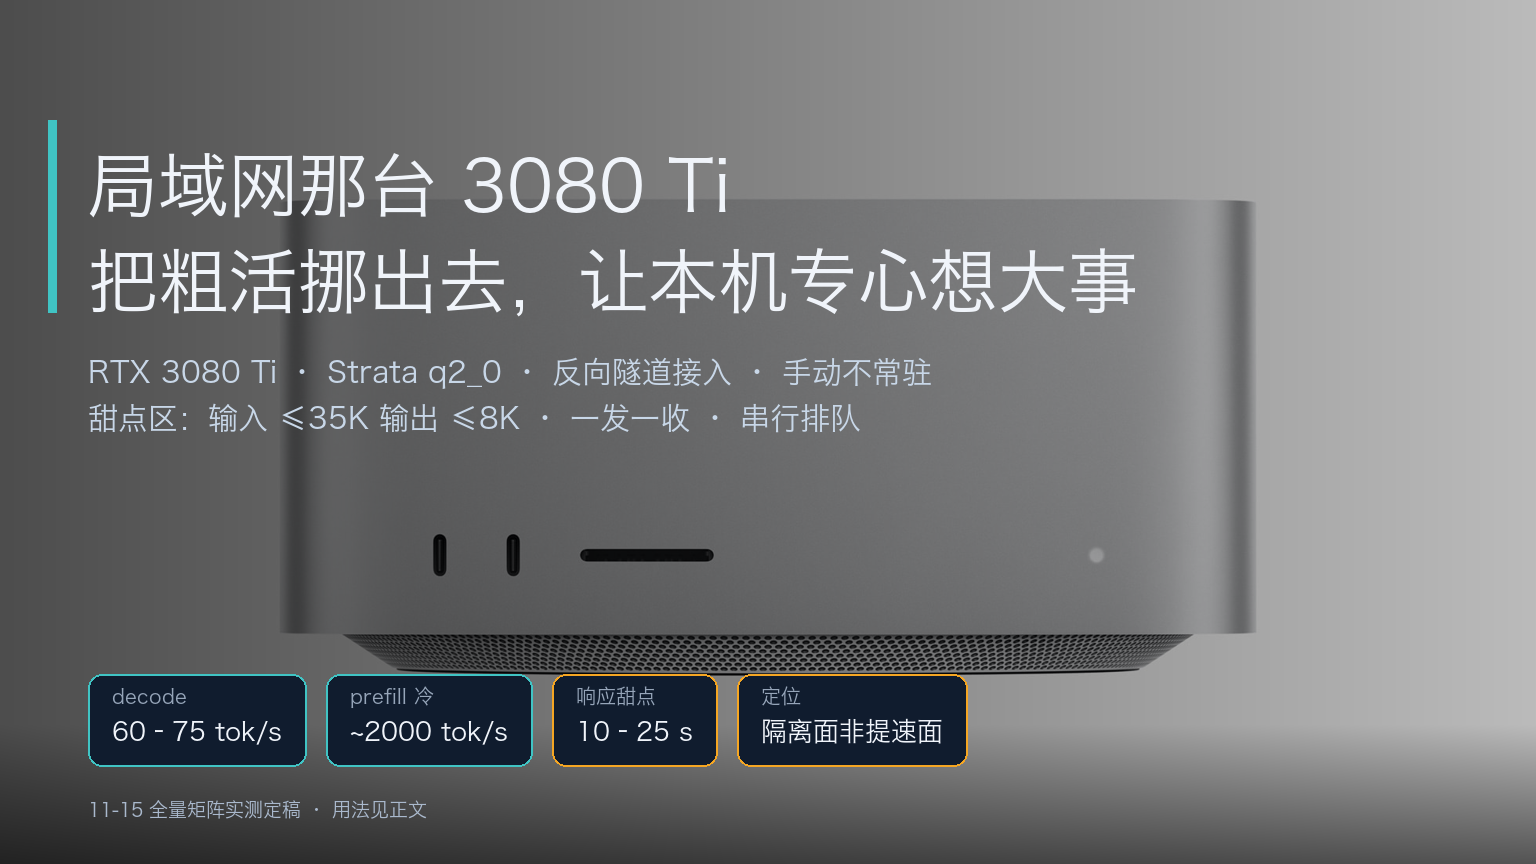
Mac 之外,家里还有一台 RTX 3080 Ti 12G老台式机,内存四通道64G(16*4)跑 Strata q2_0(n_ctx 65536,推理模型),走反向隧道接进来。定位:它是隔离面,不是提速面——decode 60–75 tok/s 比本机慢,收益是把粗加工(分类、摘要、改写、批量生成)从本机 GPU 挪开,让本机大脑专注主会话。
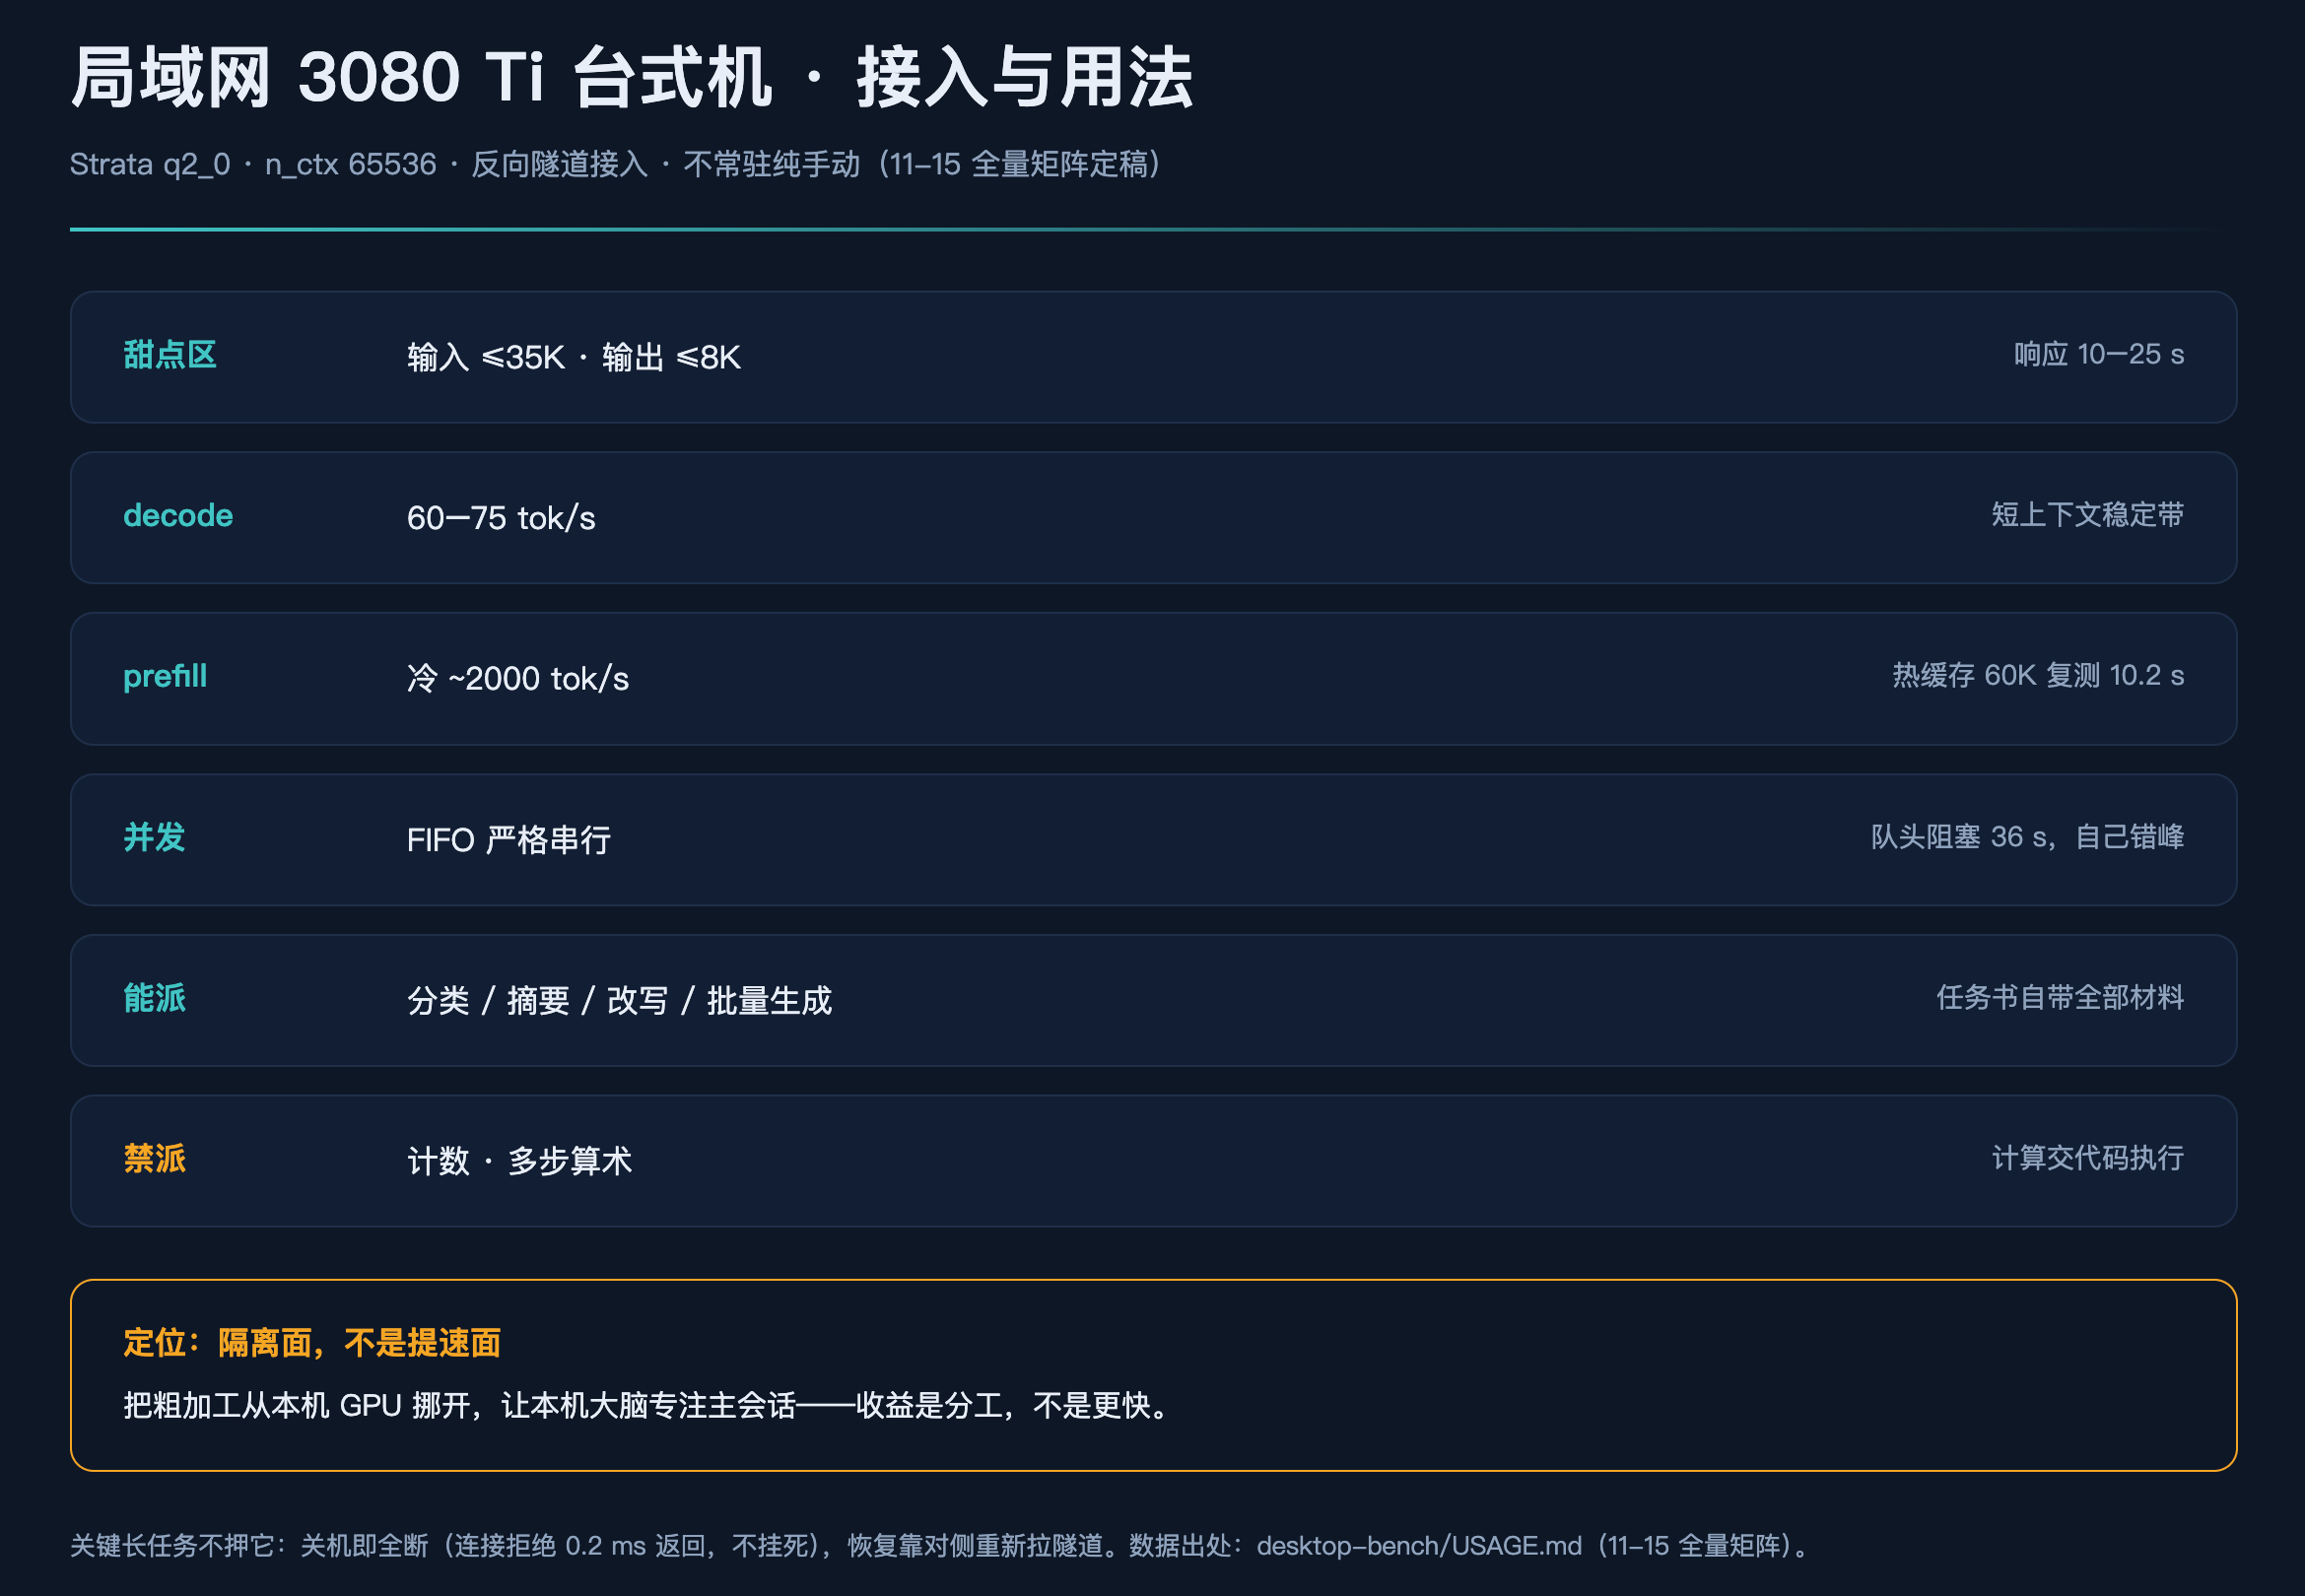
11-15 全量矩阵实测定稿的用法:
- 甜点区:业务输入 ≤35K、输出 ≤8K、单发短会话,响应 10–25s。
- 派活走 API:任务书自带全部材料,一发一收,结果落盘。DSH 界面手动切台式机只限"新窗口 + 新会话 + 单话题短用",不堆长对话。
- 严格串行:并发就是排队,队头阻塞实测 36s。长任务在跑时别插短请求指望即时响应。
- 禁派计数和多步算术——两边模型都不可信,计算交代码执行。
- 关机即全断,断得干净:连接拒绝 0.2 毫秒返回,不挂死、不重试风暴、本机零波及。没有自愈,恢复靠对侧重新拉隧道——符合"不常驻、纯手动"的设计。
边界
- 质量卷 n=5,只能说"无肉眼可见差异",不是"质量等价"。
- 速度读数全部来自单台 256GB M5 Ultra;16–24GB 机器是流式加载的主场,数字不搬。
- 90 条请求是 agent 型负载(长会话、高缓存命中),换聊天型短请求画像会不同。
- 台式机数据是 11-15 单轮矩阵,n=1 定稿,后续波动未跟踪。
图片出处
- 主题图与插图:本机双引擎生图(封面与数据板 H3,运行环境 Qwen-Image-2.1)
-
-
-
-
-
-
-
@ivan-lan 大佬,要不你再上两台M5 Ultra 256g组个试试看是不是比512G单台更优,最终还能再把256+256+512三台组个论坛最强天团。让我也有个念想,以后要不要再加一台256G


 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!

