求助:H3 首尾帧+钉图+深度控制,一镜到底时场景还是会变形、位移(背景换成别的街、东西漂、画面猛跳),怎么根治?(5080 16G・hybrid+4 步)
-
各位大神好,上次快动作划痕的帖子(topic/3092)谢谢大家,换成 STEP600 8 步以后好多了。
这次是做第一人称视角的实拍风短片(一集 22 条镜头、每条 8–10 秒),每条都带深度控制、首尾帧,中间还钉了关键图。问题有好几类,但出现最多、最想优先解决的是「场景变形和位移」:明明是一镜到底,场景却会突然变来变去。每次都得重跑或后期修,很耗时间。
我的设置
- 机器:RTX 5080 16G・内存 128G・Win11・ComfyUI 便携版
- 底模:
minimax_h3_hybrid_fl2va_ref2va_b25-49-int8 - 加速 LoRA:官方首尾帧
minimax_h3_fl2v_turbo_4step_v1.0_768p强度1.0,4步,euler+simple - 注意力 comfy kitchen(全量);视频 VAE fp16 分块解码
- 1024×576、24fps、8–10 秒;每条跑 2 个种子挑一条;跑完 RTX 超分到 720p
- 控制:Fun ControlNet Union 2.0(剪枝 int8),深度视频来自自己搭的灰盒场景;人物近景用 Blender+MPFB 人体出深度
- 首帧+尾帧+
MiniMaxH3AddGuide在指定帧钉关键图(关键图是另外用图像模型画的写实图),两张钉图之间一般隔 5 秒左右 - 有台词的镜头给
audio_guide(和镜头等长的干声轨)
★问题 1(最优先):场景变形、位移
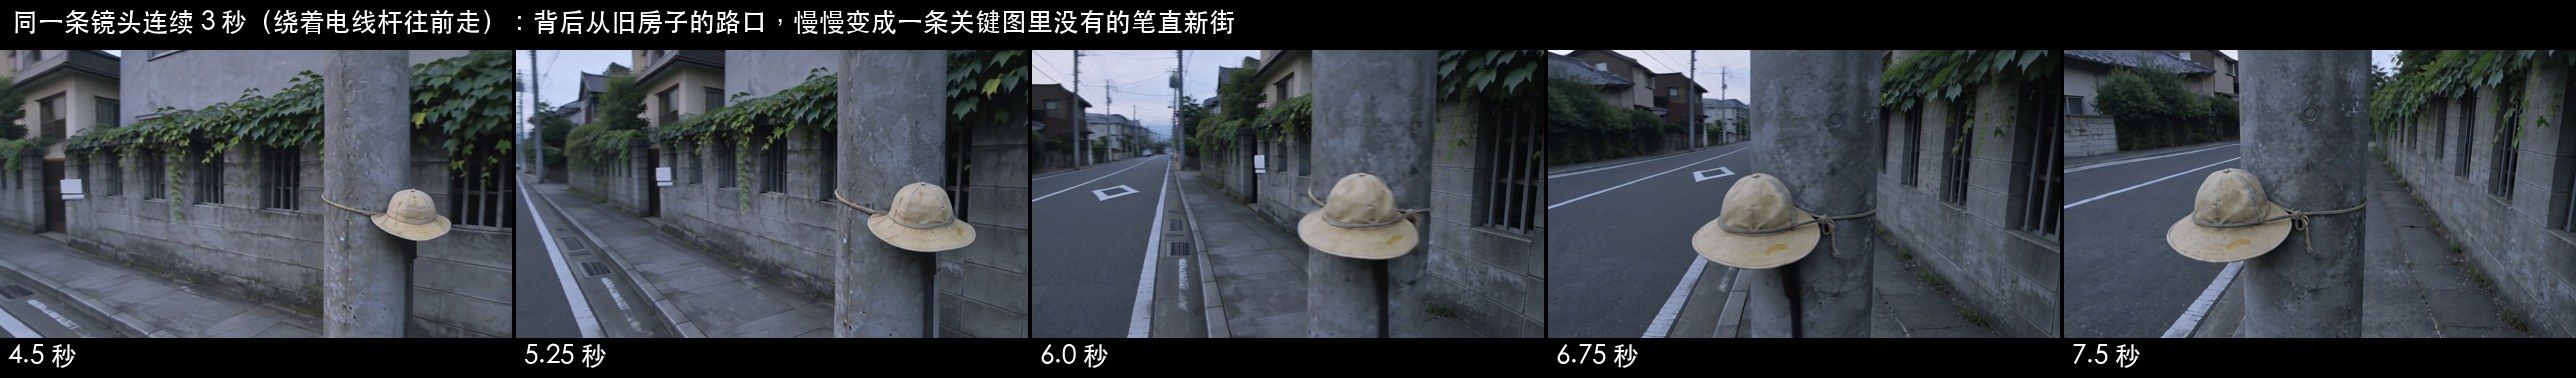
图 1:同一条镜头连续 3 秒,背后的街换成了另一条
一集 22 条里,大约 19 条有这个问题,大致是这几种:
- 转头、甩镜、快速低头抬头的时候,编出关键图里没有的东西
- 绕着电线杆往前走,背后从旧房子的路口变成一条笔直的新街(图 1)。
- 甩镜时编出奶油色、粉色的房子;窗户数 3→2→1。
- 快速低头抬头后,路沿消失、斑马线变得巨大。
- 多一根电线杆、一栋新式的楼、路牌出现又消失。
- 静止的东西在一条镜头里漂
- 饭桌上碗盘、鱼的位置慢慢滑动,还多出第三套饭菜,连着三个镜头都这样。
- 走近时背景先推近、又弹回去,像「呼吸」。
- 重影、叠化:路灯和信号杆变成两根、路灯头长到别的杆子上、一个人头上两顶帽子、房子叠成两栋。
- 画面猛跳
- 远处灯杆一帧跳约 140 像素。
- 一条 8 秒的镜头前 2.4 秒钉了 5 张图(下路沿一步、被拉回),整条街先上移约 55 像素、再猛地落下约 50 像素,看起来像换了一个地方。后面 5.6 秒只有深度+尾帧,反而很稳。
我们自己查到的原因
原因 比例 说明 同一条镜头里几张关键图把同一个地方画得不一样 22 条里约 15 条 杆子数量、路灯在信号杆左边还是右边、杆上有没有东西、碗盘排法不同 → H3 只能在两张图之间「变形」过去 关键图都一致,H3 自己在快摇、转头、低头抬头时编 约 4 条 这一类最想请教 钉图机位落差大、间隔太短 少数 0.5 秒内要求画面移动 50 多像素 → 硬拉,像换景 已经试过的
试法 结果 关键图统一(上 H3 前把同一条的关键图排成一排、逐物件对) 关键图引起的变形基本没了 转头途中多加一张钉图 编出来的东西少了,但没钉到的那几秒还会出 钉得更密 反而更容易变形:图之间稍有不一致就会中途变过去 一个大动作拆成两条,在被遮挡的那一刻切 能躲开猛跳,但镜头变多 其他问题(次要)
画面边上凭空冒出人
「我」站着转头、低头时,画面边上挤进来一个孩子(约占 1/5、约 2 秒)。控制视频和关键图里那里都是空的,提示词里也没写。也会多出手。
图 2:H3 原片(左)和同一时刻的深度控制(右)
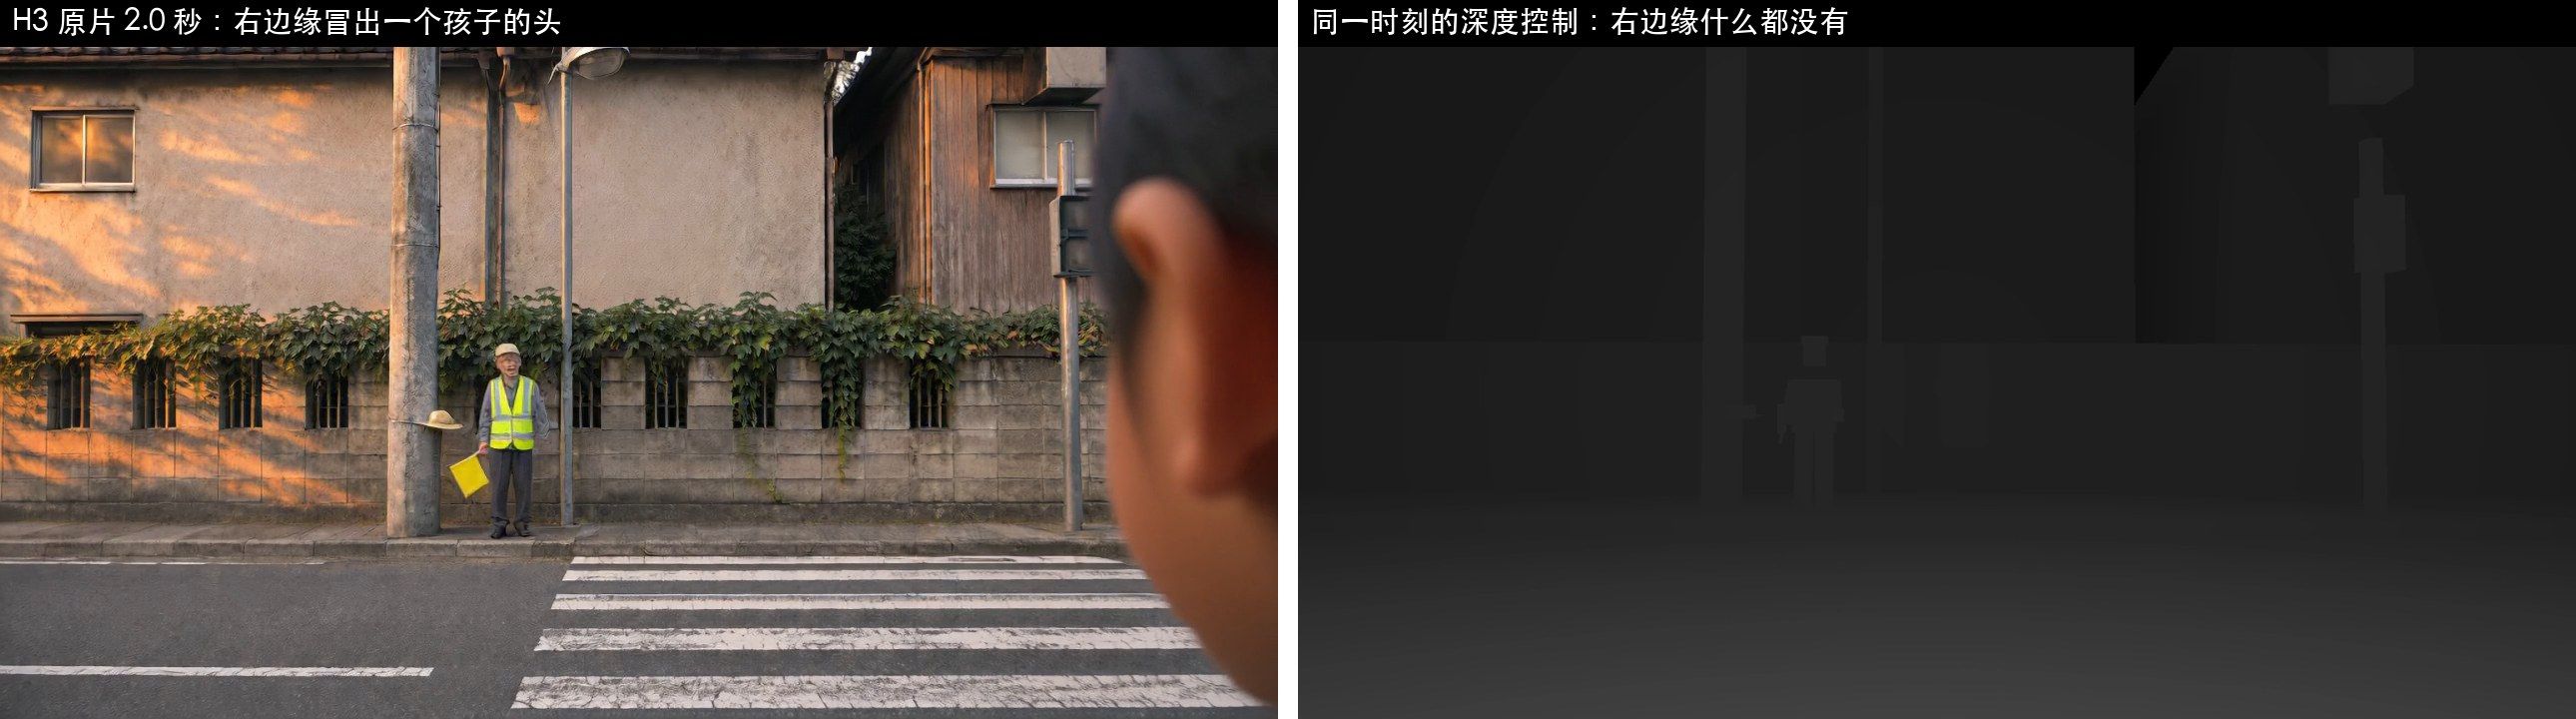
片段_画面边上冒出孩子.mp4提示词写「只有写到的人在场」没用;去掉提示词开头的身份描述(原来写「放学走路回家的 7 岁女孩」,改成只写机位高度)+正面那几秒再钉图,才压住。
远处的人脸糊
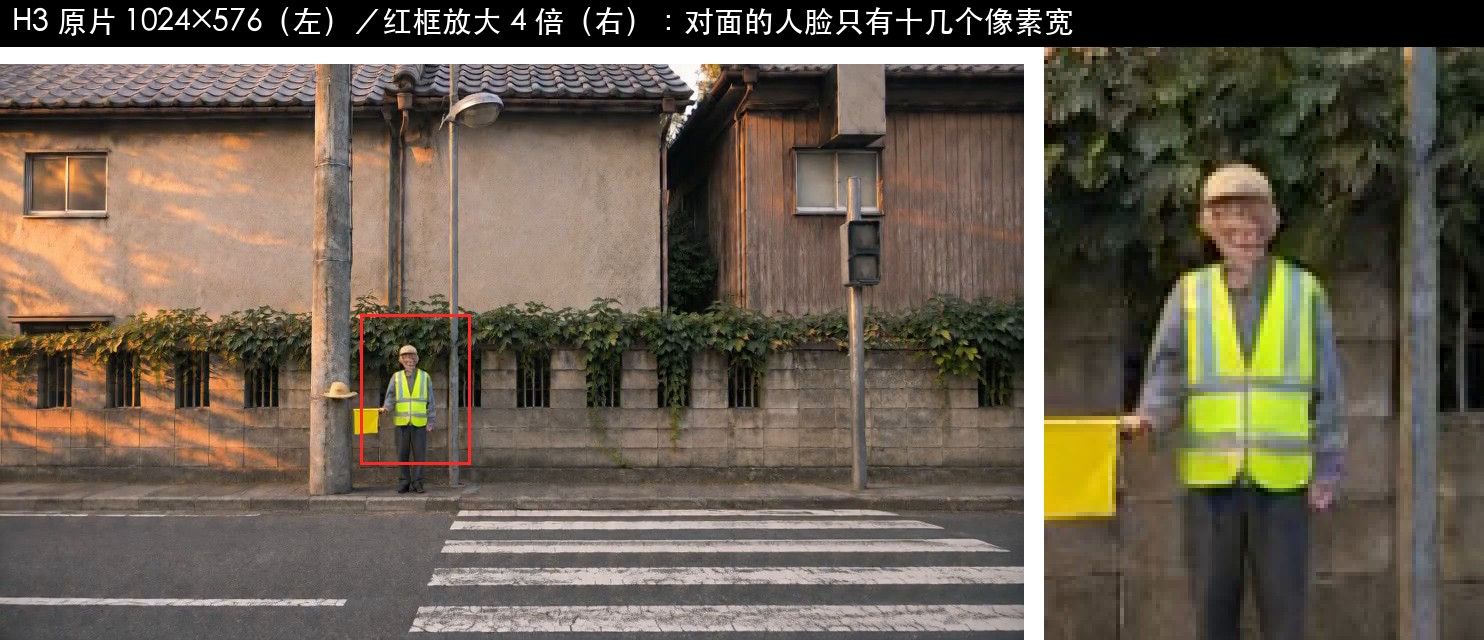
马路对面的人脸只有十几个像素宽,推近只会更糊。
图 3
说话时嘴的问题
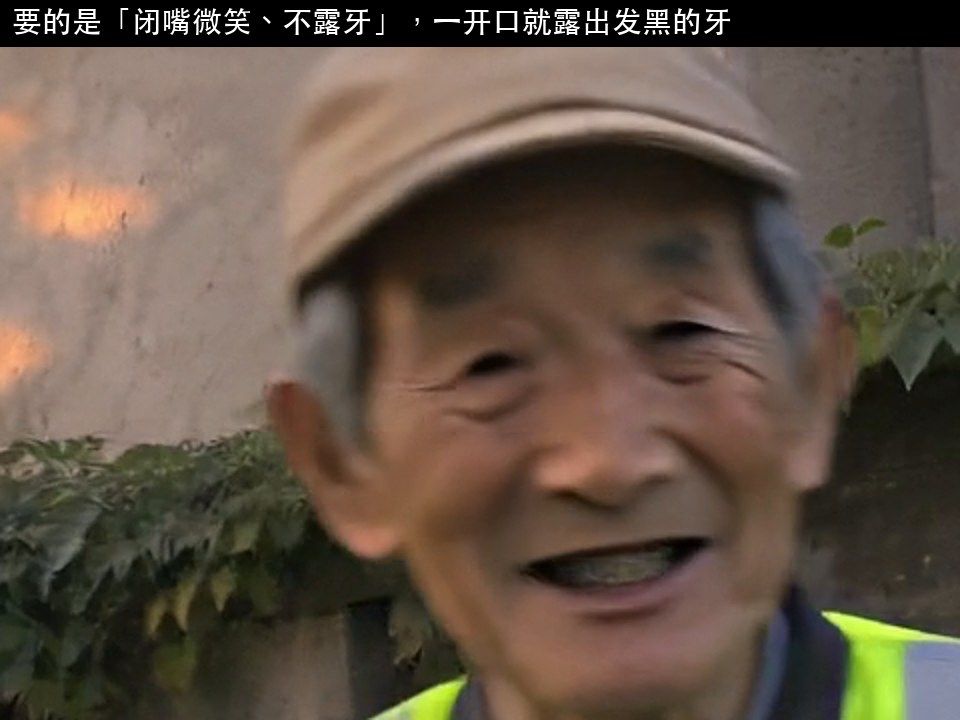
要「闭嘴微笑、不露牙」,一开口就张大嘴、露出发黑的牙;给了
audio_guide以后,台词以外也会多动嘴,开口晚约 0.2 秒。图 4
想请教(1~3 最想知道)
- 快摇、转头、低头抬头时 H3 编出新场景:除了多钉图,有没有更稳的办法?比如深度控制强度、start/end 怎么设,加速 LoRA 换 STEP600/步数加到 6~8 会不会好一些,或者有没有专门稳背景的 LoRA?
- 钉图的密度和间隔:一般隔几秒钉一张比较合适?机位变化大的地方,钉图之间最少要隔多少帧才不会硬拉?
- 静止物体(桌上的碗盘、电线杆)在一条镜头里不漂:有什么办法?人物近景的深度视频里,背景几乎全黑(深度归一化被近处的人占满),这会不会让背景更容易漂?深度的范围要怎么处理?
- H3 自己加人:负面提示词有用吗?
- 远处人脸、说话露牙:有没有推荐的做法?
先谢谢各位!
-
规矩:
提示词不要掺杂负面提示词,比如你叫他不露牙,画面会看到牙
画面有声音的话,默认嘴巴会讲对白
试一试加速lora 放成 0.8
修复小脸可以试一试face refine, 或者reactor -
规矩:
提示词不要掺杂负面提示词,比如你叫他不露牙,画面会看到牙
画面有声音的话,默认嘴巴会讲对白
试一试加速lora 放成 0.8
修复小脸可以试一试face refine, 或者reactor -
各位大神好,上次快动作划痕的帖子(topic/3092)谢谢大家,换成 STEP600 8 步以后好多了。
这次是做第一人称视角的实拍风短片(一集 22 条镜头、每条 8–10 秒),每条都带深度控制、首尾帧,中间还钉了关键图。问题有好几类,但出现最多、最想优先解决的是「场景变形和位移」:明明是一镜到底,场景却会突然变来变去。每次都得重跑或后期修,很耗时间。
我的设置
- 机器:RTX 5080 16G・内存 128G・Win11・ComfyUI 便携版
- 底模:
minimax_h3_hybrid_fl2va_ref2va_b25-49-int8 - 加速 LoRA:官方首尾帧
minimax_h3_fl2v_turbo_4step_v1.0_768p强度1.0,4步,euler+simple - 注意力 comfy kitchen(全量);视频 VAE fp16 分块解码
- 1024×576、24fps、8–10 秒;每条跑 2 个种子挑一条;跑完 RTX 超分到 720p
- 控制:Fun ControlNet Union 2.0(剪枝 int8),深度视频来自自己搭的灰盒场景;人物近景用 Blender+MPFB 人体出深度
- 首帧+尾帧+
MiniMaxH3AddGuide在指定帧钉关键图(关键图是另外用图像模型画的写实图),两张钉图之间一般隔 5 秒左右 - 有台词的镜头给
audio_guide(和镜头等长的干声轨)
★问题 1(最优先):场景变形、位移
图 1:同一条镜头连续 3 秒,背后的街换成了另一条
一集 22 条里,大约 19 条有这个问题,大致是这几种:
- 转头、甩镜、快速低头抬头的时候,编出关键图里没有的东西
- 绕着电线杆往前走,背后从旧房子的路口变成一条笔直的新街(图 1)。
- 甩镜时编出奶油色、粉色的房子;窗户数 3→2→1。
- 快速低头抬头后,路沿消失、斑马线变得巨大。
- 多一根电线杆、一栋新式的楼、路牌出现又消失。
- 静止的东西在一条镜头里漂
- 饭桌上碗盘、鱼的位置慢慢滑动,还多出第三套饭菜,连着三个镜头都这样。
- 走近时背景先推近、又弹回去,像「呼吸」。
- 重影、叠化:路灯和信号杆变成两根、路灯头长到别的杆子上、一个人头上两顶帽子、房子叠成两栋。
- 画面猛跳
- 远处灯杆一帧跳约 140 像素。
- 一条 8 秒的镜头前 2.4 秒钉了 5 张图(下路沿一步、被拉回),整条街先上移约 55 像素、再猛地落下约 50 像素,看起来像换了一个地方。后面 5.6 秒只有深度+尾帧,反而很稳。
我们自己查到的原因
原因 比例 说明 同一条镜头里几张关键图把同一个地方画得不一样 22 条里约 15 条 杆子数量、路灯在信号杆左边还是右边、杆上有没有东西、碗盘排法不同 → H3 只能在两张图之间「变形」过去 关键图都一致,H3 自己在快摇、转头、低头抬头时编 约 4 条 这一类最想请教 钉图机位落差大、间隔太短 少数 0.5 秒内要求画面移动 50 多像素 → 硬拉,像换景 已经试过的
试法 结果 关键图统一(上 H3 前把同一条的关键图排成一排、逐物件对) 关键图引起的变形基本没了 转头途中多加一张钉图 编出来的东西少了,但没钉到的那几秒还会出 钉得更密 反而更容易变形:图之间稍有不一致就会中途变过去 一个大动作拆成两条,在被遮挡的那一刻切 能躲开猛跳,但镜头变多 其他问题(次要)
画面边上凭空冒出人
「我」站着转头、低头时,画面边上挤进来一个孩子(约占 1/5、约 2 秒)。控制视频和关键图里那里都是空的,提示词里也没写。也会多出手。
图 2:H3 原片(左)和同一时刻的深度控制(右)
片段_画面边上冒出孩子.mp4提示词写「只有写到的人在场」没用;去掉提示词开头的身份描述(原来写「放学走路回家的 7 岁女孩」,改成只写机位高度)+正面那几秒再钉图,才压住。
远处的人脸糊
马路对面的人脸只有十几个像素宽,推近只会更糊。
图 3
说话时嘴的问题
要「闭嘴微笑、不露牙」,一开口就张大嘴、露出发黑的牙;给了
audio_guide以后,台词以外也会多动嘴,开口晚约 0.2 秒。图 4
想请教(1~3 最想知道)
- 快摇、转头、低头抬头时 H3 编出新场景:除了多钉图,有没有更稳的办法?比如深度控制强度、start/end 怎么设,加速 LoRA 换 STEP600/步数加到 6~8 会不会好一些,或者有没有专门稳背景的 LoRA?
- 钉图的密度和间隔:一般隔几秒钉一张比较合适?机位变化大的地方,钉图之间最少要隔多少帧才不会硬拉?
- 静止物体(桌上的碗盘、电线杆)在一条镜头里不漂:有什么办法?人物近景的深度视频里,背景几乎全黑(深度归一化被近处的人占满),这会不会让背景更容易漂?深度的范围要怎么处理?
- H3 自己加人:负面提示词有用吗?
- 远处人脸、说话露牙:有没有推荐的做法?
先谢谢各位!
-
- 控制是比较难的,最好的方法是整个街景全部3D建模。
2.要不然你一次生成九宫格,直接让H3参考。
3.静止的东西在一条镜头里漂,一般是不会变化的,我怀疑是不是你基本调度器降噪设定的不是1.0。
4.H3 自己加人,分辨率大可能就会自己加人,试一试二采呢。
5.不露牙前面有人已经回答过了。远处人脸崩坏是所有视频模型共通的。今天刚看到一个视频说的就是人脸修复。
参考视频:https://youtu.be/sKM83V9og4Q
- 控制是比较难的,最好的方法是整个街景全部3D建模。