MAC生态 视频生成的另一条路径vpipe跑 12 秒视频 33 分钟出片,h3.c 消不掉的网格它没了
-
vpipe 跑法:12 秒视频 33 分钟出片,h3.c 消不掉的网格它没有了
同一台 M5 Ultra,同一组参考图,三个成片都在帖子里。顺带把 FastH3 官方 MLX 路线也试了,单步 55.6 分钟,没跑完放弃了。
个人结论
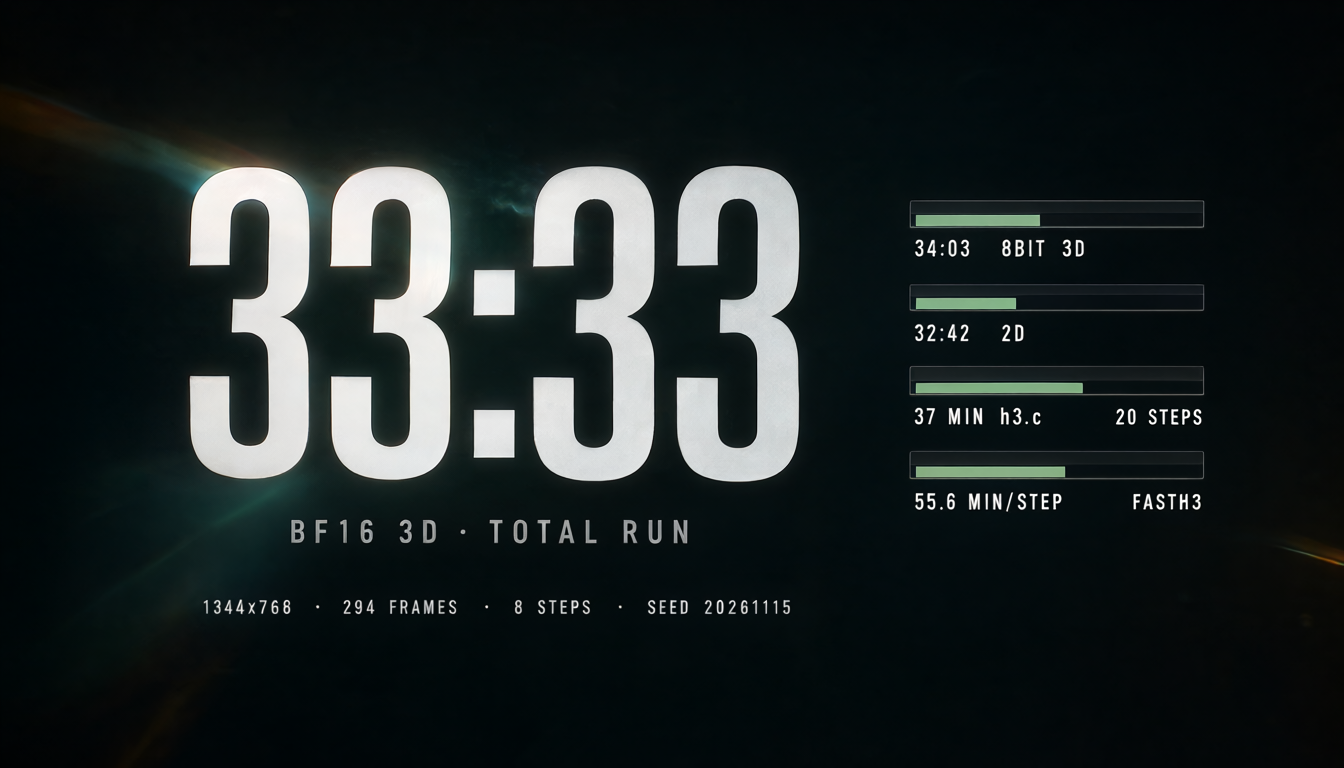
- vpipe 8 步:12 秒视频,33 分钟出片**(三场 32m42s / 33m33s / 34m03s)**
- 8bit 和 BF16 几乎同速;h3.c 那层 16px 网格,vpipe 三场未见
- FastH3 官方 MLX 路线:单步 55.6 分钟,全程预估7+小时,没跑完我放弃了。
🧭 前情提示
我用 h3.c(antirez 写的原生 C/Metal 引擎)跑 MiniMax H3 交了两条参赛视频,20 步、双参考图、单卷 37 分钟,帖子在 https://lcz.me/topic/3074。那篇里我说过一个消不掉的瑕疵:成片背景有一层 16 像素周期的网格纹理,int8 / BF16 / VAE 分块 / 去块滤镜全试过,没有一个配置能去掉,当时结论是"要么接受它或者降分辨率"。
后来论坛的一位帖主(lcz.me/topic/3131)晒了另一条路线:vpipe 管线,官方 BF16 权重自己重量化成 8bit,turbo 适配器把步数压到 8 步。他那台MAC 24G 内存的机器跑了 2 小时 38 分,但成品没网格。爱折腾的我花了点时间把他的跑法完整过一遍,顺便测一下:网格消失后,速度能到多少。
今天跑完了,三个成片 + 一个失败案例,数据全在下面。
 视频
2D版
3D版
3D BF16版
测试环境项 值 机型 Mac Studio,Apple M5 Ultra,256 GB 统一内存 管线 vpipe(H3 官方权重 Ref2VA 分区,8bit 重量化 + turbo 适配器) 同参口径 1344×768 · 288 帧请求(24fps 网格吸附到 294 帧 = 12.25s)· 6 张参考图 · seed 20261115 · 8 步 提示词 三场逐字同一份(3327 字符,含画面 + 音效 + 配乐描述) 参考图是两位角色的设定图各 3 张(设定表 ×2 + 3D 手办渲染 ×1),比 h3.c 那次的双图条件多了一倍。
 三场实测
场次 权重档 总耗时 denoise 节奏 首帧 forward 驻留实测 3D 风格 8bit 34m03s 每 10% 整 3 分钟 2551 ms wire budget 170 GB,无 parked 无 swap 2D 风格 8bit 32m42s 每 10% 整 3 分钟 2460 ms 50/50 blocks 全驻留,零 parked 零 swap 3D 风格 BF16 原卷 62 GB 33m33s 每 10% 约 3 分钟 2380 ms 62 GB 全驻留,零 parked 零 swap 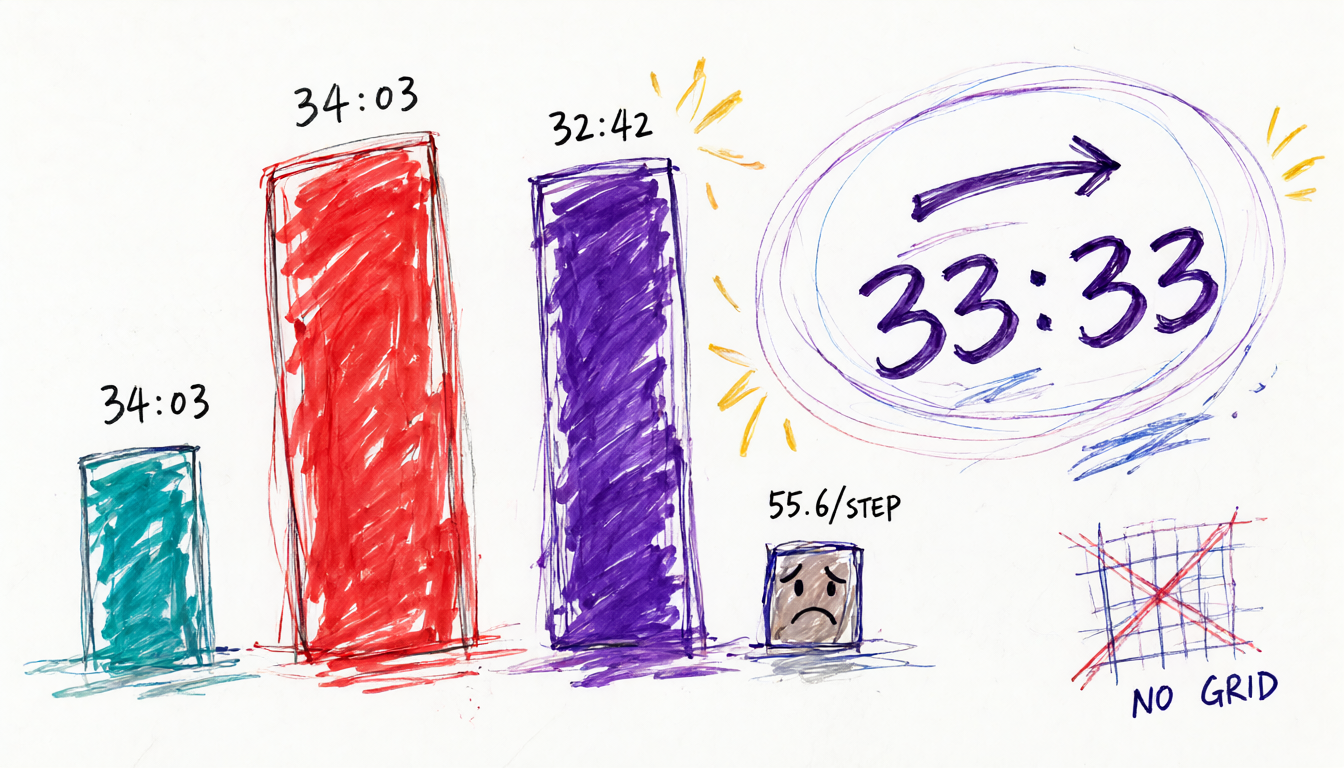
成片 ffprobe 实测:三条全部 294 帧 / 12.250000s / 含音轨,规格零漂移。
有两件事跟预期不一样:
一,8bit 和 BF16 几乎同速。 我以为"全精度会慢一大截"的,结果 34m03s 对 33m33s,差 30 秒。这台机器带宽够,权重精度对 vpipe 的速度基本没影响,选档纯看质量。62 GB 原卷全驻留也没爆内存——vpipe 会把可回收部分标成 purgeable 交给内核,跑完干脆利落地还回来,全程零 swap。
二,网格没了。 h3.c 那层 16px 周期网格,这三条成片放大看都没有。同一个模型、同一族权重,换了引擎和 VAE 路径,纹理问题直接消失。之前查 ComfyUI issue #15416 的结论"与量化位宽无关"是对的,但它指向的是 VAE 解码路径的差异——vpipe 这条路径没有这个症状。这条我只有主观观察 + 抽帧,没有做 h3.c 那种整图误差测量,欢迎有工具的兄弟补一个定量对比。
🧪 顺便说的 FastH3:没跑完也没必要,预计7小时+以上
结论:链路全通,速度判死。
FastVideo 官方刚出的 FastH3 OmniRef MLX 路线,PDD 蒸馏 8 步契约、音视频联合生成。权重导出、MLX int8/BF16 转换、四处官方文档没写细的坑,全部趟通了,正常出片:768×432、124 帧、带音频、denoise 1064 秒。
然后同参死在速度上:第一步 denoise 3339 秒(55.6 分钟),8 步就是 7 小时。零 swap、内存富余 41%,不是内存问题,纯粹算力路径慢。我直接停了,这个时间对生产力没有意义。
为什么这么慢:每步要同时算视频和音频两路 token、6 张参考图编码成 39936 行条件每步都要过注意力、MLX 版稀疏注意力目前走的是通用 sdpa 实现、BF16 档没有 int8 GEMM 加速通道。四个因素各占多少我没做单变量隔离(int8 档对照没跑,都 7 小时级别了没必要),不做定论。
唯一的价值在音视频同步生成这个能力,这台机器上的速度不可用。官方后续要是把 M5 的 nax 后端和 int8 GEMM 路径补上,可以再测。
 ️ 跟我现在能用的 h3.c 方案比
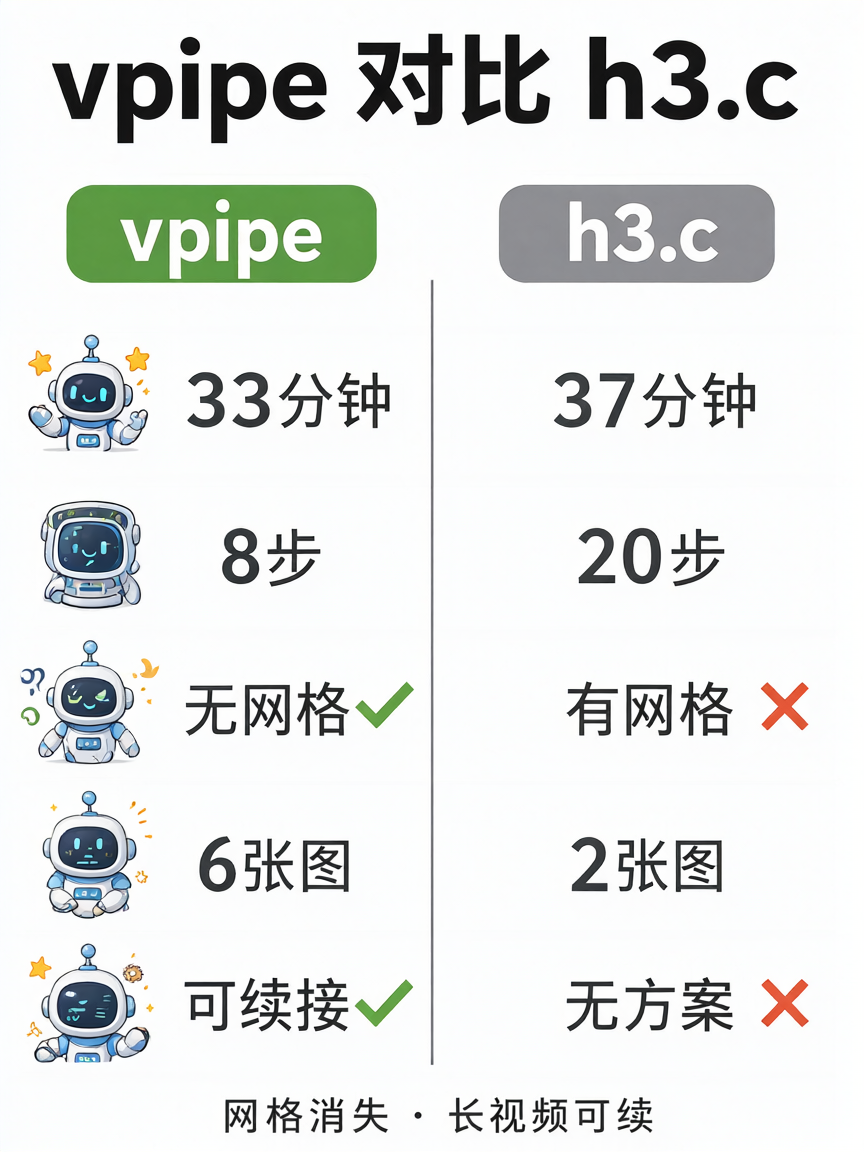
维度 h3.c vpipe 出片耗时(12s 同参) 37 分钟(20 步) 33 分钟(8 步) 网格纹理 16px 周期网格,全配置无解 三场未见(主观 + 抽帧) 参考图条件 双图 6 图,身份保持更稳 步数弹性 20 步起 turbo 8 步,也可回 20 步 长视频 无现成方案 官方 extend 链,每段净增 10.125s,可全自动串 运行时 纯 C/Metal,无 Python Python 管线,权重 mmap + purgeable 驻留管理 引擎维护 antirez 个人项目 社区管线,官方权重直接进 速度上两者差距不太大(37 vs 33 分钟,注意 h3.c 是 20 步、vpipe 是 8 步,单步成本 vpipe 低得多)。分水岭在网格和长视频:h3.c 的网格我实测无解,vpipe 没有这个问题还有续接链。
所以这台机器的视频生成常驻我定 vpipe,h3.c 留作"想要无 Python 运行时"时的备选。
 数据口径
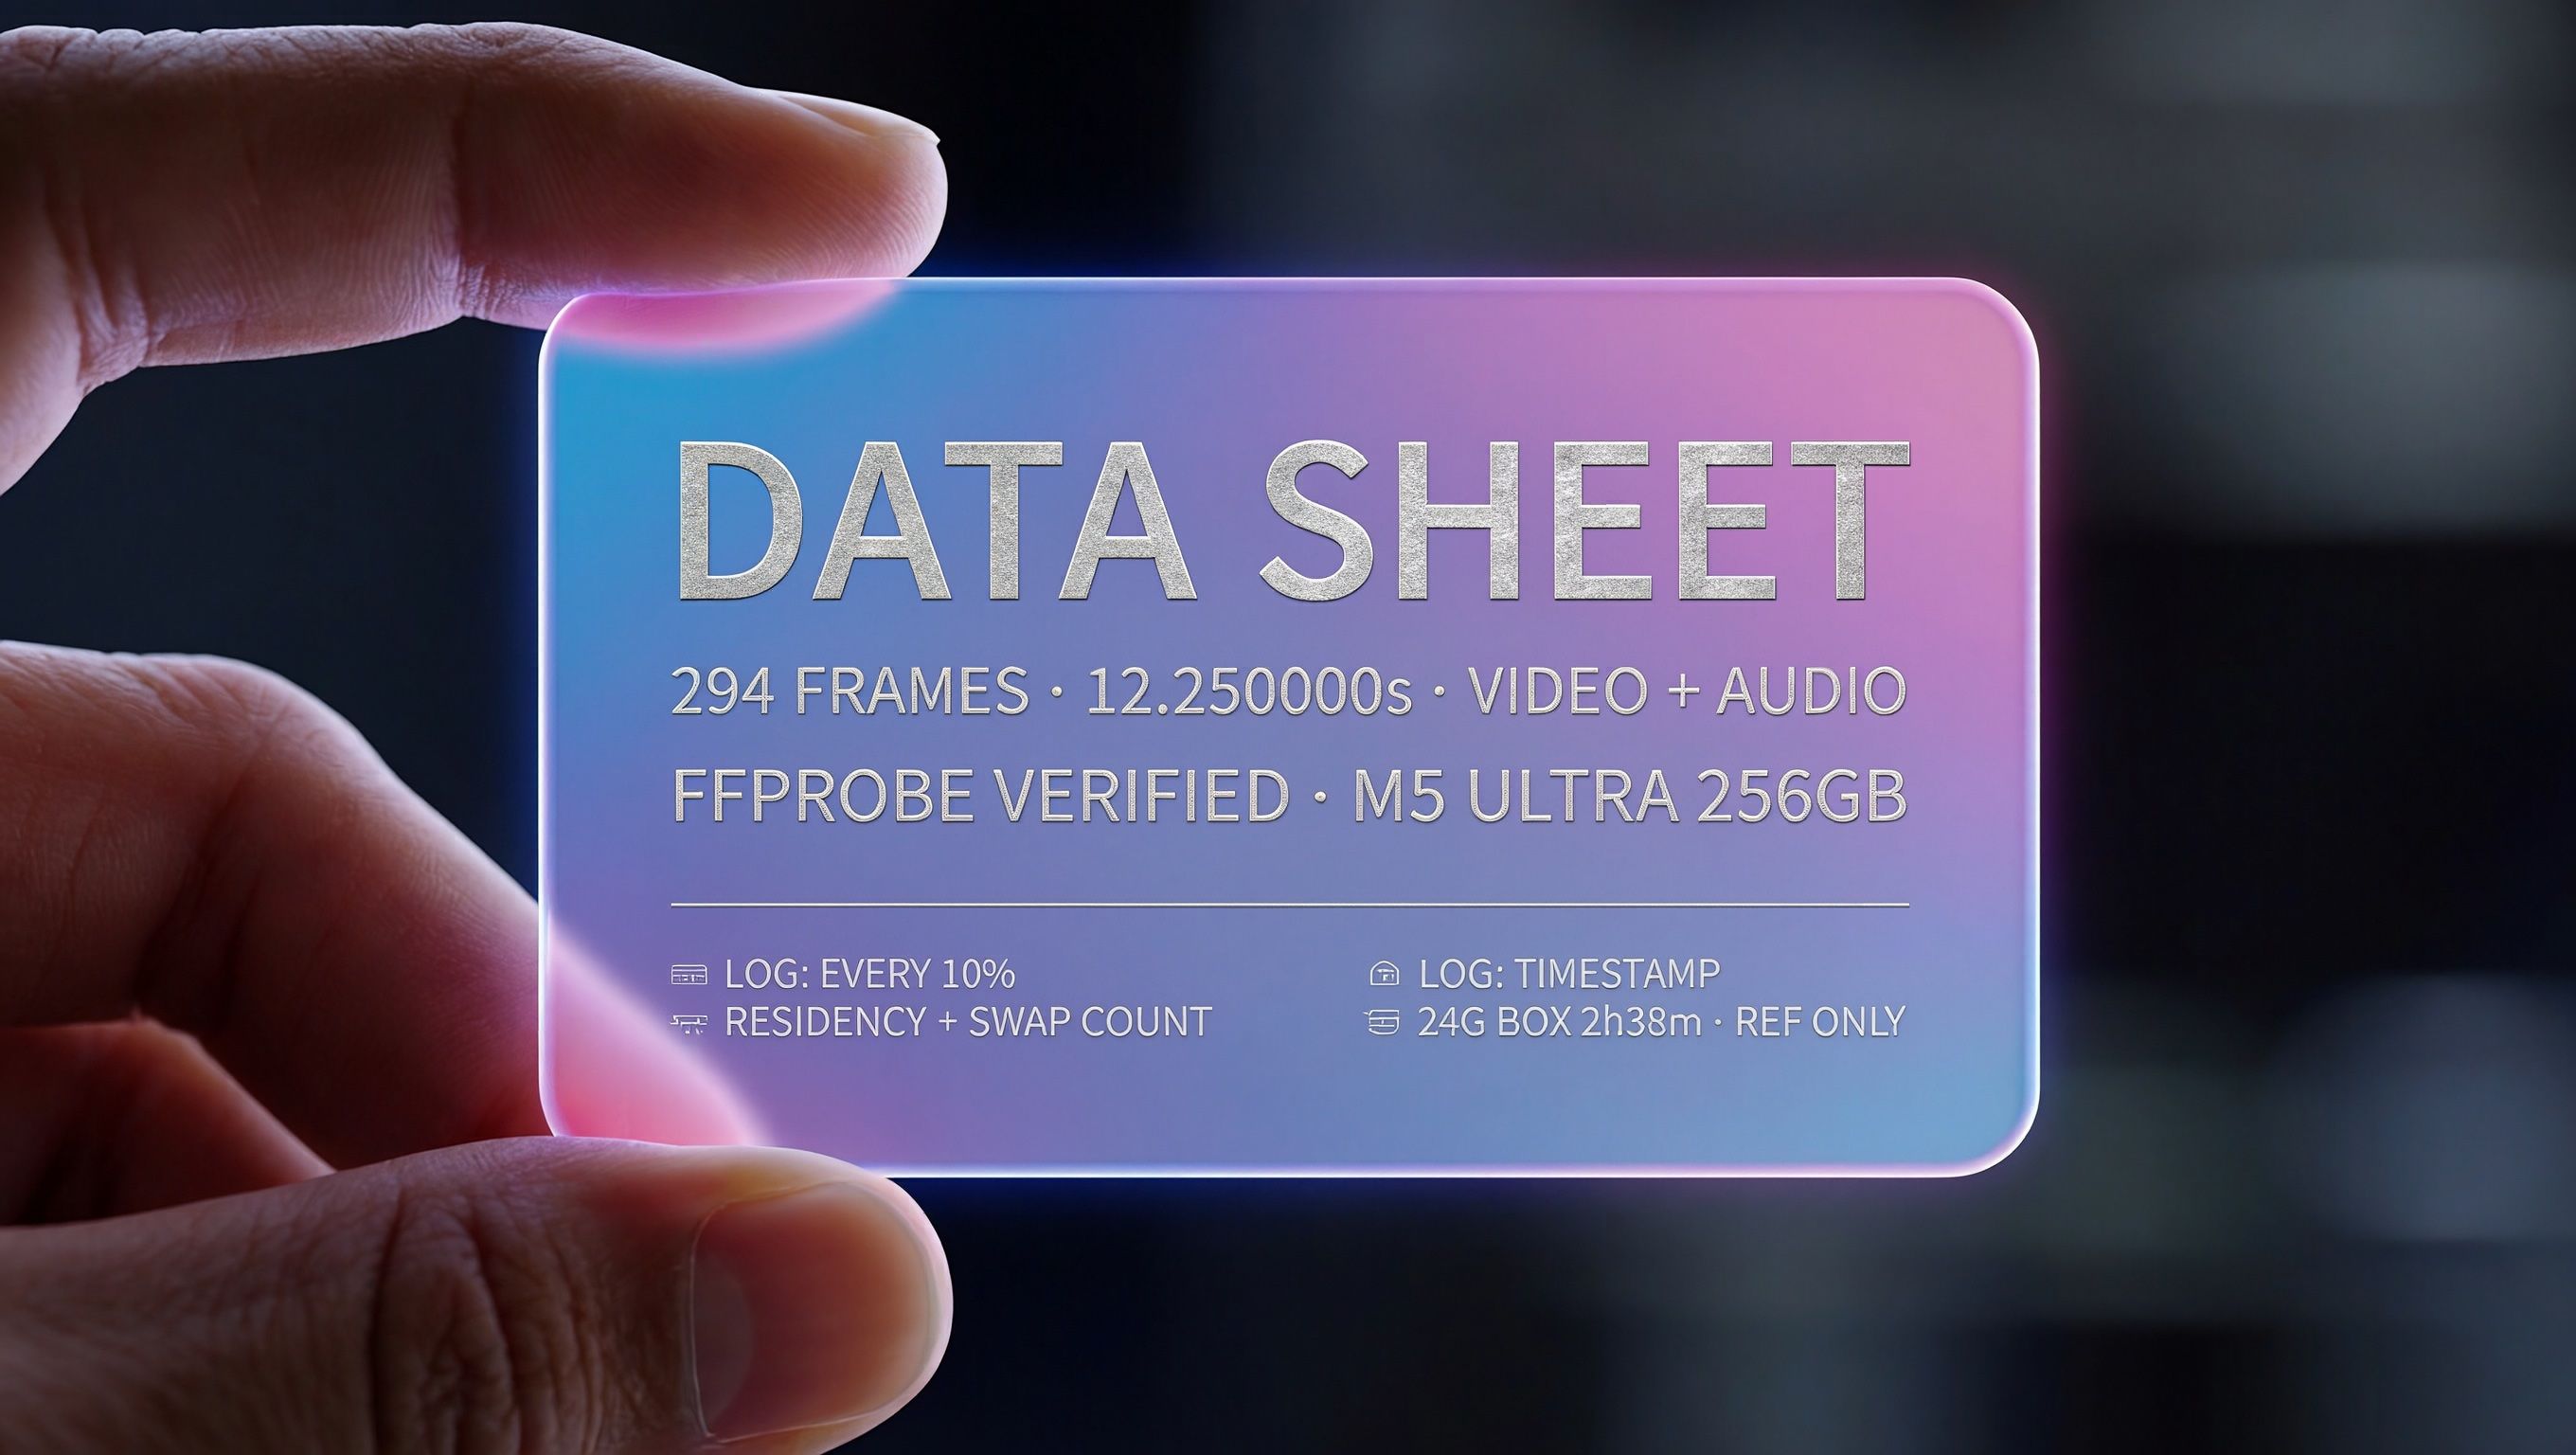
- 三场成片:ffprobe 均 294 帧 / 12.250000s / 视频+音轨
- 每场日志含 denoise 每 10% 时间戳、首帧 forward、residency probe、swap 计数,可复算
- 帖主 24G 机 2h38m 为他帖实测,与我这三场不同机不同内存,只作路线参考不作同参对比
三条路径都验证能出片之后,对比下来总算打到了可用的常驻方案。
-
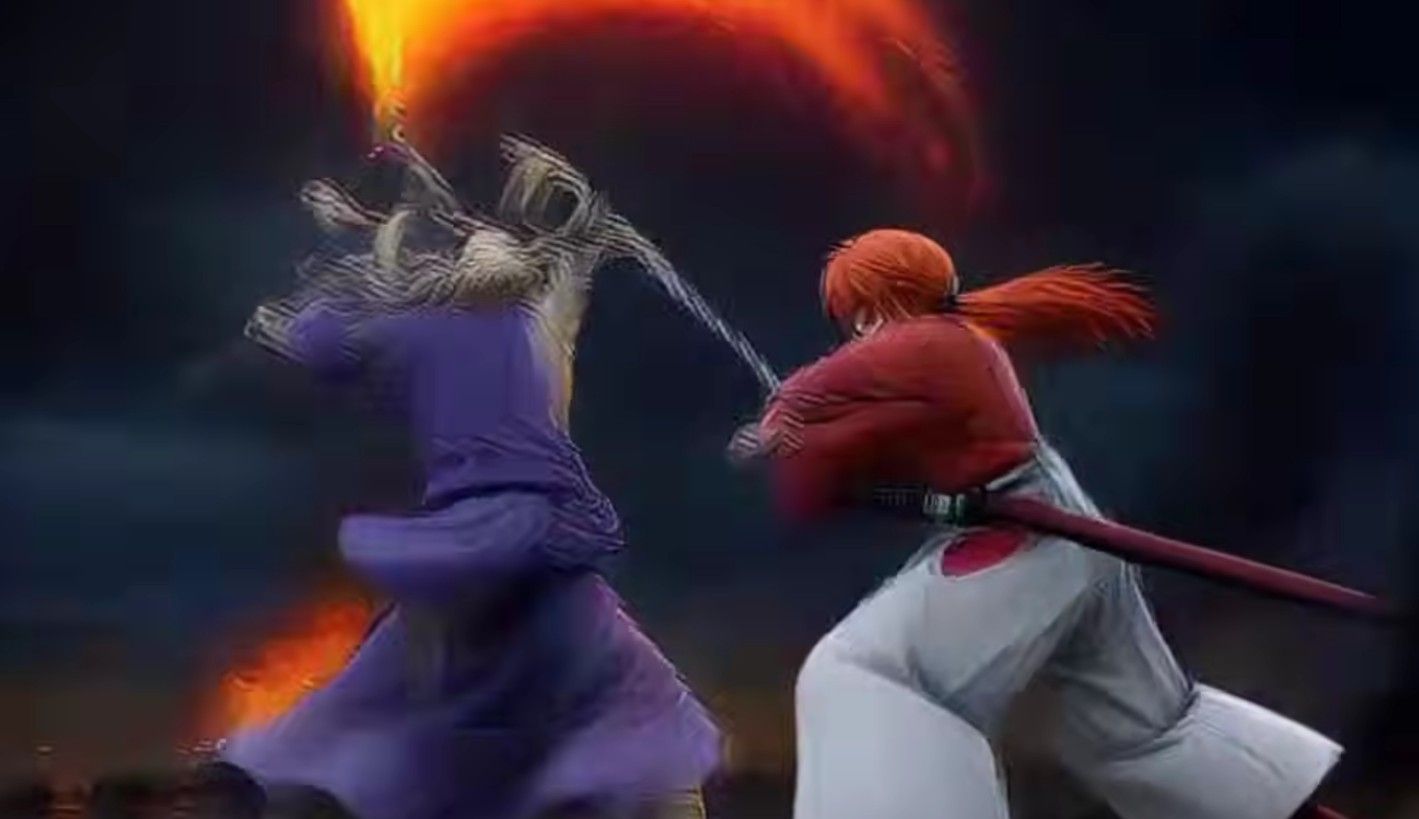
问题依旧:像素出现抖动和撕裂的问题,这个问题就连rtxpro 5000也会出现,看来是某些模型有瑕疵,等比赛后我们研究
-
问题依旧:像素出现抖动和撕裂的问题,这个问题就连rtxpro 5000也会出现,看来是某些模型有瑕疵,等比赛后我们研究
-