跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 廉頗老矣,尚能飯否? 測試tesla V100 32Gx2 部署Qwen 3.6 27B Q8模型

廉頗老矣,尚能飯否? 測試tesla V100 32Gx2 部署Qwen 3.6 27B Q8模型

已定时 已固定 已锁定 已移动 LLM讨论区
本地模型v100qwen-27b量化
10 帖子 5 发布者 798 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • soop ladiosS
    soop ladiosS
    soop ladios
    劳动模范 技术大牛
    发表于 最后由 编辑
    #1

    前幾天看著平常編程在用的洋垃圾, 突然想搞個顯卡來跑跑qwen 3.6 27B. 看了半天, 台灣這邊魔改卡不好買, 也都是天價. 7900XTX基本沒人在賣, R9700兩張又太貴, 就入了兩張Nvidia TESLA v100 32G來試試.
    電腦本來只有BMC顯示, 所以驅動啥的都沒裝, 只有裝ubuntu 26.04.
    各論壇看了看, 鎖定llama.cpp + Qwen3.6-27B-UD-Q8_K_XL.gguf , 然後把相關資料交給gemini cli去安裝, 大概一個小時它就把NVIDIA 驅動,CUDA其他相依軟件及設定搞好, llama.cpp編譯完成, 該避的坑避掉, 模型下載完然後就跑起來了, 全程無干預.
    再來就是跟它花了大概兩個小時測試調整, 主要是一開始的prefill慘不忍睹, 花很多時間在長文本測試優化. 調到一個滿意的設定, 就差不多了, 整個過程還挺順利的.
    底下是我電腦的基本資訊:

    系統與硬體狀態

    • 作業系統: Ubuntu 26.04 LTS
    • CPU: AMD EPYC 7K62
    • RAM: 128GB DDR4
    • GPU 硬體: 2x NVIDIA Tesla V100-SXM2-32GB
    • PCIe 連線: Gen3 x16 (狀態良好)
    • 平均溫度: Idle 35°C / 滿載 ~45°C
    • 功耗限制: 300W

    目前的狀態大概是這樣:

    服務運行狀態

    • 服務名稱: qwen36-llama.service
    • 執行引擎: llama.cpp (CUDA 70架構優化編譯版)
    • 載入模型: Qwen3.6-27B-UD-Q8_K_XL.gguf

    當前模型參數配置 (終極優化版)

    • 總 Context 空間: 524,288 tokens
    • 併發能力 (Parallel): 2 路 (每路 262,144 tokens)
    • KV Cache 精度: q8_0
    • MTP 加速: 啟用 (draft-mtp, 最大預測數: 2)
    • Batching 設定: Batch 1024, UBatch 256

    效能與資源佔用指標

    VRAM 記憶體佔用

    系統已確保 100% 的權重與 KV Cache 駐留於 VRAM 中,完全不依賴系統 RAM 進行 offload,徹底解除 PCIe 頻寬瓶頸。

    • GPU 0 佔用: ~24.3 GB
    • GPU 1 佔用: ~30.3 GB
    • 總計佔用: 54.6 GB
    • 安全餘裕: 剩餘約 9.4 GB,足以應付 Batch 1024 運算時產生的動態 Scratch Buffer 需求。

    推理速度 (實測)

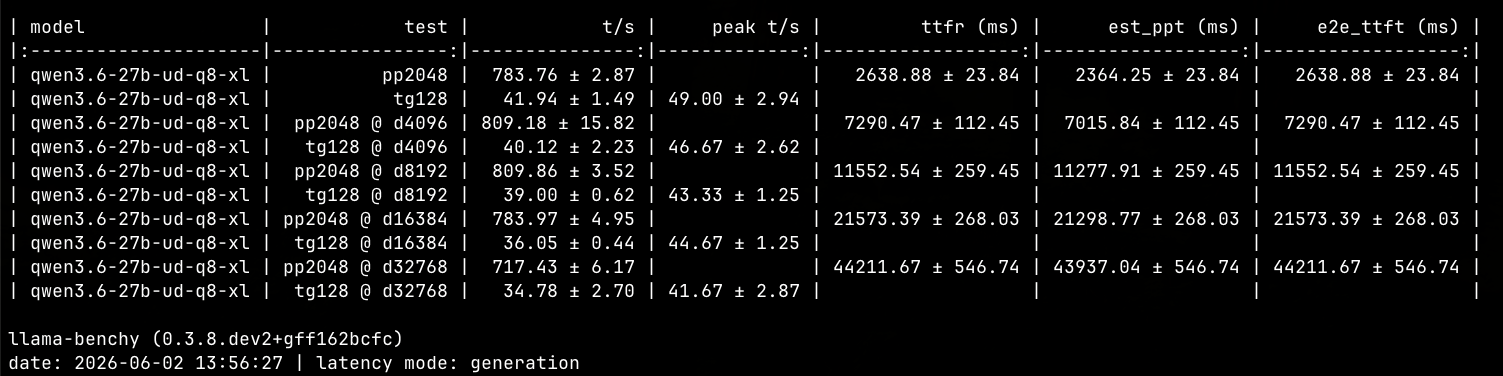
    • Prompt Processing (Prefill): 最高可達 ~611 tokens/second (長文測試)。
    • Generation (Decode): 穩定於 ~40 tokens/second。
    • MTP 接受率: 約 79% ~ 100% (極高效率)。

    以上是Gemini寫的報告, 中間有多次參數設定調整, 比較如下:

    效能測試結果總表

    測試組合 3路 256K (無MTP) 2路 256K (MTP 2) 1路 256K (B256, mtp2) 1路 256K (B512,mtp2) 1路 256K (B1024,mtp2) 2路 256K (B1024,mtp2)
    1. 成功啟動 是 是 是 是 是 是
    2. VRAM Used (GPU0/1) 27.8/31.2 GB 23.7/29.1 GB 19.3/23.8 GB 19.6/24.5 GB 19.9/25.1 GB 24.3/30.3 GB
    3. Prefill (t/s) 90.31 42.02 (短文) 263.93 395.94 611.04 23.01 (短文)
    4. Generation (t/s) 20.87 37.24 46.64 43.09 40.65 40.06
    5. MTP 接受率 N/A 79% 100% 100% 100% 87.5%
    6. 是否 OOM 否 否 否 否 否 否
    7. 數據位置 部分 RAM 部分 RAM 純 VRAM 純 VRAM 純 VRAM 純 VRAM
    8. GPU Power (0/1) 51W/49W 51W/49W ~50W/50W 52W/52W 53W/53W 51W/49W
    9. GPU Temp (0/1) 35°C/35°C 34°C/33°C 35°C/35°C 39°C/40°C 39°C/41°C 34°C/34°C

    定案之後看了一下vram占用狀態跟跑一下benchmark:
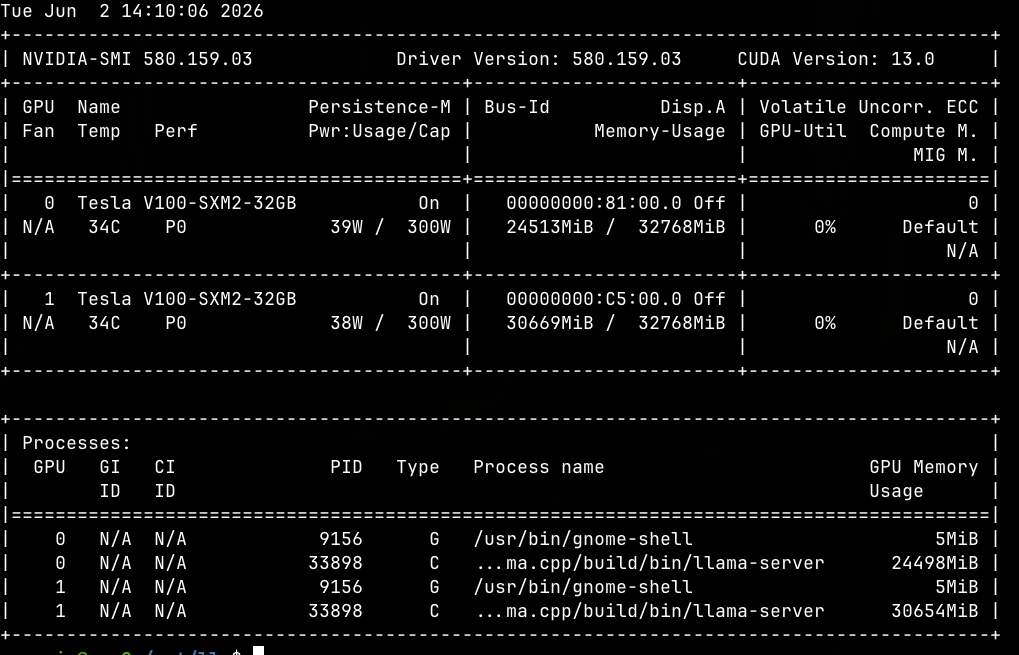
    v100_smi_2c_batch1024_ubatch_256_m2.png

    v100_bench_2c_batch1024_ubatch_256_m2.png

    心得:

    1. 一樣是qwen3.6 27B Q8模型, 實際使用速度約比雙spark高出5~10 token/s, prefill速度也還行. 不過雙spark可以容納約15路並行, 這台電腦礙於vram容量, 只能兩路.
    2. 渦輪風扇實在太吵, 必須關到小房間... 早知道不要嫌麻煩買個水冷...
    seabassS 1 条回复 最后回复
    1
    • terryT terry 于 将此主题固定
    • terryT
      terryT
      terry
      超级版主
      发表于 最后由 编辑
      #2

      大神们来评判下速度如何,效率如何。有V100可以多测下Comfy。

      油管:https://www.youtube.com/@抡锤者

      1 条回复 最后回复
      0
      • C
        C
        comeN
        发表于 最后由 编辑
        #3

        V100的16G版便宜,32G可不便宜,32G的性价比就不如双卡3080-20G,要输顺序加载1张32G和1张16G的能跑起来Q4KM的就更有价值.

        1 条回复 最后回复
        0
        • I
          I
          iocat
          发表于 最后由 编辑
          #4

          大佬你行动力也太强了,刚看完你spark的贴子

          1 条回复 最后回复
          0
          • 系统 于 取消固定此主题
          • soop ladiosS soop ladios

            前幾天看著平常編程在用的洋垃圾, 突然想搞個顯卡來跑跑qwen 3.6 27B. 看了半天, 台灣這邊魔改卡不好買, 也都是天價. 7900XTX基本沒人在賣, R9700兩張又太貴, 就入了兩張Nvidia TESLA v100 32G來試試.
            電腦本來只有BMC顯示, 所以驅動啥的都沒裝, 只有裝ubuntu 26.04.
            各論壇看了看, 鎖定llama.cpp + Qwen3.6-27B-UD-Q8_K_XL.gguf , 然後把相關資料交給gemini cli去安裝, 大概一個小時它就把NVIDIA 驅動,CUDA其他相依軟件及設定搞好, llama.cpp編譯完成, 該避的坑避掉, 模型下載完然後就跑起來了, 全程無干預.
            再來就是跟它花了大概兩個小時測試調整, 主要是一開始的prefill慘不忍睹, 花很多時間在長文本測試優化. 調到一個滿意的設定, 就差不多了, 整個過程還挺順利的.
            底下是我電腦的基本資訊:

            系統與硬體狀態

            • 作業系統: Ubuntu 26.04 LTS
            • CPU: AMD EPYC 7K62
            • RAM: 128GB DDR4
            • GPU 硬體: 2x NVIDIA Tesla V100-SXM2-32GB
            • PCIe 連線: Gen3 x16 (狀態良好)
            • 平均溫度: Idle 35°C / 滿載 ~45°C
            • 功耗限制: 300W

            目前的狀態大概是這樣:

            服務運行狀態

            • 服務名稱: qwen36-llama.service
            • 執行引擎: llama.cpp (CUDA 70架構優化編譯版)
            • 載入模型: Qwen3.6-27B-UD-Q8_K_XL.gguf

            當前模型參數配置 (終極優化版)

            • 總 Context 空間: 524,288 tokens
            • 併發能力 (Parallel): 2 路 (每路 262,144 tokens)
            • KV Cache 精度: q8_0
            • MTP 加速: 啟用 (draft-mtp, 最大預測數: 2)
            • Batching 設定: Batch 1024, UBatch 256

            效能與資源佔用指標

            VRAM 記憶體佔用

            系統已確保 100% 的權重與 KV Cache 駐留於 VRAM 中,完全不依賴系統 RAM 進行 offload,徹底解除 PCIe 頻寬瓶頸。

            • GPU 0 佔用: ~24.3 GB
            • GPU 1 佔用: ~30.3 GB
            • 總計佔用: 54.6 GB
            • 安全餘裕: 剩餘約 9.4 GB,足以應付 Batch 1024 運算時產生的動態 Scratch Buffer 需求。

            推理速度 (實測)

            • Prompt Processing (Prefill): 最高可達 ~611 tokens/second (長文測試)。
            • Generation (Decode): 穩定於 ~40 tokens/second。
            • MTP 接受率: 約 79% ~ 100% (極高效率)。

            以上是Gemini寫的報告, 中間有多次參數設定調整, 比較如下:

            效能測試結果總表

            測試組合 3路 256K (無MTP) 2路 256K (MTP 2) 1路 256K (B256, mtp2) 1路 256K (B512,mtp2) 1路 256K (B1024,mtp2) 2路 256K (B1024,mtp2)
            1. 成功啟動 是 是 是 是 是 是
            2. VRAM Used (GPU0/1) 27.8/31.2 GB 23.7/29.1 GB 19.3/23.8 GB 19.6/24.5 GB 19.9/25.1 GB 24.3/30.3 GB
            3. Prefill (t/s) 90.31 42.02 (短文) 263.93 395.94 611.04 23.01 (短文)
            4. Generation (t/s) 20.87 37.24 46.64 43.09 40.65 40.06
            5. MTP 接受率 N/A 79% 100% 100% 100% 87.5%
            6. 是否 OOM 否 否 否 否 否 否
            7. 數據位置 部分 RAM 部分 RAM 純 VRAM 純 VRAM 純 VRAM 純 VRAM
            8. GPU Power (0/1) 51W/49W 51W/49W ~50W/50W 52W/52W 53W/53W 51W/49W
            9. GPU Temp (0/1) 35°C/35°C 34°C/33°C 35°C/35°C 39°C/40°C 39°C/41°C 34°C/34°C

            定案之後看了一下vram占用狀態跟跑一下benchmark:
            v100_smi_2c_batch1024_ubatch_256_m2.png

            v100_bench_2c_batch1024_ubatch_256_m2.png

            心得:

            1. 一樣是qwen3.6 27B Q8模型, 實際使用速度約比雙spark高出5~10 token/s, prefill速度也還行. 不過雙spark可以容納約15路並行, 這台電腦礙於vram容量, 只能兩路.
            2. 渦輪風扇實在太吵, 必須關到小房間... 早知道不要嫌麻煩買個水冷...
            seabassS
            seabassS
            seabass
            编写于 最后由 编辑
            #5

            @soop-ladios
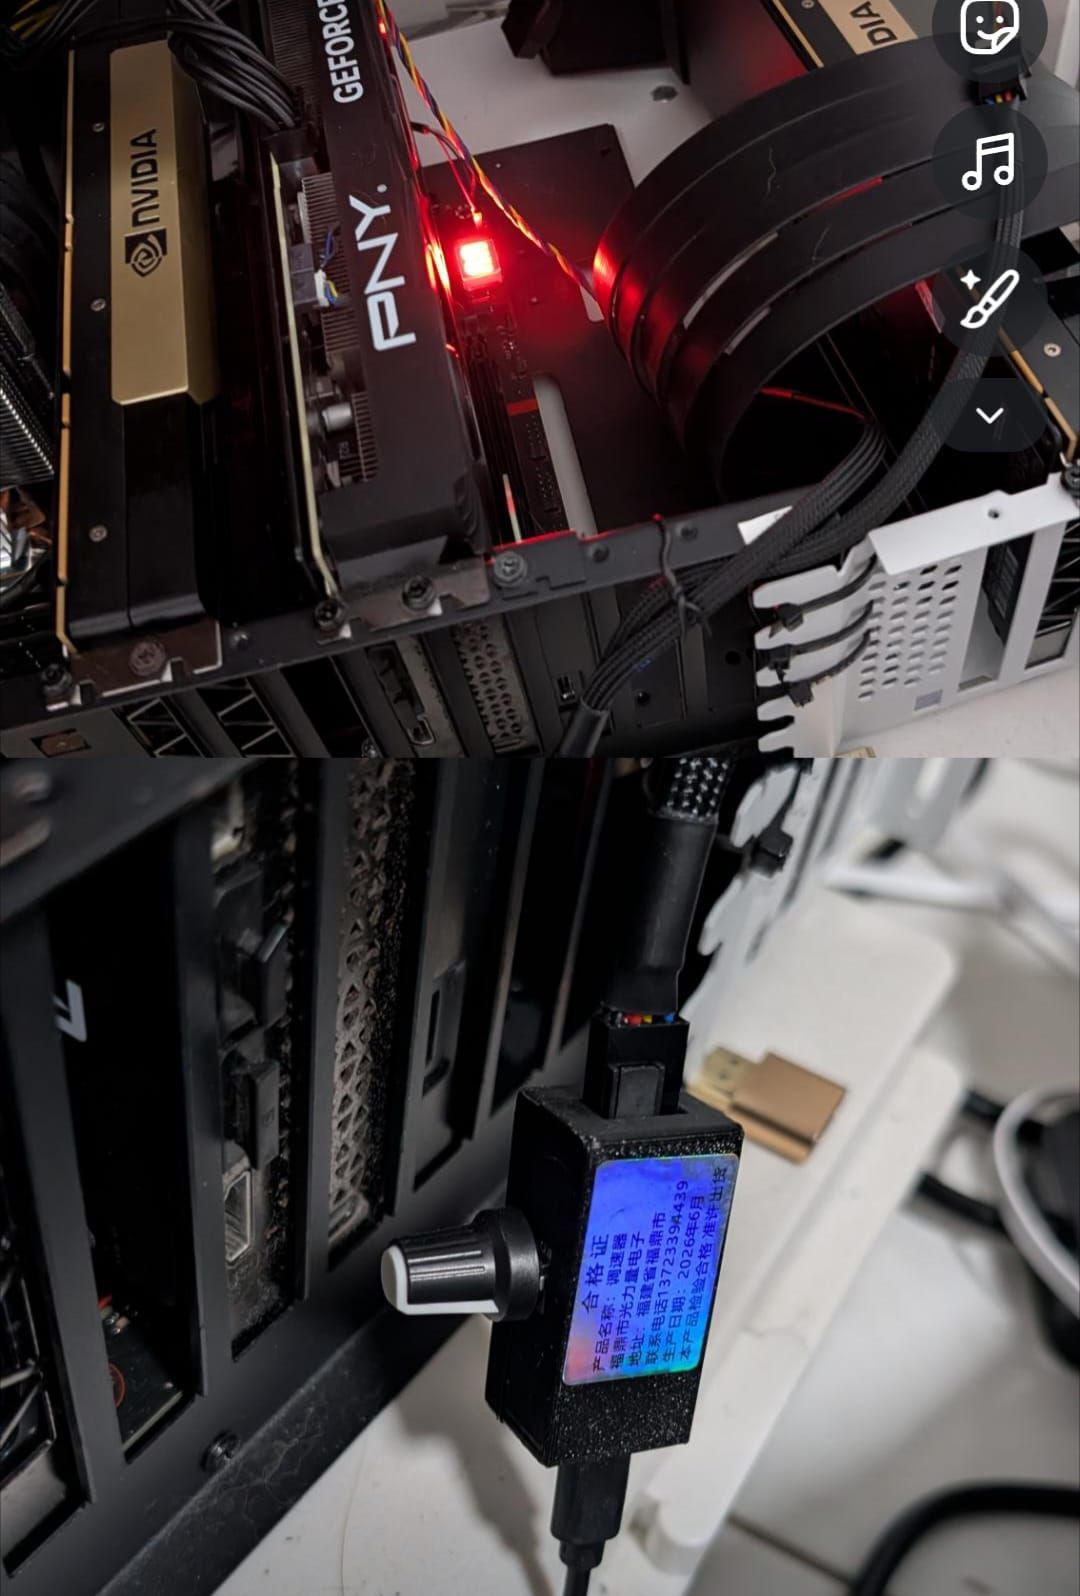
            currentcontrol.jpeg
            自己加了个风扇调速电阻/旋钮,实现手动调速。风扇转速可以自己控制,低速静音,高速加强散热。
            我也有同样的问题,目前先把风扇调到可以接受的噪音水平。

            1 条回复 最后回复
            1
            • soop ladiosS
              soop ladiosS
              soop ladios
              劳动模范 技术大牛
              编写于 最后由 编辑
              #6

              太強了, 我也想弄這個東西, 只是很懶, 又不太會弄..

              seabassS 1 条回复 最后回复
              0
              • soop ladiosS soop ladios

                太強了, 我也想弄這個東西, 只是很懶, 又不太會弄..

                seabassS
                seabassS
                seabass
                编写于 最后由 编辑
                #7

                @soop-ladios
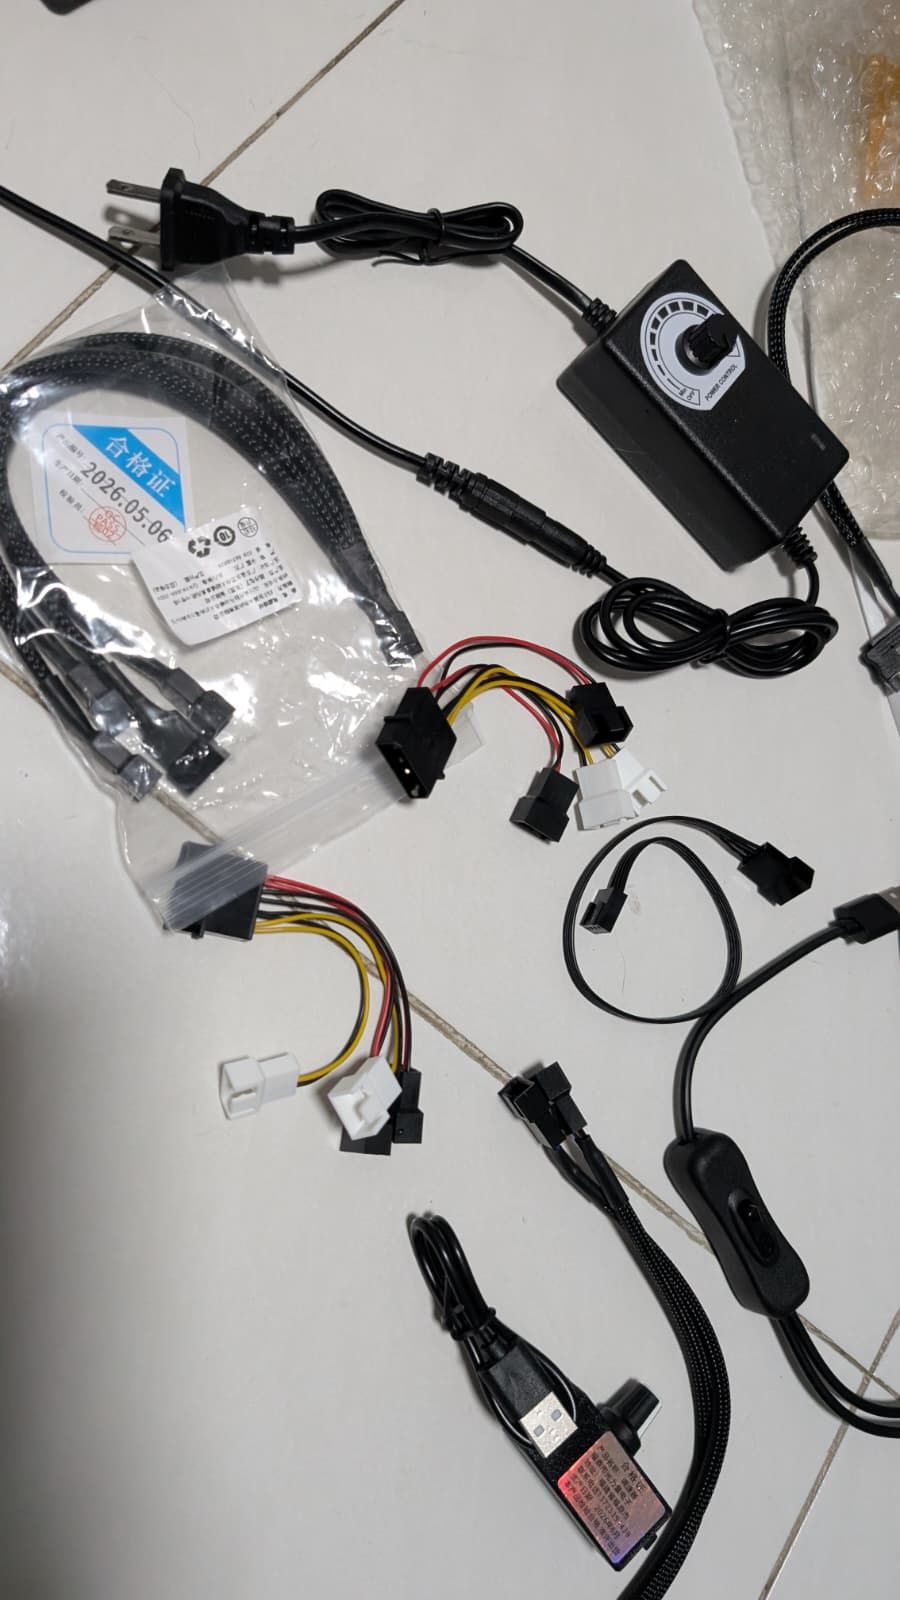
                WhatsApp Image 2026-10-08 at 9.00.21 PM (1).jpeg
                那时候我的 V100 PCIe 还没到,我买了一堆电源相关的东西来试, 我也不知道自己这样弄对不对,不过目前为止,我的 V100 还没有过热。

                soop ladiosS 1 条回复 最后回复
                0
                • seabassS seabass

                  @soop-ladios
                  WhatsApp Image 2026-10-08 at 9.00.21 PM (1).jpeg
                  那时候我的 V100 PCIe 还没到,我买了一堆电源相关的东西来试, 我也不知道自己这样弄对不对,不过目前为止,我的 V100 还没有过热。

                  soop ladiosS
                  soop ladiosS
                  soop ladios
                  劳动模范 技术大牛
                  编写于 最后由 编辑
                  #8

                  @seabass
                  請問你的也是像這種渦輪卡嗎? 是把那條線拔起來再串接那些東西嗎?
                  螢幕擷取畫面 2026-10-08 215401.png
                  螢幕擷取畫面 2026-10-08 215416.png

                  1 条回复 最后回复
                  0
                  • seabassS
                    seabassS
                    seabass
                    编写于 最后由 seabass 编辑
                    #9

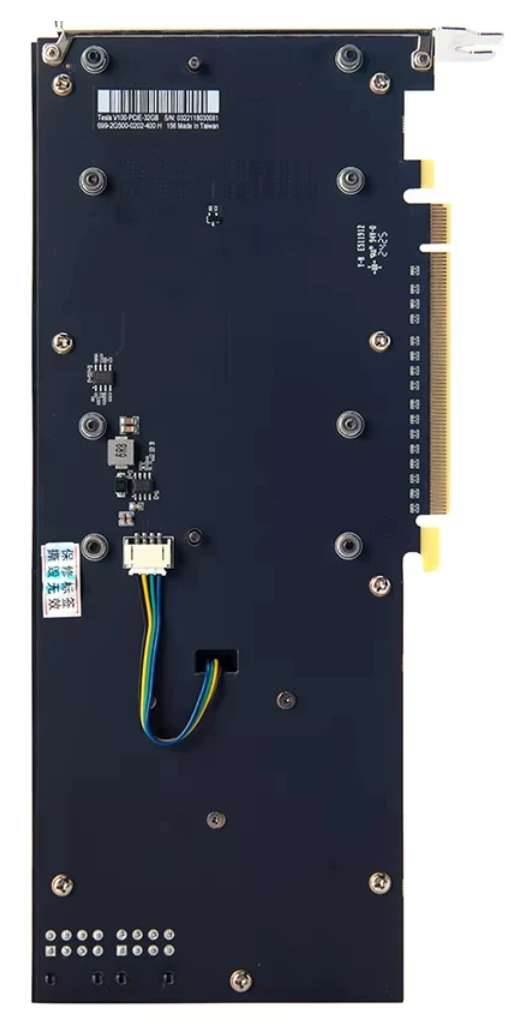
                    @soop-ladios 哎呀,我才发现你的风扇跟我的不一样,你的不是外接式的。应该接风扇,不是接显卡。
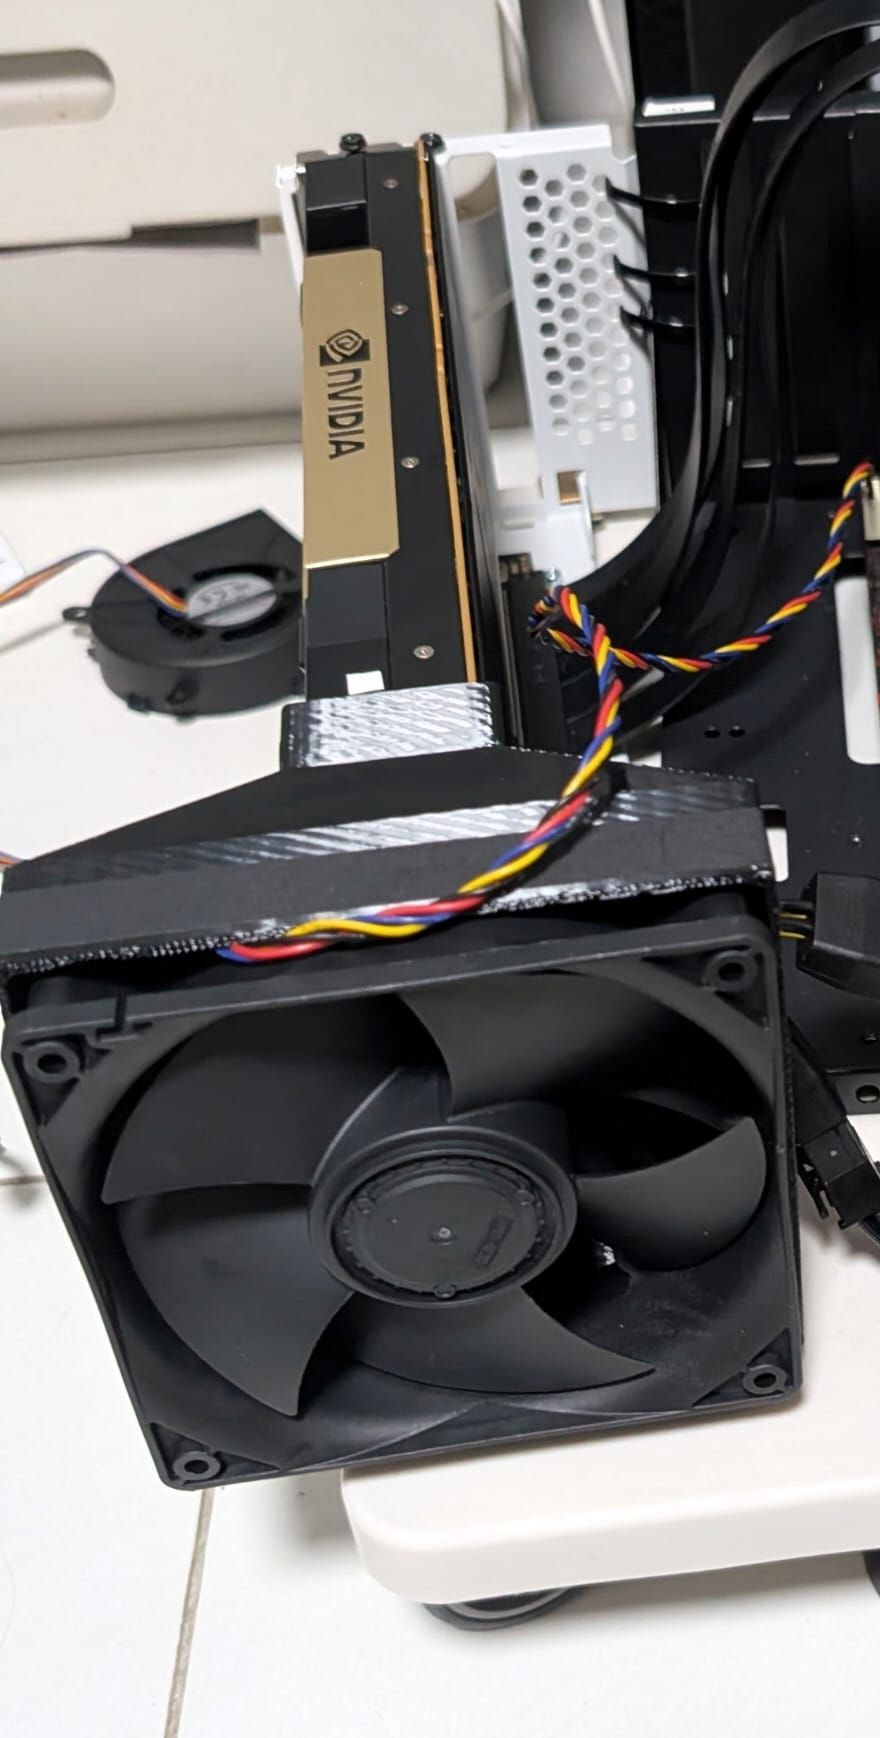
                    gpufan.jpeg

                    soop ladiosS 1 条回复 最后回复
                    0
                    • seabassS seabass

                      @soop-ladios 哎呀,我才发现你的风扇跟我的不一样,你的不是外接式的。应该接风扇,不是接显卡。
                      gpufan.jpeg

                      soop ladiosS
                      soop ladiosS
                      soop ladios
                      劳动模范 技术大牛
                      编写于 最后由 编辑
                      #10

                      @seabass 原來... 我那個渦輪風扇應該是比你這個吵很多..

                      1 条回复 最后回复
                      0

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组