目前也只能这样了。多谢拉
 南
南亚阿东
@南亚阿东
-
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。@Tony-Wang 用途和我差不多,目前主要是搜刮各种网上的知识,总结成知识库
-
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。 -
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。先说下我的情况,
硬件配置:i5 12600kf ,DDR4 16GX4 ,蓝宝石 7900XTX 涡轮版。
想着搭个本地的智能助手。目前成果:┌─ Hermes(大脑/调度)─────── Py3.14.8 · systemd hermes-gateway · 监听 0.0.0.0:8642
│ │
│ ├─ 主脑 → Ollama @127.0.0.1:11434/v1 qwen3.8-27b-iq4xs 100% GPU
│ ├─ 审计 → 同一个 Ollama qwen3-4b-cpu 100% CPU
│ └─ MCP → OpenViking(7工具) + vault-broker(各自 stdio 子进程)
│
└─ 嵌入/检索 ─ OpenViking → bge-m3(GPU,OpenViking 自己在调)
我装了dsh,长链任务全丢出去。
hermes主机,我安装的命令行版的 乌班图 24.04,
后面的,是远程让我另外一台电脑上的dsh(这个dsh后面简称1号),一点点搭起来的。
我让1号总结了群里的经验,他就给我搭了上面这套框架,知识库是我让他安排这个的。
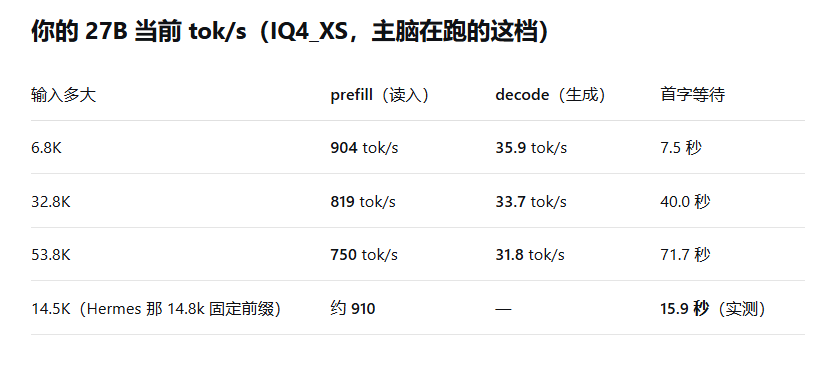
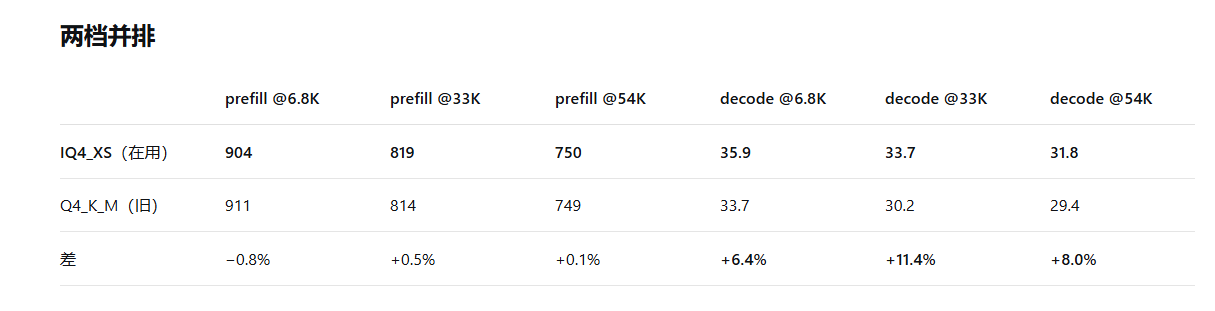
今天搭完,测试了下吞吐量,才30 tok/s 左右,我说学学群里其他的框架,他说都不适合我。我都无语了。
难道,我这台电脑,只能这样了吗?
另外,审计小模型,还有接入微信企业版以后,发图片识别的模型,都没法让GPU 来弄,塞 cpu 里,感觉能力不够。 -
3090显卡纯本地+Carnice v2 mtp: 驱动Hermes,算是进入这个时代了。 -
你们Hermes 接入Agnes模型没有?不要钱跑Hermes的话,日常操作用Qwen3.6-35B越狱版模型就很香,量化版本可以放在8g,12g的卡上跑,但是量化版本越低,智力越差,我3060 12g,跑Qwen3.6-35B-A3B-Uncensored-HauhauCS-Aggressive-Q4_K_M(19.7g)这个版本还是没问题的,用着不卡,智力还行,日常操作没问题,主要是100%越狱,所有敏感测试全部通过,可以做任何事;
做有难度的任务还是用codex上gpt5.5吧,或者换成v4pro内核也行
大佬,我目前的配模型,基本按你的逻辑的,就是没完全配好模型,v4 flash兜底模型,深度思考还没想好用啥,v4 pro 好像不咋聪明。