

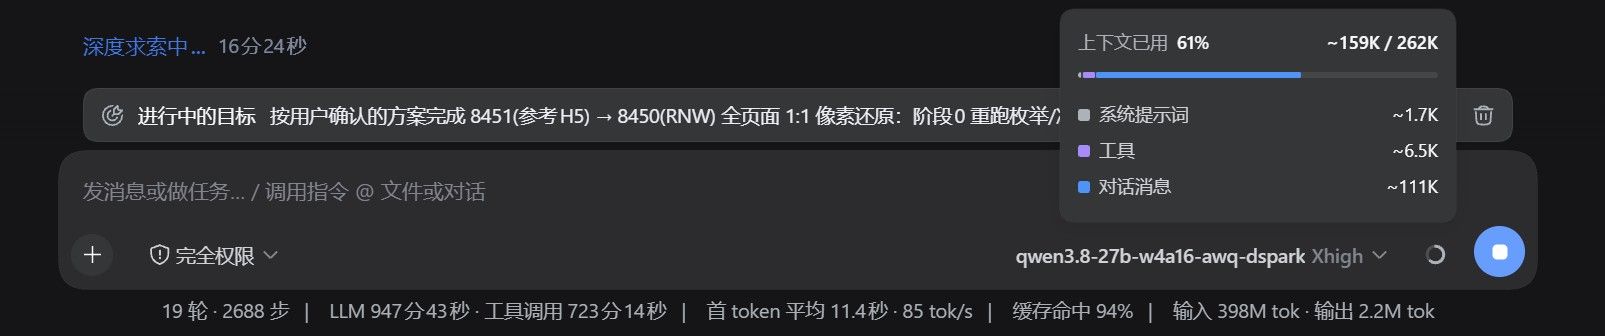
从dflash2换到dspark,代码的质量感觉上了一个台阶。
速度从110 t/s 掉到平均 85 t/s 还是可以的,任务量不小,一直在跟踪进度,react 转 react native web。
-
qwen3.8-27b-w4a16-awq 已经持续跑了15个小时了 -
4090 48GB SGlang+DFlash2 平均 110 tok/s 27B W4A16-AWQ这个速度还有没有提升空间了?同配置同模型下,还有更高的token速度吗?请晒出参数,学习一下。
配置:4090 魔改48GB 64GB内存
SGlang版本:0.5.19.dev20260825+g1fa32d50e1
实测DSH,长时间多轮写码 平均 110 tok/s
参数:
│ --model-path /home/root1/code/llm/sglang/models/Qwen3.8-27B-W4A16-AWQ
│ --served-model-name qwen3.8-27b-w4a16-awq-dflash2
│ --speculative-algorithm DFLASH
│ --speculative-draft-model-path /home/root1/code/llm/sglang/models/Qwen3.8-27B-DFlash2
│ --speculative-num-draft-tokens 8
│ --speculative-draft-model-quantization unquant
│ --default-chat-template-kwargs {"reasoning_effort":"medium"}
│ --attention-backend flashinfer(主模型)
│ --speculative-draft-attention-backend triton(草稿,滑窗)
│ --linear-attn-backend triton(GDN/mamba 层)
│ --context-length 250000
│ --kv-cache-dtype fp8_e4m3
│ --mem-fraction-static 0.75
│ --max-total-tokens 240000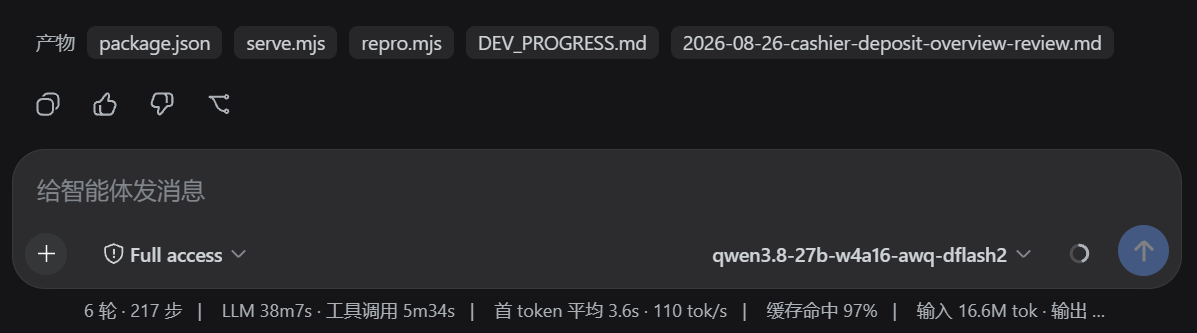
-
4090 48GB SGlang+DFlash2 平均 110 tok/s 27B W4A16-AWQ -
M5 Max/Ultral AI性能强悍?苹果、AMD、英伟达AI小主机AI性能全面分析,潜力很大但统一内存并非万能! -
Qwen releases Qwen3.8-Flash-Next! 來了 -
NInfer-4090 V3:单路218.7/多路348.5 tok/s@_折騰_ 修正下,按照大佬的配置部署好了,我的4090 48G,水冷的卡,2周前看 @terry 版主的youtube推荐,立刻就在京东找了个商家买了,用起来很爽,感谢两位大佬。
汇报下,目前按照 https://github.com/zheteng-v/ninfer-4090 的方法,部署成功了,我自己用token-speed-tester,只跑了一轮的测试,峰值150t/s左右,平均125t/s,用dsh,能保持在120t/s左右,不知道哪里设置不对,不过已经用起来很爽了,感谢两位大佬
贴一下我的启动参数,我要的是256k上下文:
cd ~/ninfer-4090终止所有使用显卡的残留进程(ninfer、python 等)
fuser -v /dev/nvidia* -k 2>/dev/null
确保旧的 ninfer 进程完全退出
pkill -9 -f "ninfer-serve"
./build/apps/ninfer-serve
~/models/Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-DFlash2-ninfer-v3.ninfer
--host 0.0.0.0
--port 30000
--max-context 262144
--host-kv-mib 40960
--host-state-slots 4
--max-concurrency 1
--max-pending-requests 10
--prefill-chunk 2048
--kv-dtype fp8
--spec dflash2
--draft-tokens 7刚开始接触本地部署,这次买的配置是4090 48g,128g内存,u7,pcie 5的双槽,计划留一个给未来加一张卡,主要是跑minimax H3,然后发现本地部署qwen 3.8 27b,也很爽。
目前除了在论坛学习,主要是跟着gemini弄,初来乍到,多向各位大佬请教,祝论坛越来越好!
如果参数没问题,可能是硬件差异有关,试试8K短码结果,如果速度能大于170k+基本可以肯定是硬件差异。不只是来自于相同显卡,CPU,内存频率也有关系。配置更好的也许跑出的速度比我更快。
-
NInfer-4090 V3:单路218.7/多路348.5 tok/s -
4090 48GB SGlang+DFlash2 平均 110 tok/s 27B W4A16-AWQ -
NInfer-4090 V3:单路218.7/多路348.5 tok/s这是 NInfer 在 48GB RTX 4090(sm_89)上的下游版本,主要围绕 Qwen3.8-27B 做原生 Linux 推理。V3 已从旧的 V2 artifact 和运行时切换到 artifact v3 与绑定实例的 Engine;模型加载、服务和推理走同一套 C++/CUDA 路径,不需要 Docker。
V3 做了什么
- 更新到 v3 权重容器和新的 Engine 绑定方式,保留 V2 作为可回退版本。
- 完成 64K 到模型原生长上下文范围的正确性验证;64K NIAH(大海捞针)结果与 oracle 一致。
- 支持持久会话、Vision 图像/视频输入,以及 OpenAI 和 Anthropic 风格的服务接口。
- 针对 RTX 4090 调整了小批量 Q4/Q5 投影的 T=8 路由,包括 GDN 投影、attention Q5 投影和 SwiGLU 路径。
- 所有速度测试均使用 INT8 或更高精度的 KV cache;没有用降低 KV 精度换速度。
实测数据
短码单请求测试使用 V3 artifact、8K 上下文、INT8 KV、固定代码任务、4096 个输出 token。当前最快的实测配置是 DFlash2 K=7:
配置 解码速度 每轮设备时间 接受率 V3 DFlash2 K=7 213.17 tok/s 24.203 ms 59.56% V3 MTP3(同一二进制、同一任务) 147.56 tok/s 22.843 ms 79.10% 保存的 V2 短码基线为 153.67 tok/s,使用的是 MTP3。213.17 tok/s 相对它高约 38.7%,但这是 V3 DFlash2 K=7 对 V2 MTP3 的跨后端比较,不是同配置的版本 A/B。相同的 64K NIAH 测试中,V2/V3 prefill 分别为 1884.70/1884.52 tok/s,decode 分别为 149.59/149.44 tok/s,长上下文表现基本持平。
并发测试是另一种口径:DFlash2 K=7 的 C2/C4/C8 聚合吞吐分别为 125.7/218.7/348.5 tok/s。它表示多路请求的总吞吐,不代表单个请求能达到这些速度。
算子测试也有改善,例如 T=8 attention Q5 gate/value 投影从 57.344 µs 降到 39.936 µs,GDN QK Q4 投影从 35.840 µs 降到 31.744 µs。这些是单算子结果,不能直接当成端到端提速比例。
快速启动
在仓库根目录执行。下载脚本会校验官方 V3 artifact 的 SHA-256:
NINFER_MODEL_DIR="$PWD/models" bash scripts/download-qwen38.sh
cmake -S . -B build -DCMAKE_BUILD_TYPE=Release -DCMAKE_CUDA_ARCHITECTURES=89
cmake --build build -j
短上下文、偏重解码速度时,可从这组已测参数开始:
./build/apps/ninfer-serve models/qwen3_8_27b.ninfer \
  --host 127.0.0.1 --port 8080 \
  --max-context 8192 --kv-capacity 8192 \
  --max-concurrency 1 --prefill-chunk 1024 --kv-dtype int8 \
  --spec dflash2 --draft-tokens 7 --lm-head-draft
服务启动后,可以用下面的请求试一下:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen3.8-27b","messages":[{"role":"user","content":"用一句话介绍 CUDA Graph。"}],"max_tokens":128}'
首次启动需要生成 CUDA Graph,冷启动可能需要几分钟;这是一次性准备时间,不计入上面的稳态解码速度。若需要长上下文,可把
--max-context和--kv-capacity调高,并按显存余量选择并发数;KV 精度保持int8或更高。相关链接