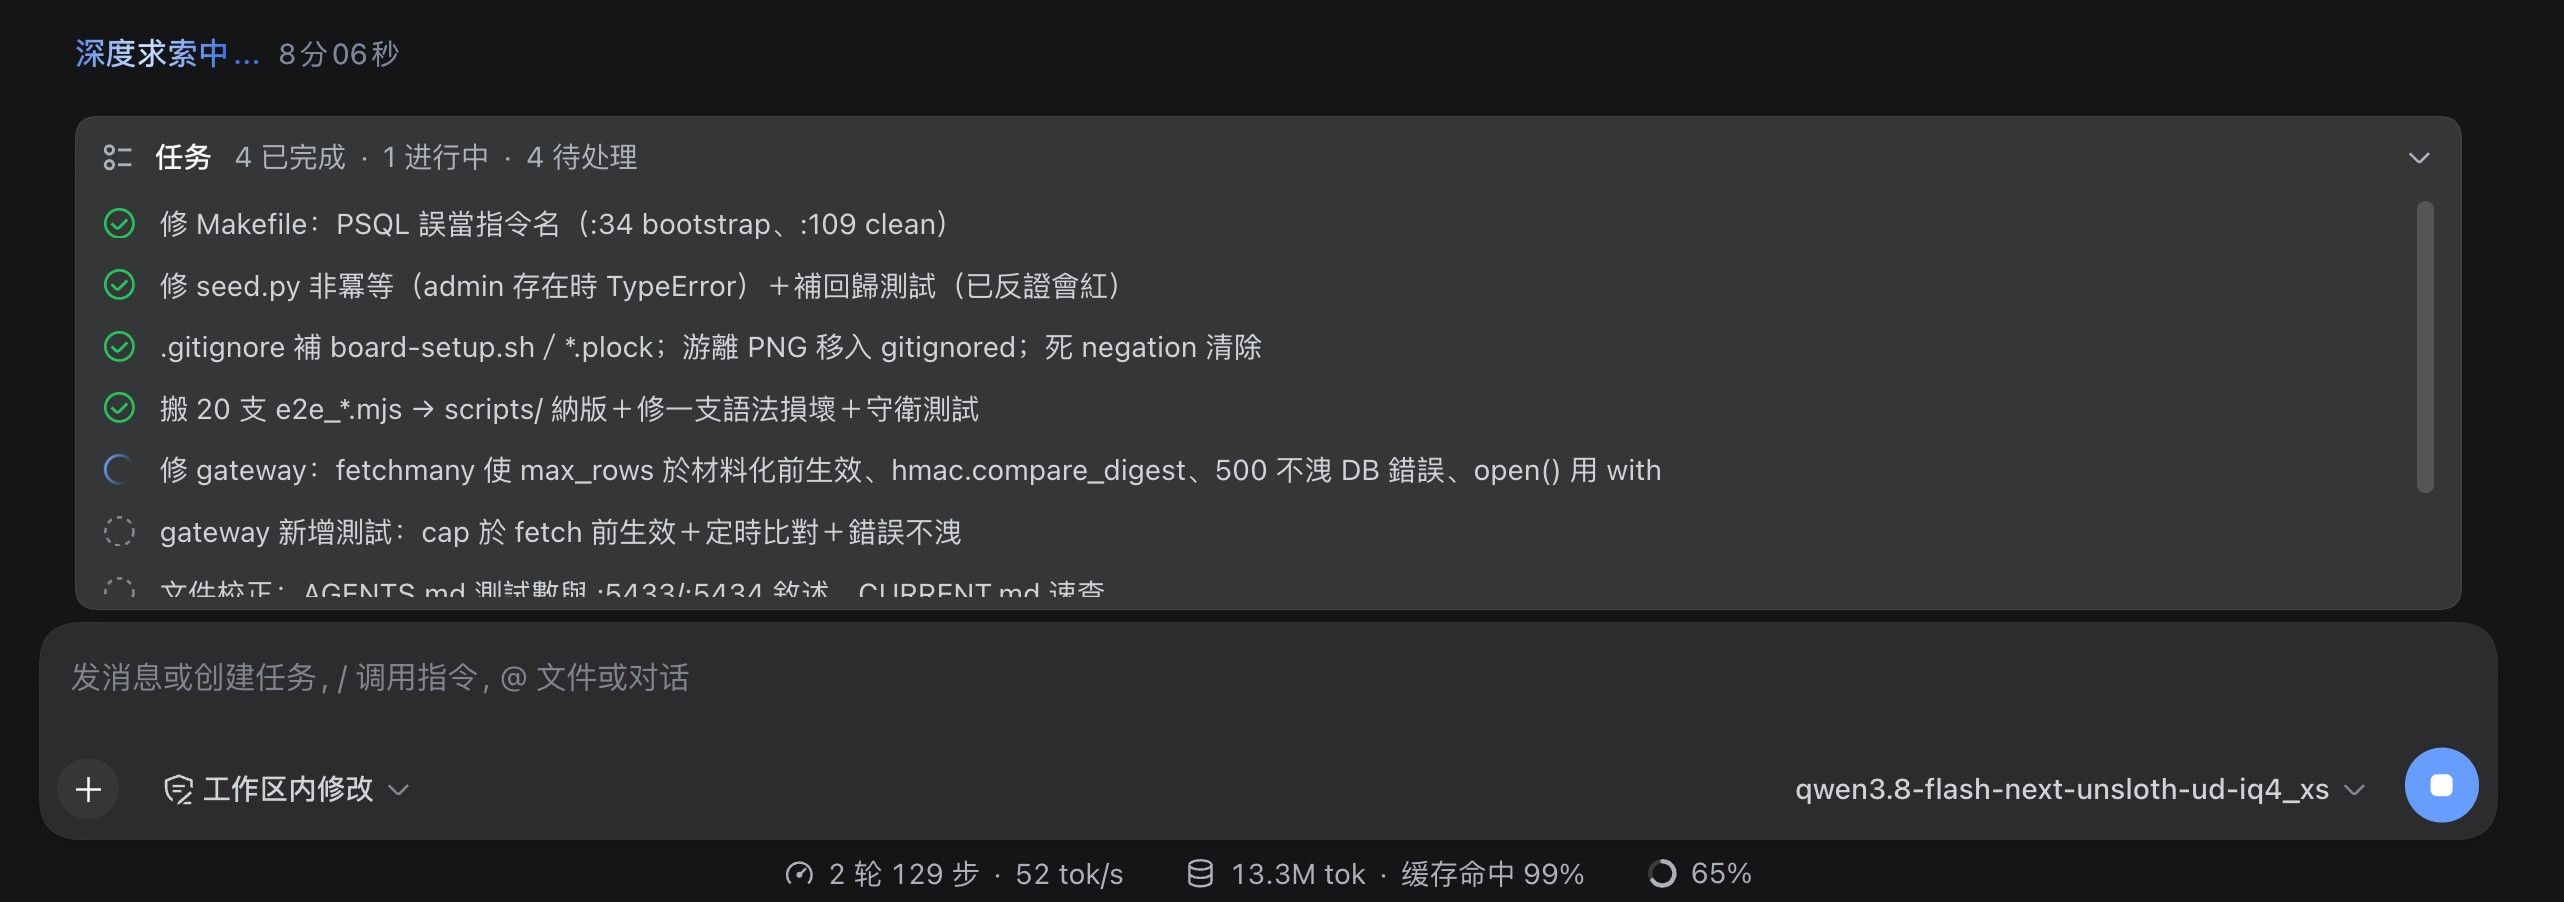
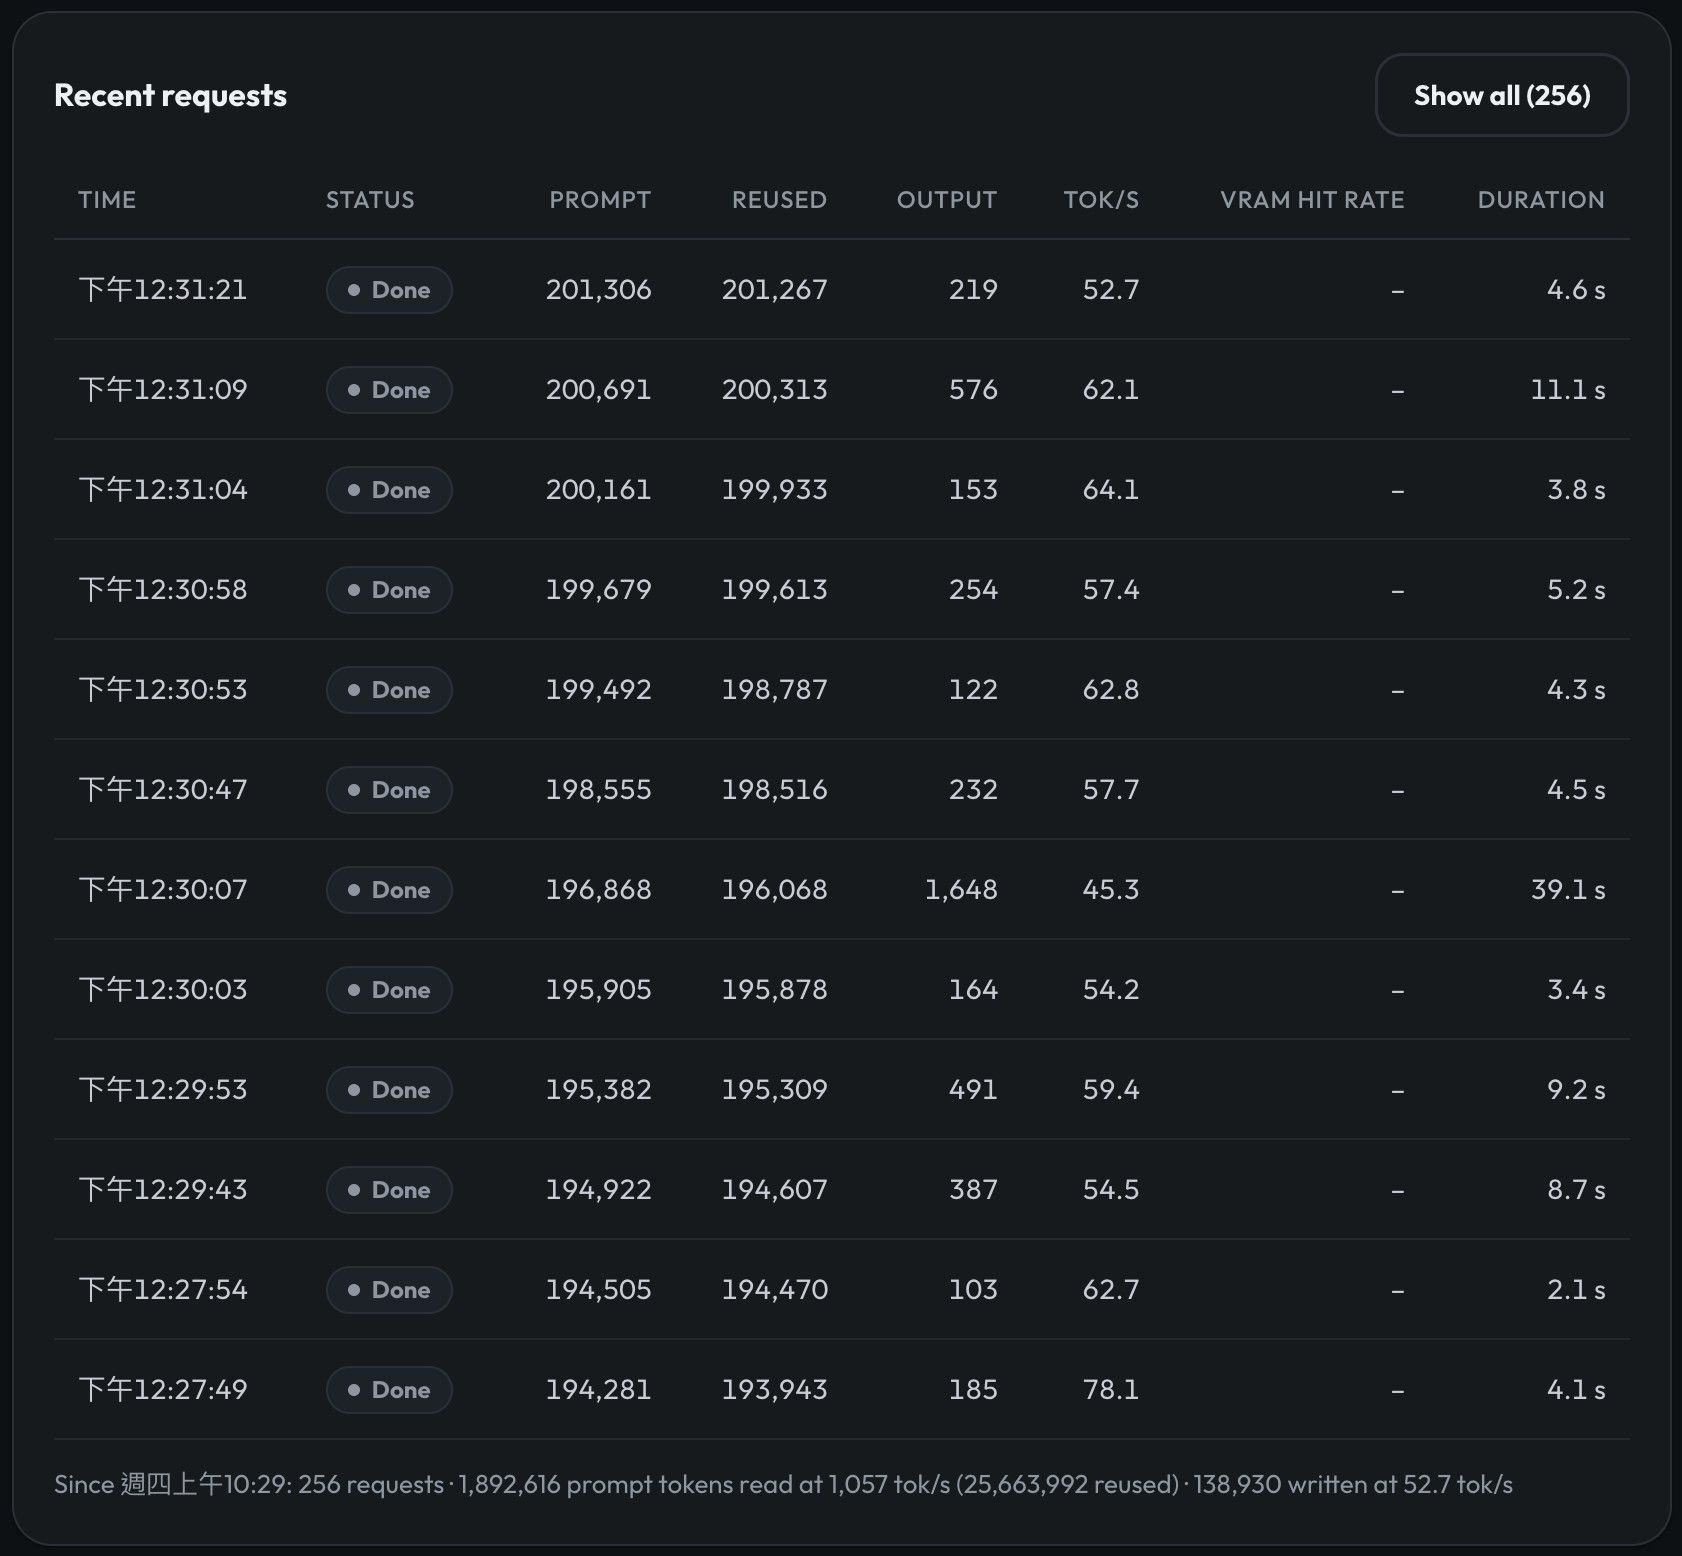
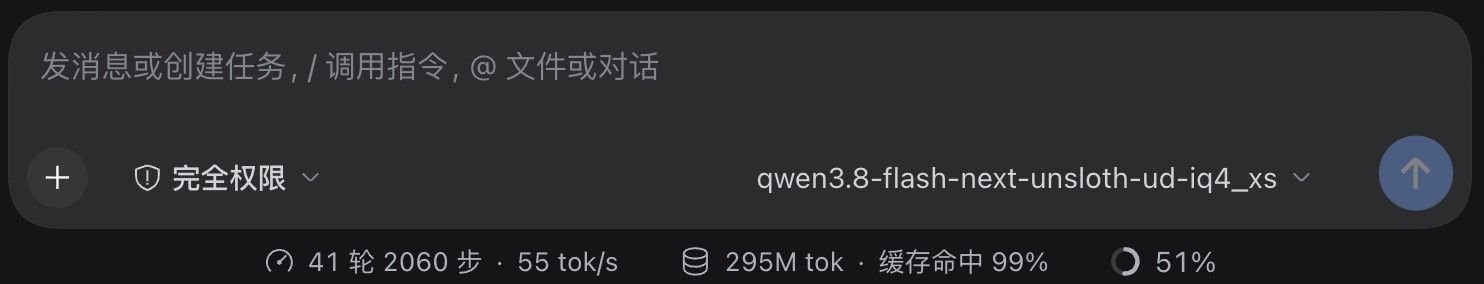
在 DeepSeek Harness 下,持續在同一個 session 進行開發,41 輪對話,過程讓他自動 compact,快 3 億 tokens,平均生成速度 55 tokens/s。
比之前在同一台機器用 Qwen3.8 27B 感受好太多了。
 A
這是在設備上使用 Pi Agent + Qwen3.8-Flash-Next UD-IQ4_XS 讓他調校自己的結果,以下是他整理的重點記錄。
機器 Ryzen AI Max+ 395(gfx1151,128 GB 統一記憶體)
模型 Qwen3.8-Flash-Next UD-IQ4_XS(Unsloth Dynamic,55.43 GiB expert / 24576 個)
環境 ROCm 7.2.4 / hipBLASLt 1.2.2 / Strata engine 0.1.40 / 256K context
只比「大段 prompt 冷讀」(≥20000 個新讀入 token):
| 階段 | prompt | 生成 |
|---|---|---|
| 預設安裝 | 382 tok/s(9 樣本,359–393) | 45.8 tok/s(268 樣本) |
| 加 hipBLASLt 調校表 | 687 tok/s(3 樣本,660–773) | 48 tok/s |
| 最終配置 | 1246 tok/s(7 樣本,1238–1299) | 52.0 tok/s(133 樣本) |
prompt +226%(3.26 倍)· 生成 +13.7%
21 萬 token 的冷讀:9.2 分鐘 → 2.8 分鐘
gfx1151 上 hipBLASLt 自行挑選 GEMM kernel 的表現很差。tools/hip/tune_hipblaslt 把 90 個真實 GEMM 尺寸逐一跑完所有候選 solution,量出最快者寫成一張表。空載跑一次,幾分鐘。
版本碼必須完全相符。 表頭綁 架構 + hipBLASLt 版本碼,引擎是嚴格比對(if (version != expected_version) 直接拒絕)。倉裡附的 gfx1151 表是 100401(ROCm 7.14.1),ROCm 7.2.4 是 100202 → 必須自己校正,沒有公版可沿用。solution ID 在版本之間也不相通。
cmake --build build --target tune_hipblaslt -j 8
./build/bin/tune_hipblaslt --pack <pack> --arch gfx1151 \
    --output tools/hip/gfx1151-hipblaslt-100202.txt
# 然後 env.STRATA_HIPBLASLT_TUNING 指向該檔
啟動日誌會回報 hipBLASLt tuning enabled (90 rows, gfx1151, version 100202)。
來自 docs/STRIX_HALO.md §5/§6:
--prefill 16384      --lookup-chain 3      --mtp-q4 all      --mtp-window 8192
env: STRATA_PF_FUSED=1  STRATA_PF_GEMM=1   STRATA_HC_UPMIX=1  STRATA_PA_FAST=1
     STRATA_HIP_WMMA=1 STRATA_SELECT_WMMA=1 STRATA_HC_Q8=1    STRATA_PF_SWITCH_MIN_T=4096
--prefill 從 auto(上限 8192)放寬到 16384,讓長 prompt 少切一半的塊。
 ️ 這 7 個環境開關會改輸出 token(加總順序 / FP16 中間值),不同於 §4 那 18 個 byte-identical 的預設開關。需要逐字可重現輸出的人不要開。
額度公式 MemAvailable − 6 GiB,要 ≥ 55.43 GiB 才裝得下全部 expert。裝不下就會每次請求都從 SSD 讀 expert,所有調校收益直接轉負。
每次重啟後確認這行:
expert cache 24576 slots, 55.43 GiB — all experts resident
這條因果鏈是:可用 RAM → expert cache 額度 → SSD 讀取量 → 速度。在統一記憶體的機器上,任何吃 RAM 的設定都要單獨測。
hip_vision() 在 AMD 上一律回 cpu(gpu / yes 會直接關閉)。自己抓 mmproj(0.85 GiB / 449M 參數 / 27 層 ViT)、自己編 strata-vision。
max_tokens 1024 = 有效解析度 1344×768--expert-cache auto --prefill 16384 --spec 4 --spec-min-p 0.5
--mtp <mtp/rt> --max-context 262144 --kv int8 --kv-resident 32768
--lookup-chain 3 --mtp-q4 all --mtp-window 8192
--vision --vram-reserve-mib 700
env STRATA_HIPBLASLT_TUNING = <自校 90 列表>
STRATA_PF_FUSED / PF_GEMM / HC_UPMIX / PA_FAST
HIP_WMMA / SELECT_WMMA / HC_Q8 = 1
STRATA_PF_SWITCH_MIN_T = 4096
vision max_tokens 1024 · threads 24 · gpu false
一句話:在 Strix Halo 上,最大的槓桿不是模型或量化,是「hipBLASLt 要自己校正」加上「別把 expert cache 的記憶體擠掉」。前者給你 3 倍,後者決定那 3 倍還在不在。