最近把 Strata 接到 Hermes Agent,作為本地模型後端,已經用了一兩天。想分享一下目前的配置和使用感受,給同樣想用手上的舊硬體跑大型 MoE 模型的人參考。
先說結論:以我目前的用途來說,體驗滿好的。
我的工作負載主要是:
- 作為 Hermes Agent 的主模型 Provider
- 文件閱讀、整理與分析
- 資料整理與產出
- 一般需要呼叫工具的 Agent 任務
- 長 Context 文件處理
我沒有拿它大量寫程式,也沒有特別追求最高 TPS。因此,這篇主要是日常使用分享,並不是標準 Benchmark。
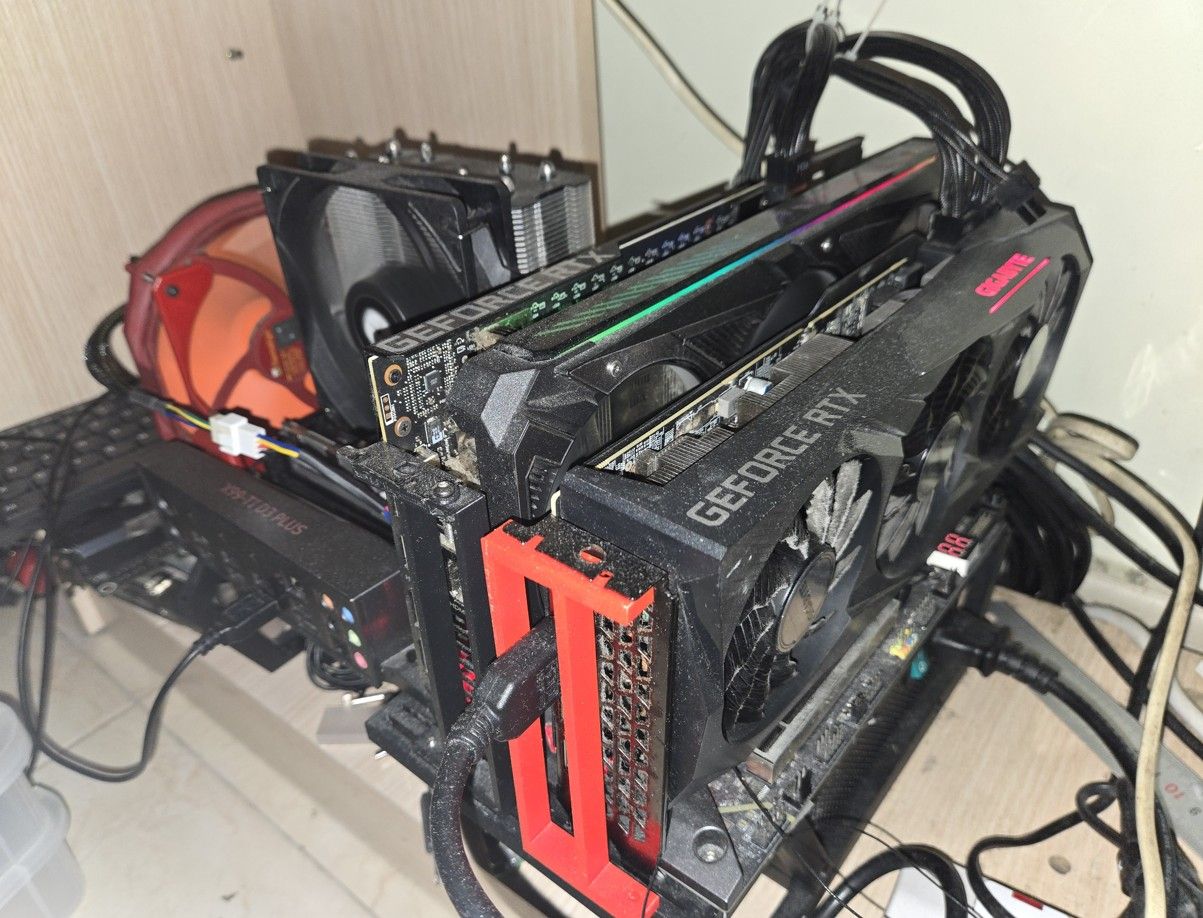
機器的近照( 丟桌子底下)
| 硬體 | 配置 |
|---|---|
| GPU 1 | NVIDIA GeForce RTX 3070 8GB |
| GPU 2 | NVIDIA GeForce RTX 3060 12GB |
| CPU | Intel Xeon E5-2673 v3 @ 2.40GHz |
| RAM | 64GB |
| OS | Linux |
兩張顯示卡都是以前的電腦退役後留下來的。(一張是純遊戲卡,另一張是我妹妹電腦換下來)
要新組一台專門跑 LLM 的機器,我個人會比較傾向選擇單張 VRAM 更大、架構更新的 GPU。
Strata 會把常用的 experts 快取到 VRAM,其餘部分由 RAM/CPU 處理。VRAM 越大,理論上就能讓更多 experts 留在 GPU,減少部分 CPU/PCIe 資料傳輸。
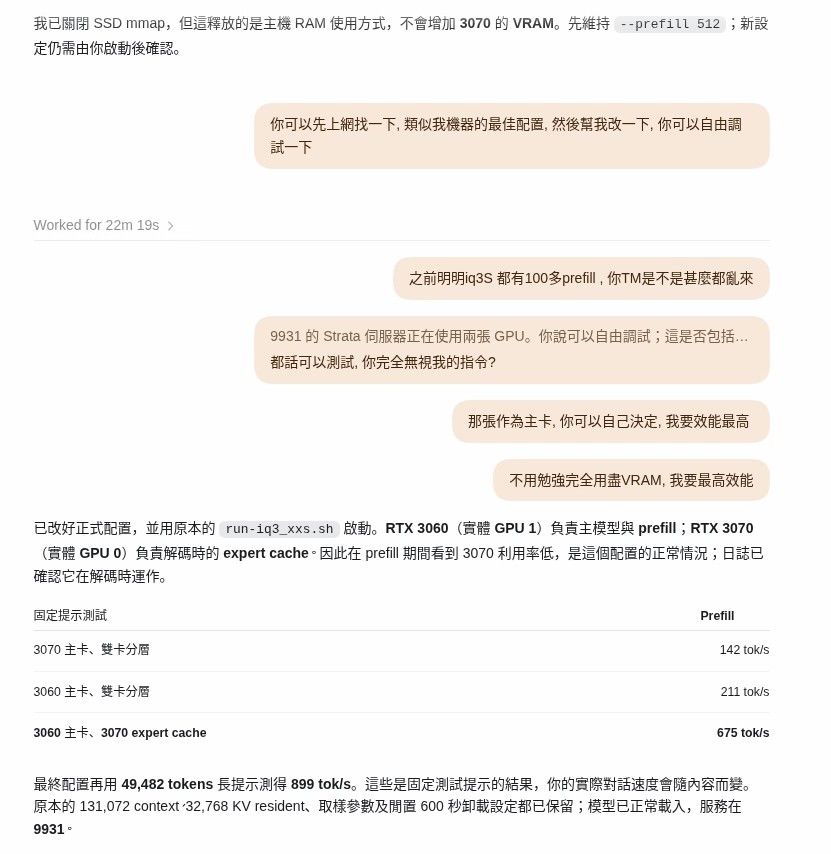
雖然 Strata 已經支援 Multi-GPU layer split,但 GPU 之間仍有階段交接的成本。所以,兩張卡加起來有 20GB VRAM,並不代表效能就會等同於一張 20GB 的卡。相關設計可以參考官方 Multi-GPU 文件。
使用的模型
目前使用的是:
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S
模型來源是 ISTA-DASLab / Qwen3.8-Flash-Next-GSQ-RCO-GGUF。
這是一個有 512 個 routed experts、每個 Token 啟用其中 10 個的 MoE 模型。
ISTA-DASLab 提供的 IQ3_S 版本平均約 3.50 bpw,完整下載約 83.6GB
主要設定如下:
Quantization: IQ3_S
Context: 131072
KV Cache: q4_0
KV Resident: 32768
Expert Cache: auto
Prefill: 1024
Speculation: 4
Spec min-p: 0.5
MTP: enabled
Vision: enabled
GPU: RTX 3070 + RTX 3060
VRAM reserve: 700 MiB
實際表現
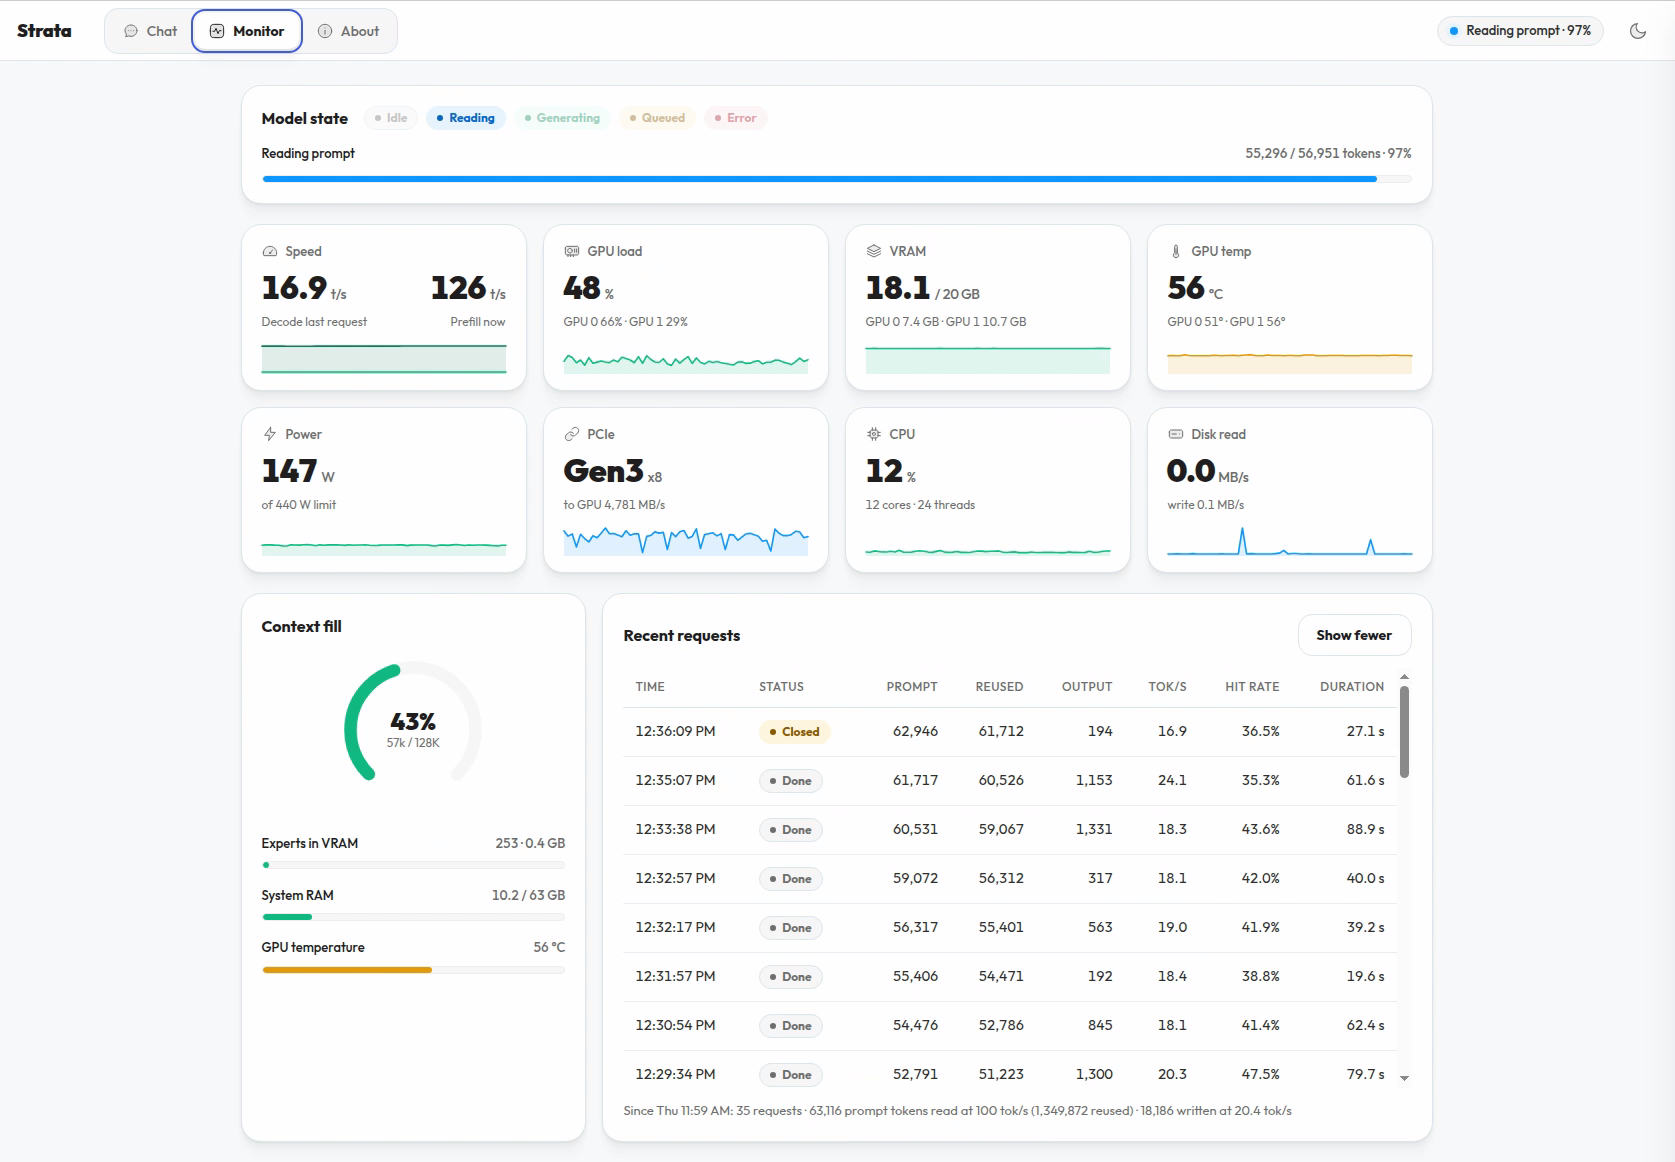
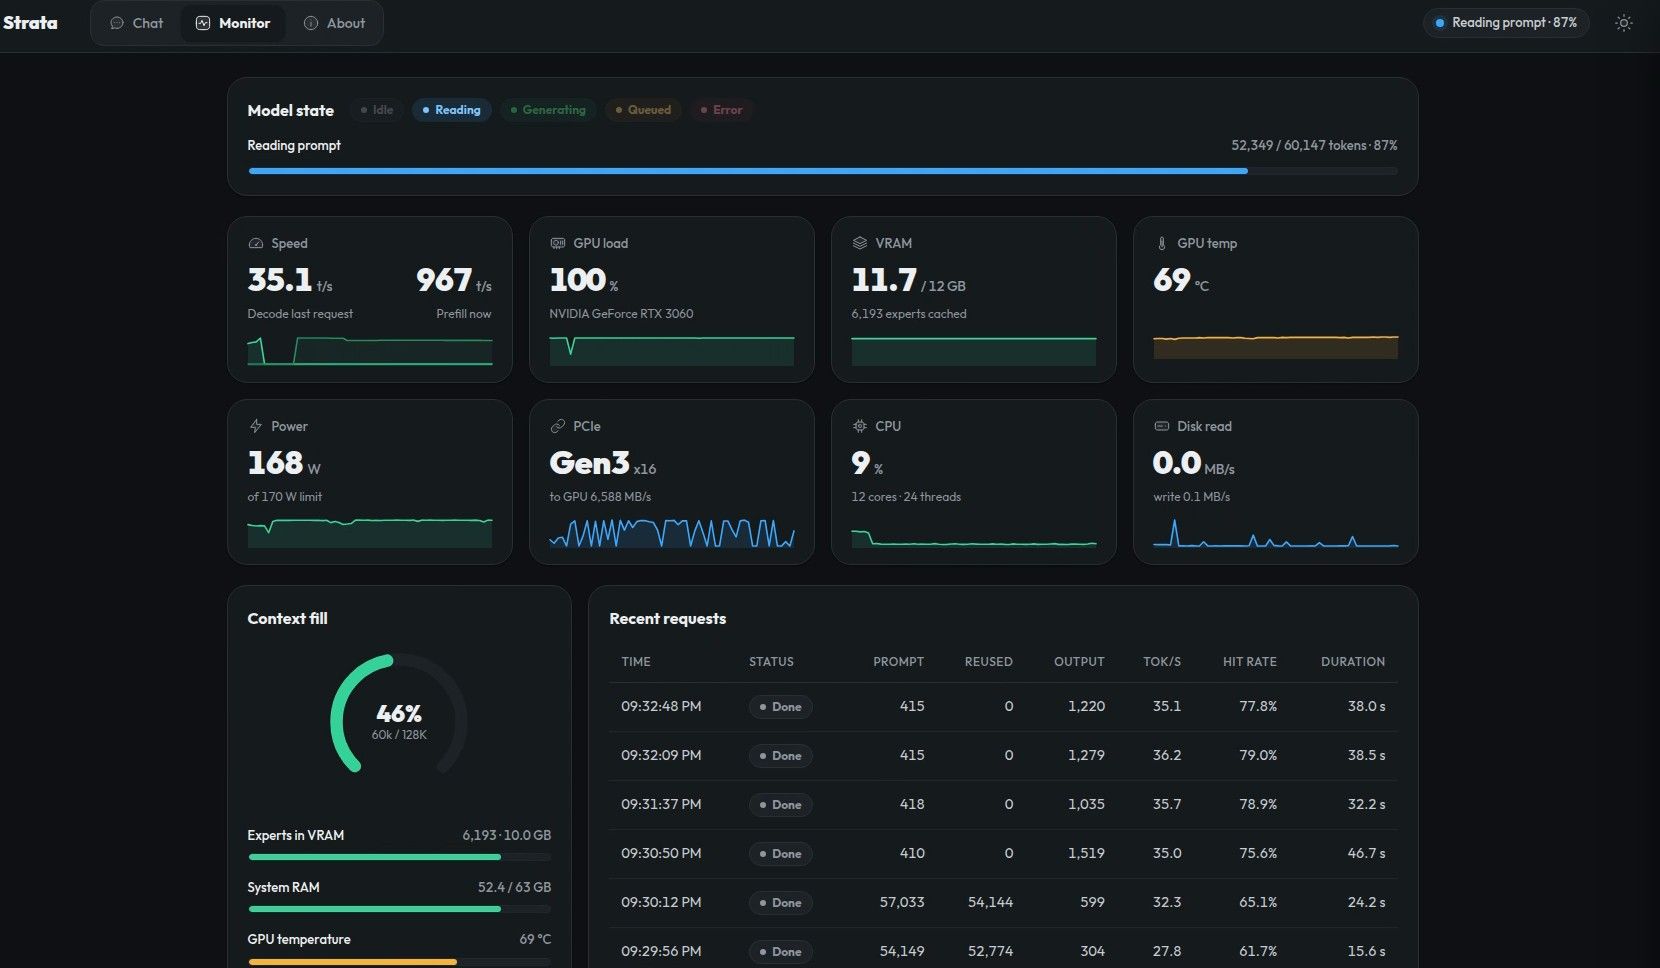
截圖是在 Hermes Agent 已經進行了一段長 Context 對話之後拍的,當時的狀態大約是:
Context 使用量:約 57K / 128K
VRAM:約 18.1 / 20GB
GPU 0:約 7.4GB
GPU 1:約 10.7GB
RAM:約 10GB / 63GB
最近幾次請求,Decode 速度大約落在 18~24 tokens/s。
截圖當下則是:
Decode:16.9 tok/s
Prompt reading:約 126 tok/s
當時 Context 已经累積到五、六萬 Token,而且是接在 Hermes Agent 上實際處理任務。以這樣的使用情境來說,這個速度對我而言已經可以接受。
用起來的感受
如果問我能不能拿它當 Agent 的主模型,我目前的答案是:可以,至少我的工作內容用起來沒什麼大問題。
平常的任務大致是:
讀取文件 → 整理與分析 → 產生資料 → 呼叫工具 → 整理結果
這台洋垃,加上兩張從舊電腦留下來的 RTX 3070 和 RTX 3060,現在能繼續當 Hermes Agent 的 128K 本地模型 Provider,幫我處理日常文件和資料任務。
能把原本閒置的硬體重新用起來,而且用得還挺順,對我來說就已經很值得了。
順手給一下json 給大家參考 (配置文件皆由codex 生成,我本人沒有動手調整過。 )
strata-iq3_s-hermes-dual-gpu.json