跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
Chu Hao-LungC

Chu Hao-Lung

@Chu Hao-Lung
体面乡绅
取消关注 关注
关于
帖子
33
主题
2
分享
0
群组
1
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 4× RTX PRO 6000 Blackwell Max Q
    Chu Hao-LungC Chu Hao-Lung
    装备秀 rtxpro6000 多卡部署

    最近終於把這台四卡 AI 工作站弄得差不多。

    一開始其實只是想組一台可以舒服跑 ComfyUI 跟本地 LLM 的機器,後來一路升級,最後乾脆直接上 WRX90 + Threadripper PRO,目標就是四張 RTX PRO 6000 Blackwell。中間踩了不少坑,弄了一台外星人,發現他並不適合upgrade 成多GPU的電腦,RAM的上限也有限。

    目前配置大概是這樣:

    配件 型號
    CPU AMD Ryzen Threadripper PRO 9975WX
    主板 ASUS Pro WS WRX90E-SAGE SE
    RAM 256GB DDR5 ECC RDIMM
    GPU 4× NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB
    總顯存 384GB
    SSD 3× Samsung 990 PRO 4TB
    PSU Thermaltake Toughpower i1650W ATX 3.1
    機箱 Cooler Master HAF 700 EVO
    系統 Windows + Ubuntu Dual Boot

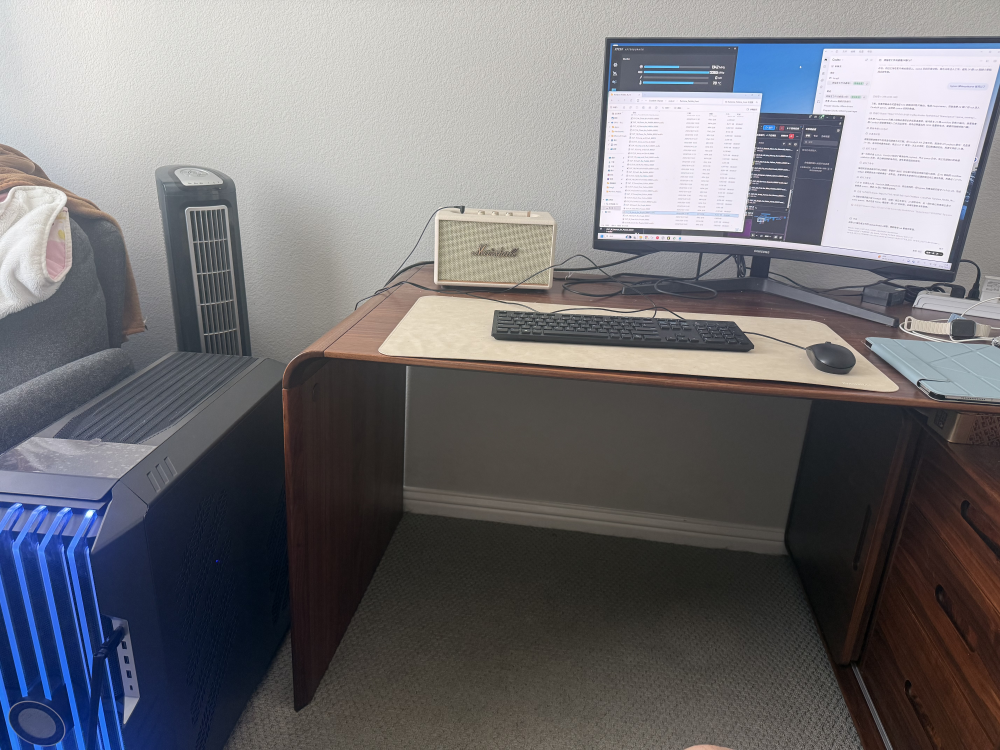
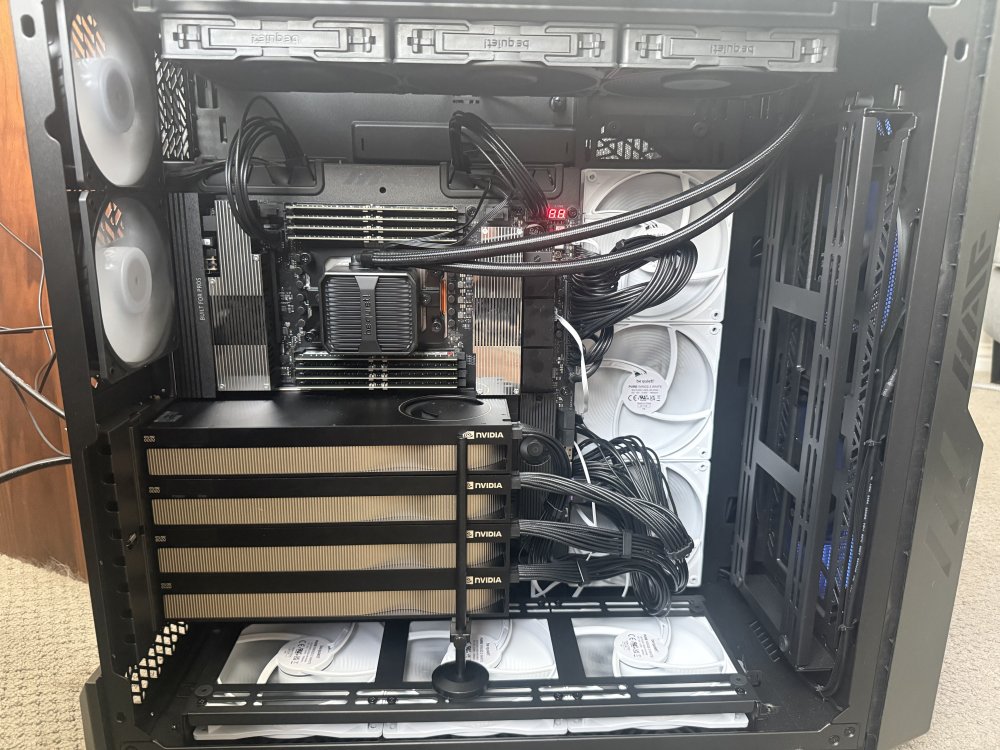
    IMG_0897.png

    IMG_0899.png

     顯卡
    

    這台的核心就是:

    4× RTX PRO 6000 Blackwell Max-Q 96GB

    所以總 VRAM 是:

    96GB × 4 = 384GB

    主要目的就是跑大模型跟 AI 影片,不是拿來打遊戲。

    目前家裡還是 120V,所以我暫時不打算讓四張卡全部跑滿。

    現在比較傾向把每張 GPU cap 在大約:

    250W
    

    四張就是大約 1000W。

    這樣至少在家用供電環境下比較好控制,不然四卡全開再加 CPU,整台機器功耗其實滿可怕的。未來可能會專門拉一條240V的線。
    老婆OS: 房間的燈怎麼在閃...

    主要拿來跑什麼
    

    目前主要是:

    • SGLang
    • llama.cpp
    • DeepSeek
    • Qwen
    • GLM
    • ComfyUI
    • MiniMax Video
    • LoRA
    • RAG / Agent

    看看幾個大型模型在四張 RTX PRO 6000 上面的實際速度。

    比較有興趣測:

    • DeepSeek V4.1 Flash
    • Qwen 大模型
    • GLM
    • 一些 100B+ 或 MoE 模型

    384GB VRAM 最大的好處就是很多模型可以直接放 GPU,不需要一直 offload 到 system RAM。
    模型越裝越多之後才發現,12TB 好像也沒有想像中那麼多。

    為什麼最後上 WRX90
    

    一開始其實也有考慮一般消費級平台。

    但真的開始考慮四張 GPU 之後,最大的問題就變成:

    • PCIe lanes
    • 插槽距離
    • GPU 空間
    • 供電
    • RAM 容量
    • SSD 擴充

    所以最後乾脆直接上:

    ASUS Pro WS WRX90E-SAGE SE

    搭配 Threadripper PRO。

    這平台最大的優點就是很明確:

    就是拿來塞一堆 PCIe 裝置的。

    不過四張卡真的塞進去之後,主板下面的線會變得非常痛苦。

    尤其是:

    • FAN header
    • Front panel
    • USB header
    • 底部線材

    第四張卡一裝下去,基本上都被壓在下面。可能等thermal pad到了 再優化一下。

    SSD 分配
    

    目前是三顆 4TB Samsung 990 PRO。

    大概分成:

    SSD 1
    Windows
    
    SSD 2
    Ubuntu
    
    SSD 3
    ComfyUI / Models / AI Data
    

    Windows 主要還是跑日常工具跟 ComfyUI。

    Ubuntu 則是拿來搞:

    • CUDA
    • SGLang
    • vLLM
    • Multi-GPU inference
    最大的問題
    

    目前覺得這種四卡機最大的問題不是算力。

    反而是:

    1. 供電
    2. 散熱
    3. PCIe 空間
    4. 線材

    我已經把機殼基本上能裝的風扇全塞滿了,溫度還是不是很理想,特別是跑deep seek v4.1 flash的時候,這個之後還想再研究一下。
    之後如果有空,再做一些更進一步的測試,最近北加真的太熱了...

  • 4× RTX PRO 6000 Blackwell Max Q
    Chu Hao-LungC Chu Hao-Lung
    装备秀 rtxpro6000 多卡部署

    @terry

    打算換一個輕一點的機殼 整理完再update!


  • 家庭装备大公开,顺便汇报一下计划和配置
    Chu Hao-LungC Chu Hao-Lung
    装备秀 多卡部署 服务器 本地模型

    說不上高手 小建議
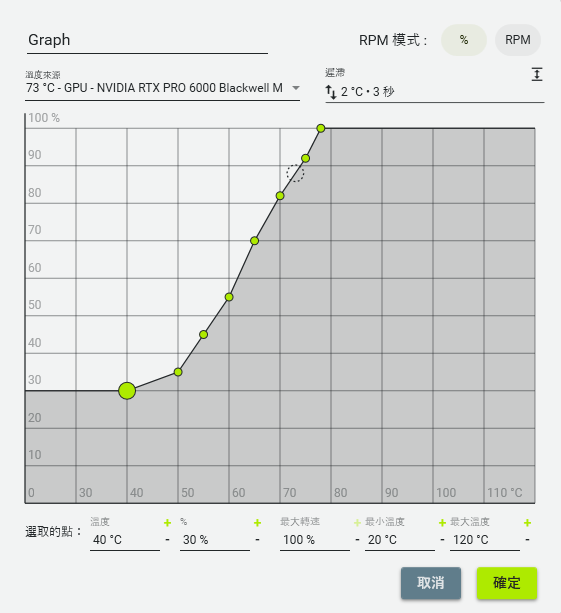
    在RTX pro 6000 max Q 那邊安裝個fan control, https://github.com/Rem0o/FanControl.Releases
    我之前搞了半天這張卡溫度就是下不來 很焦躁
    直到我看到這篇 溫度永遠維持75以下.. 可以安心跑overnight
    這是我的溫度曲線編輯(0依據, 純ai)

    屏幕截图 2026-09-19 205123.png


  • 【實測】4× RTX PRO 6000:DeepSeek V4.1 Flash 原版 vs 1017,單人生成提升約 51%
    Chu Hao-LungC Chu Hao-Lung
    LLM讨论区 rtxpro6000 deepseek 多卡部署

    @David-Chen

    純分享 說不定可以幫版主水一期視頻 哈哈


  • 【實測】4× RTX PRO 6000:DeepSeek V4.1 Flash 原版 vs 1017,單人生成提升約 51%
    Chu Hao-LungC Chu Hao-Lung
    LLM讨论区 rtxpro6000 deepseek 多卡部署

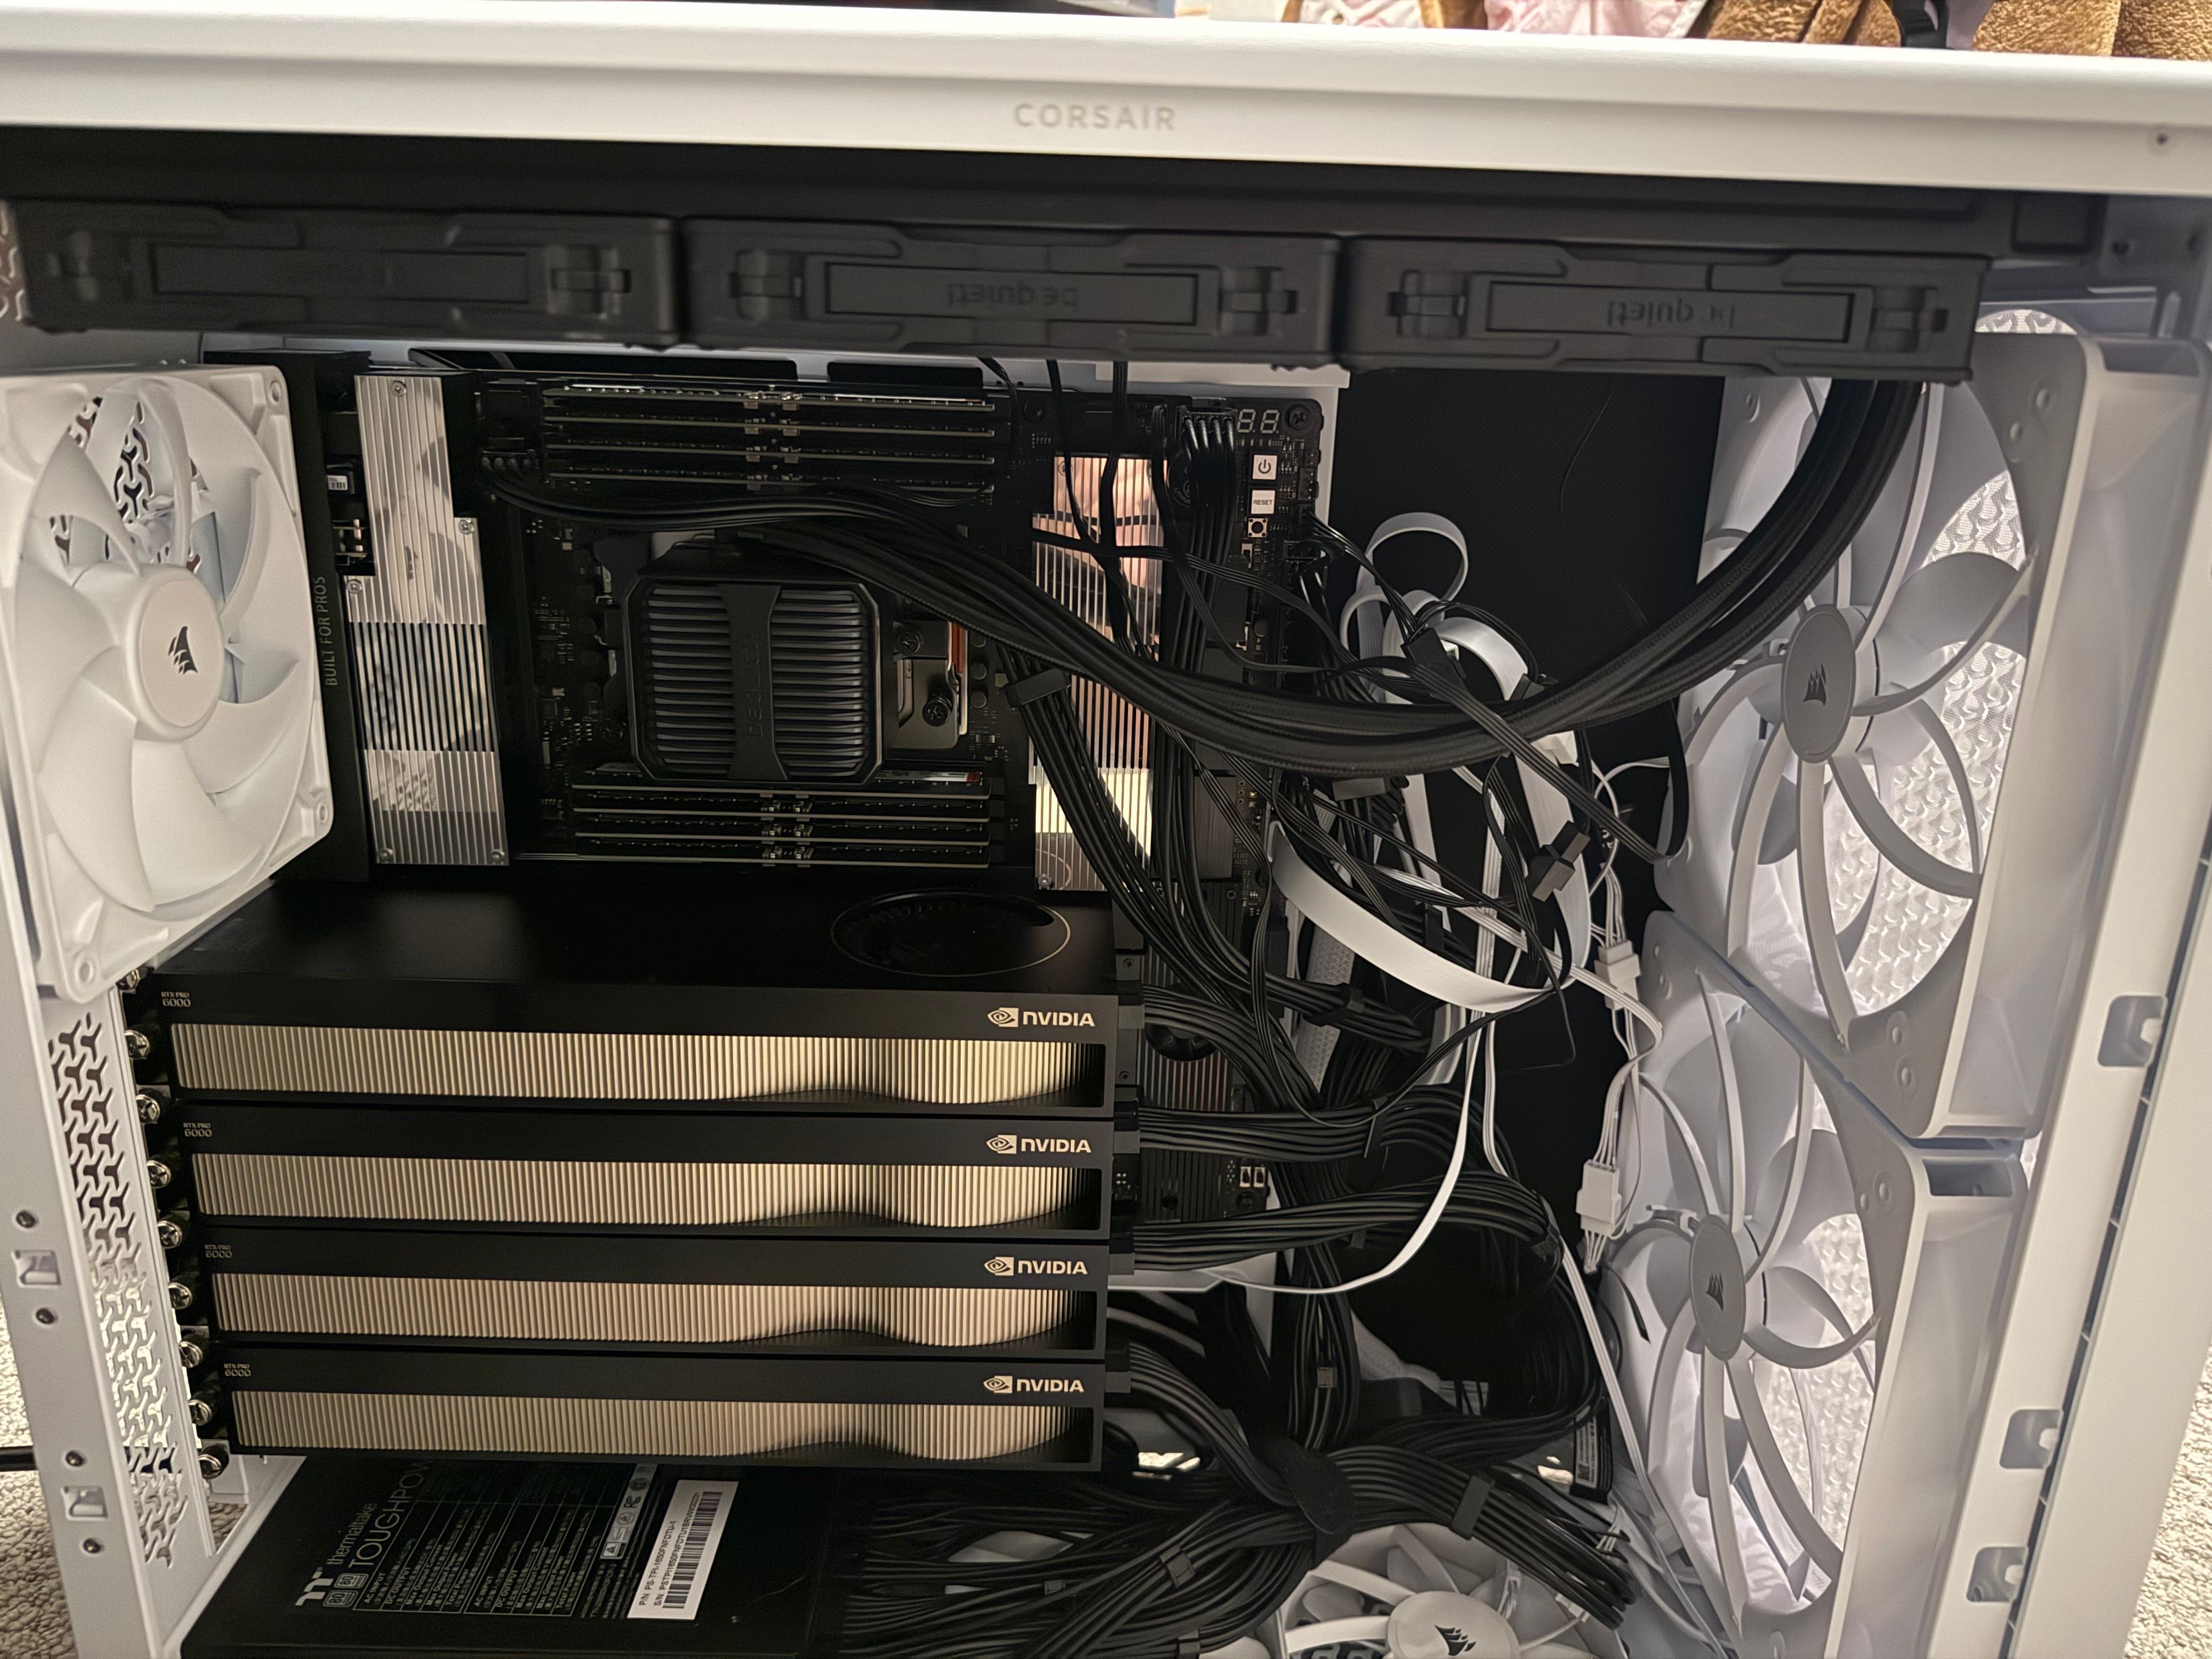
    IMG_1003.jpeg

    前陣子比較忙 ,換了一個機殼,而且抽空來做昨天更新的deep seek v4.1 flash 跟舊版本的差別。

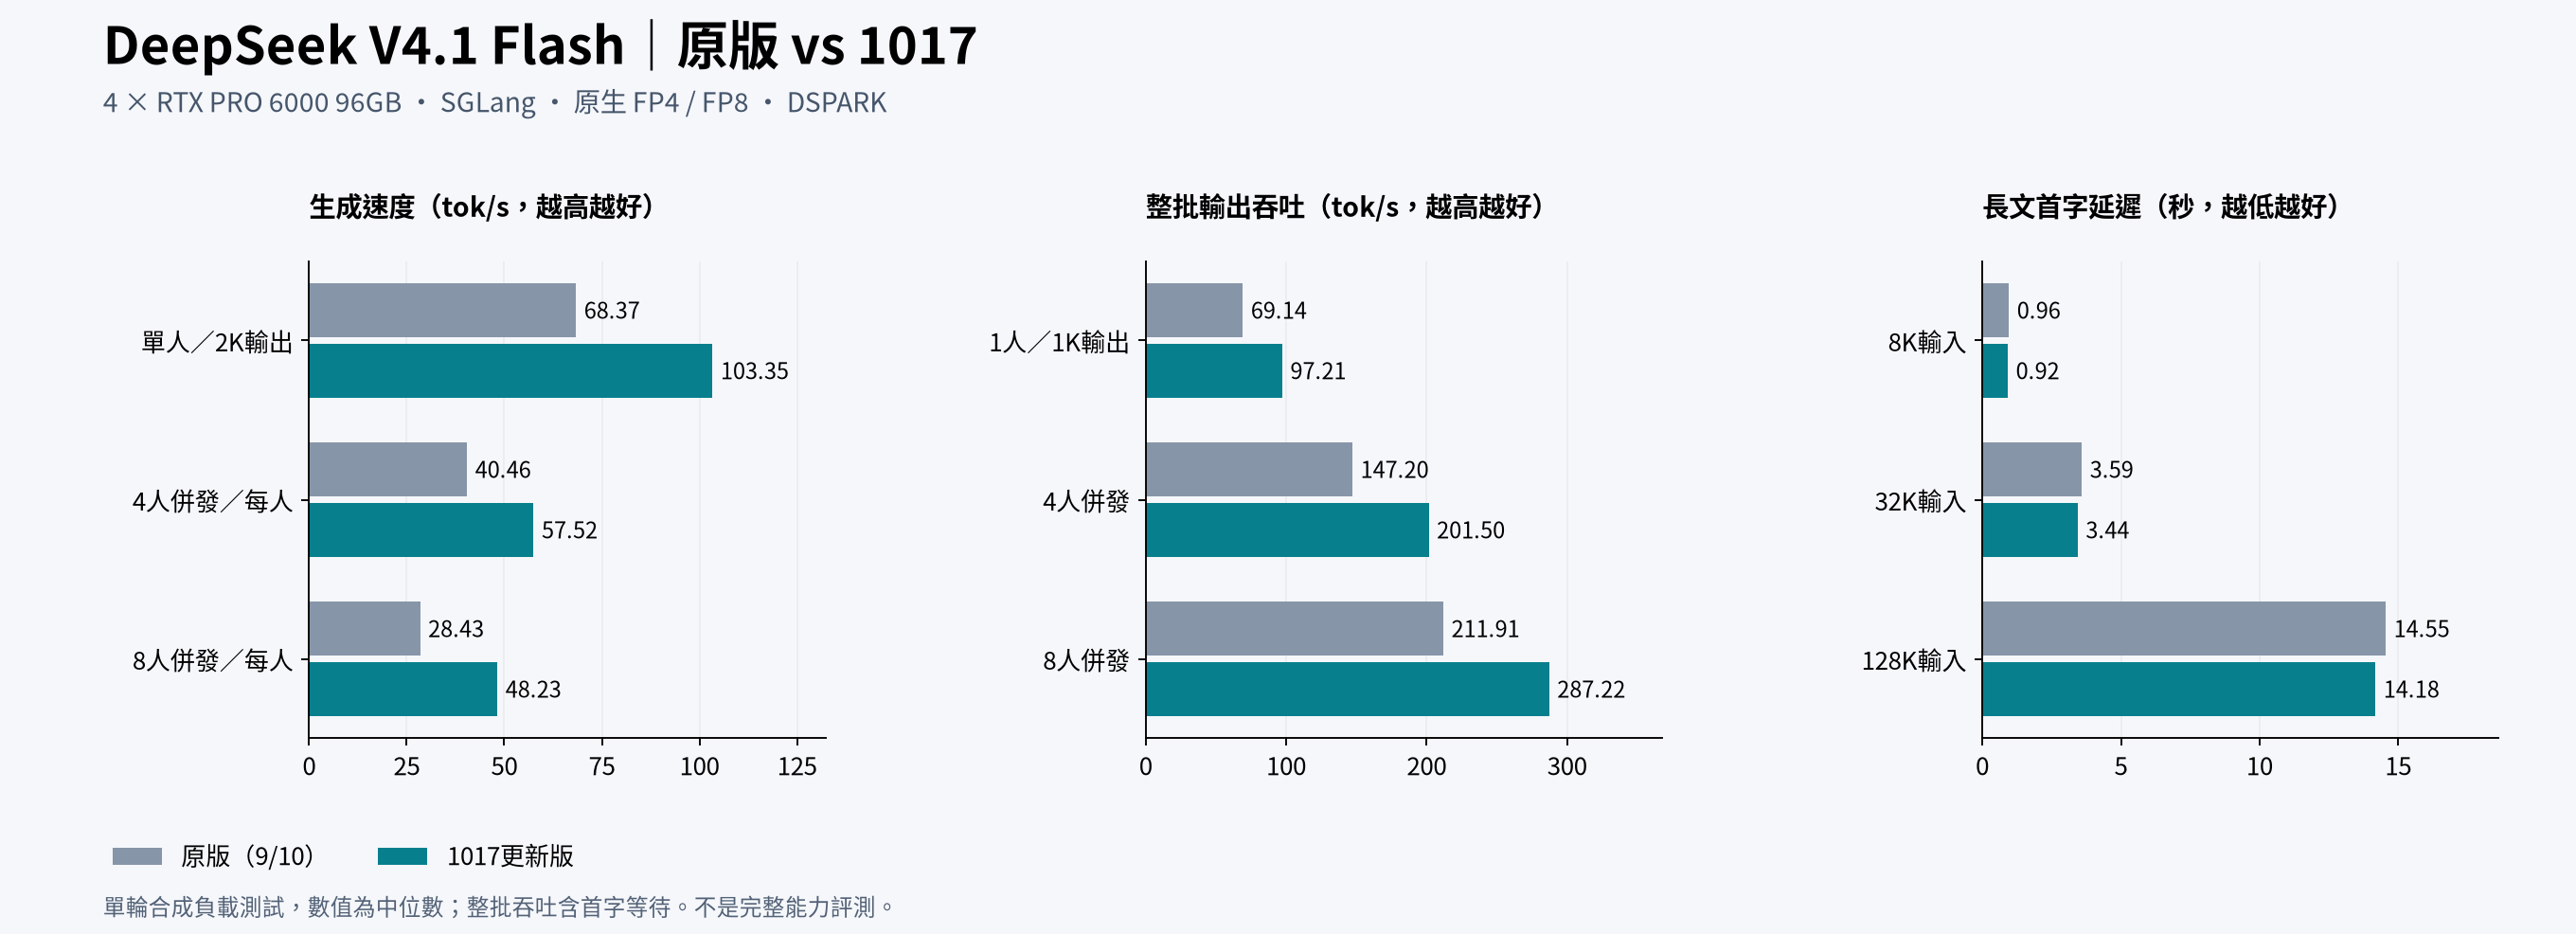
    同一台電腦、相同 SGLang 部署設定,比較 DeepSeek V4.1 Flash 原版與 1017 更新版。
    本輪結果:1017 單人生成約快 51%,8 人整批吞吐約高 36%;長文有效 Prefill 約提升 3~4%。

    1. 比較的是哪兩個版本?

    版本 官方發布日期 模型倉庫 本次權重修訂
    V4.1 Flash 原版 2026/09/10 deepseek-ai/DeepSeek-V4.1-Flash fb2764a
    V4.1 Flash 1017 2026/10/17 deepseek-ai/DeepSeek-V4.1-Flash-1017 1bae0e1

    「原版」指 1017 更新前的 V4.1 Flash,不是 V4 Flash,也不是舊版 SGLang。日期依官方更新日誌,修訂碼則對應本次實際測試檔案,不表示是發布當天的第一版權重。

    2. 軟硬體配置

    項目 配置
    CPU AMD Threadripper PRO 9975WX,32 核心
    GPU 4× RTX PRO 6000 Blackwell Max-Q,96GB/張
    RAM/儲存 256GB/本機 NVMe SSD
    作業系統 Ubuntu
    推論引擎 Docker+SGLang,套件版本標記 0.0.0.dev0
    SGLang 基底映像 固定映像摘要 c4ca651192e5…,兩版相同
    權重格式 官方原生 FP4 專家+FP8/BF16 混合精度,約 510GB
    平行/推測解碼 TP4/EP4、DSPARK block 5
    記憶體配置 NVMe Engram 卸載、64GiB Engram 快取預算
    服務設定 上下文 409,600 Token、最多 8 個同時請求、顯存配置比例 0.85

    3. 測試方式

    直接透過本機 SGLang API 測試,繞過 Harness 介面。先暖機,temperature=0、Thinking 關閉;速度項目固定輸出長度。

    項目 輸入/輸出條件 時間/版本
    單人生成 約 1K 輸入/2K 輸出 5 分鐘
    長文輸入 約 8K、32K、128K 輸入/128 輸出 合計 6 分鐘
    併發測試 約 1K 輸入/1K 輸出,1/4/8 人併發 各 3 分鐘
    基本正確性 6 道簡單題循環測試 5 分鐘

    每版約 26 分鐘,先測 1017,再切換原版。英文合成輸入每次加入隨機識別前綴;實際輸入比表列目標多約 30 Token。

    4. 生成速度與吞吐結果

    download.png

    速度單位為 tok/s,以下取中位數,越高越好。

    測試情境 原版:每人 Decode 1017:每人 Decode 原版:整批吞吐 1017:整批 吞吐
    單人,1K→2K 68.37 103.35 67.96 102.47
    1 人併發,1K→1K 69.96 98.82 69.14 97.21
    4 人併發,1K→1K 40.46 57.52 147.20 201.50
    8 人併發,1K→1K 28.43 48.23 211.91 287.22
    重點指標 1017 相對原版
    --- ---:
    單人生成,2K 輸出 +51.2%
    4 人併發,每人生成 +42.2%
    8 人併發,每人生成 +69.7%
    4 人整批吞吐 +36.9%
    8 人整批吞吐 +35.5%

    「每人 Decode」估算首字之後的生成速度;「整批吞吐」以整批輸出 Token 除以完整耗時,包含首字等待與輸入處理,兩者不能直接相乘換算。

    5. 長文輸入結果

    輸入長度 原版:有效 Prefill 1017:有效 Prefill 原版:Decode 1017:Decode 原版:整批吞吐 1017:整批吞吐
    8K 8,574.15 8,920.68 73.25 82.98 47.19 51.94
    32K 9,128.07 9,528.06 75.17 96.31 24.06 26.54
    128K 9,009.65 9,244.69 69.38 94.75 7.67 8.06

    單位均為 tok/s。長文項目只輸出 128 Token,完整耗時主要受輸入處理影響,因此整批輸出吞吐較低。

    有效 Prefill=輸入 Token ÷ 首字等待時間,包含排程與首字運算,不是純 GPU Prefill。

    6. 首字延遲與請求成功數

    延遲單位為秒,越低越好。P50 為中位數,P95 表示約 95% 的請求落在該延遲以內。

    情境 原版 P50 1017 P50 原版 P95 1017 P95 成功數:原版/1017
    單人,1K→2K 0.20 0.18 0.26 0.24 11/11 / 16/16
    長文 8K→128 0.96 0.92 1.03 1.01 15/15 / 16/16
    長文 32K→128 3.59 3.44 3.67 3.51 15/15 / 16/16
    長文 128K→128 14.55 14.18 14.90 14.59 15/15 / 16/16
    1 人併發,1K→1K 0.19 0.18 0.20 0.19 14/14 / 18/18
    4 人併發,1K→1K 0.63 0.59 0.65 0.63 28/28 / 36/36
    8 人併發,1K→1K 1.02 0.96 1.26 1.19 40/40 / 56/56

    固定測試時間內,速度不同會產生不同樣本數。

    7. 基本正確性

    題組包含乘法、加法、JSON、短文代碼擷取、Python len() 與繁中文字串遵循。

    項目 原版 1017
    基本題組答對數 270/270 271/271
    題組首字延遲 P50/P95 0.08/0.09 秒 0.08/0.09 秒
    全部正式請求成功數 408/408 445/445

    這是 6 道簡單題的重複測試,用途是檢查基本輸出與穩定性,不能代表寫作、程式修錯、複雜推理或工具使用能力。

    8. 結論與限制

    本輪測試中,1017 的主要優勢在生成速度與併發吞吐;長文首字等待與有效 Prefill 有改善,但幅度較小。基本題組兩版均全對,沒有請求失敗。

    本次使用自製測試程式,並非 Local Inference Lab 官方 benchmark。兩版各跑一輪,未交錯重測、未嚴格清除前綴快取,也未記錄每輪功耗、溫度及 GPU/RAM 峰值。DSPARK 會分批送出 Token,Decode 是客戶端估算值。因此,上述差異應視為這台機器、這組合成負載下的觀察結果,不能直接當作新版在所有任務中的固定提升。

    最近meta 也出了一款開源的模型,但是依官方要求,需要6張RTX pro 6000 但是智商好像也不太行。我配對了一下,但是tps掉太多,感覺也不是真正適合拿來生產的工具,等有更好的模型出來,再來分享結果...

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组