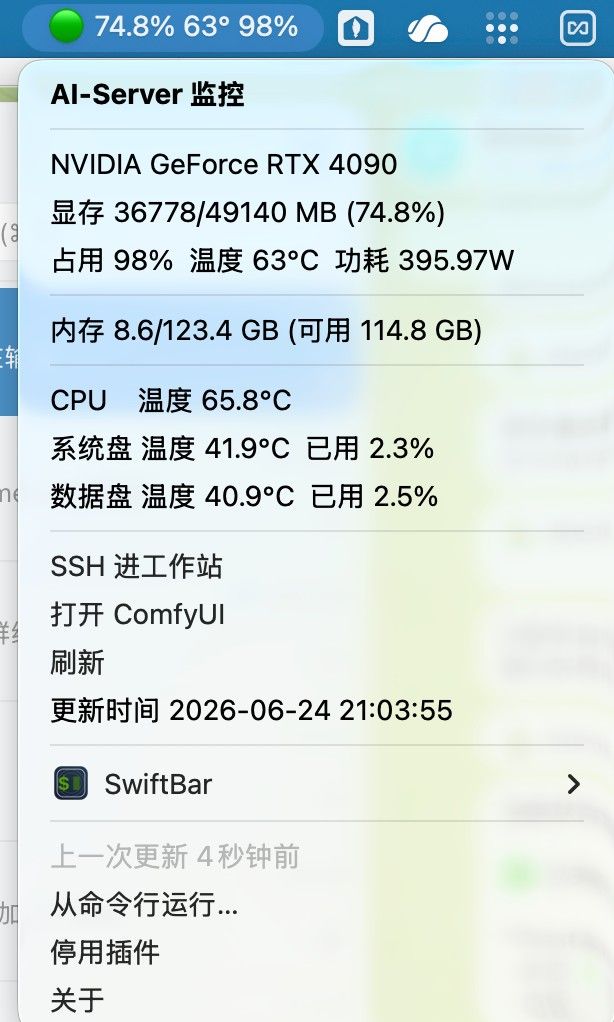
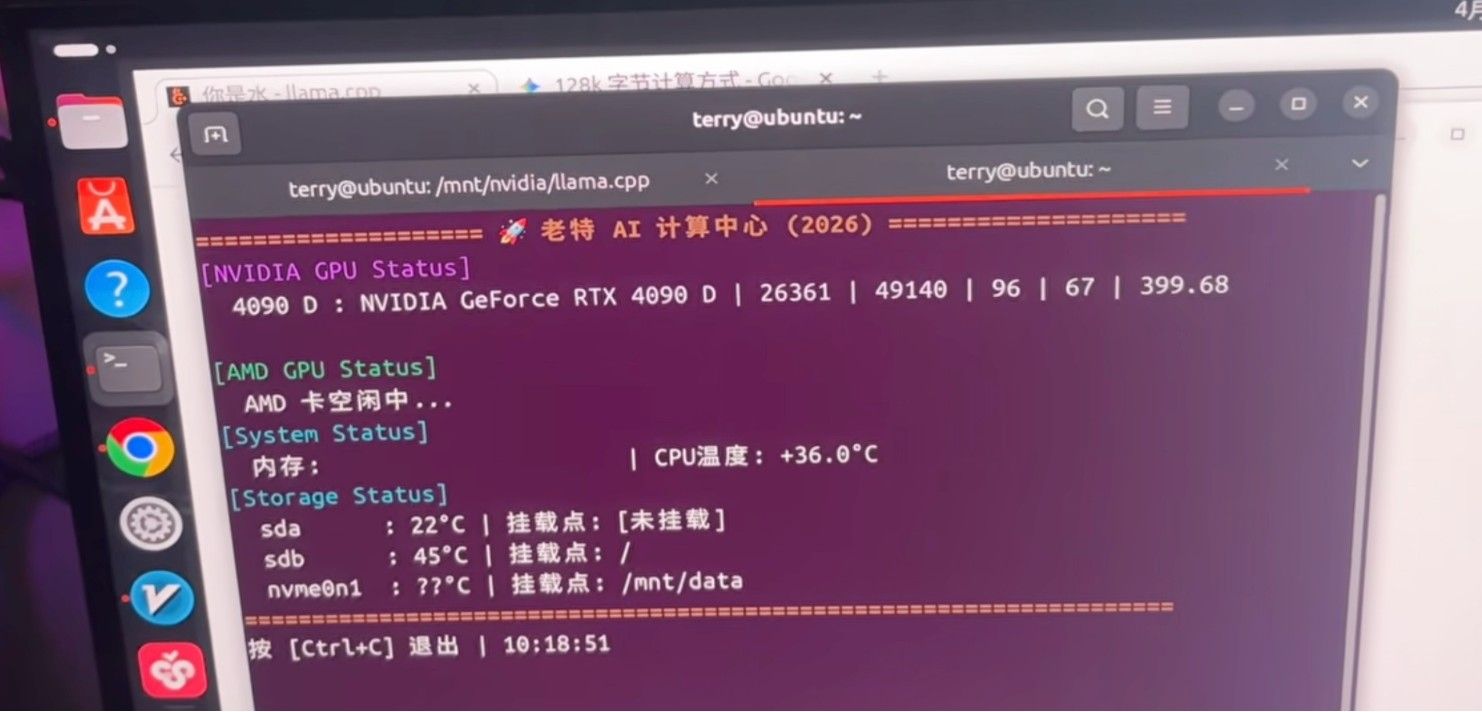
参照老特哥的视频截图,也做了个监控脚本,这样就能在Mac mini的顶部,直接显示工作站的工作状态。
 D
4090就不要谈噪音控制了,除非我这样完全不在意的,我只要快。但是这机器没啥短板,缺点就是显卡明年贬值会很厉害,趁早享受吧。
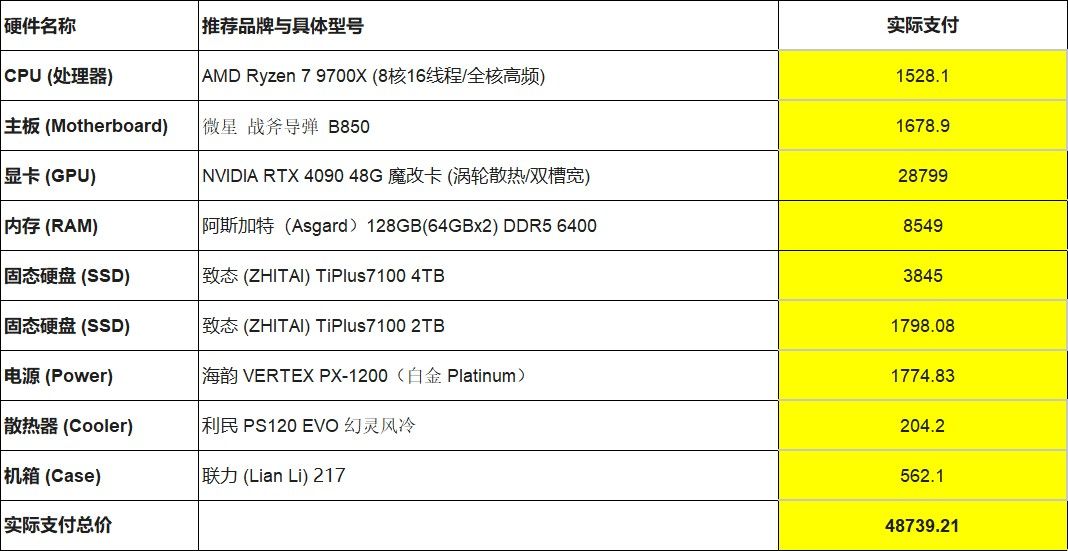
是的,看了你的视频,迅速整了一台。本来想是在现有的机器上升级显卡、换电源,但是看了论坛的某个帖子的启发,就重新整了一台新机器,就把它作为后台的工作站了,现在通过macmini SSH来连接。
目前正跟着你的视频,一步步配置好这台工作站。
你之前视频里提到,显卡驱动:570.211.01 CUDA 版本:12.80,目前我的是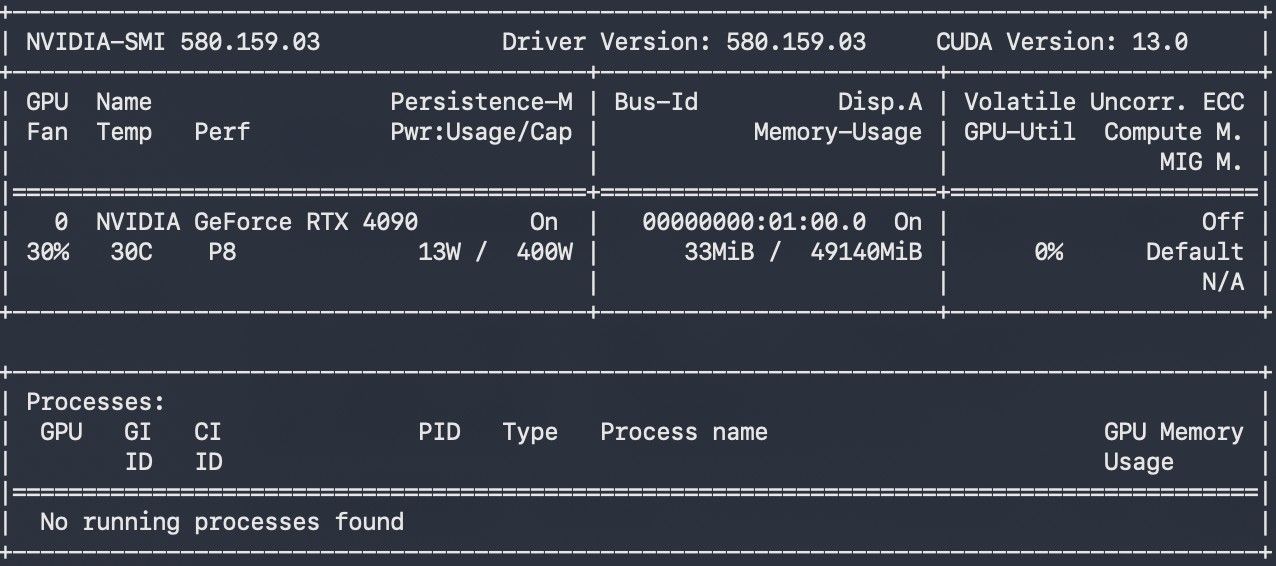
chatgpt和gemini都说让我先不要跟你的版本对齐,你的看法呢?
我的初步想法,这个ai- server需要为我做以下工作:
折腾了一整天,把单卡 4090 48G 上的 Qwen3.8-27B 部署从 SGLang 0.5.16 + 官方 FP8 换到了 0.5.19 + W4A16 + DFlash2。一共跑了七组对照,(这是按照论坛大神的作业抄的,让claudecode部署并且做了矩阵测试选定参数)。
结论先放:W4A16 单独换是负优化,比 FP8 慢 35%;但配上 DFlash2 之后代码解码从 76 涨到 245 tok/s。这两件事是一体的,分开看会得出完全相反的结论。
| 项目 | 配置 |
|---|---|
| GPU | RTX 4090 48G(sm_89) |
| 系统 | Ubuntu 24.04 |
| 框架 | SGLang 0.5.19 |
| 用途 | agent、编程、工具调用、扫描件 OCR |
| 项目 | 改动前 | 改动后 |
|---|---|---|
| SGLang | 0.5.16 | 0.5.19 |
| 主权重 | 官方 FP8(29G) | W4A16(19.6G) |
| 投机解码 | MTP | DFlash2 |
| KV | FP8 | FP8 |
| mem-fraction | 0.93 | 0.75 |
主权重是 philbert440/Qwen3.8-27B-W4A16-AWQ,draft 是 tcclaviger/Qwen3.8-27B-DFlash2-FP8(2.12G,比 BF16 版省 1.5G)。
同 prompt、temperature=0、同上下文,单位 tok/s:
| 任务 | FP8+MTP | W4A16+DFlash2 |
|---|---|---|
| 代码生成 | 75.7 | 245.6 |
| 工具调用 | 91.5 | 239.9 |
| 数学(thinking) | 64.9 | 167.4 |
| 中文散文 | 47.3 | 56.3 |
| 双并发聚合 | 136 | 349 |
长上下文 prefill 是反过来的:8.5 万 token 冷 prefill,FP8 是 32.2 秒,W4A16 是 41 秒,慢 27%。W4A16 的反量化开销在 prefill 阶段躲不掉。
质量项两边都过:8.5 万 token 大海捞针三项全中,工具调用 finish_reason=tool_calls 参数正确,A4 300dpi 扫描件 VLM 识别四项全中。速度差异不伴随质量退化。
这是我觉得最值得分享的一点。先看中间那组数据:
| 组合 | 代码解码 |
|---|---|
| FP8 + MTP | 75.7 |
| W4A16 + MTP | 48.9 |
| W4A16 + DFlash2 | 245.6 |
W4A16 配 MTP 是全场最差。原因是 4090 有原生 FP8 Tensor Core,FP8 权重几乎零反量化开销;而 W4A16 要走 Marlin 把 int4 解包成 BF16。
算一下显存带宽账(4090 是 1008 GB/s)就很清楚:
| 权重 | 理论上限 | 实测 |
|---|---|---|
| W4A16(17.75G) | 51 tok/s | 48.9 |
| FP8(28.5G) | 35 tok/s | 75.7 |
W4A16 贴着带宽上限跑,说明 MTP 在它身上基本没产生收益;FP8 跑到上限的 2.2 倍,说明 MTP 收益很大。
DFlash2 改变了这个局面。投机解码的验证阶段是一次 batch=8 的 forward,要把整个主模型权重读一遍,所以权重体积直接决定验证频率上限:
| 权重 | 验证频率上限 | 实测吞吐 |
|---|---|---|
| W4A16(17.75G) | 56.8 次/s | 245.6 |
| FP8(28.5G) | 35.4 次/s | 156.4 |
理论比值 1.60,实测 1.51,对得上。投机解码把"读一遍权重"的成本摊到 5~6 个 token 上,权重越小越快,反量化开销也一起被摊薄了。 没有投机解码时每次 forward 只出 1 个 token,开销无处可摊,W4A16 就成了最慢的。
我还测了 FP8 + DFlash2,代码 156.4 tok/s,比 W4A16 + DFlash2 慢 34%,正好印证这条规律。
服务端 accept len / accept rate 直接说明问题(block_size=8):
| 场景 | accept rate | 实测吞吐 |
|---|---|---|
| 结构化输出 | 0.57~0.76 | 152~247 |
| 中文自由写作 | 0.11 | 57 |
代码 245 对中文 56,差 4.3 倍。如果主力用途是中文长文写作而不是 agent / 编程,DFlash2 不值得上,FP8 + DFlash2 那组的中文甚至只有 30.4 tok/s,比完全不用投机解码的 47.3 还慢 36%。
默认 page_size=1 时,L3 文件后端的 key 粒度细到每个 token 一条。我这边写了 15.4G、40 万个文件,但 #cached-token 恒为 0,从来没命中过一次。线上那个 hicache 目录一度涨到 440G,全是白写的。
改成 64 之后跨重启命中 82%,TTFT 从 24.5 秒掉到 5.8 秒,落盘量反而降到 2.7G。约束是 mamba_track_interval(默认 256)必须能被它整除。
这个最阴险。 L3 文件后端跨重启保留,而它的 key 不包含 kv_cache_dtype。我把 BF16 KV 换成 FP8 KV 后没清缓存,结果:
| 项目 | 脏缓存 | 清空后 |
|---|---|---|
| 工具调用 | finish=stop,0 个调用 | 正常,5 个 |
| 大海捞针 | 三项全错 | 三项全中 |
| 捞针 TTFT | 1.8 秒 | 41 秒 |
服务健康、不报错、不崩溃,但答案是错的。 我一开始以为是 FP8 KV 精度不行,差点否掉整个方案。救回来的线索是 TTFT——8.5 万 token 的 prefill 不可能 1.8 秒,那必然是假命中。
所以换权重或改 KV dtype 之后,一定要清掉 hicache 目录。
同参数从 0.5.16 升到 0.5.19,max_total_num_tokens 从 141673 掉到 114983。启动日志里能看到原因:
Mamba Cache: ssm_state 2.67GB
           + intermediate_ssm_state_cache 1.69GB   ← 0.5.19 新增
           + intermediate_conv_window_cache 0.02GB
新增的中间状态缓存 1.71G 直接从 KV 预算扣。把 --max-mamba-cache-size 从 18 降到 14 就回来了。
注意两条弯路:关掉 prefill CUDA graph 省了 1.3G 显存但 KV 一个 token 都没涨(KV 池是按 mem-fraction 预先算定的,不吃剩余显存);把 mem-fraction 提到 0.95 直接在 KV 分配阶段 OOM。
uv pip install sglang[all]==0.5.19 会带进 nvcc 13.4.59,而 runtime 头文件是 13.0.96。启动时 FlashInfer JIT 编到第 8 个内核直接报错:
cuda/std/__cccl/cuda_toolkit.h:41: error: "CUDA compiler and CUDA toolkit headers
are incompatible, please check your include paths"
把三个包钉回一致版本就好:
uv pip install 'nvidia-cuda-nvcc==13.0.88' 'nvidia-cuda-crt==13.0.88' 'nvidia-nvvm==13.0.88'
rm -rf ~/.cache/sglang/.cache/flashinfer
验这个坑不能用裸 nvcc 编译 cuda_runtime_api.h,那样能通过、会得出"工具链没问题"的错误结论。真正的判据在 FlashInfer 自带的 CCCL 头文件里,它对 __CUDACC_VER__ 和 CUDART_VERSION 做严格一致性检查。
另外 0.5.19 换了 JIT 缓存路径,是 ~/.cache/sglang/.cache/flashinfer,不再是 ~/.cache/flashinfer。
想给同卡上的 OCR 腾显存,我试过降并发,结果只省了 16 MiB。
mem-fraction-static 是总量阀门,先圈定框架能用多少显存;降并发省下的 mamba cache 会原封不动转给 KV 池。要给 GPU 上其它进程腾地方,唯一有效的杠杆就是 mem-fraction。
顺带一提,FP8 KV 比 BF16 KV 更划算:同样容量只要一半显存,于是 mem-fraction 能从 0.85 压到 0.75,而 KV 容量反而从 155840 涨到 199680,性能一分不损。
--model-path Qwen3.8-27B-W4A16-AWQ \
--speculative-algorithm DFLASH \
--speculative-draft-model-path Qwen3.8-27B-DFlash2-FP8 \
--speculative-num-draft-tokens 8 \
--kv-cache-dtype fp8_e4m3 \
--mem-fraction-static 0.75 \
--context-length 131072 \
--max-running-requests 2 \
--max-mamba-cache-size 14 \
--page-size 64 \
--enable-hierarchical-cache --hicache-size 32 \
--hicache-storage-backend file \
--disable-prefill-cuda-graph
KV 容量 199680,空载显存 38.4G,留了 10G 给同卡上的 OCR,实测两者可以并存不互相挤爆。
这套配置的收益高度集中在结构化输出上,选之前先看自己的负载:
| 主力用途 | 建议 |
|---|---|
| agent / 编程 / 工具调用 | W4A16 + DFlash2,收益 3 倍以上 |
| 中文长文写作 | 收益只有 20%,不如省事用 FP8 |
| 长文档一次性灌入 | FP8 更好,prefill 快 27% |
另外 256K 原生上下文我也试了,能跑满,但要 mem-fraction-static 0.99 + 单路并发,24 万 token 的请求 TTFT 是 157 秒。不建议做常驻档。