我觉得本地化部署就两个场景适合:
- 你有私密的数据。local agents场景,Openclaw或者Hermes真要能帮你干活,你得给他很多私密的数据,服务器的用户名密码,邮箱密码什么的。
- 你的需求没有现成的外部算力平台,比如老特的那种定制化的数字人生产流水线。
其他你要是写代码,爬资料之类的公共信息相关需求,直接买coding plan肯定更划算。
我觉得本地化部署就两个场景适合:
本来是双卡vllm的 (用的club-3090的脚本),稳定运行,性能中规中矩。 后来想要腾出一张显卡玩comfyui, 所以想要一个靠谱的单卡方案。
club-3090里只有llama.cpp的单卡方案,prefill性能不行。于是用了 syv-ai/qwen38-27b-rtx3090 的vllm+dflash2 的方案。 直接把github仓库地址丢给dsh远程配置的,起来以后效果不错,单人使用的话,打开
SPEC=dflash2
PREFIX_CACHE=1
CTX=huge
DFLASH_MAX_LEN=180000 #我最终用的是160k
实测性能如下, 128k上下文时,prefill ~800tps, decode 33~38tps :
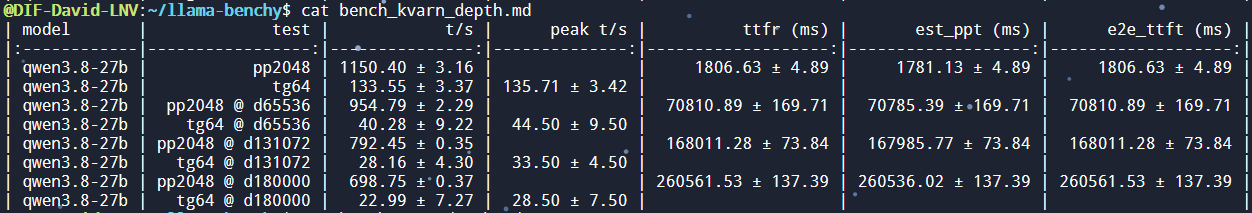
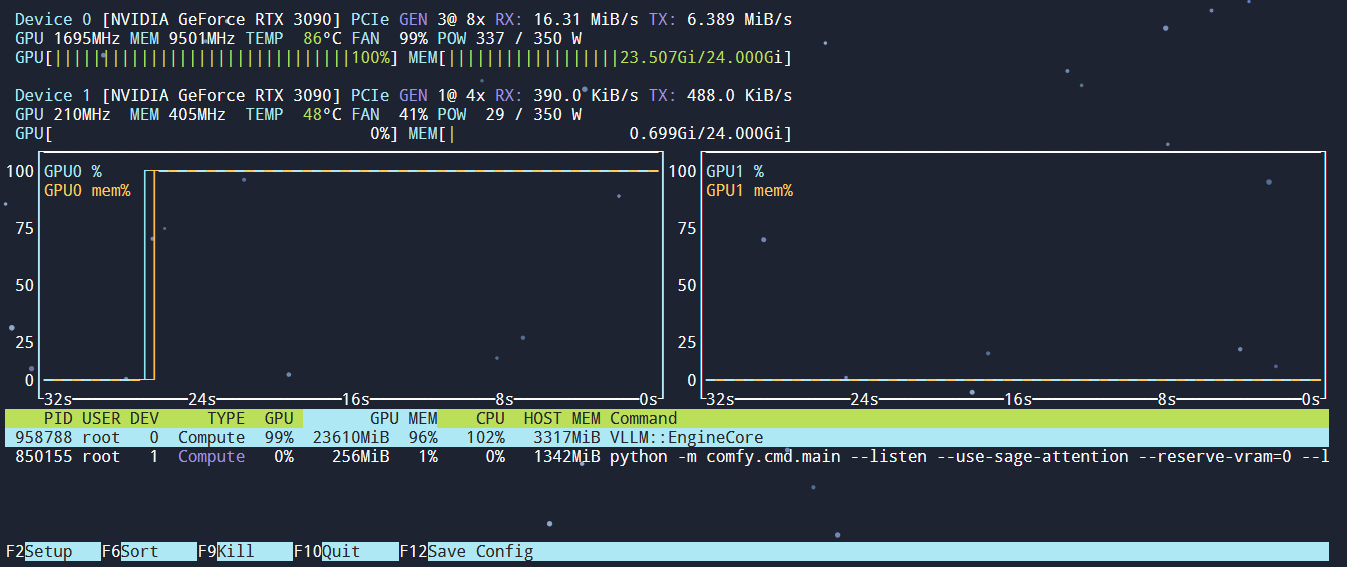
整体感觉和club-3090的双卡vllm的性能已经差不多了。接dsh跑了一下,整体感觉还行,TFTT第一次会比较长,后面因为PREFIX_CACHE就短下来了(当然也可能是tool calling的结果太短,没影响上下文):
#DSH的第一个回答
Started 2026-08-28 14:39:15.324
Total duration 23.4 s
TTFT 20.8 s
Generation 2.60 s
Throughput 75.8 tok/s

#下一个回答
Started 2026-08-28 14:39:45.347
Total duration 2.18 s
TTFT 1.23 s
Generation 947 ms
Throughput 99.3 tok/s

#再下一个
Started 2026-08-28 14:39:49.862
Total duration 2.81 s
TTFT 779 ms
Generation 2.03 s
Throughput 92.1 tok/s
DSH里跑了4轮47步,最后一次的Throughput是49.1 tok/s,此时上下文 57.7k,基本和测试相符。
以后可以用gpu0配置gpu1上的comfyui了。
另外,有一个坑,就是开了单人的这些参数以后,不要多人或者多agent同时使用,争抢资源,缓存失效,两个速度都卡出翔。 单个DSH的话,还是非常丝滑的。多人可以考虑官方的多人配置,损失decode速度,换多人可以同时使用。
@davidwei0826 DSH不错的话,Hermes和Codex测试了没?不过有一个Agent能用,就差不多了。
最近痴迷DSH,已经很久没有长时间使用Hermes和Pi等其他agent了,都是发些短任务。 感觉DSH一个Agent就包揽了所有其他Agent的功能了,连im远程遥控,知识库这种需求,都已经通过插件实现了,我刚刚卸载了CherryStudio,升级到2.0以后太不稳定。 Opencode在开发完手里的项目以后,也不准备用了。全面转向DSH哈。
不过讲真,Hermes我感觉在我手里没有你说的那么好用,也可能是我给他一直配的是Minimax-M3模型,也不用他做开发吧。 后面我再重新更新下Hermes,接ds4 flash试试。
听说 halogen 不错,手里正好有之前视作鸡肋的 MS-S1,这回支棱起来了。
halogen 是什么、官方怎么装、性能对比,论坛里几位老哥写得很细,不重复:
这篇只写我这台机器跑出来的数字和能落地的配置。
| 机器 | MS-S1(Ryzen AI MAX+ 395 / Radeon 8060S / gfx1151),128G,BIOS carve 最小 | |
| 系统 | Ubuntu 24.04.3,内核 6.18.6 | |
| 引擎 | halogen-flash-server 0.8.0 | |
| 权重 | 118 GiB | |
| 指标 | 官方 | 我这台 |
| --- | --- | --- |
| prefill @8K | ~1,246 tok/s(TTFT 6.6s) | 1,309 tok/s(TTFT 6.6s) |
| prefill @32K | ~1,424 tok/s(TTFT 23.0s) | 1,524 tok/s(TTFT 21.6s) |
| decode @32K | ~41.7 tok/s | 39.1 tok/s(draft 命中 97/149) |
| 冷启动 | — | 48 秒(其中 pin 权重 42 秒) |
| 热启动 | — | 6 秒 |
官方数字是真的,照配就能到。中间踩了三个坑,都记在下面。
内核 cmdline:
quiet splash iommu=pt amdgpu.gttsize=126976 ttm.pages_limit=32505856
启动:
sudo podman run --rm --name halogen-flash \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --ipc=host --ulimit memlock=-1:-1 \
  -p 8731:8731 \
  -e HALOGEN_VISION_TOWER=/models/qwen38-flash-next-vision.hgn \
  -e HALOGEN_REASONING_EFFORT=medium \
  -e HALOGEN_MAX_TOKENS_DEFAULT=16384 \
  -e HALOGEN_CTX=184320 -e HALOGEN_KV_POOL_POSITIONS=184320 \
  -v /home/davidwei/models/halogen-models:/models:ro \
  ghcr.io/peonist-ai/halogen-flash-server:0.8.0
起服务加载到 preparing weights, layer 0 of 48 就崩,报 unspecified launch failure(719) at hipblaslt.cpp:187,dmesg 里是 amdgpu: ring sdma0 timeout + GPU reset + SW scheduler is used。
原因是我这台机器的 cmdline 里有早年加的这两个,官方配置里没有:
amdgpu.sched_policy=2      # 强制软件调度器
amdgpu.cwsr_enable=0       # 关掉 CWSR 抢占
去掉这两个,引擎 48 秒正常就绪。 对照数据:带这俩参数那次启动 GPU 挂死 4 次;去掉后 0 次。我在这上面耗的时间比下载 118 GiB 还多。
README 要求内核 ≥7.0,说 6.18.6 上驱动会拒绝只读映射、pin 不了权重。我实测了它说的那个调用,是成功的:
hipHostRegister(只读文件映射, READONLY flag) -> hipSuccess | no error
引擎自己也打印了 checkpoint: pinned 65.60 GiB in 252 range(s) in 40.3 s (1.7 GB/s)。所以没必要升内核(我 apt 里 7.0.0 都备好了,白备)。
amd_iommu=off 我这台吃不下那一项官方说值 13–16% prefill,但我这台上开了就 sdma0 硬件超时(4 次挂死 vs 保持 iommu=pt 的 0 次)。不靠它官方数字一样达标,所以保持 iommu=pt。
另外 rootless podman 会直接挂住不动(ulimit -l 硬限制只有 15.6 GiB,而引擎要 pin 68 GiB),必须 rootful + --ulimit memlock=-1:-1。
| 路线 | 速度 |
|---|---|
| HuggingFace 走代理 | 7.5 MB/s(单连接),并发直接挂死 0 |
| hf-mirror.com 直连 + aria2c 16 连接 | 122 MiB/s |
118 GiB 十七分钟。两个坑:huggingface_hub 默认的 Xet 后端在代理下会静默卡死(不报错也不下载),要设 HF_HUB_DISABLE_XET=1;hf-mirror 会 302 到 Xet CDN,aria2 会按 blob 哈希命名文件,得显式 -o。
只下两个文件:qwen38-flash-next-w4b.hgn(115.55 GiB)+ qwen38-flash-next-w4b.overlay.hgn(2.40 GiB,质量 sidecar,引擎自动加载,必须留)。下完对 HF API 的 sha256 校验一下,我这边三个文件全 OK。
引擎启动会自己算账:
memory: 68.0 GiB weights locked + 5.1 GiB KV pool + 21.3 GiB working = 94.4 GiB in all
host memory left for everything else: 3414 contiguous 2 MiB blocks (13.3 GiB)
free(1) 会报成 79.8 GiB —— 内核把锁定的权重当成可回收缓存,实际不可回收
信引擎这行,别信 free。 我这台 free 报 79 GiB available,实际可用只有 13 GiB。
KV pool 一定要按需求降。 默认是 2×ctx,我一开始用默认,KV 吃了 11 GiB,宿主 free 掉到 1.2 GiB。注意 pool 不能小于 HALOGEN_CTX,只改 pool 会被引擎夹回原值,得两个一起降(就是上面配置里的 HALOGEN_CTX=184320 + HALOGEN_KV_POOL_POSITIONS=184320)。降完 KV 从 11 → 5.1 GiB,重启后宿主 free 回到 5.9 GiB。
顺手纠正一个流传的说法:HALOGEN_MAX_TOK 是单次 prefill 的分片大小(默认 32768,文档明确警告不要调),不是输出预算;输出预算是 HALOGEN_MAX_TOKENS_DEFAULT。另外 token 预算包含思考——预算用完不是截短回答,是 finish_reason: "length" + 空 content(思考在 reasoning_content 里,大部分客户端不显示)。先看 finish_reason 再骂模型。
vision 我开了也实测过(发一张纯色图问颜色,答「红色」)。reasoning_effort 我设 medium,默认的 xhigh 在 agent 长链任务上思考太久,体感拖沓。
94.4 GiB 常驻之后还剩十来 G,正好塞一个 embedding + 一个 whisper(Qwen3-Embedding-8B + large-v3-turbo,都跑在 GPU 上),知识库和语音识别就都有了。这样一台 MS-S1 就是个完整的个人 AI Agent 基座——Hermes 或者 DSH 直接连微信、QQ 之类,能当个人助理使了。
门槛不在装,在那几个参数。先把你 cmdline 里的祖传参数清干净,尤其 amdgpu.sched_policy=2 和 amdgpu.cwsr_enable=0。
感谢论坛几位老哥的实测帖,省了我大量试错。有同机型的兄弟要抄配置,cmdline 和容器参数照上面来就行。
结论一句话,prefill和decode都不如 syv-ai/HyperQwen 。 3090单卡还是选这个方案吧
双卡3090 vLLM跑Qwen3.6-27B,强烈建议关注: https://github.com/noonghunna/club-3090 。
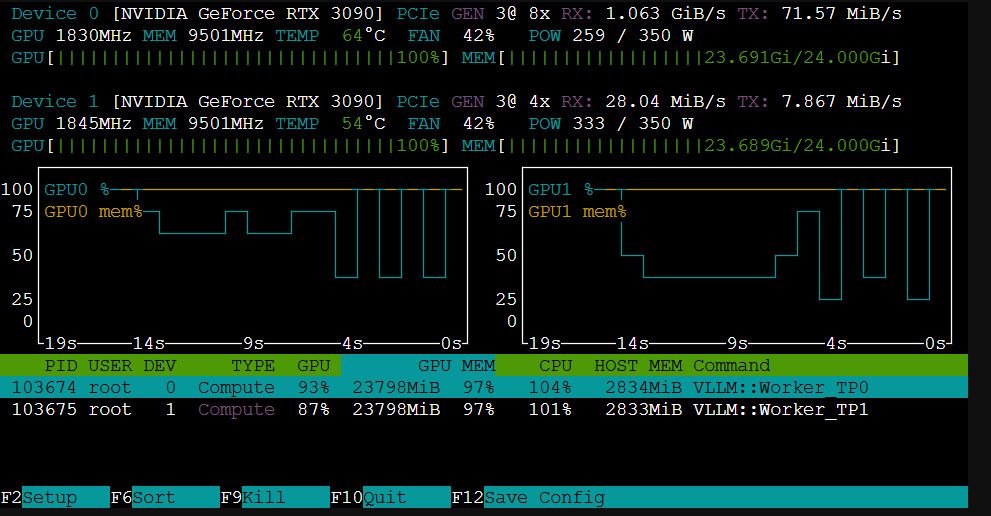
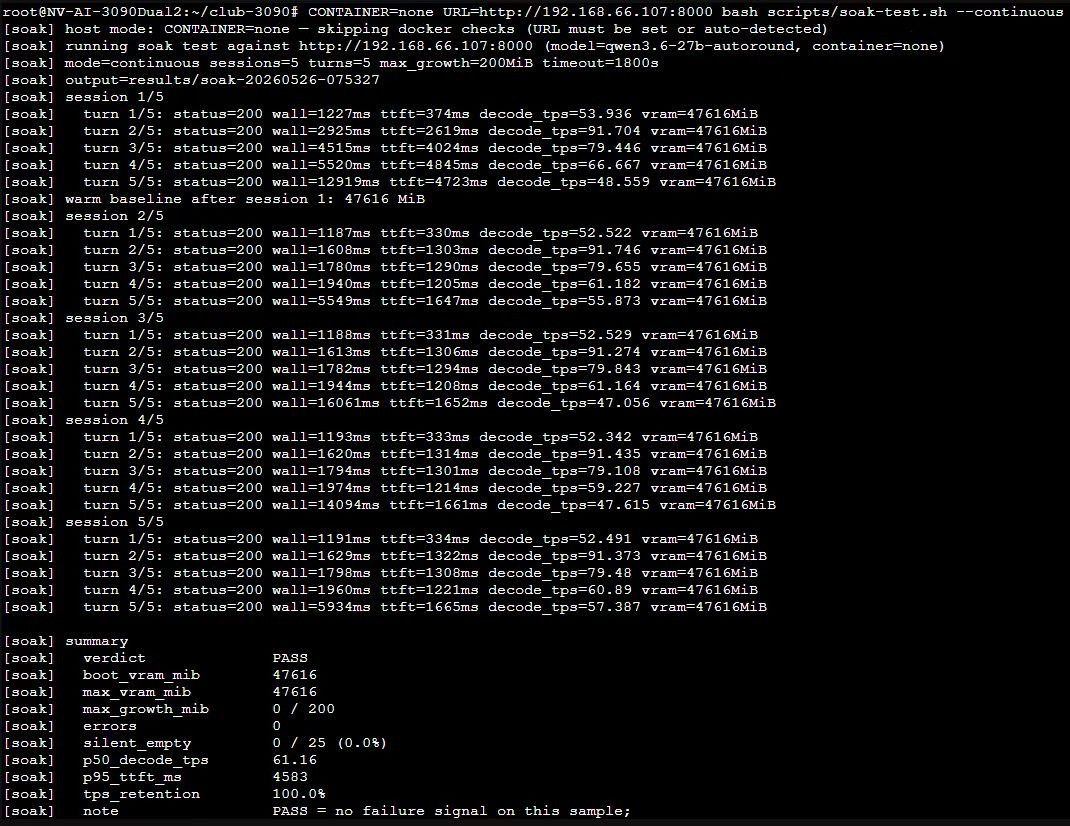
我自己的环境: 双卡3090 nvlink,模型Qwen3.6-27B-autoround-int4。 kv cache fp8_e5m2量化, 上下文长度 262144 。采用 dual-mtp 的vllm运行参数和测试脚本(soak-test.sh), p50_decode_tps:61.34;p95_ttft_ms:4864 。
官方给的测试,应该能到接近70tps,我的还有优化空间,但是能用了就没折腾,参考DUAL_CARD.md。
num_speculative_tokens我测了2,3,4,5。效果上3最好。
启动脚本:
root@NV-AI-3090Dual2:~# cat vllm.qwen3.6-27b.sh
#!/bin/bash
source /root/.bashrc
source /root/venv/bin/activate
# vLLM 启动脚本 — Qwen3.6-27B-AutoRound-INT4
# 用法: bash start-vllm-qwen3.6.sh [TP] [PP]
#   TP: tensor-parallel size,默认 2
#   PP: pipeline-parallel size,默认 1

set -e

# ========== 参数 ==========
TP="${1:-${TP:-2}}"
PP="${2:-${PP:-1}}"
MODEL_PATH="/root/models/qwen3.6-27b-autoround-int4"
PORT="${PORT:-8000}"
HOST="${HOST:-0.0.0.0}"
MAX_MODEL_LEN="${MAX_MODEL_LEN:-262144}"
GPU_MEM_UTIL="${GPU_MEMORY_UTILIZATION:-0.92}"
KV_CACHE_DTYPE="${KV_CACHE_DTYPE:-fp8_e5m2}"
TEMP="${TEMP:-${TEMPERATURE:-0.6}}"
TOP_P="${TOP_P:-0.95}"
TOP_K="${TOP_K:-20}"
MIN_P="${MIN_P:-0.0}"
REPEAT_PENALTY="${REPEAT_PENALTY:-1.0}"

# speculative decoding
SPECULATIVE_CONFIG='{"method":"mtp","num_speculative_tokens":3}'

# 推理模板参数(关闭 thinking)
CHAT_TEMPLATE_KWARGS='{"enable_thinking": false}'

# ========== 环境变量 ==========
export NVIDIA_VISIBLE_DEVICES="${NVIDIA_VISIBLE_DEVICES:-all}"
export HUGGING_FACE_HUB_TOKEN="${HF_TOKEN:-}"
export VLLM_WORKER_MULTIPROC_METHOD=spawn
export NCCL_CUMEM_ENABLE=0
export NCCL_P2P_DISABLE=0
export VLLM_NO_USAGE_STATS=1
export VLLM_USE_FLASHINFER_SAMPLER=1
export OMP_NUM_THREADS=1
export PYTORCH_CUDA_ALLOC_CONF="expandable_segments:True,max_split_size_mb:512"

# NVLink 检测(自行补充 detect_nvlink.sh 逻辑,或删掉这两行)
# source /etc/club3090/detect_nvlink.sh
# _NVLINK_ENABLED=0  # 手动设置:0=无NVLink, 1=NvLink开启

# ========== 构建命令 ==========
ARGS=(
    --model "$MODEL_PATH"
    --served-model-name qwen3.6-27b-autoround
    --quantization auto_round
    --dtype float16
    --tensor-parallel-size "$TP"
    --pipeline-parallel-size "$PP"
    --max-model-len "$MAX_MODEL_LEN"
    --gpu-memory-utilization "$GPU_MEM_UTIL"
    --max-num-seqs 2
    --max-num-batched-tokens 8192
    --kv-cache-dtype "$KV_CACHE_DTYPE"
    --trust-remote-code
  #  --chat-template "${CHAT_TEMPLATE}"      # 没有自定义模板文件则删除此行
    --reasoning-parser qwen3
    --default-chat-template-kwargs "$CHAT_TEMPLATE_KWARGS"
    --enable-auto-tool-choice
    --tool-call-parser qwen3_coder
    --enable-prefix-caching
    --enable-chunked-prefill
    --disable-custom-all-reduce
    --speculative-config "$SPECULATIVE_CONFIG"
    --override-generation-config "{\"temperature\":${TEMP},\"top_p\":${TOP_P},\"top_k\":${TOP_K},\"min_p\":${MIN_P},\"repetition_penalty\":${REPEAT_PENALTY}}"
    --host "$HOST"
    --port "$PORT"
)

echo "=========================================="
echo "启动 vLLM | TP=$TP PP=$PP | $MODEL_PATH"
echo "=========================================="
echo "命令: vllm serve ${ARGS[*]}"
echo ""

exec vllm serve "${ARGS[@]}"
deactivate
@kos-or 不会,看这个帖子里的对比: https://lcz.me/topic/1659
decode 短上下文差不多,prefill慢很多,越长越慢。
halogen是闭源专门优化的模型,等他出针对27B模型的版本把,或许会好一点。不过稠密模型全参数活跃,感觉也不会好到哪里去。
NInfer 在论坛里火了一阵(原帖 讲的是它把 NInfer 移植到 SM86),
我机器上有一张 3090,原本跑的是调优过的 vLLM 栈,这次把服务换到 NInfer 上,看看到底能到什么程度、跟原来差多少。
别人写过的背景不重复,这篇只写我这台机器的数字、能直接抄的配置,以及那几个不改就起不来的参数。
| 显卡 | 单张 RTX 3090 24G(SM86),功耗墙 300W(这卡默认 350W,影响见测评) |
| 驱动 | 595.71.05 |
| 引擎 | NInfer-3090 v0.6.1(官方 Linux x64 预编译包) |
| 权重 | neroued/Qwen3.8-27B-NInfer @ revision 18dfc887(container v2,18.2 GB) |
| 部署 | Docker(CUDA 12.8 runtime 底座 + 官方预编译二进制) |
HF 仓库的 qwen3_8_27b.ninfer 在 2026-09-15 升级成 container v3,而 v0.6.1 的预编译二进制只认 v1/v2 容器,
直接下 main 会报 artifact magic is not NInfer v1 or v2。钉到 v2 容器那个 revision:
curl -L -C - --fail -o qwen3_8_27b.ninfer \
  "https://huggingface.co/neroued/Qwen3.8-27B-NInfer/resolve/18dfc887423fa5aabf3cb56fac41490e462b3fab/qwen3_8_27b.ninfer"
# 18,210,531,328 B   sha256 eec39564993d6e9c7d5e383382a760f093465c9d163ec9a1bd6b80199514bf3e
上游只发 Dockerfile(源码 245 步 CUDA 编译)和预编译二进制,没有现成镜像(GHCR 上这个包匿名拉取是 DENIED)。
最省事的路:拿官方 Linux x64 预编译包塞进官方 CUDA runtime 底座。
FROM nvidia/cuda:12.8.0-runtime-ubuntu24.04
# GeForce 卡不能用 forward-compat 的新 libcuda,不删会在启动时报 cudaErrorCompatNotSupportedOnDevice
RUN rm -rf /usr/local/cuda-12.8/compat /usr/local/cuda/compat
RUN apt-get update && apt-get install -y --no-install-recommends ca-certificates curl \
    && rm -rf /var/lib/apt/lists/*
COPY ninfer /usr/local/bin/ninfer
COPY ninfer-serve /usr/local/bin/ninfer-serve
ENTRYPOINT ["ninfer-serve"]
预编译包:ninfer-rtx3090-linux-x64-0.6.1-rtx3090.tar.gz
(sha256 eb6a6e5b4b318dcf5a8173ccdae8d98acbe730606a50d87eaf120353962965b5),解包后两个二进制就是全部。
docker run -d --name ninfer --gpus '"device=0"' --ipc=host -p 18020:18020 \
  -v $PWD/models:/models:ro ninfer-3090:0.6.1 \
  /models/qwen3_8_27b.ninfer \
  --host 0.0.0.0 --port 18020 --model-id qwen3.8-27b --api-key "$KEY" \
  --max-context 184320 --kv-capacity 184320 \
  --max-concurrency 2 --max-pending-requests 16 --pending-timeout-ms 900000 \
  --prefill-chunk 1024 --kv-dtype rk8v4 --spec mtp --draft-tokens 3 --lm-head-draft
| 参数 | 为什么必须这么写 |
|---|---|
--kv-capacity 184320(显式) |
auto 在 C2 + MTP3 下直接拒绝启动:引擎最小运行时 6.68 GiB + 1 GiB 自动余量 > 权重加载后剩下的 6.63 GiB |
--pending-timeout-ms 900000 |
默认超时下,C2 的第二个长上下文请求会在排队时 error inference request expired while waiting for admission |
--kv-dtype rk8v4 |
int8 的 KV 在 C2 下最多只能开到 160K;rk8v4(K8/V4)能到 180K,实测两者速度没有差别 |
不加 --vision |
开视觉要多占约 2.1 GiB,C2 下上下文从 180K 掉到 136K(余量只剩 48 MiB) |
显存账(这张 24G 卡):权重 16.67 GiB + KV 池(184320 token)5.61 GiB,模型加载 19 秒,启动后余量 1.02 GiB。
踩坑一句话版:v3 模型读不了(要钉 revision)、
kv-capacity auto起不来(要显式)、fp8KV 在 SM86 上被引擎拒绝(没有对应内核)、长上下文 C2 第二个请求会排队超时(要调大 pending timeout)、开 vision 只能 136K。
划重点:单张 3090 上,180K 上下文 + 4bit KV(rk8v4) + C2 并发 + 关 vision 是反复对比后的最佳组合。
再往上加要么牺牲并发(C1),要么牺牲上下文(开 vision 只到 136K),要么牺牲速度(int8 + 关投机解码换 180K,但 decode 掉到 35 tok/s)。
测试条件:单个 Docker 实例、--max-concurrency 2、--kv-dtype rk8v4、MTP3 投机解码、默认采样、
输入是真实长度的中英混合上下文(coding = 一整段代码 + 改代码要求;agent = 系统提示 + 工具定义 + 多轮工具返回 + 提问),
每条请求最多生成 160 token。输入超过约 90K 时一个 180K 的 KV 池装不下两份,那两行是单请求(表里并发列写 1)。
功耗墙 300W(这台的设置;卡默认 350W)。满载实测:
| 功耗 | SM 频率 | 温度 | |
|---|---|---|---|
| 满载(util > 60%,n=43 采样) | avg 298 W / max 300 W(贴墙) | avg 1538 MHz(1395–1665) | 74 °C |
放开到 350W 实测 decode +8%(54.6 → 59.0 tok/s,SM 1410 → 1545 MHz),我为了控温没放。
| 输入 token | 并发 | TTFT | prefill | decode/路 | decode 合计 | MTP 接受率 | 功耗 avg/max |
|---|---|---|---|---|---|---|---|
| 8,359 | 2 | 9.2s / 19.0s | 903 tok/s | 35.7 / 38.2 tok/s | 74 tok/s | 48.2% | 292 / 300 W |
| 32,305 | 2 | 39.1s / 80.1s | 823 tok/s | 43.3 / 46.6 tok/s | 90 tok/s | 58.3% | 294 / 300 W |
| 64,233 | 2 | 87.2s / 177.5s | 736 tok/s | 55.3 / 47.7 tok/s | 103 tok/s | 54.1% | 297 / 300 W |
| 128,089 | 1 | 209.8s | 611 tok/s | 51.5 tok/s | 52 tok/s | 66.7% | 295 / 300 W |
| 173,832 | 1 | 319.6s | 544 tok/s | 41.1 tok/s | 41 tok/s | 52.2% | 296 / 300 W |
| 输入 token | 并发 | TTFT | prefill | decode/路 | decode 合计 | MTP 接受率 | 功耗 avg/max |
|---|---|---|---|---|---|---|---|
| 8,533 | 2 | 9.6s / 19.8s | 884 tok/s | 66.8 / 67.6 tok/s | 134 tok/s | 98.2% | 290 / 300 W |
| 33,057 | 2 | 40.5s / 82.0s | 815 tok/s | 79.5 / 77.9 tok/s | 157 tok/s | 98.2% | 296 / 300 W |
| 65,829 | 2 | 90.1s / 181.2s | 730 tok/s | 74.8 / 73.6 tok/s | 148 tok/s | 98.2% | 296 / 300 W |
| 131,419 | 1 | 217.5s | 605 tok/s | 63.2 tok/s | 63 tok/s | 96.3% | 296 / 300 W |
| 178,335 | 1 | 331.6s | 538 tok/s | 58.9 tok/s | 59 tok/s | 96.3% | 296 / 300 W |
同一张卡、同一个模型(Qwen3.8-27B W4A16),我上一版跑的是 syv-ai/HyperQwen 系的 vLLM 栈
(那套打了四十多个补丁 + 自定义 int8 预填注意力内核,不是原生 vLLM 开箱),本机实测:
| 输入长度 | 1K | 4K | 16K | 64K | 100K+ |
|---|---|---|---|---|---|
| vLLM(INT8 激活路径) | 2,056 | 2,170 | 1,965 | 1,412 | 1,161@100K、934@178K |
| ninfer(这篇) | ~920 | ~920 | 892@20K | 736 | 611@128K、544@178K |
单流 decode 同理:vLLM 那套 110–118 tok/s,ninfer 41–59 tok/s。两个方向都差大约一倍。
原因不是 ninfer 写得烂,是两条算力路径的物理上限差 2 倍。 27B dense 每 prefill 一个 token 约 54 GFLOP:
| 用的单元 | 3090 上的算力 | 理论上限 | 实测达到 | |
|---|---|---|---|---|
| ninfer | 反量化 → FP16 tensor core | 71 TFLOPS | ~1,315 tok/s | 925(70%) |
| vLLM | INT8 tensor core(激活也量化) | 142 TOPS | ~2,630 tok/s | 2,170(82%) |
ninfer 已经把 FP16 这条路吃到七成。我把 --prefill-chunk 从 512 扫到 3584(911 / 925 / 927 / 925 tok/s),
没有可调余量;它的权重是 4–6 bit 混合精度、激活是 FP16,所以只能走 FP16 MMA。
想翻倍得让激活也走 int8,而 ninfer 现在没有这个开关(--kv-dtype 只管 KV cache)。
也正因如此,给它换 int8 权重是负收益 —— decode 是显存带宽瓶颈,权重从 4.6 bit 涨到 8 bit,每步要读的字节多 74%,decode 只会更慢。
顺带对齐第三方数据,ninfer 在 dense 27B 这级别并不难看(llama.cpp CUDA 在 3090 上跑 Qwen3.5-27B Q4_K:
4K 1,104 / 16K 977 / 32K 848 / 64K 679 tok/s):浅上下文它低约 15%,64K 以上反而反超。
网上那些 5,000+ tok/s 的 prefill 数字是 7B 小模型或 3–4B 激活的 MoE,跟 dense 27B 不是一个量级,别被带偏。
所以怎么选:要吞吐、要短提示首字快(IDE agent、批量 API),vLLM 那套明显更强;
要单卡 180K + 双并发 + Anthropic 原生协议 + 部署极简(一个预编译包,无补丁无编译),ninfer 更省事。
我把它定位成"够用的长上下文单卡后端",不拿它跟调优过的 vLLM 比跑分。
官方单用户 71 tok/s 那组数据是 Windows 版跑出来的,README 里写得很清楚:
"A real-artifact Linux generation and Linux performance qualification remain open" —— Linux 二进制没做性能认证。
除去平台差异,我这边的缺口主要在两处:MTP 接受率(2.4 vs 2.83 token/轮)和 功耗墙(300W 把 SM 压在 ~1.5 GHz)。
参数上和官方 C1 示例逐字一致,没有漏开关。
NInfer 在 3090 上确实能用,单卡 180K 上下文 + 双并发当个人 agent 后端够了;
但它的甜区是"上下文长、并发低、部署省事",不是跑分 —— 同卡同模型上,调优过的 vLLM 栈在 prefill 和单流 decode 上都快约一倍,
根因是算力路径(FP16 vs INT8 tensor core),不是实现质量。这点我不粉饰,选它买的是"一个预编译包跑起 180K + Anthropic 协议"。
抄配置的话,把上面那四个参数照抄,尤其 --kv-capacity 显式写 和 --pending-timeout-ms 调大 —— 这两个不改,C2 根本跑不起来。
我第一台自己的PC也是手搓的,2000年 毒龙750+256M内存,20G硬盘。用了5年,最后加到512M内存做archlinux的NAS. 跑了电驴、samba、nfs什么的。记得当时硬盘都是并口,动静老大了,而且还特别烫手。
成绩速览(V100-PCIE-32G / 200W / 单请求)
| 指标 | 最好 | 区间 |
|---|---|---|
| decode | 93.9 tok/s(编码任务,640 token,MTP 接受率 92%) | 44.9–93.9 tok/s(取决于任务与 MTP 接受率) |
| prefill | 1,019.0 tok/s(7.9K prompt) | 505.8–1,019.0 tok/s(随上下文深度衰减) |
| TTFT | 0.13 s(完全相同的 prompt 重发,前缀 100% 命中) | 0.18–0.47 s(短 prompt)→ 1.96 s @2K → 250.27 s @128K |
| 并发 | 2 路各 124.6K 上下文实测跑通 | 第二路排队 4m1.1s(prefill 串行) |
| 显存 | 权重 19.7 GiB + KV 池 262,144 token | 启动后 free 1.21 GiB |
这篇针对 neroued/Qwen3.8-27B-nvfp4-NInfer 这个 nvfp4 制品,写两件事:
① 完整部署流程(含源码锚点、Dockerfile、制品下载校验、启动脚本、报错对照),别人或别人的 agent 照着能直接跑起来;
② 全部实测数字(上下文 / 制品 A/B / 任务类型 / 并发 / 显存容量 / 前缀复用),只列数据,结论很少。
给 agent / 想直接照做的人:把第 3 节那个脚本原样存成
deploy-v100-nvfp4.sh,sudo bash跑完即可(驱动、Docker、CUDA 12.8、编译引擎、打镜像、下制品校验、启动、健康检查全在里面)。
所有锚点都已钉死:引擎 repo + commit、制品 repo + revision + sha256、镜像底座、启动参数。文中标注️ 的四处是必须照做的(非 open 驱动 / v2 容器制品 / 显式
--kv-capacity/--pending-timeout-ms),踩错会直接报错或起不来。
| 项 | 值 |
|---|---|
| GPU | Tesla V100-PCIE-32GB(GV100,Volta SM70,32G HBM2,PCIe Gen3 x16) |
| 形态 | PVE 直通给 Ubuntu 24.04 VM(16 vCPU / 32G RAM / 200G 系统盘) |
| 宿主 CPU | Xeon E5-2697 v4 @2.30GHz ×16(Broadwell,无 AVX-512) |
| 驱动 | 580.178.04(非 open) |
| 功率墙 | 200 W(V100-PCIE 默认 250 W) |
| 引擎 | NInfer V100/sm_70 分支,hamawang/ninfer-v100-20260916 @ f17d37fc98b78cc025a1037e8adb1f4fb83813fb |
| 编译 | CUDA 12.8,-DCMAKE_CUDA_ARCHITECTURES=70 |
| 容器底座 | nvidia/cuda:12.8.0-runtime-ubuntu24.04 |
| 制品 | qwen3_8_27b_nvfp4.ninfer(20.02 GiB,container_version 2) |
| 运行参数 | --max-context 131072 --kv-capacity 262144 --max-concurrency 2 --kv-dtype int8 |
| 实测占用 | 权重 19.7 GiB,KV 池 262,144 token,运行时 10.8 GiB,启动后 free 1.21 GiB,ready 18.2 s |
sudo apt-get install -y "linux-headers-$(uname -r)" nvidia-driver-580-server
sudo modprobe nvidia && nvidia-smi -L
sudo nvidia-smi -pm 1 && sudo nvidia-smi -pl 200
-open 内核模块只支持 Turing 及更新架构,Volta 装上会报not supported by open nvidia.ko ... does not include the required GPU System Processor (GSP)。nvidia-smi -pl 不跨重启保留,需要开机重施(附脚本里给了 systemd oneshot 单元)。git clone https://github.com/hamawang/ninfer-v100-20260916.git /opt/ninfer-v100
cd /opt/ninfer-v100 && git checkout f17d37fc98b78cc025a1037e8adb1f4fb83813fb
# 需要 CUDA 12.8 toolkit(CUDA 13 已移除 Volta 的离线编译)
bash deploy-v100/scripts/build-v100.sh
# = cmake -S . -B build-v100 -G Ninja -DCMAKE_BUILD_TYPE=Release \
# -DCMAKE_CUDA_COMPILER=/usr/local/cuda-12.8/bin/nvcc \
# -DCMAKE_CUDA_ARCHITECTURES=70 -DNINFER_BUILD_BENCHMARKS=ON
# cmake --build build-v100 -j6
产物(可用于校验你自建的二进制,同 commit + CUDA 12.8 + sm_70):
371fd8de37e73df12b1f61144e43b210a12f9c0ef4acc193f5ae3f11f4294658  build-v100/apps/ninfer
6671447e3cbbf07565dff9417462d01bcf8aa1093aa5c9f83fb6a9a0ce79ac10  build-v100/apps/ninfer-serve
底座必须与制品编译时的 CUDA 版本对齐(二进制 RUNPATH 硬指 /usr/local/cuda-12.8/...):
FROM nvidia/cuda:12.8.0-runtime-ubuntu24.04

ARG DEBIAN_FRONTEND=noninteractive

# base 镜像只带 NVIDIA 源、没有 Ubuntu 归档,先换源再装运行库
RUN rm -f /etc/apt/sources.list.d/ubuntu.sources 2>/dev/null; \
    printf '%s\n' \
      'Types: deb' \
      'URIs: https://mirrors.tuna.tsinghua.edu.cn/ubuntu' \
      'Suites: noble noble-updates noble-backports' \
      'Components: main universe restricted multiverse' \
      'Signed-By: /usr/share/keyrings/ubuntu-archive-keyring.gpg' \
      '' \
      'Types: deb' \
      'URIs: https://mirrors.tuna.tsinghua.edu.cn/ubuntu' \
      'Suites: noble-security' \
      'Components: main universe restricted multiverse' \
      'Signed-By: /usr/share/keyrings/ubuntu-archive-keyring.gpg' \
      > /etc/apt/sources.list.d/ubuntu.sources \
    && apt-get update -qq \
    && apt-get install -y --no-install-recommends \
        ca-certificates libavcodec60 libavformat60 libavutil58 \
        libswscale7 libswresample4 libcurl4t64 \
    && rm -rf /var/lib/apt/lists/*

COPY ninfer ninfer-serve /usr/local/bin/
RUN chmod +x /usr/local/bin/ninfer /usr/local/bin/ninfer-serve

WORKDIR /workspace
EXPOSE 8080
CMD ["ninfer-serve", "--help"]
mkdir -p ctx && cp /opt/ninfer-v100/build-v100/apps/{ninfer,ninfer-serve} ctx/
docker build -t ninfer-v100:0.1.0 ctx/
libcuda.so.1 不打进镜像,由 --gpus 从宿主驱动注入(镜像与驱动版本解耦)。
mkdir -p /srv/models && cd /srv/models
curl -L -C - -o qwen3_8_27b_nvfp4.ninfer \
  "https://hf-mirror.com/neroued/Qwen3.8-27B-nvfp4-NInfer/resolve/204e3d92c30d9d05f3300d2f52e443ad1edf6ddf/qwen3_8_27b_nvfp4.ninfer"

# 校验(必须一致,否则说明下错版本)
sha256sum qwen3_8_27b_nvfp4.ninfer
# bb3360522a06e136e0367f5703414d26272b7285c8a6ab6194135c17dbd81b32
| 字段 | 值 |
|---|---|
| repo | neroued/Qwen3.8-27B-nvfp4-NInfer |
| revision(钉死) | 204e3d92c30d9d05f3300d2f52e443ad1edf6ddf(2026-08-19) |
| 文件 / 字节 | qwen3_8_27b_nvfp4.ninfer / 21,492,695,040(20.02 GiB) |
| sha256 | bb3360522a06e136e0367f5703414d26272b7285c8a6ab6194135c17dbd81b32 |
| container_version | 2 |
为什么不能下 main:仓库 main(a107ba1b)上的同名文件是 container v3(23,719,496,192 B),本引擎只认 v2,加载直接失败:
ERROR startup failed | inspecting artifact | 31.4 ms
FATAL server failed during startup | artifact magic is not NInfer v2
容器版本看文件头 8 字节即可判断:
dd if=qwen3_8_27b_nvfp4.ninfer bs=1 count=8 status=none | od -c
# 正确: N I N F E R \0 002
# v3  : N I N F E R \0 003
实测下载速度(HF 官方站不可达时用 hf-mirror):12.4 MB/s,20 GiB 约 29 分钟;
curl -C -支持断点续传。
制品建议放本地盘:本地盘加载 18.2 s,走 NFS 是 52–59 s。
#!/usr/bin/env bash
# ninfer-v100 run.sh —— nvfp4 + 2 并发 × 128K
set -euo pipefail

NAME=ninfer
IMG=ninfer-v100:0.1.0
MODEL_DIR=${MODEL_DIR:-/srv/models}
MODEL=${MODEL:-qwen3_8_27b_nvfp4.ninfer}
PORT=${PORT:-18080}
CTX=${CTX:-131072}          # 单请求逻辑上下文上限
KV_CAP=${KV_CAP:-262144}    # ★ 共享 KV 池,必须显式给 = 2 × CTX
CONC=${CONC:-2}             # 并发路数
PREFILL=${PREFILL:-2048}    # V100 推荐
PENDING_MS=${PENDING_MS:-600000}   # ★ 默认 30s 会把并发长请求挤成 503
API_KEY=${API_KEY:-}        # 留空 = 不鉴权

ARGS=(--host 0.0.0.0 --port 8080
      --max-context "$CTX" --kv-capacity "$KV_CAP" --max-concurrency "$CONC"
      --kv-dtype int8 --prefill-chunk "$PREFILL" --pending-timeout-ms "$PENDING_MS"
      --spec mtp --draft-tokens 3 --lm-head-draft
      --preserve-thinking --cors)
[ -n "$API_KEY" ] && ARGS+=(--api-key "$API_KEY")

case "${1:-start}" in
  start)
    docker rm -f "$NAME" >/dev/null 2>&1 || true
    docker run -d --name "$NAME" --restart unless-stopped \
      --gpus all --ipc=host \
      -e NVIDIA_VISIBLE_DEVICES=all -e NVIDIA_DRIVER_CAPABILITIES=compute,utility \
      -p "${PORT}":8080 -v "$MODEL_DIR":/models:ro \
      "$IMG" ninfer-serve "/models/$MODEL" "${ARGS[@]}"
    echo "started -> http://0.0.0.0:${PORT}"
    ;;
  stop)    docker stop -t 30 "$NAME";;
  logs)    docker logs -f --tail 100 "$NAME";;
  status)  docker ps -a --filter "name=^${NAME}$";;
  *) echo "usage: $0 {start|stop|logs|status}"; exit 1;;
esac
参数说明(都是实测踩出来的)
| 参数 | 为什么是这个值 |
|---|---|
--max-context 131072 |
128K 逻辑上限。超限请求被明确拒绝而不是截断:400 context_length_exceeded: prepared prompt exceeds Engine max_context 131072 |
--kv-capacity 262144 |
必须显式。nvfp4 权重 19.7 GiB 下 auto 只肯给 ~237K,而且 auto 模式要额外留 1 GiB headroom → 直接拒绝启动。显式 262144 正好 = 2×128K,实测启动后 free 1.21 GiB |
--max-concurrency 2 |
引擎真批处理路数。客户端并发超过它会被饿(实测第 3、4 条掉到 5.7 tok/s) |
--kv-dtype int8 |
Volta 没有 fp8 / nvfp4 / k8v4 的 KV 内核,只能 bf16 或 int8 |
--prefill-chunk 2048 |
V100 上的推荐值 |
--pending-timeout-ms 600000 |
默认 30 s。prefill 是单通道串行的,一条 125K prompt 要 prefill 4 分钟,第二路在队列里等超过 30 s 就被判 503 request_queue_timeout |
--spec mtp --draft-tokens 3 --lm-head-draft |
MTP 投机解码;decode 快慢几乎完全由它的接受率决定(见第 2.3 节) |
curl -s localhost:18080/health          # {"status":"ok"}
curl -s localhost:18080/v1/models       # max_model_len = 131072

curl -s localhost:18080/v1/chat/completions -H 'Content-Type: application/json' -d '{
  "model":"qwen3.8-27b",
  "messages":[{"role":"user","content":"只回答两个字:收到"}],
  "max_tokens":16,"reasoning_effort":"none"}' | head -c 200
启动日志里会打出显存账本(--log-level debug 更详细):
INFO  engine ready | qwen3.8-27b/nvfp4 | total 18.2s | weights 19.7 GiB
INFO  capacity | KV 262,144 tokens, int8, explicit | pages 4,096/4,096 | runtime 10.8 GiB | free 1.21 GiB
INFO  listening on http://0.0.0.0:8080 | model qwen3.8-27b | auth disabled
| 现象 | 根因 | 处置 |
|---|---|---|
nvidia-smi: couldn't communicate with the NVIDIA driver / nvtop 看不到卡 |
驱动没装(直通本身没问题,lspci 能看到 10de:1db6) |
装 nvidia-driver-580-server |
not supported by open nvidia.ko ... GPU System Processor (GSP) |
装了 -open 驱动,Volta 不支持 |
换非 open:apt purge "nvidia-*-open" 再装 nvidia-driver-580-server |
cannot open shared object file: libcudart.so.12 |
底座 CUDA 版本与二进制 RUNPATH 不一致 | 底座用 cuda:12.8.0-runtime-ubuntu24.04 |
FATAL ... artifact magic is not NInfer v2 |
下了 v3 容器制品(main 上的那个) | 钉 revision 204e3d92c30d(v2 容器) |
minimum Engine runtime reservation requires … but only … available after weights |
显存不够(auto 模式还要额外 1 GiB) |
显式给 --kv-capacity,并按下表算容量 |
503 request_queue_timeout |
默认 30 s 排队超时 + prefill 串行 | --pending-timeout-ms 600000 |
400 context_length_exceeded |
prompt + 输出超过 --max-context |
调小 prompt 或调大 --max-context(受显存限制,见 2.5) |
统一条件:贪心(temperature=0)、reasoning_effort: none(除注明)、prompt 为同一份技术文档按目标长度拼接;decode = 引擎口径「已提交输出 token / 秒」;TTFT = 服务端 prompt 处理时间(不含排队);功率墙 200 W;负载期功耗中位 195 W、SM 频率中位 1087 MHz(最高 1380 MHz)。
| 目标上下文 | prompt token | prefill tok/s | TTFT | decode tok/s | MTP 接受率 |
|---|---|---|---|---|---|
| 2K | 1,967 | 1,003.5 | 1.96 s | 56.8 | 47%(38/81) |
| 8K | 7,907 | 1,019.0 | 7.76 s | 72.6 | 71%(45/63) |
| 32K | 31,667 | 868.6 | 36.46 s | 57.2 | 60%(45/75) |
| 64K | 63,311 | 699.4 | 90.52 s | 36.2 | 40%(37/93) |
| 128K | 126,599 | 505.8 | 250.27 s | 37.0 | 60%(45/75) |
补充:同一配置下 8K prompt、320 输出上限的持续生成实测 71.5 tok/s(MTP 71%)。
neroued/Qwen3.8-27B-NInfer @ 18dfc887423f(groupwise-int,16.96 GiB,sha256 eec39564993d…4bf3e)作为对照:
| shape | groupwise-int:prefill / decode / MTP | nvfp4:prefill / decode / MTP |
|---|---|---|
| 1K | 987.9 / 41.8 / 51% | 1,003.5 / 56.8 / 47% |
| 7K | 1,014.0 / 43.3 / 58% | 1,019.0 / 72.6 / 71% |
| 30K | 864.7 / 42.4 / 65% | 868.6 / 57.2 / 60% |
| 61K | 696.3 / 31.3 / 52% | 699.4 / 36.2 / 40% |
| 123K | 505.9 / 29.5 / 63% | 505.8 / 37.0 / 60% |
| 编码任务(640 tok,两边 MTP 都 89%) | 115.2 / 58.6 / 89% | 119.5 / 90.9 / 89% |
| 持续生成(8K,66 tok) | 951.1 / 41.6 / 58% | 954.5 / 71.5 / 71% |
| 双并发(8K,均缓存命中) | 批 wall 3.84 s / 188 tok / 48.9 tok/s | 批 wall 2.55 s / 152 tok / 59.7 tok/s |
上下文扫描那几行的 decode 不能直接横向比:权重不同 → 生成的文本不同 → MTP 接受率不同(40% vs 52% 之类),短样本下接受率差异会盖过真实速度差。编码任务那行是干净的(prompt、输出长度 640、贪心、MTP 接受率 464/523 vs 467/525 全部对齐):58.6 → 90.9 tok/s。
注:这张表的数字来自成对跑的那一轮;同一 prompt 在 2.3 节另一轮里测得 93.4/93.9 tok/s(MTP 91–92%),两轮差异属运行间波动(同一制品重跑 ±3%)。
| 任务 | 输出 token | 8K:decode / MTP | 64K:decode / MTP |
|---|---|---|---|
| 写代码(LRU + pytest) | 640 | 93.4 / 91% | 93.9 / 92% |
| JSON 字段抽取 | 24 | 82.7 / 90% | 82.7 / 90% |
| 摘要(5.9K 文档) | 56 | 81.2 / 81% | 81.4 / 81% |
| 翻译 | 48 | 78.7 / 76% | 78.3 / 76% |
推理(effort=xhigh,1024 思考 token) |
1024 | 70.8 / 61% | 70.6 / 61% |
| 找 bug 根因(闭包 late-binding) | 253 | 68.8 / 57% | 68.8 / 57% |
| 闲聊 | 92 | 55.8 / 42% | 55.9 / 42% |
| 写小说 | 257 | 44.9 / 26% | 47.5 / 31% |
TTFT 方面:短 prompt(几十 token)在 8K 与 64K 档几乎无差别(0.09–0.47 s),只有 5.9K 文档摘要那档是 5.8 s。
(a)双并发长上下文(本机生产配置实测,2 路各 ~125K)
| 路 | prompt token | TTFT(服务端) | 其中排队 | prefill tok/s | 输出 | wall |
|---|---|---|---|---|---|---|
| L1 | 124,632 | 241.0 s | 0 | 517 | 61 | 319.9 s |
| L2 | 124,632 | 247.6 s(引擎记 8m8.7s) | 4 m 1.1 s | 503 | 61 | 490.9 s |
(b)解码批处理(引擎 5 s 窗口口径,groupwise 制品同引擎测得)
| batch | 聚合 decode tok/s | 相对 batch=1 |
|---|---|---|
| 1.00 | 60.4 | 1.00× |
| 2.00 | 87.2 | 1.44× |
| 3.98 | 126.8 | 2.10× |
(c)端到端(每路冷启动 8K prompt + 320 输出 token,groupwise 制品)
| 服务端并发 | 客户端路数 | 单路端到端 | 聚合端到端 | 加速比 |
|---|---|---|---|---|
| 2 | 1 | 24.4 tok/s | 24.4 | 1.00× |
| 2 | 2 | 24.0–24.6 | 26.5–27.2 | 1.11× |
| 4 | 4 | 23.9 | 29.3 | 1.22× |
(d)服务端日志里的两个并发现象(原文)
# prefill 单通道串行:任一瞬间只有 1 路在 prefill,其他在等
throughput | 5.0s | prefill 409.6 tok/s (2,048 tok) | running 1 (prefill 1) | waiting 1 | host 53.9%

# prefill 会饿死 decode:有 prefill 时 decode 掉到个位数
throughput | 5.0s | prefill 819.2 tok/s (4,096 tok) | decode  3.2 tok/s | running 3 (prefill 1, decode-ready 2) | batch 2.00
throughput | 5.0s |                              | decode 126.8 tok/s | running 4 (decode-ready 4)              | batch 3.98
用失败报错反解出的引擎显存公式(32G V100,int8 KV,MTP3):
运行时占用 = 2.75 GiB(固定:state 槽 + workspace + CUDA graph) + KV 池容量 × 35,904 B
权重后可用显存:nvfp4 11.70 GiB / groupwise-int 14.75 GiB
实测容量上限(--max-concurrency 2,容量需为 64 的倍数,均为「能启动 + 能跑通请求」验证过的值):
| groupwise-int | nvfp4 | |
|---|---|---|
| 权重 | 16.7 GiB | 19.7 GiB |
| 权重后可用 | 14.75 GiB | 11.70 GiB |
--kv-capacity auto |
328,960 token |  拒绝启动(差 0.88 GiB) |
| 最大共享池 | 358,912 token | 267,456 token |
| 双并发每路可用 | ≈179K | ≈130K |
| 2×160K(池需 327,680) |  余 31,232 |
差 2.01 GiB;关掉 graph + state 槽也只省 622 MiB,仍差 1.40 GiB |
单请求边界(--max-context 131072):
HTTP 400 {"error":{"code":"context_length_exceeded",
  "message":"prepared prompt exceeds Engine max_context 131072", ...}}
(同一组测量:16K 文档,prompt 15,846–15,886 token,同引擎)
| 场景 | prompt token | 命中前缀 token | TTFT |
|---|---|---|---|
| 冷请求 | 15,846 | 0 | 16.47 s |
| 完全相同请求重发 | 15,846 | 15,839(100%) | 0.13 s |
| 同 prompt、只改 max_tokens(64 → 256) | 15,846 | 15,839(100%) | 0.13 s |
| prompt 后追加一句(Chat Completions) | 15,855 | 0 | 16.72 s |
| 同正文、换会话编号 | 15,846 | 0 | 16.80 s |
显式 prompt_cache_breakpoint 写入后再追加读取 |
15,855 | 0 | 17.00 s |
Anthropic cache_control 写入 → 追加读取 |
15,886 | 15,879 | 1.65 s |
Responses API previous_response_id 续轮 |
— | 15,917 | 1.17 s |
| 项 | 值 |
|---|---|
| 功率墙 | 200 W(默认 250 W,可设 100–250) |
| 负载期功耗 | 中位 195 W,最高 228 W |
| 负载期 SM 频率 | 中位 1087 MHz,最高 1380 MHz(卡的最大 SM 时钟即 1380) |
| 空载 | 37–40 °C / 约 60 W |
| PCIe | Gen3 x16(8 GT/s),非瓶颈 |
#!/usr/bin/env bash
# ============================================================
#  NInfer + Qwen3.8-27B (nvfp4) @ Tesla V100-PCIE-32GB
#  CUDA 12.8 / sm_70 / Docker / 200W / 2 并发 × 128K
#  用法: sudo bash deploy-v100-nvfp4.sh
# ============================================================
set -euo pipefail
MODEL_DIR=${MODEL_DIR:-/srv/models}
PORT=${PORT:-18080}; CTX=${CTX:-131072}; KV_CAP=${KV_CAP:-262144}
CONC=${CONC:-2};   POWER_LIMIT=${POWER_LIMIT:-200}
SRC_DIR=${SRC_DIR:-/opt/ninfer-v100}; CUDA_ROOT=${CUDA_ROOT:-/usr/local/cuda-12.8}
REPO=https://github.com/hamawang/ninfer-v100-20260916.git
COMMIT=f17d37fc98b78cc025a1037e8adb1f4fb83813fb
ART_URL=https://hf-mirror.com/neroued/Qwen3.8-27B-nvfp4-NInfer/resolve/204e3d92c30d9d05f3300d2f52e443ad1edf6ddf/qwen3_8_27b_nvfp4.ninfer
ART_SHA=bb3360522a06e136e0367f5703414d26272b7285c8a6ab6194135c17dbd81b32
IMG=ninfer-v100:0.1.0
step(){ echo; echo "==== $* ===="; }

step "1/6 NVIDIA 驱动(非 open)+ 功率墙"
if ! command -v nvidia-smi >/dev/null 2>&1; then
  apt-get update -qq && apt-get install -y "linux-headers-$(uname -r)" nvidia-driver-580-server
  modprobe nvidia 2>/dev/null || { echo "驱动已装,请重启后重新运行本脚本"; exit 0; }
fi
nvidia-smi -L
nvidia-smi -pm 1 && nvidia-smi -pl "$POWER_LIMIT"
# 功率墙不跨重启,落一个开机单元
cat > /usr/local/bin/nvidia-powerlimit.sh <<'EOF'
#!/bin/bash
for _ in $(seq 1 60); do nvidia-smi -L >/dev/null 2>&1 && break; sleep 5; done
nvidia-smi -pm 1 >/dev/null 2>&1 || true
nvidia-smi -pl "${1:-200}"
EOF
chmod +x /usr/local/bin/nvidia-powerlimit.sh

step "2/6 Docker + nvidia-container-toolkit"
if ! command -v docker >/dev/null 2>&1; then
  install -m 0755 -d /etc/apt/keyrings
  curl -fsSL https://mirrors.tuna.tsinghua.edu.cn/docker-ce/linux/ubuntu/gpg \
    | tee /etc/apt/keyrings/docker.asc >/dev/null && chmod a+r /etc/apt/keyrings/docker.asc
  echo "deb [arch=amd64 signed-by=/etc/apt/keyrings/docker.asc] https://mirrors.tuna.tsinghua.edu.cn/docker-ce/linux/ubuntu $(. /etc/os-release; echo "$VERSION_CODENAME") stable" \
    > /etc/apt/sources.list.d/docker.list
  apt-get update -qq && apt-get install -y docker-ce docker-ce-cli containerd.io
fi
if ! command -v nvidia-ctk >/dev/null 2>&1; then
  apt-get update -qq && apt-get install -y nvidia-container-toolkit || {
    curl -fsSLO https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-keyring_1.1-1_all.deb
    dpkg -i cuda-keyring_1.1-1_all.deb && apt-get update -qq && apt-get install -y nvidia-container-toolkit; }
fi
nvidia-ctk runtime configure --runtime=docker
systemctl enable --now docker && systemctl restart docker

step "3/6 CUDA 12.8 toolkit(编译引擎)"
if [ ! -x "$CUDA_ROOT/bin/nvcc" ]; then
  curl -fsSLO https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2404/x86_64/cuda-keyring_1.1-1_all.deb
  dpkg -i cuda-keyring_1.1-1_all.deb && apt-get update -qq
  apt-get install -y cuda-toolkit-12-8
fi
"$CUDA_ROOT/bin/nvcc" --version | tail -1

step "4/6 构建引擎"
if [ ! -x "$SRC_DIR/build-v100/apps/ninfer-serve" ]; then
  command -v cmake >/dev/null 2>&1 && command -v ninja >/dev/null 2>&1 || apt-get install -y cmake ninja-build git
  [ -d "$SRC_DIR/.git" ] || git clone "$REPO" "$SRC_DIR"
  git -C "$SRC_DIR" checkout "$COMMIT"
  ( cd "$SRC_DIR" && CUDA_ROOT="$CUDA_ROOT" bash deploy-v100/scripts/build-v100.sh )
fi
sha256sum "$SRC_DIR"/build-v100/apps/ninfer "$SRC_DIR"/build-v100/apps/ninfer-serve

step "5/6 打镜像 + 下制品"
CTXDIR=$(mktemp -d)
cp "$SRC_DIR"/build-v100/apps/{ninfer,ninfer-serve} "$CTXDIR"/
cat > "$CTXDIR/Dockerfile" <<'EOF'
FROM nvidia/cuda:12.8.0-runtime-ubuntu24.04
ARG DEBIAN_FRONTEND=noninteractive
RUN rm -f /etc/apt/sources.list.d/ubuntu.sources 2>/dev/null; \
    printf '%s\n' 'Types: deb' 'URIs: https://mirrors.tuna.tsinghua.edu.cn/ubuntu' \
      'Suites: noble noble-updates noble-backports' 'Components: main universe restricted multiverse' \
      'Signed-By: /usr/share/keyrings/ubuntu-archive-keyring.gpg' '' \
      'Types: deb' 'URIs: https://mirrors.tuna.tsinghua.edu.cn/ubuntu' 'Suites: noble-security' \
      'Components: main universe restricted multiverse' \
      'Signed-By: /usr/share/keyrings/ubuntu-archive-keyring.gpg' \
      > /etc/apt/sources.list.d/ubuntu.sources \
    && apt-get update -qq \
    && apt-get install -y --no-install-recommends ca-certificates \
        libavcodec60 libavformat60 libavutil58 libswscale7 libswresample4 libcurl4t64 \
    && rm -rf /var/lib/apt/lists/*
COPY ninfer ninfer-serve /usr/local/bin/
RUN chmod +x /usr/local/bin/ninfer /usr/local/bin/ninfer-serve
WORKDIR /workspace
EXPOSE 8080
EOF
docker build -t "$IMG" "$CTXDIR"
mkdir -p "$MODEL_DIR"
if [ ! -f "$MODEL_DIR/qwen3_8_27b_nvfp4.ninfer" ]; then
  curl -L -C - -o "$MODEL_DIR/qwen3_8_27b_nvfp4.ninfer" "$ART_URL"
fi
echo "$ART_SHA  $MODEL_DIR/qwen3_8_27b_nvfp4.ninfer" | sha256sum -c -

step "6/6 启动"
docker rm -f ninfer >/dev/null 2>&1 || true
docker run -d --name ninfer --restart unless-stopped --gpus all --ipc=host \
  -e NVIDIA_VISIBLE_DEVICES=all -e NVIDIA_DRIVER_CAPABILITIES=compute,utility \
  -p "${PORT}":8080 -v "$MODEL_DIR":/models:ro "$IMG" \
  ninfer-serve /models/qwen3_8_27b_nvfp4.ninfer \
    --host 0.0.0.0 --port 8080 \
    --max-context "$CTX" --kv-capacity "$KV_CAP" --max-concurrency "$CONC" \
    --kv-dtype int8 --prefill-chunk 2048 --pending-timeout-ms 600000 \
    --spec mtp --draft-tokens 3 --lm-head-draft --preserve-thinking --cors
for i in $(seq 1 40); do
  [ "$(curl -s -o /dev/null -w '%{http_code}' "http://127.0.0.1:${PORT}/health" || true)" = 200 ] \
    && { echo "就绪: http://127.0.0.1:${PORT}/v1  (model id: qwen3.8-27b)"; exit 0; }
  sleep 5
done
echo "未就绪,看日志: docker logs ninfer"; exit 1
开机自启:容器带 --restart unless-stopped 即可;功率墙用上面那个脚本挂一个 oneshot 单元:
# /etc/systemd/system/nvidia-powerlimit.service
[Unit]
Description=Lock V100 power limit
After=systemd-modules-load.service
Before=docker.service
[Service]
Type=oneshot
RemainAfterExit=yes
ExecStart=/usr/local/bin/nvidia-powerlimit.sh 200
[Install]
WantedBy=multi-user.target
Rustdesk我一直在用效果不错。建议自架服务,不要用官方服务,安全第一。
内网穿透,方案很多了,我现在是手机ipv6的wireguard穿回来;如果你传大文件,建议用vmess这种伪装的协议,我架了一个vmess的ws,放在ipv6的网站下,作为传大文件和wg的备用。wg是基于udp的,用的多了容易被运营商卡速度,vmess+ws基于tcp没有这个问题。
如果不愿意用ipv6或者嫌不方便,可以考虑nat打洞,具体youtube上各大博主都有介绍,嫌麻烦就cloudflare,不怕麻烦就弄个小水管的vps做信息中转。我实测nat打洞还是挺方便的,各种网络环境都能回来。 cloudflare反代方案好在不用改端口,但是速度不太行,小流量延时不敏感的可以考虑。
两张nvlink我跑过,用的club-3090的vllm docker. 之前发过一片朋友圈如下:
双卡3090+nvlink,模型Qwen3.6-27B-autoround-int4。 kv cache fp8_e5m2, 上下文长度 262144 。采用 club-3090 的vllm运行参数和测试脚本 soak-test.sh, p50_decode_tps:61.34;p95_ttft_ms:4864 。
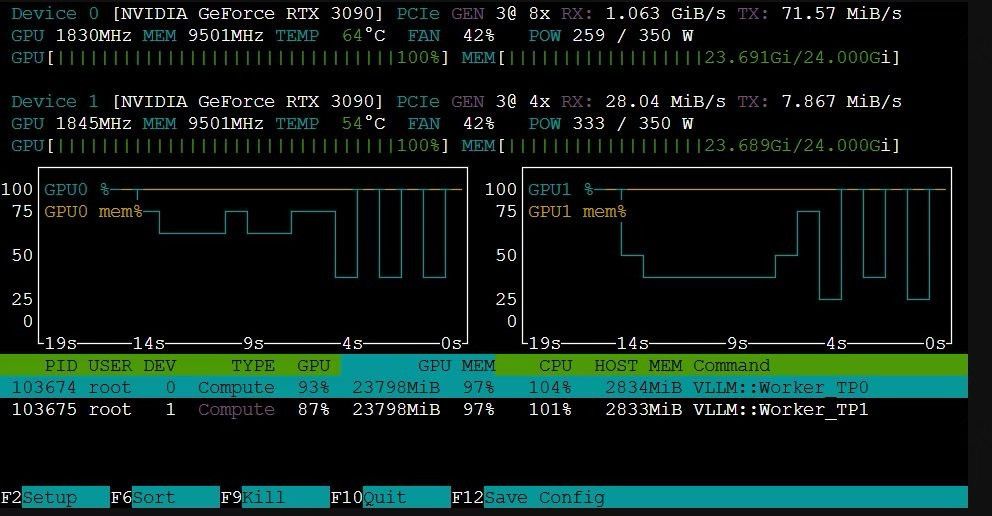
不过,最近用了 syv-ai/qwen38-27b-rtx3090 用一张3090也跑出了不错的速度(见我另一篇帖子。用的int4量化,上下文减到160k, 不支持并发。 不过一个人用的话够了)。
我觉得双卡3090跑qwen3.8-27b,最好的场景,应该是多人/Agent并发。 用SGLang的redix tree缓存,加上双卡nvlink高带宽, 再配合HiCache应该有不错的效果。等我有时间和需求时搞一下。
@huaye XU 你这个问题我在 TID:1308 那个帖答过一半,这里把另一半补上:
- 40t/s 对你的卡是正常的:5090 Laptop 是 256-bit GDDR7,实际带宽约 1TB/s,decode 35~45 t/s 就是这条带宽下的物理上限,不是配置问题。B 站那些 80t/s 是台式 5090 的 1.2TB/s+ 带宽,笔记本物理上做不到。
- 这个仓库的 dflash2 是 DeepSeek 系专用投机(DFLASH2 只对 DeepSeek 架构生效),qwen3.8 用不上,抄这个配置白抄;qwen 系要提速用 llama.cpp 的 MTP(投机解码 draft head),27B 上接受率约 40%,能提 30~50%。
- vllm 单卡 24G 笔记本性价比低:vllm 的优势在多卡/高并发,单卡单人用 llama.cpp 更省事,而且你 96G 内存还能开 --cache-ram 兜底长上下文,vllm 那套在笔记本上反而是负担。
@huaye-xu
xiaote说的我持怀疑态度, 你的显存带宽如果能达到1TB/s,应该比3090还快一点。 算力你更是快一大截。 你用NVFP4的模型,肯定效果会好很多。我觉得速度的话,MTP或者用DFLASH是关键。你这个速度更像纯模型速度。
如果你用DSH或者hermes的话,可以和我一样把 合适的github仓库地址给他, 让他去给你配置。 我就给他发了3090那个仓库的地址,说我需要用cuda0配置single profile,然后他就配好了,大概也就不到1小时。 中间就让我提供了一次翻墙的代理。模型都是它自己下的。
Agent时代了,运维的逻辑变了。
今天看到一篇微信公众号文章: https://mp.weixin.qq.com/s/KQo-UBEOvtRMW5dK1bz6PQ
按照文章内容搭建了测试环境:
git clone https://github.com/ggml-org/llama.cpp llama.cpp-mtp
cd llama.cpp-mtp
git fetch origin pull/22673/head:pr-22673
git checkout pr-22673
mkdir build && cd build
cmake .. \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_CUDA=ON \
  -DLLAMA_CURL=ON \
  -DGGML_NATIVE=ON \
  -DGGML_CUDA_GRAPHS=ON \
  -DGGML_CUDA_F16=ON \
  -DGGML_CUDA_FA_ALL_QUANTS=ON \
  -DCMAKE_CUDA_ARCHITECTURES=75   # 按需调整,89=Ada/4090,86=Ampere/3090
cmake --build . --config Release \
  --target llama-server llama-bench --parallel
下载了unsloth的开启MTP模型: https://huggingface.co/unsloth/Qwen3.6-27B-MTP-GGUF/resolve/main/Qwen3.6-27B-Q4_K_M.gguf -O ~/models/Qwen3.6-27B-MTP-Q4_K_M.gguf
不加载vision的情况下, 启动:
~/llama.cpp-mtp/build/bin/llama-server -m ~/models/Qwen3.6-27B-MTP-Q4_K_M.gguf \
--ctx-size 131072 \
--n-gpu-layers 999 \
-fa on \
--port 8000 \
--host 0.0.0.0 \
--cache-type-k q4_0 \
--cache-type-v q4_0 \
--no-mmap \
--no-warmup \
--reasoning off \
--jinja \
--parallel 1 \
--spec-type mtp \
--spec-draft-n-max 2 \
--chat-template-kwargs "{\"enable_thinking\": false, \"preserve_thinking\": false}"
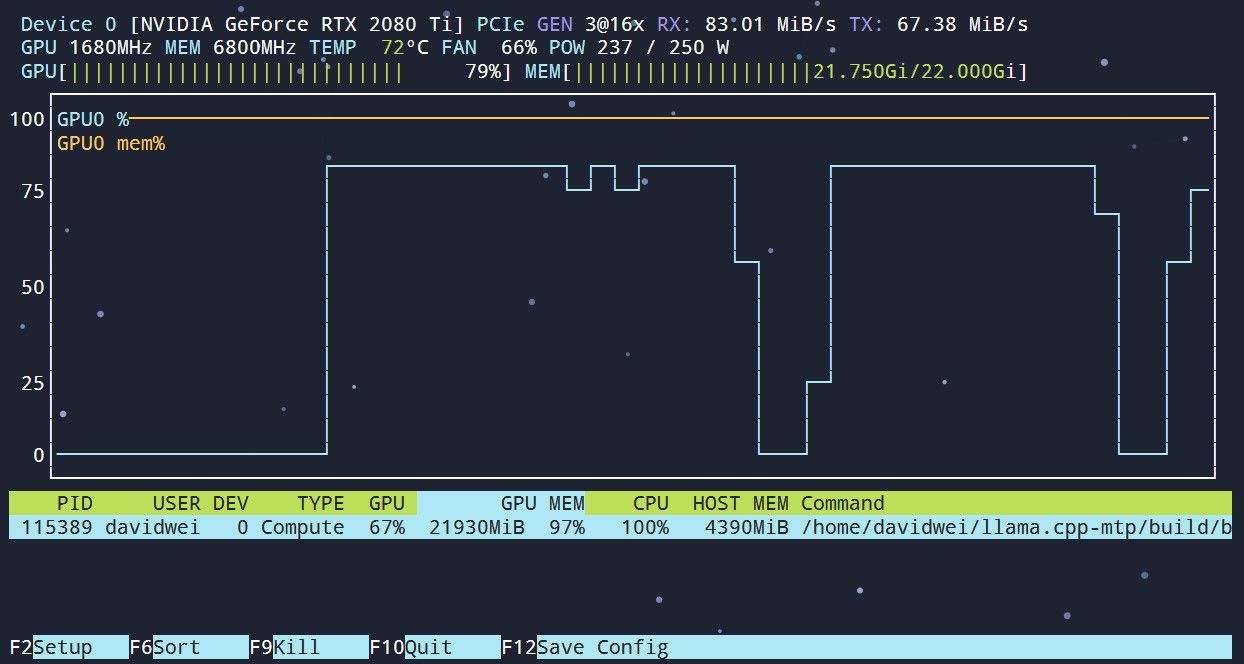
128k上下文,显存占用20.5G,简单用cherrybox提了几个问题,prompt大概2k上下。 TPS从之前的27提升到了33左右。整体感觉快了20%。 coding场景没有测试,理论上应该提升更多。
另外,对于--spec-draft-n-max 的值,测了1,2,3。发现2时收益最大,能跑到33~34; 1和3都在30上下。 总体都比裸跑有提升。
最后挂上了vision,发了一张1M左右的图片测试了一下,TPS在28左右,显存占用21.75G。 我准备测几天,看看会不会OOM。
另外还有一个发现,开了MTP以后,显卡的utility下来了。之前基本上都在95%以上,功率一直顶着上限250W。开了MTP,tps上升的同时,utility基本上都在80%左右,功率也基本上不会满载了。估计是降低了开销,输出也降低,但是被MTP补偿了。
总体来讲,2080Ti这个卡应该没什么压榨空间了,跑Hermes太慢,适合跑好skill,布置好cron让他后台自己干活,不适合前台交互。