大家好。第一次在这里发表聊天, 有什么不对的请多多包含。
花了2个多月 用SGlang 跑 Deepseek 4.1 Flash 1017. 终于达到理想的结果。 看了很久视频今天打算分享我设置 3 + 1 设置。 本来要买四张 RTX Pro 6000D(节省开销) 84GB 后来第四张 显卡买了 收到故障 , 当时显卡从 5万一张飙升至7万 商家就 质保变退款。 无奈之下第四张卡买了 满血 96GB 工作站版 凑数 4 张 显卡来跑AI。 (其实4张84GB 也能跑但是区别在 总上下文)
Sglang 引擎可以支持 权重不平衡分配,所以意外的满血版多容纳了一些权重。 经过2个多月的修改,设置,引擎提升 终于达到了 Prefill 11000 (0-500K之间) - 7000 (988K)token 每秒。 目前最多三个并发 总上下文 3百多万
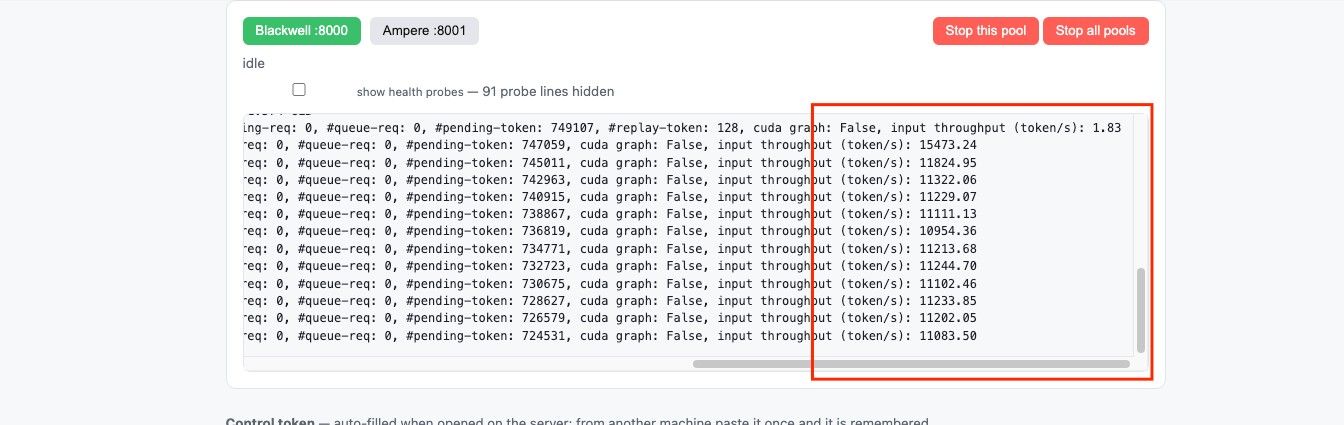
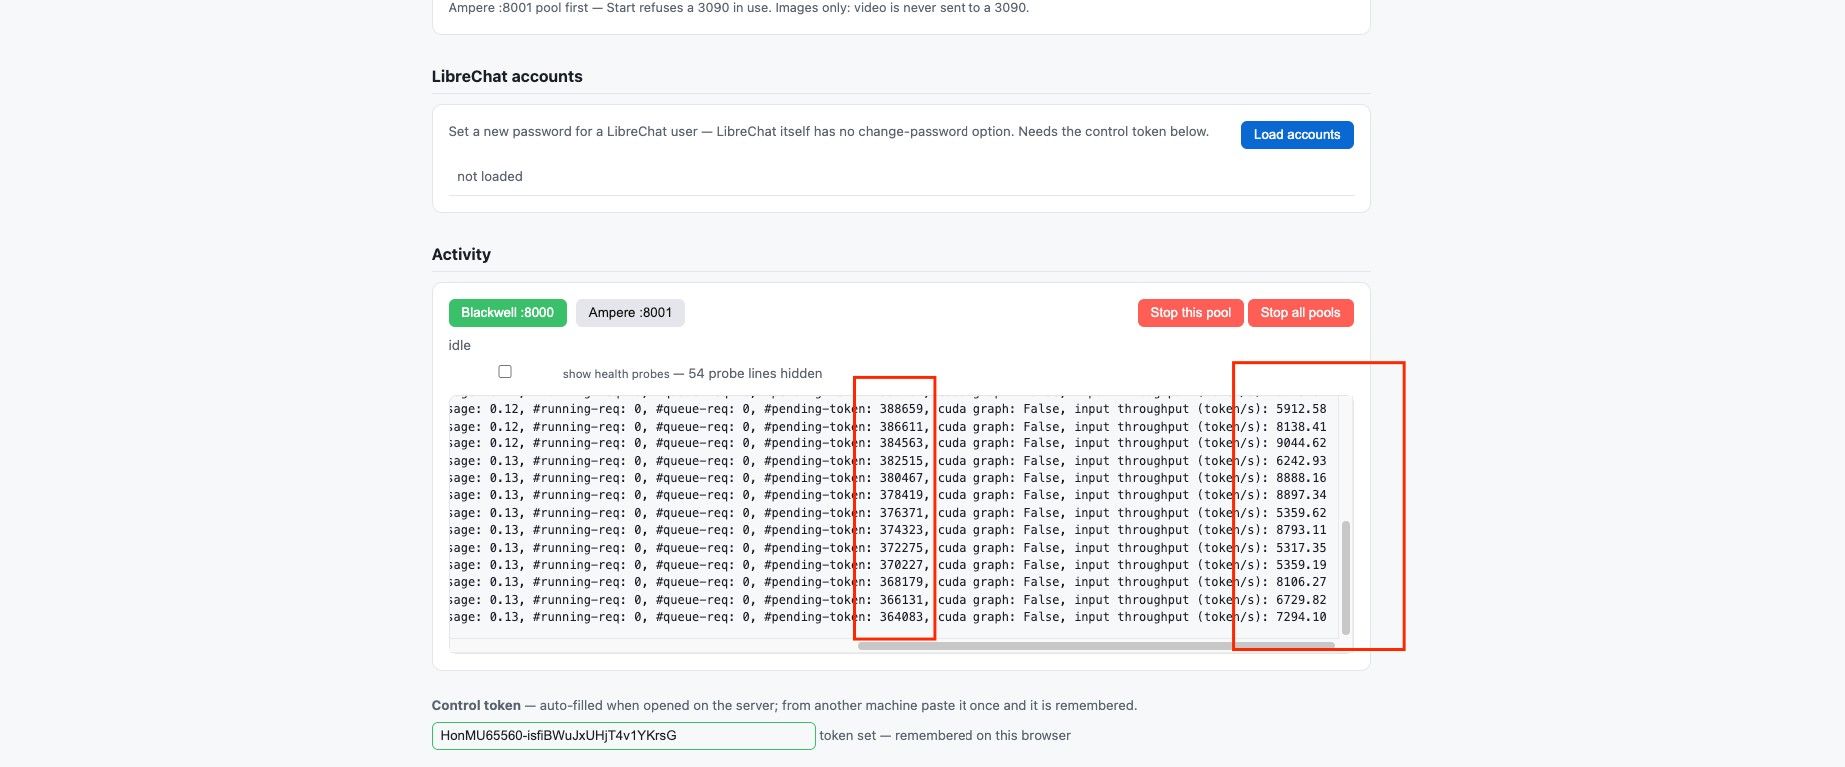
一并发的输出 (写代码更快)
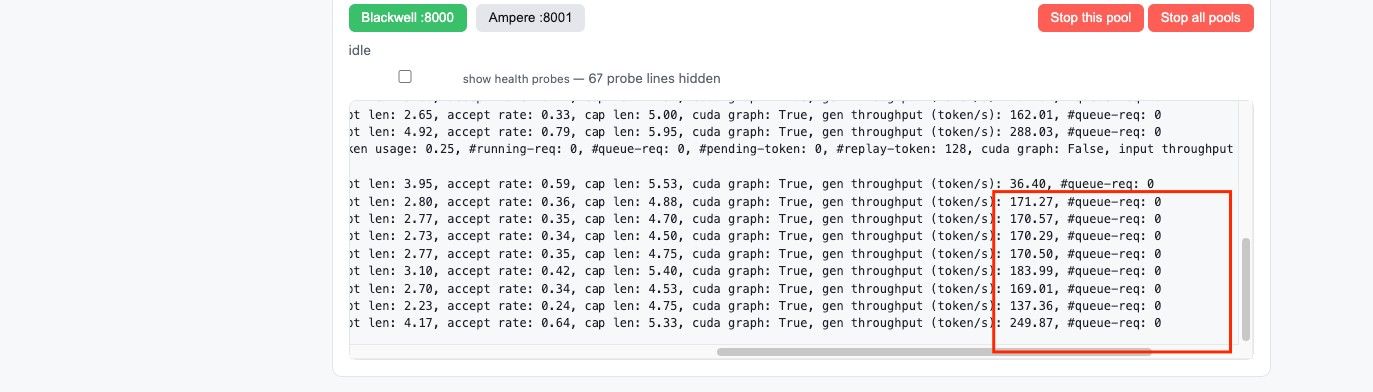
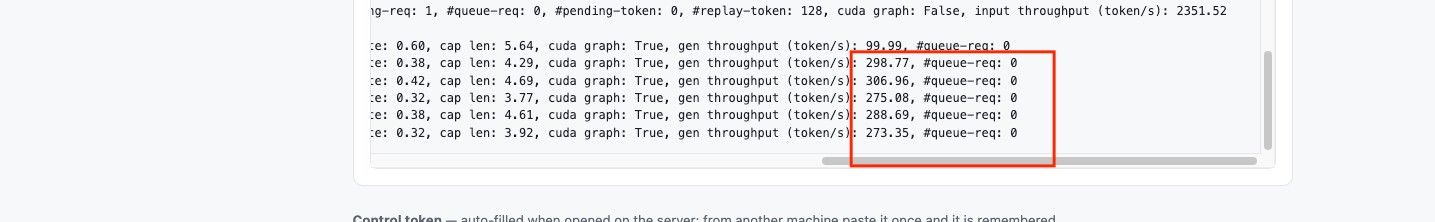
三并发输出
显卡设备 - AMD EPYC 7F52 + 512GB DDR4
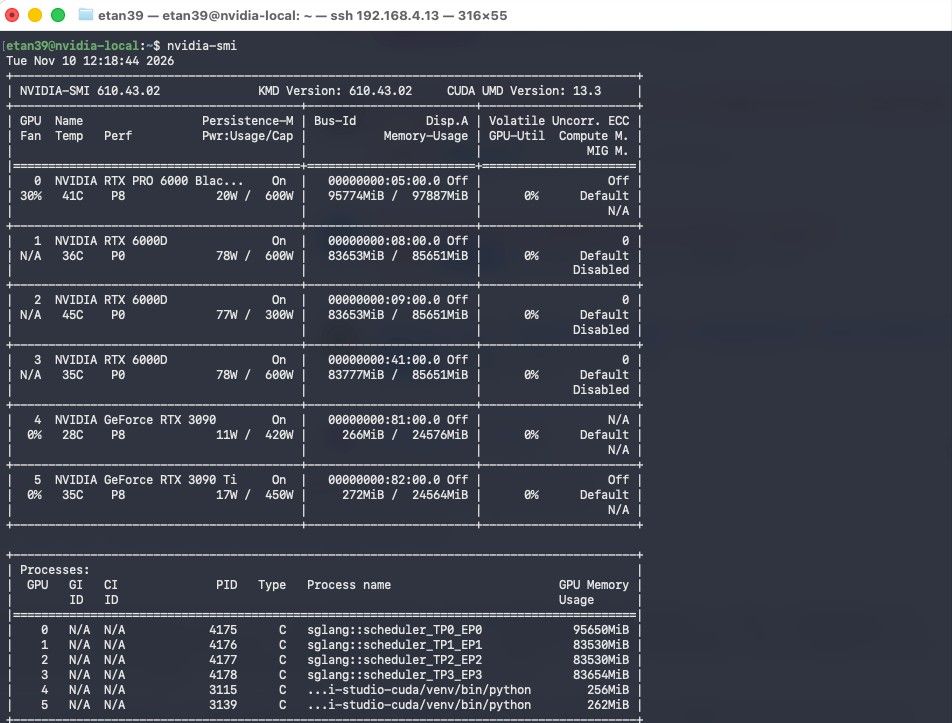
大佬们如果想要本地跑快点的Deepseek v4.1 Flash 1017, 这个方案提供参考。 以下是我设置日志
DeepSeek V4.1 Flash:在 4 张 RTX PRO 6000 上实现 100 万上下文
2026 年 10 月 21 日 · 阅读约 30 分钟
四张 PCIe Blackwell 显卡,无 NVLink:100 万 token 上下文,冷启动预填充 149 秒,解码 212 tok/s,现已支持三个并发会话。
点击放大
四张没有 NVLink 的 PCIe Blackwell 显卡,现在以完整的 1,048,576 token 窗口服务 DeepSeek-V4.1-Flash:988K token 的冷启动提示预填充耗时 149 秒(6,618 tok/s),解码约 212 tok/s。
十一个星期前,同样这四张卡在 llama.cpp 上只能跑到 60 tok/s 的解码速度,而且根本无法支撑长上下文。要走到完整的 100 万窗口、再达到这样的速度,花了两个月的硬件工作、一次没人算进去的内存分配、一次只有在替换卡到手即坏、最终凑成一套不匹配的卡组后才成为可能的非均匀专家切分,以及一个我们忘了带到新启动器上的环境变量。这是完整的历程——包括失败的部分。
历程:从 630 秒到 149 秒
988K token 冷启动预填充:三周内从 630 秒降到 149 秒。点击放大
这不是靠一个灵光一现的点子实现的。前后大约十一个星期,其中两周花在与模型无关的硬件上,最后三周用来让 100 万 token 窗口装得下、然后再让它变快。以下是完整路径,包括失败的部分。
八月:先证明这件事可行
我们最初在 llama.cpp 上(2026-08-11)跑 DeepSeek-V4-Flash 加 DSpark 草稿模型,因为那是当时唯一能在 sm_120 工作站 Blackwell 上跑起来的栈。它确实能跑,但很慢:解码 60.1 tok/s,上下文只有几万 token。
那个月得到两件事:
- 草稿模型比引擎本身更重要。 加上 DSpark 草稿模型后,在相同权重下解码从 60.1 提升到 102.4 tok/s,即 1.7 倍。
- 机器本身是坏的。 PCIe 错误风暴达到每分钟 23 次,追查下来是一块坏板子和 SlimSAS 线缆。换了新的 Tyan S8030GM2NE 和线缆后降到零。然后
amd_iommu=off iommu=pt 加上 NCCL 点对点,把 TP4 预填充从 977 提升到 2,149 tok/s,解码从 75 提升到 91.3。
最后这一点值得细想:在完全还没做任何模型层面工作之前,仅仅一个内核参数就让预填充翻了一倍多。
九月:互联成了天花板
到九月底,我们已经用四张卡提供服务,瓶颈是全归约(all-reduce),而不是算力。
| 日期 |
改动 |
全归约总线带宽 |
| 2026-09-21 |
NCCL_P2P_LEVEL 从 SYS 改为 PHB |
6.21 → 9.31 GB/s |
| 2026-09-28 |
为三张 GPU 加 Broadcom PEX 88096 交换芯片 |
9.31 → 19.53 GB/s |
| 2026-10-17 |
为 DS4.1 设置 NCCL_P2P_LEVEL=PHB |
3.83 → 19.57 GB/s |
第三行是最痛的。我们为 DeepSeek V4 设过 PHB,但忘了把它带到 DS4.1 的启动器上。整整三周,发往交换芯片之外那张 GPU 的流量都在走主机内存。2026-10-17 修好后,冷启动 498K 从 150 秒降到 75 秒,冷启动 988K 从 374 秒降到 223 秒——比这篇文章里其他任何单项改动带来的收益都大。
教训:你对一个启动器做的设置,不等于你对整台机器做的设置。 我们这个设置就那样静静待着,悄悄吃掉了 40% 的预填充性能。
2026-09-29 首次 DS4.1 服务:400K 窗口,350K 时预填充 2,564 tok/s,解码 96-108 tok/s。
内存墙:为什么是 400K 而不是 100 万
这是耗时最长的部分,而且它不是调参问题——而是一笔没有被计入的分配。
每一次尝试 100 万上下文都死于同样的特征:请求中途 OOM,失败点还会漂移,而且对 mem-fraction-static 完全免疫。我们从 0.92 调到 0.94,失败点纹丝不动。这本该立刻告诉我们:这块内存是被预算器看不见的东西占走的。
我们最终在 OOM 那一刻取了分配器快照,答案是 V4.1 的稠密预填充 indexer:fp32 的 [chunk × context] 分数张量加上 bool 候选掩码,约占全部预填充内存增长的 94%,而且分配在 mem_fraction_static 的核算范围之外。
上游有同样的 bug,而且已经命名了它(SGLang issue #35201):"indexer 与上下文成正比的 logits 分配未被 mem_fraction_static 计入——长上下文预填充必然 OOM。"已经有人把我们的问题写下来了。
增长是线性且巨大的:每 1,000 token 增长 13.7 MiB。到 100 万 token 就是 13.7 GB 没人预算过的内存。
两个运行时补丁解决了它,无需重新编译:
- 给 indexer 拷贝预算加 256 MiB 上限。
- 改用 int32 候选块 id 的行分块预填充 indexer——手工移植上游 SGLang PR #40217。
这使窗口从 400K → 600K → 800K → 100 万,第一次冷启动 988K 通过耗时 629.7 秒。
第二个内存天花板:非均匀专家
100 万上下文跑通后,新的限制出现了:三张 84 GiB 的卡没有余量,而那张 96 GB 的卡却半闲置着。
以下是干净重启后测得的数字:
| 干净重启后 |
PRO 6000(rank 0) |
每张 6000D |
| 主模型加载后剩余 |
21.34 GiB |
9.52-9.56 GiB |
| 内存池与 CUDA 图之后剩余 |
15.86 GiB |
4.02-4.12 GiB |
PRO 6000 上有 11.8 GiB 完全没被使用。 2026-10-11,一个冷启动的 784K 提示在三张 6000D 上因差不到 0.5 GiB 而失败,而 rank 0 还有约 16 GB 空闲。
修复方案是非均匀专家切分——96 GB 的卡承担 384 个路由专家中的 108 个,84 GiB 的卡各承担 92 个,而不是原版的 96/96/96/96。一个专家位置在全部 40 层上占 0.70 GiB,所以移走四个大约能给每张 6000D 释放 2.7 GiB。
84 GiB 6000D 上的峰值空闲显存。点击放大
|
均等切分 |
非均匀 108/92/92/92 |
| 6000D 主模型 |
72.63 GiB |
69.97 GiB |
| 内存池后剩余 |
4.64-4.77 GiB |
7.31-7.44 GiB |
| 冷启动 988K 峰值空闲 |
~1.3 GB |
~3.8 GB |
上线前我们离线验证了路由:45 项检查确认每个专家都恰好被一个 rank 加载、并在它被加载进去的那个槽位里运行;另有一项内核检查显示非均匀切分与单 rank 结果的接近程度与均等切分相当(0.002337 对 0.002347),并故意放了一个损坏的对照组(0.933535)来证明这个测试能区分错误路由和正确路由。
那张坏掉的卡反而成了优势
原计划是四张完全相同的 RTX 6000D。第四张到手就是坏的。
再等一张 6000D 意味着延迟,所以我们买了 96 GB 的 RTX PRO 6000——那是当时真正有货的型号。三张比第四张小 12 GB 的卡,不是任何人会刻意设计的配置;它只是当一张卡坏掉、而你又只能拿到能拿到的那张替换卡时,最终得到的结果。
在搭建过程的大部分时间里,它看起来像个负担。原版 SGLang 假定所有 rank 相同,在混装卡组上拒绝启动,而且小的那几张正是耗尽内存的。
然后非均匀切分把它翻了盘。因为 96 GB 的卡空间更大,它能比其他的承担更多专家——108 对每张 92,而不是原版的 96/96/96/96。把四个专家位置从小卡上移走,每张大约释放 2.7 GiB,这正是"冷启动 784K 提示因差 0.5 GiB 而挂掉"和"从容运行"之间的差别。
正是这份余量,把"很快,但上下文上限约 400K"变成了三个并发的 100 万会话。如果没有一张卡能承担更重的份额,就没有任何地方可以再平衡——每张卡都一样紧缺,也就无解了。
所以这个优势不是运气。坏卡迫使我们用了混装机器;非均匀切分把一个约束变成了容量。如果第四张 6000D 是好的,我们会有四张相同的 84 GiB 卡、总显存更少、也没有可再分配的余量——三槽配置根本不会存在。
可以推广的要点:在张量并行机器里,不均匀的卡本身不是问题——只有当切分是均等的时候它才是问题。 原版 SGLang 假定各 rank 相同,不一致时就不启动。按能力而不是按数量来切分,混装机器可以胜过同构机器,因为大卡能吸收小卡无法承受的不均衡。
如果搭建途中你的卡坏了,就这么做:不要凑同型号,买你能买到的最大替换卡,然后重新平衡分片。
十月:缓存、分块,以及换引擎
内存问题解决后,剩下的工作就是速度和缓存。
- 2026-10-04 — 预填充 chunk 从 1,024 改为 4,096,Claude Code 的 system 消息保持内联。冷启动 988K 从 629.7 降到 373.4 秒;每轮提示缓存复用从约 35K 中的 8,192 提升到 99.9%。
- 2026-10-16 — HiCache 文件层,32 个缓存尾部,2.1M GPU 池。重启后恢复 777K 会话,从 269.7 秒的重新预填充降到从磁盘恢复的 5.1 秒。六个 agent 共 2.7M token,100% 复用。
- 2026-10-18 — DeepSeek-V4.1-Flash-1017 权重(仅权重更新;速度上无明显变化,质量在噪声范围内),KV 文件层迁到三块 NVMe 组成的 RAID0。339K token 的提示从缓存恢复仅 2.90 秒,而计算需要 55.56 秒,而且它经受住了一次断电。
- 2026-10-21 — 换引擎。冷启动 988K 从 223 降到 149 秒,解码从约 108 升到约 212 tok/s,空闲显存从 1.7 升到 4.2 GiB。
完整调优日志
| 日期 |
步骤 |
收益 |
| 2026-10-21 |
更新的 SGLang 引擎(2026-10-19 SM120 构建)+ 我们的切分、indexer 预算和附加组件;chunk 2,048 配 expandable_segments |
冷启动 988K 223 → 149 秒;解码 ~108 → ~212 tok/s;空闲显存 1.7 → 4.2 GiB |
| 2026-10-18 |
DeepSeek-V4.1-Flash-1017 权重 + 10 月 16 日编码器修复;KV 文件层放到 NVMe RAID0 |
速度与内存相同;质量在噪声内;断电后 2.9 秒恢复 339K 提示 |
| 2026-10-17 |
为 DS4.1 设置 NCCL_P2P_LEVEL=PHB(此前没有) |
全归约 3.83 → 19.57 GB/s;冷启动 498K 150 → 75 秒;冷启动 988K 374 → 223 秒 |
| 2026-10-17 |
为 Claude Code 加 /v1/messages 兼容层 |
请求不再被拒绝后重试;PDF、redacted thinking、超长提示都得到处理 |
| 2026-10-16 |
HiCache 文件层 + 32 个缓存尾部 + 2.1M GPU 池 |
重启后恢复 777K 从 269.7 → 5.1 秒;6 个 agent 共 2.7M token,100% 复用 |
| 2026-10-12 |
非均匀专家切分 108/92/92/92 |
84 GiB 卡上空闲显存 1,322 → 3,798 MiB;解码 108.8 → 110.3 tok/s |
| 2026-10-04 |
预填充 chunk 1,024 → 4,096;Claude Code system 消息保持内联 |
冷启动 988K 629.7 → 373.4 秒;每轮缓存复用约 35K 中的 8,192 → 99.9% |
| 2026-10-03 |
Indexer scratch 预算 256 MiB + 行分块预填充 indexer(移植上游 #40217) |
窗口 400K → 600K → 800K → 100 万;首次冷启动 988K 通过耗时 629.7 秒 |
| 2026-09-29 |
DS4.1-Flash 首次服务:SGLang,TP4 + EP4,Engram 表放在主机内存 |
400K 窗口,350K 时预填充 2,564 tok/s,解码 96-108 tok/s |
| 2026-09-28 |
为三张 GPU 加 Broadcom PEX 88096 交换芯片 |
全归约 9.31 → 19.53 GB/s;V4 预填充 42K 时 +51%,672K 时 +20% |
| 2026-09-21 |
NCCL P2P level 从 SYS 改为 PHB |
全归约 6.21 → 9.31 GB/s;V4 预填充 +14-24% |
| 2026-09-20 |
新主板(Tyan S8030GM2NE),SlimSAS 线缆更换 |
PCIe 错误风暴 23/分钟 → 0 |
| 2026-08-25 |
内核 amd_iommu=off iommu=pt + NCCL 点对点 |
TP4 预填充 977 → 2,149 tok/s,解码 75 → 91.3 |
| 2026-08-11 |
DeepSeek V4-Flash 在 llama.cpp 上配 DSpark 草稿模型 |
解码 60.1 → 102.4 tok/s(1.7 倍) |
真正重要的东西(按重要性排序)
如果你只从这十一个星期里带走一件事:
- 为这个模型设置 NCCL PHB —— 冷启动 988K 从 374 秒降到 223 秒。一个环境变量,被遗忘了三周。
- indexer 补丁 —— 它是把窗口从 400K 做到 100 万的前提。在它解决之前,别的都不重要。
- 更新的引擎 —— 223 → 149 秒,解码翻倍。收益真实,但它需要底下的内存工作才能用得上。
- 非均匀专家切分 —— 在那些受限的卡上把余量从 1.3 GB 提到 3.8 GB。
- Chunk 4,096 和 HiCache —— 630 → 373 秒,重启从 4.5 分钟降到 5 秒。
规律是:最大的收益来自配置和内存核算,而不是聪明的优化。 这个模型一直都有这个能力。我们大部分时间都花在发现"内存被花在了我们没看的地方"。
机器配置
一台工作站,无 NVLink:四张 Blackwell 卡在 PCIe 4.0 上,其中三张位于 PCIe 交换芯片之后。
| 部件 |
说明 |
| GPU(服务用) |
1x RTX PRO 6000 Blackwell Workstation(96 GB)+ 3x RTX 6000D(可用 84 GiB),均为 PCIe 4.0 |
| PCIe 拓扑 |
GPU 0-2 位于 Broadcom PEX 88096 交换芯片之后;GPU 3 独占一个 CPU 根端口 |
| CPU / 内存 |
AMD EPYC 7F52(16 核 Zen 2),主板 Tyan S8030GM2NE,512 GB DDR4-2933 ECC |
| 内核 |
amd_iommu=off iommu=pt pcie_aspm=off pci=realloc |
| 缓存盘 |
KV 文件层在三块 NVMe 的 RAID0 上(/mnt/scratch,上限 1000G);权重在 2 TB NVMe 上 |
| 服务 |
SGLang main 2026-10-19(ormandj SM120 镜像)+ 我们的运行时补丁,TP4 + EP4,DSpark 投机解码,fp8 KV |
| 模型 |
DeepSeek-V4.1-Flash-1017:40 层,hidden 5,120,384 个路由专家(激活 6 个);Engram 表(189 GiB)放在主机内存 |
为什么只有三张卡在交换芯片之后
四张里有三张是中国市场的 RTX 6000D(可用 84 GiB),而不是完整的 96 GB 版本——448 位总线上 28 颗 3 GB GDDR7,156 个 SM,为出口管制做了削减。原计划是四张 6000D;第四张到手即坏,96 GB 的卡是作为替换买来的。但它与主板的交互方式还有一个容易被忽略的点,这也是这台机器不是"四张卡全在一个交换芯片后"的原因。
简短版: Tyan S8030GM2NE 不让我们调整 PCIe 内存映射 I/O(MMIO)资源分配。没有这个,四张大显存 Blackwell 卡在交换芯片之后放不进平台的地址空间,所以三张在交换芯片后,第四张占自己的 CPU 根端口。
机制(尽力还原)。 这部分是根据平台行为和公开报告推断的,不是我们自己抓的 BIOS dump——请把它当作一个在你的板子上需要验证的假设。
每张 Blackwell 卡都会向固件请求一个非常大的 BAR1 窗口来暴露其显存:这一级别的大概是每卡 128 GB 量级。四张就是大约半个 TB 的 MMIO 地址空间,固件必须在不重叠的前提下切分并对齐,再分配到各根端口。服务器和工作站 BIOS 通常把 Above 4GB MMIO Limit 默认设为 40 位(1 TB)——听起来很宽裕,直到分配器的 2 的幂对齐吃掉了其中大部分。当它无法放置每个窗口时,通常的结果是 POST 卡在 D4"PCI resource allocation error. Out of resources"代码,或者某张卡干脆永远枚举不出来。
暴露 Above 4GB MMIO Limit 和 Re-Size BAR 的板子可以让你抬高这个上限(通常建议 44 位 / 16 TB),从而装下四张。我们的 S8030 没给我们这个控制项,所以四张全在交换芯片后不是一个选项。
所以这个拓扑是对固件限制的变通,而不是我们为性能选择的方案:
- GPU 3 独占自己的 CPU 根端口,在交换芯片之外。
- 发往它的流量除非告诉 NCCL 这一跳在主机桥内,否则不能做点对点拷贝——这正是 NCCL_P2P_LEVEL=PHB 在这台机器上值 40% 预填充的原因。
- 三张挂在交换芯片上的卡彼此走 PIX/PXB;第四张是更长的路径。
我们接下来会试的(未验证): 一块能让你抬高 above-4G MMIO 上限并启用 Re-Size BAR 的板子,应该能让四张卡都在 PCIe 交换芯片之后。如果能,每一对都会变成 PIX/PXB,全归约不再跨越根复合体,P2P 带宽应该还能进一步提升。我们没测过这个——这是从拓扑推出的假设,不是结果。它大概也能让我们去掉 PHB 覆盖,因为那时 PHB 就不再是正确的级别了。
如果你要搭这套,两条实用提示:
- 买板子之前先确认那个 BIOS 设置。 在我们的硬件上,它就是"三卡在交换芯片后"和"四卡在交换芯片后"之间唯一的差别。
- 失败并不总是明显的。 有些板子能 POST,但会静默地留下一张卡未分配;另一些会卡在 D4。在假设分配正确之前,确认
nvidia-smi -L 显示全部四张,且 lspci -vv 中每个 BAR 的 current size 与其 supported 列表相符。
换引擎买到了什么
同样的四张 GPU,同样的 1017 权重,同样的 2.1M token KV 池——这个对比早于第三个槽位,所以下面两列都是双槽配置。引擎变了,每个头条数字都动了。
四张 RTX PRO 6000,无 NVLink——换引擎买到了什么。点击放大
| 指标 |
旧引擎(10 月 17-18 日) |
新引擎(10 月 21 日) |
| 上下文窗口 |
1,048,576 |
1,048,576 |
| GPU KV 池 |
2.1M token |
2.1M token |
| 冷启动 498K 预填充 |
74.8 秒 |
54.2 秒(9,189 tok/s) |
| 冷启动 988K 预填充 |
222.5 秒 |
149.3 秒(6,618 tok/s),needle 2/2 |
| 解码,短提示 |
108.4 tok/s |
212.3 tok/s |
| 解码,约 1.04M 上下文 |
103.5 tok/s |
184.3 tok/s |
| 峰值最低空闲显存 |
1,706-1,922 MiB |
4,210 MiB |
| 两个约 948K 提示同时 |
未测 |
都得到回答,259.6 秒 |
| Needle,878,591 token 处 5 个深度 |
-- |
5/5 |
| 工具调用 / 多轮 / 视觉 |
4/4, 4/4, 11/11 |
4/4, 4/4, 11/11 |
新引擎是 ghcr.io/ormandj/sglang-deepseek-v41-flash-sm120:v0.4.3:2026-10-19 的 SGLang main 加 32 个补丁,FlashInfer 0.7.2,为 SM120(Blackwell 工作站)卡构建。之前的引擎是约 2026-09-10 的 dev 构建加我们自己的补丁。
冷启动预填充:223 秒到 149 秒
988K token 冷启动预填充 149 秒,从 223 秒降下来。点击放大
冷启动测量,无任何缓存,两个引擎在每个级别都 needle 2/2。
| 提示 |
498K |
598K |
698K |
798K |
898K |
988K |
| 旧 |
74.8 |
96.9 |
122.4 |
152.0 |
186.8 |
222.5 |
| 新 |
54.2 |
69.4 |
86.5 |
105.8 |
127.5 |
149.3 |
短提示预填充改善幅度类似:
| 提示 token |
4.1K |
32.8K |
131K |
336K |
| 旧 |
6,190 |
8,216 |
8,233 |
7,526 |
| 新 |
7,882 |
11,291 |
11,441 |
10,662 |
解码:各处大约翻倍
解码在每个上下文长度上都大约翻倍。点击放大
| 上下文 |
35 |
11.6K |
47.7K |
96K |
194K |
379K |
750K |
1,036K |
| 旧 |
108.4 |
113.0 |
99.5 |
113.8 |
109.8 |
107.8 |
112.8 |
103.5 |
| 新 |
212.3 |
201.2 |
216.9 |
211.5 |
197.7 |
198.7 |
180.6 |
184.3 |
在 100 万上下文下增益仍然保持:184 tok/s,而旧引擎只有 104。峰值空闲显存从 1.7 GiB 升到 4.2 GiB,正是这一点让更深的 KV 池变得安全。
它不是开箱即用的
四轮才到位。
- 原版配置。 预填充快了 36-48%,解码约 1.9 倍,但该配置假定四张 96 GB 卡。在我们 84 GiB 的 6000D 上它只装得下约 40 万 token 的 KV——没有 100 万窗口。
- 移植我们的专家切分。 108/92/92/92 切分加 256 MiB indexer 预算,chunk 2048、mem 0.915。100 万通过:988K 冷启动 149.1 秒。
- 生产用的 chunk 4096。 能启动,但长预填充崩了:500K 冷启动用了 278.7 秒,而对照是 54 秒。在这个引擎上不可用。
- 生产设置加完整池。 Chunk 2048、mem 0.93、2.1M 上限、所有客户端附加组件、32 个缓存尾部和 HiCache 文件层。全部通过。这就是随后的双槽服务;第三个槽位是之后加的(见下),把池提到 3.15M、mem 0.942。
为什么 chunk 4,096 在这里会失败
这是最有意思的部分,而且它不是一个简单的"缓冲区太大"。
在 4,096 行时,引擎的内存在第一个 chunk 就被占满。FlashInfer MoE scratch 空间是每次调用时分配的、没有预分配缓冲区;mHC 残差缓冲区翻倍;而在 4,096+ 行时引擎会切换到单独的大批量代码路径,包括第二条 CUDA 流,它们持有内存更久并造成碎片。无论如何,约有 1.85 GiB 被预留给预录制的解码尾部 CUDA 图。
这触发了一个反馈回路。V4.1 预填充 indexer 根据空闲 GPU 内存来决定其分数 tile 的大小。几乎没有空闲时,tile 缩到只有几行——每个 index 层最多约 1,000 次微小内核启动,每次都重读整个上下文。因此代价随上下文增长:随着上下文增长,预填充从约 11K tok/s 掉到约 1.1K tok/s。而在 2,048 时约有 4 GB 保持空闲,所以 tile 能保持较大。
现场数据也一致。 其他在 RTX PRO 6000 上跑这个模型的人在生产中用 chunk 2,048;在 8 张 GPU 上,4,096 并不更快(128K 时 6,301 对 6,853 tok/s)。我们自己的测量:即便装得下,4,096 也只能买到约 4% 的预填充提升。
原版配置实际给你什么
在任何调优之前,引擎自带配置已经快得多——而且在我们这些卡上 100 万上下文不可用。这一点值得知道,因为它告诉你收益来自哪里、墙在哪里。
在相同 chunk 4,096 和与旧生产服务相同的提示规模下运行:
| 提示 token |
旧引擎(tok/s) |
原版新引擎 |
| 4.1K |
6,190 |
8,424 |
| 8.2K |
7,310 |
10,356 |
| 32.8K |
8,216 |
11,816 |
| 131K |
8,233 |
11,995 |
| 336K |
7,526 |
11,132 |
| 上下文 |
旧解码 |
原版解码 |
| --- |
--- |
--- |
| 35 |
108.4 |
214.3 |
| 96K |
113.8 |
215.7 |
| 379K |
107.8 |
200.4 |
所以开箱即用:预填充 +36-48%,解码约 1.9 倍。引擎本身就是那个收益。此后的一切都是关于让它装得下。
为什么原版在这里撑不住 100 万
上游的配置假定四张 96 GB 卡。我们三张 6000D 是 85.6 GB,没有非均匀专家切分时每张装 74.1 GiB 权重,而不是生产的 72.6——而那张 96 GB 的 PRO 6000 却有约 17 GB 闲置。
五次启动尝试,按顺序:
| 启动 |
设置 |
结果 |
| 1 |
原样 |
拒绝:TP 内存不均衡 |
| 2 |
mem 0.93, chunk 8192 |
KV 664,832,然后预热时 OOM(980 MiB 空闲) |
| 3 |
mem 0.91 |
拒绝:权重导致 0.916 以下无 KV |
| 4 |
mem 0.925, chunk 8192 |
KV 393,984,然后预热时 OOM(248 MiB 空闲) |
| 5 |
mem 0.925, chunk 4096 |
服务成功——KV 399,872,峰值 84.65 / 85.65 GB |
第 5 次能跑,但只有约 40 万 KV 而不是 2.1M:没有 100 万上下文,没有余量,也没有第二个 agent 的空间。速度是真的;容量不是。
修复方案是非均匀专家切分(96 GB 卡承担 108 个专家,84 GiB 卡各 92 个),它把 6000D 的权重降到 71.5 GiB,并把差额交给 KV 池。这一个改动就是把"快但只有 400K"变成"快且有 2.1M"的关键。
给你自己搭建的启示
如果你用四张 96 GB 卡,原版配置可能直接就能用。在混装或 84 GiB 卡上,预期要先重新平衡专家——而且不要把原版配置的基准数字当成你会拿到的数字,因为它测的是一个你的机器可能装不下的内存形状。
10 月 18 日的权重
DeepSeek 的 1017 版本是一个仅权重更新——相同的配置、张量名、分片和分词器;分片哈希不同。
在旧引擎上,原始版 vs 1017 是打平:冷启动 988K 253.5 秒对 257.1 秒,解码 108.9 对 106.1 tok/s。饱和测试集上的质量:HumanEval 157/164 对 156/164,GSM8K 297/300 对 296/300。DeepSeek 报告的增益在更难的推理和 agent 基准上,而这些测试集达不到那个水平。
我们还移植了 DeepSeek 的 10 月 16 日编码器修复:推理努力级别 low/high/max 对应 50/75/100,仅携带工具结果的消息不再开启新回合,以及 ns::name 工具命名空间。新引擎已经包含这些。
试过并否决的: 参考模型在 wo_a 之前对注意力输出做的 fp8 往返,损失约 13% 解码(106.1 到 92.7 tok/s),质量无可测变化。保持关闭。
三个并发 100 万会话
单会话时引擎已经很快了。对 agent 工作真正重要的问题不一样:这台机器能同时撑住三个完整的 100 万 token 会话而不倒吗?
能。 现在生产上服务三个槽位,4 个槽位试过并否决。
取舍:池 vs 余量
一个能装下完整 1,048,576 token 上下文的槽位不是免费的。每个约花 1.7 GB KV 池加约 0.07 GB 解码 CUDA 图。
6000D 启动后的空闲显存。点击放大
| 槽位 |
池 |
mem |
启动后空闲(6000D / GPU0) |
| 2(之前) |
2,099,968 |
0.93 |
5.97 / 6.55 GB |
| 3(现在) |
3,149,824 |
0.942 |
4.23 / 4.82 GB |
| 4 |
4,199,936 |
0.96 |
2.50 / 3.09 GB |
池就是 N × 1,050,000。在 mem 0.93 时,栈构建 2,599,936 token(无上限),每 +0.01 的 mem 分数增加约 547k。
为什么 4 槽失败。 池装得下,功能检查也通过了——工具、多轮 4/4、视觉 11/11、OCR 3/3。然后第一个普通的 2k token 请求就挂了:
cutlass_fused_moe: "Tried to allocate 124.00 MiB ... 40.12 MiB is free" on GPUs 1 and 2
调度器退出,之后每个请求都被拒绝。那个阶段的最低空闲是 6000D 上的 898 MiB。在 84 GiB 卡上,4 槽不是一个能扛住真实流量的配置——池装得下,负载装不下。
3 槽实际交付了什么
功能上:工具通过,多轮 4/4,视觉 11/11,OCR 3/3,以及超长提示按预期返回 Anthropic 措辞的 400。
多流同时解码(短提示,thinking 关闭——与 212 tok/s 的单流数字不可比,后者用的是不同的测试框架):
三个并发流。点击放大
| 流数 |
每流 |
合计 |
| 1 |
189.6 tok/s |
190.0 |
| 2 |
154.4 tok/s |
295.7 |
| 3 |
137.4 tok/s |
392.4 |
从一流到三流,总吞吐翻倍,而每流速度下降约 28%。这是预期的形状,也是 agent 工作正确的取舍:三个 agent 在推进,胜过单个 agent 全速跑。
预填充不变。 三槽和双槽产生的预填充曲线在噪声范围内相同:
| 提示 |
2 槽 |
3 槽 |
| 131K |
11,441 tok/s |
11,431 |
| 498K 冷启动 |
54.2 秒 |
54.1 秒 |
| 988K 冷启动 |
149.3 秒 |
149.4 秒 |
这些冷启动级别是在 3 槽激活时测的,不是从双槽服务沿用的——needle 检查在这个配置上跑过:每个级别 2/2。单流解码也保持在 decode_bench 的 ±10 噪声内(短上下文 212.2,1,036K 时 177.1)。
值得精确说明探测了什么、没探测什么,因为这两者容易混淆:
| 测试 |
槽位 |
Needle 检查 |
| 冷启动预填充,131K-988K |
3 |
每个级别 2/2 |
| 三个并发 988K 会话 |
3 |
未探测——正确性由答案判断,不是 needle |
| 两个并发约 948K 提示(较早) |
2 |
未探测 |
所以 3 槽配置对单请求冷启动预填充做了 needle 验证,窗口声明正是依赖这一点。并发运行证明调度器能撑住三个长会话并返回正确答案;它们没有额外证明三个会话都在驻留时的 needle 检索。这是证据上的一个缺口,不是已知的失败。
三个真实的 988K 会话同时跑——2.96M token,占池的 94%——全部正确回答:
| 会话 |
提示 token |
首 token |
结果 |
| 1 |
988,050 |
150.2 秒 |
PASS |
| 2 |
988,055 |
297.0 秒 |
PASS |
| 3 |
988,050 |
443.9 秒 |
PASS |
教训:槽位增加解码并发,不增加预填充吞吐
看那些首 token 时间:150 秒、297 秒、444 秒。预填充是一个接一个跑的,每个约 6,680 tok/s。
这是因为 2,048 token 的预填充 chunk 被所有运行中的请求共享。后面的长提示要等前面的跑完。所以三个槽位给你三个 agent 同时思考,但它们不能让三个长提示的预填充整体更快。
如果你的负载是三个 agent 各自冷启动 900K 提示,预期最后一个要等。如果是三个 agent 跑长期存活的缓存会话——agent 工作通常就是这种——你能拿到完整收益,因为前缀缓存意味着你根本不需要重新预填充。
真正重要的浸泡测试
基准不是生产测试,所以 3 槽配置被拿去跑了一个 agent 式浸泡测试:三个类 Claude-Code 会话分别预热到 698K / 754K / 780K token(同时 2.23M),每回合带 3-15K 工具输出加一个 <system-reminder>,每 4 回合起 2 个并行子 agent,800K 时压缩。
56 个请求,0 错误,PASS。
- 压缩:3/3(S3 804,298 用 26.5 秒,S2 802,023 用 11.2 秒,S1 802,489 用 6.8 秒)——每个都从缓存读取了其前序提示的 100.0%。
- 600K-804K 上下文的 agent 回合:22 个。中位数 6.0 秒,最大 18.5 秒。
- 子 agent 冷启动:8 个(54K-67K),排队时最大 25.3 秒。
- 缓存复用:42 个判定回合中最差 96.2%;每个长上下文回合都在 99%+。
- 最低空闲:GPU0 2,585;6000D 1,960-2,042 MiB。
三个低于 99% 的回合都是压缩后的小上下文(前序 5-10K),最后一个不完整页没被缓存——不是真正的回退。
一个值得重复的测量陷阱: 第一次试跑把缓存复用算成"缓存 ÷ 整个提示",这在某回合往小上下文里加了很多东西时会低估复用(一个 5K 子 agent 上的 3K 工具输出被打成 51-60% 并 FAIL)。按会话的前序提示来算是诚实的度量——服务器数据在两次运行中完全相同。如果你在测前缀缓存复用,在相信那个数字之前先决定你要的是哪个分母。
最终设置
现有启动器上的三个环境变量覆盖——除默认值外不改文件:
| 设置 |
值 |
| MAX_RUNNING_REQUESTS / MAX_NUM_SEQS |
3 |
| MAX_TOTAL_TOKENS(池下限) |
3,150,000 |
| MEMORY_FRACTION |
0.942 |
HiCache 层的主机内存随池增长(比例 2);有 287 GB 可用,这没问题。
诚实的限制:客户端只有在真的同时发超过两个请求时才受益。 如果你的 agent 工具把子 agent 扇出限制在 2,第三个槽位大部分时间是闲的——它是为"两个会话加一个子 agent 重叠"那一刻准备的余量,不是你总能看到的吞吐倍增器。
重要的设置
| 设置 |
值 |
原因 |
| 预填充 chunk |
2,048 |
4,096 在这个引擎上会让长预填充崩溃(见上);2,048 保持约 4 GB 空闲,使 indexer tile 保持较大 |
| PYTORCH_CUDA_ALLOC_CONF |
expandable_segments:True |
必需。没有它引擎会把约 5.7 GiB 搁置成 reserved-but-unused,连 256 token 请求都失败 |
| 启动预热 |
无 |
上游的 --warmups serving_coverage 在 84 GiB 卡上 OOM |
| --mem-fraction-static |
0.942 |
配合 --max-total-tokens 3150000;实际设定用量的是上限而不是分数 |
| NCCL_P2P_LEVEL |
PHB |
让 NCCL 对交换芯片外那张 GPU 使用直接 GPU 到 GPU 拷贝(全归约 3.83 对 19.57 GB/s) |
| KV 池 |
3.15M token,fp8 |
三个 100 万会话保持驻留 |
| --swa-prefix-tails |
32 |
配 HiCache 时主机层保留被逐出的尾部 |
| HiCache |
file 后端,write-through |
GPU -> 主机内存(4.2M token)-> NVMe;会话经受重启 |
| 专家切分 |
108 / 92 / 92 / 92 |
96 GB 卡比 84 GB 卡承担更多专家 |
| Indexer 预算 |
256 MiB |
上游现在已对 indexer 分块;我们只给它的分数预算设上限 |
| 并发 |
--max-running-requests 3 |
三个槽位;每流速度降约 28%,但合计大致翻倍 |
沿用的客户端附加组件:Claude Code /v1/messages 兼容、对话中 system 消息保持内联以便前缀缓存复用、采样默认 0.95 / 1.0、推理努力 "off" 别名,以及重复循环防护。
如何自己得到这个结果
如果你有四张 Blackwell 工作站卡并想要这个结果,工作顺序比任何单个 flag 都重要。 这是实际奏效的顺序。
1. 先把互联弄对
下游的一切都被 PCIe 限制。这些卡没有 NVLink,所以所有跨 GPU 流量都走 PCIe,拓扑决定你的天花板。
- 在负载下检查链路宽度,而不是空闲时。 我们有一张卡因为坏 riser 只训练到 x8。空闲时看着正常。它损失了约 15% 预填充(冷启动 988K 253.5 秒对 223.0 秒),直到我们对比 nvidia-smi 链路宽度和 lspci -vv 才发现。每次打开机箱后都要复查。
- 了解你的拓扑。
nvidia-smi topo -m 告诉你哪些卡共享交换芯片、哪些在自己的根端口上。我们的是:三张在 Broadcom PEX 88096 之后,一张直连。
- 设置 NCCL_P2P_LEVEL=PHB。 没有它,发往交换芯片外那张 GPU 的流量会走主机内存。在我们机器上那是全归约 3.83 对 19.57 GB/s——5 倍差距,表现为冷启动 988K 的 374 秒对 223 秒。
- 内核 flag 很重要。 我们用
amd_iommu=off iommu=pt pcie_aspm=off pci=realloc 启动。在我们上一块板子上,仅 iommu=pt 就把 TP4 预填充从 977 提升到 2,149 tok/s。
2. 在追速度之前先定 KV 池大小
100 万窗口首先是一个内存问题。三件事解锁了它:
- 非均匀专家切分。 96 GB 卡比 84 GiB 卡承担更多专家:108 / 92 / 92 / 92。这把 84 GiB 卡上的最低空闲显存从 1,322 提到 3,798 MiB。
- 把 indexer scratch 预算限制在 256 MiB(DSV41_INDEXER_BUDGET_MIB)。这是把窗口从 400K -> 600K -> 800K -> 100 万推上去的东西。
- 用分层缓存。 HiCache 配 file 后端把 KV 层放到 NVMe,所以 777K 会话 5.1 秒回来,而不是 269.7 秒重新预填充。
如果你在 84 GiB 卡上,预期要调切分而不是照抄一个:比例是你卡组构成的函数。
3. 用长预填充来选 chunk 大小,而不是短提示
这是最容易犯的错误。Chunk 4,096 在这个引擎上并不更快——它能启动、通过短测试,然后在长上下文上崩掉(500K 冷启动:278.7 秒对 chunk 2,048 的 54 秒)。
不要因为它在 32K 上装得下就接受某个 chunk 大小。测一个 500K+ 的冷启动提示。 失败模式是一个反馈回路,而不是 OOM 崩溃:空闲内存耗尽时 indexer 缩小 tile,这倍增内核启动次数,而这又随上下文增长让问题更糟。
4. 设好分配器,跳过预热
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True 在这个引擎上是必需的。没有它我们看到约 5.7 GiB 被搁置为 reserved-but-unused,连 256 token 请求都失败。注意这和我们旧引擎的发现相反,那时它会导致失控生成。
不要用上游的 --warmups serving_coverage。它在 84 GiB 卡上 OOM。
设 --mem-fraction-static 0.942 配 --max-total-tokens 3150000。实际设定池的是显式 token 上限,不是分数。
5. 信任之前先验证
能抓到我们错误的检查:
| 检查 |
抓到了什么 |
| 负载下的 nvidia-smi 链路宽度 |
一张卡训练到 x8——15% 预填充 |
| 冷启动 500K+ 预填充,而不只是短提示 |
Chunk 4,096 在长上下文上崩溃 |
| 多深度 needle 测试 |
静默的上下文退化 |
| 峰值最低空闲显存 |
100 万窗口是否真的安全 |
| 两个并发长提示 |
真实 agent 负载下的行为 |
6. 预期要保留你自己的补丁
原版配置是为四张 96 GB 卡调优的。在混装或 84 GiB 配置上你会带上自己的专家切分、indexer 预算和 chunk 大小。我们的记在上面的设置表里——把它们当作一个开始测量的起点,而不是可以照抄的配置。
好消息:这个引擎已经包含我们之前手工移植的 indexer 分块和编码器修复,所以需要维护的东西比以前少了。
死胡同
| 尝试 |
结果 |
| Chunk 4,096(新引擎) |
能启动,但长预填充崩溃:500K 冷启动 278.7 秒对 54 秒 |
| 上游启动预热 |
在 84 GiB 卡上 OOM |
| 注意力输出的 fp8 往返 |
解码 -13%,无质量收益 |
| Chunk 12,288 / 16,384(旧引擎) |
第一个 chunk 就 OOM |
| Chunk 10,240(旧引擎) |
装得下,988K 时快 8.6%,但 KV 池减半 |
| Chunk 8,192(旧引擎) |
快 6.8%,代价 1.6 GB 显存;否决 |
| 更大的 indexer 预算(1,024 MiB) |
39 次分配失败,无加速 |
| fp4 indexer flag(旧引擎) |
慢 25-29%;新引擎默认开启 |
| expandable_segments(旧引擎) |
有害:失控生成。在新引擎上反过来了,是必需的 |
| SGLang 自定义全归约、torch 对称内存、NCCL NVLS |
在 4 张纯 PCIe SM120 卡上不可用 |
两个硬件教训
一张卡因为坏 riser 只训练到 PCIe x8。它损失了约 15% 预填充(冷启动 988K 253.5 秒对 x16 的 223.0 秒),直到我们在负载下检查链路宽度才发现。换 riser 后:221.8 秒,解码 108.4。每次打开机箱后都检查 nvidia-smi / lspci。
PHB 伴随着一次主机硬复位(一个 AMD "data fabric sync flood")。之后的重启是干净的,目前还不清楚 PHB 是否相关。在照抄这个之前值得知道。
我们还没有证明的
这些数字的诚实边界:
- 新引擎上没有重跑质量测试集。 相同权重,功能与 needle 检查通过,但这个引擎上的 HumanEval/GSM8K 还没做。
- 重启后的缓存恢复没有重测。 早先"777K 5.1 秒回来"的结果属于旧引擎。
- 引擎的 PCIe-IPC 全归约在这些混装卡上从未启用("every rank must use identical collective arguments"),所以全归约跑在 NCCL 上。上面的每个数字都是在没有它的情况下——可能还有更多可用。
- 10 月 21 日晚起进入生产,尚未浸泡。 所有数字都是基准流量。
- 三个并发 988K 会话没有做 needle 探测。 三个都正确回答了,但三个 100 万会话驻留时的 needle 检索未测——见 3 槽一节的表格。3 槽上的单请求冷启动预填充是 needle 验证的 2/2。
致谢
DeepSeek 的 DeepSeek-V4.1-Flash-1017。SGLang 项目。ormandj 的 SM120 镜像(ghcr.io/ormandj/sglang-deepseek-v41-flash-sm120)。最初的 4x RTX PRO 6000 DS4.1 配置 0xSero/deepseek-v4.1-flash-4x-rtx-pro-6000(现在在 sybil-solutions 下)是旧引擎的基础。SGLang PR #43376 和 issue #40877 为 chunk 分析提供了参考;上游 PR #40217 是 indexer 分块思路的来源。
方法: 冷启动提示与 needle 检查用 scripts/coldctx_run.py,短预填充用 scripts/bench_openai_ctx.py,解码用 scripts/decode_bench.py(512 token 的 2-3 次运行取中位数;单次运行波动约 ±10 tok/s)。


 。 卖了。