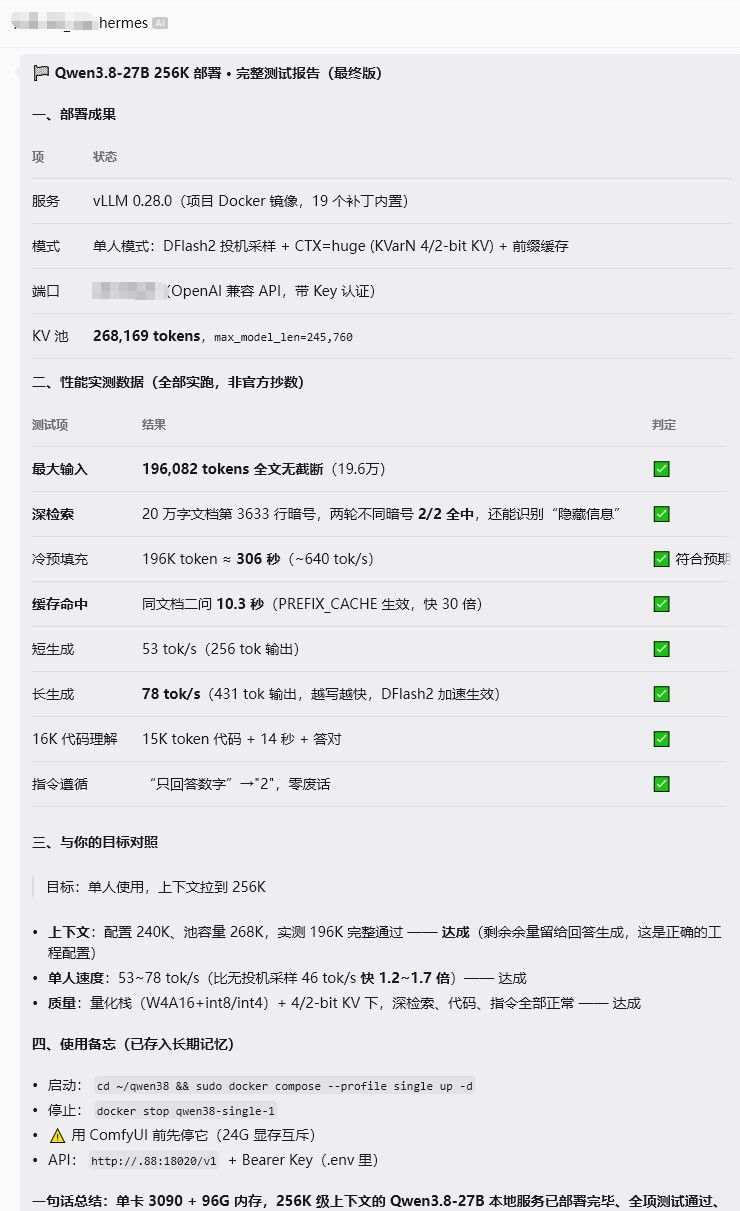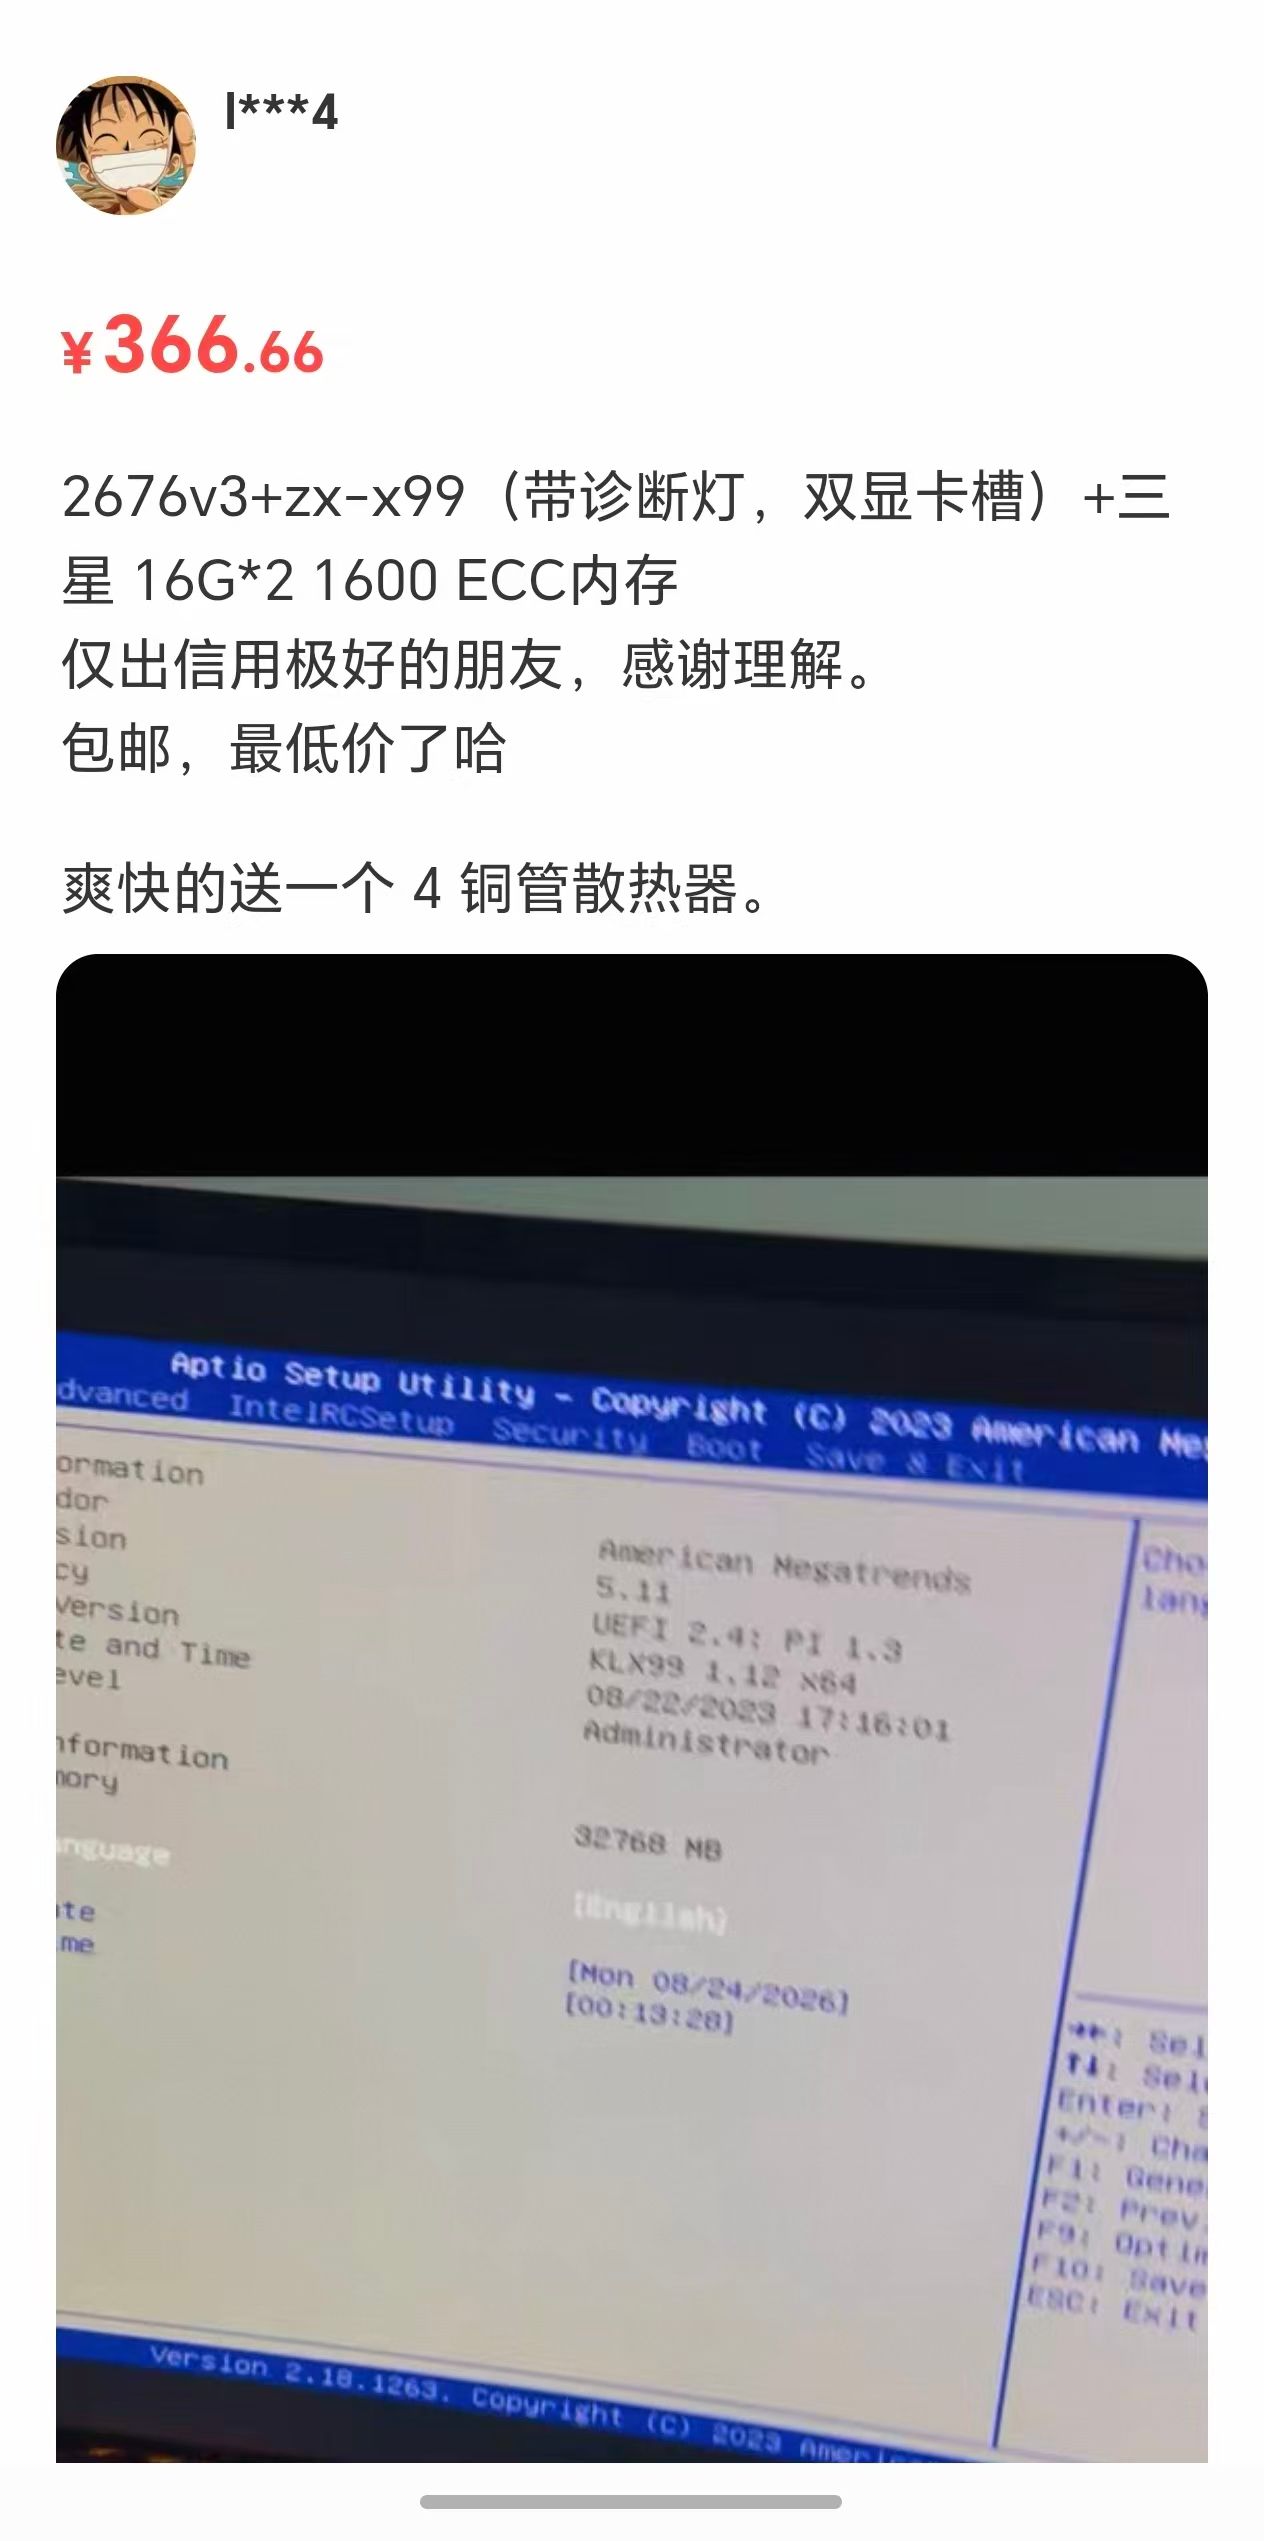
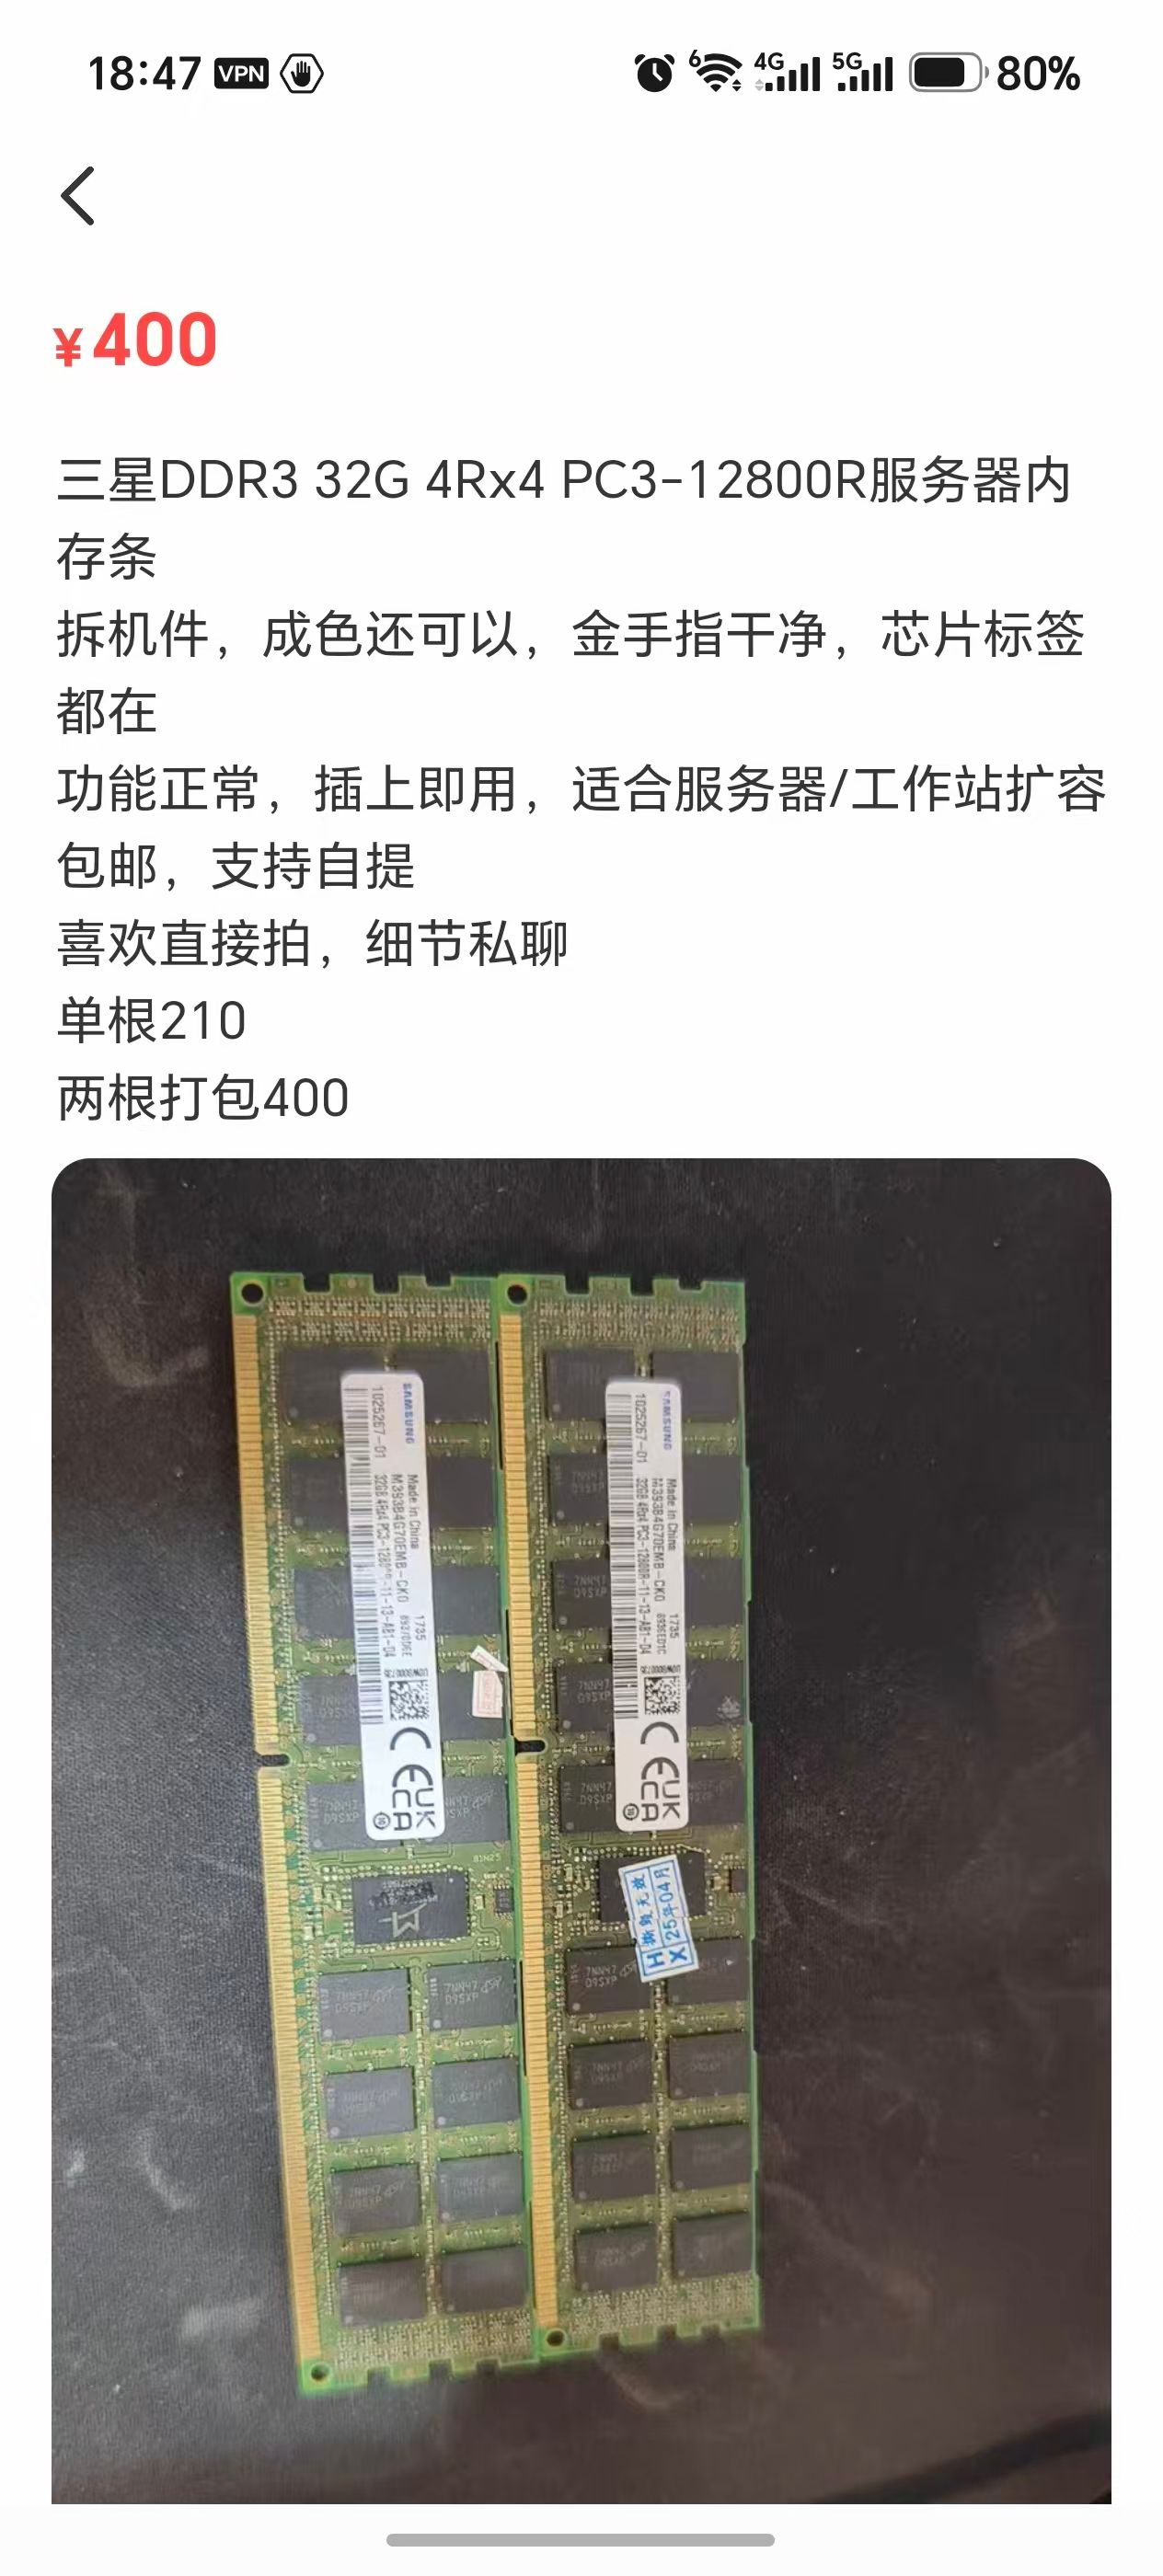
8月27日闲鱼买的,主板很新,96G ddr3,搭配我的3090跑strata,comfyui玩 。原来用的是13500TE+B660m +32Gddr4,有点浪费了,集显作主力机在家用。新买的垃圾配件加3090直接ubuntu,一根网线一根电源线丢公司机房角落,整个世界都清净了。
F
fafafa
@fafafa
-
DDR3 1866HZ RECC拆机条32G单条不到300,搭配X99洋垃圾4通道主板完全能带得动高端显卡,硬件大涨价行情下的性价比之选,双11冲一波! -
3090单卡跑qwen3.8 27b q4km 上下文2456K达成,但是感觉生产力还是不太行。根据论坛上的大佬们的贴子,将我的3090跑起来了,小任务确实还能应付一下。
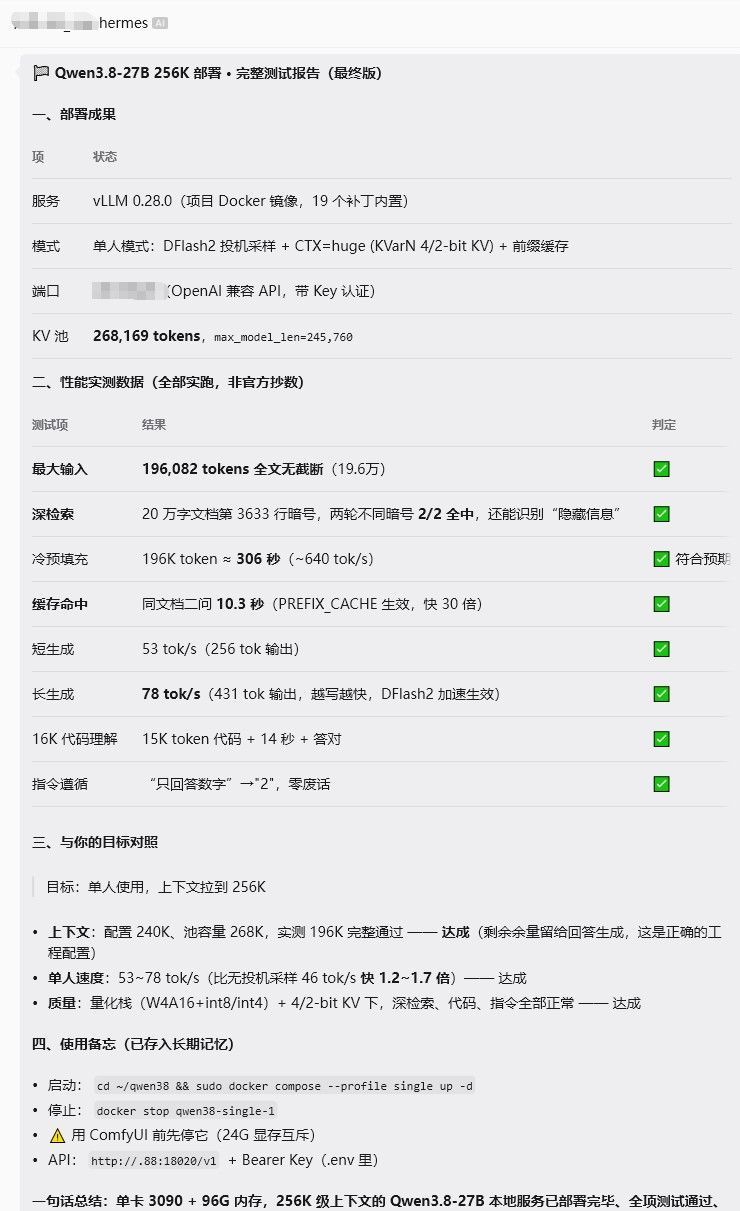
尝试了一个将一个3.9万行的项目分别扔进本地部署的qwen3.8,在线的glm5.3flash,glm5.3,要求查bug及提出优化建议。
1、本地部署的Qwen3.8跑了2个小时,上下文竟然还没有爆,但是时间太长了,我只能手动终止,ai自已回复:完成进度:约 25%~30%(6 项待办完成 1 项,第 2 项进行中被中断)。
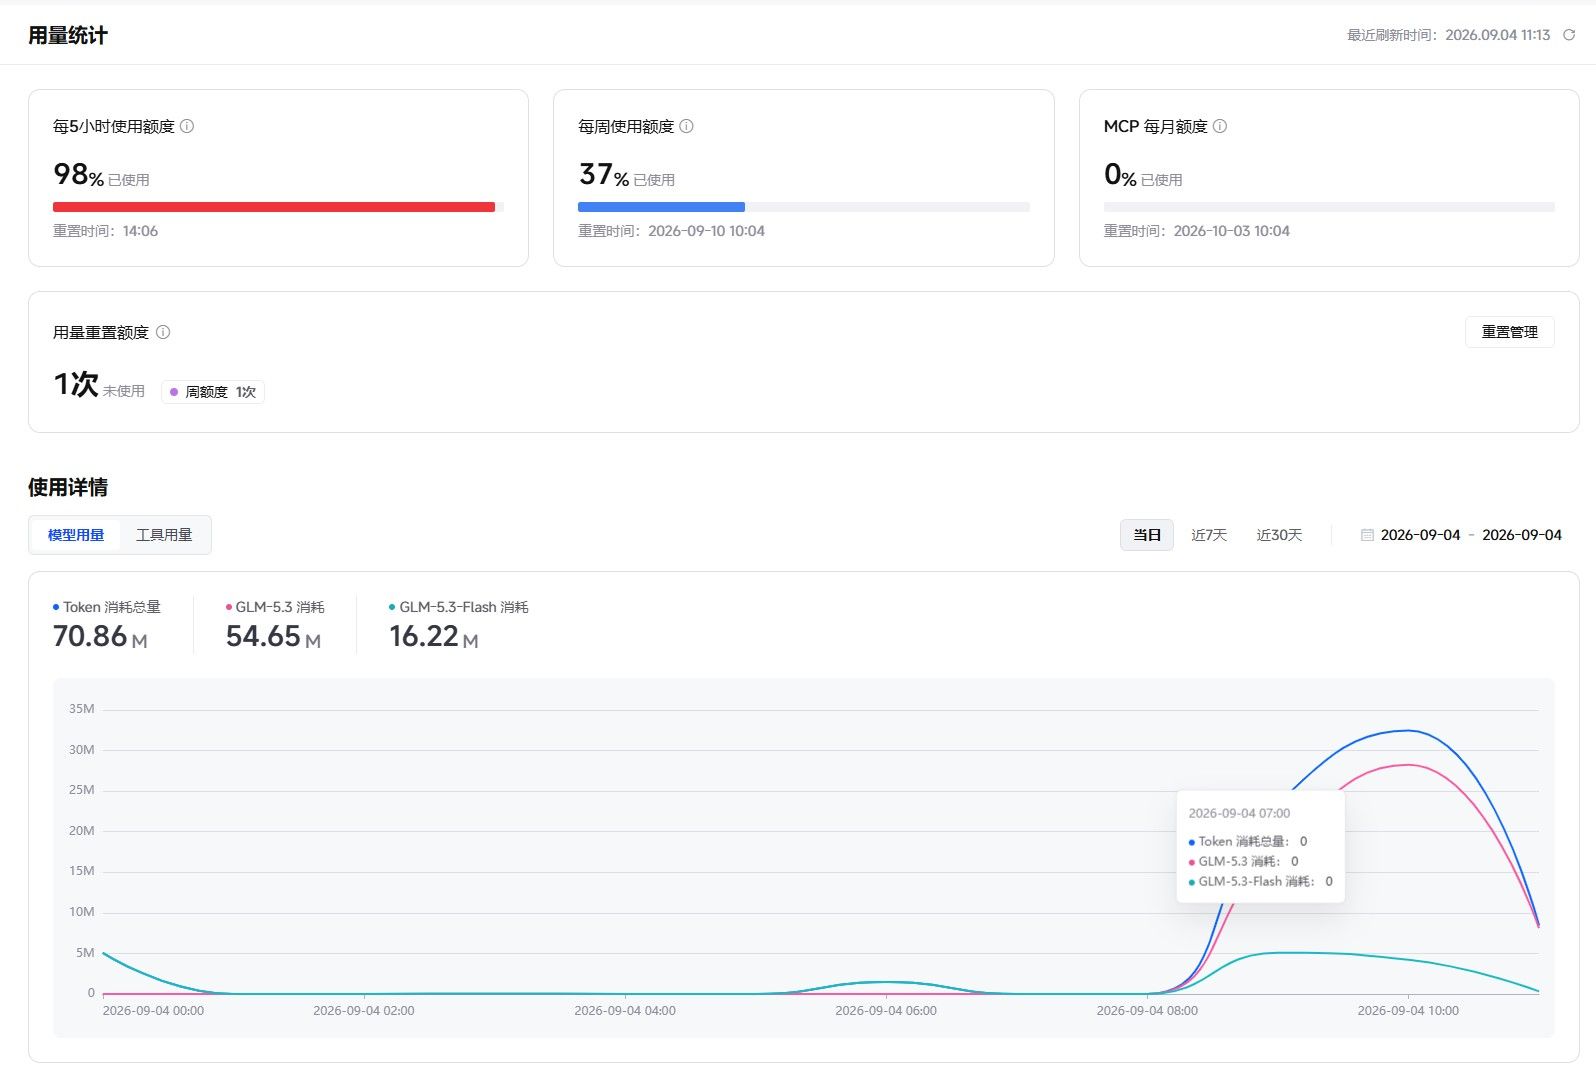
2、glm5.3flash用时大概在30分钟,中间感觉一直没有输出信息,问了一句什么进度,然后3分钟后输出任务完成。智谱的coding plan V2套餐 pro,显示周使用量从56%增加到58%。
3、glm5.3用时17分6秒,中间没有任务卡顿直接完成任务。智谱的coding plan V2套餐 pro,显示周使用量从58%增加到59%。
glm5.3flash与glm5.3都出了详细的报告,我用deepseek V4 pro帮我做了分析:
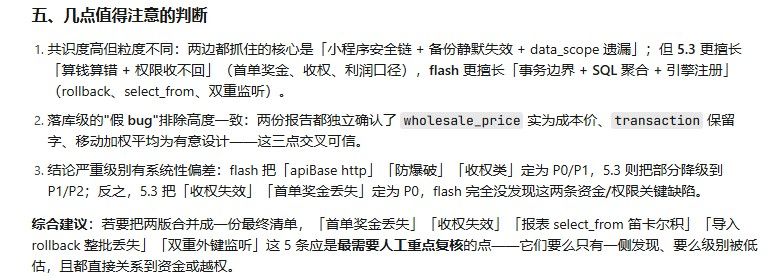
两个模型共同提出的16项,只有 glm5.3 指出的问题14项,只有 glm5.3flash 指出的问题也是14项。感觉这两个在线api也是傻,能各自漏掉14个问题?

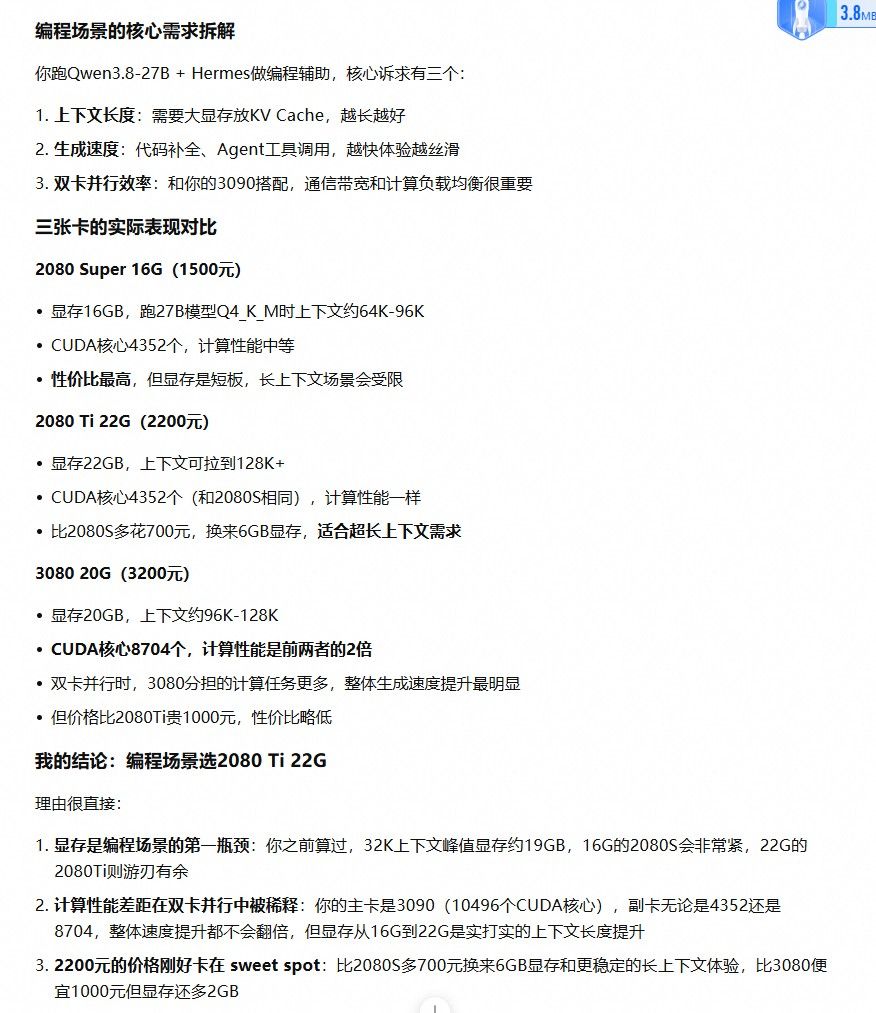
现在主要问题是,我一个coding plan不够用了,经常跑几下就没了,想小任务交给本地部署的qwen3.8 27b来跑。但是感觉速度实在是太慢了,而且好像也感觉不太靠谱。如果加多一张3080 20G,不知道对速度提升大不大,像现在这样,在线的glm跑十几~三十分钟的任务,本地跑二个小时还是30%进度的话,意义真是不大了。
-
3090 24G 单卡部署 Qwen3.8-27B@Botio-Kuo 是的,我也没有自己搞,是hermes搞的。
-
3090 24G 单卡部署 Qwen3.8-27B -
3090 24G 单卡部署 Qwen3.8-27B -
3090 24G 单卡部署 Qwen3.8-27B@Botio-Kuo 你这是什么意思?3090单卡可以设置上下文2XXK?求教,我设置128K没几轮下来就爆了。
-
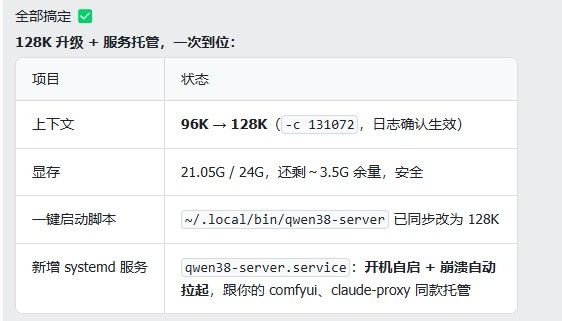
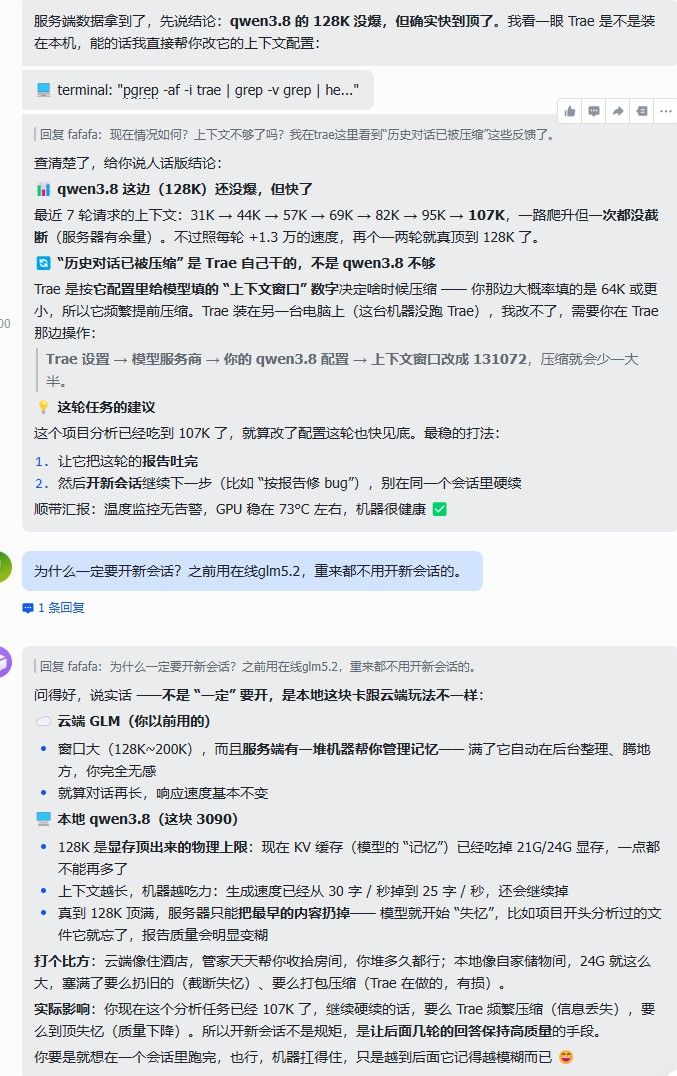
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km@applejuice 感谢老哥,原来是真可以跑128K的,用hermes帮我调整好了。但是trae那边还是频繁出现“历史对话压缩中”。然后没多久就:“模型请求失败,点击右侧箭头展开模型服务商错误信息进行排查。Context size has been exceeded. (4028)”。这个真是无解吧。感觉就算加一个2080ti 22g,还是解决不了,跑几轮又要开新会话。不像在线大模型可以一直跑在一个会话里。
-
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km@imbiplaza-ASUS 3080 20g 大概在3300元左右。
-
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km -
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km@applejuice 我这水平搞测试报告有点困难了。

-
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km -
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km -
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km@applejuice 那不是意义不大了。。。。。。
-
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km@applejuice 感谢回复,你是说我原来3090是35t/s,但加了2080ti 后,速度还会下降到跟2080ti单卡的水平?
-
原有一张3090,可以搭配一张2080ti 22g吗?玩qwen3.8 27b q4km我原来在用X99,2676v3, 32gddr3,3090 24g,跑qwen3.8 27b q4km,只能开32K上下文,35t/s,用trae编程(有免费积分)没几下就爆显存了。本来想再买一张3090的,好家伙,价格都到7~8K了,实在舍不得。看了一下,2080ti 22g才2200左右,有点心动了。问了一下千问,说是可以加,对速度对智力没一点用,但对提升上下文有很大作用,而且也推荐买2080ti 22g。我还是放心不下,先问问各位大大。
-
多个agent多个模型不同时间对一个项目进行开发,究竟有没有问题?我目前在开发一个自己公司的管理系统,到现在大概4万多行代码了。
在这段开发的时间里,我购买了一个智谱的Coding Plan pro套餐,但消耗太快了不够用,还充值了deepseek。目前使用时间大概是这样的:
早上:使用trae + glm5.2或glm5.1 薅羊毛,早上不怎么用排队。其本上中午就用完名称额度了。
下午:使用codex + deepseek-v4-pro 费用低一点,但感觉还是glm5.2比较稳。
晚上:使用zcode + glm5.2 费用高,用完就休息。 。
随着系统越来越大,感觉几个大模型,几个agent换来换去这样搞,经常会出现莫名奇妙的bug,改完这又改那,有时还是挺烦的。另外感觉还是zcode + glm5.2 稳定点。
各位大哥有没有类似的情况,除了加钱,有什么办法?
 。应该是坚持一个agent加一个大模型会好一点吗?