@terry
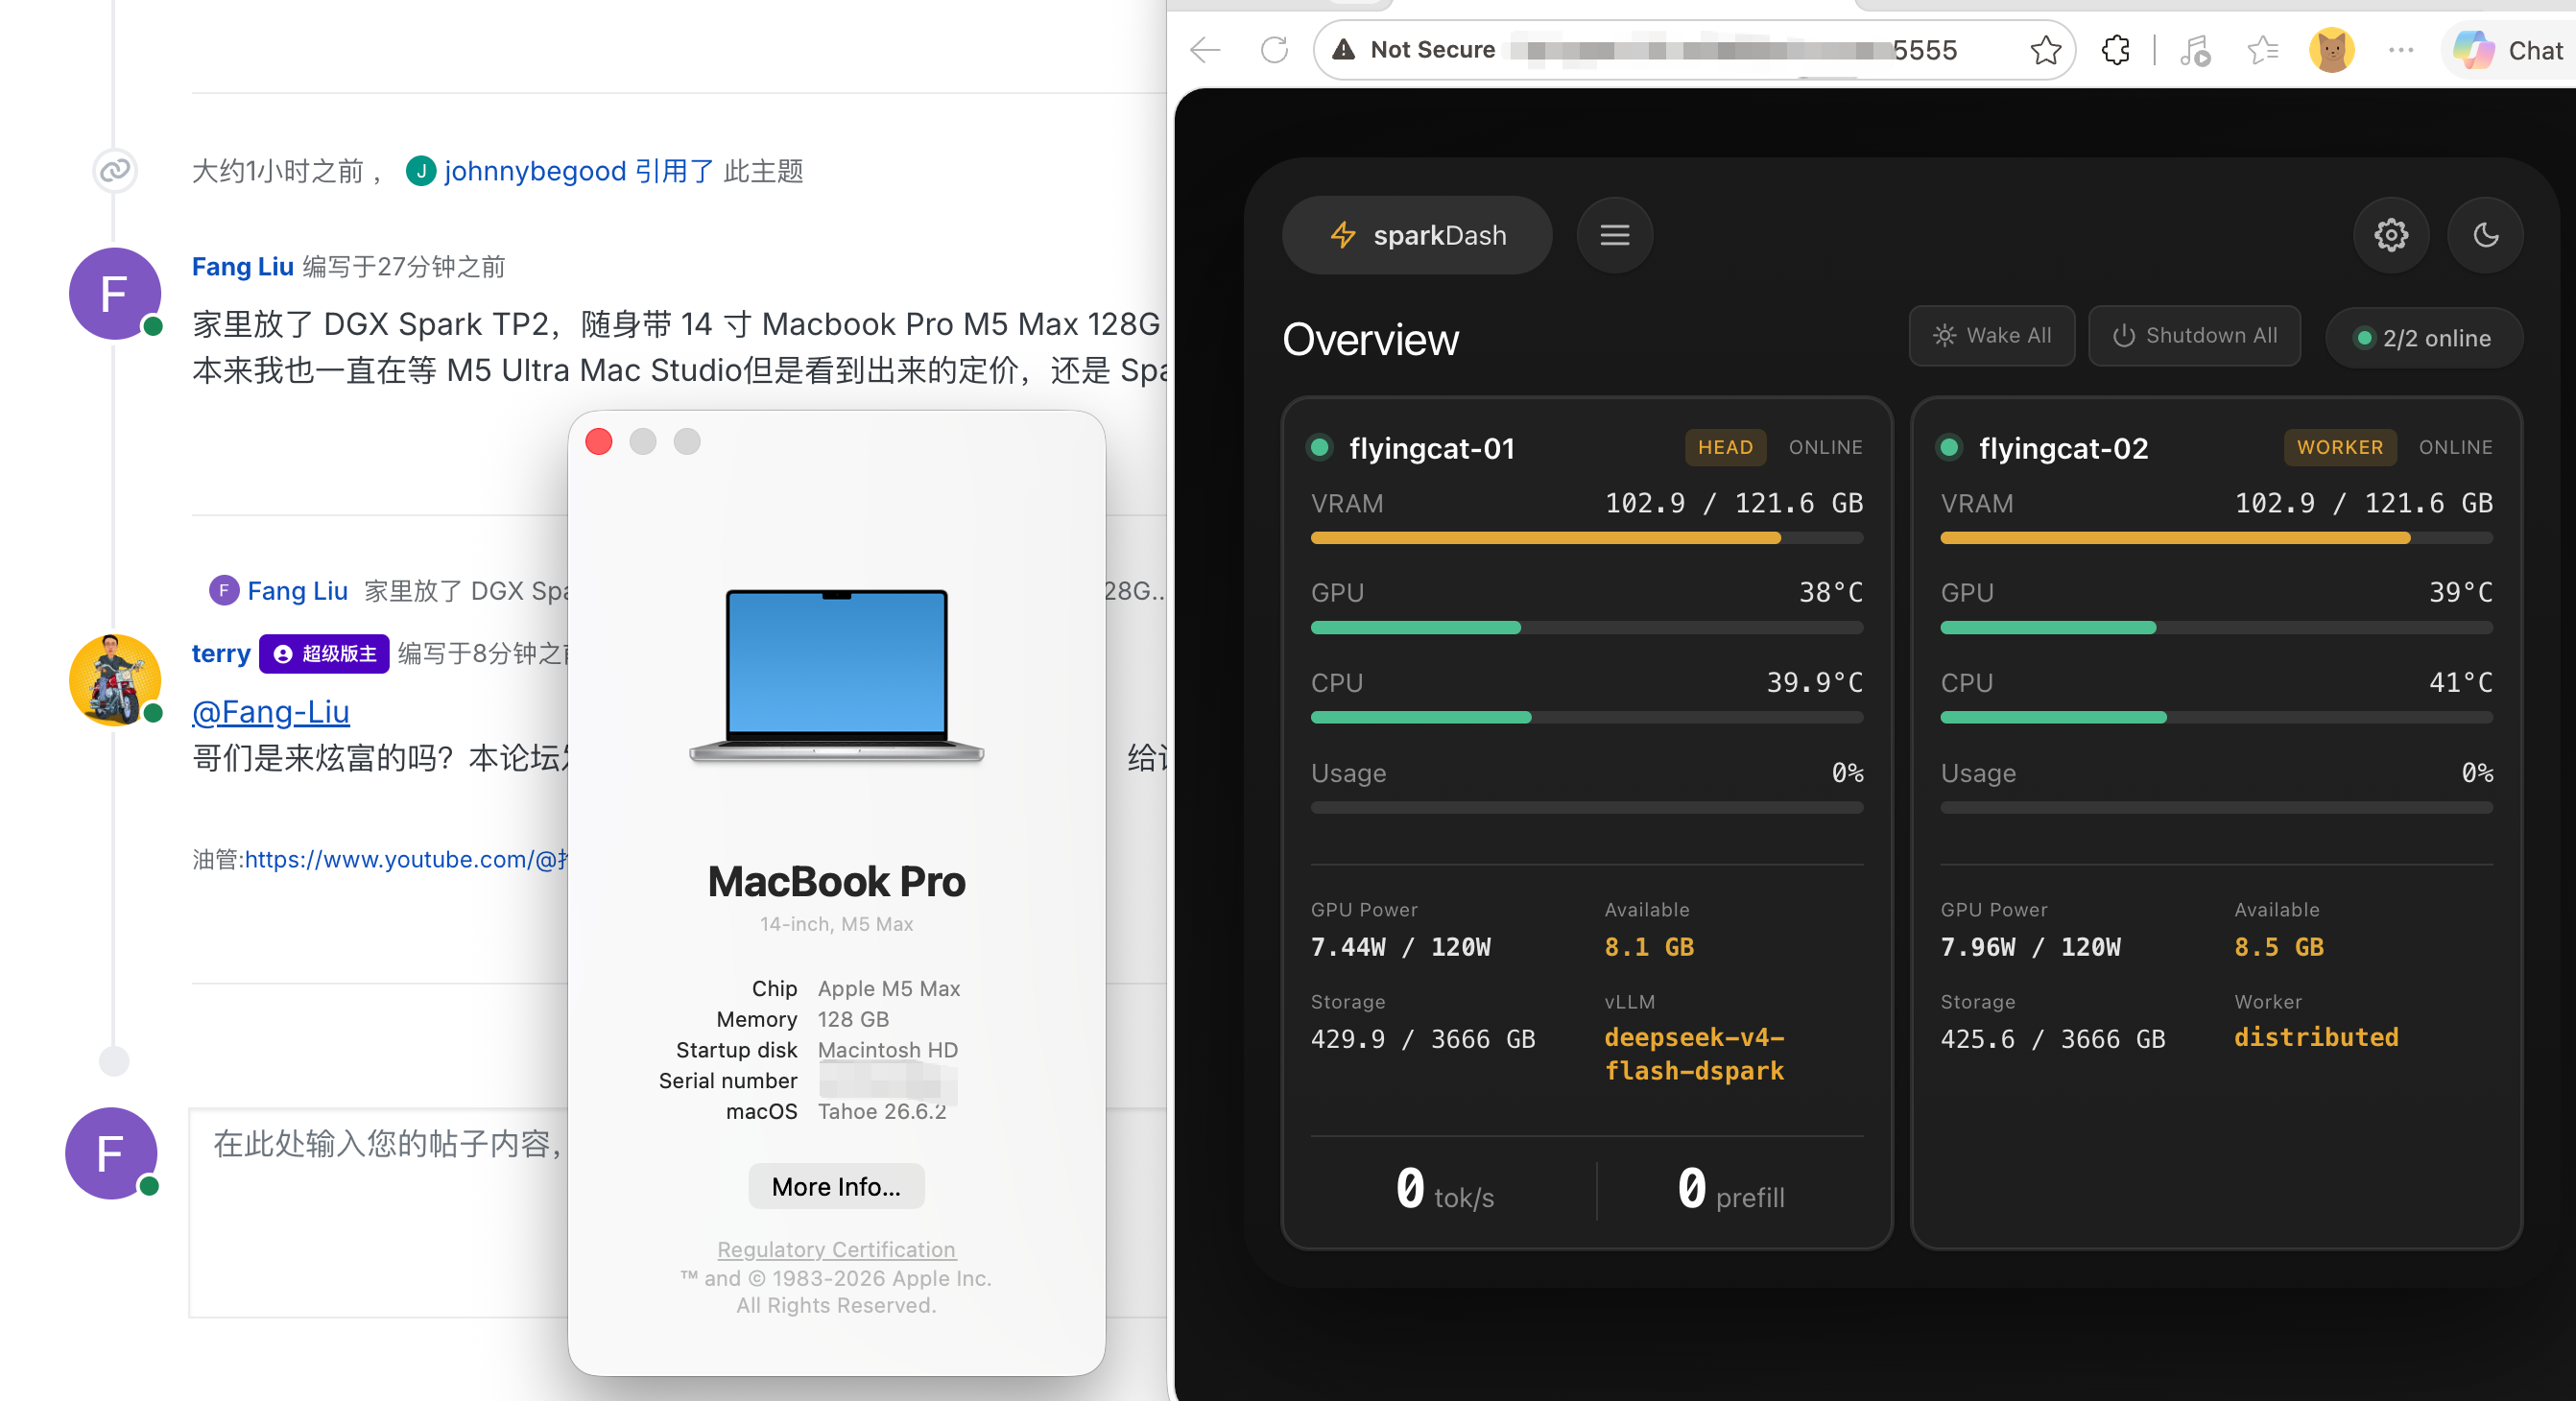
我其实就是笔记本到处跑,家里 Deepseek V4 Flash 0731随时待命
Agent 主要的任务几乎都跑在Deepseek 上,一些快速对话和任务就笔记本自己解决
然后我还没切换到 Vision Exp,所以视觉多模态都是本地用 Qwen3.8 27B作为前端先处理再喂Deepseek
128G 的 RAM,可以跑 Qwen3.6 35B A3B和 Qwen3.8 27B同时加载并发并且系统和其他工作软件也不影响
Qwen3.8 Flash Next我下了 oQ4e量化,在等 oMLX 继续完善
我的主要需求是复杂的办公,并不是 coding,未来复杂任务的工作流可能是本地 Qwen3.8 Flash Next + Deepseek V4 Flash Vision Exp + 线上的 Qwen3.8 Max这样的聚合
 F
Fang Liu
@Fang Liu
-
M5 Ultra 256G VS 双DGX Spark,谁是本地AI王者?96G的 M5 Ultra值得买吗?它和RTX Pro5000搭配高端PC怎么选? -
M5 Ultra 256G VS 双DGX Spark,谁是本地AI王者?96G的 M5 Ultra值得买吗?它和RTX Pro5000搭配高端PC怎么选? -
M5 Ultra的1.2T/s高带宽有多大用处? -
M5 Ultra 256G VS 双DGX Spark,谁是本地AI王者?96G的 M5 Ultra值得买吗?它和RTX Pro5000搭配高端PC怎么选? -
大家怎麼看:LM Studio Bionic -
个人用数据分析类的场景,最低需要什么模型可以达到效果 -
M5 Max Macbook Pro Hermes环境 硬件测试 -
Qwen3.8 27B M5 Max我下载了全精度权重用 oMLX 转换成了 oQ4e 量化,保留 MTP
https://huggingface.co/fevaoctwh/Qwen3.8-27B-oQ4e-mtp
在 M5 Max平台上可以说是精度和速度的一个平衡吧,更高的量化,M5 Max 就受限于内存带宽,decode 速度完全上不去了Measured with the built-in oMLX benchmark (
/admindashboard), single-request mode:- Engine: Auto
- Context: Code (Python)
- Test pattern:
pp<T> / tg128= prefill T tokens, then generate 128 tokens - Hardware: Apple Silicon (M5 Max, 128 GB unified memory)
Test TTFT (ms) TPOT (ms) Prefill (tok/s) Generation (tok/s) E2E (s) Throughput (tok/s) Peak Mem pp1024 / tg128 1161.5 15.84 881.6 63.6 3.184 361.9 16.72 GB pp4096 / tg128 5155.9 19.23 794.4 52.4 7.614 554.8 18.19 GB pp8192 / tg128 11856.7 18.13 690.9 55.6 14.176 586.9 19.24 GB pp16384 / tg128 25982.8 17.80 630.6 56.6 28.260 584.3 20.78 GB 量化后的能力肯定是打折的,作为 Agent 本地对话模型和简单任务是完全够用了,我现在使用的是Qwen3.6-35B-A3B-oQ6e
M 芯片目前的架构还是适合激活参数小的 MoE, 甜点尺寸应该是 100B 左右总参数量但是激活小于 10B 参数的模型Model Type Released MMLU-Pro LiveCodeBench v6 SWE-bench Verified Qwen3.8-27B-oQ4e-mtp (this model) Quantized 4/5-bit MLX, 27B dense Aug 2026 80.7% * — (not run) — Qwen3.6-27B Non-quantized, 27B dense Apr 2026 86.2% ~83.9 77.2% Qwen3.6-35B-A3B Non-quantized, 35B MoE Apr 2026 85.2% 80.4 73.4% Gemma 4 31B Non-quantized, 31B dense Mar 2026 85.2% 80.0 52.0% LiveCodeBench v6 还在跑 27/300…… 结果要明天了