
用Codex,Claude code,Deepseek Harness直接调用都很顺利,质量也不错,感觉自己省了好多钱,其实除了硬件也花了不少token,哈哈
 G
用Codex,Claude code,Deepseek Harness直接调用都很顺利,质量也不错,感觉自己省了好多钱,其实除了硬件也花了不少token,哈哈
@williamlouis A100是不是有机会先等到?
@Xiaote 那以我的情况,现在的价格,2万块以内换什么卡呢?
先说一下背景,本人80后,坐标上海,从2024年初开始用Claude总结会议纪要,写每周工作报告,到后来回邮件到后来用的越来越重.
到今年7月的时候就发现20美金的Claude和20美金的Codex都不够用了,开始想要不要玩一玩本地模型,当时还不知道Terry和这个论坛,就通过Chat-GTP和Google来回对比花了3000不到买了块V100的洋垃圾,想着如果跑通了未来可以升级.
没想到跑出了看起来似乎还不错的数字,这几天用下来感觉真的是能用了,加上Terry推荐的Harness,感觉Claude可以退掉了.
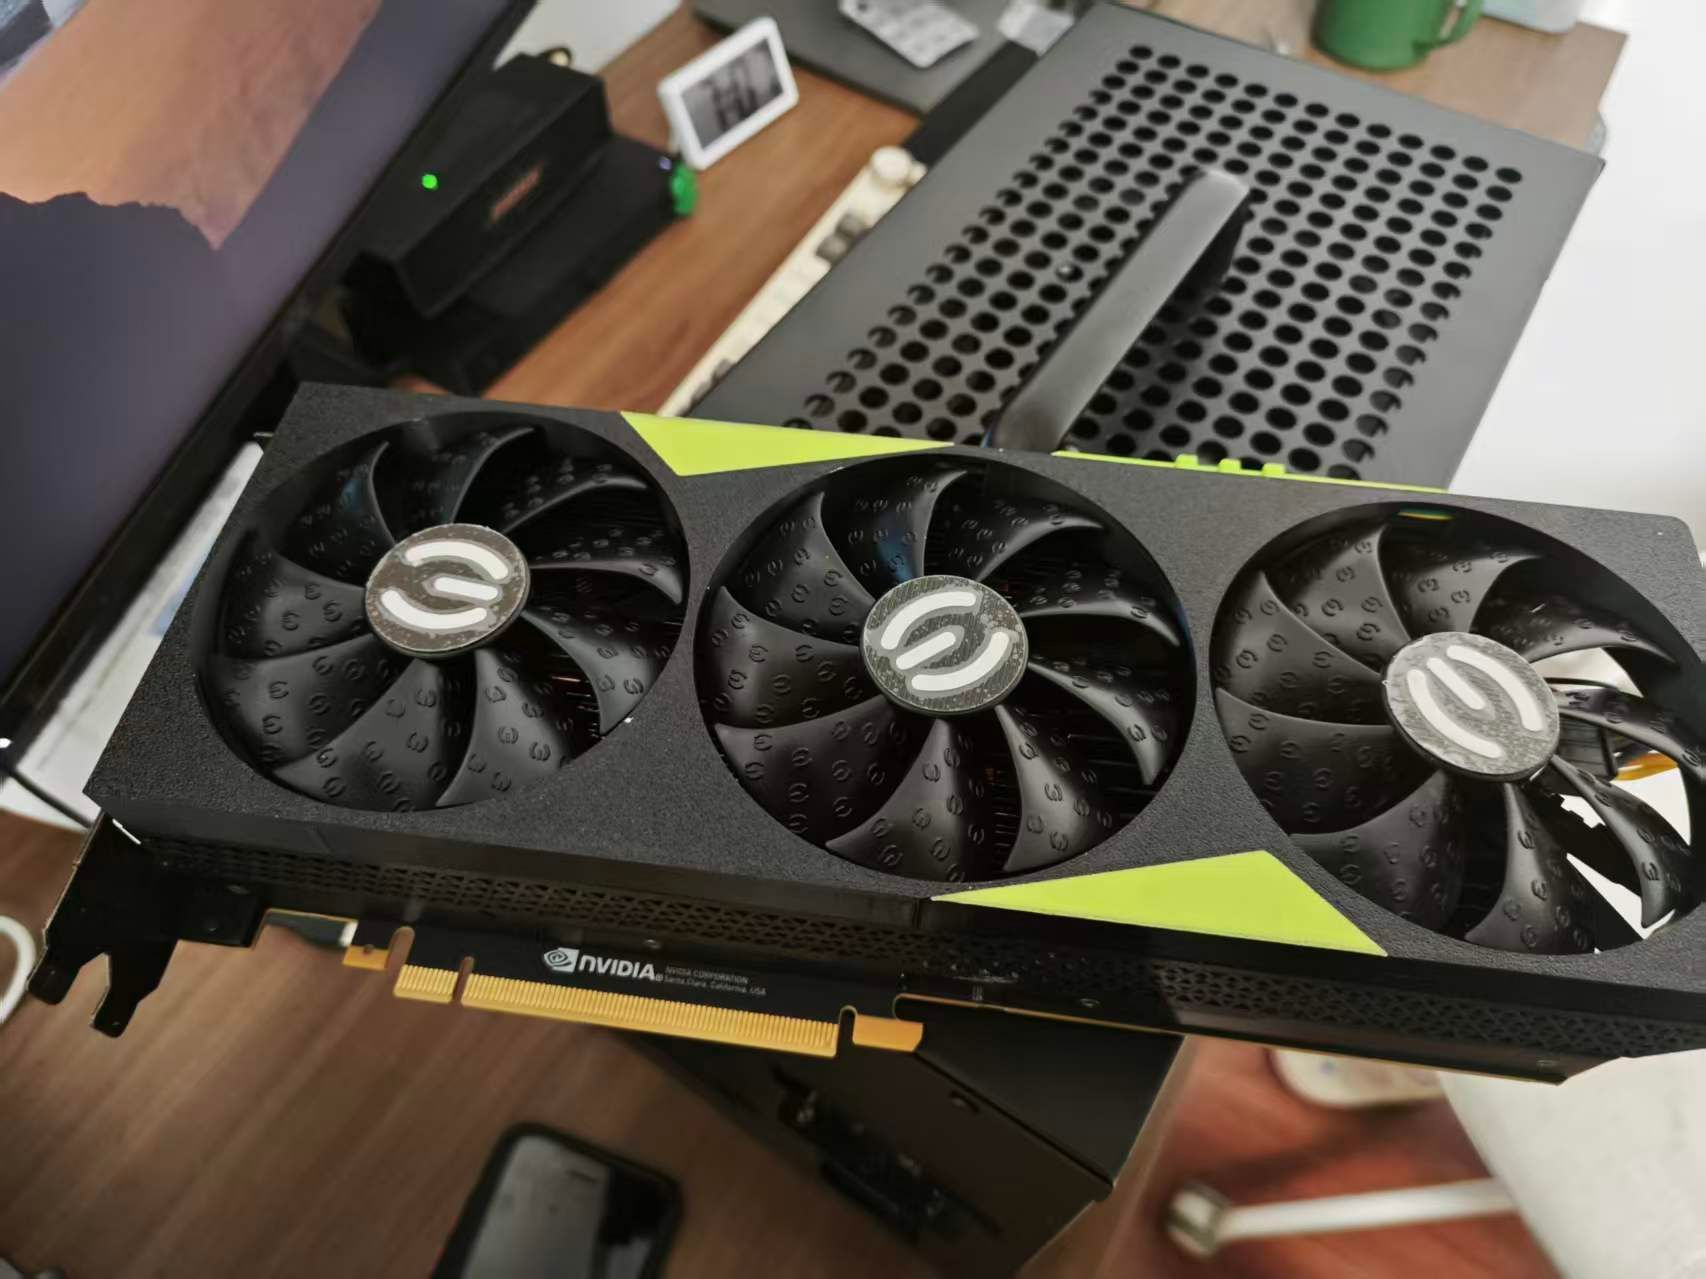
这是买回来卡和显卡坞时候拍的照片
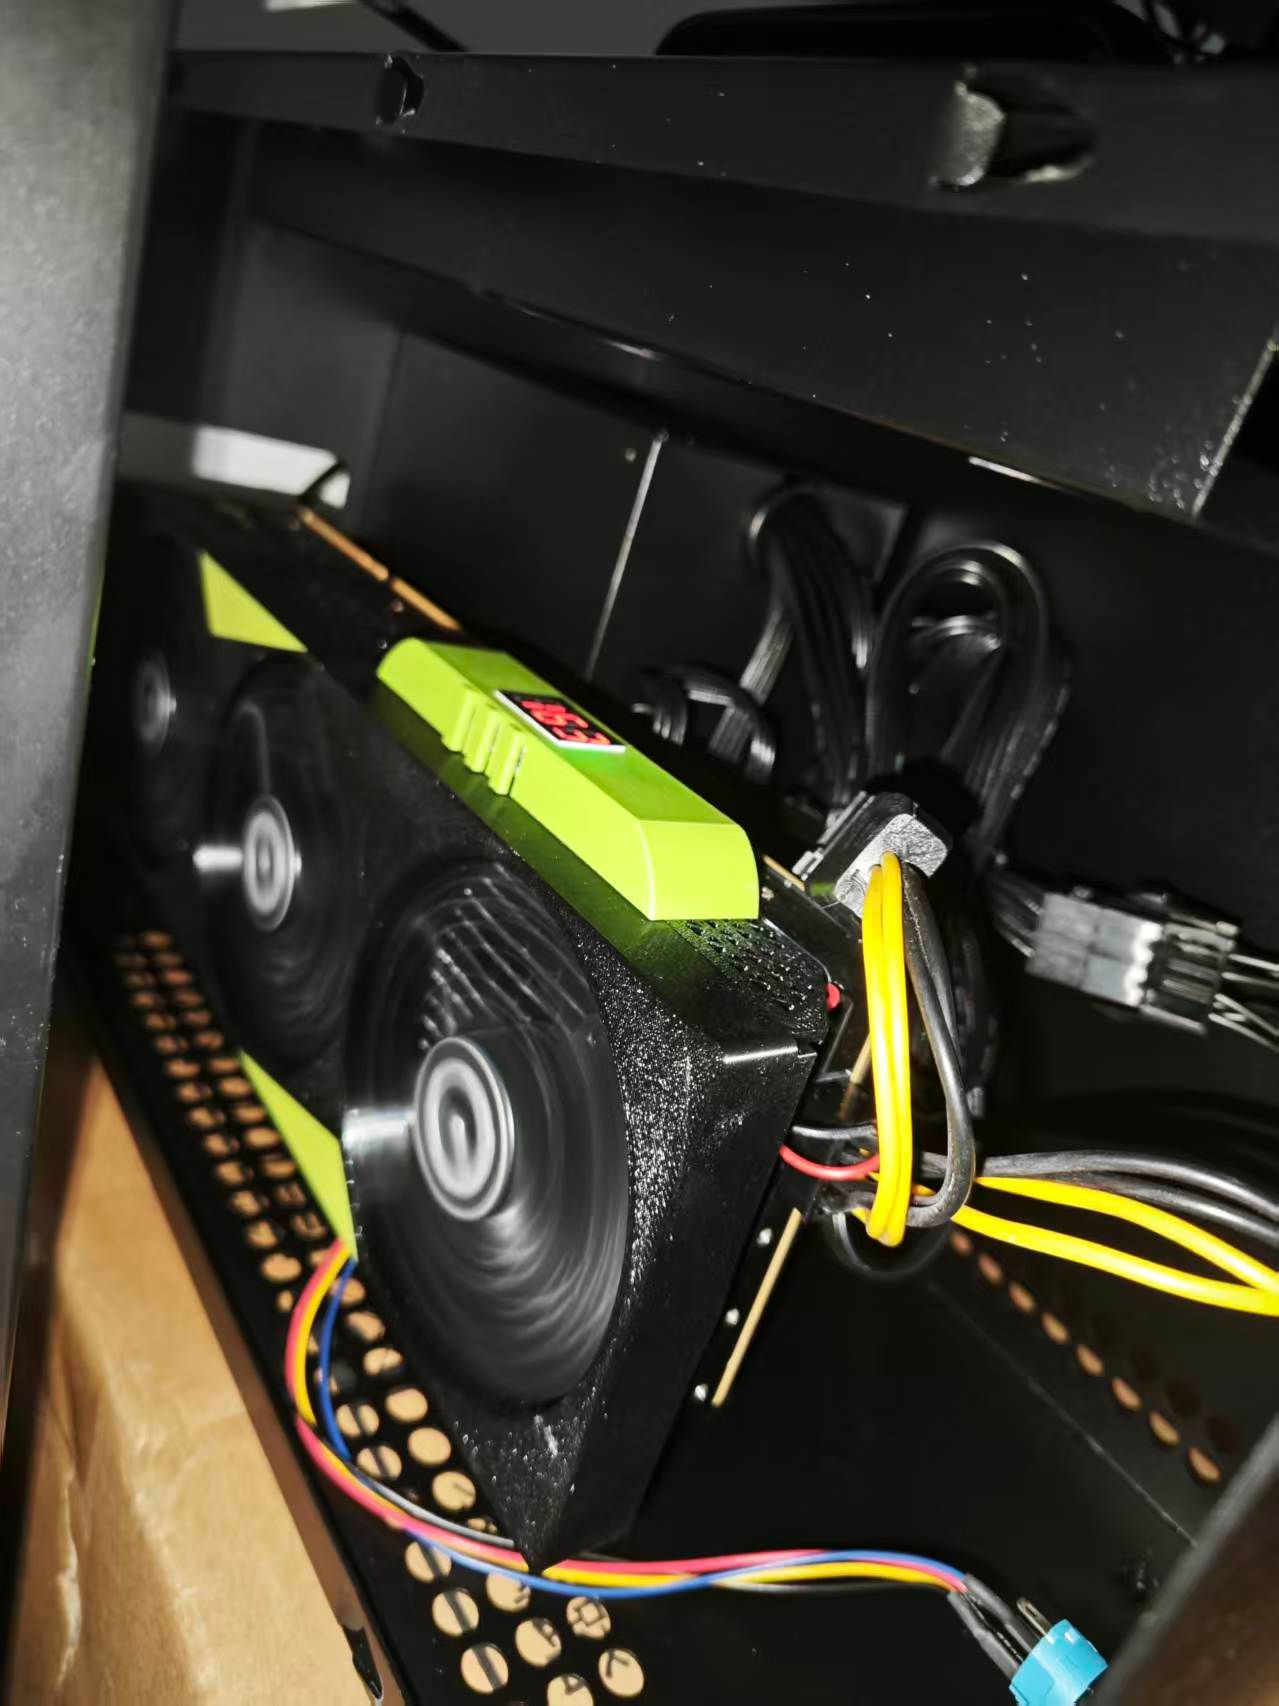
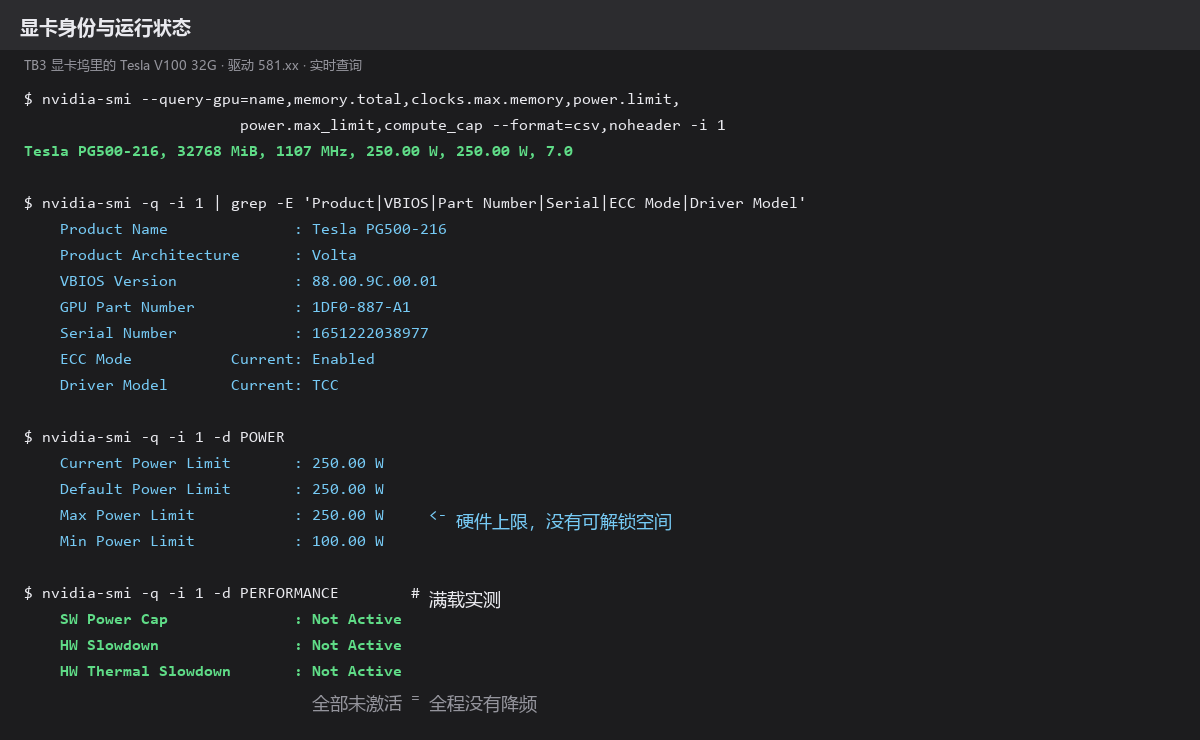
一、身份与规格:原厂 Tesla 信息完整
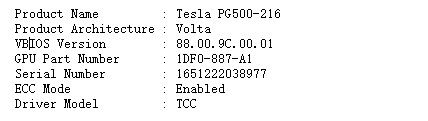
判断这张卡是原厂 Tesla 卡,依据就是这四项——它们同时出现在一张卡上,改卡很难伪造。
外接链路:雷电口协商到 PCIe Gen3 x4。坞内供电是 2× PCIe 8-pin,额定 300 W,另有一路 CPU 8-pin 未使用。
二、显存频率 1107 MHz,落在 V100S 规格上
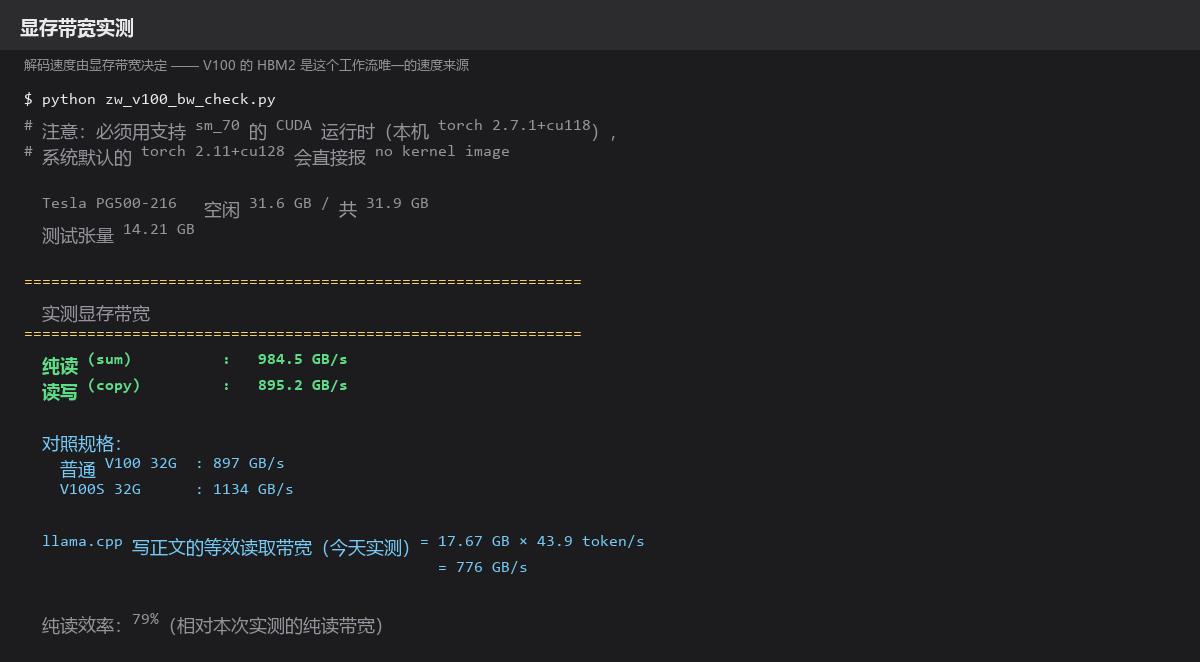
用 PyTorch 测 14.21 GB 张量的读写:
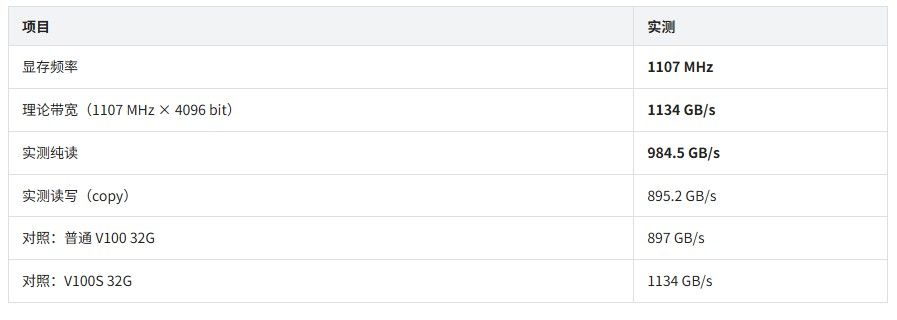
1107 MHz 这个频率把这张卡归到了 V100S 规格,实测带宽也印证了这一点:984.5 GB/s 的纯读落在 1134 GB/s 理论值的 87%,是合理水平。另一个参照是 RTX 3090 的 936 GB/s,这张卡比它高。
三、250 W 是硬件上限,满载全程没有降频
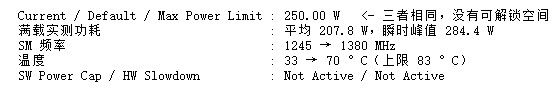
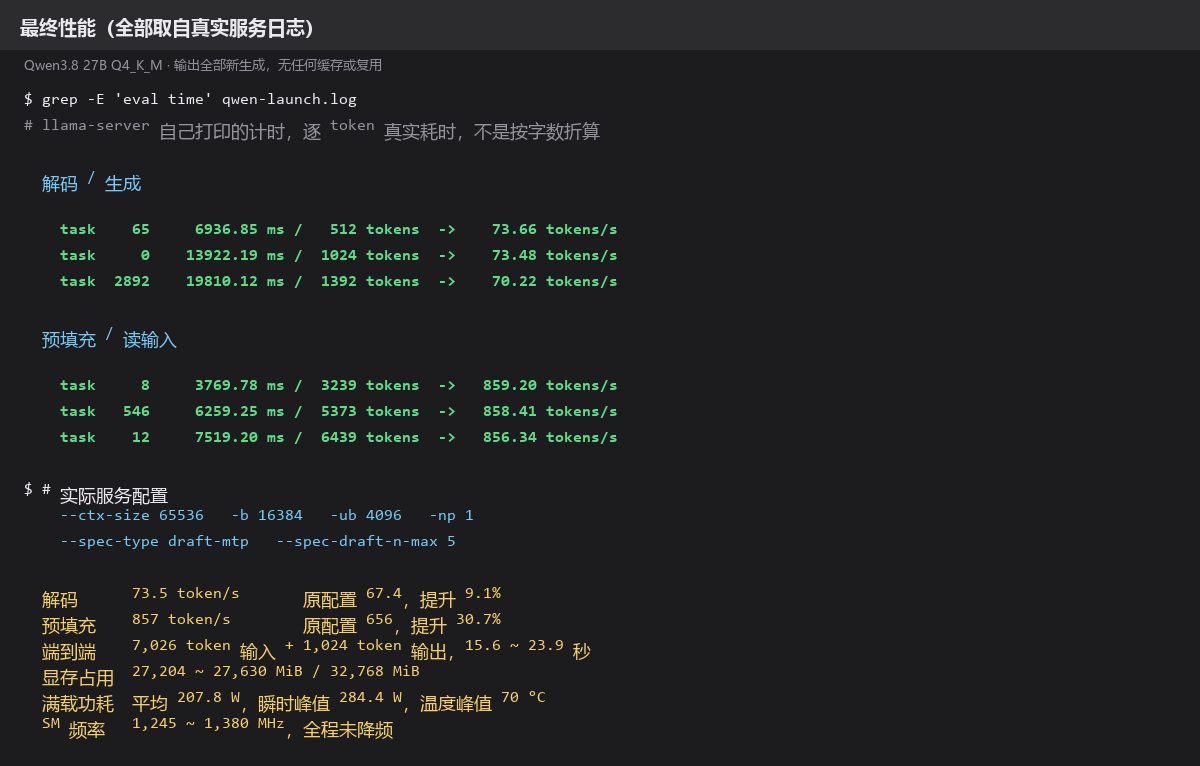
峰值 284.4 W 超过 250 W 上限,这是 GPU 功耗采样的瞬时超调,持续时间极短。三项降频原因全程显示 Not Active,说明没有因为功耗撞墙而降频。平均功耗 207.8 W 低于上限 42 W,250 W 这个额度平时用不满。
四、软件配置:llama.cpp 10964 加 MTP 投机解码
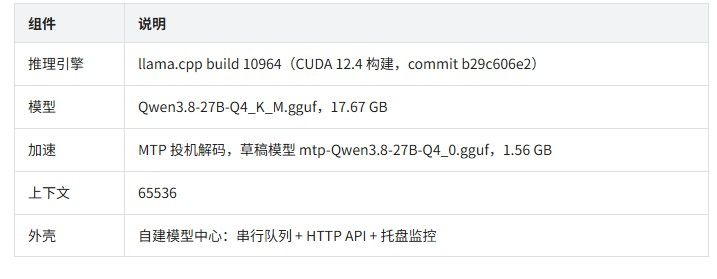
每一组都真实重载模型,负载是同一份 7026 token 真实材料加同一提示词,seed 固定,避免单次抖动。
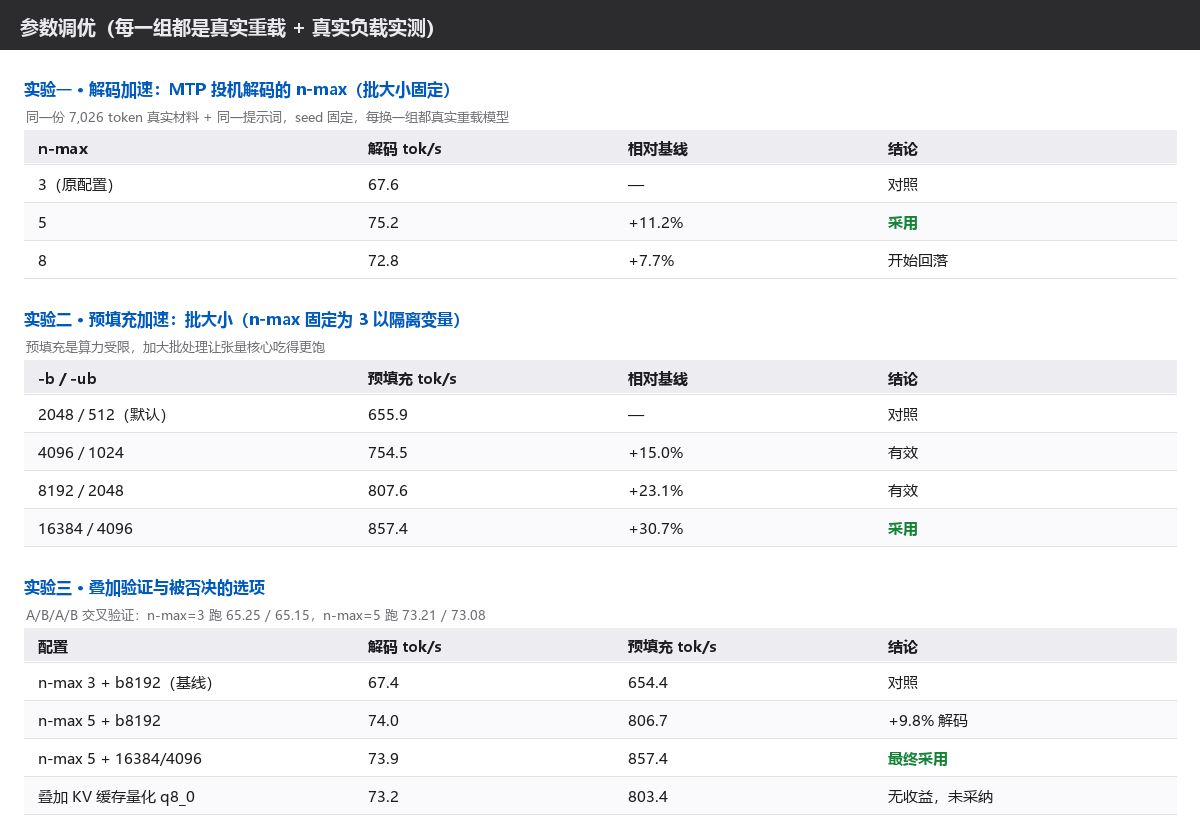
5.1 草稿长度 n-max=5,解码提升 11.2%
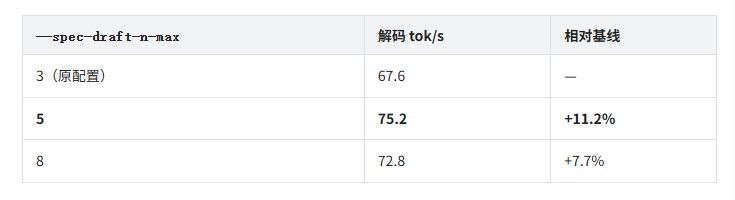
投机解码让草稿模型一次猜多个 token,n-max 是猜的长度。5 是甜点,8 开始回落——猜得越长,草稿本身出错概率越高,被主模型否决的浪费越多。
5.2 批大小 16384/4096,预填充提升 30.7%
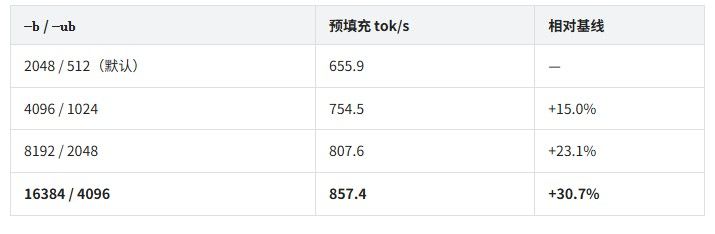
预填充是算力受限,加大批处理让 GPU 吃得更饱,这一组的收益比解码那一组更大。
5.3 KV 缓存量化:无收益,未采纳
--cache-type-k q8_0 --cache-type-v q8_0 跑出解码 73.2(对照 74.0),预填充 803.4(对照 806.7)。两项都略低,未采纳。
六、一个必须写出来的错误:用通用提示词测出来的结论是反的
第一轮调参,我用「写一篇行业分析」这类通用提示词做基准,得出「n-max 越大越慢」的结论,差点把投机解码关掉。
换成真实抽取负载(要求输出 FACT | 主题 | 内容 的结构化格式)重测,结论直接反转。
原因在草稿接受率:
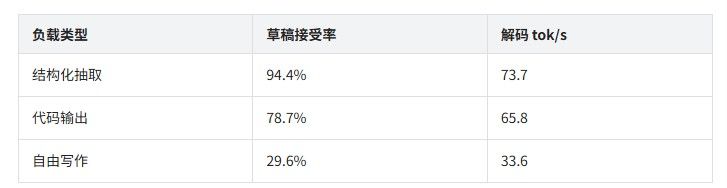
结构化抽取的输出格式高度可预测,草稿模型几乎每次都猜对;自由写作没有可预测的套路,草稿十次里错七次。同一张卡、同一个模型,差 2.2 倍。
这条经验比任何一组参数都值钱:判断本地模型够不够快,必须用自己真实的负载去测,通用 benchmark 在这里会给出完全错误的结论。
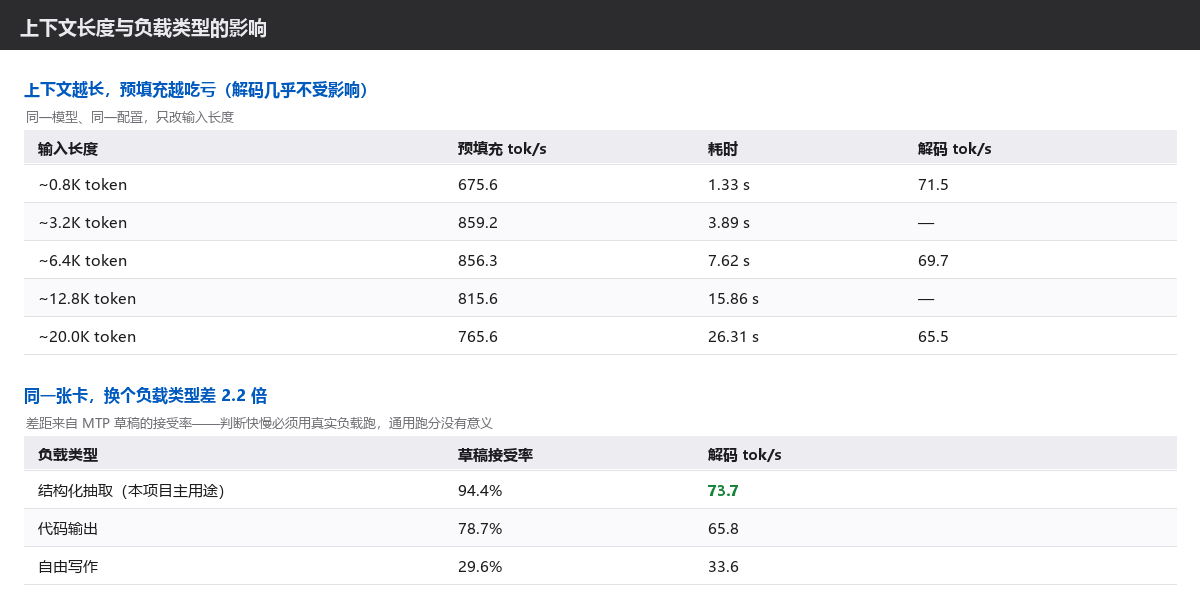
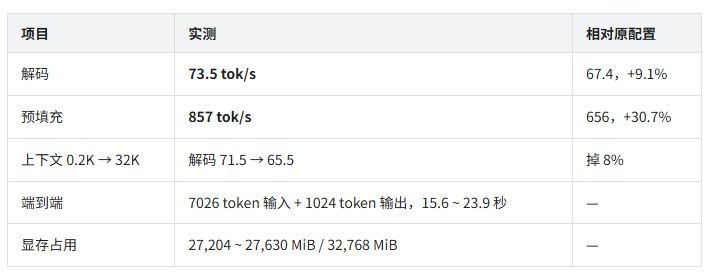
七、最终结果:解码 73.5 tok/s、预填充 857 tok/s
--ctx-size 65536 -b 16384 -ub 4096 -np 1
--spec-type draft-mtp --spec-draft-n-max 5
九、我拿来做什么工作:
投研报告的资料抽取——几万字行业材料进去,输出结构化的数字登记表与事实表
会议纪要提炼——录音转写稿进去,出主题、结论、行动项
本地翻译——中英文材料互译
不跑 ComfyUI 生图,不做模型训练。负载以长文本读取和结构化输出为主,解码占七成、预填充占三成,正好是这张卡带宽优势能吃满的地方。
写在最后
先谢 Terry。DeepSeek Harness 这套东西是从你的 YouTube 频道看到的,还有很多需要向你和大家学习.
作为一个小白现在似乎已经跑通了本地模型部署了,下一步肯定是无尽的硬件,软件折腾,时隔快20年再一次在论坛发帖,好多青少年时期"玩电脑"的回忆又涌现出来,岁月如梭,祝大家开心.