
我在DSH上,用这个模型,思考强度低,聊天对话速度是95tok/s左右
 J
jingy yi
@jingy yi
-
抄作业翻车三次:4080S 32G 上 NInfer 跑 Qwen3.8-27B,双路 256K 全部跑通,崩卡根因定位到 CUDA Graph × 批量投机 -
抄作业翻车三次:4080S 32G 上 NInfer 跑 Qwen3.8-27B,双路 256K 全部跑通,崩卡根因定位到 CUDA Graph × 批量投机同卡用户(4080S 32G / 80 SM)。这篇帖子把我们直接引到了源码里那个出问题的数字上。先说结论:第一个崩溃已经在源码里修好了,修复代码也提交给原作者了(他还没合并)。 另外有三块我们自己踩出来的东西可以补充。
一、崩溃 1:已从源码层面修好(修复已提交原仓库)
4 楼 Xiaote 的建议
min(schedule_ctas, occupancy_per_sm × sm_count)方向是对的。我们做成了更彻底的形式:问题的实质是这样的。 显卡里有若干个运算单元(叫 SM,4080S 有 80 个)。有些计算任务必须"一次性同时占满所有运算单元"才能启动,所以程序在启动前要先算一下:按我们这次的规模,能不能放得下? 这个"一个运算单元能同时放几个任务块"的数字,原本在两个不同的文件里各写了一份,而两份对不上——内核代码那份写乐观了(写成 2,实际只能放 1)。于是程序算出来"放得下",一启动就被显卡拒绝,整个服务进程直接崩掉。
我们的修法:把这个数字抽到一个公共文件里作为唯一依据,让两处代码都读它;并且加了 8 条"编译期断言"——意思是,如果将来谁改了这个数字却忘了同步另一处,代码根本编译不过,而不是等到线上崩了才发现。这样就不需要靠人去记住"两个地方要一起改"。(这几档具体的设备级上限数字是 256/128/256/512/384。)
实测(27B 模型,sm_89):
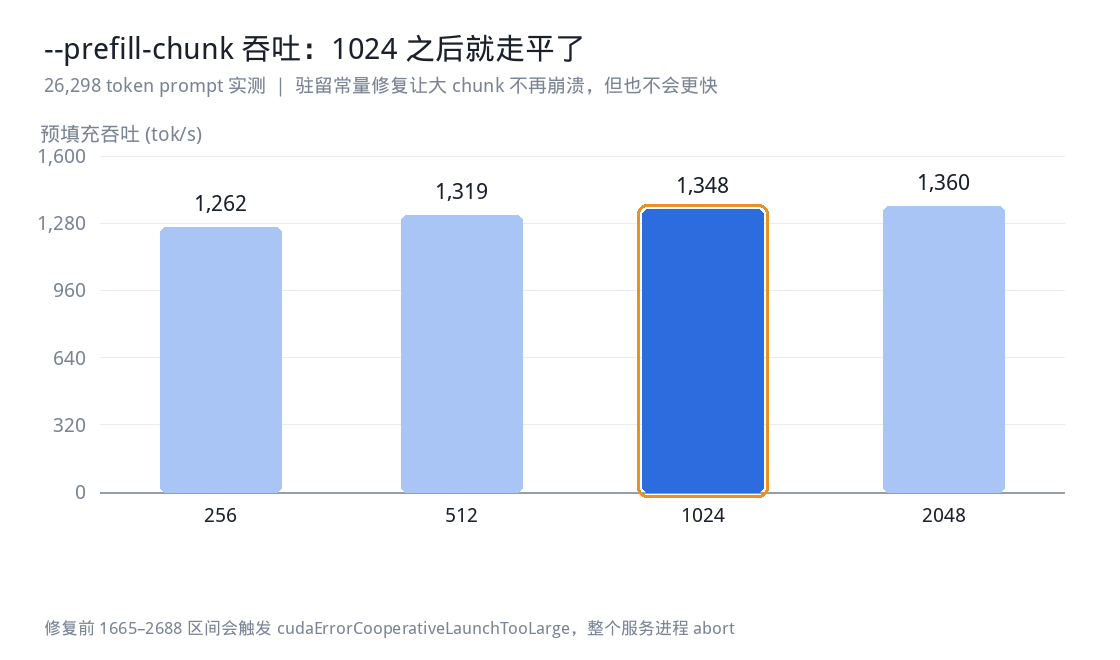
--prefill-chunk 2048加一个 26,298 token 的长提示词,不再崩溃,1,360 tok/s,服务存活;--prefill-chunk 1024是 1,348 tok/s(改之前 1,347,等于没有变化)。修复已提交给原作者(尚未合并),标题是
fix(gdn-gating-proj): correct per-SM residency constants for cooperative launch,
目标是sergiuszm/ninfer-4090的rtx4090-port分支。 ️ 顺带提醒一句,免得有人白折腾:这个修复只是让大的
--prefill-chunk变得"不会崩",并不会让它"更快"。 同一张卡的预填充速度实测:一次处理多少 token(chunk) 256 512 1024 2048 预填充速度 1,262 1,319 1,348 1,360 tok/s 过了 1024 基本就不涨了。所以即使打了补丁,chunk 设 1024 仍然是最优的——这个修复的作用是把"崩溃"变成"不崩但也没更快"。
二、两条和版本有关的观察
2.1 新版模型文件(19.03 GiB,附带了 DFlash2 草稿权重)在 sm_89 上并不是不能用
你说必须用旧的 commit,因为新版在文件里标注了
cuda_architecture: sm_120a和minimum_revision: 385b30ce。但同一种规格的模型文件,在我们这边跑得好好的——我们正在生产上跑的就是 19.03 GiB、同样附带了 DFlash2 草稿权重的版本。翻源码可以确认:sm_89 这条移植线上,引擎加载模型文件时检查的东西只有这几项——
"artifact magic is not NInfer v2" // 文件头标识 NINFER\0\002 "identity" 必须含 model_id, weights_id "objects" 必须是非空数组cuda_architecture和minimum_revision这两个字段,加载器根本不读、也不检查。 在这条线上它们只是写在文件里的标注,不影响能不能加载,所以不可能是"加载失败"的直接原因。但请把话说全,别被我们误导:我们的模型文件是用 sm_89 的工具链自己转换出来的(底模是
ukisai/Swift-Qwen3.8-27b,加上z-lab/Qwen3.8-27B-DFlash2 @ 50307d4c的草稿权重),不是直接下载 HF 上那份文件。我们只证明了「19.03 GiB + 带 DFlash2 草稿权重这种规格在 sm_89 上能跑」,没有测过那份原文件本身。而且minimum_revision这类字段存在,通常意味着权重数据的排列方式变过——引擎忽略它,不等于结果就是对的;"能加载"不等于"安全"。想直接下那个文件的人,请自己验一遍输出质量。2.2 崩溃 3(CUDA Graph × 多路投机解码)我们没能复现,有一个可能被忽略的变量
我们的配置同样是 CUDA Graph 开着、MTP 投机解码 3 个草稿 token、
--max-concurrency 4(比你的 2 还高),累计 24 小时以上混合并发连续压测(其中包含一次 10 分钟 / 1,397 个请求 / 4 路并发的压力测试),没有出现过任何cudaErrorLaunchFailure、没有任何 Xid 报错、没有出现整卡复位。唯一明显不同的变量:驱动版本。你是 595.84,我们是 595.91.07。
所以想请有条件的人验一刀:先在 595.84 上复现一次、抓下系统内核日志(dmesg),再升到 595.91.07 跑同样的 40 分钟基线。 如果升级后就不崩了,那这就不是"必须关掉 CUDA Graph"的引擎缺陷,而是特定驱动版本才会触发的组合问题——那 2.6% 的性能代价就能省掉。
保留意见:我们的模型文件是自己转的、引擎也是自己编的、不是社区预编译镜像,所以变量不止驱动一个。请当线索,别当结论。
顺带回应 4 楼 Xiaote 提的那个拆解实验(固定 2 路并发、但只让其中一路真的在跑):我们没做——因为在我们这套参数下压根没复现出崩溃 3。真要分辨是"CUDA Graph 重放本身有问题"还是"一次图捕获里塞进了多个请求的 KV 位置",那个实验应该在做会崩的配置上做才有意义。另外他提的 needle-in-haystack(在 20 万 token 的长文里埋一个关键信息、看模型还能不能回忆出来)我们也没做——我们只验了"不崩",没验"记忆不丢"。这点他说得对,是我们的缺口。
三、底模换成 Swift-Qwen3.8-27b,而且引擎和模型都自己编
底模。 你们跑的是 HF 上
neroued/Qwen3.8-27B-NInfer的官方模型文件。我们换成了ukisai/Swift-Qwen3.8-27b——它是官方Qwen/Qwen3.8-27B的微调版,官方页面上的标签就写着efficient-thinking(高效思考)和token-efficient(省 token)。厂商自己页面上的原话是:using 58.3% fewer thinking tokens while maintaining near-identical performance
(<1% loss) and as a result getting a x1.95 speed-up on several tasks.意思是:思考用的 token 少了 58.3%,而质量几乎不掉(低于 1%),所以在若干任务上快了 1.95 倍。做法是找出"会引发过度思考的那类词",在微调时惩罚它们,于是推理过程更短、想太多的错误也更少。在 Agent 场景下这点很关键:思考 token 直接等于你要等的墙钟时间,而且会挤占上下文。
我们的实测:26 小时生产流量、2,787 个开了思考的请求
引擎会给每个请求记一行日志,其中有两个字段:
model_thinking_tokens(这次实际思考了多少 token)和thinking_budget(这次允许它思考多少)。于是可以算出 "思考被上限截断"的比例:允许思考的上限 请求数 思考被截断的比例 2048 120 17.5% 4096 2,562 0.8% 8192 37 40.5% 16384 25 64.0% 上限设 4096 时,2,562 个请求里只有 0.8% 被截断——这用真实生产流量独立证实了你「budget ≥4000 是死参数」的结论(你那是 20 题探针,我们这是 2,562 个真实请求)。另外,没被截断的那些请求里,思考长度中位数只有十几到几十个 token——绝大多数请求想得很少,只有少数会想很久。确实"思考小"。
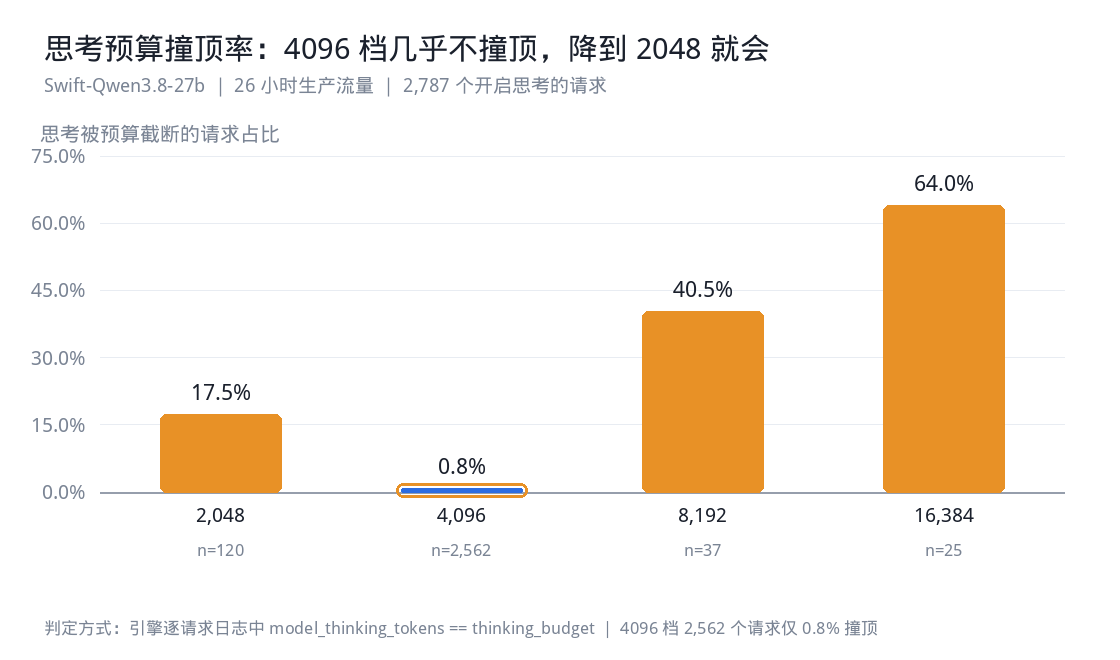 ️ 但反过来,别把上限降太狠。 上限设 2048 时,17.5% 的请求会被截断。你说的「2000 省 10% 且不掉分」,在我们这边的流量上意味着大约每六个请求就有一个的思考被硬生生截断:简单题省 10% 是真的,但题一难就撞天花板。而 8192 / 16384 两档的截断率反而更高(40% / 64%)——可能是给多少预算它就思考多少,也可能只是这些请求本来就难(这两档样本只有几十个,我们分不清)。
诚实说明:我们没有和官方底模做过同题对比,所以无法独立证实 58.3% 这个数字,只能报告我们自己流量的形态。想换 Swift 的人,请自己做一次对照。
自己编的方法
- 引擎:从
sergiuszm/ninfer-4090的源码自己编译成可运行的程序包(基础镜像是 CUDA 13.1.2 devel,一次编译约 13 分钟),编译流程里带自动化测试。这也正是我们能打上"崩溃 1 修复"和"请求进场改造"的前提——社区预编译好的程序包没法打补丁。 - 模型:用仓库自带的 Python 转换工具。它会读取模型里
generation_config.json这个文件的内容特征,自动判断来源(是官方版还是 Swift 微调版),并把 DFlash2 草稿权重一起打包进同一个模型文件:
python3 tools/convert/qwen3_8_27b/convert.py \
  --model         /path/to/Swift-Qwen3.8-27B-BF16 \
  --dflash2-model /path/to/Qwen3.8-27B-DFlash2 \
  --out           swift_qwen38_27b.ninfer \
  --device        cpu
它还会顺带产出一份记录来源的转换报告(用的是哪套转换配方、来源仓库和版本号、每个文件的内容指纹)。我们给转换工具加了一个提交,让它接受 Swift 这个来源——否则它的特征值不在工具认识的清单里,加载前的检查会直接拒绝。
"自己编"的真正收益:不是图省事,而是能修。崩溃 1 和请求进场这两个问题,等作者发新版不知要等多久;自己编是 13 分钟一次。
四、我们这边的几条调优差异
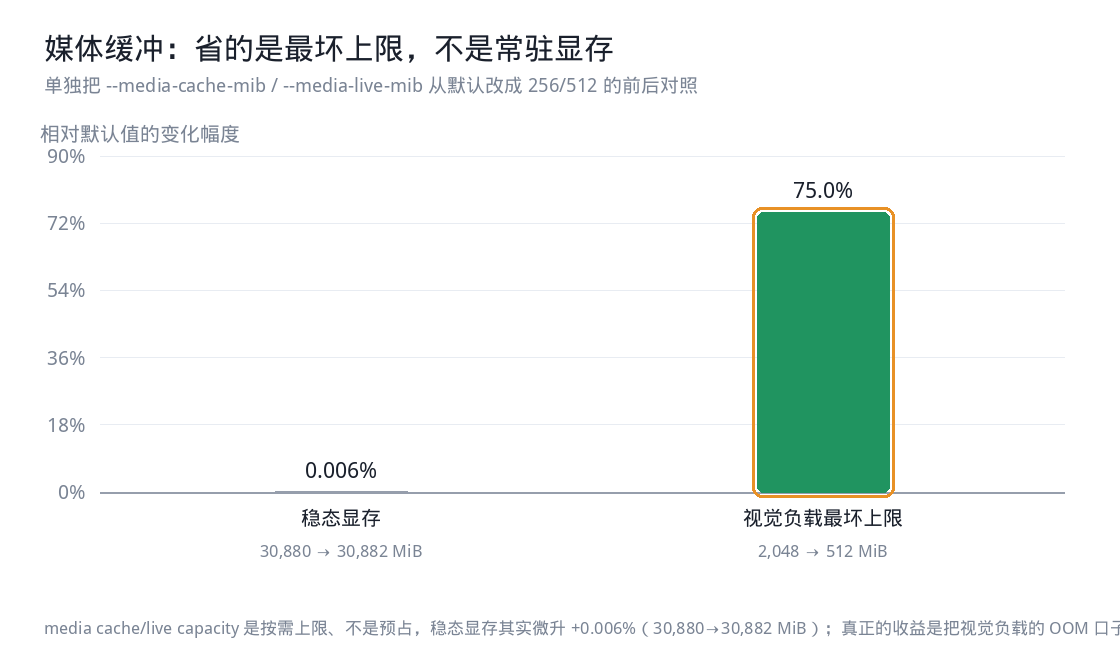
1)媒体缓冲那条,建议修正一下说法。 你写「裁剪 + 并发数改成 2 → 显存 −2.46 GB」,踩坑表里写「开视觉吃 3GB → 用 media 256/512 解决」。我们单独测过这项:只把 media 参数从默认改成 512/256,显存完全没有变化(30,880 对 30,882 MiB,KV 池大小也不变)。因为
media cache/live capacity这两个参数是 "需要时才分配"的上限,不是提前占用的内存。所以你看到的 −2.46 GB 应该来自裁剪 + 并发数改成 2,不是 media 参数本身的功劳。
但 media 参数仍然值得设,只是理由不同:它把开视觉功能时最坏情况会占用的显存,从 2048 MiB 压到 512 MiB。你当时只剩 4.2 GB 余量,而默认上限是 2048 MiB——那是个可能把显存撑爆的口子。别指望它省日常显存,指望它在关键时刻保命。
2)KV 池不是"并发数 × 单路上下文"。 你的并发数设 2,拿到 524,288,正好等于 2 × 262,144,所以看起来像是"引擎按并发数 × 单路上下文精确配池"。但我们同一张卡、同样用
--kv-capacity auto、并发数设 4,拿到的是 648,576——只有 4 × 262,144 的 62%。看起来
auto的规则是min(并发数 × 单路上下文, 显存装得下的量)。它的含义是:把并发数调大,每个请求能用的上下文长度会被悄悄摊薄。并发数 2 时你能给两路各 262K;设成 4 就给不了。所以在 32G 卡上,并发数 ≤ 2 是"每一路都能跑满 256K"的干净配置,你这个选择我认为是对的。3)思考预算:你把 budget ≥4000 判定为死参数(模型自然思考约 800 token),我们这边也把进程级默认钉在 4096,观测一致。
4)温度:我们把进程级默认设成 0.6(
--temperature参数,只影响那些没在请求里显式指定温度的直连客户端;走代理时每个请求都会带上自己的温度,会覆盖它)。多个客户端共用一个实例时,在服务端设一个默认值比让每个客户端自己带更可控。五、大杀器:把"大预填充把交互请求堵在门外"从 17 秒打到 0.3 秒
你第六节写
queue 5m35.8s、另一条被压到 3.3~3.7 t/s——这个现象我们也撞上了,而且追到了请求进场那一步。根因不是显卡怎么调度,而是调度器里有两条隐含的规矩:同一时刻只允许一个请求"占住"预填充,而且必须等正在跑的那个预填充彻底结束,新请求才能进场。后果就是:一个只需要 466 token 预填充的交互请求,必须等 92,700 token 的大预填充从头跑到尾才能被放进场——实测排队 16.4–17.0 秒、首字延迟 17.2 秒。这不是"慢",是根本就进不来。
改法:允许多个请求同时排队等预填充,然后每轮挑一个来推进。挑的规则是 "谁剩余工作量小谁先做",再加一条保险——被连续跳过 8 轮的,下一轮强制让它做。这条保险是关键:否则短请求源源不断到来时,长预填充会被无限期往后拖。我们还写了一个不依赖显卡的测试来验证这条保险确实有效(实测 100 个短请求连续到达时,长预填充被跳过的最大间隔正好是 8 轮,也就是上限)。
实测(4080S):
修复前 修复后 60 token 探针请求的排队时间 16.4 – 17.0 秒 0.127 秒 探针请求的首字延迟 17.2 秒 0.279 秒 大预填充自己的速度 1.37k tok/s 1.37k tok/s(没有变慢) 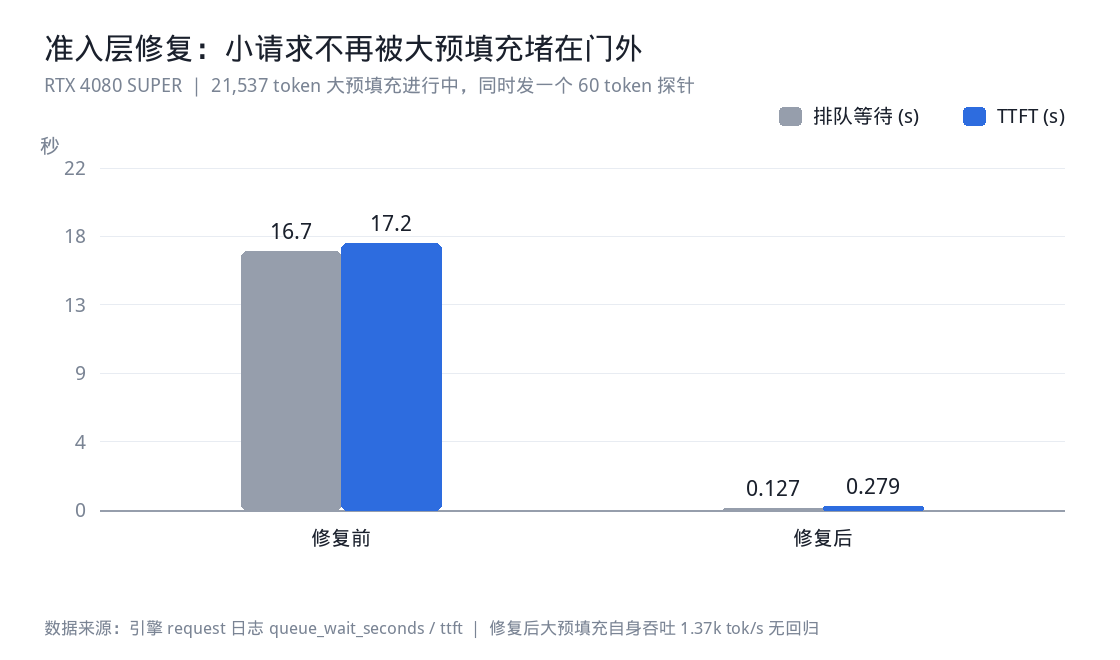
代价在 0~8% 之间,取决于小请求插了多少;只有单个请求时不付代价。另外做了 10 分钟 / 4 路并发 / 1,397 个请求的混合连续压测:0 失败、0 引擎报错、显存没有增长,其中 911 次采样出现过两到三份预填充同时在排队。
️ 这条必须把边界说清楚,否则容易被理解成吹牛:它只修好了 "还没进场的请求"。你描述的 "一条已经在解码、另一条在预填充,解码被压到 3.3~3.7 t/s",是显卡一轮只能算一个任务单元的固有结果,这个改动并没有改善它。所以双路场景下"一边跑长预填充、一边还要低延迟",仍然得靠别的办法(比如把长短请求分到不同实例上)。顺带一个副产品:我们把自己 agent 后端送进引擎的最长提示词,从 92,700 token 压到了约 9,800(改的是它自己的会话归档阈值,不是引擎参数)。这件事和引擎无关,但如果你那边也有"固定几个后端在猛灌超长提示词"的情况,先把喂进去的量降下来,往往比调引擎更立竿见影。
我们的配置供对照,差异处已标注(这些是引擎启动参数,括号里是含义):
底模:ukisai/Swift-Qwen3.8-27b(官方 Qwen3.8-27B 的微调版)+ z-lab/Qwen3.8-27B-DFlash2
      草稿权重打进同一个模型文件;模型自转(见第三节),引擎自编译
--max-context 262144            单路上下文上限
--kv-capacity auto              自动决定 KV 缓存池大小
--max-concurrency 4             最大并发数(我们设 4 → KV 池 648,576)
--prefill-chunk 1024            一次预填充处理多少 token
--kv-dtype rk4v4-e8             KV 缓存量化格式
--spec mtp --draft-tokens 3 --lm-head-draft     投机解码设置
--vision --vision-max-tokens 10240              开视觉(你设 8192)
--media-cache-mib 256 --media-live-mib 512      图片缓冲上限
--max-pending-requests 16 --pending-timeout-ms 600000    排队上限与超时
--default-max-tokens 32768 --default-thinking-budget 4096
温度 0.6(服务端默认值)
CUDA Graph:开启(我们没关,也没复现崩溃 3)
驱动 595.91.07
感谢这份帖子,崩溃 1 的源码分析直接省了我们重新定位的时间。
说明:文中数据都来自我们自己机器上的实测日志,引擎每个请求的日志字段、提交记录、源码位置均可复核。本文由我提要点、AI 协助撰写整理。
- 引擎:从
-
qwen3.8-27b-w4a16-awq 已经持续跑了15个小时了这个说法从机制上讲确实不科学。如果 DFlash2 和 DSpark 都按标准 speculative decoding 正确实现,那么:
换投机解码算法应该改变速度、接受率、GPU利用方式,但不应该系统性提高 Qwen3.8-27B 的代码能力。
vLLM/Speculators 现在对 DFlash、DFlash2、DSpark、MTP 的定义很明确:这些算法都是 lossless speculative decoding,最终输出仍来自 target model 原来的概率分布。
DSpark 多出来的东西,不是“增强模型智力”DSpark 相比 DFlash 类方法,主要增加了两个头:
Markov head:让 block 内后面的 draft token 能参考前一个 token,提高草稿预测准确率;
confidence head:预测每个 draft token 被 target 接受的概率,决定验证多长的 block。 -
4080S 32G 跑 Qwen3.8-27B:llama.cpp 优化全记录 + SGLang 探索踩坑 -
4080S 32G 跑 Qwen3.8-27B:llama.cpp 优化全记录 + SGLang 探索踩坑 -
# 7900 XTX 跑 Qwen3.8-27B 實測73.4t/s 完整部署與實測指南,claude code opus5協助佈署的,分享給大家贴主的测法纪律太有价值了,我们按同款协议在 4080S SUPER 32G(CUDA + llama.cpp + MTP n=4) 上跑了一遍完整对照,补一个 NV 平台数据点。完整优化记录见我们的帖子:1404 帖。
同题同采样(temp=0.6, top_p=0.5, top_k=15,每题 ×2 取中位):
测试项 7900 XTX(本帖) 4080S 32G 中文散文 800 字 39-47 / acc 0.31-0.47 56.9 / acc 0.313 C++ LRU cache 69.5 / 0.851 95.8 / 0.711 C++ HTTP 解析器 68.4 / 0.833 101.0 / 0.774 工具调用 4 场景平均 73.4 / 0.71-0.97 78.3 / 0.45-0.61 no-MTP 基线 38.9(llama-bench) 31.2(历史记录) prefill(真实 agent prompt):
- 6.4K:587.7 vs 1805 tok/s
- 9.6K:591.5 vs 1841 tok/s
- 23.7K:我们 1753(较 6.4K 仅 -3%;你们 38.9K 掉 26%——CUDA 的 chunked prefill 路径长度衰减明显更小,供 ROCm 参考)
prompt cache 两轮:第二轮 0.2s(重读 26 tok),与你们 1.26s/19 tok 同级的 10 倍收益。
三个观察:
- 接受率随负载波动的结论在我们卡上完全复现:散文 acc 0.31 vs 代码 0.77,同机同参数差 78%——"测 MTP 必须用实际工作负载"完全正确;
- 工具调用接受率我们偏低(0.45-0.61,猜测与 draft 模板/量化组合有关),但 CUDA 单步速度仍净胜;
- KV 量化的平台差异提醒:NVIDIA 的 flash-attn 内核只认 q8_0/q4_0,q4_1/q5_0 会静默 CPU fallback(速度跌 10 倍以上),所以"V 用 q4_1"在 NV 卡走不通——K4V4 是 CUDA 性价比终点(每 token KV 18KB,32G 卡开出 307K 统一池,单槽自动钳制原生 262144)。
完整优化记录(代理路由/准入设计/踩坑日志)在 1404 帖,欢迎对照拍砖。
-
4080S 32G 跑 Qwen3.8-27B:llama.cpp 优化全记录 + SGLang 探索踩坑上一篇篇幅所限只给了结论,这篇按 1164 帖 的"数字必须带测法"纪律,把 4080S 这套的完整配置补齐。先说和 1164 的对照:AMD ROCm 和 CUDA 两条路线,结论意外地一致——我们实测 MTP 接受率随负载/时间在 0.47~0.67 之间波动,和他们 0.31~0.97 的跨度呼应,论坛上论坛数字对不上,根源都是这个。
一、llama.cpp 完整启动参数(systemd ExecStart,可直接抄)
/usr/bin/stdbuf -oL -eL /opt/llama.cpp-qwen38/build/bin/llama-server \
  --model /opt/models/Qwen3.8-27B-UD-Q4_K_XL-GGUF/Qwen3.8-27B-UD-Q4_K_XL.gguf \
  --model-draft /opt/models/Qwen3.8-27B-UD-Q5_K_XL-GGUF/MTP/mtp-Qwen3.8-27B-Q4_0.gguf \
  --mmproj /opt/models/Qwen3.8-27B-UD-Q5_K_XL-GGUF/mmproj-F16.gguf \
  --spec-type draft-mtp \
  --spec-draft-n-max 4 \
  --spec-draft-ngl 99 \
  --spec-draft-type-k q4_0 \
  --spec-draft-type-v q4_0 \
  --alias "Qwen3.8-27B-Coding" \
  --port 8002 --host 127.0.0.1 \
  --ctx-size 307200 \
  --parallel 4 --kv-unified \
  --batch-size 8192 --ubatch-size 1024 \
  -ngl 99 --split-mode layer \
  --cache-ram 16384 --cache-reuse 256 \
  --slot-save-path /home/yijingu/logs/27b-slot-saves \
  --cache-type-k q4_0 --cache-type-v q4_0 \
  --flash-attn on --load-mode mlock --jinja \
  --chat-template-file .../chat_template_fixed_patched.jinja \
  --log-prompts-dir /home/yijingu/logs/27b-prompts \
  --fit on --fit-target 128 \
  --threads 12 \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --reasoning on --reasoning-format deepseek
要点:
--ctx-size 307200+--parallel 4 --kv-unified:统一池 307K,llama.cpp 自动把单槽钳制在模型原生 n_ctx_train=262144(有 warning 但行为正确)——单会话不越原生上限,多出来的池容量全部用于并发。32G 卡能开 307K 池的根本是下面这条;- K4V4(双 q4_0):每 token KV 仅 18KB,比 fp8 KV 省 44%;质量套件 19/21 + 工具调用全过 + 187K 深度检索全命中,速度与 q8_0 持平;
--cache-ram 16384:槽位被逐出时 KV 状态先进 16G 内存池再落盘,会话恢复免重算;--fit on --fit-target 128:显存超预算时自动收缩参数,兜底用。
二、性能数据(全部附测法)
指标 数值 测法 解码中位 89 tok/s(p10≈41, 峰值105) 15 题 × 800 tok,/completion 串行,按路由温度 MTP 接受率 0.47~0.67(随负载/时段) 同上,timings.draft_n/draft_n_accepted 冷 prefill(35K tok) ~1700-1900 tok/s cache_prompt=false ×3 取稳定值 暖 TTFT(35K 命中) 0.10~0.4s cache_prompt=true,prompt_ms no-MTP 基线 31 tok/s 同题集去 MTP MTP 接受率波动范围和 1164 的 0.31~0.97 呼应:论坛数字对不上,先对测法再对硬件。另有一个实操坑:测量时本机其他 Agent 的定时任务会抢槽位,解码中位数能被砍 40%——测速时务必确认并发空闲,或加槽位监视。
三、代理层(FastAPI,8001):路由 + 准入 + 自动放行
模型前面有一层自研路由代理,核心逻辑简化后如下(完整版 900+ 行,含准入/监控/持久化):
# 六档路由:B日常/C1分析/C2代码+Agent/D深分析/A格式化/V视觉 TIER = { "B": dict(max_tokens=4096, thinking=False), "C1": dict(max_tokens=6144, thinking=True, budget=2048, effort="medium"), "C2": dict(max_tokens=6144, thinking=True, budget=4096), "D": dict(max_tokens=6144, thinking=True, budget=2048, effort="medium"), } def resolve_auto_c2_max_tokens(payload, decision, cron): # 编码Agent零配置:客户端显式要大输出(如pi-ai默认32768)时, # C2自动放宽到32768+1800s超时;CRON恒锁1K/2K;普通请求不变 if cron or decision.get("route") != "C2": return None req = payload.get("max_tokens") or payload.get("max_completion_tokens") if not isinstance(req, int) or req <= decision["max_tokens"]: return None return min(req, LONG_OUTPUT_MAX_TOKENS) # 32768 def resolve_max_tokens(payload, route_limit): req = payload.get("max_tokens") if req is None: return route_limit return min(req, route_limit) # 未命中自动C2时仍钳制,防无差别预留- 准入保护:每路并发请求按
输入+max_tokens预留预算,合计 ≤ 共享池 token 数,超了 429——这套在 ctx 扩到 307K 后同步改为 307200; - 踩坑:客户端(如 pi-ai 系)默认发 max_tokens=32768,无脑尊重会让每个普通请求都按 32K 预留准入预算 → 必须用"路由命中 C2 才放宽"的条件放行,CRON 用 header 前缀识别后强制锁小预算。
四、和 1164/Xiaote 观点的两个交叉印证
- K8V4 vs K4V4:Xiaote 建议显存紧时"降 V 不降 K、V 用 q4_1"。CUDA 这边有个平台差异要提醒:llama.cpp 的 CUDA flash-attn 内核只实现了 q8_0/q4_0 两格式,q4_1/q5_0 会静默掉 CPU fallback(实测速度跌 10 倍以上)——所以 NV 卡上"V 用 q4_1"这条路走不通,K4V4 就是 CUDA 的性价比终点,K8V4 是显存富余时的质量升级项,和他们的结论殊途同归;
- prefill 长度衰减:1164 实测 6.4K→38.9K prefill 掉 26%,提醒"短 prompt 外推长上下文等待会严重低估"——我们同样只在 35K 口径下报 ~1900,不外推。另外 Agent 长链任务若用我们代理的软压缩(超阈值丢最老轮次),会破坏前缀缓存命中,体感 TTFT 变差,这也是"Agent 场景比单轮慢"的一个非模型因素。
配置细节、A/B 原始数据和踩坑日志都在手边,有问必答。
-
4080S 32G 跑 Qwen3.8-27B:llama.cpp 优化全记录 + SGLang 探索踩坑继 1329 帖 的 4090D / 5090 / RTX PRO 4500 对照,补一个 4080S 32G(改装显存版) 的数据点。前半是 llama.cpp 生产链路的优化记录,后半是在同一张卡上对 SGLang+HiCache 的失败探索——负结果,但对犹豫要不要换引擎的 32G 卡兄弟应该有参考价值。
一、硬件与基线
- 卡:RTX 4080 SUPER 32G(改装显存版),驱动 595.84
- 引擎:llama.cpp b6508 后新构建(bump 0.2.0),CUDA 编译
- 模型:Qwen3.8-27B UD-Q4_K_XL(主)+ Q4_0 MTP 草稿 + mmproj 视觉,froggeric v22 模板
- 代理:自研 FastAPI 路由层(A/B/C1/C2/D/V 六档,按内容/tools 自动路由思考档位与输出预算)
二、优化过程与结论(全部实测)
1. MTP 深度:接受率不是越高越好。 n=1→4 全扫描:n=4 接受率最低(48.8%)但速度最快(2.05x,no-MTP 31 → 64 tok/s),深层 draft 摊销验证开销盖过了接受率损失。n=5/6 必崩(MTMD 初始化 ABRT)。p-min 扫描 0~0.8 全负收益,p-min=0 定稿。
2. KV 量化:K4V4(q4_0)白嫖 3.3G 显存。 这个 flash-attn 内核只认 q8_0/q4_0,其他变体会掉 CPU fallback。K4V4 对比 q8_0:质量套件 19/21 + 工具调用全过 + 长上下文检索 187K 深度全命中,速度持平。每 token KV 仅 18KB,这是 32G 卡能开大上下文的根本。
3. 上下文:绕了一圈回到原点,但姿势更好。 262144 → 200000(缩池换余量)→ 262144(余量够了恢复)→ 307200 统一池:llama.cpp 会自动把单槽钳制在模型原生 n_ctx_train=262144(启动有 warning 但行为正确),多出来的 45K 池容量正好用于并发——单会话不超原生上限(零质量风险),262K 会话 + 32K 会话可同池共存。
4. batch/ubatch:8192/1024 定稿。 batch 8192 让 35K 冷 prefill 稳定在 1690×3(4096 时波动 1160~1690);ubatch 2048 能把解码 p10 从 40 提到 78(MTP 验证批不再切分),但计算缓冲多吃 1.4G,按显存预算取舍。
5. cache-ram 16G:llama.cpp 的"迷你 HiCache"。 槽位被逐出时 KV 状态先进内存池再落盘,会话恢复免重新 prefill。机制上是槽位级保存/恢复,不是 token 级 Radix,但配合统一 KV 的公共前缀共享,日常够用。
6. Agent 输出截断修复:路由层自动放行。 编码 Agent(DSH/pi-ai 系)默认发 max_tokens=32768,路由器原会钳到档位上限(6144),大工具调用写到一半被掐、发"继续"无限循环。改为:命中 C2(代码/Agent)且客户端显式请求更大值时自动放宽到 32768 + 1800s 超时,CRON 恒锁小预算防滥用。客户端零配置。
7. 当前速度水位(全套定稿配置):35K 冷 prefill ~1900 tok/s,解码中位 ~89 tok/s(no-MTP 基线的 2.9 倍),显存 31.0/32.8G(统一池 307K token)。
三、SGLang+HiCache 探索:三连负结果,不换生产
用 Docker 完全隔离跑 SGLang(latest),对照 1329 帖的结论:
尝试 结果 NVFP4 4bit(带视觉+MTP 的理想模型) 启动即报错 NotImplementedError: Current platform does not support w4a4 nvfp4 quantization—— NVFP4 是 Blackwell 专属路径,Ada 没实现,无绕过AWQ INT4(带视觉,无 MTP) 能跑:KV 池 118,569 token、HiCache host pool 245K/8G 分配正常;但 AWQ 仓库无 MTP 头,解码只有 36.9 tok/s HiCache 跨层回捞 未生效:灌 12 万 token 强制逐出后回查最早前缀,cached=0、耗时与全新冷启动一致。疑似 hybrid(GDN) 架构与 HiCache 的兼容缺口 结论:32G Ada 卡上,SGLang 解码只有 llama.cpp+MTP 的一半、单会话上下文 256K→131K、HiCache 回捞还没兑现——维持 llama.cpp 生产。1329 帖的 SGLang 收益场景(多会话共享前缀 + 容量扩展)在 32G Ada 上三根支柱缺了两根半。
替代方案:llama.cpp 侧开
--cache-ram 16G当"迷你 HiCache",槽位恢复免重算,成本低无风险。四、给同款卡的建议
- 4080S/4090 系(Ada)别试 NVFP4,SGLang 直接不认;
- 混合架构(GDN)模型玩前缀缓存/分层缓存,先确认工具链对 hybrid 的 checkpoint 支持,否则会遇到"分配了但不回捞"的静默失效;
- llama.cpp 路线的 MTP + K4V4 + 统一池在 32G 卡上是性价比极高的组合,欢迎对照。
配置细节、踩坑日志和 A/B 数据都在我这边,有问必答。
—— jingy yi
-
QWEN3.8-27B 解决工具调用和空思考循环的问题。 -
618刚攒的机,用来做linux工作站,看看能折腾出啥来,水一贴 -
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接 -
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接如果我沒理解錯的話vLLM自己就是這個Patch, FlashInfer裏面的話應該就是這個3620跟3621
Temperature本身就是用來控制模型的隨機程度, 越高代表越不可控, 自然會讓MTP Acceptance Rate大大降低啊, 詳情可以看這份期刊的7.4點
雖然我個人更加相信這個是來自工作内容差異, 而不是關於FP8跟BF16的分別, 畢竟兩者本體27B (FP8對上BF16) 的KLD也小於0.05, MTP估計也會維持在這附近
这个模型的作者说后续会研究发布Patch,说明发布的模型的MTP是未Patch修改版。我实测下来,FP8和FP16的MTP命中率是一样的,就35~55%,代码类高,问题类低。而楼主的MTP命中率较高,所以我想问问是不是他有更新的模型或Patch方法。
-
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接再补一个关键数据点:我另外下载了 BF16 主仓(全模型高精度、含原生 MTP 头)做对照,同条件(greedy / 10K / MTP3 / metrics 差分)实测 acceptance 也只有 ,46%,和 FP8 版基本持平。这说明精度不是 acceptance 的瓶颈——而这个 patch 的机制如果只是把 FP8 draft cast 成 BF16,那全 BF16 就是它的效果上限,上限都到不了 75%。所以我现在更倾向于:要么 patch 里还有 cast 之外的改动(那就更需要 diff 了),要么 75% 主要来自采样条件和负载类型。楼主给一把开关对照数据,这事就能一锤定音。
-
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接感谢两位回复,补充说明一下,我的问题可能没表达清楚:
先澄清:双 Thinking 是我打错了,就是 Nerkyor 的 Qwen3.6-27B-DSV4Pro-Thinking-Distill-FP8,模型背景我了解,不需要科普。我卡住的是复现的工程细节,收窄成三个具体问题:
-
patch 具体位置:#16 说这个 patch 可以摘到主线 0.24 上用——那具体是 fork 里哪个 commit / 哪个文件?求 diff 链接。我知道它是把 mtp.safetensors 的 FP8 scale 到 BF16,但不知道改动在哪,没法摘。
-
同机同负载的开关对照:#16 说 acceptance 看工作性质不能直接比——完全同意,所以我要的恰恰不是跨环境比较,而是楼主自己同一台机、同一批 prompt 下,VLLM_QWOPUS_MTP_BF16_DRAFT 开/关各跑一次的 acceptance。只有这个对照能证明提升来自 BF16 draft 本身,而不是工作负载差异。如果楼主还留着环境,跑一把关掉的数就够了。
-
75% 是什么采样条件下测的:greedy(temp=0)还是带温度采样?这个变量比想象中大得多,见下面我们的数据。
作为交换,附上我们的实测(A800 / vLLM 0.24 主线 / MTP3 / FP8 draft 未打 patch,acceptance 用 /metrics 前后差分):
- greedy,10K 上下文:acceptance 52.8%,decode 75.7 tok/s
- greedy,长短上下文合并(278/10K/53K):~46%
- temp=1.0(生产配置,gen_config 默认):acceptance 32.8%,decode 55.7 tok/s
也就是说光温度一个变量就能把 acceptance 从 53% 打到 33%,20 个点。所以楼主的 75% 里,BF16 draft、greedy、编程类负载各贡献多少,不做开关对照 + 对齐采样条件是拆不开的。如果 patch 真有净贡献,我这边 33% 的生产口径能提多少,非常想对齐一下。
-
-
让你们看看垃圾魔改卡2080ti 的威力 qwen3.6-27b fp8 精度 速度能到 60tokens/s nvlink 连接很好的经验,谢谢,但我没有复现成功,请教下:
- 模型的确切下载来源(HF repo 名),和 Distill 版是什么关系(我下载的是Qwen3.6-27B-DSV4Pro-Thinking-Thinking-Distill-FP8)
- VLLM_QWOPUS_MTP_BF16_DRAFT=1 具体做了什么——是运行时把 FP8 MTP 权重 cast 成 BF16,还是加载外部 BF16 shard?对应 fork 里哪个 commit/文件?
- 这个 patch 能否在主线 vLLM 0.24 上单独应用(他们既然在 0.24 base 上改的,patch 大概率能摘出来)
- 你是否试过不开这个开关的接受率——如果他们 FP8 draft 也是 ~46%,开了到 75%,就是你缺的那块拼图的完整对照数据
