

双 RX 7900 XTX 跑 FlashNext,ESXi 直通、近 256K 同机实测和空闲功耗
搭这台机器的时候,我想的是把长文、代码和图片都放在本地跑。比如一整份材料发进去,最后问的可能是开头提过的一件小事。我想让模型读完以后,还能把那个细节找出来。材料一长,上下文很快就到了二十多万 token。平时我也想让服务一直开着,想用就直接发请求。
两张 7900 XTX 就是拿来分担同一个请求的。每张卡有 24 GiB,FlashNext 的 Q5 权重比两张卡加起来还大,长上下文的缓存也要占显存。我的做法是让两张卡分层跑,常用的专家权重尽量留在显存里,其余主要放内存。后来翻日志,Q5 那轮光是驻留在系统内存里的专家权重就有约 78 GiB。虚拟机里约 108 GiB 的内存,这里实实在在用上了。
两张卡是怎么接的
主机跑 ESXi,两张卡都直通给同一台 Ubuntu 虚拟机。启动后我先确认 ROCm 能认到两张卡,再去看引擎日志,确认两边各跑 24 层,也都分到了专家权重。
| 项目 | 这台机器 |
|---|---|
| CPU / 虚拟机 | AMD EPYC 7K62,客机分配 50 vCPU,MemTotal 108.06 GiB |
| 显卡 | 2 × RX 7900 XTX,gfx1100,各 24 GiB,ESXi PCIe 直通 |
| 系统 / 推理栈 | Ubuntu 24.04,ROCm 7.2.1,Strata 引擎 0.1.56,HIP gfx1100 构建 |
| 引擎版本 | 源码 ffa80d73133ea5c548aefe57889a16e8085a938f,构建开启 STRATA_MMQ_KQUANTS |
| 双卡用法 | gpu=[0,1],layer_split="24",parallel=1,STRATA_PEER_TRANSPORT=host |
客机里看 PCIe,两个设备都报 5.0 GT/s ×32。我把这项当客机枚举信息记录。物理槽位速率、主机侧 NUMA 和卡间带宽,要用宿主机上的测量回答。这轮比较固定的是两张卡分层和 host 传输。
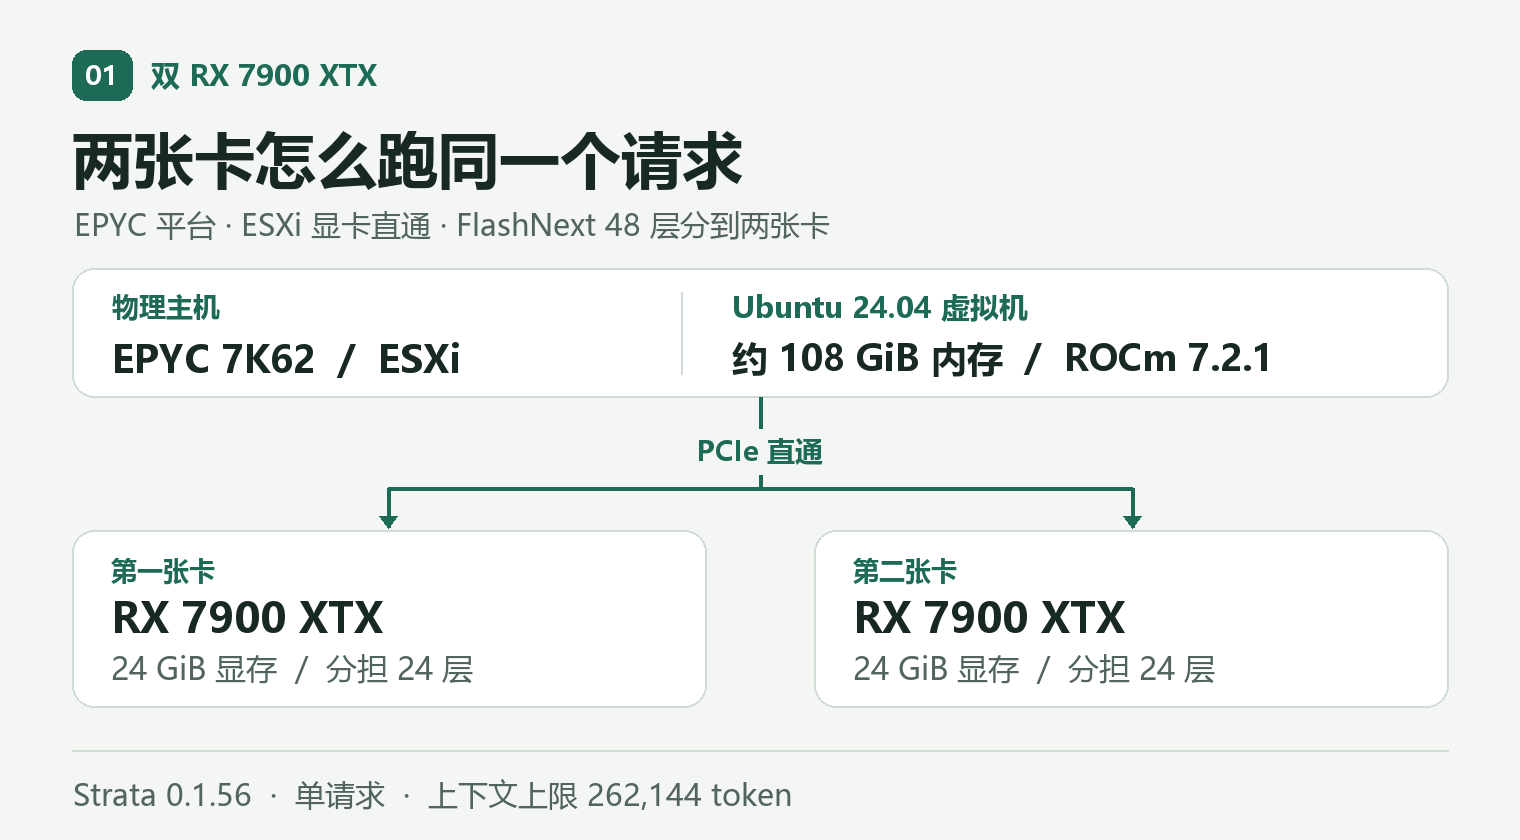
图 1 两张 7900 XTX 直通给同一台虚拟机,分担一个推理请求。
后来做 Q5 对照的时候,我从加载模型开始就记显存,长请求和 102 道题也算在内。用原专家表那轮,两张卡采到的最低剩余显存分别是约 1,363 MiB 和 1,078 MiB。两张都是 24 GiB,跑起来剩的余量也有差别。我后来就分开记两张卡,看哪张先吃紧。
最早也试过 Q6,能跑完当时的 17 项,近 256K 长文的首字中位数却到了 438 秒。七分多钟才开始回,日常用实在等不住,我就接着试 Q5。早期的测试参数后来有调整,这个数就当是当时的折腾记录。下面的 Q4 和 Q5 是换成同一批请求以后重新测的。
请求都跑完了,怎么还有 200 多瓦?
先贴两张 11 月 4 日的监控原图。第一张看着像一半负载,后来再看,GPU 那个圈已经红到 100% 了。显存两张都显示 95%,功耗却从 138 W 跳到了 224 W。
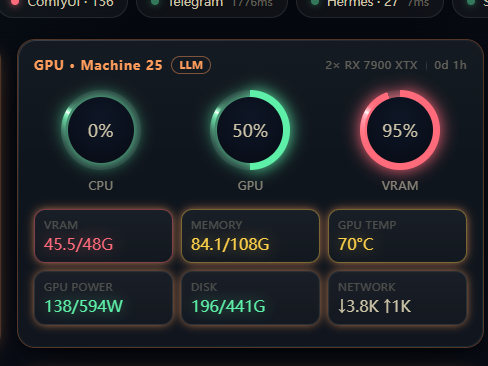
图 2 监控面板显示 GPU 50%,双卡功耗 138 W。
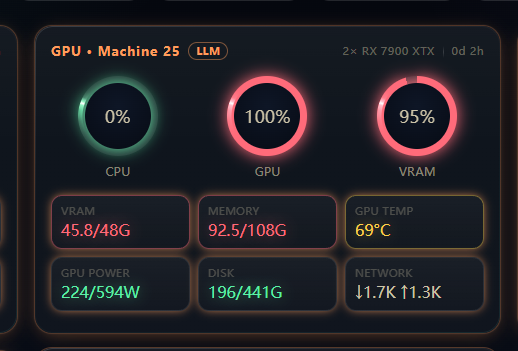
图 3 同一天的另一张截图,GPU 100%,双卡功耗 224 W。
我先去看是不是还有请求在跑。队列已经空了,输出 token 计数也没再动,可两张卡还是都报 100%,连续 9 次采样的合计功耗在 220–233 W。面板上的 GPU 百分比是两张卡的平均值。之前看到 50% 的时候,拆开查就有过一张 0%、另一张 100% 的情况。停掉推理服务做对照,两个忙碌读数都降到了 0%。
后来改 HIP 硬件队列上限逐档试。原来的 GPU_MAX_HW_QUEUES=8,Q5 载入等请求时双卡功耗中位数 227 W,停服务、模型卸载后是 23 W。六队列和五队列在载入后都出现过一张卡报 100%,双卡合计 99 W。四队列跑完短请求看着正常,等 102 题跑完,队列清空后又出现单卡 100%,合计 109.5 W。
三队列那轮,我在同一个进程里跑完 102 题和 17 项功能、性能检查,分别测到 23 W 和 25 W,两卡忙碌读数都是 0%。把 GPU_MAX_HW_QUEUES=3 用到正式服务,做完 API 验证后模型还在显存里,双卡合计 19.5 W。这里的瓦数来自显卡遥测,按两张卡相加。
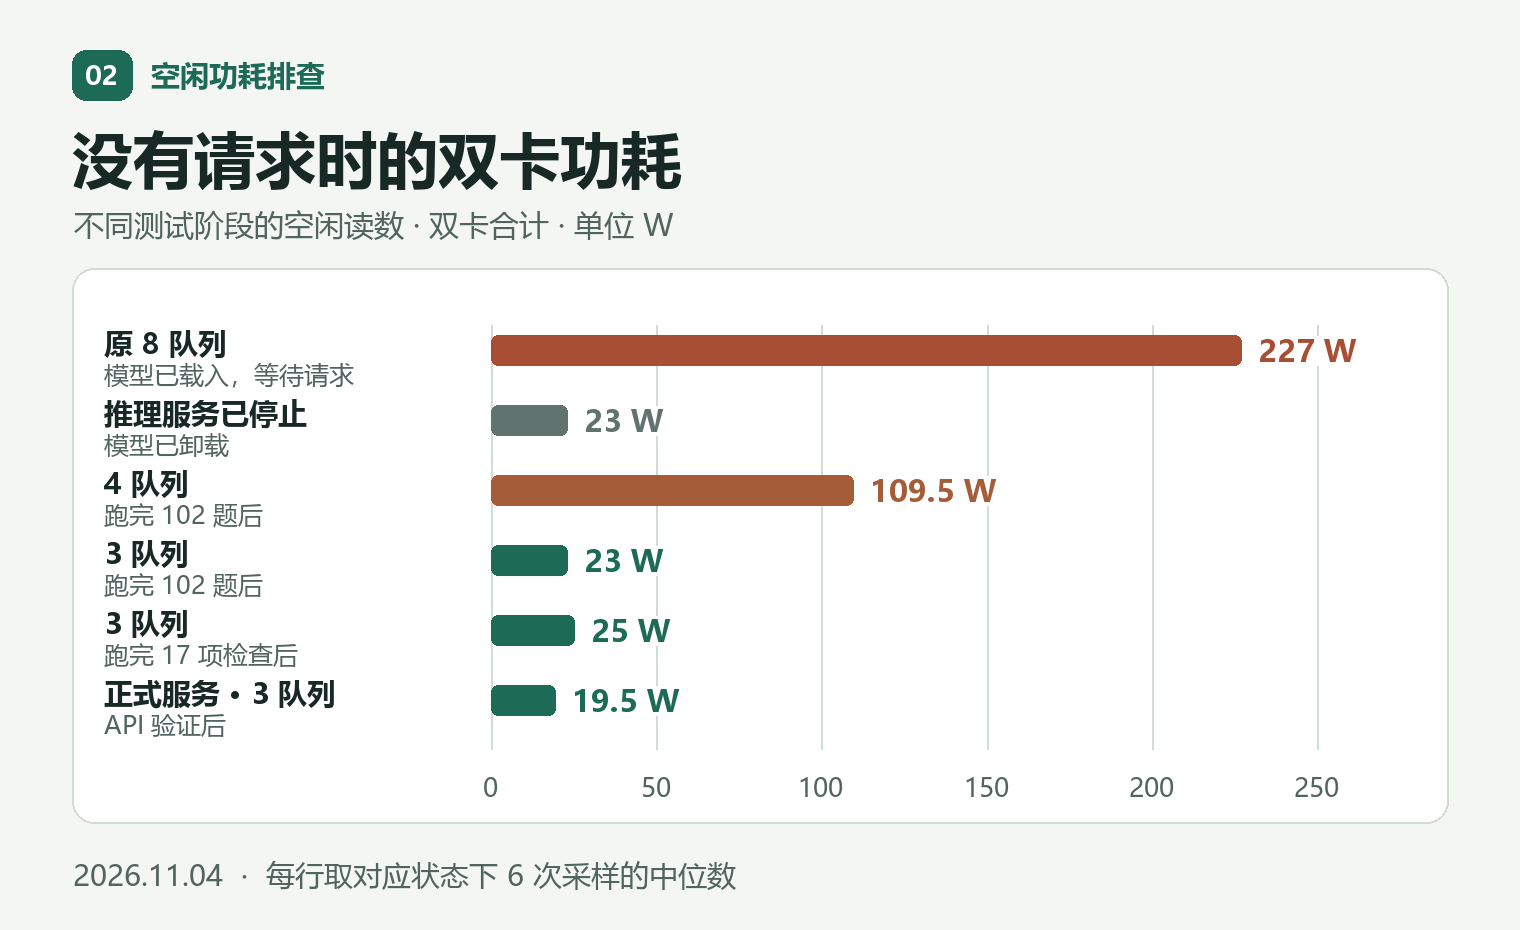
图 4 每行是对应状态下 6 次采样的中位数,功耗按两张显卡合计。
四队列那次最容易看走眼,刚启动的十几瓦只说明当时那一小段正常。后面我用三个窗口分别看短请求、102 题、整套长文和图片跑完后的状态。这个结果是我这台 ESXi 直通机配 ROCm 7.2.1 的实测,具体是哪条队列卡住,目前只查到现象跟推理进程的存续一起变化。
Q4 和 Q5 各要等多久
| 版本 | 权重来源 | 主 GGUF 合计 |
|---|---|---|
| Q4 | cygnal/Qwen3.8-Flash-Next-Heretic2-IQ4XS-NGQ4-GGUF,revision b7a350f3ba4c29962cefe9e69af225f142cda9bc |
98,403,355,776 B,约 91.65 GiB |
| Q5 | orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF 的 Q5_K_M,revision 98eb3357afd966c25cadd082c7f830eafde7aa52 |
134,106,668,160 B,约 124.90 GiB,三片 |
体积只算主 GGUF。两边实际使用各自的权重、pack、tokenizer 路径和视觉投影,推理引擎、环境变量和采样对齐。Q4 名字里有 IQ4XS,实际 GGUF 的专家张量混用了 IQ4_XS、IQ4_NL 和 Q5_1,内置 PLE 表为 Q4_0。这是两套可用权重的同机对照,分数差包括了各自的权重版本。
两边都用 INT8 KV、--kv-resident 32768、MTP4、双窗口、--expert-cache auto 和 --vram-reserve-mib 1536。262,144 是上下文上限,32,768 是配置的显存 KV 驻留窗口。双窗口是引擎的流水线设置,服务并发仍是 1。每边先跑同一条预热请求,再按 128K 长文一条、近 256K 长文三条、近 256K 代码三条的顺序跑。两边八条实际请求的 payload SHA 都逐条一致。
测速请求关闭 thinking,temperature=0.2、top_p=0.95、top_k=20、seed=42。正式计时的七条每条生成 256 token,实际 cache_n=0。PP 和 TG 取引擎的 prompt_per_second 和 predicted_per_second,TTFT 取客户端从发请求到第一个可见字符的时间。128K 实际输入 131,072 token,近 256K 实际输入 261,632 token,近 256K 两组各取三次中位数。
| 请求 | 读入 Q4 / Q5(tok/s) | 生成 Q4 / Q5(tok/s) | 首字 Q4 / Q5(秒) |
|---|---|---|---|
| 128K 长文 | 2210.4 / 1447.5 | 53.8 / 36.2 | 59.53 / 90.82 |
| 近 256K 长文 | 2537.5 / 1848.5 | 63.2 / 45.6 | 103.45 / 141.84 |
| 近 256K 代码 | 2568.6 / 1917.1 | 65.7 / 53.3 | 102.17 / 136.78 |
近 256K 长文三次的生成区间是 Q4 60.6–68.3、Q5 42.7–49.0 tok/s。长请求里埋了要找回的细节,这几轮两边都找到了。Q5 的长文 TTFT 中位数约 142 秒,后面 256 个 token 的生成阶段约 6 秒。拿它查一份长材料里的某个细节,前面这段等候才是我每天能感觉到的差别。
日志里能看到的差别
两套都用 --expert-cache auto,实际装进 GPU 的专家数差得不少。我把这轮七条长请求的日志对齐后,单独摘了几项。
| 日志字段 | Heretic2 Q4 | OrcaRouter Q5 |
|---|---|---|
| GPU 常驻专家槽位,两卡合计 | 13,459 | 9,379 |
| RAM 中的专家补集 | 52.53 GiB | 78.18 GiB |
| 128K 长文 GPU 专家命中率,单次 | 88.5% | 73.8% |
| 128K 长文 decode 文件等待,单次 | 34.5 ms | 1,443.0 ms |
| 近 256K 长文 GPU 专家命中率,三次中位 | 95.4% | 89.0% |
| 近 256K 长文 KV 显存命中率,三次中位 | 96.26% | 96.15% |
| 近 256K 长文 decode 文件等待,三次中位 | 1.1 ms | 97.8 ms |
| MTP 草稿接受/提议,七条合计 | 876 / 1,260(69.5%) | 850 / 1,296(65.6%) |
这轮 Q4 的专家权重整体更小,自动分配多塞进了 4,080 个 GPU 槽位。近 256K 长文的 KV 显存命中都在 96% 左右,专家命中率拉开的差距更大,MTP 接受率也有变化。要把那几十秒的首字差距拆到专家搬运、PLE、内核和其他开销,还得另做逐项对照。上面的文件等待是 decode 日志里的字段,和整条请求耗时分开看。
跑得更快,为什么我还是留了 Q5
同一套冻结 102 题,Q4 答对 69 题,Q5 答对 78 题。同题集、同评分器、同采样,两边请求失败和 GPU 视觉协议失败都是 0。按类别看是下面这组。
| 题类 | Q4 | Q5 |
|---|---|---|
| 中文 | 16/20 | 18/20 |
| 推理 | 8/20 | 10/20 |
| 代码 | 10/20 | 11/20 |
| 金融 | 19/24 | 21/24 |
| 普通读图 | 10/12 | 12/12 |
| 文档读图 | 6/6 | 6/6 |
我翻了几道原始答案。有一道图表题,Q4 连最大项的数值都读对了,可题目要的是类别名,它把数字填了进去。还有一道代码题,题目要单参数的函数,Q4 生成了两个参数,照原来的函数签名调用就对不上。也有像有效税率这种算错的。两份权重版本本身有差异,我就按这两个版本在这套题上的结果选。
中间还试过给 Q5 重排专家,把预跑时更常用的那批提前放进显存。我的想法很简单,常用的先放进去,看看能不能少等几次从内存拿数据。两组的显存预留相同,两张卡的专家槽位分别是 4,616 和 4,763,只换初始排序。
这轮还踩了个测速坑。请求里已经写了 cache_prompt=false,但第一次重发同一份 128K 提示,日志显示还是复用了 131,065 个 token,实际只重新读了 7 个。那条结果作废。重跑时在隔离测速请求加 strata_checkpoint=false,实测每条 cache_n=0。两边都先预热引擎,再完整读入长提示。
同一次 Q5 对照里,预热后 128K 生成从 45.7 掉到 38.8 tok/s,近 256K 长文从 48.0 掉到 41.7 tok/s。近 256K 代码那条冷测生成从 36.4 升到 40.0 tok/s,首字从 163.92 秒拉到 230.45 秒,预热后生成也从 51.1 降到 50.0 tok/s。102 题从 78 到 77,唯一变化是 code-histogram 由对变错。我测完就回到原专家表了。
现在机器就常驻 Q5。长材料发一次要等多久,我心里大致有数。对我自己的用法来说,多等这几十秒还能接受。答完以后两张卡能降下来,服务还能继续挂着,这台机子才算顺手。
跑分时用的参数
两套对照共用的 Strata args 如下。模型、投影、pack 和词表路径按安装位置填。GPU 列表、layer_split 和 parallel 在服务配置里设置,值见上面的硬件表。
--pack "$PACK_DIR" --native "$MODEL_GGUF" --ple-gguf "$PLE_GGUF" \
--expert-profile "$EXPERT_PROFILE" --expert-cache auto --resident-experts \
--prefill auto --pool-workers 24 --max-context 262144 \
--kv int8 --kv-resident 32768 --ple-io direct --ple-row-cache 1048576 \
--spec 4 --spec-min-p 0.65 --mtp "$MTP_DIR" --mtp-q4 all \
--mtp-window 4096 --mtp-draft-vocab "$DRAFT_VOCAB" --pipeline-windows 2 \
--pcie-frac 0 --vram-reserve-mib 1536 --adapt-every 24 \
--prompt-cache 8 --prompt-cache-every 8192 \
--conversation-cache-slots 2 --conversation-cache-mib 8192 \
--conversation-cache-min-tokens 4096 --stats --vision
两边共用的引擎环境变量也贴在这里。调优表的文件名保留,路径按本机填写。
export STRATA_RDNA_MMVQ_WAVE=3
export STRATA_PEER_TRANSPORT=host
export STRATA_HIP_WMMA=1
export STRATA_SELECT_WMMA=1
export STRATA_PREFILL_CPU_SHARE=auto
export STRATA_HC_Q8=0
export STRATA_PREFILL_AUTO_MAX=32768
export STRATA_PREFILL_RING=384
export STRATA_ROUTE_TAIL_SKIP=0
export STRATA_HEAD_MIX_MULTI=1
export STRATA_ONE_TOKEN_COMMIT=0
export STRATA_AUX_CPUS=off
export STRATA_GR_RDNA=1
export STRATA_GR_RDNA_Q8=1
export STRATA_RDNA_Q6K=1
export STRATA_GR_RDNA_A8=1
export GPU_MAX_HW_QUEUES=3
export STRATA_QFUSE=1
export STRATA_COMBINE_CPU=1
export STRATA_VERIFY_QDEDUP=1
export STRATA_WAIT_FUSE=1
export STRATA_ROUTE_PUBLISH=1
export STRATA_GR_INJ_UP=1
export STRATA_GR_FUSED=1
export STRATA_GDN_HEAD=1
export STRATA_GDN_CHUNKED=1
export STRATA_GDN_CHUNK_GDV=0
export STRATA_PA_KLDS=1
export STRATA_GDN_PP=1
export STRATA_GDN_CONVL2=1
export STRATA_GDN_NOY=1
export STRATA_PF_GEMM=1
export STRATA_PF_PAD=1
export STRATA_HC_UPMIX=1
export STRATA_PF_HCDOWN=1
export STRATA_FUSE_CONVAB=1
export STRATA_PA_FAST=1
export STRATA_PF_GROUP_RES=1
export STRATA_KV_HOST_DMA=1
export STRATA_DP_PREFILL=0
export STRATA_RESIDENT_PIN=0
export STRATA_RESIDENT_HEADROOM_GIB=12
export STRATA_HIPBLASLT_TUNING="$HIPBLASLT_TABLE"  # gfx1100-hipblaslt-100202.txt
export STRATA_MTP_STAGE0=0
export HSA_USERPTR_FOR_PAGED_MEM=0
export STRATA_PF_FUSED=1
export STRATA_PF_FUSED_KQ=1
export STRATA_PF_F16=1