@kop-wang 香港天天漲,上週3萬9,昨天4萬1, 今天4萬3(港幣)。
K
KAKAHermes
@KAKAHermes
-
ASUS GX10小主機 純分享 臉書 -
关于小公司跑本地大模型硬件建议@soop-ladios 感謝提供寶貴數據!非常有參考性,真幫了大忙! 希望可以向TP4這個方向發展。
-
关于小公司跑本地大模型硬件建议@soop-ladios 多謝提醒,我測試一部試試,但不能租用兩部GB10 模擬TP吧。。。。
-
关于小公司跑本地大模型硬件建议@soop-ladios 是的,我也是計劃先買兩台GB10來跑TP,加上本身的伺服器跑LiteLLM。
-
关于小公司跑本地大模型硬件建议 -
Asus Ascent GX10到货,双gb10的DSV4-Flash集群全程hermes远程部署留言希望看測試結果
-
关于小公司跑本地大模型硬件建议 -
关于小公司跑本地大模型硬件建议 -
关于小公司跑本地大模型硬件建议 -
关于小公司跑本地大模型硬件建议 -
关于小公司跑本地大模型硬件建议 -
关于小公司跑本地大模型硬件建议 -
关于小公司跑本地大模型硬件建议@CS6 多些老特小特和CS6大神回覆

早期预算是15万左右,直接用现有的HPE ProLiant DL380 Gen11 (会后续添加记忆体去128或256)配合RTX Pro 6000 即方案A 来跑上述需求。 而且还保留的升级的可能性,未来预算够,还可以添加多1-2张RTX Pro 6000。但现在价格飙去了20万,所以才考虑其他可行方案。
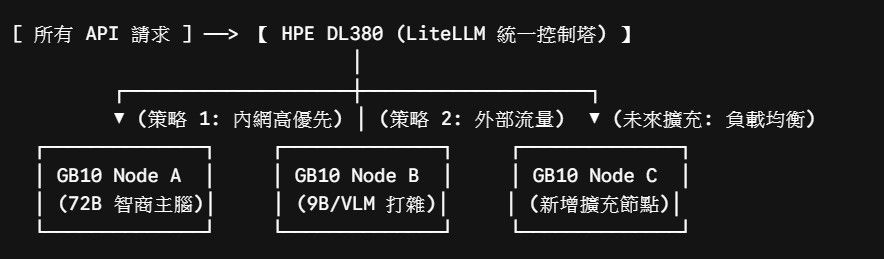
GB10 x 2 也有考虑过,让HPE ProLiant DL380 Gen11作为流量入口与负载均衡器利用 Intel Xeon 的吞吐能力,处理每天 1000 次的 Chatbot 网页并发请求、运行 Docker 容器、管理反向代理(Nginx / Traefik)、以及处理较轻量的 OCR 任务。两台GB10 专心做 GPU 矩阵运算,而且还可以做到推理分流(内部知识库应用跟外部Chatbot及OCR分开), 但架构复杂度上升:从单机部署变成了多机分散式(DL380 + 2x GB10),内网需要配置好良好的 API 路由,维护成本大大提升。加上个人始终觉得GB10就是玩具。。。
所以结论是先试试runPod 或租用云GPU,计算所需要的资源才决定购买哪些硬件。
-
关于小公司跑本地大模型硬件建议场景: 一家小公司,主要是来跑本地知识库,提供20-25人同时使用,另外还有自家网页的ChatBot 及一些网站上的OCR API调用(流量200-500左右)
-
硬件规划方案 A: 已经有台全新HPE ProLiant DL380 Gen11 闲置的伺服器,64GB ECC DDR5 记忆体,10TB SSD硬盘。 打算采购RTX PRO 6000 96GB 伺服器版本。
-
硬件规划方案 B: 自组一套Workstation及RTX PRO 5000 72GB伺服器版本。但不能利用现有的伺服器硬件,分配显存也需要用其他手段来实现。
-
硬件规划方案 C:APPLE MAC STUDIO M5 ULTRA 256GB 统一内存。也不能利用现有的伺服器硬件,而且苹果生态跑AI也比较麻烦些。
原本考虑方案A ,因为RTX PRO 6000 有MIG技术,可以分配显存去不同应用VM,例如CHATBOX,OCR,本地知识库。但因为RTX PRO 6000价格一直上飙,由之前的13万港币,到现在16-20万港币了。
而方案B需要另外配一台工作站,成本也要13-14万。
因为苹果发布M5 Ultra 处理器的Mac Studio, 请问各位大神, 如果不考虑Confy UI等应用场景,是否方案C,10万左右的Mac Studio比较适合我们的应用场景? -