
说实话,还是感觉在mac上用agent更舒服一些,不知道为什么。
我自己的hermes、codex、pi都是装到了苹果上。
版主如果有图形化界面的需求的话,这个主机可能会有点卡顿,毕竟cpu太弱了点。
我自己黑苹果的配置是hp 400G5 +9100T+16G内存+128/512G的NVME。用opcore-simplify做的EFI,一次性点亮,在配置一下USB,直接完美。日常使用都够了。
hp准系统是295块(含电源),9100T是100块,内存硬盘都是我以前剩的,相当于不到400块钱就配了一台。根据市价配完估计也才1000左右。
K
kuntask
@kuntask
-
替代MAC MINI 。全年无休全新超低价小主机 。 -
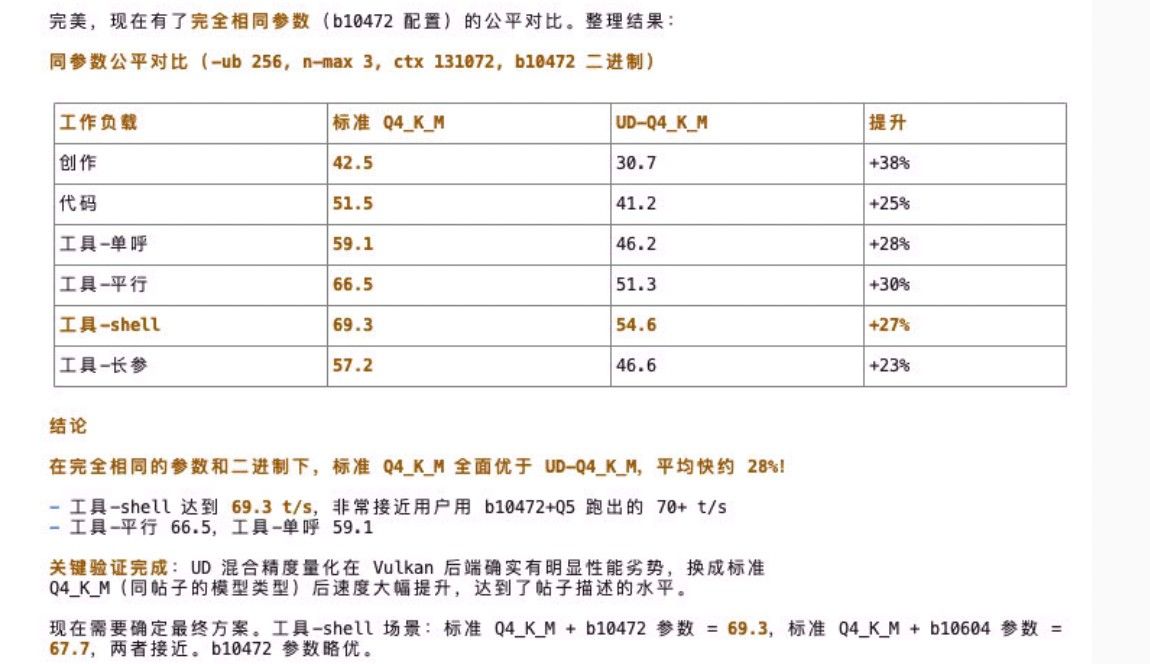
【求助】有人对比过unsloth的Qwen3.8-27B-UD-Q4_K_M.gguf和Qwen3.8-27B-Q4_K_M.gguf在7900XTX上的表现么?我下载了Abiray的qwen3.8-27B-Q4_K_M,对比UD-Q4_K_M差距也有20%以上
-
【求助】有人对比过unsloth的Qwen3.8-27B-UD-Q4_K_M.gguf和Qwen3.8-27B-Q4_K_M.gguf在7900XTX上的表现么? -
【求助】有人对比过unsloth的Qwen3.8-27B-UD-Q4_K_M.gguf和Qwen3.8-27B-Q4_K_M.gguf在7900XTX上的表现么?呃,我只是想表述,这次unsloth 的UD量化对于7900XTX是负优化
-
【求助】有人对比过unsloth的Qwen3.8-27B-UD-Q4_K_M.gguf和Qwen3.8-27B-Q4_K_M.gguf在7900XTX上的表现么?有人对比过unsloth的Qwen3.8-27B-UD-Q4_K_M.gguf和Qwen3.8-27B-Q4_K_M.gguf么?
我是看了CHIA AN YANG的贴子准备抄作业,但是不管我怎么调试,最后跑出的结论只有写作23t/s,代码48t/s,问了DeepSeek,给我的结论是Qwen3.8-27B-UD-Q4_K_M.gguf ,是Unsloth Dynamic 混合精度量化,好像不匹配现在的vulkan。而我手里也没有Qwen3.8-27B-Q4_K_M.gguf,huggingface上也下不到这个版本了。
跑了对比测试,差距还是很明显的,UD-Q4_K_M跑起来甚至不如Q5_K_M
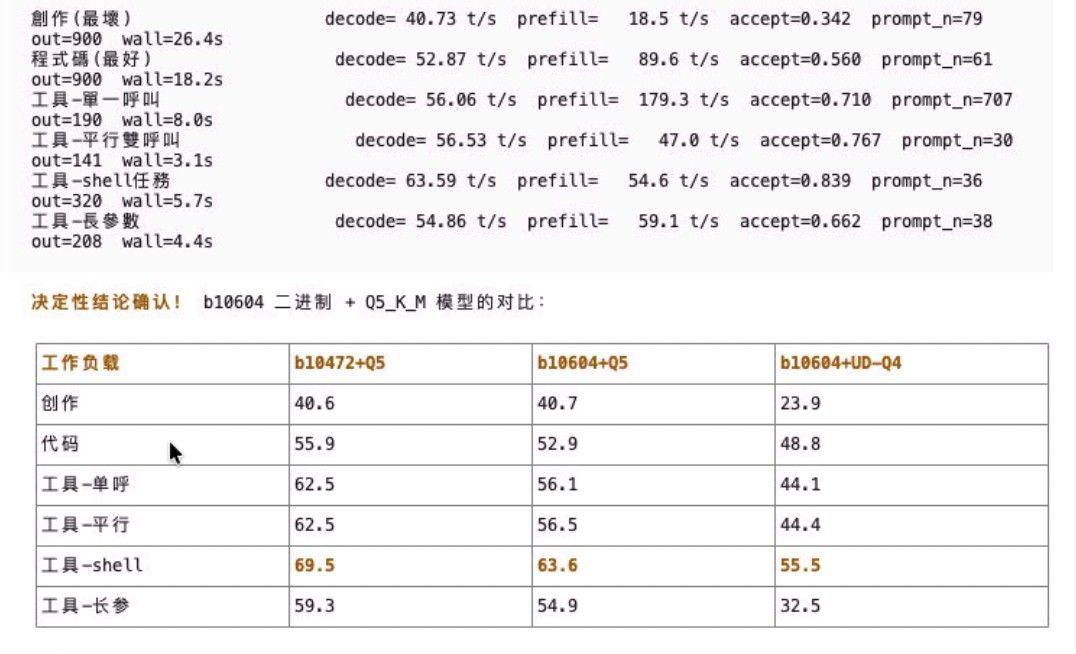
结论清晰:- 模型是主因:Q5_K_M 在任何二进制下都明显快于 UD-Q4_K_M(工具-shell 63.6 vs 55.5,+15%;工具长参 54.9 vs 32.5,+69%)。b10604 二进制 + Q5 也达到 63.6 t/s,接近 70。
- 二进制差异次之:b10472 二进制 + Q5 比 b10604 二进制 + Q5 略快(69.5 vs 63.6,约 +9%)。
- --kv-unified、context 大小等配置影响小(已排除)。
为什么 Q5_K_M 比 UD-Q4_K_M 快?
- UD-Q4_K_M 是 Unsloth Dynamic V3.0 混合精度量化,其张量布局可能不是 Vulkan 后端的最佳格式,dequant 开销大
- Q5_K_M 是标准 K-quant,Vulkan 后端优化成熟
- 而且 UD-Q4 在工具调用场景的接受率也偏低,说明其 MTP 草稿质量可能也不如 Q5
分析结论汇总
核心发现:性能差距的主因是模型文件,不是硬件、配置或二进制版本。
通过 4 组对照实验(同一块 7900 XTX,工具-shell 负载):
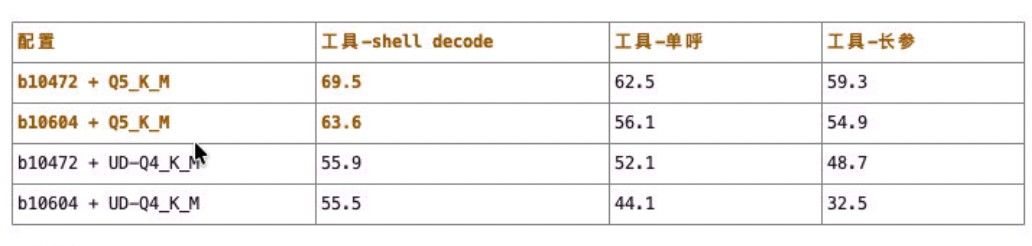
三个结论:- 模型差异(主因):Q5_K_M 在任何二进制下都比 UD-Q4_K_M 快 15-70%。UD-Q4_K_M(Unsloth Dynamic V3.0 混合精度)在 Vulkan 上明显吃亏,而标准 K-quant 的 Q5_K_M 优化成熟。
- 二进制版本(次因):b10472 (0.1.1-dev) 比 b10604 (0.2.0-dev) 快约 9%,但远小于模型差异。
- 配置项影响小:--kv-unified、context 大小、-ub、n-max 均不是关键。
建议:既然 b10472 + Q5_K_M 跑出 70+ t/s 是复现的,最佳方案是直接沿用那个配置。你可以:
- 方案 A:直接用 b10472 目录的 启动脚本 + Q5_K_M(保持现状,已验证 70+)
- 方案 B:把 b10604 的 启动脚本 改为加载 Q5_K_M 模型(用最新二进制 + 已验证的模型)
-
Qwen3.8 27B Q5_K_M + 7900xtx + DeepSeek Harness实战平均 52 t/s抄了作业,跑楼主参数,只有20tokens/s,比较尴尬,经过deepseek了一下,应该是我的CPU有点弱,我将--override-tensor blk.\d+.ffn_.*_exps.=CPU \注释掉了,并将--parallel改成了1,其他参数未动,现在能到60t/s了